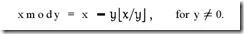首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | DolphinDB 内存表详解

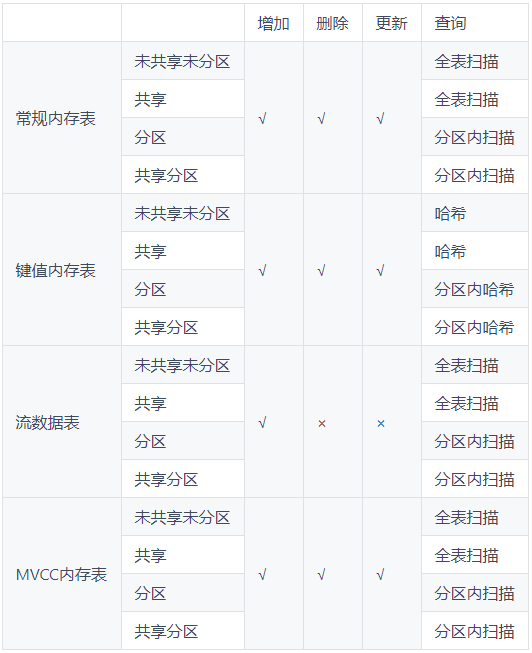
内存表是DolphinDB数据库的重要组成部分。内存表不仅可以直接用于存储数据,实现高速数据读写,而且可以缓存计算引擎的中间结果,加速计算过程。本教程主要介绍DolphinDB内存表的分类、使用场景以及各种内存表在数据操作以及表结构(schema)操作上的异同。 1. 内存表类别 根据不同的使用场景以及功能特点,DolphinDB内存表可以分为以下四种: 常规内存表 键值内存表 流数据表 MVCC内存表 1.1 常规内存表 常规内存表是DolphinDB中最基础的表结构,支持增删改查等操作。SQL查询返回的结果通常存储在常规内存表中,等待进一步处理。 创建 使用table函数可创建常规内存表。table函数有两种用法:第一种用法是根据指定的schema(字段类型和字段名称)以及表容量(capacity)和初始行数(size)来生成;第二种用法是通过已有数据(矩阵,表,数组和元组)来生成一个表。 使用第一种方法的好处是可以预先为表分配内存。当表中的记录数超过容量时,系统会自动扩充表的容量。扩充时系统首先会分配更大的内存空间(增加20%到100%不等),然后复制旧表到新的表,最后释放原来的内存。对于规模较大的表,扩容的成本会比较高。因此,如果我们可以事先预计表的行数,建议创建内存表时预先分配一个合理的容量。如果表的初始行数为0,系统会生成空表。如果初始行数不为0,系统会生成一个指定行数的表,表中各列的值都为默认值。例如: //创建一个空的常规内存表 t=table(100:0,`sym`id`val,[SYMBOL,INT,INT]) //创建一个10行的常规内存表 t=table(100:10,`sym`id`val,[SYMBOL,INT,INT]) select * from t sym id val --- -- --- 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 table函数也允许通过已有的数据来创建一个常规内存表。下例是通过多个数组来创建。 sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 t=table(sym,id,val) 应用 常规内存表是DolphinDB中应用最频繁的数据结构之一,仅次于数组。SQL语句的查询结果,分布式查询的中间结果都存储在常规内存表中。当系统内存不足时,该表并不会自动将数据溢出到磁盘,而是Out Of Memory异常。因此我们进行各种查询和计算时,要注意中间结果和最终结果的size。当某些中间结果不再需要时,请及时释放。关于常规内存表增删改查的各种用法,可以参考另一份教程内存分区表加载和操作。 1.2 键值内存表 键值内存表是DolphinDB中支持主键的内存表。通过指定表中的一个或多个字段作为主键,可以唯一确定表中的记录。键值内存表支持增删改查等操作,但是主键值不允许更新。键值内存表通过哈希表来记录每一个键值对应的行号,因此对于基于键值的查找和更新具有非常高的效率。 创建 使用keyedTable函数可创建键值内存表。该函数与table函数非常类似,唯一不同之处是增加了一个参数指明键值列的名称。 //创建空的键值内存表,主键由sym和id字段组成 t=keyedTable(`sym`id,1:0,`sym`id`val,[SYMBOL,INT,INT]) //使用向量创建键值内存表,主键由sym和id字段组成 sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 t=keyedTable(`sym`id,sym,id,val) 注意:指定容量和初始大小创建键值内存表时,初始大小必须为0。 我们也可以通过keyedTable函数将常规内存表转换为键值内存表。例如: sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 tmp=table(sym, id, val) t=keyedTable(`sym`id, tmp) 数据插入和更新的特点 往键值内存表中添加新纪录时,系统会自动检查新记录的主键值。如果新记录中的主键值不存在于表中,那么往表中添加新的记录;如果新记录的主键值与已有记录的主键值重复时,会更新表中该主键值对应的记录。请看下面的例子。 首先,往空的键值内存表中插入新记录,新记录中的主键值为AAPL, IBM和GOOG。 t=keyedTable(`sym,1:0,`sym`datetime`price`qty,[SYMBOL,DATETIME,DOUBLE,DOUBLE]); insert into t values(`APPL`IBM`GOOG,2018.06.08T12:30:00 2018.06.08T12:30:00 2018.06.08T12:30:00,50.3 45.6 58.0,5200 4800 7800); t; sym datetime price qty ---- ------------------- ----- ---- APPL 2018.06.08T12:30:00 50.3 5200 IBM 2018.06.08T12:30:00 45.6 4800 GOOG 2018.06.08T12:30:00 58 7800 再次往表中插入一批主键值为AAPL, IBM和GOOG的新记录。 insert into t values(`APPL`IBM`GOOG,2018.06.08T12:30:01 2018.06.08T12:30:01 2018.06.08T12:30:01,65.8 45.2 78.6,5800 8700 4600); t; sym datetime price qty ---- ------------------- ----- ---- APPL 2018.06.08T12:30:01 65.8 5800 IBM 2018.06.08T12:30:01 45.2 8700 GOOG 2018.06.08T12:30:01 78.6 4600 可以看到,表中记录条数没有增加,但是主键对应的记录已经更新。 继续往表中插入一批新记录,新记录本身包含了重复的主键值MSFT。 可以看到,表中有且仅有一条主键值为MSFT的记录。 应用场景 (1)键值表对单行的更新和查询有非常高的效率,是数据缓存的理想选择。与redis相比,DolphinDB中的键值内存表兼容SQL的所有操作,可以完成根据键值更新和查询以外的更为复杂的计算。 (2)作为时间序列聚合引擎的输出表,实时更新输出表的结果。具体请参考教程使用DolphinDB计算K线。 1.3 流数据表 流数据表顾名思义是为流数据设计的内存表,是流数据发布和订阅的媒介。流数据表具有天然的流表对偶性(Stream Table Duality),发布一条消息等价于往流数据表中插入一条记录,订阅消息等价于将流数据表中新到达的数据推向客户端应用。对流数据的查询和计算都可以通过SQL语句来完成。 创建 使用streamTable函数可创建流数据表。streamTable的用法和table函数完全相同。 //创建空的流数据表 t=streamTable(1:0,`sym`id`val,[SYMBOL,INT,INT]) //使用向量创建流数据表 sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 t=streamTable(sym,id,val) 我们也可以使用streamTable函数将常规内存表转换为流数据表。例如: sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 tmp=table(sym, id, val) t=streamTable(tmp) 流数据表也支持创建单个键值列,可以通过函数keyedStreamTable来创建。但与keyed table的设计目的不同,keyedstreamtable的目的是为了在高可用场景(多个发布端同时写入)下,避免重复消息。通常key就是消息的ID。 数据操作特点 由于流数据具有一旦生成就不会发生变化的特点,因此流数据表不支持更新和删除记录,只支持查询和添加记录。流数据通常具有连续性,而内存是有限的。为解决这个矛盾,流数据表引入了持久化机制,在内存中保留最新的一部分数据,更旧的数据持久化在磁盘上。当用户订阅旧的数据时,直接从磁盘上读取。启用持久化,使用函数enableTableShareAndPersistence,具体参考流数据教程。 应用场景 共享的流数据表在流计算中发布数据。订阅端通过subscribeTable函数来订阅和消费流数据。 1.4 MVCC内存表 MVCC内存表存储了多个版本的数据,当多个用户同时对MVCC内存表进行读写操作时,互不阻塞。MVCC内存表的数据隔离采用了快照隔离模型,用户读取到的是在他读之前就已经存在的数据,即使这些数据在读取的过程中被修改或删除了,也对之前正在读的用户没有影响。这种多版本的方式能够支持用户对内存表的并发访问。需要说明的是,当前的MVCC内存表实现比较简单,更新和删除数据时锁定整个表,并使用copy-on-write技术复制一份数据,因此对数据删除和更新操作的效率不高。在后续的版本中,我们将实现行级的MVCC内存表。 创建 使用mvccTable函数创建MVCC内存表。例如: //创建空的流数据表 t=mvccTable(1:0,`sym`id`val,[SYMBOL,INT,INT]) //使用向量创建流数据表 sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 t=mvccTable(sym,id,val) 我们可以将MVCC内存表的数据持久化到磁盘,只需创建时指定持久化的目录和表名即可。例如, t=mvccTable(1:0,`sym`id`val,[SYMBOL,INT,INT],"/home/user1/DolphinDB/mvcc","test") 系统重启后,我们可以通过loadMvccTable函数将磁盘中的数据加载到内存中。 loadMvccTable("/home/user1/DolphinDB/mvcc","test") 我们也可以使用mvccTable函数将常规内存表转换为MVCC内存表。 sym=`A`B`C`D`E id=5 4 3 2 1 val=52 64 25 48 71 tmp=table(sym, id, val) t=mvccTable(tmp) 应用场景 当前的MVCC内存表适用于读多写少,并有持久化需要的场景。譬如动态的配置系统,需要持久化配置项,配置项的改动不频繁,已新增和查询操作为主,非常适合MVCC表。 2. 共享内存表 DolphinDB中的内存表默认只在创建内存表的会话中使用,不支持多用户多会话的并发操作,当然对别的会话也不可见。如果希望创建的内存表能被别的用户使用,保证多用户并发操作的安全,必须共享内存表。4种类型的内存表均可共享。在DolphinDB中,我们使用share命令将内存表共享。 t=table(1..10 as id,rand(100,10) as val) share t as st //或者share(t,`st) 上面的代码将表t共享为表st。 使用undef函数可以删除共享表。 undef(`st,SHARED) 2.1 保证对所有会话可见 内存表仅在当前会话可见,在其他会话中不可见。共享之后,其他会话可以通过访问共享变量来访问内存表。例如,我们在当前会话中把表t共享为表st。 t=table(1..10 as id,rand(100,10) as val) share t as st 我们可以在其他会话中访问变量st。例如,往共享表st插入一条数据。 insert into st values(11,200) select * from st id val -- --- 1 1 2 53 3 13 4 40 5 61 6 92 7 36 8 33 9 46 10 26 11 200 切换到原来的会话,我们可以发现,表t中也增加了一条记录。 select * from t id val -- --- 1 1 2 53 3 13 4 40 5 61 6 92 7 36 8 33 9 46 10 26 11 200 2.2 保证线程安全 在多线程的情况下,内存表中的数据很容易被破坏。共享则提供了一种保护机制,能够保证数据安全,但同时也会影响系统的性能。 常规内存表、流数据表和MVCC内存表都支持多版本模型,允许多读一写。具体说,读写互不阻塞,写的时候可以读,读的时候可以写。读数据时不上锁,允许多个线程同时读取数据,读数据时采用快照隔离(snapshot isolation)。写数据时必须加锁,同时只允许一个线程修改内存表。写操作包括添加,删除或更新。添加记录一律在内存表的末尾追加,无论内存使用还是CPU使用均非常高效。常规内存表和MVCC内存表支持更新和删除,且采用了copy-on-write技术,也就是先复制一份数据(构成一个新的版本),然后在新版本上进行删除和修改。由此可见删除和更新操作无论内存和CPU消耗都比较高。当删除和更新操作很频繁,读操作又比较耗时(不能快速释放旧的版本),容易导致OOM异常。 键值内存表写入时需维护内部索引,读取时也需要根据索引获取数据。因此键值内存表共享采用了不同的方法,无论读写都必须加锁。写线程和读线程,多个写线程之间,多个读线程之间都是互斥的。对键值内存表尽量避免耗时的查询或计算,否则会使其它线程长时间处于等待状态。 3. 分区内存表 当内存表数据量较大时,我们可以对内存表进行分区。分区后一个大表有多个子表(tablet)构成,大表不使用全局锁,锁由每个子表独立管理,这样可以大大增加读写并发能力。DolphinDB支持对内存表进行值分区、范围分区、哈希分区和列表分区,不支持组合分区。在DolphinDB中,我们使用函数createPartitionedTable创建内存分区表。 创建分区常规内存表 t=table(1:0,`id`val,[INT,INT]) db=database("",RANGE,0 101 201 301) pt=db.createPartitionedTable(t,`pt,`id) 创建分区键值内存表 kt=keyedTable(1:0,`id`val,[INT,INT]) db=database("",RANGE,0 101 201 301) pkt=db.createPartitionedTable(t,`pkt,`id) 创建分区流数据表 创建分区流数据表时,需要传入多个流数据表作为模板,每个流数据表对应一个分区。写入数据时,直接往这些流表中写入;而查询数据时,需要查询分区表。 st1=streamTable(1:0,`id`val,[INT,INT]) st2=streamTable(1:0,`id`val,[INT,INT]) st3=streamTable(1:0,`id`val,[INT,INT]) db=database("",RANGE,1 101 201 301) pst=db.createPartitionedTable([st1,st2,st3],`pst,`id) st1.append!(table(1..100 as id,rand(100,100) as val)) st2.append!(table(101..200 as id,rand(100,100) as val)) st3.append!(table(201..300 as id,rand(100,100) as val)) select * from pst 创建分区MVCC内存表 与创建分区流数据表一样,创建分区MVCC内存表,需要传入多个MVCC内存表作为模板。每个表对应一个分区。写入数据时,直接往这些表中写入;而查询数据时,需要查询分区表。 mt1=mvccTable(1:0,`id`val,[INT,INT]) mt2=mvccTable(1:0,`id`val,[INT,INT]) mt3=mvccTable(1:0,`id`val,[INT,INT]) db=database("",RANGE,1 101 201 301) pmt=db.createPartitionedTable([mt1,mt2,mt3],`pst,`id) mt1.append!(table(1..100 as id,rand(100,100) as val)) mt2.append!(table(101..200 as id,rand(100,100) as val)) mt3.append!(table(201..300 as id,rand(100,100) as val)) select * from pmt 由于分区内存表不使用全局锁,创建以后不能再动态增删子表。 3.1 增加查询的并发性 分区表增加查询的并发性有三层含义:(1)键值表在查询时也需要加锁,分区表由子表独立管理锁,相当于把锁的粒度变细了,因此可以增加读的并发性;(2)批量计算时分区表可以并行处理每个子表;(3)如果SQL查询的过滤指定了分区字段,那么可以缩小分区范围,避免全表扫描。 以键值内存表为例,我们对比在分区和不分区的情况下,并发查询的性能。首先,创建模拟数据集,一共包含500万行数据。 n=5000000 id=shuffle(1..n) qty=rand(1000,n) price=rand(1000.0,n) kt=keyedTable(`id,id,qty,price) share kt as skt id_range=cutPoints(1..n,20) db=database("",RANGE,id_range) pkt=db.createPartitionedTable(kt,`pkt,`id).append!(kt) share pkt as spkt 我们在另外一台服务器上模拟10个客户端同时查询键值内存表。每个客户端查询10万次,每次查询一条数据,统计每个客户端查询10万次的总耗时。 def queryKeyedTable(tableName,id){ for(i in id){ select * from objByName(tableName) where id=i } } conn=xdb("192.168.1.135",18102,"admin","123456") n=5000000 jobid1=array(STRING,0) for(i in 1..10){ rid=rand(1..n,100000) s=conn(submitJob,"evalQueryUnPartitionTimer"+string(i),"",evalTimer,queryKeyedTable{`skt,rid}) jobid1.append!(s) } time1=array(DOUBLE,0) for(j in jobid1){ time1.append!(conn(getJobReturn,j,true)) } jobid2=array(STRING,0) for(i in 1..10){ rid=rand(1..n,100000) s=conn(submitJob,"evalQueryPartitionTimer"+string(i),"",evalTimer,queryKeyedTable{`spkt,rid}) jobid2.append!(s) } time2=array(DOUBLE,0) for(j in jobid2){ time2.append!(conn(getJobReturn,j,true)) } time1是10个客户端查询未分区键值内存表的耗时,time2是10个客户端查询分区键值内存表的耗时,单位是毫秒。 time1 [6719.266848,7160.349678,7271.465094,7346.452625,7371.821485,7363.87979,7357.024299,7332.747157,7298.920972,7255.876976] time2 [2382.154581,2456.586709,2560.380315,2577.602019,2599.724927,2611.944367,2590.131679,2587.706832,2564.305815,2498.027042] 可以看到,每个客户端查询分区键值内存表的耗时要低于查询未分区内存表的耗时。 查询未分区的内存表,可以保证快照隔离。但查询一个分区内存表,不再保证快照隔离。如前面所说分区内存表的读写不使用全局锁,一个线程在查询时,可能另一个线程正在写入而且涉及多个子表,从而可能读到一部分写入的数据。 3.2 增加写入的并发性 以分区的常规内存表为例,我们可以同时往不同的分区写入数据。 t=table(1:0,`id`val,[INT,INT]) db=database("",RANGE,1 101 201 301) pt=db.createPartitionedTable(t,`pt,`id) def writeData(mutable t,id,batchSize,n){ for(i in 1..n){ idv=take(id,batchSize) valv=rand(100,batchSize) tmp=table(idv,valv) t.append!(tmp) } } job1=submitJob("write1","",writeData,pt,1..100,1000,1000) job2=submitJob("write2","",writeData,pt,101..200,1000,1000) job3=submitJob("write3","",writeData,pt,201..300,1000,1000) 上面的代码中,同时有3个线程对pt的3个不同的分区进行写入。需要注意的是,我们要避免同时对相同分区进行写入。例如,下面的代码可能会导致系统崩溃。 job1=submitJob("write1","",writeData,pt,1..300,1000,1000) job2=submitJob("write2","",writeData,pt,1..300,1000,1000) 上面的代码定义了两个写入线程,并且写入的分区相同,这样会破坏内存。为了保证每个分区数据的安全性和一致性,我们可将分区内存表共享。这样即可定义多个线程同时对相同分区分入。 share pt as spt job1=submitJob("write1","",writeData,spt,1..300,1000,1000) job2=submitJob("write2","",writeData,spt,1..300,1000,1000) 4. 数据操作比较 4.1 增删改查 下表总结了4种类型内存表在共享/分区的情况下支持的增删改查操作。 说明: 常规内存表、键值内存表、MVCC内存表都支持增删改查操作,流数据表仅支持增加数据和查询,不支持删除和更新操作。 对于键值内存表,如果查询的过滤条件中包含主键,查询的性能会得到明显提升。 对于分区内存表,如果查询的过滤条件中包含分区列,系统能够缩小要扫描的分区范围,从而提升查询的性能。 4.2 并发性 在没有写入的情况下,所有内存表都允许多个线程同时查询。在有写入的情况下,4种内存表的并发性有所差异。下表总结了4种内存表在共享/分区的情况下支持的并发读写情况。 说明: 共享表允许并发读写。 对于没有共享的分区表,不允许多线程对相同分区同时写入的。 4.3 持久化 常规内存表和键值内存表不支持数据持久化。一旦节点重启,内存中的数据将全部丢失。 只有空的流数据表才支持数据持久化。要对流数据表进行持久化,首先要配置流数据持久化的目录persistenceDir,再使用enableTableShareAndPersistence使用将流数据表共享,并持久化到磁盘上。例如,将流数据表t共享并持久化到磁盘上。 t=streamTable(1:0,`id`val,[INT,INT]) enableTableShareAndPersistence(t,`st) 流数据表启用了持久化后,内存中仍然会保留流数据表中部分最新的记录。默认情况下,内存会保留最新的10万条记录。我们也可以根据需要调整这个值。 流数据表持久化可以设定采用异步/同步、压缩/不压缩的方式。通常情况下,异步模式能够实现更高的吞吐量。 系统重启后,再次执行enableTableShareAndPersistence函数,会将磁盘中的所有数据加载到内存。 MVCC内存表支持持久化。在创建MVCC内存表时,我们可以指定持久化的路径。例如,创建持久化的MVCC内存表。 t=mvccTable(1:0,`id`val,[INT,INT],"/home/user/DolphinDB/mvccTable") t.append!(table(1..10 as id,rand(100,10) as val)) 系统重启后,我们可以使用loadMvccTable函数将磁盘中的数据加载到内存中。例如: t=loadMvccTable("/home/user/DolphinDB/mvccTable","t") 5. 表结构操作比较 内存表的结构操作包括新增列、删除列、修改列(内容和数据类型)以及调整列的顺序。下表总结了4种类型内存表在共享/分区的情况下支持的结构操作。 说明: 分区表以及MVCC内存表不能通过addColumn函数新增列。 分区表可以通过update语句来新增列,但是流数据表不允许修改,因此流数据表不能通过update语句来新增列。 6. 小结 DolphinDB支持4种类型内存表,还引入了共享和分区的概念,基本能够满足内存计算和流计算的各种需求。

优秀的个人博客,低调大师

每日一博 | 原码、反码、补码详解

作者:ziqiu.zhang 链接:https://www.cnblogs.com/zhangziqiu/archive/2011/03/30/ComputerCode.html 本篇文章讲解了计算机的原码, 反码和补码. 并且进行了深入探求了为何要使用反码和补码, 以及更进一步的论证了为何可以用反码, 补码的加法计算原码的减法. 论证部分如有不对的地方请各位牛人帮忙指正! 希望本文对大家学习计算机基础有所帮助! 一、机器数和真值 在学习原码, 反码和补码之前, 需要先了解机器数和真值的概念. 1、机器数 一个数在计算机中的二进制表示形式, 叫做这个数的机器数。机器数是带符号的,在计算机用一个数的最高位存放符号, 正数为0, 负数为1. 比如,十进制中的数 +3 ,计算机字长为8位,转换成二进制就是00000011。如果是 -3 ,就是 10000011 。 那么,这里的 00000011 和 10000011 就是机器数。 2、真值 因为第一位是符号位,所以机器数的形式值就不等于真正的数值。例如上面的有符号数 10000011,其最高位1代表负,其真正数值是 -3 而不是形式值131(10000011转换成十进制等于131)。所以,为区别起见,将带符号位的机器数对应的真正数值称为机器数的真值。 例:0000 0001的真值 = +000 0001 = +1,1000 0001的真值 = –000 0001 = –1 二、原码, 反码, 补码的基础概念和计算方法. 在探求为何机器要使用补码之前, 让我们先了解原码, 反码和补码的概念.对于一个数, 计算机要使用一定的编码方式进行存储. 原码, 反码, 补码是机器存储一个具体数字的编码方式. 1、原码 原码就是符号位加上真值的绝对值, 即用第一位表示符号, 其余位表示值. 比如如果是8位二进制: [+1]原= 0000 0001 [-1]原= 1000 0001 第一位是符号位. 因为第一位是符号位, 所以8位二进制数的取值范围就是: [1111 1111 , 0111 1111] 即 [-127 , 127] 原码是人脑最容易理解和计算的表示方式. 2、反码 反码的表示方法是: 正数的反码是其本身 负数的反码是在其原码的基础上, 符号位不变,其余各个位取反. [+1] = [00000001]原= [00000001]反 [-1] = [10000001]原= [11111110]反 可见如果一个反码表示的是负数, 人脑无法直观的看出来它的数值. 通常要将其转换成原码再计算. 3、补码 补码的表示方法是: 正数的补码就是其本身 负数的补码是在其原码的基础上, 符号位不变, 其余各位取反, 最后+1. (即在反码的基础上+1) [+1] = [00000001]原= [00000001]反= [00000001]补 [-1] = [10000001]原= [11111110]反= [11111111]补 对于负数, 补码表示方式也是人脑无法直观看出其数值的. 通常也需要转换成原码在计算其数值. 三、为何要使用原码, 反码和补码 在开始深入学习前, 我的学习建议是先"死记硬背"上面的原码, 反码和补码的表示方式以及计算方法. 现在我们知道了计算机可以有三种编码方式表示一个数. 对于正数因为三种编码方式的结果都相同: [+1] = [00000001]原= [00000001]反= [00000001]补 所以不需要过多解释. 但是对于负数: [-1] = [10000001]原= [11111110]反= [11111111]补 可见原码, 反码和补码是完全不同的. 既然原码才是被人脑直接识别并用于计算表示方式, 为何还会有反码和补码呢? 首先, 因为人脑可以知道第一位是符号位, 在计算的时候我们会根据符号位, 选择对真值区域的加减. (真值的概念在本文最开头). 但是对于计算机, 加减乘数已经是最基础的运算, 要设计的尽量简单. 计算机辨别"符号位"显然会让计算机的基础电路设计变得十分复杂! 于是人们想出了将符号位也参与运算的方法. 我们知道, 根据运算法则减去一个正数等于加上一个负数, 即: 1-1 = 1 + (-1) = 0 , 所以机器可以只有加法而没有减法, 这样计算机运算的设计就更简单了. 于是人们开始探索 将符号位参与运算, 并且只保留加法的方法. 首先来看原码: 计算十进制的表达式: 1-1=0 1 - 1 = 1 + (-1) = [00000001]原+ [10000001]原= [10000010]原= -2 如果用原码表示, 让符号位也参与计算, 显然对于减法来说, 结果是不正确的.这也就是为何计算机内部不使用原码表示一个数. 为了解决原码做减法的问题, 出现了反码: 计算十进制的表达式: 1-1=0 1 - 1 = 1 + (-1) = [0000 0001]原+ [1000 0001]原= [0000 0001]反+ [1111 1110]反= [1111 1111]反= [1000 0000]原= -0 发现用反码计算减法, 结果的真值部分是正确的. 而唯一的问题其实就出现在"0"这个特殊的数值上. 虽然人们理解上+0和-0是一样的, 但是0带符号是没有任何意义的. 而且会有[0000 0000]原和[1000 0000]原两个编码表示0. 于是补码的出现, 解决了0的符号以及两个编码的问题: 1-1 = 1 + (-1) = [0000 0001]原+ [1000 0001]原= [0000 0001]补+ [1111 1111]补= [0000 0000]补=[0000 0000]原 这样0用[0000 0000]表示, 而以前出现问题的-0则不存在了.而且可以用[1000 0000]表示-128: (-1) + (-127) = [1000 0001]原+ [1111 1111]原= [1111 1111]补+ [1000 0001]补= [1000 0000]补 -1-127的结果应该是-128, 在用补码运算的结果中, [1000 0000]补就是-128. 但是注意因为实际上是使用以前的-0的补码来表示-128, 所以-128并没有原码和反码表示.(对-128的补码表示[1000 0000]补算出来的原码是[0000 0000]原, 这是不正确的) 使用补码, 不仅仅修复了0的符号以及存在两个编码的问题, 而且还能够多表示一个最低数. 这就是为什么8位二进制, 使用原码或反码表示的范围为[-127, +127], 而使用补码表示的范围为[-128, 127]. 因为机器使用补码, 所以对于编程中常用到的32位int类型, 可以表示范围是: [-231, 231-1] 因为第一位表示的是符号位.而使用补码表示时又可以多保存一个最小值. 四、原码, 反码, 补码 再深入 计算机巧妙地把符号位参与运算, 并且将减法变成了加法, 背后蕴含了怎样的数学原理呢? 将钟表想象成是一个1位的12进制数. 如果当前时间是6点, 我希望将时间设置成4点, 需要怎么做呢?我们可以: 1. 往回拨2个小时: 6 - 2 = 4 2. 往前拨10个小时: (6 + 10) mod 12 = 4 3. 往前拨10+12=22个小时: (6+22) mod 12 =4 2,3方法中的mod是指取模操作, 16 mod 12 =4 即用16除以12后的余数是4. 所以钟表往回拨(减法)的结果可以用往前拨(加法)替代! 现在的焦点就落在了如何用一个正数, 来替代一个负数. 上面的例子我们能感觉出来一些端倪, 发现一些规律. 但是数学是严谨的. 不能靠感觉. 首先介绍一个数学中相关的概念: 同余 同余的概念 两个整数a,b,若它们除以整数m所得的余数相等,则称a,b对于模m同余 记作 a ≡ b (mod m) 读作 a 与 b 关于模 m 同余。 举例说明: 4 mod 12 = 4 16 mod 12 = 4 28 mod 12 = 4 所以4, 16, 28关于模 12 同余. 负数取模 正数进行mod运算是很简单的. 但是负数呢? 下面是关于mod运算的数学定义: 上面是截图, "取下界"符号找不到如何输入(word中粘贴过来后乱码). 下面是使用"L"和"J"替换上图的"取下界"符号: x mod y = x - y L x / y J 上面公式的意思是: x mod y等于 x 减去 y 乘上 x与y的商的下界. 以 -3 mod 2 举例: -3 mod 2 = -3 - 2xL -3/2 J = -3 - 2xL-1.5J = -3 - 2x(-2) = -3 + 4 = 1 所以: (-2) mod 12 = 12-2=10 (-4) mod 12 = 12-4 = 8 (-5) mod 12 = 12 - 5 = 7 开始证明 再回到时钟的问题上: 回拨2小时 = 前拨10小时 回拨4小时 = 前拨8小时 回拨5小时= 前拨7小时 注意, 这里发现的规律! 结合上面学到的同余的概念.实际上: (-2) mod 12 = 10 10 mod 12 = 10 -2与10是同余的. (-4) mod 12 = 8 8 mod 12 = 8 -4与8是同余的. 距离成功越来越近了. 要实现用正数替代负数, 只需要运用同余数的两个定理: 反身性: a ≡ a (mod m) 这个定理是很显而易见的. 线性运算定理: 如果a ≡ b (mod m),c ≡ d (mod m) 那么: (1)a ± c ≡ b ± d (mod m) (2)a * c ≡ b * d (mod m) 如果想看这个定理的证明, 请看:http://baike.baidu.com/view/79282.htm 所以: 7 ≡ 7 (mod 12) (-2) ≡ 10 (mod 12) 7 -2 ≡ 7 + 10 (mod 12) 现在我们为一个负数, 找到了它的正数同余数. 但是并不是7-2 = 7+10, 而是 7 -2 ≡ 7 + 10 (mod 12) , 即计算结果的余数相等. 接下来回到二进制的问题上, 看一下: 2-1=1的问题. 2-1=2+(-1) = [0000 0010]原+ [1000 0001]原= [0000 0010]反+ [1111 1110]反 先到这一步, -1的反码表示是1111 1110. 如果这里将[1111 1110]认为是原码, 则[1111 1110]原 = -126, 这里将符号位除去, 即认为是126. 发现有如下规律: (-1) mod 127 = 126 126 mod 127 = 126 即: (-1) ≡ 126 (mod 127) 2-1 ≡ 2+126 (mod 127) 2-1 与 2+126的余数结果是相同的! 而这个余数, 正式我们的期望的计算结果: 2-1=1 所以说一个数的反码, 实际上是这个数对于一个膜的同余数. 而这个膜并不是我们的二进制, 而是所能表示的最大值! 这就和钟表一样, 转了一圈后总能找到在可表示范围内的一个正确的数值! 而2+126很显然相当于钟表转过了一轮, 而因为符号位是参与计算的, 正好和溢出的最高位形成正确的运算结果. 既然反码可以将减法变成加法, 那么现在计算机使用的补码呢? 为什么在反码的基础上加1, 还能得到正确的结果? 2-1=2+(-1) = [0000 0010]原+ [1000 0001]原= [0000 0010]补+ [1111 1111]补 如果把[1111 1111]当成原码, 去除符号位, 则: [0111 1111]原= 127 其实, 在反码的基础上+1, 只是相当于增加了膜的值: (-1) mod 128 = 127 127 mod 128 = 127 2-1 ≡ 2+127 (mod 128) 此时, 表盘相当于每128个刻度转一轮. 所以用补码表示的运算结果最小值和最大值应该是[-128, 128]. 但是由于0的特殊情况, 没有办法表示128, 所以补码的取值范围是[-128, 127] 本文分享自微信公众号 - C语言与CPP编程(cwdushu)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 深入了解 ActiveMQ

认识MQ(Message Queue) 什么是消息队列 消息队列 首先我们先从以下几个维度来认识一下消息队列: 消息队列:一般我们会简称它为MQ(MessageQueue) 消息(Message):传输的数据。 队列(Queue):队列是一种先进先出的数据结构。 消息队列从字面的含义来看就是一个存放消息的容器。 消息队列可以简单理解为:把要传输的数据放在队列中。 把数据放到消息队列叫做生产者。 从消息队列里边取数据叫做消费者。 为什么需要消息队列 使用消息队列主要是基于以下三个主要场景: 解耦 异步 削峰/限流 下面我们分场景来描述下使用消息队列带来的好处 解耦 假设我们有一个用户系统A,用户系统A可以产生一个userId。 然后,现在有系统B和系统C都需要这个userId去做相关的操作。 解耦前架构 伪码大致如下: javapublicclassSystemA{//系统B和系统C的依赖SystemBsystemB=newSystemB();SystemCsystemC=newSystemC();//系统A独有的数据userIdprivateStringuserId="activeMq-1234567890";publicvoiddoSomething(){//系统B和系统C都需要拿着系统A的userId去操作其他的事systemB.SystemBNeed2do(userId);systemC.SystemCNeed2do(userId);}} 「这样类似的业务场景大家是不是很熟悉,大家是不是这样写很合情合理,也很简单。」 某一天,系统B的负责人告诉系统A的负责人,现在系统B的SystemBNeed2do(String userId)这个接口不再使用了,让系统A别去调它了。于是,系统A的负责人说"好的,那我就不调用你了。",于是就把调用系统B接口的代码给删掉了。代码变成这样了: javapublicvoiddoSomething(){//系统A不再调用系统B的接口了//systemB.SystemBNeed2do(userId);systemC.SystemCNeed2do(userId);} 由于业务需要,系统D说也需要用到系统A的userId,于是代码改成了这样: javapublicvoiddoSomething(){//已经不再需要系统B的依赖了//systemB.SystemBNeed2do(userId);//系统C和系统D都需要拿着系统A的userId去操作其他的事systemC.SystemCNeed2do(userId);systemD.SystemDNeed2do(userId);} 当前系统A、B、C、D系统的交互是这样子的。 系统交互 随着业务需求的变化,代码也要一遍一遍的修改。 还会存在另外一个问题,调用系统C的时候,如果系统C挂了,系统A还要想办法处理。如果调用系统D时,由于网络延迟,请求超时了,那系统A是反馈fail还是重试? 那么怎么去解决这样的现状呢,如何从频繁的修改代码中解脱呢? 这时候我们就引入一层消息队列中间件,交互图如下: 解耦 将系统A产生的userId写到消息队列中,系统C和系统D从消息队列中拿数据。 这样有什么好处? 系统A只负责把数据写到队列中,谁想要或不想要这个数据(消息),系统A一点都不关心。 即便现在系统D不想要userId这个数据了,系统B又突然想要userId这个数据了,都跟系统A无关,系统A一点代码都不用改。 系统D拿userId不再经过系统A,而是从消息队列里边拿。系统D即便挂了或者请求超时,都跟系统A无关, 只跟消息队列有关。这样一来,系统A与系统B、C、D都解耦了。 异步 系统A做的是主要的业务,而系统B、C、D是非主要的业务。比如系统A处理的是订单下单,而系统B是订单下单成功了,那发送一条短信告诉具体的用户此订单已成功,而系统C和系统D也是处理一些小事而已。 那么此时,为了提高用户体验和吞吐量,其实可以异步地调用系统B、C、D的接口。 异步 削峰/限流 我们再来一个场景,现在我们每个月要搞一次大促,大促期间的并发可能会很高的,比如每秒3000个请求。假设我们现在有两台机器处理请求,并且每台机器只能每次处理1000个请求。 削峰前 系统B和系统C根据自己的能够处理的请求数去消息队列中拿数据,这样即便有每秒有8000个请求,那只是把请求放在消息队列中,去拿消息队列的消息由系统自己去控制,这样就不会把整个系统给搞崩。 削峰/限流 什么是JMS MQ 全称:Java MessageService 中文:Java 消息服务。 JMS 是 Java 的一套 API 标准,最初的目的是为了使应用程序能够访问现有的MOM 系 统(MOM 是 MessageOriented Middleware 的英文缩写,指的是利用高效可靠的消息传递机制进行平台无关的数据交流,并基于数据通信来进行分布式系统的集成。) 后来被许多现有的 MOM 供应商采用,并实现为MOM 系统。 常见 MOM 系统包括 Apache的 ActiveMQ、阿里巴巴的 RocketMQ、IBM 的 MQSeries、Microsoft 的 MSMQ、BEA 的 RabbitMQ 等。(并非全部的 MOM 系统都遵循JMS 规范)】 基于 JMS 实现的 MOM,又被称为JMSProvider。 JMS中的一些概念 「Broker」 消息服务器,作为server提供消息核心服务 「Provider 生产者」 消息生产者是由会话创建的一个对象,用于把消息发动到一个目的地 「Consumer 消费者」 消息消费者是由会话创建的一个对象,它用于接收发送到目的地的消息。消息的消费可以采用以下两种方法: 同步消费。通过调用消费者的receive方法从目的地中显式提取消息。receive方法可以一直阻塞到消息到达。 异步消费。客户可以为消费者注册一个消息监听器,以定义在消息到达时所采取的动作。 「P2P 点对点消息模型」 消息生产者生产消息发送到queue 中,然后消息消费者从queue 中取出并且消费消息。消息被消费以后,queue 中不再有存储,所以消息消费者不可能消费到已经被消费的消息。Queue支持存在多个消费者,但是对一个消息而言,只会有一个消费者可以消费、其它的则不能消费此消息了。当消费者不存在时,消息会一直保存,直到有消费消费。 「Pub/Sub 发布订阅消息模型」 消息生产者(发布)将消息发布到topic 中,同时有多个消息消费者(订阅)消费该消息。和点对点方式不同,发布到 topic 的消息会被所有订阅者消费。当生产者发布消息,不管是否有消费者。都不会保存消息一定要先有消息的消费者,后有消息的生产者。 「P2P vs Pub/Sub」 P2P vsPub/Sub 「Queue」 队列存储,常用于点对点消息模型 默认只能由唯一的一个消费者处理。一旦处理消息删除。 「Topic」 主题存储,用于订阅/发布消息模型 主题中的消息,会发送给所有的消费者同时处理。只有在消息可以重复处理的业务场景中可使用。 「ConnectionFactory」 连接工厂,jms中用它创建连接 连接工厂是客户用来创建连接的对象,例如ActiveMQ提供的ActiveMQConnectionFactory。 「Connection」 JMS Connection封装了客户与JMS提供者之间的一个虚拟的连接。 「Destination 消息的目的地」 目的地是客户用来指定它生产的消息的目标和它消费的消息的来源的对象。 订阅一个主题的消费者只能消费自它订阅之后发布的消息。JMS规范允许客户创建持久订阅,这在一定程度上放松了时间上的相关性要求。持久订阅允许消费者消费它在未处于激活状态时发送的消息。在点对点消息传递域中,目的地被成为队列(queue);在发布/订阅消息传递域中,目的地被成为主题(topic)。 「Session」 JMS Session是生产和消费消息的一个单线程上下文。会话用于创建消息生产者(producer)、消息消费者(consumer)和消息(message)等。会话提供了一个事务性的上下文,在这个上下文中,一组发送和接收被组合到了一个原子操作中。 消息可靠性机制 「确认 JMS消息」 只有在被确认之后,才认为已经被成功地消费了。消息的成功消费通常包含三个阶段:客户接收消息、客户处理消息和消息被确认。 在事务性会话中,当一个事务被提交的时候,确认自动发生。 在非事务性会话中,消息何时被确认取决于创建会话时的应答模式(acknowledgement mode)。该参数有以下三个可选值: 「Session.AUTO_ACKNOWLEDGE」。当客户成功的从receive方法返回的时候,或者从MessageListener.onMessage方法成功返回的时候,会话自动确认客户收到的消息。 「Session.CLIENT_ACKNOWLEDGE」。客户通过消息的acknowledge方法确认消息。需要注意的是,在这种模式中,确认是在会话层上进行:确认一个被消费的消息将自动确认所有已被会话消费的消息。例如,如果一个消息消费者消费了10个消息,然后确认第5个消息,那么所有10个消息都被确认。 「Session.DUPS_ACKNOWLEDGE」。该选择只是会话迟钝的确认消息的提交。如果JMS Provider失败,那么可能会导致一些重复的消息。如果是重复的消息,那么JMS Provider必须把消息头的JMSRedelivered字段设置为true。 「持久性」 JMS 支持以下两种消息提交模式: 「PERSISTENT」。指示JMSProvider持久保存消息,以保证消息不会因为JMS Provider的失败而丢失。 「NON_PERSISTENT」。不要求JMS Provider持久保存消息。 「优先级」 可以使用消息优先级来指示JMS Provider首先提交紧急的消息。优先级分10个级别,从0(最低)到9(最高)。如果不指定优先级,默认级别是4。「需要注意的是,JMSProvider并不一定保证按照优先级的顺序提交消息。」 「消息过期」 可以设置消息在一定时间后过期,默认是永不过期 「临时目的地」 可以通过会话上的createTemporaryQueue方法和createTemporaryTopic方法来创建临时目的地。它们的存在时间只限于创建它们的连接所保持的时间。只有创建该临时目的地的连接上的消息消费者才能够从临时目的地中提取消息。 「持久订阅」 首先消息生产者必须使用PERSISTENT提交消息。客户可以通过会话上的createDurableSubscriber方法来创建一个持久订阅,该方法的第一个参数必须是一个topic,第二个参数是订阅的名称。 JMS Provider会存储发布到持久订阅对应的topic上的消息。如果最初创建持久订阅的客户或者任何其它客户使用相同的连接工厂和连接的客户ID、相同的主题和相同的订阅名再次调用会话上的createDurableSubscriber方法,那么该持久订阅就会被激活。 JMS Provider会向客户发送客户处于非激活状态时所发布的消息。 持久订阅在某个时刻只能有一个激活的订阅者。持久订阅在创建之后会一直保留,直到应用程序调用会话上的unsubscribe方法。 「本地事务」 在一个JMS客户端,可以使用本地事务来组合消息的发送和接收。JMS Session接口提供了commit和rollback方法。事务提交意味着生产的所有消息被发送,消费的所有消息被确认;事务回滚意味着生产的所有消息被销毁,消费的所有消息被恢复并重新提交,除非它们已经过期。 事务性的会话总是牵涉到事务处理中,commit或rollback方法一旦被调用,一个事务就结束了,而另一个事务被开始。关闭事务性会话将回滚其中的事务。 需要注意的是,如果使用请求/回复机制,即发送一个消息,同时希望在同一个事务中等待接收该消息的回复,那么程序将被挂起,因为知道事务提交,发送操作才会真正执行。需要注意的还有一个,消息的生产和消费不能包含在同一个事务中。 ActiveMQ 存储 ActiveMQ支持很多种存储方式,常见的有 KahaDB存储,AMQ存储,JDBC存储,LevelDB存储,Memory 消息存储。我们重点介绍一下KahaDB和JDBC存储方式。 KahaDB存储 KahaDB是默认的持久化策略,所有消息顺序添加到一个日志文件中,同时另外有一个索引文件记录指向这些日志的存储地址,还有一个事务日志用于消息回复操作。是一个专门针对消息持久化的解决方案,它对典型的消息使用模式进行了优化。 在data/kahadb这个目录下,会生成四个文件,来完成消息持久化 db.data 它是消息的索引文件,本质上是B-Tree(B树),使用B-Tree作为索引指向db-*.log里面存储的消息 db.redo 用来进行消息恢复 *db-.log 存储消息内容。 kahadb文件结构 新的数据以APPEND的方式追加到日志文件末尾。属于顺序写入,因此消息存储是比较 快的。默认是32M,达到阀值会自动递增 lock文件 锁,写入当前获得kahadb读写权限的broker ,用于在集群环境下的竞争处理。 KahaDB有如下几个特性: 日志形式存储消息; 消息索引以 B-Tree 结构存储,可以快速更新; 完全支持 JMS 事务; 支持多种恢复机制kahadb 可以限制每个数据文件的大小。不代表总计数据容量。 配置方式如下: <persistenceAdapter><kahaDBdirectory="${activemq.data}/kahadb"/></persistenceAdapter> JDBC 存储 支持通过 JDBC 将消息存储到关系数据库,性能上不如文件存储,能通过关系型数据库查询到消息的信息。 MQ 支持的数据库:Apache Derby、MySQL、PostgreSQL、Oracle、SQLServer、Sybase、Informix、MaxDB。使用JDBC存储需要用到下面三张数据表。 「activemq_acks」:用于存储订阅关系。如果是持久化Topic,订阅者和服务器的订阅关系在这个表保存。主要的数据库字段如下: container:消息的destination sub_dest:如果是使用static集群,这个字段会有集群其他系统的信息 client_id:每个订阅者都必须有一个唯一的客户端id用以区分 sub_name:订阅者名称 selector:选择器,可以选择只消费满足条件的消息。条件可以用自定义属性实现,可支持多属性and和or操作 last_acked_id:记录消费过的消息的id。 「activemq_lock」:在集群环境中才有用,只有一个Broker可以获得消息,称为Master Broker,其他的只能作为备份等待Master Broker不可用,才可能成为下一个Master Broker。这个表用于记录哪个Broker是当前的Master Broker。 「activemq_msgs」:用于存储消息,Queue和Topic都存储在这个表中。主要的数据库字段如下 id:自增的数据库主键 container:消息的destination msgid_prod:消息发送者客户端的主键 msg_seq:是发送消息的顺序,msgid_prod+msg_seq可以组成jms的messageid expiration:消息的过期时间,存储的是从1970-01-01到现在的毫秒数 msg:消息本体的java序列化对象的二进制数据 priority:优先级,从0-9,数值越大优先级越高 xid:topic 配置方式如下: 配置数据源 conf/acticvemq.xml 文件: <beanid="mysql-ds"class="org.apache.commons.dbcp.BasicDataSource"destroy-method="close"><propertyname="driverClassName"value="com.mysql.jdbc.Driver"/><propertyname="url"value="jdbc:mysql://localhost:3306/activemq?relaxAutoCommit=true"/><propertyname="username"value="root"/><propertyname="password"value="111111"/><propertyname="maxActive"value="200"/><propertyname="poolPreparedStatements"value="true"/></bean> 配置 broke 中的 persistenceAdapter dataSource 指定持久化数据库的 bean,createTablesOnStartup 是否在启动的时候创建数据表,默认值是 true,这样每次启动都会去创建数据表了,一般是第一次启动的时候设置为 true,之后改成 false。 <persistenceAdapter><jdbcPersistenceAdapterdataSource="#mysql-ds"createTablesOnStartup="false"/></persistenceAdapter> 协议 ActiveMQ支持的client-broker通讯协议有:TCP、NIO、UDP、SSL、Http(s)、VM。 Transmission Control Protocol (TCP) 这是默认的Broker配置,TCP的Client监听端口是61616。 在网络传输数据前,必须要序列化数据,消息是通过一个叫wire protocol的来序列化成字节流。默认情况下,ActiveMQ把wire protocol叫做OpenWire,它的目的是促使网络上的效率和数据快速交互。 TCP连接的URI形式:tcp://hostname:port?key=value&key=value TCP传输的优点:(1)TCP协议传输可靠性高,稳定性强 (2)高效性:字节流方式传递,效率很高 (3)有效性、可用性:应用广泛,支持任何平台 New I/O API Protocol(NIO) NIO协议和TCP协议类似,但NIO更侧重于底层的访问操作。它允许开发人员对同一资源可有更多的client调用和服务端有更多的负载。 适合使用NIO协议的场景:(1)可能有大量的Client去链接到Broker上一般情况下,大量的Client去链接Broker是被操作系统的线程数所限制的。因此,NIO的实现比TCP需要更少的线程去运行,所以建议使用NIO协议 (2)可能对于Broker有一个很迟钝的网络传输NIO比TCP提供更好的性能 NIO连接的URI形式:nio://hostname:port?key=value Transport Connector配置示例: <transportConnectors><transportConnectorname="nio"uri="nio://localhost:61618?trace=true"/></transportConnectors> User Datagram Protocol(UDP) UDP和TCP的区别 (1)TCP是一个原始流的传递协议,意味着数据包是有保证的,换句话说,数据包是不会被复制和丢失的。UDP,另一方面,它是不会保证数据包的传递的 (2)TCP也是一个稳定可靠的数据包传递协议,意味着数据在传递的过程中不会被丢失。这样确保了在发送和接收之间能够可靠的传递。相反,UDP仅仅是一个链接协议,所以它没有可靠性之说 从上面可以得出:TCP是被用在稳定可靠的场景中使用的;UDP通常用在快速数据传递和不怕数据丢失的场景中,还有ActiveMQ通过防火墙时,只能用UDP UDP连接的URI形式:udp://hostname:port?key=value Transport Connector配置示例: <transportConnectors><transportConnectorname="udp"uri="udp://localhost:61618?trace=true"/></transportConnectors> Active MQ的安全机制 「web控制台安全」修改jetty-realm.properties# username: password [,rolename ...](用户名:密码 角色)注意:配置需重启ActiveMQ才会生效 「消息安全机制」修改activemq.xml 在中添加如下代码: <plugins><simpleAuthenticationPlugin><users><authenticationUserusername="admin"password="admin"groups="admins,publishers,consumers"/><authenticationUserusername="publisher"password="publisher"groups="publishers,consumers"/><authenticationUserusername="consumer"password="consumer"groups="consumers"/><authenticationUserusername="guest"password="guest"groups="guests"/></users></simpleAuthenticationPlugin></plugins> ActiveMQ 使用 在java中使用ActiveMQ只需要引入相关依赖 <dependency><groupId>org.apache.activemq</groupId><artifactId>activemq-all</artifactId><version>5.15.11</version></dependency> 编写生产者 publicclassSender{publicstaticvoidmain(String[]args)throwsJMSException{//1.建立工厂对象,ActiveMQConnectionFactoryacf=newActiveMQConnectionFactory(ActiveMQConnectionFactory.DEFAULT_USER,ActiveMQConnectionFactory.DEFAULT_PASSWORD,"tcp://localhost:61618");//2从工厂里拿一个连接Connectionconnection=acf.createConnection();connection.start();//3从连接中获取Session(会话)Sessionsession=connection.createSession(false,Session.AUTO_ACKNOWLEDGE);//4从会话中获取目的地(Destination)消费者会从这个目的地取消息Queuequeue=session.createQueue("mq.test");//5从会话中创建消息提供者MessageProducerproducer=session.createProducer(queue);//6从会话中创建文本消息(也可以创建其它类型的消息体)TextMessagemessage=session.createTextMessage("msg:helloworld");//7通过消息提供者发送消息到ActiveMQproducer.send(message);//8关闭连接connection.close();}} 编写消费者 publicclassReceiver{publicstaticvoidmain(String[]args)throwsJMSException{//1.建立工厂对象,ActiveMQConnectionFactoryacf=newActiveMQConnectionFactory(ActiveMQConnectionFactory.DEFAULT_USER,ActiveMQConnectionFactory.DEFAULT_PASSWORD,"tcp://localhost:61618");//2从工厂里拿一个连接Connectionconnection=acf.createConnection();connection.start();//3从连接中获取Session(会话)Sessionsession=connection.createSession(false,Session.AUTO_ACKNOWLEDGE);//4从会话中获取目的地(Destination)消费者会从这个目的地取消息Queuequeue=session.createQueue("mq.test");//5从会话中创建消息消费者MessageConsumerconsumer=session.createConsumer(queue);while(true){//6消费者接收消息Messagemsg=consumer.receive();TextMessagetextMessage=(TextMessage)msg;System.out.println("text:"+textMessage.getText());}}} 常用API及特性 事务消息 Session session = connection.createSession(true, Session.AUTO_ACKNOWLEDGE);提交事务:session.commit(); 回滚事务:session.rollback(); 开启事务后,只有事务commit成功,消息才会发送到MQ中 持久化 默认持久化是开启的; 开启非持久化示例代码: producer.setDeliveryMode(DeliveryMode.NON_PERSISTENT) 设置消息优先级 producer.setPriority(); 设置消息超时/过期时间 producer.setTimeToLive 设置了消息超时的消息,消费端在超时后无法在消费到此消息。 死信 此类消息会进入到ActiveMQ.DLQ队列且不会自动清除,称为死信,有消息堆积的风险。 签收模式 签收代表接收端的session已收到消息的一次确认,反馈给broker 如果session带有事务,并且事务成功提交,则消息被自动签收。如果事务回滚,则消息会被再次传送。 消息事务是在生产者producer到broker或broker到consumer过程中同一个session中发生的,保证几条消息在发送过程中的原子性。在支持事务的session中,producer发送message时在message中带有transactionID。broker收到message后判断是否有transactionID,如果有就把message保存在transaction store中,等待commit或者rollback消息。 ActiveMQ支持自动签收与手动签收 「Session.AUTO_ACKNOWLEDGE」 当客户端从receiver或onMessage成功返回时,Session自动签收客户端的这条消息的收条。 「Session.CLIENT_ACKNOWLEDGE」 客户端通过调用消息(Message)的acknowledge方法签收消息。在这种情况下,签收发生在Session层面:签收一个已经消费的消息会自动地签收这个Session所有已消费的收条。 「Session.DUPS_OK_ACKNOWLEDGE」 Session不必确保对传送消息的签收,这个模式可能会引起消息的重复,但是降低了Session的开销,所以只有客户端能容忍重复的消息,才可使用。 独占消费者 Queue queue = session.createQueue("xxoo?consumer.exclusive=true"); 发送异步消息 ActiveMQConnectionFactoryconnectionFactory=newActiveMQConnectionFactory("admin","admin","tcp://localhost:61616");//2.获取一个向ActiveMQ的连接connectionFactory.setUseAsyncSend(true);ActiveMQConnectionconnection=(ActiveMQConnection)connectionFactory.createConnection();connection.setUseAsyncSend(true); 消息堆积 producer每发送一个消息,统计一下发送的字节数,当字节数达到ProducerWindowSize值时,需要等待broker的确认,才能继续发送。 brokerUrl中设置: tcp://localhost:61616?jms.producerWindowSize=1048576 destinationUri中设置: myQueue?producer.windowSize=1048576 延迟消息投递 首先在配置文件中开启延迟和调度 <brokerxmlns="http://activemq.apache.org/schema/core"brokerName="localhost"dataDirectory="${activemq.data}"schedulerSupport="true"> 延迟发送示例代码:message.setLongProperty(ScheduledMessage.AMQ_SCHEDULED_DELAY,10*1000); 创建监听器 ActiveMQConnectionFactoryacf=newActiveMQConnectionFactory(ActiveMQConnectionFactory.DEFAULT_USER,ActiveMQConnectionFactory.DEFAULT_PASSWORD,"tcp://localhost:61618");//2从工厂里拿一个连接Connectionconnection=acf.createConnection();connection.start();//3从连接中获取Session(会话)Sessionsession=connection.createSession(false,Session.AUTO_ACKNOWLEDGE);//4从会话中获取目的地(Destination)消费者会从这个目的地取消息Queuequeue=session.createQueue("mq.test");//5从会话中创建消息消费者MessageConsumerconsumer=session.createConsumer(queue);MyListenermyListener=newMyListener();MessageListenerlistener=myListener::receiveMessage;consumer.setMessageListener(listener); SpringBoot整合ActiveMQ 添加依赖 <dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-activemq</artifactId></dependency> 配置文件 server:port:80spring:activemq:broker-url:tcp://localhost:61618user:adminpassword:adminpool:enabled:true#连接池最大连接数max-connections:5#空闲的连接过期时间,默认为30秒idle-timeout:0packages:trust-all:truejms:pub-sub-domain:true 配置类 @Configuration@EnableJmspublicclassActiveMqConfig{//topic模式的ListenerContainer@BeanpublicJmsListenerContainerFactory<?>jmsListenerContainerTopic(ConnectionFactoryactiveMQConnectionFactory){DefaultJmsListenerContainerFactorybean=newDefaultJmsListenerContainerFactory();bean.setPubSubDomain(true);bean.setConnectionFactory(activeMQConnectionFactory);returnbean;}//queue模式的ListenerContainer@BeanpublicJmsListenerContainerFactory<?>jmsListenerContainerQueue(ConnectionFactoryactiveMQConnectionFactory){DefaultJmsListenerContainerFactorybean=newDefaultJmsListenerContainerFactory();bean.setConnectionFactory(activeMQConnectionFactory);returnbean;}} 编写生产者 @ServicepublicclassMqProducerService{@AutowiredprivateJmsMessagingTemplatejmsMessagingTemplate;publicvoidsendStringQueue(Stringdestination,Stringmsg){System.out.println("send...");ActiveMQQueuequeue=newActiveMQQueue(destination);jmsMessagingTemplate.afterPropertiesSet();ConnectionFactoryfactory=jmsMessagingTemplate.getConnectionFactory();try{Connectionconnection=factory.createConnection();connection.start();Sessionsession=connection.createSession(true,Session.AUTO_ACKNOWLEDGE);Queuequeue2=session.createQueue(destination);MessageProducerproducer=session.createProducer(queue2);TextMessagemessage=session.createTextMessage("hahaha");producer.send(message);}catch(JMSExceptione){//TODOAuto-generatedcatchblocke.printStackTrace();}jmsMessagingTemplate.convertAndSend(queue,msg);}publicvoidsendStringQueueList(Stringdestination,Stringmsg){System.out.println("xxooq");ArrayList<String>list=newArrayList<>();list.add("1");list.add("2");jmsMessagingTemplate.convertAndSend(newActiveMQQueue(destination),list);}} 编写消费者 @JmsListener(destination="user",containerFactory="jmsListenerContainerQueue")publicvoidreceiveStringQueue(Stringmsg){System.out.println("接收到消息...."+msg);}@JmsListener(destination="ooo",containerFactory="jmsListenerContainerTopic")publicvoidreceiveStringTopic(Stringmsg){System.out.println("接收到消息...."+msg);} 小结 本文详细介绍了为什么需要引入消息队列,JMS、ActiveMQ的基础概念以及常用API,与原生JAVA整合及SpringBoot整合等知识点,可以让大家更好的了解ActiveMQ的使用场景及使用方式。 如果本文对你有帮助, 别忘记给我个三连: 点赞,转发,评论 。 咱们下期见! 收藏等于白嫖,点赞才是真情! End 干货分享 这里为大家准备了一份小小的礼物,关注公众号,输入如下代码,即可获得百度网盘地址,无套路领取!001:《程序员必读书籍》002:《从无到有搭建中小型互联网公司后台服务架构与运维架构》003:《互联网企业高并发解决方案》004:《互联网架构教学视频》006:《SpringBoot实现点餐系统》007:《SpringSecurity实战视频》008:《Hadoop实战教学视频》 010:微信交流群 近期热文top 1、关于JWT Token 自动续期的解决方案 2、还不了解ETL,看看这篇文章? 3、为什么微服务需要api网关 4、架构师之路-微服务技术选型 5、RocketMQ进阶-事务消息 我就知道你“在看” 本文分享自微信公众号 - JAVA日知录(javadaily)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | JVM 的入门知识

前言:巴拉巴拉,今天给大家分享一点java三剑客(jre,jvm,jdk)中的jvm,纯理论教科书篇。 非原创,里面摘取了多个博客里面的内容 1JDK、 JRE、JVM 的关系是什么? 我们学习JVM的之前,简单科普一下他们三者有啥关系 JVM JAVA 虚拟机(Java Virtual Machine)。它只识别 .class 类型文件,它能够将 class 文件中的字节码指令进行识别并调用操作系统向上的 API 完成动作 JRE Java 运行时环境(Java Runtime Environment)。它主要包含两个部分:JVM 的标准实现和 Java 的一些基本类库。相对于JVM 来说,JRE多出了一部分 Java 类库 JDK Java 开发工具包(Java Development Kit)。JDK 是整个 Java 开发的核心,它集成了 JRE 和一些好用的小工具 常用工具 jar.exe jar文件管理工具,打包压缩解压jar文件 java.exe java运行工具,运行.class字节码文件或 .jar文件 javac.exe java编译工具,用来编译.java源代码文件 javap.exe java反编译工具,根据java字节码文件反汇编成java源代码文件 jvisualvm.exe jvm监控,分析工具 这三者的关系:JDK > JRE > JVM 由于Oracle jdk 从jdk 8u211以后商业用途需要收费,提供一下免费JDK 阿里dragonwell8 https://github.com/alibaba/dragonwell8/releases 亚马逊Corretto https://docs.aws.amazon.com/corretto/latest/corretto-8-ug/downloads-list.html adoptopenjdk https://adoptopenjdk.net openjdk http://openjdk.java.net/install 2 JVM的核心 JVM(Java Virtual Machine)是用来运行Java字节码的虚拟机,包括字节码指令集、程序寄存器、栈、堆、方法区和垃圾回收器。 JVM运行在操作系统之上,不与硬件设备直接交互。 Java源文件在通过编译器之后被编译成相应的.Class文件(字节码文件),.Class文件又被JVM中的解释器编译成机器码在不同的操作系统(Windows、Linux、Mac)上运行。 每种操作系统的解释器都是不同的,但基于解释器实现的虚拟机是相同的,这也是Java能够跨平台的原因。 在一个Java进程开始运行后,虚拟机就开始实例化了,有多个进程启动就会实例化多个虚拟机实例。进程退出或者关闭,则虚拟机实例消亡,在多个虚拟机实例之间不能共享数据。 Java程序的具体运行过程如下。 (1)Java源文件被编译器编译成字节码文件。 (2)JVM将字节码文件编译成相应操作系统的机器码。 (3)机器码调用相应操作系统的本地方法库执行相应的方法。 Java虚拟机包括一个类加载器子系统(Class Loader SubSystem)、运行时数据区(Runtime Data Area)、执行引擎和本地接口库(Native InterfaceLibrary)。 本地接口库通过调用本地方法库(Native Method Library)与操作系统交互。 JVM核心图 ◎ 类加载器子系统用于将编译好的.Class文件加载到JVM中; ◎ 运行时数据区用于存储在JVM运行过程中产生的数据,包括程序计数器、方法区、本地方法区、虚拟机栈和虚拟机堆; ◎ 执行引擎包括即时编译器和垃圾回收器,即时编译器用于将Java字节码编译成具体的机器码,垃圾回收器用于回收在运行过程中不再使用的对象; ◎ 本地接口库用于调用操作系统的本地方法库完成具体的指令操作。 3 JVM的内存区域 JVM的内存区域分为线程私有区域(程序计数器、栈、本地方法区)、线程共享区域(堆、方法区)和直接内存。 3.1 线程私有区域 生命周期与线程相同,随线程的启动而创建,随线程的结束而销毁。在JVM内,每个线程都与操作系统的本地线程直接映射,因此这部分内存区域的存在与否和本地线程的启动和销毁对应。 3.1.1程序计数器 程序计数器是一块很小的内存空间,用于存储当前运行的线程所执行的字节码的行号指示器。每个运行中的线程都有一个独立的程序计数器,在方法正在执行时,该方法的程序计数器记录的是实时虚拟机字节码指令的地址;如果该方法执行的是Native方法,则程序计数器的值为空(Undefined)。程序计数器属于“线程私有”的内存区域,它是唯一没有Out Of Memory(内存溢出)的区域。 3.1.2虚拟机栈 虚拟机栈是描述Java方法的执行过程的内存模型,它在当前栈帧(Stack Frame)中存储了局部变量表、操作数栈、动态链接、方法出口等信息。同时,栈帧用来存储部分运行时数据及其数据结构,处理动态链接(Dynamic Linking)方法的返回值和异常分派(Dispatch Exception)。栈帧用来记录方法的执行过程,在方法被执行时虚拟机会为其创建一个与之对应的栈帧,方法的执行和返回对应栈帧在虚拟机栈中的入栈和出栈。无论方法是正常运行完成还是异常完成(抛出了在方法内未被捕获的异常),都视为方法运行结束。 上图展示了线程运行图。 线程1在CPU1上运行,线程2在CPU2上运行,在CPU资源不够时其他线程将处于等待状态,等待获取CPU时间片。 而在线程内部,每个方法的执行和返回都对应一个栈帧的入栈和出栈,每个运行中的线程当前只有一个栈帧处于活动状态。 jvm参数: -Xss128k:每个线程栈的大小,合理的减少可以使剩余的系统内存支持更多的线程。 3.1.3 本地方法区 本地方法区和虚拟机栈的作用类似,区别是虚拟机栈为执行Java方法服务,本地方法栈为Native方法服务。 3.2线程共享区域 随虚拟机的启动而创建,随虚拟机的关闭而销毁。 3.2.1 堆 也叫作运行时数据区,在JVM运行过程中创建的对象和产生的数据都被存储在堆中,堆是被线程共享的内存区域,也是垃圾收集器进行垃圾回收的最主要的内存区域。由于现代JVM采用分代收集算法,因此Java堆从GC(Garbage Collection,垃圾回收)的角度还可以细分为:新生代、老年代和永久代。 jvm参数: -Xms4G : JVM启动时整个堆(包括年轻代,年老代)的初始化大小 (一般将和最大保持一致,可以避免堆内存频繁震荡,导致系统性能下降,jvm会尽可能维持在最小空间运行,这样很有可能发生频繁GC)。 -Xmx4G : JVM启动时整个堆的最大值。 -Xmn2G:年轻代的空间大小,剩下的是年老代的空间。 3.2.2 方法区 方法区也被称为永久代,用于存储常量、静态变量、类信息、即时编译器编译后的机器码、运行时常量池等数据 JVM把GC分代收集扩展到了方法区,这样JVM的垃圾收集器就可以像管理Java堆一样管理这部分内存。 永久代的内存回收主要针对常量池的回收和类的卸载,可回收的对象很少。 3.3 直接内存 也叫堆外内存,就是把内存对象分配在Java虚拟机的堆以外的内存 ,它并不是JVM运行时数据区的一部分,直接受操作系统管理(而不是虚拟机),这样做的结果就是能够在一定程度上减少垃圾回收对应用程序造成的影响。 JDK的NIO模块提供的基于Channel与Buffer的I/O操作方式就是基于堆外内存实现的,NIO模块通过调用Native函数库直接在操作系统上分配堆外内存,然后使用java.nio.DirectByteBuffer对象作为这块内存的引用 对内存进行操作。 这样可以加快复制速度,因为堆内数据刷新到远程时,会先复制到直接内存,然后再发送,可以减少堆内存和直接内存的来回复制影响性能,因此堆外内存在高并发应用场景下被广泛使用( Ehcache,Netty、Flink、HBase、Hadoop都有用到堆外内存)。 4 JVM的运行时内存(堆) JVM的运行时内存也叫作JVM堆,从GC的角度可以将JVM堆分为新生代、老年代和永久代。其中新生代默认占1/3堆空间,老年代默认占2/3堆空间,永久代占非常少的堆空间。新生代又分为Eden区、ServivorFrom区和ServivorTo区,Eden区默认占8/10新生代空间,ServivorFrom区和ServivorTo区默认分别占1/10新生代空间。 4.1 新生代 JVM新创建的对象(除了大对象外)会被存放在新生代,默认占1/3堆内存空间。由于JVM会频繁创建对象,所以新生代会频繁触发MinorGC进行垃圾回收。 新生代又分为Eden区、ServivorTo区和ServivorFrom区 ◎Eden区:Java新创建的对象首先会被存放在Eden区,如果新创建的对象属于大对象,则直接将其分配到老年代。大对象的定义和具体的JVM版本、堆大小和垃圾回收策略有关,一般为2KB~128KB,可通过XX:PretenureSizeThreshold设置其大小。在Eden区的内存空间不足时会触发GC。 ◎ServivorTo区:保留上一次GC时的幸存者。 ◎ServivorFrom区: 上一次GC的幸存者,作为这一次GC的被扫描者。 新生代的GC过程叫作MinorGC,采用复制算法实现,具体过程如下。 (1)Eden区内存空间不足会触发GC (2)扫描Eden区和ServivorFrom区进行GC回收 (3)将存活的对象复制到ServivorTo区(如果某对象的年龄达到老年代的标准(对象晋升老年代的标准由XX:MaxTenuringThreshold设置,默认为15),则将其复制到老年代。如果ServivorTo区的内存空间不够,则也直接将其复制到老年代;如果对象属于大对象(大小为2KB~128KB的对象属于大对象,例如通过XX:PretenureSizeThreshold=2097152设置大对象为2MB,1024×1024×2),则也直接将其复制到老年代) (4)将现有ServivorTo区的存活的对象年龄加1 (5)清空Eden区和ServivorFrom区中的对象 (6)将ServivorTo区和ServivorFrom区互换(原来的ServivorTo区成为下一次GC时的ServivorFrom区) 4.2 老年代 老年代主要存放有长生命周期的对象和大对象。老年代的GC过程叫作MajorGC。在老年代,对象比较稳定,MajorGC不会被频繁触发。在进行MajorGC前,JVM会进行一次MinorGC,在MinorGC过后仍然出现老年代空间不足或无法找到足够大的连续空间分配给新创建的大对象时,会触发MajorGC进行垃圾回收,释放JVM的内存空间。MajorGC采用标记清除算法,该算法首先会扫描所有对象并标记存活的对象,然后回收未被标记的对象,并释放内存空间。因为要先扫描老年代的所有对象再回收,所以MajorGC的耗时较长。MajorGC的标记清除算法容易产生内存碎片。在老年代没有内存空间可分配时,会抛出Out Of Memory异常。 报错误的原因是因为执行垃圾收集的时间比例太大, 有效的运算量太小。默认情况下, 如果GC花费的时间超过 98%, 并且GC回收的内存少于 2%, JVM就会抛出这个错误。 4.3 永久代 永久代指内存的永久保存区域,主要存放Class和Meta(元数据)的信息。Class在类加载时被放入永久代。永久代和老年代、新生代不同,GC不会在程序运行期间对永久代的内存进行清理,这也导致了永久代的内存会随着加载的Class文件的增加而增加,在加载的Class文件过多时会抛出Out OfMemory异常,比如Tomcat引用Jar文件过多导致JVM内存不足而无法启动。需要注意的是,在Java 8中永久代已经被元数据区(也叫作元空间)取代。元数据区的作用和永久代类似,二者最大的区别在于:元数据区并没有使用虚拟机的内存,而是直接使用操作系统的本地内存。因此,元空间的大小不受JVM内存的限制,只和操作系统的内存有关。在Java 8中,JVM将类的元数据放入本地内存(Native Memory)中,将常量池和类的静态变量放入Java堆中,这样JVM能够加载多少元数据信息就不再由JVM的最大可用内存(MaxPermSize)空间决定,而由操作系统的实际可用内存空间决定。 5.垃圾回收与算法 5.1 如何确定是垃圾? Java采用引用计数法和可达性分析来确定对象是否应该被回收,其中,引用计数法容易产生循环引用的问题,可达性分析通过根搜索算法(GC RootsTracing)来实现。根搜索算法以一系列GC Roots的点作为起点向下搜索,在一个对象到任何GCRoots都没有引用链相连时,说明其已经死亡。根搜索算法主要针对栈中的引用、方法区中的静态引用和JNI中的引用展开分析,如图1-6所示。 5.1.1 引用计数法 在Java中如果要操作对象,就必须先获取该对象的引用,因此可以通过引用计数法来判断一个对象是否可以被回收。在为对象添加一个引用时,引用计数加1;在为对象删除一个引用时,引进计数减1;如果一个对象的引用计数为0,则表示此刻该对象没有被引用,可以被回收。引用计数法容易产生循环引用问题。循环引用指两个对象相互引用,导致它们的引用一直存在,而不能被回收。 Object1与Object2互为引用,如果采用引用计数法,则Object1和Object2由于互为引用,其引用计数一直为1,因而无法被回收。 5.1.2 可达性分析 为了解决引用计数法的循环引用问题,Java还采用了可达性分析来判断对象是否可以被回收。具体做法是首先定义一些GC Roots对象,然后以这些GCRoots对象作为起点向下搜索,如果在GC roots和一个对象之间没有可达路径,则称该对象是不可达的。不可达对象要经过至少两次标记才能判定其是否可以被回收,如果在两次标记后该对象仍然是不可达的,则将被垃圾收集器回收。 5.2 常用的垃圾回收算法 Java中常用的垃圾回收算法有标记清除(Mark-Sweep)、复制(Copying)、标记整理(Mark-Compact)和分代收集(GenerationalCollecting)这4种垃圾回收算法。 5.2.1标记清除算法、 标记清除算法是基础的垃圾回收算法,其过程分为标记和清除两个阶段。在标记阶段标记所有需要回收的对象,在清除阶段清除可回收的对象并释放其所占用的内存空间 由于标记清除算法在清理对象所占用的内存空间后并没有重新整理可用的内存空间,因此如果内存中可被回收的小对象居多,则会引起内存碎片化的问题,继而引起大对象无法获得连续可用空间的问题。 5.2.2 复制算法 复制算法是为了解决标记清除算法内存碎片化的问题而设计的。复制算法首先将内存划分为两块大小相等的内存区域,即区域1和区域2,新生成的对象都被存放在区域1中,在区域1内的对象存储满后会对区域1进行一次标记,并将标记后仍然存活的对象全部复制到区域2中,这时区域1将不存在任何存活的对象,直接清理整个区域1的内存即可。 复制算法的内存清理效率高且易于实现,但由于同一时刻只有一个内存区域可用,即可用的内存空间被压缩到原来的一半,因此存在大量的内存浪费。同时,在系统中有大量长时间存活的对象时,这些对象将在内存区域1和内存区域2之间来回复制而影响系统的运行效率。因此,该算法只在对象为“朝生夕死”状态时运行效率较高。 5.2.3标记整理算法 标记整理算法结合了标记清除算法和复制算法的优点,其标记阶段和标记清除算法的标记阶段相同,在标记完成后将存活的对象移到内存的另一端,然后清除该端的对象并释放内存。 5.2.4分代收集算法 无论是标记清除算法、复制算法还是标记整理算法,都无法对所有类型(长生命周期、短生命周期、大对象、小对象)的对象都进行垃圾回收。因此,针对不同的对象类型,JVM采用了不同的垃圾回收算法,该算法被称为分代收集算法。分代收集算法根据对象的不同类型将内存划分为不同的区域,JVM将堆划分为新生代和老年代。新生代主要存放新生成的对象,其特点是对象数量多但是生命周期短,在每次进行垃圾回收时都有大量的对象被回收;老年代主要存放大对象和生命周期长的对象,因此可回收的对象相对较少。因此,JVM根据不同的区域对象的特点选择了不同的算法。目前,大部分JVM在新生代都采用了复制算法,因为在新生代中每次进行垃圾回收时都有大量的对象被回收,需要复制的对象(存活的对象)较少,不存在大量的对象在内存中被来回复制的问题,因此采用复制算法能安全、高效地回收新生代大量的短生命周期的对象并释放内存。JVM将新生代进一步划分为一块较大的Eden区和两块较小的Servivor区,Servivor区又分为ServivorFrom区和ServivorTo区。JVM在运行过程中主要使用Eden区和ServivorFrom区,进行垃圾回收时会将在Eden区和ServivorFrom区中存活的对象复制到ServivorTo区,然后清理Eden区和ServivorFrom区的内存空间。 老年代主要存放生命周期较长的对象和大对象,因而每次只有少量非存活的对象被回收,因而在老年代采用标记清除算法。在JVM中还有一个区域,即方法区的永久代,永久代用来存储Class类、常量、方法描述等。在永久代主要回收废弃的常量和无用的类。JVM内存中的对象主要被分配到新生代的Eden区和ServivorFrom区,在少数情况下会被直接分配到老年代。在新生代的Eden区和ServivorFrom区的内存空间不足时会触发一次GC,该过程被称为MinorGC。在MinorGC后,在Eden区和ServivorFrom区中存活的对象会被复制到ServivorTo区,然后Eden区和ServivorFrom区被清理。如果此时在ServivorTo区无法找到连续的内存空间存储某个对象,则将这个对象直接存储到老年代。若Servivor区的对象经过一次GC后仍然存活,则其年龄加1。在默认情况下,对象在年龄达到15时,将被移到老年代。 5.2.5分区收集算法 分区算法将整个堆空间划分为连续的大小不同的小区域,对每个小区域都单独进行内存使用和垃圾回收,这样做的好处是可以根据每个小区域内存的大小灵活使用和释放内存。分区收集算法可以根据系统可接受的停顿时间,每次都快速回收若干个小区域的内存,以缩短垃圾回收时系统停顿的时间,最后以多次并行累加的方式逐步完成整个内存区域的垃圾回收。如果垃圾回收机制一次回收整个堆内存,则需要更长的系统停顿时间,长时间的系统停顿将影响系统运行的稳定性。 5.3 java中垃圾收集器 Java堆内存分为新生代和老年代:新生代主要存储短生命周期的对象,适合使用复制算法进行垃圾回收;老年代主要存储长生命周期的对象,适合使用标记整理算法进行垃圾回收。因此,JVM针对新生代和老年代分别提供了多种不同的垃圾收集器,针对新生代提供的垃圾收集器有Serial、ParNew、Parallel Scavenge,针对老年代提供的垃圾收集器有Serial Old、Parallel Old、CMS,还有针对不同区域的G1,ZGC分区收集算法。 1. Serial (新生代单线程复制算法) 针对新生代的垃圾回收器,它是单线程执行的,是一款串行的垃圾回收器,采用的是复制算法。它的单线程并不仅仅指它在进行垃圾回收时是单线程或者单处理器执行,更深的含义是它在垃圾回收时,需要暂停其他所有的线程,造成 STW。 当 JVM 处于客户端模式下时,Serial 是默认的垃圾回收器,它的优点是简单高效。在内存资源受限的环境下,Serial 垃圾回收器相比其他垃圾回收器,它所占用的内存更小。对于单处理器的场景,Serial 处理器由于是单线程的,它省去了线程之间的资源竞争,因此会更加高效。 当使用参数 「-XX:+UseSerialGC」时,在开启使用Serial垃圾回收器同时,老年代的垃圾回收器为Serial Old。 2.Serial Old(老年代单线程标记整理算法) 和 Serial 一样,Serial Old 也是单线程执行的,是一款串行的垃圾回收器,不同的是 Serail Old 回收的是老年代区域,采用的算法是标记-压缩(整理)算法。在进行垃圾回收时,同样也会造成 STW 的现象。 3.ParNew(新生代多线程复制算法) 针对新生代区域的垃圾回收器,它是 Serial 垃圾收集器的多线程版本,即它是一款并行的垃圾回收器,支持多个垃圾回收线程同时并行回收垃圾,使用的也是复制算法。ParNew 的大部分参数配置和 Serial 收集器一样,但额外多了部分参数,如:可以通过参数 「-XX:ParallelGCThreads」 来指定并行的垃圾回收的线程个数,默认情况下,垃圾回收线程的个数与处理器的个数相等。在单处理器的系统中,ParNew 的性能并不一定比 Serial 好,因为线程的切换需要额外耗费 CPU 资源。 可以使用参数 「-XX:+UseParNewGC」 来开启使用 ParNew 进行垃圾回收。 ParNew 可以和 Serial Old 或者 CMS 搭配使用,然而从 JDK9 开始,官方已经移除了 ParNew 和 Serial Old 的组合使用方式,同时 JDK9 中将 CMS 标记为 Deprecated 状态,在 JDK14 中彻底移除 CMS,这就导致了 ParNew 将处于一个十分尴尬的地位,在高版本中既不能和 Serial Old 搭配使用,也将在未来无法和 CMS 搭配使用,这就导致了 ParNew 这款垃圾回收器必然消失在历史的舞台。 4.Parallel Scavenge (新生代多线程复制算法) 针对新生代的并行的垃圾回收器,它和 ParNew 虽然都是并行、针对新生代,但是它们的区别很大,Parallel Scavenge 是一款「吞吐量优先」的垃圾回收器。适用于那些期望尽可能的利用 CPU 资源、尽快完成程序的运算任务以及不太注重用户交互行为的场景。 Parallel Scavenge 提供了两个参数来精准地控制吞吐量,分别是 「MaxGCPauseMillis」 和 「GCTimeRatio」。 MaxGCPauseMillis 表示的是每次进行 GC 时,系统的最大停顿时间,如果配置了该参数,那么 JVM 在每次进行垃圾回收时,它会尽可能的将停顿时间控制在 MaxGCPauseMillis 之内。该参数并不是配置的越小越好,如果配置得很小,那么 JVM 可能会为了达到停顿时间控制在 MaxGCPauseMillis 之内的目的,选择以减小新生代区域的大小为代价,毕竟每次回收 300M 的空间所花的时间肯定比 500M 的短。「而 JVM 将新生代的内存区域调小后,带来的后果就是垃圾回收进行得更加频繁了,最后会导致系统的吞吐量下降」。通常情况下,我们无法精准地把控每次垃圾回收需要停顿的时间,所以该参数需要慎用,一不小心,配置的不合理,可能适得其反。 GCTimeRatio 表示的是每次 GC 的时间占用的比率是多少(具体计算方是:GCTimeRatio = 用户线程运行时间/ GC 线程运行时间),例如:如果 GCTimeRatio 参数的值配置的 19,那么 GC 运行的时间占总时间的 5%(1/(1+19))。JVM 通过这个参数来达到控制系统吞吐量的目的。 另外 JVM 还提供了一个参数,叫做「UseAdpativeSizePolicy」,它表示的是让 JVM「根据系统的运行情况来动态调整」新生代(Eden、S0、S1)、老年代的大小,我们只需要设置好最基本的内存参数以及 MaxGCPauseMillis(最大停顿时间)或者 GCTimeRatio(目标吞吐量)即可,不需要设置-XX:Xmn(新生代的内存大小)、-XX:SurvivorRatio (Surivivior区域的比例)等参数了,JVM 会根据系统运行时监控到相关信息,来动态进行调整。Parallel Scavenge 支持动态调整策略,这也算是它和 ParNew 收集器的另一大不同之处了。 5.Parallel Old (老年代多线程标记整理算法) 收集器的老年代版本,也是支持多线程的并行执行,它底层是基于标记-压缩(整理)算法来实现的。在 JDK6 中才开始提供,在 Parallel Old 出现之前,Parallel Scavenge 收集器只能配合着 Serial Old 使用,无法与 CMS 垃圾回收器配合使用,这是因为 Parallel Scavenge 与 CMS、Serial、ParNew 这些收集器的底层框架不一样,无法兼容导致的。而 Serial Old 又是单线程的垃圾收集器,在多处理器的场景下,性能不高,白白浪费了 Parallel Scavenge 并行的优点,好车配劣马,所以在 Parallel Old 出现之前,Parallel Scavenge 一直处于比较鸡肋的地位。目前,Parallel Scavenge 和 Parallel Old 的组合,其垃圾回收效果不错,是 JDK8 中默认的垃圾回收组合方式。 6.CMS(老年代多线程标记清除算法) CMS 的全称是 Concurrent-Mark-Sweep 的缩写,翻译过来就是并发标记清除,它是一款「以低停顿时间为目标」的垃圾回收器,特点是低延时。 CMS 的工作原理大致分为四个步骤:初始标记、并发标记、重新标记、并发清除。 使用参数:「-XX:+UseConcMarkSweepGC」 即可开启使用 CMS 垃圾回收器。 「初始标记」指的是仅仅只标记出和 GC Roots 直接关联的对象,这个过程需要暂停所有的用户线程,因此会产生 STW。由于这一步仅仅标记和 GC Roots 直接关联的对象,因此这一步耗费的时间会很短,造成的停顿时间会很短。 「并发标记」。这一步是从和 GC Roots 直接关联的对象出发,开始遍历整个对象图引用链,这个过程是 GC 线程和用户线程并发执行的,因此不会造成 STW。这一步因为需要遍历所有对象的引用链,所以耗费时间较长,由于不会造成 STW,即使耗时较长,也没有关系。 「重新标记」。在并发标记阶段,用户线程仍然在运行,因此会改变对象之间的引用关系,那么在重新标记阶段,就是对并发标记的结果进行修正。把那些怀疑是垃圾,而实际不是垃圾的对象重新标记为存活对象。这一步需要暂停所有的用户线程,因此会造成 STW 的现象,这一步的耗时会比初始标记阶段长一些,但是远小于并发标记阶段的耗时。 「并发清除」。这一阶段是垃圾回收线程和用户线程一起并发执行,垃圾回收线程进行垃圾对象的清除,这一步耗时较长,但不会造成 STW。 整体上来看,CMS 垃圾回收器只有在初始标记阶段和重新标记阶段会造成用户线程的停顿,但是这两步都耗时较短,因此整体上,CMS 进行垃圾回收时,是低延时的。 7.G1(新生代和老年代多线程分区标记整理算法) G1是一个并行回收器,它把堆内存分割为很多不相关的区域(Region)(物理上不连续的)。使用不同的 Region来表示Eden、S0区,S1区,Old区等。 独立使用这些区域的内存资源并且跟踪这些区域的垃圾收集进度,同时在后台维护一个优先级列表,在垃圾回收过程中根据系统允许的最长垃圾收集时间,优先回收垃圾最多的区域。 在JDK1.7正式启用,是JDK9以后默认的垃圾回收器,被Oracle官方称为“全功能的垃圾收集器” 优点: 1. 并行与并发 并行性:G1在回收期间,可以有多个GC线程同时工作(不再是一个GC线程),有效利用多核计算能力,此时用户线程处于STW 并发性:G1拥有与应用程序交替执行的能力,部分工作可以和应用程序同时执行,因此,一般来说,不会在整个回收阶段发生完全阻塞应用程序的情况 2. 分区收集,支持新老代 同时兼顾年轻代和老年代。将堆空间分为若干个小区域(Region),这些区域中包含了逻辑上的年轻代和老年代。 3.可预测的停顿时间模型 回收时间可预测性,每次根据允许的时间优先回收价值最大的Region,尽可能提高收集效率 配置参数 -XX:+UseG1GC:手动指定使用G1收集器执行内存回收任务。 -XX:G1HeapRegionSize:设置每个Region的大小,大小区间只能是1M、2M、4M、8M、16M和32M , 如果G1HeapRegionSize为默认值,则在堆初始化时计算Region的实践大小 。 -XX:MaxGCPauseMillis:设置期望达到的最大GC停顿时间指标(JVM会尽力实现,但不保证达到),默认值是200ms -XX:ParallelGCThread:设置STW工作线程数的值,最多设置为8 -XX:ConcGCThreads:设置并发标记的线程数。 -XX:InitiatingHeapoccupancyPercent:设置触发并发GC周期的Java堆占用率阙值。超过此值,就触发GC。默认值是45。 文章:https://mp.weixin.qq.com/s/7CWbARimO5rFBHq4NtAt5Q 8.最前沿的低延时垃圾回收技术——ZGC,Shenandoah ZGC 全称为 Z Garbage Collector,一款在保证吞吐量的情况下,追求低延时的垃圾回收器。 ZGC 是目前垃圾回收器中最前沿的技术,可惜的是目前 ZGC 还没有被正式使用,一直处于实验状态(Experiment)。从 JDK11 开始,被加入到了 OpenJDK 中,到目前 2020 年 4 月份发布的最新 Oracle JDK14 中,ZGC 依旧处于实验状态。 可以通过添加 JVM 参数:-XX:+UnlockExperimentalVMOptions 进行解锁实验状态。 Shenandoah 的目标是将垃圾回收的停顿时间控制在 10ms 以内,这意味着 Shenandoah 不仅需要在并发标记阶段实现并发,还需要在标记清除阶段实现并发。 Shenandoah 垃圾回收器是 RedHat 公司发明的,非 Oracle 公司官方实现,不是 Oracle 的亲儿子,因此在一定程度上遭到了“排挤”,只在开源的 OpenJDK12 中开始出现,而在商业版的 Oracle JDK12 中则没有。 ZGC文章:https://mp.weixin.qq.com/s/FkG0iweym0q8gGDx2b8iMg Shenandoah文章:https://mp.weixin.qq.com/s/J9lOoihkfUKvJpt-7GSxXw 9.总结 随着JDK的不断更新,垃圾回收器的效率也越来越高,每一次JDK大版本的更新,必然会对垃圾回收器更新,截止到目前,JDK14可以使用的最新的垃圾回收器ZGC,在 JDK9 中,取消了 ParNew 与 Serial Old、Serial 与 CMS 的搭配组合,并且 CMS 被标记 Deprecated,在 JDK14 中被彻底移除。 评估GC性能的重要指标: 吞吐量:运行用户代码的时间占总运行时间的比例 暂停时间[STW]:执行GC线程时,用户线程被暂停的时间 内存占用:Java堆区所占的内存大小 吞吐量 吞吐量就是CPU运行用户代码的时间与CPU总消耗时间的比值,即: 吞吐量 = 运行用户代码时间 /(运行用户代码时间 + 垃圾收集时间) 吞吐量高是降低了内存回收的执行频率 比如:虚拟机总共运行了100分钟,其中垃圾收集花掉1分钟,那吞量就是99% 暂停时间 暂停时间是指一个时间段内应用程序线程暂停,让GC线程执行的状态,例如: GC期间100毫秒的暂停时间,意味着在这100毫秒期间内没有应用程序线程是活动的 暂停时间短,但是频繁的执行内存回收 这两个指标本质上是互斥的,我们只能在最大吞吐量优先的情况下,降低停顿时间。 想知道自己的GC算法,可以使用 java -XX:+PrintCommandLineFlags -version 查看 我的14默认的是G1 6 JVM的类加载机制 6.1 JVM的类加载阶段 JVM的类加载分为5个阶段:加载、验证、准备、解析、初始化。在类初始化完成后就可以使用该类的信息,在一个类不再被需要时可以从JVM中卸载。 1.加载 指JVM读取Class文件,并且根据Class文件描述创建java.lang.Class对象的过程。类加载过程主要包含将Class文件读取到运行时区域的方法区内,在堆中创建java.lang.Class对象,并封装类在方法区的数据结构的过程,在读取Class文件时既可以通过文件的形式读取,也可以通过jar包、war包读取,还可以通过代理自动生成Class或其他方式读取。 2.验证 主要用于确保Class文件符合当前虚拟机的要求,保障虚拟机自身的安全,只有通过验证的Class文件才能被JVM加载。 3.准备 主要工作是在方法区中为类的变量分配内存空间并设置不同数据类型的静态变量的默认值。 4.解析 JVM会将常量池中的符号引用替换为直接引用。 5.初始化 初始化阶段,执行类构造器<clinit>()方法的过程 <clinit>()方法是由编译器自动收集类中的所有类变量的赋值动作和静态语句块(static{}块)中的语句合并产生的。 JVM规定,只有在父类的<client>方法都执行成功后,子类中的<client>方法才可以被执行。 在一个类中既没有静态变量赋值操作也没有静态语句块时,编译器不会为该类生成<client>方法。 哪些情况会进行类的初始化?主动引用 1.创建类的实例 2.访问类的静态变量 3.访问类的静态方法 4.反射(Class.forName) 5.子类初始化会先对父类初始化 6.虚拟机启动时,定义了main()方法的会先初始化 哪些情况不会进行类初始化?被动引用 1. 子类调用父类的静态变量,子类不会被初始化。只有父类被初始化。对于静态字段,只有直接定义这个字段的类才会被初始化. 2. 通过数组定义来引用类,不会触发类的初始化 3. 访问类的常量,不会初始化类 对于类的初始化我们搞点小demo瞧瞧,上东西~~ 6.2 类加载器 JVM提供了3种类加载器,分别是启动类加载器、扩展类加载器和应用程序类加载器。 (1)启动类加载器:负责加载JAVA_HOME/lib目录中的类库,或通过-Xbootclasspath参数指定路径中被虚拟机认可的类库。 (2)扩展类加载器:负责加载JAVA_HOME/lib/ext目录中的类库,或通过java.ext.dirs系统变量加载指定路径中的类库。 (3)应用程序类加载器:负责加载用户路径(classpath)上的类库。 除了上述3种类加载器,我们也可以通过继承java.lang.ClassLoader实现自定义的类加载器。 6.3 双亲委派机制 JVM通过双亲委派机制对类进行加载。双亲委派机制指一个类在收到类加载请求后不会尝试自己加载这个类,而是把该类加载请求向上委派给其父类去完成,其父类在接收到该类加载请求后又会将其委派给自己的父类,以此类推,这样所有的类加载请求都被向上委派到启动类加载器中。若父类加载器在接收到类加载请求后发现自己也无法加载该类(通常原因是该类的Class文件在父类的类加载路径中不存在),则父类会将该信息反馈给子类并向下委派子类加载器加载该类,直到该类被成功加载,若找不到该类,则JVM会抛出ClassNotFoud异常。双亲委派类加载机制的类加载流程如下。 (1)将自定义加载器挂载到应用程序类加载器。 (2)应用程序类加载器将类加载请求委托给扩展类加载器。 (3)扩展类加载器将类加载请求委托给启动类加载器。 (4)启动类加载器在加载路径下查找并加载Class文件,如果未找到目标Class文件,则交由扩展类加载器加载。 (5)扩展类加载器在加载路径下查找并加载Class文件,如果未找到目标Class文件,则交由应用程序类加载器加载。 (6)应用程序类加载器在加载路径下查找并加载Class文件,如果未找到目标Class文件,则交由自定义加载器加载。 (7)在自定义加载器下查找并加载用户指定目录下的Class文件,如果在自定义加载路径下未找到目标Class文件,则抛出ClassNotFoud异常。双亲委派机制的核心是保障类的唯一性和安全性。例如在加载rt.jar包中的java.lang.Object类时,无论是哪个类加载器加载这个类,最终都将类加载请求委托给启动类加载器加载,这样就保证了类加载的唯一性。如果在JVM中存在包名和类名相同的两个类,则该类将无法被加载,JVM也无法完成类加载流程。

优秀的个人博客,低调大师

每日一博 | SQL 注入漏洞分享

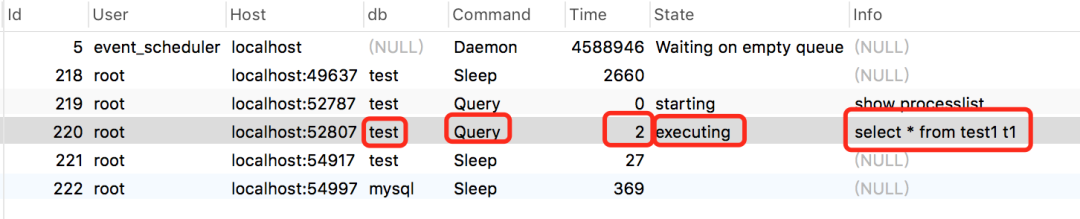
前言 最近我在整理安全漏洞相关问题,准备在公司做一次分享。恰好,这段时间团队发现了一个sql注入漏洞:在一个公共的分页功能中,排序字段作为入参,前端页面可以自定义。在分页sql的mybatis mapper.xml中,order by字段后面使用$符号动态接收计算后的排序参数,这样可以实现动态排序的功能。 但是,如果入参传入: id; select 1 -- 最终执行的sql会变成: select * from user order by id; select 1 -- limit 1,20 --会把后面的limit语句注释掉,导致分页条件失效,返回了所有数据。攻击者可以通过这个漏洞一次性获取所有数据。 动态排序这个功能原本的想法是好的,但是却有sql注入的风险。值得庆幸的是,这次我们及时发现了问题,并且及时解决了,没有造成什么损失。 但是,几年前在老东家的时候,就没那么幸运了。 一次sql注入直接把我们支付服务搞挂了。 1. 还原事故现场 有一天运营小姐姐跑过来跟我说,有很多用户支付不了。这个支付服务是一个老系统,转手了3个人了,一直很稳定没有出过啥问题。 我二话不说开始定位问题了,先看服务器日志,发现了很多报数据库连接过多的异常。因为支付功能太重要了,当时为了保证支付功能快速恢复,先找运维把支付服务2个节点重启了。 5分钟后暂时恢复了正常。 我再继续定位原因,据我当时的经验判断一般出现数据库连接过多,可能是因为连接忘了关闭导致。但是仔细排查代码没有发现问题,我们当时用的数据库连接池,它会自动回收空闲连接的,排除了这种可能。 过了会儿,又有一个节点出现了数据库连接过多的问题。 但此时,还没查到原因,逼于无奈,只能让运维再重启服务,不过这次把数据库最大连接数调大了,默认是100,我们当时设置的500,后面调成了1000。(其实现在大部分公司会将这个参数设置成1000) 使用命令: set GLOBAL max_connections=500; 能及时生效,不需要重启mysql服务。 这次给我争取了更多的时间,找dba帮忙一起排查原因。 使用show processlist;命令查看当前线程执行情况: 还可以查看当前的连接状态帮助识别出有问题的查询语句。(需要特别说明的是上图只是我给的一个例子,线上真实的结果不是这样的) id 线程id User 执行sql的账号 Host 执行sql的数据库的ip和端号 db 数据库名称 Command 执行命令,包括:Daemon、Query、Sleep等。 Time 执行sql所消耗的时间 State 执行状态 info 执行信息,里面可能包含sql信息。 果然,发现了一条不寻常的查询sql,执行了差不多1个小时还没有执行完。 dba把那条sql复制出来,发给我了。然后kill -9 杀掉了那条执行耗时非常长的sql线程。 后面,数据库连接过多的问题就没再出现了。 我拿到那条sql仔细分析了一下,发现一条订单查询语句被攻击者注入了很长的一段sql,肯定是高手写的,有些语法我都没见过。 但可以确认无误,被人sql注入了。 通过那条sql中的信息,我很快找到了相关代码,查询数据时入参竟然用的Statment,而非PrepareStatement预编译机制。 知道原因就好处理了,将查询数据的地方改成preparestatement预编译机制后问题得以最终解决。 2.为什么会导致数据库连接过多? 我相信很多同学看到这里,都会有一个疑问:sql注入为何会导致数据库连接过多? 我下面用一张图,给大家解释一下: 攻击者sql注入了类似这样的参数: -1;锁表语句--。 其中 ;前面的查询语句先执行了。 由于 --后面的语句会被注释,接下来只会执行锁表语句,把表锁住。 正常业务请求从数据库连接池成功获取连接后,需要操作表的时候,尝试获取表锁,但一直获取不到,直到超时。注意,这里可能会累计大量的数据库连接被占用,没有及时归还。 数据库连接池不够用,没有空闲连接。 新的业务请求从数据库连接池获取不到连接,报数据库连接过多异常。 sql注入导致数据库连接过多问题,最根本的原因是长时间锁表。 3.预编译为什么能防sql注入? preparestatement预编译机制会在sql语句执行前,对其进行语法分析、编译和优化,其中参数位置使用占位符?代替了。 当真正运行时,传过来的参数会被看作是一个纯文本,不会重新编译,不会被当做sql指令。 这样,即使入参传入sql注入指令如: id; select 1 -- 最终执行的sql会变成: select * from user order by 'id; select 1 --' limit 1,20 这样就不会出现sql注入问题了。 4.预编译就一定安全? 不知道你在查询数据时有没有用过like语句,比如:查询名字中带有“苏”字的用户,就可能会用类似这样的语句查询: select * from user where name like '%苏%'; 正常情况下是没有问题的。 但有些场景下要求传入的条件是必填的,比如:name是必填的,如果注入了:%,最后执行的sql会变成这样的: select * from user where name like '%%%'; 这种情况预编译机制是正常通过的,但sql的执行结果不会返回包含%的用户,而是返回了所有用户。 name字段必填变得没啥用了,攻击者同样可以获取用户表所有数据。 为什么会出现这个问题呢? %在mysql中是关键字,如果使用like '%%%',该like条件会失效。 如何解决呢? 需要对%进行转义:/%。 转义后的sql变成: select * from user where name like '%/%%'; 只会返回包含%的用户。 5.有些特殊的场景怎么办? 在java中如果使用mybatis作为持久化框架,在mapper.xml文件中,如果入参使用#传值,会使用预编译机制。 一般我们是这样用的: <sql id="query"> select * from user <where> name = #{name} </where></sql> 绝大多数情况下,鼓励大家使用#这种方式传参,更安全,效率更高。 但是有时有些特殊情况,比如: <sql id="orderBy"> order by ${sortString}</sql> sortString字段的内容是一个方法中动态计算出来的,这种情况是没法用#,代替$的,这样程序会报错。 使用$的情况就有sql注入的风险。 那么这种情况该怎办呢? 自己写个util工具过滤掉所有的注入关键字,动态计算时调用该工具。 如果数据源用的阿里的druid的话,可以开启filter中的wall(防火墙),它包含了防止sql注入的功能。但是有个问题,就是它默认不允许多语句同时操作,对批量更新操作也会拦截,这就需要我们自定义filter了。 6.表信息是如何泄露的? 有些细心的同学,可能会提出一个问题:在上面锁表的例子中,攻击者是如何拿到表信息的? 方法1:盲猜 就是攻击者根据常识猜测可能存在的表名称。 假设我们有这样的查询条件: select * from t_order where id = ${id}; 传入参数:-1;select * from user 最终执行sql变成: select * from t_order where id = -1; select * from user; 如果该sql有数据返回,说明user表存在,被猜中了。 建议表名不要起得过于简单,可以带上适当的前缀,比如:t_user。这样可以增加盲猜的难度。 方法2:通过系统表 其实mysql有些系统表,可以查到我们自定义的数据库和表的信息。 假设我们还是以这条sql为例: select code,name from t_order where id = ${id}; 第一步,获取数据库和账号名。 传参为:-1 union select database(),user()# 最终执行sql变成: select code,name from t_order where id = -1 union select database(),user()# 会返回当前 数据库名称:sue 和 账号名称:root@localhost。 第二步,获取表名。 传参改成:-1 union select table_name,table_schema from information_schema.tables where table_schema='sue'#最终执行sql变成: select code,name from t_order where id = -1 union select table_name,table_schema from information_schema.tables where table_schema='sue'# 会返回数据库sue下面所有表名。 建议在生成环境程序访问的数据库账号,要跟管理员账号分开,一定要控制权限,不能访问系统表。 7.sql注入到底有哪些危害? 1. 核心数据泄露 大部分攻击者的目的是为了赚钱,说白了就是获取到有价值的信息拿出去卖钱,比如:用户账号、密码、手机号、身份证信息、银行卡号、地址等敏感信息。 他们可以注入类似这样的语句: -1; select * from user; -- 就能轻松把用户表中所有信息都获取到。 所以,建议大家对这些敏感信息加密存储,可以使用AES对称加密。 2. 删库跑路 也不乏有些攻击者不按常理出牌,sql注入后直接把系统的表或者数据库都删了。 他们可以注入类似这样的语句: -1; delete from user; -- 以上语句会删掉user表中所有数据。 -1; drop database test; -- 以上语句会把整个test数据库所有内容都删掉。 正常情况下,我们需要控制线上账号的权限,只允许DML(data manipulation language)数据操纵语言语句,包括:select、update、insert、delete等。 不允许DDL(data definition language)数据库定义语言语句,包含:create、alter、drop等。 也不允许DCL(Data Control Language)数据库控制语言语句,包含:grant,deny,revoke等。 DDL和DCL语句只有dba的管理员账号才能操作。 顺便提一句:如果被删表或删库了,其实还有补救措施,就是从备份文件中恢复,可能只会丢失少量实时的数据,所以一定有备份机制。 3. 把系统搞挂 有些攻击者甚至可以直接把我们的服务搞挂了,在老东家的时候就是这种情况。 他们可以注入类似这样的语句: -1;锁表语句;-- 把表长时间锁住后,可能会导致数据库连接耗尽。 这时,我们需要对数据库线程做监控,如果某条sql执行时间太长,要邮件预警。此外,合理设置数据库连接的超时时间,也能稍微缓解一下这类问题。 从上面三个方面,能看出sql注入问题的危害真的挺大的,我们一定要避免该类问题的发生,不要存着侥幸的心理。如果遇到一些不按常理出票的攻击者,一旦被攻击了,你可能会损失惨重。 8. 如何防止sql注入? 1. 使用预编译机制 尽量用预编译机制,少用字符串拼接的方式传参,它是sql注入问题的根源。 2. 要对特殊字符转义 有些特殊字符,比如:%作为like语句中的参数时,要对其进行转义处理。 3. 要捕获异常 需要对所有的异常情况进行捕获,切记接口直接返回异常信息,因为有些异常信息中包含了sql信息,包括:库名,表名,字段名等。攻击者拿着这些信息,就能通过sql注入随心所欲的攻击你的数据库了。目前比较主流的做法是,有个专门的网关服务,它统一暴露对外接口。用户请求接口时先经过它,再由它将请求转发给业务服务。这样做的好处是:能统一封装返回数据的返回体,并且如果出现异常,能返回统一的异常信息,隐藏敏感信息。此外还能做限流和权限控制。 4. 使用代码检测工具 使用sqlMap等代码检测工具,它能检测sql注入漏洞。 5. 要有监控 需要对数据库sql的执行情况进行监控,有异常情况,及时邮件或短信提醒。 6. 数据库账号需控制权限 对生产环境的数据库建立单独的账号,只分配DML相关权限,且不能访问系统表。切勿在程序中直接使用管理员账号。 7. 代码review 建立代码review机制,能找出部分隐藏的问题,提升代码质量。 8. 使用其他手段处理 对于不能使用预编译传参时,要么开启druid的filter防火墙,要么自己写代码逻辑过滤掉所有可能的注入关键字。 最后说一句(求关注,别白嫖我) 如果这篇文章对您有所帮助,或者有所启发的话,帮忙扫描下发二维码关注一下,您的支持是我坚持写作最大的动力。 求一键三连:点赞、转发、在看。 关注公众号:【苏三说技术】,在公众号中回复:面试、代码神器、开发手册、时间管理有超赞的粉丝福利,另外回复:加群,可以跟很多BAT大厂的前辈交流和学习。 个人公众号 个人微信 本文分享自微信公众号 - 苏三说技术(gh_9f551dfec941)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | TiDB HTAP 深度解读

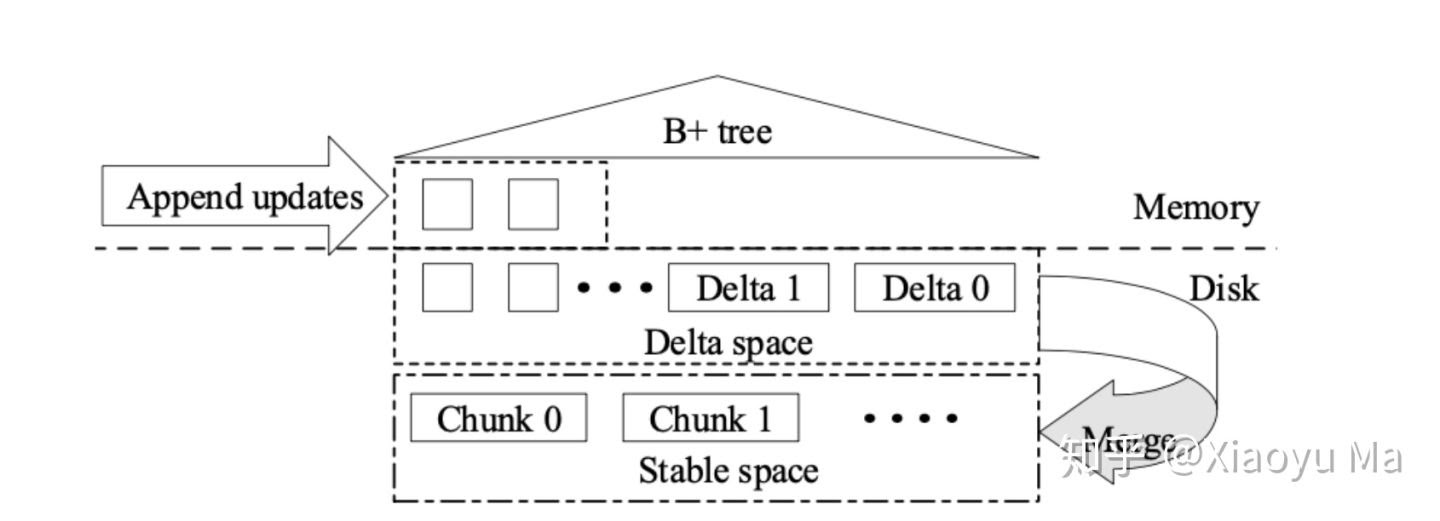
HTAP (Hybrid Transactional / Analytical Processing)是近些年需求不断受到关注的技术名词,它描述了一个数据库能够同时满足交易以及分析两种作业。TiDB 4.0 是一个针对 HTAP 进行了特别的设计和架构强化,这次给大家带来一篇 VLDB 2020 HTAP 主题的论文解读,比较特殊的是这篇论文是 PingCAP 写的,关于 TiDB HTAP 架构。所以这篇解读,是以作者团队(中的一部分)的视角来写的。原文在此,欢迎指正。 说重点 论文整体介绍了一下 TiDB 的架构和设计,对 TiDB 有兴趣的同学推荐完整看下,会对理解架构有很大帮助。不过既然重点是 HTAP,那么在我看来比较重要的地方是这三点: 实时更新的列存 Multi-Raft 的复制体系 根据业务 SQL 智能选择行/列存储 后面我也会着重说一下这三部分。 先说存储 TP 和 AP 传统来说仰赖不同的存储格式:行存对应 OLTP,列存对应 OLAP。然而这两者的优劣差异在内存中会显得不那么明显,因此 SAP Hana 的作者 Hasso Plattner 提出使用 In-Memory + 列存技术同时处理 OLTP 和 OLAP。随后 2014 年 Gartner 提出的 HTAP 概念,也主要是针对内存计算。 这里有个关键信息,列存不合适 TP 类场景。这也许已经是很多人的常识,不过也许并不是所有人都想过为何列存不合适 TP。 数据快速访问需要仰赖 Locality,简单说就是希望根据你的访问模式,要读写的数据尽量放在一起。并不在一起的数据需要额外的 Seek 并且 Cache 效率更低。行存和列存,去除 encoding 和压缩这些因素,本质上是针对不同的访问模式提供了不同的数据 Locality。行存让同一行的数据放在一起,这样类似一次访问一整行数据就会得到很好的速度;列存将同一列的数据放在一起,那么每次只获取一部分列的读取就会得到加速;另一方面,列存在传统印象里更新很慢也部分是因为如果使用 Naive 的方式去将一行拆开成多列写入到应有的位置,将带来灾难性的写入速度。这些效应在磁盘上很明显,但是在内存中就会得以削弱,因此这些年以来我们提起 HTAP,首先想到的是内存数据库。 虽然内存价格在不断下降,但是仍然成本高企。虽说分析机构宣传 HTAP 带来的架构简化可以降低总成本,但实际上内存数据库仍然只是在一些特殊领域得到应用:若非那些无可辩驳的超低延迟场景,架构师仍然需要说服老板,HTAP 带来的好处是否真的值得使用内存数据库。这样, HTAP 的使用领域就受到很大的限制。 所以,我们还是以磁盘而非内存为设计前提。 之前并不是没有人尝试使用行列混合的设计。这种行列混合可以是一种折中格式如 PAX,也可以是在同一存储引擎中通过聪明的算法糅合两种形态。但无论如何,上面说的 Locality 问题是无法绕过的,哪怕通过超强的工程能力去压榨性能,也很难同时逼近两侧的最优解,更不用提技术上这将会比单纯考虑单一场景复杂数倍。 TiDB 并不想放弃 TP 和 AP 任何一侧,因此虽然也知道 Spanner 使用 PAX 格式做 HTAP,却没有贸然跟进。也许有更好的办法呢? TiDB 整体一直更相信以模块化来化解工程问题,包括 TiDB 和 TiKV 的分层和模块切割都体现了这种设计倾向。这次 HTAP 的构思也不例外。经过各种前期的的 Prototype 实验,包括并不限于通过类似 Binlog 之类的 CDC 方案将 TP 的更新同步到易构的 AP 侧,但是这些效果都不尽如人意,我们最终选了通过 Raft 来剥离 / 融合行存和列存,而非在同一套引擎中紧耦合两种格式。这种方式让我们能单独思考两个场景,也无需对现有的引擎做太大的改变,让产品成型和稳定周期大大缩短。另一方面,模块化也使得我们可以更 好借助其他开源产品(ClickHouse)的力量,因为复杂的细节无需被封印在同一个盒子。 市面上有其他设计采用了更紧密的耦合,例如 MemSQL 节点同时运行 TP 和 AP 两种业务,Spanner 选择 PAX 兼顾不同的读取模式,甚至传统数据库大多也在同一个引擎中添加了不同数据组织的支持。这样的架构会引入过于复杂的设计,也未必能在 TP 和 AP 任意一端取得好的收益。 由于选择了松耦合的设计,我们只需要专心解决一个问题就可以搞定存储:如何设计一个可根据主键实时更新的列存系统。事实上,列存多少都支持更新,只是这种更新往往是通过整体覆盖一大段数据来达到的,这也就是为什么多数传统的 OLAP 数据库只能支持批量的数据更新,。如果无需考虑实时主键更新,那么存储可以完全无需考虑数据的去重和排序:存储按照主键顺序整理不止是为了快速读取定位,也是为了写入更新加速。如果需要更新一笔数据,引擎至少需要让同一笔数据的新老版本能以某种方式快速去重,无论是读时去重还是直接写入覆盖。传统意义上分析型数据库或者 Hadoop 列存都抛弃了实时更新能力,因此无需在读或者写的时候负担这个代价,这也是它们得以支持非常高速批量加载和读取的原因之一。但这样的设计无法满足我们场景。要达到 HTAP 的目标,TiDB 的列存引擎必须能够支持实时更新,而且这个更新的速率不能低于行存。 事实上,我们肯定不是第一个在业界尝试实现列存更新的产品。业界对于列存更新,无论是何种变体,一个很通用的做法叫做 Delta Main。既然做列存更新效率不佳,那么我们何不使用写优化方式存储变更数据,然后逐步将更新部分归并到读优化的主列存区?只要我们保持足够的归并频率,那么整个数据的大部分比例都将以读优化的列存形态存在以保持性能。这是一个几乎从列存诞生起就有被想到的设计:你可以认为列存鼻祖 C-Store 就是某种意义上的 Delta Main 设计,它使用一个行存引擎做为写区,并不断将写区数据归并为列存。 我们的可更新列存引擎 DeltaTree 的设计也是非常类似的思路。宏观上,DeltaTree 将数据按照主键序排序切分,类似 TiDB 的 Region 概念那样,每一个数据范围单独形成一个片段,每当片段的物理大小超过阈值就会分裂。微观上来说,每个片段就如上图一般,分成 Delta 和 Stable Space 两部分。其中 Delta 部分以优化写入为主,他们是以写入顺序攒批排列的小数据块,以写入顺序排列而非主键顺序能使得写入大大加速,因为数据写入只需要不断追加。每当积攒了足够多的 Delta 数据,引擎就会将他们归并到 Stable 区,Stable 区的设计类似 Parquet,也是以行组(Row-Group)再按列切割,并排序后压缩存储。Stable 区无疑是对读取优化的,如果只考虑 Stable,那么速度将会很快。但实际上在读取时,仍未归并到 Stable 的 Delta 数据可能需要覆盖 Stable 中的老数据,因此读取会是一个在线归并过程。为了加速这个归并,引擎为 Delta 部分添加了内存中的辅助 B+Tree 索引,这样 Delta 虽然并非物理有序(保持 Delta 物理有序将大大降低写入性能),但仍然保持逻辑有序,免去了归并前排序的代价。同时,由于宏观上数据区间的划分,使得每次归并无需重写所有数据减轻了归并的压力。 回头说之前提到的 LSM 列存方案。实际上你可以认为 LSM 也可以近似认为是一种 Delta Main。当数据写入 MemTable 时,也是以写优化的追加形式写入。那是否 LSM 也可以成为一种支持列存更新的设计呢?我们也尝试过,并非不可能,只是性能对比 DeltaTree 尚有差距:进行范围读取时,LSM 需要进行非常重的多路归并,因为任何上层的新数据都可能会覆盖下层的老数据,而层和层之间存在交集,因此 N 层的 LSM 也许需要进行 N 路归并才能获取一段数据。我们曾经实现过基于 ClickHouse MergeTree 改造的 LSM 列存引擎,对比新的 DeltaTree 将近慢了一倍。 至此为止,我们解决了可更新列存问题。 再说复制 既然选择了松耦合的存储引擎,行列存储并不在同一个模块内,那随之而来的问题必然是如何进行数据复制。对于传统的主从复制体系,我们往往使用比如 MySQL Binlog 这样的 High Level 层级进行复制。实际上,这种复制体系也是我们第一个原型迭代所使用的手段。基于 Binlog 的复制体系能很好封装不必要的细节,只要列存引擎 TiFlash 可以正常回放日志就可以,无需关心例如事务实现等等细节。这样我们很快得到了第一版 TiFlash,它通过 binlog 串联行存与列存,但是需要再往下实现容错,负载均衡等等一系列特性。更麻烦的是,TiDB 是一个分布式且多主的系统。每个 TiDB 服务器都会产生一份 binlog,如果要保持数据一致性,不会新老覆盖,binlog 实际上还需要经过一层汇聚和排序,这几乎将分布式降维打击成了单点吞吐,而排序管道也大大增加了数据到达的延迟。因此原型版的 TiFlash 是无法提供行列混合查询的:你只能单独查询行存或者列存,因为数据无法保证一致,在查询中混合两者会创造无穷无尽的不可知数据错误。 于是我们转而从更低层级的日志进行复制,是的,我们选了在 Raft 层进行对接。从更底层进行对接的好处显而易见,Raft Log 保留了数据复制所需的一切细节,我们得以将 TiFlash 设计成一种特异的 TiKV 节点,从而能够直接获得 Multi-Raft 体系所赋予的一切好处:数据变得可以通过 PD 进行透明迁移扩容,容错本身也完全无需操心全部交由 Raft 体系来完成,当副本丢失时,存储层会自动发起恢复,而复制本身的复杂一致性保障也变得无需操心。从面临自己完善基于 ClickHouse 的副本体系,到坐享其成,一切都是如此美好。当然在实际的工程实现上也有代价,由高层准 SQL 级的 Binlog 改为完全底层的 Raft Log,代价也是相当巨大的。我们需要在 ClickHouse 上实现所有 Multi-Raft 体系所需的复杂操作,例如 Region 的分裂与合并,以及迁移和读取容错。 新的设计是整个 HTAP 体系成立的关键,它给与 TiFlash 无缝接入整个存储层的能力。同一套复制体系,同一套调度体系,一样的事务模型,一样的一致性保障。它的复制设计是完全分布式,负载均衡且自动容错的。 相比通过主从复制或者同机器行列双写,它的 AP 和 TP 部分可以完全独立地运转,自由扩容:如果你需要更多 AP 算力,那请增加 TiFlash 节点;如果你需要增加 TP 算力,请增加 TiKV 节点。互不干扰,以 Workload 而言或者计算资源扩展而言都是。 与此同时,这种复制又是自动负载均衡且点对点直接链接的。每个 Region Leader 副本会单独与列存侧的副本进行沟通完全无需中间存储介质,当 Region 副本过大分裂时,列存副本也会跟着分裂;当副本因为热点打散进行迁移时,他们之间的复制管道也会跟着迁移。这对于 TiDB 的 Multi-Raft 体系来说都是已经实现的功能。 另外 Raft 体系带来的最大好处却是一致性和异步复制的共存。 传统意义上,如果需要复制保持副本一致,就必须采用同步复制。这样,无论是列存节点的高压,还是网路延迟加大,都会对 TP 业务带来巨大冲击:为了保持数据一致性,行存事务必须等待列存确实完成写入才能返回,否则期间的故障将会带来数据丢失和不一致。另外新增任何列存节点也会加大遭遇网络延迟的概率。虽然诸多 HTAP 产品并不会态度考虑 AP 和 TP 互相影响的问题,我们仍然希望娇弱的 TP 能收到更大程度的保护。 这,恰恰可以通过 Raft 解决。TiFlash 通过 Learner 角色接入 Raft 体系,这允许列存以不投票只异步抄写的方式加入集群,这意味着它不会因为自身的稳定干扰正常 TP 业务的运转。当 TP 侧有事务写入,TiKV 无需等待 TiFlash 的数据同步,仅仅在完成正常的行存副本容错复制就可以返回客户端完成事务。那你也许要问了,这样是否数据无法保证一致性,是否行存和列存之间也许存在数据延迟?是也不是。物理上来说,确实存在,一个系统理论上并无可能做到异步复制仍然能同时物理上保持副本一致。但实际上我们也无需保证数据每时每刻在物理上一致,我们只需要提供一种一致的逻辑读取结果就行了。这也是 Raft 本身的核心特点之一,虽然多个副本并非全都每时每刻保持一致,但是只要读取的时候能得到最新的一致性数据即可。当实际读取发生时,列存副本会向行存的 Leader 发起校对请求,这个请求本身很简单:请告诉我在你收到请求的瞬间,最新日志序号是多少。而 TiFlash 会等待数据复制进度追上校对结果。仅此而已。这就使得 TiFlash 能够保证取得足够新鲜的数据,新鲜到保证囊括上一个瞬间写入的信息。是的,从 TiKV 写入的最新数据保证能从 TiFlash 被读取,这形成了读取的水位线。而通过时间戳和 MVCC 配合,TiFlash 的异步同步也可以提供与 TiKV 一样的强一致保证。这使得 TiFlash 列存表现得并不像一套异构复制体系,而更像是一种特殊的列存索引,也使得我们可以放心大胆地在同一个查询中混合两种不同引擎,而无需担心是否会由不一致带来微妙难以追查的错误。 智能选择 智能选择放在最后说,是因为它也的确是我们最后实现的。TiDB 的行列存智能选择就是通过代价优化自动选择行存或者列存。说起来这部分也很简单,犹如使用统计信息选择索引,我们也可以通过代价公式估算列存的使用代价。综合各个访问路径的开销,我们就能知道需要选择何种方式读取数据,而列存只是其中一种,并无特殊性。 技术上来说,这并没有太多新意。但通过自动选择,TiDB 的 HTAP 体系从 TP + 报表的用况一下子拓展到了 HTAP 混合业务。一些边界模糊的业务系统,通过 TiFlash 加持,变得架构简单。例如物流系统,用户希望能够在同一套查询平台检索个别单号以及投递明细,又希望能统计某时间段不同货物类别的收发情况。明细查询对于 TiDB 来说并无任何障碍,但以往没有列存的时候,大数据集下的多维分析性能对比真的分析型产品仍有不小的差距。有了 TiFlash 之后,这样 AP 和 TP 边界模糊的业务就立马变得圆润完整起来。反倒是原始计划中的 TiSpark 读取,由于 TiDB 更贴近业务和 DBA 而非大数据的特点,相较之下显得并没有那么多。 最后 这篇文章并不完全讲述了我们论文的内容。缺失的部分是 TiDB 非 HTAP 部分的设计,有兴趣的同学可以点击原文在此。另外,也欢迎大家使用我们的产品,各位的使用和宝贵意见是 TiDB 发展最基本的推动力。

优秀的个人博客,低调大师

每日一博 | 探索匿名递归函数

匿名递归 在 C# 里递归可以这么定义吗? Func<int, int> fac = (x) => (x <= 1) ? 1 : x * fac(x - 1); 目前不行。因为 C# 只认识下面这种写法: Func<int, int> fac = null; fac = (x) => (x <= 1) ? 1 : x * fac(x - 1); 但这实际上并未使该函数匿名化,而是把变量 fac 的引用绑定到了匿名函数的上下文中。这在变量 fac 被修改后存在失效的风险。 将自己传给自己 为了使匿名递归可行,必须将自身作为参数传给自己。 这么写可行吗? var fac = (f, x) => (x <= 1) ? 1 : f(f, x - 1); fac(fac, 5); 在 C# 里不行。因为 fac 的类型签名无法被自动推断,需要人工提供。 delegate int SelfFactorial(SelfFactorial f, int x); 写成泛型,提高通用性: delegate TResult SelfApplicable<T, TResult>(SelfApplicable<T, TResult> self, T arg); SelfApplicable<int, int> fac = (f, x) => (x <= 1) ? 1 : f(f, x - 1); fac(fac, 5); 更进一步,为 fac 构建函数闭包,得到我们想要的函数形式: Func<int, int> Fac = (x) => fac(fac, x); 综合以上过程,给出一个通用形式的帮助函数,简化类型推断: static Func<T, TResult> Make<T, TR>(SelfApplicable<T, TR> self) { return (x) => self(self, x); } var fac = Make<int, int>((f, x) => (x <= 1) ? 1 : x * f(f, x - 1)); 推广到两个参数的情形: delegate TR SelfApplicable<T1, T2, TR>(SelfApplicable<T1, T2, TR> self, T1 arg1, T2 arg2); static Func<T1, T2, TR> Make<T1, T2, TR>(SelfApplicable<T1, T2, TR> self) { return (x, y) => self(self, x, y); } var gcd = Make<int, int, int>((f, x, y) => (y == 0) ? x : f(f, y, x % y)); 柯里化 柯里化即将多参数的函数转化为多个单参数函数的嵌套。 你可能会想到这种写法: var fac = Make2<int, int>((f) => (x) => (x <= 1) ? 1 : x * f(x - 1)); 这需要配套怎样的 Make2 呢? static Func<T, TR> Make2<T, TR>(Func<Func<T, TR>, Func<T, TR>> g) { // 建立一个新的上下文,在里面用上 g 就能把 g 保存起来。 var wrapped_k = (x) => { // 先跳过这行分析下面的,因为 h 是为了传给 g 做参数的。 // 这个操作必须在子函数体内,不然就死循环了。 var h = Make2(g); // k 才是想要的那个功能函数,但获得这个 k 之前没法传给 g 做其参数 f,陷入了鸡生蛋蛋生鸡的矛盾。 // g 的参数 f 无法是 k,但 Make2 能构造 k 的转发函数,且转发函数使用时才会计算,不会死循环。 var k = g(h); k(x); }; // 这是一个 k 的转发函数,用起来就跟 k 没什么区别。而且它的上下文里有 g 的引用。 return wrapped_k; } 这是一个不动点组合子(将在下文中解释其含义),让我们先将其重命名为 Fix。 static Func<T, TR> Fix<T, TR>(Func<Func<T, TR>, Func<T, TR>> g) { return (x) => g(Fix(g))(x); } Fix 要配合一种两层的匿名函数写法。其中递归函数自身作为外层函数的参数,Fix 将其转化为了可以直接使用的函数对象。 两个参数的 Fix 函数也可以顺利写出来了: static Func<T1, T2, TR> Fix<T1, T2, TR>(Func<Func<T1, T2, TR>, Func<T1, T2, TR>> g) { return (x, y) => g(Fix(g))(x, y); } // 称为单步函数 var g0 = (f) => (x) => (x <= 1) ? 1 : x * f(x - 1); var fac = Fix<int, int>(g0); fac(5); var g1 = (f) => (x, y) => (y == 0) ? x : f(y, x % y); var gcd = Fix<int, int, int>(g1); gcd(10, 15); 先把单步函数抽象一下: // use(x) 产生当次执行的计算结果 // next(f, x) 递归地产生 f(x),或是在没有下一个 x 时及时终止 // reduce(a, b) 将当次与递归的结果合并为最终结果 var g = (f) => (x) => reduce(use(x), next(f, x)); 以一个参数的 Fix 函数为例分析其过程。 先分析这个两层匿名函数 g,并将内层函数单独称为 k: // 注意:这是方便理解而拆开的伪代码,因为不可能使 k 在没有 f 的上下文中绑定到 f。类型推断也是个问题。 var k = (x) => reduce(use(x), next(f, x); var g = (f) => k; var f0 = Fix(g) = (x) => g(Fix(g))(x); 这里的参数 x 被直接转发给了内部函数 h(Fix(g)),因此我们可以在分析时简化。 var f0 = (x) => k(x), f=Fix(g); 虽然每次 f=Fix(g) 计算得到一个新的函数对象而不是复用已得到的 f0,但二者的效果是相同的。 这里有一个等式: g(Fix(g)) == Fix(g) 一般地,我们称值 x 是函数 f 的一个不动点,当且仅当 f(x) = x。 那么根据上文中的两个等式,Fix(g) 是 g 的一个不动点。 Y-组合子 Y-组合子定义为: Y = λf.(λx.f (x x)) (λx.f (x x)) 注意:根据 α-变换,两个 λx 是不同的变元,互不影响。即上式与下式等价: Y = λf.(λx.f (x x)) (λy.f (y y)) 但只要表达式相同,自由变元的名字无关紧要,所以在两个不同的地方都用 λx 是没问题的。 拆分一下,方便理解: h = λx.f (x x) Y = λf.h h 写成 C# 是: var Y = (f) => { // 这虽然写得出代码,但执行起来会死循环 var H = (x) => f(x(x)); return H(H); }; 因此这里需要多一层嵌套,使 x(x) 被推迟执行。推迟执行最重要的目的是在递归到头的时候不再计算从而能够退出。 对应于 λ-演算,即可以使用 η-变换。有两个做法: x x 展开为 λv.(x x) v f (x x) 展开为 λv.(f (x x)) v 第二种变换对应的 C# 是: var Y = (g) => { var H = (h) => { var wrapped_k = (x) => { // 每次 h(h) 都得到一个新的 wrapped_k var new_wrapped_k = h(h); // 在 wrapped_k 中使用了 g // 换取真正的功能函数,而 new_wrapped_k(next(x)) 是能递归下去的 var k = g(new_wrapped_k); return k(x); }; return wrapped_k; }; // 巧妙的 H(H), h(h) 组合,创建对 g 的闭包 return H(H); }; 简写为: var Y = (g) => { var H = (h) => (x) => g(h(h))(x); return H(H); }; Θ-组合子 var H = (h) => (g) => (x) => g(h(h)(g))(x); var Θ = H(H); Θ-组合子 与 Y-组合子 的唯一区别就是变量 g 在多层函数的位置,以及因此而需要的一个重复传参的步骤。 这个例子侧面说明了以下等式: λx.λy.((f x y) y0 x0) == λy.λx.((f x y) x0 y0)

优秀的个人博客,低调大师

每日一博 | 玩转 iOS “宏定义”

玩转iOS“宏定义” 宏定义在C类语言中非常重要,因为宏是一种预编译时的功能,因此其可以比运行时更高层面的对程序流程进行控制。在初学宏定义的时候,大家可能都会有这样一种感觉:就是完全替换么,太简单了。但如果你真这么想,那你就太天真了,不说自己编写宏,在Foundation框架中内置定义的许多宏要看明白也要费一番脑筋。本篇博客,总结了前辈的经验,同时收集了一些编写非常巧妙的宏进行分析,希望可以帮助大家对宏定义有更加深刻的理解,并且可以将心得应用于实际开发中。 一、准备 宏的本质是预编译时的替换,在开始正文之前,我们需要先介绍一种观察宏替换后结果的方法,这样帮助我们更方便的对宏最终的结果进行验证与测试。Xcode开发工具自带查看预编译结果的功能,首先需要对工程编译一遍,之后选择工具栏中的Assistant选项,打开助手窗口,如下图所示: 之后选择窗口的Preprocess选项,即可打开预编译结果窗口,可以看到,宏被替换后的最终结果,如下图所示: 后面,我们将使用这种方式来对编写的宏进行验证。 二、关于“宏定义” 宏使用#define来进行定义,宏定义分为两种,一种是对象式宏,一种是函数式宏。对象式宏通常对来定义量值,在预编译时,直接将宏名替换成对应的量值,函数式宏在定义时可以设置参数,其作用与函数很类似。 例如,我们可以将π的值定义成一个对象式宏,在使用的时候,用有意义的宏名要比直接使用π的字面值方便很多,例如: #import <Foundation/Foundation.h> #define PI 3.1415926 int main(int argc, const char * argv[]) { @autoreleasepool { // insert code here... CGFloat res = PI * 3; NSLog(@"%f", res); } return 0; } 函数式宏要更加灵活一些,例如对圆面积计算的方法,我们就可以将其定义成一个宏: #define PI 3.1415926 #define CircleArea(r) PI * r * r int main(int argc, const char * argv[]) { @autoreleasepool { // insert code here... CGFloat res = CircleArea(1); NSLog(@"%f", res); } return 0; } 现在,有了这个面积计算宏我们可以更加方便的计算圆的面积了,看上去很完美,后面我们就使用这个函数式宏为例,来深入理解宏的原理。 三、从一个简单的函数式宏说起 再来看下上面我们编写的计算面积的宏,正常情况下好像没什么问题,但是需要注意,归根结底宏并不是函数,如果完全把其作为函数使用,我们就可能会陷入一系列的陷阱中,比如这样使用: #define PI 3.1415926 #define CircleArea(r) PI * r * r int main(int argc, const char * argv[]) { @autoreleasepool { // insert code here... CGFloat res = CircleArea(1 + 1); NSLog(@"%f", res); } return 0; } 运行代码,运算的结果并不是半径为2个圆的面积,哪里出了问题呢,我们还是先看下宏预编译后的结果: CGFloat res = 3.1415926 * 1 + 1 * 1 + 1; 一目了然了,由于运算符的优先级问题导致了运算顺序错误,在编程中,所有运算符优先级产生的问题都可以使用一种方式解决:用小括号。对CircleArea宏进行一下改造,如下: #define CircleArea(r) (PI * (r) * (r)) 对执行顺序进行了强制的控制,代码执行又恢复了正常,看上去好像是没有问题了,现在就满意了还为时过早,例如下面这样使用这个宏: #import <Foundation/Foundation.h> #define PI 3.1415926 #define CircleArea(r) PI * (r) * (r) int main(int argc, const char * argv[]) { @autoreleasepool { // insert code here... int r = 1; CGFloat res = CircleArea(r++); NSLog(@"%f, %d", res, r); } return 0; } 运行,发现结果又错了,不仅计算结果与我们的预期不符,变量自加的的结果也不对了,我们检查其展开的结果: CGFloat res = 3.1415926 * (r++) * (r++); 原来问题出在这里,宏在展开的时候,将参数替换了两次,由于参数本身是一个自加表达式,所以被自加了两次,产生了问题,那么这个问题怎么解决呢,C语言中有一种很有用的语法,即使用大括号定义代码块,代码块会将最后一条语句的执行结果返回,修改上面宏定义如下: #import <Foundation/Foundation.h> #define PI 3.1415926 #define CircleArea(r) \ ({ \ typeof(r) _r = r; \ (PI * (_r) * (_r)); \ }) int main(int argc, const char * argv[]) { @autoreleasepool { int r = 1; CGFloat res = CircleArea(r++); NSLog(@"%f, %d", res, r); } return 0; } 这次程序又恢复的了正常。但是,如果如果在调用宏是变量的名字与宏内的临时变量产生了重名,灾难就又发生了,例如: #import <Foundation/Foundation.h> #define PI 3.1415926 #define CircleArea(r) \ ({ \ typeof(r) _r = r; \ (PI * (_r) * (_r)); \ }) int main(int argc, const char * argv[]) { @autoreleasepool { int _r = 1; CGFloat res = CircleArea(_r); NSLog(@"%f, %d", res, _r); } return 0; } 运行上面代码,会发现宏内的临时变量没有被初始化成功。这确实难受,我们在进一步,比如对临时变量的名字做一些手脚,将其命名为极其不容易重复的名字,其实系统内置的一个宏就是专门用来构造唯一性变量名的:__COUNTER__,这个宏是一个计数器,在编译的时候会自动进行累加,再次对我们编写的宏进行改造,如下: #import <Foundation/Foundation.h> #define PI 3.1415926 #define PAST(A, B) A##B #define CircleArea(r) __CircleArea(r, __COUNTER__) #define __CircleArea(r, v) \ ({ \ typeof(r) PAST(_r, v) = r; \ (PI * PAST(_r, v) * PAST(_r, v)); \ }) int main(int argc, const char * argv[]) { @autoreleasepool { int _r = 1; CGFloat res = CircleArea(_r); CGFloat res2 = CircleArea(_r); NSLog(@"%f, %f", res, res2); } return 0; } 这里改造后,我们的宏就没有那么容易理解了,首先__COUNTER__在每次宏替换时都会进行自增,##是一种宏中专用的特殊符号,用来将参数拼接到一起,但是需要注意,使用##符号拼接的如果是另外一个宏,则其会阻止宏的展开,因此我们定义了一个转换宏PAST(A, B)来处理拼接。如果你一下子不能理解为什么这样就可以解决宏展开的问题,你只需要记住这样一条宏展开的原则:如果形参有使用#或##这种处理符号,则不会进行宏参数的展开,否则先展开宏参数,在展开当前宏。上面代码最终预编译的结果如下: int main(int argc, const char * argv[]) { @autoreleasepool { int _r = 1; CGFloat res = ({ typeof(_r) _r0 = _r; (3.1415926 * _r0 * _r0); }); CGFloat res2 = ({ typeof(_r) _r1 = _r; (3.1415926 * _r1 * _r1); }); NSLog(@"%f, %f", res, res2); } return 0; } 一个简单的计算圆面积的宏,为了安全,我们就进行了这么多的处理,看来要用好宏,的确不容易。 四、编写宏时的好习惯 通过前面的介绍,我们知道,如果随随意意的编写一个宏是非常不负责任的,看上去好像没问题与在任何场景下使用都没有问题是完全不同的。在编写宏时,我们可以刻意的去培养这样几个编码习惯: 参数与计算结果要加小括号 这条原则应该不必多说了,前面的示例中就有演示,完整的添加小括号可以避免很多由于运算符优先级造成的异常问题。 多语句功能性宏,要使用do-while包裹 这条原则看上去有些莫名其妙,但是其非常重要,例如,我们需要编写一个自定义的LOG宏,在进行打印时添加一些自定义的信息,你或许会这样写: #define LOG(string) \ NSLog(@"自定义的信息"); \ NSLog(string); int main(int argc, const char * argv[]) { @autoreleasepool { LOG(@"info") } return 0; } 运行代码,目前貌似没有问题,但是如果其和if语句进行结合,可能问题就来了: int main(int argc, const char * argv[]) { @autoreleasepool { if (NO) LOG(@"info") } return 0; } 运行代码,还是有一行LOG信息被输出了,看下其预编译后的结果如下: int main(int argc, const char * argv[]) { @autoreleasepool { if (__objc_no) NSLog(@"自定义的信息"); NSLog(@"info"); } return 0; } 找到问题了,由于if结构如果不加大括号进行规范,其默认作用域只有一句代码,多写大括号是不会出问题,因此编写多语句宏时,加上大括号是一个好习惯,如下: #define LOG(string) \ {NSLog(@"自定义的信息"); \ NSLog(string);} 这样解决了问题,但是并不完美,假设在使用时这样写: int main(int argc, const char * argv[]) { @autoreleasepool { if (NO) LOG(@"NO"); else LOG(@"YES"); } return 0; } 结果发现还是会报错,是由于分号捣的鬼,预编译结果如下: int main(int argc, const char * argv[]) { @autoreleasepool { if (__objc_no) {NSLog(@"自定义的信息"); NSLog(@"NO");}; else {NSLog(@"自定义的信息"); NSLog(@"YES");}; } return 0; } 我们知道,像if,while,for这种语法结构块的大括号后是不需要分号的,我们为了兼容单行if语句由于宏的原因被展开成多行的问题强行加了一个大括号上去,就产生这样的问题了,解决它的一个好方法是真的将多行的宏转化成单语句,do-whlie结构就可以实现这种效果,修改宏如下: #define LOG(string) \ do {NSLog(@"自定义的信息"); \ NSLog(string);} while(0); int main(int argc, const char * argv[]) { @autoreleasepool { if (NO) LOG(@"NO") else LOG(@"YES"); } return 0; } 预编译后: int main(int argc, const char * argv[]) { @autoreleasepool { if (__objc_no) do {NSLog(@"自定义的信息"); NSLog(@"NO");} while(0); else do {NSLog(@"自定义的信息"); NSLog(@"YES");} while(0);; } return 0; } 现在,无论外面怎么使用,这个宏都可以正常工作了。 对于不定参数的宏,借助##符号来拼接参数 在定义函数时,我们可以定义函数的参数为不定个数参数,定义函数式宏时也类似,使用符号"..."可以指定不定个数参数,例如对LOG宏进行调整,如下: #define LOG(format, ...) \ do {NSLog(@"自定义的信息"); \ NSLog(format, __VA_ARGS__);} while(0); int main(int argc, const char * argv[]) { @autoreleasepool { if (NO) LOG(@"%d", NO) else LOG(@"%d", YES); } return 0; } __VA_ARGS__也是一个内置的宏符号,则作用是代表宏定义中的可变参数“...”,需要注意,如果按照上面的写法,如果我们传入的可变参数为0个,会产生问题,其原因也是由于多了一个逗号,例如: int main(int argc, const char * argv[]) { @autoreleasepool { if (NO) LOG(@"%d") // 这里会被预编译成NSLog(@"%d", ) else LOG(@"%d", YES); } return 0; } 解决方案是对可变参数进行一次##拼接,宏在使用##符号进行参数拼接时,如果后面的参数为空,其会自动将前面的逗号去掉,如下: #define LOG(format, ...) \ do {NSLog(@"自定义的信息"); \ NSLog(format, ##__VA_ARGS__);} while(0); 五、特殊的宏符号与常用内置宏 有几个特殊的符号可以让宏定义变得非常灵活,常用的特殊符号和特殊宏列举如下: # 井号的作用是将参数字符串化,例如: #define Test(p) #p int main(int argc, const char * argv[]) { @autoreleasepool { Test(abc); // 预编译后成为 "abc"; } return 0; } ## 双井号我们前面有使用过,其作用是对参数进行拼接,例如: #define Test(a,b) a##b int main(int argc, const char * argv[]) { @autoreleasepool { Test(1,2); // 预编译后成为 12; } return 0; } __VA_ATGS__ 可变参数宏中专用,表示所有传入的可变参数。 __COUNTER__ 一个累加计数宏,常用来构造唯一变量名。 __LINE__ 记录LOG信息时,常用的一个内置宏,预编译时会将其替换为当前的行号。 __FILE__ 记录LOG信息时,常用的一个内置宏,预编译时会将其替换为当前文件的全路径。 __FILE_NAME__ 记录LOG信息时,常用的一个内置宏,预编译时会将其替换为当前的文件名。 __DATE__ 记录LOG信息时,常用的一个内置宏,预编译时会将其替换为当前日期。 __TIME__ 记录LOG信息时,常用的一个内置宏,预编译时会将其替换为当前时间。 六、宏的展开规则 通过前面的介绍,对于应用宏我们已经没有太大的问题,并且也了解了很多宏的使用技巧。这一小节将更深入的对宏的替换规则进行讨论。宏本身是支持嵌套的,例如: #define M1(A) M2(A) #define M2(A) A int main(int argc, const char * argv[]) { @autoreleasepool { M1(1); } return 0; } 上面代码中定义的两个宏基本上是没有意义的,M1宏替换后的结果是M2宏,M2宏最终被替换为参数本身,从这个例子可以看出,宏是可以嵌套递归展开的,但是递归展开是有原则,不会出现无限递归,例如: #define M1(A) M2(A) #define M2(A) M1(A) int main(int argc, const char * argv[]) { @autoreleasepool { M1(1); // 最终展开为 M1(1) } return 0; } 宏的展开需要符合下面原则: 在展开宏的过程中会先将参数进行展开,如果使用##对参数进行了拼接或使用#进行了处理,则此参数不会被展开。 在宏的展开过程中,如果替换列表中出现了要被展开的宏,则此宏不会被展开。 上面的展开原则提到了替换列表,宏在展开过程中会维护一个替换列表,展开的过程中需要从参数到宏本身,从外层宏到内层宏一层一层的替换,每次替换的时候都会将被替换的宏名放入维护的替换列表中,再下一轮替换中,如果再次出现替换列表中出现过的宏名,则不会被再次替换。以我们上面的代码为例进行分析: 首先M1宏在第一轮替换后,被替换成了M2,此时替换列表中放入宏名M1。 M2依然是一个宏名,第二轮对M2进行替换,将其替换为M1,再次将M2放入替换列表,此时替换列表中有宏名M1和M2。 M1依然是宏名,但是替换列表中已经存在M1,此宏名不再展开。 七、宏的妙用 这一小节,我们要转身成为鉴赏家,来对很多实用的宏的巧妙案例进行分析与鉴赏。从这些优秀的使用案例中,可以扩宽我们对宏使用的思路。 MIN与MAX Foundataion内置了一些常用的运算宏,如获取两个数的最大值、最小值、绝对值等等。以MAX宏为例,这个宏的编写基本涵盖了函数式宏所有要注意的点,如下: #define __NSX_PASTE__(A,B) A##B #if !defined(MAX) #define __NSMAX_IMPL__(A,B,L) ({ __typeof__(A) __NSX_PASTE__(__a,L) = (A); __typeof__(B) __NSX_PASTE__(__b,L) = (B); (__NSX_PASTE__(__a,L) < __NSX_PASTE__(__b,L)) ? __NSX_PASTE__(__b,L) : __NSX_PASTE__(__a,L); }) #define MAX(A,B) __NSMAX_IMPL__(A,B,__COUNTER__) #endif 其中__NSMAX_IMPL__宏借助计数__COUNTER__和拼接__NSX_PASTE__宏来构造唯一的内部变量名,我们前面提供的示例宏的写法也基本是参照这个系统宏来的。后面大家在编写函数式宏的时候,都可以参照下这个宏的实现。 2.NSAssert等 NSAssert是断言宏,在开发调试中经常会使用断言来进行安全保障,这个宏的定义如下: #define NSAssert(condition, desc, ...) \ do { \ __PRAGMA_PUSH_NO_EXTRA_ARG_WARNINGS \ if (__builtin_expect(!(condition), 0)) { \ NSString *__assert_file__ = [NSString stringWithUTF8String:__FILE__]; \ __assert_file__ = __assert_file__ ? __assert_file__ : @"<Unknown File>"; \ [[NSAssertionHandler currentHandler] handleFailureInMethod:_cmd \ object:self file:__assert_file__ \ lineNumber:__LINE__ description:(desc), ##__VA_ARGS__]; \ } \ __PRAGMA_POP_NO_EXTRA_ARG_WARNINGS \ } while(0) NSAssert宏定义中使用到了不定参数拼接消除逗号的技巧,并且是多行宏语句使用do-while进行优化的一个实践。 3.@weakify与@strongify weakify与strongify是ReactCocoa中常用的两个宏,用来处理循环引用问题。这两个宏的定义非常巧妙,以weakify宏为例,要看懂这个宏并不是十分简单,首先与这个宏相关的宏定义列举如下: #if DEBUG #define rac_keywordify autoreleasepool {} #else #define rac_keywordify try {} @catch (...) {} #endif #define rac_weakify_(INDEX, CONTEXT, VAR) \ CONTEXT __typeof__(VAR) metamacro_concat(VAR, _weak_) = (VAR); #define weakify(...) \ rac_keywordify \ metamacro_foreach_cxt(rac_weakify_,, __weak, __VA_ARGS__) #define metamacro_foreach_cxt(MACRO, SEP, CONTEXT, ...) \ metamacro_concat(metamacro_foreach_cxt, metamacro_argcount(__VA_ARGS__))(MACRO, SEP, CONTEXT, __VA_ARGS__) #define metamacro_argcount(...) \ metamacro_at(20, __VA_ARGS__, 20, 19, 18, 17, 16, 15, 14, 13, 12, 11, 10, 9, 8, 7, 6, 5, 4, 3, 2, 1) #define metamacro_at20(_0, _1, _2, _3, _4, _5, _6, _7, _8, _9, _10, _11, _12, _13, _14, _15, _16, _17, _18, _19, ...) metamacro_head(__VA_ARGS__) #define metamacro_at(N, ...) \ metamacro_concat(metamacro_at, N)(__VA_ARGS__) #define metamacro_concat(A, B) \ metamacro_concat_(A, B) #define metamacro_concat_(A, B) A ## B #define metamacro_head(...) \ metamacro_head_(__VA_ARGS__, 0) #define metamacro_foreach_cxt1(MACRO, SEP, CONTEXT, _0) MACRO(0, CONTEXT, _0) #define metamacro_head_(FIRST, ...) FIRST 其中rac_keywordify区分DEBUG和RELEASE环境,在DEBUG环境下,其实际上是创建了一个无用的autoreleasepool,消除前面的@符号,在RELEASE环境下,其会创建一个try-catch结构,用来消除参数警告。metamacro_foreach_cxt宏比较复杂,其展开过程如下: // 第一步: 原始宏 metamacro_foreach_cxt(rac_weakify_,, __weak, obj) // 第二步: 展开metamacro_foreach_cxt metamacro_concat(metamacro_foreach_cxt, metamacro_argcount(obj))(rac_weakify_,, __weak, obj) // 第三步: 展开metamacro_argcount metamacro_concat(metamacro_foreach_cxt, metamacro_at(20, obj, 20, 19, 18, 17, 16, 15, 14, 13, 12, 11, 10, 9, 8, 7, 6, 5, 4, 3, 2, 1))(rac_weakify_,, __weak, obj) // 第四步: 展开metamacro_at metamacro_concat(metamacro_foreach_cxt,metamacro_concat(metamacro_at, 20)(obj, 20, 19, 18, 17, 16, 15, 14, 13, 12, 11, 10, 9, 8, 7, 6, 5, 4, 3, 2, 1))(rac_weakify_,, __weak, obj) // 第五步:展开metamacro_concat metamacro_concat(metamacro_foreach_cxt,metamacro_at20(obj, 20, 19, 18, 17, 16, 15, 14, 13, 12, 11, 10, 9, 8, 7, 6, 5, 4, 3, 2, 1))(rac_weakify_,, __weak, obj) // 第六步:展开metamacro_at20 metamacro_concat(metamacro_foreach_cxt,metamacro_head(1))(rac_weakify_,, __weak, obj) // 第七步:展开metamacro_head metamacro_concat(metamacro_foreach_cxt,metamacro_head_(1, 0))(rac_weakify_,, __weak, obj) // 第八步:展开metamacro_head_ metamacro_concat(metamacro_foreach_cxt,1)(rac_weakify_,, __weak, obj) // 第九步:展开metamacro_concat metamacro_foreach_cxt1(rac_weakify_,, __weak, obj) // 第十步:展开metamacro_foreach_cxt1 rac_weakify_(0, __weak, obj) // 第十一步:展开rac_weakify_ __weak __typeof__(obj) metamacro_concat(obj, _weak_) = (obj); // 第十二步:展开metamacro_concat __weak __typeof__(obj) obj_weak_ = (obj); strongify宏的展开与之类似。 4.ParagraphStyleSet宏 ParagraphStyleSet宏是YYLabel中提供的一个设置属性字符串ParagraphStyle相关属性的快捷方法,其中使用到的一个技巧是直接使用宏的形参作为属性名进行使用,使得各种属性的设置都使用同一个宏即可完成,其定义如下: #define ParagraphStyleSet(_attr_) \ [self enumerateAttribute:NSParagraphStyleAttributeName \ inRange:range \ options:kNilOptions \ usingBlock: ^(NSParagraphStyle *value, NSRange subRange, BOOL *stop) { \ NSMutableParagraphStyle *style = nil; \ if (value) { \ if (CFGetTypeID((__bridge CFTypeRef)(value)) == CTParagraphStyleGetTypeID()) { \ value = [NSParagraphStyle yy_styleWithCTStyle:(__bridge CTParagraphStyleRef)(value)]; \ } \ if (value. _attr_ == _attr_) return; \ if ([value isKindOfClass:[NSMutableParagraphStyle class]]) { \ style = (id)value; \ } else { \ style = value.mutableCopy; \ } \ } else { \ if ([NSParagraphStyle defaultParagraphStyle]. _attr_ == _attr_) return; \ style = [NSParagraphStyle defaultParagraphStyle].mutableCopy; \ } \ style. _attr_ = _attr_; \ [self yy_setParagraphStyle:style range:subRange]; \ }]; 八、结语 宏看上去简单,但是真的用好用巧却并不容易,我想,最好的学习方式就是在实际应用中不断的使用,不断的琢磨与优化。如果能将宏的使用驾轻就熟,一定会为你的代码能力带来质的提升。 专注技术,热爱生活,交流技术,也做朋友。 ——珲少 QQ群:805263726

优秀的个人博客,低调大师

每日一博 | Dubbo 底层原理剖析

阅读指南 本文会通过 图文+案例,对 Dubbo 的底层原理进行剖析-探索Dubbo 分层的意义。阅读之前,要求对 Dubbo 有所了解,并且会简单使用。最好阅读下前面的一篇文章: 基于 Java 实现最初级版的 RPC。 正文 先来看一张摘自官网的 令人头大 的 Dubbo 框架设计图,另外还有几张图,就不一一贴出了,详细请参考 [Dubbo 框架设计](http://dubbo.apache.org/zh- cn/docs/dev/design.html) 其实 Dubbo 官网关于框架设计的部分已经讲得很详细了,但是对于我们这种没工作多久的菜鸟,仍然需要花费大量的时间去理解。 框架设计的简要说明 Dubbo 的框架设计图中从下至上分为十层,其中,Service 和 Config 层为 API,其它各层均为 SPI。也就是除了 Service 和 Config 层,其余各层都至少有一种替代品。 比如 Protocol 层: org.apache.dubbo.rpc.protocol.dubbo.DubboProtocol org.apache.dubbo.rpc.protocol.rmi.RmiProtocol org.apache.dubbo.rpc.protocol.http.HttpProtocol Dubbo 的这种高扩展性全部基于 Dubbo SPI 机制,前面花费了多篇文章去讲解 Dubbo SPI 使用,这是研究 Dubbo 源码的关键。 官网 Demo 案例 篇幅原因,具体使用方法和代码还是到官网 Dubbo - 快速启动,下面的内容全部基于这个案例。 图解服务调用过程 官网给出了非常详细的服务调用过程,都是从架构层面,还有整个流程会经历哪个类,哪个方法,下面就基于官网的图文,再结合案例给出自己的理解。 从 main 函数的代码来看,整个流程看着很简单 当我们加上注册中心后 结合 xml 配置 和 Dubbo - 架构, 图解如下: 结合框架设计 服务引用过程 4.1 Proxy 层 对服务消费端使用的 DemoService接口进行代理,把本地调用透明地转换为远程调用, 该层默认使用的是 JavassistProxyFactory, 对该层的理解,可以参考之前的文章 基于 Java 实现最初级版的 RPC 4.2 Cluster 层 从图中可以看出,服务提供者有 2 个实例,那么消费者最终会调用哪个实例,就是由 Cluster 层决定的,该层还会桥连注册中心 zookeeper,获取 2 个服务提供者的注册信息,比如ip,port。当然该层还有其他功能。 4.3 Protocol 层 要实现图中的远程调用,其实本质就是通过网络通信,来传输信息。Dubbo 为此提供了多种通信协议,默认为 DubboProtocol。 // 有删减 dubbo://LOCALHOST:20880/org.apache.dubbo.demo.DemoService ?anyhost=true&application=demo-provider&bind.ip=192.168.31.87&bind.port=20880& interface=org.apache.dubbo.demo.DemoService &methods=sayHello,sayHello1&timestamp=1586693904645 4.4 Exchanger 层 封装请求响应内容为 Request / Response 对象。做 web 接口开发的都知道,我们会把一些参数或者响应内容封装到 XXXRequest/YYYResponse 对象中。 4.5 Transport 层 该层为网络传输层,基于 Netty ,Mina 等通信框架实现。 4.6 Serialize 既然涉及到网络传输,必然会把请求对象进行序列化操作。 服务暴露过程 5.1 开启 Server 并监听指定端口 5.2 将请求数据进行反序列化 5.3 Exchanger 负责解析 Request 对象 5.4 通过 Protocol 层, 根据具体协议解析 Request 对象 5.5 对服务提供者的服务实现类进行代理 总结 本文结合官网的 Demo 案例, 通过画图的方式, 对 Dubbo 的框架设计图进行了简化, 目的是了解 Dubbo 框架分层的作用。一个简单的 RPC 就是基于动态代理 + 网络通信, 动态代理 (Proxy) 就是把本地调用透明转换为远程调用 远程调用就要涉及到网络通信 (Transport) - 基于 socket 在 socket 基础上, 我们可以自定义我们的协议 (Protocol) ,也可以复用现有的协议,比如 http 基于上面的过程, 我们可以封装 Request / Response 对象 (Exchanger) 既然要网络传输, 就要想办法进行序列化/反序列化 (Serialize) 当提供多个服务提供者实例时, 就应该有一个地方 (注册中心 Register) 负责管理服务提供者的元数据信息, 当消费者从上面的多个服务提供者 选取一个 调用服务 (Cluster) 时, 就要选取某种策略 (比如轮询, hash) 最后需要一个监控中心 (Monitor) , 负责一些统计功能,比如服务调用次数

优秀的个人博客,低调大师

每日一博 | 浅谈微服务架构

微服务来源 单体应用 微服务是相对于单体应用的,在介绍微服务之前,先简单介绍一下单体应用:通常是由三个重要部分组成:客户端界面(由HTML、JavaScript组成)、数据库(由许多的表组件构成一个通用的、相互关联的数据管理系统)、服务端应用。服务端应用处理客户端的HTTP请求、执行逻辑、检索并更新数据库中的数据、然后将处理后的数据返回给客户端。 一个单体应用被构建成一个系统时,业务中所有请求都要在单一的进程中处理完成,当访问量很高情况下服务器压力是很大的。当然可以水平扩展,利用负载均衡将实例布署到多台服务器中。 单体架构的缺点 [ ] 开发效率低 [ ] 代码维护难 [ ] 部署不灵活 [ ] 稳定性不高 [ ] 扩展性不高 云时代 在此之前单体应用也是很成功的,但是随着云时代的到来,单体应用就显得有些不妥了,特别是应用程序发布到云端的时候,一个功能的变更,需要统一的编译和发布。这样的架构模式很难使得一个模块的变更不影响到其他模块,而且在扩展方面也只能进行整体的扩展,不能根据正在运行的部分进行扩展。 微服务架构风格 云时代单体应用的尴尬导致了微服务架构风格的出现:以服务构建应用。 一个系统由多个服务组成,各服务可以被独立布署、独立扩展,每个服务也都提供了清晰的模块边界,甚至不同的服务都可以使用不同的编程语言来实现,也可以由不同的团队进行管理。 微服务介绍 微服务是SOA架构下的最终产物 SOA介绍 SOA架构即面向服务的架构,是一种组件模型,它将应用程序的不同功能单元进行拆分,并通过这些服务之间定义良好的接口和协议联系起来;这些不同功能的单元在被拆分后,就被称为服务。 在这种架构中,最重要的是接口的定义,这种定义是不依赖于实现服务的硬件平台、操作系统和编程语言的,即中立的。这样就可以使各服务可以与非本系统的服务以同样方式进行交互,使得各服务之间松耦合。它的优点就是非常灵活——当组成整个应用程序的每个服务的内部结构和实现逐渐地发生改变时,各服务能够继续存在并提供服务。 SOA的特征: 可从企业外部访问 随时可用 粗粒度的服务接口分级 松散耦合 可重用的服务 服务接口设计管理 标准化的服务接口 支持各种消息模式 精确定义的服务契约 分布式定义 > 旨在支持应用程序和服务的开发,可以利用物理架构,由多个自治的处理元素,不共享主内存,但通过网络发送消息合作。 微服务风格特征 组件化与服务 组件化的主要方式是把它拆分成服务,这些组件被链接到程序,并通过内存中函数调用来调用,而服务是进程外组件,他们利用某个机制通信,比如WebService请求,或远程过程调用。 把服务当成组件的一个主要原因是,服务可以独立部署。如果应用程序是由一个单独进程中的很多库组成,那么对任何一个组件的改变都将导致必须重新部署整个应用程序。但是如果把应用程序拆分成很多服务,只需要重新部署那个改变的服务。 另一方面,把服务当组件将拥有更清晰的组件接口。 围绕业务功能的组织 当寻找把一个大的应用程序拆分成小的部分时,通常管理都会集中在技术层面,UI团队、服务端业务逻辑团队和数据库团队。当使用这种标准对团队进行划分时,甚至小小的更变都将导致跨团队项目协作,从而消耗时间和增加沟通成本。 微服务的划分方法不同,它倾向围绕业务功能的组织来分割服务。这些服务实现商业领域的软件,包括用户界面,持久化存储,任何的外部协作。因此,团队是跨职能的,包含开发过程所要求的所有技能:用户体验、数据库和项目管理。 强化终端及弱化通道 微服务的应用致力松耦合和高内聚:采用单独的业务逻辑,基于互联网构建系统。Unix本身就是这样的哲学。 第一种做法是接受请求、处理业务逻辑、返回响应。侧重简单的REST风格,而不是复杂的协议。 第二种做法是通过轻量级消息总线来发布消息。这种的通信协议非常的单一,像RabbitMQ或者Kafka这样的实现,需要依赖产生或者消费消息的终端或者服务来处理这类问题。 在整体工风格中,组件在进程内执行,进程间的消息通信通常通过调用方法或者回调函数。从内存内部原始的调用变成远程调用,产生的大量的不可靠通信。因此需要把粗粒度的方法成更加细粒度的通信。 微服务定义总结 [x] 由一系列微小的服务共同组成 [x] 运行在自己的进程里 [x] 每个服务为独立业务开发 [x] 独立部署 [x] 分布式管理 SOA 架构与微服务架构 微服务是由SOA演化而来,但是微服务与SOA架构有着太多不同了,微服务风格与SOA所提倡的一些优势非常相似,但是区别还是非常大: ESB和API网关 SOA架构:使用ESB(企业服务总线)来连接各个服务节点。为了集成不同系统,不同协议的服务,ESB做了消息的转化解释和路由工作,让不同的服务互联互通。 微服务架构:微服务将API网关服务当作系统的唯一入口。所有的客户端和消费端都通过统一的网关接入微服务,在网关层处理所有的非业务功能。通常,网关提供Restful的访问API。服务端通过API-GateWay注册和管理服务。 架构特点不同: SOA架构特点: 系统集成 系统的服务化 业务的服务化 微服务架构特点 通过服务实现组件化 按业务来划分服务 去中心化 基础设施自动化(devOps) 主要区别 功能 SOA 微服务 组件大小 大块业务逻辑 单独任务或小块业务逻辑 耦合 通常松耦合 总是松耦合 公司架构 任何类型 小型、专注于功能交叉团队 管理 着重中央管理 着重分散管理 目标 确保应用能够交互操作 执行新功能、快速拓展开发团队 服务拆分 服务拆分前提 首先要有一个持续集成的平台,使得服务在拆分的过程中,基于功能的一致性,并且持续的拆分,持续的演进,持续的集成,从而保证系统时刻处于可以验证交付的状态,而非闭门拆分一段时间。 在接入层,API和UI要动静分离,API由API网关统一的管理,这样后端无论如何拆分,对于前端来讲,可以保证统一的入口,而且可以实现拆分过程中的灰度发布,路由分发,流量切分,从而保证拆分的平滑进行。而且拆分后的微服务之间,为了高性能,要避免每次调用都进行认证鉴权的,应该在API网关上做统一的认证鉴权,一旦进入网关内,服务之间的调用就是可信的。 对于数据库,需要进行良好的设计,不应该有大量的联合查询,而是将数据库当成一个简单的key-value查询,复杂的联合查询通过应用层,或者通过Elasticsearch进行。 要做应用的无状态化,只有无状态的应用,才能横向扩展,这样拆分才有意义。 服务拆分的维度与策略 AKF扩展立方体模型 x轴:代表无差别的克隆服务和数据,工作可以很均匀的分散在不同的服务实例上。 y轴:关注应用中职责的划分。 z轴:关注服务和数据的优先级划分。 理论上按照这三个扩展维度,可以将一个单体系统进行无限扩展。 业务与数据 服务拆分存在两大维度,即业务与数据。 业务体现在各种功能代码中,通过确定业务的边界,并使用领域与界限上下文、领域事件等技术手段可以实现拆分。 数据的拆分则体现在如何将集中式的中心化数据转变为各个微服务各自拥有的独立数据。 服务拆分的方法论 如何拆“功能” 单一职责,松耦合、高内聚 关注点分离 按职责 按通用性 按粒度级别 业务和数据的关系 先考虑业务功能,再考虑数据 无状态服务 微服务实现的支撑 一个微服务架构应用的实现,至少需要以下功能的支撑: 云端服务发现(用于定位服务,以实现云端中间层服务发现和故障转。) 统一配置中心(配置管理工具包,集中化管理集群配置) 消息总线(用于在集群中传播状态变化) 各服务之间的通信方式(中立的接口和协议) 容错管理工具(通过熔断机制控制服务和第三方库的节点,从而对延迟和故障提供更强大的容错能力) API网关(在云平台上提供动态路由,监控,弹性,安全等边缘服务的框架) 分布式链路追踪(各链路状态信息收集) 日志收集工具(分布式日志收集) 基于SpringCloud的微服务实现 SpringCloud简介 Spring Cloud是一系列框架的有序集合。利用Spring Boot的开发便利性巧妙地简化了分布式系统基础设施的开发(如配置管理,服务发现,断路器,智能路由,微代理,控制总线,一次性令牌,全局锁,领导选举,分布式会话,集群状态)。 SpringCloud对微服务实现的支撑 云端服务发现 --> Eureka 服务发现是基于微服务架构的关键原则之一。Eureka 采用了C-S的设计架构。Eureka Server作为服务注册功能的服务器,它是服务注册中心。而系统中的其他微服务,使用 Eureka 的客户端连接到 Eureka Server,并维持心跳连接。 Eureka由两个组件组成:Eureka服务器和Eureka客户端。Eureka服务器用作服务注册服务器。Eureka客户端是一个JAVA客户端,用来简化与服务器的交互、作为轮询负载均衡器,并提供服务的故障切换支持。 统一配置中心 --> Spring Cloud Config Spring Cloud Config用来为分布式系统中的基础设施和微服务应用提供集中化的外部配置支持,它分为服务端与客户端两个部分。其中服务端也称为分布式配置中心,它是一个独立的微服务应用,用来连接配置仓库并为客户端提供获取配置信息、加密/解密信息等访问接口;而客户端则是微服务架构中的各个微服务应用或基础设施,它们通过指定的配置中心来管理应用资源与业务相关的配置内容,并在启动的时候从配置中心获取和加载配置信息。Spring Cloud Config实现了对服务端和客户端中环境变量和属性配置的抽象映射。 消息总线 --> Spring Cloud Bus Spring Cloud Bus将分布式系统的节点与轻量级消息代理链接。这可以用于广播状态更改(例如配置更改)或其他管理指令。Bus就像一个扩展的Spring Boot应用程序的分布式执行器,也可以用作应用程序之间的通信渠道。 各服务之间的通信方式 --> Feign(RestFul) Feign是一个声明式WebService客户端。Spring Cloud集成Ribbon和Eureka以在使用Feign时提供负载平衡的HTTP客户端。 容错管理工具 --> Hystrix 在分布式环境中,许多服务依赖项中的一些必然会失败。Hystrix是一个库,通过添加延迟容忍和容错逻辑,控制这些分布式服务之间的交互。Hystrix通过隔离服务之间的访问点、停止级联失败和提供回退选项来实现,以提高系统的整体弹性。 API网关 --> Zuul Zuul相当于是第三方调用(app应用端和PC端)和服务提供方之间的防护门。作为边缘服务,Zull的作用是对后端服务做必要的聚合和裁剪后暴露给外部不同的设备,旨在实现动态路由,监控,弹性负载和安全性。 分布式链路追踪 --> Spring Cloud Sleuth Spring Cloud Sleuth为SpringCloud应用实现了一种分布式追踪解决方案,可以跟踪一个用户请求的过程(包括数据采集,数据传输,数据存储,数据分析,数据可视化),捕获这些跟踪数据,就能构建微服务的整个调用链的视图,这是调试和监控微服务的关键工具。并兼容了Zipkin, HTrace和log-based追踪。 日志收集工具 --> Graylog(非Spring Cloud) Graylog是强大的日志管理、分析工具,可以收集监控多种不同应用的日志。它基于 Elasticsearch, Java和MongoDB。可用于在分布式系统应用中,收集各节点日志整理并分析。 分享一首诗 我曾七次鄙视自己的灵魂—— 第一次,当它本可进取时,却故作谦卑; 第二次,当它在空虚时,用爱欲来填充; 第三次,在困难和容易之间,它选择了容易; 第四次,它犯了错,却借由别人也会犯错来宽慰自己; 第五次,它自由软弱,却把它认为是生命的坚韧; 第六次,当它鄙夷一张丑恶的嘴脸时,却不知那正是自己面具中的一副; 第七次,它侧身于生活的污泥中,虽不甘心,却又畏首畏尾。 一杯茶(左羽博客)

优秀的个人博客,低调大师

每日一博 | nginx worker 进程循环

worker进程启动后,其首先会初始化自身运行所需要的环境,然后会进入一个循环,在该循环中不断检查是否有需要执行的事件,然后处理事件。在这个过程中,worker进程也是需要与master进程交互的,更有甚者,worker进程作为一个子进程,也是可以接收命令行指令(比如kill等)以进行相应逻辑的处理的。那么worker进程是如何与master或者命令行指令进行交互的呢?本文首先会对worker进程与master进程交互方式,以及worker进程如何处理命令行指令的流程进行讲解,然后会从源码上对worker进程交互的整个工作流程进行介绍。 1. worker与master进程交互方式 这里首先需要说明的是,无论是master还是外部命令的方式,nginx都是通过标志位的方式来处理相应的指令的,也即在接收到一个指令(无论是master还是外部命令)的时候,worker会在其回调方法中设置与该指令相对应的标志位,然后在worker进程在其自身的循环中处理完事件之后会依次检查这些标志位是否为真,是则根据该标志位的作用执行相应的逻辑。 对于worker进程与master进程的交互,其是通过socket管道的方式进行的。在ngx_process.h文件中声明了一个ngx_process_t结构体,这里我们主要关注其channel属性: typedef struct { // 其余属性... ngx_socket_t channel[2]; } ngx_process_t; 这里的ngx_process_t结构体的作用是存储某个进程相关的信息的,比如pid、channel、status等。每个进程中都有一个ngx_processes数组,数组元素就是这里的ngx_process_t结构体,也就是说每个进程都会通过ngx_processes数组保存其余进程的基本信息。其声明如下: // 存储了nginx中所有的子进程数组,每个子进程都有一个对应的ngx_process_t结构体进行标记 extern ngx_process_t ngx_processes[NGX_MAX_PROCESSES]; 这里我们就可以看出,每个进程都会一个与之对应的channel数组,这个数组的长度为2,其是与master进程进行交互的管道流。在master进程创建每一个子进程的之前,都会创建一个channel数组,该数组的创建方法为: int socketpair(int domain, int type, int protocol, int sv[2]); 这个方法的主要作用是创建一对匿名的已经连接的套接字,也就是说,如果在一个套接字中写入数据,那么在另一个套接字中就可以接收到写入的数据。通过这种方式,如果在父进程中往管道的一边写入数据,那么在子进程就可以在另一边接收到数据,这样就可以实现父子进程的数据通信了。 在master进程启动完子进程之后,子进程会保有master进程中相应的数据,也包括这里的channel数组。如此,master进程就可以通过channel数组实现与子进程的通信了。 2. worker处理外部命令 对于外部命令,其本质上是通过signals数组中定义的各个信号以及回调方法进行处理的。在master进程初始化基本环境的时候,会将signals数组中指定的信号回调方法设置到对应的信号中。由于worker进程会继承master进程的基本环境,因而worker进程在接收到这里设置的信号之后,也会调用对应的回调方法。而该回调方法的主要逻辑也仅仅只是设置相应的标志位的值。关于nginx接收到信号之后如何设置对应的标志位,可以参照本人前面的文章(nginx master工作循环 超链接),这里不再赘述。 3. 源码讲解 master进程是通过ngx_start_worker_processes()方法启动各个子进程的,如下是该方法源码: /** * 启动n个worker子进程,并设置好每个子进程与master父进程之间使用socketpair * 系统调用建立起来的socket句柄通信机制 */ static void ngx_start_worker_processes(ngx_cycle_t *cycle, ngx_int_t n, ngx_int_t type) { ngx_int_t i; ngx_channel_t ch; ngx_memzero(&ch, sizeof(ngx_channel_t)); ch.command = NGX_CMD_OPEN_CHANNEL; for (i = 0; i < n; i++) { // spawn是产卵的意思,这里就是生成一个子进程的意思,而该子进程所进行的事件循环就是 // ngx_worker_process_cycle()方法,这里的ngx_worker_process_cycle是worker进程处理事件的循环, // worker进程在一个无限for循环中,不断的检查相应的事件模型中是否存在对应的事件, // 然后将accept事件和read、write事件分开放入两个队列中,最后在事件循环中不断的处理事件 ngx_spawn_process(cycle, ngx_worker_process_cycle, (void *) (intptr_t) i, "worker process", type); // 下面的这段代码的主要作用是将新建进程这个事件通知到其他的进程,上面的 // ch.command = NGX_CMD_OPEN_CHANNEL;中NGX_CMD_OPEN_CHANNEL表示的就是当前是新建了一个进程, // 而ngx_process_slot存储的就是该新建进程所存放的数组位置,这里需要进行广播的原因在于, // 每个子进程被创建后,其内存数据都是复制的父进程的,但是ngx_processes数组是每个进程都有一份的, // 因而数组中先创建的子进程是没有后创建的子进程的数据的,但是master进程是有所有子进程的数据的, // 因而这里master进程创建子进程之后,其就会向ngx_processes数组的每个进程的channel[0]上 // 写入当前广播的事件,也即这里的ch,通过这种方式,每个子进程接收到这个事件之后, // 都会尝试更新其所保存的ngx_processes数据信息 ch.pid = ngx_processes[ngx_process_slot].pid; ch.slot = ngx_process_slot; ch.fd = ngx_processes[ngx_process_slot].channel[0]; // 广播事件 ngx_pass_open_channel(cycle, &ch); } } 这里我们主要需要关注上面的启动子进程的方法调用,也即这里的ngx_spawn_process()方法,该方法的第二个参数是一个方法,在启动子进程之后,子进程就会进入该方法所指定的循环中。而在ngx_spawn_process()方法中,master进程会为当前新创建的子进程创建一个channel数组,以用于与当前子进程进行通信。如下是ngx_spawn_process()方法的源码: ngx_pid_t ngx_spawn_process(ngx_cycle_t *cycle, ngx_spawn_proc_pt proc, void *data, char *name, ngx_int_t respawn) { u_long on; ngx_pid_t pid; ngx_int_t s; if (respawn >= 0) { s = respawn; } else { // 在ngx_processes数组中存储了当前创建的所有进程,而ngx_last_process则是当前当前记录的最后一个 // process在ngx_processes中的下一个位置的索引,只不过ngx_processes中记录的进程有可能有部分 // 已经失效了。当前循环就是从头开始查找是否有某个进程已经失效了,如果已经失效了,则复用该进程位置, // 否则直接使用ngx_last_process所指向的位置 for (s = 0; s < ngx_last_process; s++) { if (ngx_processes[s].pid == -1) { break; } } // 这里说明所创建的进程数达到了最大限度 if (s == NGX_MAX_PROCESSES) { ngx_log_error(NGX_LOG_ALERT, cycle->log, 0, "no more than %d processes can be spawned", NGX_MAX_PROCESSES); return NGX_INVALID_PID; } } // NGX_PROCESS_DETACHED标志表示当前fork出来的进程与原来的父进程没有任何关系,比如进行nginx升级时, // 新生成的master进程就与原先的master进程没有关系 if (respawn != NGX_PROCESS_DETACHED) { /* Solaris 9 still has no AF_LOCAL */ // 这里的socketpair()方法的主要作用是生成一对套接字流,用于主进程和子进程的通信,这一对套接字会 // 存储在ngx_processes[s].channel中,本质上这个字段是一个长度为2的整型数组。在主进程和子进程 // 进行通信的之前,主进程会关闭其中一个,而子进程会关闭另一个,然后相互之间往未关闭的另一个文件描述符中 // 写入或读取数据即可实现通信。 // AF_UNIX表示当前使用的是UNIX文件形式的socket地址族 // SOCK_STREAM指定了当前套接字建立的通信方式是管道流,并且这个管道流是双向的, // 即管道双方都可以进行读写操作 // 第三个参数protocol必须为0 if (socketpair(AF_UNIX, SOCK_STREAM, 0, ngx_processes[s].channel) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "socketpair() failed while spawning \"%s\"", name); return NGX_INVALID_PID; } ngx_log_debug2(NGX_LOG_DEBUG_CORE, cycle->log, 0, "channel %d:%d", ngx_processes[s].channel[0], ngx_processes[s].channel[1]); // 将ngx_processes[s].channel[0]设置为非阻塞模式 if (ngx_nonblocking(ngx_processes[s].channel[0]) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, ngx_nonblocking_n " failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; } // 将ngx_processes[s].channel[1]设置为非阻塞模式 if (ngx_nonblocking(ngx_processes[s].channel[1]) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, ngx_nonblocking_n " failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; } on = 1; // 将ngx_processes[s].channel[0]套接字管道设置为异步模式 if (ioctl(ngx_processes[s].channel[0], FIOASYNC, &on) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "ioctl(FIOASYNC) failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; } // 当前还处于主进程中,这里的ngx_pid指向了主进程的进程id,当前方法的作用主要是将 // ngx_processes[s].channel[0]的操作权限设置给主进程,也就是说主进程通过向 // ngx_processes[s].channel[0]写入和读取数据来与子进程进行通信 if (fcntl(ngx_processes[s].channel[0], F_SETOWN, ngx_pid) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "fcntl(F_SETOWN) failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; } // FD_CLOEXEC表示当前指定的套接字管道在子进程中可以使用,但是在execl()执行的程序中不可使用 if (fcntl(ngx_processes[s].channel[0], F_SETFD, FD_CLOEXEC) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "fcntl(FD_CLOEXEC) failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; } // FD_CLOEXEC表示当前指定的套接字管道在子进程中可以使用,但是在execl()执行的程序中不可使用 if (fcntl(ngx_processes[s].channel[1], F_SETFD, FD_CLOEXEC) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "fcntl(FD_CLOEXEC) failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; } // ngx_processes[s].channel[1]是用于给子进程监听相关事件使用的,当父进程向 // ngx_processes[s].channel[0]发布事件之后,ngx_processes[s].channel[1]中就会接收到 // 对应的事件,从而进行相应的处理 ngx_channel = ngx_processes[s].channel[1]; } else { // 如果是NGX_PROCESS_DETACHED模式,则表示当前是另外新起的一个master进程,因而将其管道值都置为-1 ngx_processes[s].channel[0] = -1; ngx_processes[s].channel[1] = -1; } ngx_process_slot = s; // fork()方法将产生一个新的进程,这个进程与父进程的关系是子进程的内存数据将完全复制父进程的。 // 还需要注意的是,fork()出来的子进程执行的代码是从fork()之后开始执行的,而对于父进程而言, // 该方法的返回值为父进程id,而对于子进程而言,该方法返回值为0,因而通过if-else语句就可以让父进程 // 和子进程分别调用后续不同的代码片段 pid = fork(); switch (pid) { case -1: // fork出错 ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "fork() failed while spawning \"%s\"", name); ngx_close_channel(ngx_processes[s].channel, cycle->log); return NGX_INVALID_PID; case 0: // 子进程执行的分支,这里的proc()方法是外部传进来的,也就是说,当前方法只是创建一个新的进程, // 具体的进程处理逻辑,将交由外部代码块进行定义ngx_getpid()方法获取的就是当前新创建的子进程的进程id ngx_pid = ngx_getpid(); proc(cycle, data); break; default: // 父进程会走到这里 break; } ngx_log_error(NGX_LOG_NOTICE, cycle->log, 0, "start %s %P", name, pid); // 父进程会走到这里,当前的pid是fork()之后父进程得到的新创建的子进程的pid ngx_processes[s].pid = pid; ngx_processes[s].exited = 0; if (respawn >= 0) { return pid; } // 设置当前进程的各个属性,并且存储到ngx_processes数组中的对应位置 ngx_processes[s].proc = proc; ngx_processes[s].data = data; ngx_processes[s].name = name; ngx_processes[s].exiting = 0; switch (respawn) { case NGX_PROCESS_NORESPAWN: ngx_processes[s].respawn = 0; ngx_processes[s].just_spawn = 0; ngx_processes[s].detached = 0; break; case NGX_PROCESS_JUST_SPAWN: ngx_processes[s].respawn = 0; ngx_processes[s].just_spawn = 1; ngx_processes[s].detached = 0; break; case NGX_PROCESS_RESPAWN: ngx_processes[s].respawn = 1; ngx_processes[s].just_spawn = 0; ngx_processes[s].detached = 0; break; case NGX_PROCESS_JUST_RESPAWN: ngx_processes[s].respawn = 1; ngx_processes[s].just_spawn = 1; ngx_processes[s].detached = 0; break; case NGX_PROCESS_DETACHED: ngx_processes[s].respawn = 0; ngx_processes[s].just_spawn = 0; ngx_processes[s].detached = 1; break; } if (s == ngx_last_process) { ngx_last_process++; } return pid; } ngx_spawn_process()方法最后会fork()一个子进程以执行其第二个参数所指定的回调方法。但是在这之前,我们需要说明的是,其通过socketpair()方法调用会创建一对匿名的socket,然后将其存储在当前进程的channel数组中,如此就完成了channel数组的创建。 worker进程启动之后会执行ngx_worker_process_cycle()方法,该方法首先会对worker进程进行初始化,其中就包括对继承而来的channel数组的处理。由于master进程和worker进程都保有channel数组所指代的socket描述符,而本质上master进程和各个worker进程只需要保有该数组的某一边的描述符即可。因而这里worker进程在初始化过程中,会关闭其所保存的另一边的描述符。在nginx中,master进程统一的会保留channel数组的0号位的socket描述符,关闭1号位的socket描述符,而worker进程则会关闭0号位的socket描述符,保留1号位的描述符。这样master进程需要与worker进程通信时,就只需要往channel[0]中写入数据,而worker进程则会监听channel[1],从而接收到master进程的数据写入。这里我们首先看一下worker进程的初始化方法ngx_worker_process_init()的源码: /** * 这里主要是对当前进程进行初始化,为其设置优先级和打开的文件限制等参数。 * 最后会为当前进程添加一个监听channel[1]的连接,以不断读取master进程的消息,从而进行相应的处理 */ static void ngx_worker_process_init(ngx_cycle_t *cycle, ngx_int_t worker) { sigset_t set; ngx_int_t n; ngx_time_t *tp; ngx_uint_t i; ngx_cpuset_t *cpu_affinity; struct rlimit rlmt; ngx_core_conf_t *ccf; ngx_listening_t *ls; // 设置时区相关的信息 if (ngx_set_environment(cycle, NULL) == NULL) { /* fatal */ exit(2); } ccf = (ngx_core_conf_t *) ngx_get_conf(cycle->conf_ctx, ngx_core_module); // 设置当前进程的优先级 if (worker >= 0 && ccf->priority != 0) { if (setpriority(PRIO_PROCESS, 0, ccf->priority) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "setpriority(%d) failed", ccf->priority); } } // 设置当前进程能够打开的文件句柄数 if (ccf->rlimit_nofile != NGX_CONF_UNSET) { rlmt.rlim_cur = (rlim_t) ccf->rlimit_nofile; rlmt.rlim_max = (rlim_t) ccf->rlimit_nofile; if (setrlimit(RLIMIT_NOFILE, &rlmt) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "setrlimit(RLIMIT_NOFILE, %i) failed", ccf->rlimit_nofile); } } // Changes the limit on the largest size of a core file(RLIMIT_CORE) for worker processes. // 简而言之就是设置核心文件能够使用的最大大小 if (ccf->rlimit_core != NGX_CONF_UNSET) { rlmt.rlim_cur = (rlim_t) ccf->rlimit_core; rlmt.rlim_max = (rlim_t) ccf->rlimit_core; if (setrlimit(RLIMIT_CORE, &rlmt) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "setrlimit(RLIMIT_CORE, %O) failed", ccf->rlimit_core); } } // geteuid()返回执行当前程序的用户id,这里的0表示是否为root用户 if (geteuid() == 0) { // setgid()方法的作用是更改组的id if (setgid(ccf->group) == -1) { ngx_log_error(NGX_LOG_EMERG, cycle->log, ngx_errno, "setgid(%d) failed", ccf->group); /* fatal */ exit(2); } // initgroups()是更改附加组的id if (initgroups(ccf->username, ccf->group) == -1) { ngx_log_error(NGX_LOG_EMERG, cycle->log, ngx_errno, "initgroups(%s, %d) failed", ccf->username, ccf->group); } // 更改用户的id if (setuid(ccf->user) == -1) { ngx_log_error(NGX_LOG_EMERG, cycle->log, ngx_errno, "setuid(%d) failed", ccf->user); /* fatal */ exit(2); } } // 需要注意的是,对于cache manager和cache loader进程,这里的worker传入的是-1, // 表示这两个进程不需要设置亲核性 if (worker >= 0) { // 获取当前worker的CPU亲核性 cpu_affinity = ngx_get_cpu_affinity(worker); if (cpu_affinity) { // 设置worker的亲核心 ngx_setaffinity(cpu_affinity, cycle->log); } } #if (NGX_HAVE_PR_SET_DUMPABLE) if (prctl(PR_SET_DUMPABLE, 1, 0, 0, 0) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "prctl(PR_SET_DUMPABLE) failed"); } #endif if (ccf->working_directory.len) { // chdir()的作用是将当前的工作目录更改为其参数所传入的路径 if (chdir((char *) ccf->working_directory.data) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "chdir(\"%s\") failed", ccf->working_directory.data); /* fatal */ exit(2); } } // 初始化空的set指令集合 sigemptyset(&set); // ◆ SIG_BLOCK:将 set 参数指向信号集中的信号加入到信号掩码中。 // ◆ SIG_UNBLOCK:将 set 参数指向的信号集中的信号从信号掩码中删除。 // ◆ SIG_SETMASK:将 set 参数指向信号集设置为信号掩码。 // 这里就是直接初始化要阻塞的信号集,默认为空集 if (sigprocmask(SIG_SETMASK, &set, NULL) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "sigprocmask() failed"); } tp = ngx_timeofday(); srandom(((unsigned) ngx_pid << 16) ^ tp->sec ^ tp->msec); ls = cycle->listening.elts; for (i = 0; i < cycle->listening.nelts; i++) { ls[i].previous = NULL; } // 这里调用各个模块的init_process()方法进行进程模块的初始化 for (i = 0; cycle->modules[i]; i++) { if (cycle->modules[i]->init_process) { if (cycle->modules[i]->init_process(cycle) == NGX_ERROR) { /* fatal */ exit(2); } } } // 这里主要是关闭当前进程中其他各个进程的channel[1]管道句柄 for (n = 0; n < ngx_last_process; n++) { if (ngx_processes[n].pid == -1) { continue; } if (n == ngx_process_slot) { continue; } if (ngx_processes[n].channel[1] == -1) { continue; } if (close(ngx_processes[n].channel[1]) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "close() channel failed"); } } // 关闭当前进程的channel[0]管道句柄 if (close(ngx_processes[ngx_process_slot].channel[0]) == -1) { ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_errno, "close() channel failed"); } #if 0 ngx_last_process = 0; #endif // ngx_channel指向的是当前进程的channel[1]句柄,也即监听master进程发送消息的句柄。 // 当前方法中,首先会为当前的句柄创建一个connection对象,并且将其封装为一个事件,然后将该事件添加到 // 对应的事件模型队列中以监听当前句柄的事件,事件的处理逻辑则主要有这里的ngx_channel_handler() // 方法进行。这里的ngx_channel_handler的主要处理逻辑是,根据当前收到的消息设置当前进程的一些标志位, // 或者更新某些缓存数据,如此,在当前进行的事件循环中,通过不断检查这些标志位,从而实现在事件进程中 // 处理真正的逻辑。因而这里的ngx_channel_handler的处理效率是非常高的 if (ngx_add_channel_event(cycle, ngx_channel, NGX_READ_EVENT, ngx_channel_handler) == NGX_ERROR) { /* fatal */ exit(2); } } 该方法主要是对worker进程进行初始化,这里我们主要需要关注最后会遍历ngx_processes数组,这个数组中保存了当前nginx中各个进程的相关信息。在遍历过程中,会关闭当前进程保有的其余进程的channel[1]句柄,而保留有channel[0]句柄,这样当前进程如果需要与其他进程通信,也只需要往目标进程的channel[0]中写入数据即可。在遍历完成之后,当前进程就会关闭自身的channel[0]句柄,而保留channel[1]句柄。最后,会通过ngx_add_channel_event()方法为当前进程添加对channel[1]的监听事件,这里在调用ngx_add_channel_event()方法时传入的第二个参数是ngx_channel,该参数是在前面的ngx_spawn_process()方法中赋值的,指向的就是当前进程的channel[1]的socket句柄。 关于ngx_add_channel_event()方法,其本质就是创建一个ngx_event_t结构体的事件,然后将其添加到当前所使用的事件模型(比如epoll)句柄中。这里不再赘述该方法的实现源码,不过我们需要关注的是该事件触发时的回调方法,即调用ngx_add_channel_event()方法时传入的第三个参数ngx_channel_handler()方法。如下是该方法的源码: static void ngx_channel_handler(ngx_event_t *ev) { ngx_int_t n; ngx_channel_t ch; ngx_connection_t *c; if (ev->timedout) { ev->timedout = 0; return; } c = ev->data; for (;;) { // 在无限for循环中不断读取master进程发过来的消息 n = ngx_read_channel(c->fd, &ch, sizeof(ngx_channel_t), ev->log); // 如果读取消息出错,说明当前的句柄可能失效了,就需要关闭当前连接 if (n == NGX_ERROR) { if (ngx_event_flags & NGX_USE_EPOLL_EVENT) { ngx_del_conn(c, 0); } ngx_close_connection(c); return; } if (ngx_event_flags & NGX_USE_EVENTPORT_EVENT) { if (ngx_add_event(ev, NGX_READ_EVENT, 0) == NGX_ERROR) { return; } } if (n == NGX_AGAIN) { return; } // 对发送过来的消息进行处理 switch (ch.command) { // 如果是quit消息,则设置quit标志位 case NGX_CMD_QUIT: ngx_quit = 1; break; // 如果terminate消息,则设置terminate标志位 case NGX_CMD_TERMINATE: ngx_terminate = 1; break; // 如果是reopen消息,则设置reopen标志位 case NGX_CMD_REOPEN: ngx_reopen = 1; break; // 如果是新建进程消息,则更新当前ngx_processes数组对应位置的数据 case NGX_CMD_OPEN_CHANNEL: ngx_processes[ch.slot].pid = ch.pid; ngx_processes[ch.slot].channel[0] = ch.fd; break; // 如果是关闭channel的消息,则关闭ngx_processes数组对应位置的句柄 case NGX_CMD_CLOSE_CHANNEL: if (close(ngx_processes[ch.slot].channel[0]) == -1) { ngx_log_error(NGX_LOG_ALERT, ev->log, ngx_errno, "close() channel failed"); } ngx_processes[ch.slot].channel[0] = -1; break; } } } 在ngx_channel_handler()方法中,主要是读取所监听的socket句柄中的数据,而数据是以一个ngx_channel_t结构体所承载的,这个ngx_channel_t是nginx所统一使用的master与worker进程进行通信的结构体,其会指定当前发生的事件类型,以及发生该事件的进程信息。如下是ngx_channel_t结构体的声明: typedef struct { // 当前发生的事件类型 ngx_uint_t command; // 发生事件的pid ngx_pid_t pid; // 发生事件的进程在ngx_processes数组中的下标 ngx_int_t slot; // 发生事件的进程的channel[0]描述符的值 ngx_fd_t fd; } ngx_channel_t; 在从当前进程的channel[1]中读取了ngx_channel_t结构体的数据之后,ngx_channel_handler()方法会根据发生的事件类型更新相应的标志位的状态,并且会更新当前进程的ngx_processes数组中对应的发生事件的进程的状态信息。 在处理了master进程所发送的事件之后,worker进程就会继续其循环,在该循环中会检查其所关注的标志位的状态,然后会根据这些状态执行对应的逻辑。如下是worker进程工作的循环的源码: /** * 进入worker进程工作的循环 */ static void ngx_worker_process_cycle(ngx_cycle_t *cycle, void *data) { ngx_int_t worker = (intptr_t) data; ngx_process = NGX_PROCESS_WORKER; ngx_worker = worker; // 初始化worker进程,前面对该方法的源码进行了讲解 ngx_worker_process_init(cycle, worker); ngx_setproctitle("worker process"); for (;;) { if (ngx_exiting) { // 这里主要是检查有没有事件是非cancelable状态的,也就是说是否所有的事件都已经取消了,如果取消了, // 就会返回NGX_OK。这里的逻辑可以理解为,如果被标记为了ngx_exiting,那么此时,如果还有未取消的 // 事件存在,则会走到下面的ngx_process_events_and_timers()方法,如此就会处理未完成的事件, // 然后在循环中再次走到这个位置,最终if条件为true,从而执行退出worker进程的工作 if (ngx_event_no_timers_left() == NGX_OK) { ngx_log_error(NGX_LOG_NOTICE, cycle->log, 0, "exiting"); ngx_worker_process_exit(cycle); } } ngx_log_debug0(NGX_LOG_DEBUG_EVENT, cycle->log, 0, "worker cycle"); // 这里通过检查相应的事件模型中是否存在对应的事件,然后将其放入队列中进行处理, // 这里是worker进程处理事件的核心方法 ngx_process_events_and_timers(cycle); // 这里ngx_terminate是强制关闭nginx的选项,如果向nginx发送了强制关闭nginx命令,则当前进程会直接退出 if (ngx_terminate) { ngx_log_error(NGX_LOG_NOTICE, cycle->log, 0, "exiting"); ngx_worker_process_exit(cycle); } // 这里ngx_quit是优雅退出的选项。这里主要是将ngx_exiting置为1,用于表征当前进程需要退出, // 然后会执行如下三个工作: // 1. 往事件队列中添加一个事件,用于处理当前处于活跃状态的连接,将其close标志位置为1,并且执行该连接 // 当前的处理方法,以尽快完成连接事件; // 2. 关闭当前cycle中监听的socket句柄; // 3. 将当前所有处于空闲状态的连接的close状态标记为1,然后调用其连接处理方法. if (ngx_quit) { ngx_quit = 0; ngx_log_error(NGX_LOG_NOTICE, cycle->log, 0, "gracefully shutting down"); ngx_setproctitle("worker process is shutting down"); if (!ngx_exiting) { ngx_exiting = 1; ngx_set_shutdown_timer(cycle); ngx_close_listening_sockets(cycle); ngx_close_idle_connections(cycle); } } // ngx_reopen主要是重新打开nginx的所有文件,比如切换nginx的日志文件等等 if (ngx_reopen) { ngx_reopen = 0; ngx_log_error(NGX_LOG_NOTICE, cycle->log, 0, "reopening logs"); ngx_reopen_files(cycle, -1); } } } 可以看到,worker进程主要处理了nginx是否退出相关的标志位,还处理了nginx是否重新读取了配置文件的标志位。 4. 小结 本文首先对master-worker进程交互的基本原理进行了讲解,然后深入到源码中讲解了nginx是如何实现master和worker进程的相互通信的。

优秀的个人博客,低调大师

每日一博 | 浅析 Nginx 网络事件

Nginx 是一个事件驱动的框架,所谓事件主要指的是网络事件,Nginx 每个网络连接会对应两个网络事件,一个读事件一个写事件。在深入了解 Nginx 各种原理及在极端场景下的一些错误场景处理时,需要首先理解什么是网络事件。 网络传输 接下来看上面这张图,比如主机 A 就是一台家里的笔记本电脑,那么主机 B 就是一台服务器,上面跑着 Nginx 服务。从主机 A 发送一个 HTTP 的 GET 请求到主机 B,这样的一个过程中主要经历了哪些事件?通过上图数据流部分可以看出: 应用层里发送了一个 GET 请求 -> 到了传输层,这一步主要在做一件事,就是浏览器打开了一个端口,在 windows 的任务管理器中可以看到这一点,他会把这个端口记下来以及把 Nginx 打开的端口比如 80 或者 443 也记到传输层 -> 然后在网络层会记下我们主机所在的 IP 和目标主机,也就是 Nginx 所在服务器公网 IP -> 到链路层以后 -> 经过以太网 -> 到达家里的路由器(网络层),家中的路由器会记录下所在运营商的一些下一段的 IP -> 通过广域网 -> 跳转到主机 B 所在的机器中 -> 报文会经过链路层 -> 网络层 -> 到传输层,在传输层操作系统就知道是给那个打开了 80 或者 443 的进程,这个进程自然就是 Nginx -> 那么 Nginx 在他的 HTTP 状态处理机里面(应用层)就会处理这个请求。 在上述过程中网络报文扮演了一个怎样的角色呢? TCP流与报文 数据链路层会在数据的前面 Header 部分和 Footer 部分添加上源 MAC 地址和源目的地址 -> 到了网络层则是 Nginx 的公网地址(目的 IP 地址)和浏览器的公网地址(源 IP 地址)-> 到了 TCP 层(传输层),指定了 Nginx 打开的端口(目的端口)和浏览器打开的端口(源端口)-> 然后应用层就是 HTTP 协议了。 这就是一个报文,也就是说我们发送的 HTTP 协议会被切割成很多小的报文,在网络层会切割叫 MTU,以太网的每个 MTU 是 1500 字节;在 TCP 层(传输层)呢会考虑中间每个环节中最大的一个 MTU 值,这个时候往往每个报文只有几百字节,这个报文大小我们称为叫 MSS ,所以每收到一个 MSS 小于这么大小的一个报文时其实就是一个网络事件。 这个时候,我们来看下 TCP 协议中许多事件是怎样和我们日常调用的一些接口(比如 Accept、Read、Write、Close)是怎样关联在一起的? TCP 协议与非阻塞接口 请求建立 TCP 连接事件实际上是发送了一个 TCP 报文,通过上面第二部分讲解的那样的一个流程到达了 Nginx,对应的是读事件。因为对于 Nginx 来说,我读取到了一个报文,所以就是 Accept 建立链接事件。 如果是 TCP 连接可读事件,就是发送了一个消息,对于 Nginx 也是一个读事件,就是 Read 读消息。 如果是对端(也就是浏览器)主动地关掉了,相当于 windows 操作系统会去发送一个要求关闭链接的一个事件,对于 Nginx 来说还是一个读事件,因为他只是去读取一个报文。 那什么是写事件呢?当我们的浏览器需要向浏览器发送响应的时候,需要把消息写到操作系统中,要求操作系统发送到网络中,这就是一个写事件。 像这样的一些网络读写事件,通常在 Nginx 中或者任何一个异步事件的处理框架中,他会有个东西叫事件收集、分发器。会定义每类事件处理的消费者,也就是说事件是一个生产者,是通过网络中自动的生产到我们的 Nginx 中的,我们要对每种事件建立一个消费者。比如连接建立事件消费者,就是对 Accept 调用,HTTP 模块就会去建立一个新的连接。还有很多读消息或者写消息,在 HTTP 状态机中不同的时间段会调用不同的方法也就是每个消费者处理。 以上就是一个事件分发、消费器,包括 AIO 像异步读写磁盘事件,还有定时器事件,比如是否超时(worker_shutdown_timeout)。 Nginx 网络事件实例 上面介绍了网络报文的发送以及对应的 Nginx 中的网络事件,比如 Accept 建立一条新连接其实是收到一条读事件,接下来我们通过抓包来分析建立三次握手时时怎么样让 Nginx 收到读事件,使用的抓包工具是 Wireshark。 首先我们安装 Wireshark 软件,并对 Nginx 所在 IP 和端口进行抓包,然后访问页面,在 TCP 层主要说两件事情: 浏览器首先会打开这个页面,本地打开了一个 1875 端口,而 Nginx 启动的是 8080 端口。 TCP 层主要做的是进程与进程之间通讯这件事。 IP 层主要解决机器与机器之间怎样互相找到的问题。 三次握手也就是 windows 先向 Nginx 发送了一次 [SYN],那么相反的 Nginx 所在的服务器也会向 windows 发送一个 [SYN],这个时候 Nginx 是没有感知到的,因为这个连接还是处于半打开的状态。直到这台 windows 服务器再次发送 [ACK] 到 Nginx 所在的服务器之上时,Nginx 所在的操作系统才会去通知 Nginx 我们收到了一个读事件,这个读事件对应是建立一个新连接,所以此时 Nginx 应该调用 Accept 方法去建立一个新的连接。 以上我们通过 Wireshark 抓包演示了正常的三次握手是怎么样引发一个读事件来使得 Nginx 去处理这样一个读事件来建立新的连接的。 总结 这篇文章主要讲解了网络事件,并通过抓包来分析 Nginx 网络事件,这对我们理解 Nginx 异步处理框架是非常有帮助的,包括 OpenResty 也是强依赖于网络事件以及事件分发的。

优秀的个人博客,低调大师

每日一博 | 互斥那点事儿(下)

“我找到好办法了!” 没有想到,说话的人竟然是磁盘! 进程调度器瑟瑟的说:“你有方法?还是算了吧,我怕用你的方法操作系统要乱套了。” 磁盘委屈的道:“不就是刚刚冤枉你了吗,这么小气干什么!再说了,这个方法不是我想出来的,是我从文件里找到的。” 操作系统挑了挑眉毛:“哦?你找到什么文件了,让大家也瞅瞅?” 磁盘嗡嗡的转起来,很快就把文件取出来了。 “当当当当~ 这可是大师 Dijkstra 的论文,他引入了一个全新的变量类型——信号量(semaphore)。然后还为信号量设置了两种操作,P(proberen,检测) 和 V(verhogen,增量) 。” ”说清楚点啊,信号量是怎么个用法啊?“进程急切的问道。 “别急,让我接着看。。。Dijkstra 提出,P操作是检测信号量是否为正值,如果不是,就阻塞调用进程。 V操作能唤醒一个阻塞进程,让他恢复执行 。具体点的话就是这样: “ // S 为信号量 P(s): { S = S - 1 if (S < 0) { 调用该 P 操作的进程阻塞,并插入相应的阻塞队列; } } // S 为信号量 V(s): { S = S + 1 if (S <= 0) { 从等待信号量 S 的阻塞队列里唤醒一个进程; } } 内存仔细看了代码,说:”这个实现也要求是原子操作诶,Dijkstra 这个方法很有趣啊。“ 进程蒙圈了:“我怎么完全看不懂啊?内存你给我讲讲呗。” “好,我就用最简单的一组线程举例子了: // 线程 A,B,C , S = 1 ... P(S) //S = S - 1 若 S < 0 ,阻塞等待 购票操作 V(S) //S = S + 1 若 S <= 0, 表明有线程阻塞了,得唤醒其中一个 ... 这里的 「购票操作」 就是我们要保护的临界区,我们要保证一次只能有一个线程进入。那我们就把 S 的初始值设为 1 。当线程 A 第一个调用 P(S) 后,S 的值就变成了 0 ,A 成功进入临界区。在 A 出临界区之前,线程 B 如果调用 P(S), S 就变成 -1 ,满足 S < 0 的判断条件,线程 B 就被阻塞了。等 A 调用 V(S) 后,S 的值又变成 0 ,满足 S <= 0,就会把线程 B 唤醒,B 就能进入临界区了。“ 进程恍然大悟:“原来是这样,看起来和二元锁差不多啊,但是不用忙等待了。” 内存神秘一笑:“信号量能做的可不止这些,你想想看,要是我把 S 的初始值设为 2 ,会发生什么?” “一次能有两个线程访问临界区!”进程这次反应快多了:“也就是说 S 的初始值可以控制有多少个线程进入临界区,太厉害了!” tobe 注:从信号量的值能看出还有多少个进程能进入临界区,如果为负数,表明有 x 个进程因为调用 P(S) 而被阻塞 “没错,所以说信号量是一个很灵活的并发机制。而且信号量还有另一个厉害的用处: 你看这两个进程有什么特别的地方?“ “emmmm,这个嘛,进程 P2 的 V 操作居然放在 P 操作的前面,而且两个操作的信号量还不是同一个。” “没错,这样使用信号量,能让两个进程做到同步。你看,如果 P1 运行到 P(S1),他是不是会阻塞?” 进程认真一看,说:“没错诶,S1 初始值是 0,P1 肯定得停在这一句。让我再看看,,,如果 P1 想接着运行,就得等 P2 调用 V(S1) 把他唤醒。” “是的,这就是同步——运行快的 P1 必须在这里停下来等 P2 运行到指定位置。两个进程的执行顺序就是这样: 也就是说 x 最终的值必然是 30,而不可能是 20。在信号量的帮助下,这两个进程达成了同步。“ 进程由衷的感叹:“信号量实在是太强大了!咱们以后就用信号量来解决互斥的问题吧!” tobe 注:在 Linux 里提供了信号量和互斥量(也就是二元锁)这两种主要机制实现互斥,不过 Linux 的信号量功能要比文章里讲得复杂得多,「UNIX 环境高级编程」这本书里写到「。。。三种特性造成了这种并非必要的复杂性」,对于一般的互斥操作,还是建议使用互斥锁(当然是阻塞而非忙等待)。稍微复杂点的锁还有「读写锁」,以后有机会再讲吧~ 觉得我写的还不错的话,就点个赞吧! 如果本文对你有帮助,欢迎关注我的公众号 tobe的呓语 ,带你深入计算机的世界~ 公众号后台回复关键词【计算机】有惊喜哦~

优秀的个人博客,低调大师

每日一博 | 互斥那点事儿(上)

本年度第 10 次操作系统成员会议开始啦! 一月一度的会议旨在让大家互相交流,解决最近在工作中出现的问题,以提高整个计算机系统的工作效率。因为计算机硬件在飞速发展,而操作系统是连接计算机硬件和应用程序的中间层,如果故步自封,很快就会被市场淘汰,所以每位操作系统成员都很重视月度会议。 这次提出问题的是进程和线程两兄弟。 站在众人前面,线程显得有些怯场,他戳了戳进程,示意让他先来讲。进程迅速整理了下思路,挺直了身板,说:“这次的问题是在一个订票系统里发现的,我把这个系统的简单逻辑画出来了,你们一边看我一边说。” “这个订票系统分为服务器端(server)和客户端(client),当用户与服务器建立连接时,服务器端就会建立一个新的线程来为客户端提供服务。订票逻辑是这样的: 单独从这个逻辑图上看是没有问题的,但在实际情况下,因为经常出现多个用户同时抢订一张票的情景,这种方式就可能会出错。就像这样: 在线程 A 确定完余票(假设是 1),但还未能成功订票之前,线程 B 得到了余票数为 1 的信息,所以 B 也认为可以订票,最后导致一张票卖出去两份。“ 内存一针见血的道:“我看这就是几个线程执行流的冲突问题嘛,本来应该一个线程订票操作结束后,另一个线程才能查询余票。像这样执行流交叉,肯定还会出现其它意想不到的问题。” 进程佩服的说:“诶别说,内存你说的太有道理了,我也遇到过类似的情况,上次我和另一个进程共享一部分内存空间,结果在使用同一个数据的时候,他把我刚写进去的数据覆盖掉了,害得我后面的计算全出错了。” 这时,磁盘发表了他的看法:“执行流的问题,那一看就是进程调度器的锅,怎么非得在别人执行到关键步骤的时候把人家从 CPU 上赶下来!要是调度器稍微等一会儿,这问题不就解决了?” 进程调度器听到这话,气的站起来,说:“你,你怎么凭空污人清白!什么时候切换进程不是由我来决定好不好?我是负责从就绪队列里选出最应该使用 CPU 的进程而已。等我开始调度的时候,那些进程就已经被操作系统撤下来了。” 操作系统补充道:“调度器说的没错,调度的时机是由中断决定的。看样子这种情况出现在进程时间片用尽的时候,出现了时钟中断,然后被其他进程抢占了 CPU 资源。” 磁盘听了,不好意思的说:“对不起,刚刚是我太武断了。那照你的意思,我们在执行到这部分代码的时候,像这样屏蔽时钟中断可以解决这个问题了?” 操作系统摇摇头:“「中断禁用」这种方式确实可以防止进程在运行这部分代码时进行切换,但是,时钟中断是我的一项非常重要的功能,怎么能随随便便就把控制权交给人类呢?万一有的程序员想要他们的代码可以完全占有 CPU ,不把时钟中断给我开启怎么办?我是不可能把这种重要权限交出去的,我要对整个系统负责。” 内存在旁边赞同道:“除了这一方面,你还要知道,现在都是多核时代了,你即使禁用了这个 CPU 的时钟中断,其他几个核还是能切换进程,然后访问这些数据。磁盘啊,你明明存了那么多文件,怎么懂得还是那么少。。。” 磁盘愤愤的道:“别瞧不起我,我这就去找有没有办法解决这个问题!” 思考了许久的 CPU 开口了:“我来捋一捋吧,现在咱的目标是,不让两个进程同时执行这一段代码——我们把这段代码叫做临界区吧,换句话说,我们需要让进程互斥的进入临界区。那我们就把这段临界区「加锁」,” “加锁?这是什么意思?” “加锁是个比喻,其实「锁」只是一个共享变量,我们可以让它有 OPEN 和 CLOSE 这两个值。一个进程,比如说 A,进入临界区之前,先检查锁是不是 OPEN 状态,如果是的话,就把锁改为 CLOSE 状态 ,这样其他进程在进入临界区时,会发现锁已经 CLOSE 了,那就让他们循环等待 ,直到 A 出临界区然后将锁打开。” 内存眉头一皱,发现事情并没有这么简单——如果 A 发现锁是开着的,但在 A 还没有关闭锁之前,切换到了进程 B ,那么 B 也会发现锁是开着的,那么 B 也将能够进入临界区! 想到这里,内存把问题告诉 CPU,但 CPU 说,这对他不是问题。 原来计算机里有一条硬件支持的指令——TSL(test and set lock,测试并加锁),这条指令可以保证读字和写字的操作「不可分割」,也就是说,在这条指令结束前,就连其他处理器也不可能访问该内存字。 “TSL 指令会把内存字 lock 读到寄存器上,然后在对应的内存地址上写入一个非零值。那我们就可以利用这条指令改进刚刚的加锁的方法,就像这样: 我们让进程在进入临界区之前先调用 enter_region ,如果锁已经被关闭(表现为锁非 0 ),就循环调用enter_region ,直到锁打开,然后再进入临界区。出临界区之后,就调用 leave_region 把锁打开。这样不就解决你的问题了?“ 内存点点头,说:“这确实是一个好方法,解决了临界区的互斥问题。” 不过操作系统不是很满意这种解决方案:“这种解决方式需要忙等待,浪费了 CPU 的资源啊,我觉得这种 TSL 方案需要改进。” 这时候大家陷入了沉默——谁也没有想到更好的解决方案,会议好像就此僵住了。 谁能想到一种更好的方案呢? 哈哈,我在文章里埋了伏笔哦,你猜猜是谁找到了更好的方法呢? 觉得我写的还不错的话,就点个赞吧! 声明:原创文章,未经授权,禁止转载

优秀的个人博客,低调大师

每日一博 | Spring Cloud Hystrix 熔断

一、什么是熔断 在一个家庭中有各种各样的家电,我们假设每个家电都没有保险丝,一旦有一天某个家电出现短路,造成整个电路短路然后很有可能就把整个家庭的电器及电路给烧坏了。但如果每个家电入口线路都有一个保险丝(断路器),那么不管那个家电发生短路这个家电的保险丝就会快速熔断(断开电路),从而保护了整个电路及电路上其它的家电的正常运行。 软件行业里面的熔断机制与这个一致,在整个微服务集群中,由于其中一个或者几个微服务出现故障或堵塞,若没有快速的熔断机制,就会造成整个微服务集群的拥堵最终整个微服务出现雪崩被拖死。熔断机制的核心机制就是在确保某个微服务出现故障的时候实现快速熔断(断路)或者服务降级快速失败,避免拥堵。从而保证其它业务其它服务的正常运行。 二、Hystrix 设计原则 防止单个服务的故障,耗尽整个系统服务的容器(比如tomcat)的线程资源,避免分布式环境里大量级联失败。通过第三方客户端访问(通常是通过网络)依赖服务出现失败、拒绝、超时或短路时执行回退逻辑。 用快速失败代替排队(每个依赖服务维护一个小的线程池或信号量,当线程池满或信号量满,会立即拒绝服务而不会排队等待)和优雅的服务降级;当依赖服务失效后又恢复正常,快速恢复。 提供接近实时的监控和警报,从而能够快速发现故障和修复。监控信息包括请求成功,失败(客户端抛出的异常),超时和线程拒绝。如果访问依赖服务的错误百分比超过阈值,断路器会跳闸,此时服务会在一段时间内停止对特定服务的所有请求。 将所有请求外部系统(或请求依赖服务)封装到HystrixCommand或HystrixObservableCommand对象中,然后这些请求在一个独立的线程中执行。使用隔离技术来限制任何一个依赖的失败对系统的影响。每个依赖服务维护一个小的线程池(或信号量),当线程池满或信号量满,会立即拒绝服务而不会排队等待。 三、Hystrix特性 请求熔断:当Hystrix Command请求后端服务失败数量超过一定比例(默认50%), 断路器会切换到开路状态(Open). 这时所有请求会直接失败而不会发送到后端服务. 断路器保持在开路状态一段时间后(默认5秒), 自动切换到半开路状态(HALF-OPEN)。这时会判断下一次请求的返回情况, 如果请求成功, 断路器切回闭路状态(CLOSED), 否则重新切换到开路状态(OPEN). Hystrix的断路器就像我们家庭电路中的保险丝, 一旦后端服务不可用, 断路器会直接切断请求链, 避免发送大量无效请求影响系统吞吐量, 并且断路器有自我检测并恢复的能力。 服务降级:Fallback相当于是降级操作. 对于查询操作, 我们可以实现一个fallback方法, 当请求后端服务出现异常的时候, 可以使用fallback方法返回的值. fallback方法的返回值一般是设置的默认值或者来自缓存。 依赖隔离(采用舱壁模式,Docker就是舱壁模式的一种):在Hystrix中, 主要通过线程池来实现资源隔离. 通常在使用的时候我们会根据调用的远程服务划分出多个线程池.比如说,一个服务调用另外两个服务,你如果调用两个服务都用一个线程池,那么如果一个服务卡在哪里,资源没被释放后面的请求又来了,导致后面的请求都卡在哪里等待,导致你依赖的A服务把你卡在哪里,耗尽了资源,也导致了你另外一个B服务也不可用了。这时如果依赖隔离,某一个服务调用A B两个服务,如果这时我有100个线程可用,我给A服务分配50个,给B服务分配50个,这样就算A服务挂了,我的B服务依然可以用。 请求缓存:比如一个请求过来请求我userId=1的数据,你后面的请求也过来请求同样的数据,这时我不会继续走原来的那条请求链路了,而是把第一次请求缓存过了,把第一次的请求结果返回给后面的请求(参考@CacheResult、@CacheKey、@CacheRemove注解)。 请求合并:我依赖于某一个服务,我要调用N次,比如说查数据库的时候,我发了N条请求发了N条SQL然后拿到一堆结果,这时候我们可以把多个请求合并成一个请求,发送一个查询多条数据的SQL的请求,这样我们只需查询一次数据库,提升了效率。 在Hystrix 中我们用的比较多的是前三点,后面两点并不适用于所有业务。 四、实战 1、添加依赖 添加 `spring-cloud-starter-hystrix`模块,实际使用过程中我们使用了Feign后已经包含了Hystrix模块及Ribbon模块,不需要单独引入。 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-hystrix</artifactId> </dependency> 2、开启Hystrix 在启动类中加入@EnableCircuitBreaker注解,表示允许断路器。如下代码所示: //允许断路器 @EnableCircuitBreaker public class Application { ... } 在spring cloud 项目中使用 `@SpringCloudApplication` 注解后已经包含了`@EnableCircuitBreaker` 注解及其它微服务注解,看源码: @Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited @SpringBootApplication @EnableDiscoveryClient @EnableCircuitBreaker public @interface SpringCloudApplication { } 3、方法级熔断 Spring cloud 采用http进行通讯,spring cloud 结合Eureka针对http请求响应操作做了封装,支持两种方式,RestTemplate 及Feign模式,Feign模式参考其它章节,这里简单介绍RestTemplate模式。 @Service public class HelloService { @Autowired private RestTemplate restTemplate; //请求熔断注解,当服务出现问题时候会执行fallbackMetho属性的名为helloFallBack的方法 @HystrixCommand(fallbackMethod = "helloFallBack") public String helloService() throws ExecutionException, InterruptedException { return restTemplate.getForEntity("http://HELLO-SERVICE/hello",String.class).getBody(); } public String helloFallBack(){ return "error"; } } 这是一个外部服务调用的restTemplate实现,通过 @HystrixCommand(fallbackMethod = "helloFallBack") 标志这个方法开启熔断机制, 指定熔断后服务降级方法为:helloFallBack()。此时若被调用方异常,接下来请求都会进入服务降级实现(回调方法)并快速失败。@HystrixCommand 也可以指定其它配置: public @interface HystrixCommand { String groupKey() default ""; String commandKey() default ""; String threadPoolKey() default ""; String fallbackMethod() default ""; HystrixProperty[] commandProperties() default {}; HystrixProperty[] threadPoolProperties() default {}; Class<? extends Throwable>[] ignoreExceptions() default {}; ObservableExecutionMode observableExecutionMode() default ObservableExecutionMode.EAGER; HystrixException[] raiseHystrixExceptions() default {}; String defaultFallback() default ""; } 让我们来逐个介绍下@HystrixCommand注解的各个参数: commandKey:配置全局唯一标识服务的名称,比如,库存系统有一个获取库存服务,那么就可以为这个服务起一个名字来唯一识别该服务,如果不配置,则默认是@HystrixCommand注解修饰的函数的函数名。 groupKey:一个比较重要的注解,配置全局唯一标识服务分组的名称,比如,库存系统就是一个服务分组。通过设置分组,Hystrix会根据组来组织和统计命令的告、仪表盘等信息。Hystrix命令默认的线程划分也是根据命令组来实现。默认情况下,Hystrix会让相同组名的命令使用同一个线程池,所以我们需要在创建Hystrix命令时为其指定命令组来实现默认的线程池划分。此外,Hystrix还提供了通过设置threadPoolKey来对线程池进行设置。建议最好设置该参数,使用threadPoolKey来控制线程池组。 threadPoolKey:对线程池进行设定,细粒度的配置,相当于对单个服务的线程池信息进行设置,也可多个服务设置同一个threadPoolKey构成线程组。 fallbackMethod:@HystrixCommand注解修饰的函数的回调函数,@HystrixCommand修饰的函数必须和这个回调函数定义在同一个类中,因为定义在了同一个类中,所以fackback method可以是public/private均可。 commandProperties:配置该命令的一些参数,如executionIsolationStrategy配置执行隔离策略,默认是使用线程隔离,此处我们配置为THREAD,即线程池隔离。参见:com.netflix.hystrix.HystrixCommandProperties中各个参数的定义。 threadPoolProperties:线程池相关参数设置,具体可以设置哪些参数请见:com.netflix.hystrix.HystrixThreadPoolProperties ignoreExceptions:调用服务时,除了HystrixBadRequestException之外,其他@HystrixCommand修饰的函数抛出的异常均会被Hystrix认为命令执行失败而触发服务降级的处理逻辑(调用fallbackMethod指定的回调函数),所以当需要在命令执行中抛出不触发降级的异常时来使用它,通过这个参数指定,哪些异常抛出时不触发降级(不去调用fallbackMethod),而是将异常向上抛出。 observableExecutionMode:定义hystrix observable command的模式; raiseHystrixExceptions:任何不可忽略的异常都包含在HystrixRuntimeException中; defaultFallback:默认的回调函数,该函数的函数体不能有入参,返回值类型与@HystrixCommand修饰的函数体的返回值一致。如果指定了fallbackMethod,则fallbackMethod优先级更高。 给个例子: @HystrixCommand(commandKey = "testCommand", groupKey = "testGroup", threadPoolKey = "testThreadKey", fallbackMethod = "hiConsumerFallBack", ignoreExceptions = {NullPointerException.class}, threadPoolProperties = { @HystrixProperty(name = "coreSize", value = "30"), @HystrixProperty(name = "maxQueueSize", value = "101"), @HystrixProperty(name = "keepAliveTimeMinutes", value = "2"), @HystrixProperty(name = "queueSizeRejectionThreshold", value = "15"), @HystrixProperty(name = "metrics.rollingStats.numBuckets", value = "12"), @HystrixProperty(name = "metrics.rollingStats.timeInMilliseconds", value = "1440") } )

优秀的个人博客,低调大师

新浪微博布局学习——妙用TabHost

正文 一、效果图 红色部分是本文要实现的目标。 二、实现 maintabs.xml <? xmlversion="1.0"encoding="UTF-8" ?> < TabHost android:id ="@android:id/tabhost" android:layout_width ="fill_parent" android:layout_height ="fill_parent" xmlns:android ="http://schemas.android.com/apk/res/android" > < LinearLayout android:orientation ="vertical" android:layout_width ="fill_parent" android:layout_height ="fill_parent" > < FrameLayout android:id ="@android:id/tabcontent" android:layout_width ="fill_parent" android:layout_height ="0.0dip" android:layout_weight ="1.0" /> < TabWidget android:id ="@android:id/tabs" android:visibility ="gone" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:layout_weight ="0.0" /> < RadioGroup android:gravity ="center_vertical" android:layout_gravity ="bottom" android:orientation ="horizontal" android:id ="@id/main_radio" android:background ="@drawable/maintab_toolbar_bg" android:layout_width ="fill_parent" android:layout_height ="wrap_content" > < RadioButton android:text ="@string/main_home" android:checked ="true" android:id ="@+id/radio_button0" android:layout_marginTop ="2.0dip" android:drawableTop ="@drawable/icon_1_n" style ="@style/main_tab_bottom" /> < RadioButton android:id ="@+id/radio_button1" android:layout_marginTop ="2.0dip" android:text ="@string/main_news" android:drawableTop ="@drawable/icon_2_n" style ="@style/main_tab_bottom" /> < RadioButton android:id ="@+id/radio_button2" android:layout_marginTop ="2.0dip" android:text ="@string/main_my_info" android:drawableTop ="@drawable/icon_3_n" style ="@style/main_tab_bottom" /> < RadioButton android:id ="@+id/radio_button3" android:layout_marginTop ="2.0dip" android:text ="@string/menu_search" android:drawableTop ="@drawable/icon_4_n" style ="@style/main_tab_bottom" /> < RadioButton android:id ="@+id/radio_button4" android:layout_marginTop ="2.0dip" android:text ="@string/more" android:drawableTop ="@drawable/icon_5_n" style ="@style/main_tab_bottom" /> </ RadioGroup > </ LinearLayout > </ TabHost > styles.xml < style name ="main_tab_bottom" > < item name ="android:textSize" > @dimen/bottom_tab_font_size </ item > < item name ="android:textColor" > #ffffffff </ item > < item name ="android:ellipsize" > marquee </ item > < item name ="android:gravity" > center_horizontal </ item > < item name ="android:background" > @drawable/home_btn_bg </ item > < item name ="android:paddingTop" > @dimen/bottom_tab_padding_up </ item > < item name ="android:layout_width" > fill_parent </ item > < item name ="android:layout_height" > wrap_content </ item > < item name ="android:button" > @null </ item > < item name ="android:singleLine" > true </ item > < item name ="android:drawablePadding" > @dimen/bottom_tab_padding_drawable </ item > < item name ="android:layout_weight" > 1.0 </ item > </ style > home_btn_bg.xml < selector xmlns:android ="http://schemas.android.com/apk/res/android" > < item android:state_focused ="true" android:state_enabled ="true" android:state_pressed ="false" android:drawable ="@drawable/home_btn_bg_s" /> < item android:state_enabled ="true" android:state_pressed ="true" android:drawable ="@drawable/home_btn_bg_s" /> < item android:state_enabled ="true" android:state_checked ="true" android:drawable ="@drawable/home_btn_bg_d" /> < item android:drawable ="@drawable/transparent" /> </ selector > 代码说明: 1. 需要注意的是他这里把TabWidget的Visibility设置成了gone!也就是默认难看的风格不见了:,取而代之的是5个带风格的单选按钮. 2. 注意为单选按钮设置的style,其中最重要的是为其background设置了home_btn_bg.xml,也就是自定义了选中效果。 Java文件 public class MainTabActivity extends TabActivity implements OnCheckedChangeListener{ private TabHostmHost; private IntentmMBlogIntent; private IntentmMoreIntent; private IntentmInfoIntent; private IntentmSearchIntent; private IntentmUserInfoIntent; @Override protected void onCreate(BundlesavedInstanceState){ super .onCreate(savedInstanceState); requestWindowFeature(Window.FEATURE_NO_TITLE); setContentView(R.layout.maintabs); // ~~~~~~~~~~~~初始化 this .mMBlogIntent = new Intent( this ,HomeListActivity. class ); this .mSearchIntent = new Intent( this ,SearchSquareActivity. class ); this .mInfoIntent = new Intent( this ,MessageGroup. class ); this .mUserInfoIntent = new Intent( this ,MyInfoActivity. class ); this .mMoreIntent = new Intent( this ,MoreItemsActivity. class ); initRadios(); setupIntent(); } /** *初始化底部按钮 */ private void initRadios(){ ((RadioButton)findViewById(R.id.radio_button0)).setOnCheckedChangeListener( this ); ((RadioButton)findViewById(R.id.radio_button1)).setOnCheckedChangeListener( this ); ((RadioButton)findViewById(R.id.radio_button2)).setOnCheckedChangeListener( this ); ((RadioButton)findViewById(R.id.radio_button3)).setOnCheckedChangeListener( this ); ((RadioButton)findViewById(R.id.radio_button4)).setOnCheckedChangeListener( this ); } /** *切换模块 */ @Override public void onCheckedChanged(CompoundButtonbuttonView, boolean isChecked){ if (isChecked){ switch (buttonView.getId()){ case R.id.radio_button0: this .mHost.setCurrentTabByTag( " mblog_tab " ); break ; case R.id.radio_button1: this .mHost.setCurrentTabByTag( " message_tab " ); break ; case R.id.radio_button2: this .mHost.setCurrentTabByTag( " userinfo_tab " ); break ; case R.id.radio_button3: this .mHost.setCurrentTabByTag( " search_tab " ); break ; case R.id.radio_button4: this .mHost.setCurrentTabByTag( " more_tab " ); break ; } } } private void setupIntent(){ this .mHost = getTabHost(); TabHostlocalTabHost = this .mHost; localTabHost.addTab(buildTabSpec( " mblog_tab " ,R.string.main_home, R.drawable.icon_1_n, this .mMBlogIntent)); localTabHost.addTab(buildTabSpec( " message_tab " ,R.string.main_news, R.drawable.icon_2_n, this .mInfoIntent)); localTabHost.addTab(buildTabSpec( " userinfo_tab " ,R.string.main_my_info, R.drawable.icon_3_n, this .mUserInfoIntent)); localTabHost.addTab(buildTabSpec( " search_tab " ,R.string.menu_search, R.drawable.icon_4_n, this .mSearchIntent)); localTabHost.addTab(buildTabSpec( " more_tab " ,R.string.more, R.drawable.icon_5_n, this .mMoreIntent)); } private TabHost.TabSpecbuildTabSpec(Stringtag, int resLabel, int resIcon, final Intentcontent){ return this .mHost .newTabSpec(tag) .setIndicator(getString(resLabel), getResources().getDrawable(resIcon)) .setContent(content); } 代码说明 1. 由于TabWidget被隐藏,所以相关的事件也会无效,这里取巧用RadioGroup与RadioButton的特性来处理切换,然后监听事件调用setCurrentTabByTag来切换Activity。 2. 注意即使TabWidget被隐藏,也要为其设置indicator,否则会保持。 三、总结 在这之前如果要做这种效果我恐怕第一时间就会想到用ActivityGroup来做,主要是因为TabHost的TabWidget非常难看,用起来也不方便。其实从源码可以看出,TabActivity也是继承自ActivityGroup,这里结合了单选按钮和TabHost,各取其长,有时间可以专门写一个这样的自定义控件:) 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582149,如需转载请自行联系原作者

优秀的个人博客,低调大师

新浪微博布局学习——活用RelativeLayout

正文 一、效果图 格子布局效果: (图一) 居中正在加载的效果: (图二) 二、实现代码 2.1 实现 图一 效果代码 < RelativeLayout android:id ="@id/rlDigest" android:background ="@drawable/panel_bg" android:layout_width ="fill_parent" android:layout_height ="100.0dip" android:layout_margin ="10.0dip" > < TextView android:textSize ="16.0sp" android:textColor ="#ff7d899d" android:gravity ="center_vertical" android:id ="@id/tvAddress" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_marginLeft ="5.0dip" android:layout_marginTop ="10.0dip" android:text ="@string/userinfo_address" android:layout_alignParentLeft ="true" android:layout_alignParentTop ="true" /> < TextView android:textSize ="16.0sp" android:textColor ="#ff373737" android:id ="@id/tvAddress_content" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_marginLeft ="10.0dip" android:layout_toRightOf ="@id/tvAddress" android:layout_alignTop ="@id/tvAddress" /> < View android:id ="@id/vHDivider" android:background ="@drawable/horizontal_separation_line_repeat" android:layout_width ="fill_parent" android:layout_height ="1.0dip" android:layout_centerVertical ="true" /> < TextView android:textSize ="16.0sp" android:textColor ="#ff7d899d" android:gravity ="center_vertical" android:id ="@id/tvAccount_info" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:text ="@string/account_info" android:layout_below ="@id/vHDivider" android:layout_alignLeft ="@id/tvAddress" android:layout_alignParentBottom ="true" /> < TextView android:textSize ="16.0sp" android:textColor ="#ff373737" android:gravity ="center_vertical" android:id ="@id/tvAccount_info_content" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_marginLeft ="10.0dip" android:layout_marginBottom ="12.0dip" android:singleLine ="true" android:layout_toRightOf ="@id/tvAccount_info" android:layout_alignBottom ="@id/tvAccount_info" /> </ RelativeLayout > < RelativeLayout android:background ="@drawable/panel_bg" android:layout_width ="fill_parent" android:layout_height ="130.0dip" android:layout_margin ="10.0dip" > < View android:id ="@id/vVDivider1" android:background ="@drawable/vertical_separation_line_repeat" android:layout_width ="1.0dip" android:layout_height ="fill_parent" android:layout_centerHorizontal ="true" /> < View android:id ="@id/vHDivider2" android:background ="@drawable/horizontal_separation_line_repeat" android:layout_width ="fill_parent" android:layout_height ="1.0dip" android:layout_centerVertical ="true" /> < RelativeLayout android:id ="@id/llAttention" android:background ="@drawable/bg_panel_above_left" android:clickable ="true" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_toLeftOf ="@id/vVDivider1" android:layout_above ="@id/vHDivider2" android:layout_alignParentLeft ="true" android:layout_alignParentTop ="true" > < TextView android:gravity ="center" android:id ="@id/tvAttention_count" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:layout_marginTop ="10.0dip" android:text ="0" android:layout_centerHorizontal ="true" style ="@style/userinfo_panel_textview_count" /> < TextView android:gravity ="center" android:id ="@id/tvAttention" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:text ="@string/attention" android:layout_below ="@id/tvAttention_count" android:layout_centerHorizontal ="true" style ="@style/userinfo_panel_textview_title" /> </ RelativeLayout > < LinearLayout android:orientation ="vertical" android:id ="@id/rlWeibo" android:background ="@drawable/bg_panel_above_right" android:clickable ="true" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_toRightOf ="@id/vVDivider1" android:layout_above ="@id/vHDivider2" android:layout_alignParentTop ="true" android:layout_alignParentRight ="true" > < TextView android:gravity ="center" android:layout_gravity ="center_horizontal" android:id ="@id/tvWeibo_count" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:layout_marginTop ="10.0dip" android:text ="0" style ="@style/userinfo_panel_textview_count" /> < TextView android:gravity ="center" android:layout_gravity ="center_horizontal" android:id ="@id/tvTopic" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:text ="@string/radio_button_topic" style ="@style/userinfo_panel_textview_title" /> </ LinearLayout > < LinearLayout android:orientation ="vertical" android:id ="@id/llFans" android:background ="@drawable/bg_panel_below_left" android:clickable ="true" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_toLeftOf ="@id/vVDivider1" android:layout_below ="@id/vHDivider2" android:layout_alignParentLeft ="true" android:layout_alignParentBottom ="true" > < TextView android:gravity ="center" android:layout_gravity ="center_horizontal" android:id ="@id/tvFans_count" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:layout_marginTop ="10.0dip" android:text ="0" style ="@style/userinfo_panel_textview_count" /> < TextView android:gravity ="center" android:layout_gravity ="center_horizontal" android:id ="@id/tvFans" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:text ="@string/fans" style ="@style/userinfo_panel_textview_title" /> </ LinearLayout > < LinearLayout android:orientation ="vertical" android:id ="@id/llTopic" android:background ="@drawable/bg_panel_below_right" android:clickable ="true" android:layout_width ="wrap_content" android:layout_height ="wrap_content" android:layout_toRightOf ="@id/vVDivider1" android:layout_below ="@id/vHDivider2" android:layout_alignParentRight ="true" android:layout_alignParentBottom ="true" > < TextView android:gravity ="center" android:layout_gravity ="center_horizontal" android:id ="@id/tvTopic_count" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:layout_marginTop ="10.0dip" android:text ="0" style ="@style/userinfo_panel_textview_count" /> < TextView android:gravity ="center" android:layout_gravity ="center_horizontal" android:id ="@id/tvTopic" android:layout_width ="fill_parent" android:layout_height ="wrap_content" android:text ="@string/his_topics" style ="@style/userinfo_panel_textview_title" /> </ LinearLayout > </ RelativeLayout > 代码说明: 2.1.1 第一个RelativeLayout为图一上的实现代码。注意使用了一个View,也就是一条横线,令其居中布局;"地址:"的TextView通过layout_alignParentLeft和layout_alignParentTop令其在整个RelativeLayout顶左顶上;"账号信息:"的TextView通过layout_below令其位于横线下方,layout_alignLeft令其与"地址:"的TextView左边对齐,然后用layout_alignParentBottom让其居于容器底部。 2.1.2 第二个RelativeLayout为图一下的实现代码。关键是vVDivider1和vVDivider2,与3.1.1类似,画出了一个十字架的布局,然后分别用居左、居上、居下、居右等方式实现了该布局效果。 2.2 实现 图二 效果代码 < RelativeLayout android:id ="@+id/rlpb" android:layout_width ="fill_parent" android:background ="#ffeff0f4" android:visibility ="gone" android:layout_height ="fill_parent" android:layout_weight ="1.0" > < LinearLayout android:layout_centerInParent ="true" android:layout_width ="wrap_content" android:layout_height ="wrap_content" > < ProgressBar android:id ="@+id/prb" style ="?android:attr/progressBarStyleSmallTitle" android:layout_width ="wrap_content" android:layout_height ="wrap_content" /> < TextView android:text ="@string/loadinfo" android:layout_width ="wrap_content" android:layout_height ="wrap_content" /> </ LinearLayout > </ RelativeLayout > 代码说明: 主要是layout_centerInParent属性的应用,令其居于RelativeLayout的中间。使用的时候领ListView先隐藏,然后让这个布局显示并填充,用完在设置Visible为GONE即可。 三、总结 熟练掌握以下重要属性,并灵活运用: android:layout_centerInParent 居中布局 android:layout_centerVertical 水平居中布局 android:layout_centerHorizontal 垂直居中布局 android:layout_alignParentTop 居于容器内顶部 android:layout_alignParentBottom 居于容器内底部 android:layout_alignParentLeft 居于容器内左边 android:layout_alignParentRight 居于容器内右边 android:layout_above 居于指定View的上方 android:layout_below 居于指定View的下方 android:layout_toRightOf 在指定View的右边 android:layout_toLeftOf 在指定View的左边 android:layout_alignTop 与指定View的Top一致 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582146,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册