首页 文章 精选 留言 我的

精选列表

搜索[基础模型],共10008篇文章
优秀的个人博客,低调大师

MySQL实战——基础架构

本文属于个人备忘录,主要是极客时间《MySQL实战45讲》学习笔记。 MySQL架构 MySQL 可以分为 Server 层和存储引擎层两部分。不同的存储引擎共用一个Server层。 Server层 概述 Server层包括 连接器 查询缓存 分析器 优化器 执行器 ... Server层功能 MySQL大多数核心服务功能 所有的内置函数,如日期、时间、数学和加密函数等 跨存储引擎的功能,如存储过程、触发器、视图等 连接器 连接器做什么? 连接器负责跟客户端建立连接、获取权限、维持和管理连接。 连接命令示例 mysql -h$ip -P$port -u$user -p 其中,mysql是客户端工具,用来跟服务端建立连接。在完成经典的 TCP 握手后,连接器就要开始认证你的身份,这个时候用的就是你输入的用户名和密码。 如果用户名或密码不对,会收到"Access denied for user"错误,客户端结束执行 如果用户名密码认证通过,连接器会到权限表里面查出你拥有的权限。之后,这个连接里面的权限判断逻辑,都将依赖于此时读到的权限。 这就意味着,一个用户成功建立连接后,即使你用管理员账号对这个用户的权限做了修改,也不会影响已经存在连接的权限。 权限修改完成后,只有再新建的连接才会使用新的权限设置。 连接完成后,如果没有后续的动作,这个连接就处于空闲状态,可以用show processlist命令看该链接状态。如下。 其中Command列显示为“Sleep”的这一行,就表示现在系统里面有一个空闲连接。 mysql> show processlist; +----+----------+-----------------+---------+---------+--------+-----------+------------------+ | Id | User | Host | db | Command | Time | State | Info | +----+----------+-----------------+---------+---------+--------+-----------+------------------+ | 28 | testuser | localhost:60453 | db_test | Sleep | 8 | | NULL | | 29 | testuser | localhost:53231 | db_test | Query | 0 | starting | show processlist | +----+----------+-----------------+---------+---------+--------+-----------+------------------+ 25 rows in set (0.00 sec) 客户端如果太长时间没动静,连接器会自动断开。这个时间是由参数wait_timeout控制的,默认值是8小时。 mysql> show variables like 'wait_timeout'; +---------------+-------+ | Variable_name | Value | +---------------+-------+ | wait_timeout | 28800 | +---------------+-------+ 1 row in set (0.01 sec) mysql> 如果在连接被断开之后,客户端再次发送请求的话,会收到一个错误:Lost connection to MySQL server during query。这时候如果要继续,就需要重连后再执行请求。 什么是长连接? 长连接:指连接成功后,如果客户端持续有请求,则一直使用同一个连接。 建立连接的过程通常比较复杂,建议使用中要尽量减少建立连接的动作,即尽量使用长连接。 什么是短连接? 短连接:指每次执行完很少的几次查询就断开连接,下次查询再重新建立一个。 长连接的影响 影响 全部使用长连接后,可能会发现,有些时候MySQL占用内存涨得特别快。 如果长连接累积下来,可能导致内存占用太大,被系统强行杀掉(OOM),看起来是MySQL异常重启。 原因 是因为MySQL在执行过程中临时使用的内存是管理在连接对象里面的。这些资源会在连接断开的时候才释放。 解决办法 定期断开长连接。 使用一段时间,或者程序里面判断执行过一个占用内存的大查询后断开连接,之后查询时再重连。 执行mysql_reset_connection重新初始化连接资源 MySQL >= 5.7版本 在每次执行一个比较大的操作后,重新初始化链接资源 这个过程不需要重连和重新鉴权,但是会将连接恢复到刚刚创建完时的状态 查询缓存 连接建立完成后,就可以进行查询了。MySQL接到一个查询请求后,会先查询缓存。 如果语句在缓存中,则其对应的结果会被直接返回给客户端,以提高查询效率。 如果语句不在缓存中,会继续后面的执行阶段。执行完成后,执行结果会被存入查询缓存中。 但是大多数情况下不要使用查询缓存。因为查询缓存往往弊大于利。 查询缓存的失效非常频繁,只要有对一个表的更新,这个表上所有的查询缓存都会被清空。 不使用缓存 对于更新压力大的数据库来说,查询缓存的命中率会非常低。 可使用缓存 业务是一张静态表,很长时间才会更新一次。 比如,一个系统配置表,那这张表上的查询才适合使用查询缓存。 可通过设置参数query_cache_type来设置要不要使用查询缓存。 DEMAND 默认都不使用查询缓存 SQL_CACHE 显式指定使用查询缓存,如 mysql> select SQL_CACHE * from T where ID=10; 通常情况下,该参数设置为OFF,即关闭查询缓存即可。 mysql> show variables like 'query_cache_type'; +------------------+-------+ | Variable_name | Value | +------------------+-------+ | query_cache_type | OFF | +------------------+-------+ 1 row in set (0.00 sec) 注意 MySQL 8.0版本直接将查询缓存的整块功能删掉了,即8.0开始彻底没有这个功能了。 分析器 分析器做什么? 词法分析 识别SQL语句各个字符串是什么、代表什么 语法分析 根据语法规则,判断SQL语句是否满足MySQL语法 如果语句不对,会报“You have an error in your SQL syntax”错误 mysql> elect * from t where ID=1; ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near 'elect * from t where ID=1' at line 1 一般语法错误会提示第一个出现错误的位置,需要关注紧接“use near”的内容。 优化器 优化器做什么? 在表里面有多个索引的时候,决定使用哪个索引 或者在一个语句有多表关联(join)的时候,决定各个表的连接顺序 比如执行下面这样的语句,这个语句是执行两个表的join: mysql> select * from t1 join t2 using(ID) where t1.c=10 and t2.d=20; 两种执行方法 先从表t1里面取出c=10的记录的ID值,再根据ID值关联到表t2,再判断t2里面d的值是否等于20 先从表t2里面取出d=20的记录的ID值,再根据ID值关联到t1,再判断t1里面c的值是否等于10 这两种执行方法的逻辑结果是一样的,但是执行的效率会有不同,而优化器的作用就是决定选择使用哪一个方案。 执行器 分析器:要做什么优化器:怎么做 执行步骤 鉴权 没有:返回无权限错误 有:继续 打开表执行 打开表的时候,执行器就会根据表的引擎定义,去使用这个引擎提供的接口。 有索引查询 第一次调用的是“取满足条件的第一行”这个接口 之后循环调用“满足条件的下一行”这个接口 无索引查询 调用InnoDB引擎接口取这个表的第一行,判断ID值是不是10 如果不是则跳过 如果是则将这行存在结果集中 调用引擎接口取下一行,重复相同的判断逻辑,直到取到这个表的最后一行 执行器将上述遍历过程中所有满足条件的行组成的记录集作为结果集返回给客户端 扫描了多少行? 数据库慢查询日志中有一个rows_examined字段,表示这个语句执行过程中扫描了多少行 这个值就是在执行器每次调用引擎获取数据行的时候累加的 存储引擎层 存储引擎层负责数据的存储和提取 架构模式是插件式的,支持InnoDB、MyISAM、Memory 等多个存储引擎 目前最常用的存储引擎是InnoDB,它从MySQL 5.5.5 版本开始成为了默认存储引擎 比如,执行create table建表时, 如果不指定引擎类型,默认使用的就是 InnoDB 使用engine=memory 来指定内存引擎创建表

优秀的个人博客,低调大师

MongoDB基础知识

微服务流行,我也是越来越喜欢MongoDB了,除非必要要用MySQL,我都会倾向于MongoDB。 MongoDB 什么是MongoDB ? MongoDB 是由C++语言编写的,是一个基于分布式文件存储的开源数据库系统。 在高负载的情况下,添加更多的节点,可以保证服务器性能。 MongoDB 旨在为WEB应用提供可扩展的高性能数据存储解决方案。 MongoDB 将数据存储为一个文档,数据结构由键值(key=>value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。 value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。" title="MongoDB 将数据存储为一个文档,数据结构由键值(key=>value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。" data-original="https://raw.githubusercontent.com/fengwenyi/erwin-learn-note/master/images/MongoDB/mongodb-01.png"> MongoDB特点 MongoDB 是一个面向文档存储的数据库,操作起来比较简单和容易。 你可以在MongoDB记录中设置任何属性的索引 (如:FirstName="Sameer",Address="8 Gandhi Road")来实现更快的排序。 你可以通过本地或者网络创建数据镜像,这使得MongoDB有更强的扩展性。 如果负载的增加(需要更多的存储空间和更强的处理能力) ,它可以分布在计算机网络中的其他节点上这就是所谓的分片。 Mongo支持丰富的查询表达式。查询指令使用JSON形式的标记,可轻易查询文档中内嵌的对象及数组。 MongoDb 使用update()命令可以实现替换完成的文档(数据)或者一些指定的数据字段 。 Mongodb中的Map/reduce主要是用来对数据进行批量处理和聚合操作。 Map和Reduce。Map函数调用emit(key,value)遍历集合中所有的记录,将key与value传给Reduce函数进行处理。 Map函数和Reduce函数是使用Javascript编写的,并可以通过db.runCommand或mapreduce命令来执行MapReduce操作。 GridFS是MongoDB中的一个内置功能,可以用于存放大量小文件。 MongoDB允许在服务端执行脚本,可以用Javascript编写某个函数,直接在服务端执行,也可以把函数的定义存储在服务端,下次直接调用即可。 MongoDB支持各种编程语言:RUBY,PYTHON,JAVA,C++,PHP,C#等多种语言。 MongoDB安装简单。 MongoDB与其他数据库的对比 MongoDB 与 MySQL 由于MongoDB独特的数据处理方式,可以将热点数据加载到内存,故而对查询来讲,会非常快(当然也会非常消耗内存);同时由于采用了BSON的方式存储数据,故而对JSON格式数据具有非常好的支持性以及友好的表结构修改性,文档式的存储方式,数据友好可见;数据库的分片集群负载具有非常好的扩展性以及非常不错的自动故障转移(大赞)。 不足:数据库的查询采用了特有的查询方式,有一定的学习成本(不高);索引不咋滴;锁只能提供到collection级别,还做不到行级锁;没有事务机制(不能回滚啊);学习资料肯定没有MySQL的多。 MongoDB与Hadoop的区别 MongoDB侧重于对数据进行操作的应用系统,而Hadoop则侧重于对数据进行分析统计的应用。 MongoDB能够满足对数据库读写性能具有极高要求的应用场景(很消耗memory的),一般这些应用的响应延迟会要求控制在10ms以下,甚至更低。而Hadoop由于每一次的读写操作会包含大量数据(Hadoop更适合少次操作大批量数据的场景),通过聚集分析处理大量数据,这种分析一般都会走MapReduce,会造成很高的延迟(数分钟到数小时不等) MongoDB查询 查询语法 db.collection.find(query, projection).pretty() collection:文档名称,或者可写成 getCollection('col_name') query :可选,使用查询操作符指定查询条件 projection:可选,使用投影操作符指定返回的键。查询时返回文档中所有键值, 只需省略该参数即可(默认省略)。 pretty():易读 条件语法 操作 格式 范例 等于 {<key>:<value>} db.col.find({"by":"菜鸟教程"}).pretty() 小于 {<key>:{$lt:<value>}} db.col.find({"likes":{$lt:50}}).pretty() 小于或等于 {<key>:{$lte:<value>}} db.col.find({"likes":{$lte:50}}).pretty() 大于 {<key>:{$gt:<value>}} db.col.find({"likes":{$gt:50}}).pretty() 大于或等于 {<key>:{$gte:<value>}} db.col.find({"likes":{$gte:50}}).pretty() 不等于 {<key>:{$ne:<value>}} db.col.find({"likes":{$ne:50}}).pretty() AND语法 db.col.find({key1:value1, key2:value2}).pretty() OR语法 db.col.find( { $or: [ {key1: value1}, {key2:value2} ] } ).pretty() AND 与 OR db.col.find( { key1: value1, $or: [ {key2: value2}, {key3: value3} ] } ).pretty() limit() 该参数指定从MongoDB中读取的记录条数。 db.col.find().limit(NUMBER) skip() 跳过指定数量的数据 db.col.find().limit(NUMBER).skip(NUMBER) 排序 db.col.find().sort({KEY:1}) 聚合 db.col.aggregate(AGGREGATE_OPERATION) 举例:现在我们通过以上集合计算每个作者所写的文章数,使用aggregate()计算结果如下: db.mycol.aggregate([{$group : {_id : "$by_user", num_tutorial : {$sum : 1}}}]) 与sql相同: select by_user, count(*) from mycol group by by_user 管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的参数。 MongoDB的聚合管道将MongoDB文档在一个管道处理完毕后将结果传递给下一个管道处理。管道操作是可以重复的。 表达式:处理输入文档并输出。表达式是无状态的,只能用于计算当前聚合管道的文档,不能处理其它的文档。 这里我们介绍一下聚合框架中常用的几个操作: $project:修改输入文档的结构。可以用来重命名、增加或删除域,也可以用于创建计算结果以及嵌套文档。 $match:用于过滤数据,只输出符合条件的文档。$match使用MongoDB的标准查询操作。 $limit:用来限制MongoDB聚合管道返回的文档数。 $skip:在聚合管道中跳过指定数量的文档,并返回余下的文档。 $unwind:将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值。 $group:将集合中的文档分组,可用于统计结果。 $sort:将输入文档排序后输出。 $geoNear:输出接近某一地理位置的有序文档。

优秀的个人博客,低调大师

Java基础——分支语句

分支语句主要包括以下几种结构: if、 if-else、 多重if、 嵌套if、 switch 下面详细解释一下各个语句的结构和使用示例。1、if // 单纯的if结构 /* * if(条件){ * 内容 * } */ int num = 3; if (num >= 0) { System.out.println("if结构"); } if(false == 2>=4){ System.out.println("1"); } 2、if-else // if-else结构 /* * if(条件){ * 内容 * }else{ * 内容 * } */ int rank = 2; if (rank==1) { System.out.println("啥奖励都有!"); }else { System.out.println("奖励你一巴掌!"); } 3、多重if // if-else if-else结构 /* * if(条件1){ * 内容1 * }else if(条件2){ * 内容2 * }else if(条件3){ * 内容3 * }else{ * 内容4 * } */ if(a==0) { System.out.println("a=0"); }else if(a==1) { System.out.println("a==1"); }else if(a==2){ System.out.println("a=2"); }else{ System.out.println("a>2"); } 4、嵌套if //嵌套if语句 /* * if(条件1){ * if(条件2){ * 内容 * } * } */ if (isFull==false) { if (a==2) { System.out.println("嵌套if"); } } 5、switch // switch 语句 /* * switch(变量){ * case 值1: * 内容1 * break; * case 值2: * 内容2 * break; * default: * 内容3 * break; * } */ switch (a) { case 0: System.out.println(0); break; case 1: System.out.println(1); break; case 2: System.out.println(2); break; default: System.out.println("啥都没有"); break; } 接下来是几个个人练习使用示例:练习1 题目描述: 如果你有500w以上可以在四环以内买房, 如果你有200w到500w之间可以在四环到五环买房, 如果你有100w到200w你可以在五环外买房, 如果有10000到100w之间可以租房住, 如果连1w都不到那你只能露宿街头了... 练习2每周一次的大扫除开始了, 老师对同学们做了如下安排: 一米七以上的男生挑水,一米七以上的女生擦玻璃,一米七以下的男生墩地,一米七以下的女生擦桌子请按照要求编写一个程序来分配班级人员的工作分组 练习1参考: public class Exercise06 { public static void main(String[] args) { Scanner in = new Scanner(System.in); int money = in.nextInt(); if (money>=5000000) { System.out.println("四环以内买房!"); }else if (money >= 2000000) { System.out.println("四环到五环"); }else if (money >= 1000000) { System.out.println("五环外"); }else if (money >= 10000) { System.out.println("租房"); }else { System.out.println("露宿街头"); } } } 练习2参考: public class Exercise07 { public static void main(String[] args) { Scanner in = new Scanner(System.in); System.out.println("please input height:"); int height = in.nextInt(); System.out.println("please input sex:"); String sex = in.next(); if (height>=170) { if (sex.equals("男")) { System.out.println("一米七以上的男的去挑水吧"); }else{ System.out.println("一米七以上的女的去擦玻璃吧"); } }else { if (sex.equals("男")) { System.out.println("一米七以下的男的去墩地吧"); }else{ System.out.println("一米七以下的女的去擦桌子吧"); } } } } 欢迎大家指导交流!

优秀的个人博客,低调大师

(二)Docker基础概念

基本概念 Docker 包括三个基本概念 镜像(Image) 容器(Container) 仓库(Repository) 理解了这三个概念,就理解了 Docker 的整个生命周期。 然后是安装 Docker 镜像 我们都知道,操作系统分为内核和用户空间。对于 Linux 而言,内核启动后,会挂 载 root 文件系统为其提供用户空间支持。而 Docker 镜像(Image),就相当于 是一个root 文件系统。比如官方镜像Ubuntu14.04就包含了完整的一套Ubuntu 14.04 最小系统的root文件系统。 分层存储 因为镜像包含操作系统完整的root件系统,其体积往往是庞大的,因此在 Docker 设计时,就充分利用 Union FS 的技术,将其设计为分层存储的架构。所以 严格来说,镜像并非是像一个 ISO 那样的打包文件,镜像

优秀的个人博客,低调大师

Javascript基础之-Promise

Promise是什么呢?根据ecma-262的定义: Promise是一个被用于延时计算的最终结果的占位符 (A Promise is an object that is used as a placeholder for the eventual results of a deferred (and possibly asynchronous) computation.) 这个怎么理解呢 比如说,我要去麦当劳买点吃的,下单以后人家会先给你一个订单号,等人家外卖做好了,会提示你,并用那个订单小票来换取你真正的食物,在这时候,那个订单小票就是你这顿饭的占位符。 回到Promise,它有三种状态,分别为完成,拒绝和待决议, 而待决议的状态代表它还没有被完成或者是拒绝,也就是说,如果它一直都是处于待决议的状态,意味着代码永远都不会继续往下执行 所以下面这段代码永远都执行不到finish new Promise((resolve, reject) => { console.log('waiting'); document.writeln('waiting'); }).then((msg) => { console.log('finish'); }); 也就是意味着,必须显示的执行resolve()或者是reject,程序才会继续往下执行。 那怎么解决这个问题呢,其实很简单,决议一下就好了嘛,哈哈~~ 或者给Promise设置一个超时时间,看下面的代码: function timeoutPromise(delay) { return new Promise( function(resolve,reject){ setTimeout( function(){ reject( "Timeout!" ); }, delay ); } ); } Promise.race([ new Promise(() => { console.log('waiting...'); }), timeoutPromise(3000) ]).catch((msg) => { console.log(msg); }) 这段代码呢,会先等待5秒,然后会打印出一个错误"Timeout",在这里,Promise.race()实际上就是竞态的,谁先决议,其余的就会被抛弃。所以咱们三秒钟后决议一个拒绝,剩下那个promise自动被抛弃了 说到错误处理了,思考下面的代码: new Promise((resolve, reject) => { foo.bar(); }).then((msg) => { console.log(msg); }, null).then((msg) => { console.log(msg); }, (err) => { console.log(err); }); 这段代码,很明显foo不是对象,所以会报ReferenceError,所以呢,会自动决议为reject,然后他紧接着的那个then没有拒绝处理回调,然后接着往下传递错误,直到有reject回调为止,假如一直都没有reject回调呢,他就会在全局抛出一个未捕获的异常。 那么如果在Promise决议多次呢,实际上只有第一次决议生效,也就是说,只能有一种决议生效,又成功又失败,或者成功多次,失败多次听着就不靠谱是吧,思考下面的代码 new Promise((resolve, reject) => { resolve(); reject(); console.log('exec finish'); }).then((msg) => { console.log('resolve'); }, (err) => { console.log('reject'); }); 运行结果是输出exec finish 和resolve,因为第一次决议为resolve, 所以reject决议就被抛弃了 大家想一下,决议后对应的then里面的回调函数是同步还是异步的呢,思考下面这个问题: console.log(0); let p = new Promise((resolve, reject) => { console.log(1); resolve(); console.log(2); }) console.log(3); p.then((msg) => { console.log(4); }); console.log(5); 他的结果是 1 2 3 5 4 答案很显然啦,是异步的!实际上当决议以后,就会把它放到一个异步队列里调用 那为什么要这么设计呢,会给我们带来什么好处呢,思考下面这个问题 function getResult() { console.log(a); } function opt() { if (isAsync) { setTimeout(() => { getResult(); }, 0); } else { getResult(); } } var a = 0; var isAsync = false; opt(); a++; isAsync = true; opt(); a++; 他的结果输出的是0 2,那为什么不是0, 1,实际上就是因为由于同步和异步的的不确定性导致的,也叫zalgo,所以呢,要想消除他们的不确定性,必须就让他里面的代码要么都是同步,要么都是异步,这也是then为什么是异步的原因了 关于then,还有一个问题,就是then的返回值是什么,来继续看问题 var p = Promise.resolve( 21 ); var p2 = p.then( function(v){ return v * 2; }); console.log(p2); 通过他的结果,你很容易就能看出来,then的返回值是一个Promise,那么,这个then回调是不是可以这么理解呢? function callback() { return Promise.resolve(42); } 如果是的话,那么咱们就研究一下Promise.resolve()的特性,然后then()同理就可以是吧 那么我们现在就研究一下Promise.resolve()的一些特性: 如果向Promise.resolve()传递一个非Promise,非thenable的立即值,就会立即得到这个值填充的Promise,这个有三个关键字,非Promise,非thenable和立即值 如果向Promise.resolve()传递一个真正的promise,那么就会返回这个Promise,又一个例子,很好理解 var p = Promise.resolve(42); var p2 = Promise.resolve(p); console.log(p === p2); // true 如果向Promise.resolve()传递一个非Promise的thenable值,那么就会展开这个值,并且在展开过程会持续到提取出一个具体的Promise最终值 大家应该会有一点疑惑,thenable是什么,这段话是什么意思 var obj = { then(resolve, reject) { resolve(42); } }; Promise.resolve(obj).then((msg) => { console.log(msg); //42 }); 好了,Promise.resolve()特性讲完了,then返回值同理 同理完了以后呢,就会出现一些比较有意思的用法 首先就是链式调用,比如说 var p = Promise.resolve( 21 ); var p2 = p.then( function(v){ console.log( v ); // 21 // 用值42填充p2 return v * 2; } ); // 连接p2 p2.then( function(v){ console.log( v ); // 42 } ); 很简单吧,就不赘述了。 还有一个比较有意思,就是Promise实现同步执行,也就是前一个then如果是异步的话,它必须操作完成后,才会执行后面的then,常见的写法是这样的 new Promise((resolve, reject) => { setTimeout(() => { console.log('exec in promise it'); resolve(); }, 1000); }).then(() => { return new Promise((resolve, reject) => { setTimeout(() => { console.log('exec in then it'); resolve(); }, 1000); }); }); 这个先过一秒输出第一句话,再过一秒输出第二句话 这个的原理实际上刚刚Promise.resolve()的第二条,如果返回的是Promise,那么会直接返回这个Promise,在这里,直接返回return的这个Promise后,就会等待这个Promise决议,在一秒后决议完,就执行后面的then 最后一个有关then的知识点了: 一个Promise决议后,这个Promise上所有的通过then()注册的回调都会在下一个异步时间节点上依次被立即调用,这些回掉中任意一个都无法影响或者延误对其他回调的调用 var p = new Promise((resolve, reject) => { resolve(); }); p.then( function(){ p.then( function(){ console.log( "C" ); } ); console.log( "A" ); } ); p.then( function(){ console.log( "B" ); } ); // a b c 这个的重点实际上是这些决议回调都被加入到了一个队列中,输出的顺序正好实际上就代表了他们加入队列后的先后顺序 参考书籍《你不知道的Javascript中卷》本文转载自http://www.lht.ren/article/3/

优秀的个人博客,低调大师

Java基础学习1

1Java的数据类型 l基本类型(8种) l引用类型 2八种基本类型 byte 1 -128到127,-27到27-1 short 2 -215到215-1 int 4 -231到231-1 long 8 -263到263-1 float 4 单精度 IEEE 754规范 美国电子电气工程师协会浮点数表示规范 double 8 双精度 char 2 0到65535 0到216-1 boolean 1 真true00000001 假false00000000 2.1计算机的存储单位 lbit -比特,电位 lbyte -字节,8bit lKb - 1024 byte lMb - 1024 Kb lGb - 1024 Mb lTb - 1024 Gb lPb - 1024 Tb 2.2二进制 lbyte 10000000-128 ... 11111100-4 11111101-3 11111110-2 11111111-1 000000000 000000011 000000102 000000113 000001004 000001015 000001106 000001117 000010008 ... 01111111127 84608 8*104 4*103 6*102 8*100 11011 24 23 21 20 853 8530 85300 110 1100 11000 674 除2取余法 674 /2337余0 337 /2168余1 168 /284余0 84 /242余0 42 /221余0 21 /210余1 10 /25余0 5 /22余1 2 /21余0 1 /20余1 11 102 1004 10008 1000016 10000032 100000064 10000000128 100000000256 1000000000512 100000000001024 1000个苹果,分装机箱, 不管客户要多少苹果,都可以整箱交付 变量交换 //项目:变量交换 package; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { //提示输入 System.out.print("输入整数a:"); //获得输入的值,保存到变量a inta=newScanner(System.in).nextInt(); System.out.print("输入整数b:"); intb=newScanner(System.in).nextInt(); //变量交换,三步转圈赋值 intc=a; a=b; b=c; System.out.println("a = "+a); System.out.println("b = "+b); } } 自由落体距离 //项目:自由落体距离 package; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.println("输入降落时间(秒):"); //获得输入的值,保存到变量t doublet= newScanner(System.in).nextDouble(); //调用f()方法 //把时间t的值,传递到f()方法计算 //得到f()方法的计算结果,保存到变量d doubled=f(t); System.out.println(t+"秒降落了"+d+"米"); } staticdoublef(doublet) { doubled= 0.5*9.8*t*t; returnd;//把计算结果返回到上面调用位置 } } 2.3char类型(2字节) l字符、字符的整数编码 Unicode编码表 0 nil 1 ? 2 ? 3 ? ... 97 a 98 b ... 20013 中 ... 65535 lchar c1 = 97 char c2 = 'a' 2.4基本类型的字面值(5条规则) 1.整数字面值是int类型 int a = 56456; //右侧字面值是int类型,但超出int范围 long a =9999999999; 2.byte,short,char三种比int小的整数,可以用范围内的值,直接赋值 //右侧是byte,不是int byte a = 127; //右侧是int byte a =128; 3.浮点数字面值是double类型 double a = 3.14; //右侧是double,不是float float a =3.14; 4.字面值后缀 L - long long a = 9999999999L; F - float float a = 3.14f; D - double double a = 3.0; double a = 3d; 5.进制前缀 16进制: 两个16进制字符,可以表示一个字节 8进制: 1个8进制字符,可以表示3位 0x - 16进制 0xff255 0- 8进制 0377255 \u - char类型16进制 必须表示char类型完整的两个字节值 'a''\u0061' '中''\u4e2d' 2.5基本类型的运算规则(5条规则) 1.计算结果的数据类型,与最大的类型一致 3/2得1 3d/2得1.5 2.byte,short,char比int小的整数,运算时,会自动转成int byte a = 3; byte b = 4; //错,右侧是int+int,结果是int byte c = a+b; 3.整数运算溢出 Integer.MAX_VALUE+1 得负数最小值 300000000*60*60*24*365 300000000L*60*60*24*365 01111111111111111111111111111111 +1 10000000000000000000000000000000 4.浮点数运算不精确 2-1.9 得0.10000000000000009 4.35*100 得434.9999999999999999994 Java中有精确运算方法,后面会讲 5.浮点数的特殊值 nInfinity(无穷大) 3.14/0 Double.MAX_VALUE*2 nNaN(Not a Number) Math.sqrt(-3) 2.6基本类型的类型转换 l小的类型转成大的类型 byte a = 127; int b = a; 01111111 00000000 00000000 0000000001111111 byte a = -1; int b = a; 11111111 11111111 11111111 1111111111111111 l大的类型转成小的类型 n必须强制转型 int a = 356; byte b = (byte) a; 00000000 00000000 0000000101100100 01100100 牛郎织女 两颗星相距16.4光年 光速299792458米/秒 喜鹊身长0.46米 牛郎织女相会,需要多少只喜鹊 //项目:牛郎织女 package; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.println("两颗星相距16.4光年"); System.out.println("光速299792458米/秒"); System.out.println("喜鹊身长0.46米"); System.out.println("牛郎织女相会,需要多少只喜鹊"); //1光年是多少米 longly= 299792458L*60*60*24*365; //16.4光年是多少米 doubled=ly*16.4; //求喜鹊数量 doubler=d/0.46; //向上取整 //Math.ceil(r) //取整结果是double类型6436345.0 longn= (long) Math.ceil(r); System.out.println(n); } } 3运算符 +-*/ + 数学运算 字符串的连接运算 % 取余、求模 判断变量a能否被4整除, a%4余数是0 == != 相等 不相等 > >= < <= 大小比较 && 逻辑与 左边是真,并且右边是真,结果是真 短路与,左边是假,右边忽略不执行 || 逻辑或 左边是真,或者右边是真,结果都是真 短路或,左边是真,右边忽略不执行 ! 非 非真是假,非假是真 对布尔值做相反判断 判断“非a”是真,即a是假 if(!a) { } & 位与 两位都是1结果是1 | 位或 有一位是1,结果就是1 ^ 异或 不同是1 对同一个值异或两次,得到原值 ~ 求反 1变0,0变1 >> 带符号向右移位 符号位是0,左边补0 符号位是1,左边补1 >>> 不带符号向右移位 不管符号位是0还是1,左边都补0 << 向左移位 ++ -- 自增1、自减1 int a=5 print(a++)先取值后自增 1)先取出a的原值等待打印 2)a自增变成6 3)打印原值5 int a=5 print(++a)先自增后取值 1)a自增变成6 2)取出a的新值等待打印 3)打印a的新值6 ? : 三项运算 1 ? 2 : 3 1是真,取2的值 1是假,取3的值 = 赋值 += ^= >>= ... 复合的赋值运算 a += 2; //a = a+2; 自动转型 byte a = 2; a = (byte) (a+2); a += 2; a += 3.94; () 转型运算 l向右移1位相当于除2 l向左移1位相当于乘2 3.1运算符优先级 l不用记优先级表,多加小括号 (1+(2-3))*4/5 平年闰年 输入年号,显示是平年还是闰年 闰年条件: *)能被4整除,并且不能被100整除 *)能被400整除 2000 1000 2016 2018 //平年闰年 package; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.print("输入年号:"); inty=newScanner(System.in).nextInt(); //调用runNian()方法 //对年号y的值判断是否闰年 //该方法返回boolean值 if(runNian(y)) { System.out.println("闰年"); }else{ System.out.println("平年"); } } staticbooleanrunNian(inty) { booleanrun=false;//假设不是闰年 /*if(y%4 == 0) {//能被4整除 //能被4整除的情况下 if(y%100 != 0) {//再判断不能被100整除 run = true; } } if(y%400 == 0) {//能被400整除 run = true; }*/ if((y%4==0 &&y%100 != 0) ||y%400==0) { run=true; } returnrun; } } 3.2位运算 00000000000000000000000001110011 00000000000000000000000001010101 & ---------------------------------- 00000000000000000000000001010001 00000000000000000000000001110011 00000000000000000000000001010101 | ---------------------------------- 00000000000000000000000001110111 00000000000000000000000001110011 00000000000000000000000001010101 ^ ---------------------------------- 00000000000000000000000000100110 00000000000000000000000001110011 ~ ---------------------------------- 11111111111111111111111110001100 00000000000000000000000001110011>>2 00000000000000000000000000011100 10000000000000000000000001110011>>2 11100000000000000000000000011100 10000000000000000000000001110011>>>2 00100000000000000000000000011100 10000000000000000000000001110011<<2 00000000000000000000000111001100 位运算 10011001100001001011100011110011 10011001 10000100 10111000 11110011 r 10011001100001001011100000000000 11111111 11111111 11111111 11110011 //项目:int拆分4字节 package*; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.print("输入整数:"); //获得输入的值,保存到变量n intn=newScanner(System.in).nextInt(); /* * n向右移动24,16,8,0位 *再强转成byte类型 *分别保存到b1,b2,b3,b4变量 *再打印显示 */ byteb1= (byte) (n>>24); byteb2= (byte) (n>>16); byteb3= (byte) (n>>8); byteb4= (byte) (n>>0); System.out.println(b1); System.out.println(b2); System.out.println(b3); System.out.println(b4); // intr= 0; /* * b1,b2,b3,b4 *左移24位, *再不带符号右移0,8,16,24位 *结果再与r求或,保存到r */ //r = r | (b1<<24>>>0); //r = r | (b2<<24>>>8); //r = r | (b3<<24>>>16); //r = r | (b4<<24>>>24); /* * b1,b2,b3,b4 *对0x000000ff求与 *再左移24,16,8,0位 *结果再与r求或,保存到r */ r=r| ((b1& 0x000000ff) << 24); r=r| ((b2& 0x000000ff) << 16); r=r| ((b3& 0x000000ff) << 8); r=r| ((b4& 0x000000ff) << 0); System.out.println(r); } } 三个整数的最大值 项目:day0108_三个数最大值 类:day0108.Test1 packageday0108; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.println("输入三个整数"); inta=newScanner(System.in).nextInt(); intb=newScanner(System.in).nextInt(); intc=newScanner(System.in).nextInt(); //a,b的最大值保存到max //max,c的最大值保存到max //intmax = a>b ? a : b; //max = max>c ? max : c; intmax=a>b? (a>c?a:c) : (b>c?b:c); System.out.println("最大值:"+max); } }

优秀的个人博客,低调大师

Go基础语法(一)

image.png 先讲一下,写这种笔记的目的: 自己在学的过程中能一字一句读下来并且写出来,便于理解加深记忆,这样做比只看教程记忆会更加深刻。 当我某些细的点遗忘的时候我可以快速查询,因为笔记是我自己写的我知道知识点写在哪部分。 可以分享出来给其他热爱go的入门者或者在上学的同学看,因为这边记录的是把官方内容精简了些。 什么是Golang Go 亦称为 Golang(译注:按照 Rob Pike 说法,语言叫做 Go,Golang 只是官方网站的网址),是由谷歌开发的一个开源的编译型的静态语言。 Golang 的主要关注点是使得高可用性和可扩展性的 Web 应用的开发变得简便容易。(译注:Go 的定位是系统编程语言,只是对 Web 开发支持较好) Go 语言一些优点: 并发是语言的一部分(并非通过标准库实现),所以编写多线程程序会是一件很容易的事。后续教程将会讨论到,并发是通过 Goroutines 和 channels 机制实现的。 Golang 是一种编译型语言。源代码会编译为二进制机器码。而在解释型语言中没有这个过程,如 Nodejs 中的 Python。 语言规范十分简洁。所有规范都在一个页面展示,你甚至都可以用它来编写你自己的编译器呢。 Go 编译器支持静态链接。所有 Go 代码都可以静态链接为一个大的二进制文件(译注:相对现在的磁盘空间,其实根本不大),并可以轻松部署到云服务器,而不必担心各种依赖性。 安装 Mac OS 官网下载https://golang.org/dl/ 安装程序。双击开始安装,会将 Golang 安装到 /usr/local/go 目录下,同时 /usr/local/go/bin 文件夹也会被添加到 PATH 环境变量中。 (这里只介绍Mac OS下的安装,其他平台请自行查阅) 建立工作区 在 Mac 或 Linux 操作系统下,Go 工作区应该设置在 $HOME/go。所以我们要在 $HOME 目录下创建 go 目录。 也可以通过设置 GOPATH ,用其他目录来作为工作区。我这边使用的ide是这个 image.png 设置GOPATH的方式: image.png 所有 Go 源文件都应该放置在工作区里的 src 目录下。请在刚添加的 go 目录下面创建目录 src。 所有 Go 项目都应该依次在 src 里面设置自己的子目录。我们在 src 里面创建一个目录 hello 来放置整个 hello 项目。 创建上述目录之后,其目录结构如下: go src hello hello.go hello.go中写入代码: package main import "fmt" func main() { fmt.Println("Hello World") } 使用命令go run hello.go名运行: image.png 使用 go install hello 命令 当你输入 go install hello 时,go 工具会在工作区中搜索 hello 包。接下来它会在工作区的 bin 目录下,创建一个名为 hello(Windows 下名为 hello.exe)的二进制文件。运行 go install hello 后,其目录结构如下所示: go bin hello src hello hello.go 代码中第一行: package main ,每一个 Go 文件都应该在开头进行 package name 的声明(译注:只有可执行程序的包名应当为 main)。包(Packages)用于代码的封装与重用,这里的包名称是main。 变量 变量:变量指定了某存储单元(Memory Location)的名称,该存储单元会存储特定类型的值。在 Go 中,有多种语法用于声明变量。 package main import ( "fmt" "math" ) func main() { var age int // 变量声明 fmt.Println("my age is", age) age = 10 //变量赋值 fmt.Println("my age is", age) age = 30 //变量赋值 fmt.Println("my age is", age) var name string = "allen" // 声明变量并初始化 fmt.Println("my name is", name) var num = 29 // 可以推断类型 fmt.Println("my num is", num) var width, height int = 100, 50 // 声明多个变量 fmt.Println("width is", width, "height is", height) var a, b int //省略初始化,默认值为0 fmt.Println("width is", a, "height is", b) //一个语句中声名不同类型变量 var ( c = "jie" d = 24 e int ) fmt.Println("my c is", c, ", d is", d, "and e is", e) m, n := "allen", 29 // 简短声明 fmt.Println("m name is", m, "n is", n) //变量也可以在运行时进行赋值 q, p := 145.8, 543.8 e1 := math.Min(q, p) fmt.Println("minimum value is ", e1) } 声明单个变量 :var name type 声明变量并初始化 : var name type = initialvalue 类型推断(Type Inference) : 如果变量有初始值,那么 Go 能够自动推断具有初始值的变量的类型。因此,如果变量有初始值,就可以在变量声明中省略 type。例:var name = initialvalue 声明多个变量 : var name1, name2 type = initialvalue1, initialvalue2。 一个语句中声明不同类型的变量 : var ( name1 = initialvalue1, name2 = initialvalue2 ) 简短声明 : name := initialvalue, 简短声明要求 := 操作符左边的所有变量都有初始值。 简短声明的语法要求 := 操作符的左边至少有一个变量是尚未声明的。 由于 Go 是强类型(Strongly Typed)语言,因此不允许某一类型的变量赋值为其他类型的值。 类型 基本类型: bool 数字类型 int8, int16, int32, int64, int uint8, uint16, uint32, uint64, uint float32, float64 complex64, complex128 byte rune string 有符号整型: image.png int:根据不同的底层平台(Underlying Platform),表示 32 或 64 位整型。除非对整型的大小有特定的需求,否则你通常应该使用 int 表示整型。 在 Printf 方法中,使用%T打印变量类型。 Go 的 unsafe 包提供了一个 Sizeof 函数,该函数接收变量并返回它的字节大小。 func main() { a := true b := false fmt.Println("a:", a, "b:", b) c := a && b //仅当 a 和 b 都为 true 时,操作符 && 才返回 true fmt.Println("c:", c) d := a || b //当 a 或者 b 为 true 时,操作符 || 返回 true fmt.Println("d:", d) var a1 int = 89 b1 := 95 fmt.Println("a1 is", a1, "and b is", b1) fmt.Printf("type of a is %T, size of a is %d", a1, unsafe.Sizeof(a1)) // a 的类型和大小 fmt.Printf("\ntype of b is %T, size of b is %d", b1, unsafe.Sizeof(b1)) // b 的类型和大小 } 在32位系统下,字节大小为4,64位下,字节大小为8。 无符号整型 image.png uint:根据不同的底层平台,表示 32 或 64 位无符号整型。 浮点型 float32:32 位浮点数 float64:64 位浮点数 package main import ( "fmt" ) func main() { a, b := 5.67, 8.97 //a 和 b 的类型根据赋值推断得出,float64 是浮点数的默认类型 fmt.Printf("type of a %T b %T\n", a, b) sum := a + b diff := a - b fmt.Println("sum", sum, "diff", diff) no1, no2 := 56, 89 fmt.Println("sum", no1+no2, "diff", no1-no2) } a 和 b 的类型根据赋值推断得出,float64 是浮点数的默认类型。 复数类型 complex64:实部和虚部都是 float32 类型的的复数。 complex128:实部和虚部都是 float64 类型的的复数。 其他数字类型 byte 是 uint8 的别名。 rune 是 int32 的别名。 string 类型 在 Golang 中,字符串是字节的集合。如果你现在还不理解这个定义,也没有关系。我们可以暂且认为一个字符串就是由很多字符组成的。后面会在一个教程中深入学习字符串。 package main import ( "fmt" ) func main() { first := "Zhao" last := "Alle" name := first +" "+ last fmt.Println("My name is",name) } 类型转换 Go 有着非常严格的强类型特征。Go 没有自动类型提升或类型转换。 package main import ( "fmt" ) func main() { i := 55 //int j := 67.8 //float64 sum := i + int(j) //j is converted to int fmt.Println(sum) q := 10 var w float64 = float64(q) // 若没有显式转换,该语句会报错 fmt.Println("w", w) } 把 v 转换为 T 类型的语法是 T(v)。 赋值的情况也是如此。把一个变量赋值给另一个不同类型的变量,需要显式的类型转换。 常量 定义:在 Go 语言中,术语"常量"用于表示固定的值。 使用关键字 const 表示常量。 package main func main() { const a = 55 // 允许 a = 89 // 不允许重新赋值 } 常量不能再重新赋值为其他的值。因此上面的代码将不能正常工作,它将出现一个编译错误: cannot assign to a 常量的值会在编译的时候确定。因为函数调用发生在运行时,所以不能将函数的返回值赋值给常量。 字符串常量 const a = "Hello World" 上面的例子,我们把 Hello World 分配给常量 a。现在常量 a 是没有类型的。 无类型的常量有一个与它们相关联的默认类型(上边默认类型是string),并且当且仅当一行代码需要时才提供它。在声明中 var b = "Sam" , b 需要一个类型,它从字符串常量 Sam 的默认类型中获取。 创建一个带类型的常量:const c string = "Hello World" 常量c就是一个string类型的。 Go 是一个强类型的语言,在分配过程中混合类型是不允许的。 布尔常量 布尔常量和字符串常量用法相同,他们是两个无类型的常量 true 和 false。 package main func main() { const trueConst = true type myBool bool var defaultBool = trueConst // 允许 var customBool myBool = trueConst // 允许 defaultBool = customBool // 不允许 } 数字常量 包含整数、浮点数和复数的常量 func main() { const a = 5 var intVar int = a var int32Var int32 = a var float64Var float64 = a var complex64Var complex64 = a fmt.Println("intVar",intVar, "\nint32Var", int32Var, "\nfloat64Var", float64Var, "\ncomplex64Var",complex64Var) } 常量a 的值是 5 ,a 的语法是通用的(它可以代表一个浮点数、整数甚至是一个没有虚部的复数),因此可以将其分配给任何兼容的类型。这些常量的默认类型可以被认为是根据上下文在运行中生成的。 var intVar int = a 要求 a 是 int,所以它变成一个 int 常量。 var complex64Var complex64 = a 要求 a 是 complex64,因此它变成一个复数类型。 数字表达式 func main() { var a = 5.9/8 fmt.Printf("a's type %T value %v",a, a) } 在上面的程序中, 5.9 在语法中是浮点型,8 是整型,5.9/8 是允许的,因为两个都是数字常量。除法的结果是 0.7375 是一个浮点型,所以 a 的类型是浮点型。 如果内容对你有帮助,记得关注作者给个赞哦~,后续会持续更新。

优秀的个人博客,低调大师

网络编程基础篇

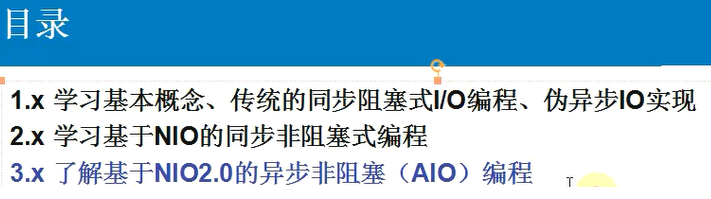
传统的BIO编程,服务器的主线程需要先阻塞,然后等待客户端的请求才去创建线程执行。一般分为两个部分,client和server。在网络良好的情况下,一般没有什么问题,但是网络不好的情况,会导致效率很低。 Server.java package bhz.bio; import java.io.IOException; import java.net.ServerSocket; import java.net.Socket; public class Server { final static int PROT = 8765; public static void main(String[] args) { ServerSocket server = null; try { server = new ServerSocket(PROT); System.out.println(" server start .. "); while(true){ //进行阻塞 Socket socket = server.accept(); //新建一个线程执行客户端的任务 new Thread(new ServerHandler(socket)).start(); } } catch (Exception e) { e.printStackTrace(); } finally { if(server != null){ try { server.close(); } catch (IOException e) { e.printStackTrace(); } } server = null; } } } Client.java package bhz.bio; import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import java.io.PrintWriter; import java.net.Socket; public class Client { final static String ADDRESS = "127.0.0.1"; final static int PORT = 8765; public static void main(String[] args) { Socket socket = null; BufferedReader in = null; PrintWriter out = null; try { socket = new Socket(ADDRESS, PORT); in = new BufferedReader(new InputStreamReader(socket.getInputStream())); out = new PrintWriter(socket.getOutputStream(), true); //向服务器端发送数据 out.println("接收到客户端的请求数据..."); String response = in.readLine(); System.out.println("Client: " + response); } catch (Exception e) { e.printStackTrace(); } finally { if(in != null){ try { in.close(); } catch (IOException e) { e.printStackTrace(); } } if(out != null){ try { out.close(); } catch (Exception e) { e.printStackTrace(); } } if(socket != null){ try { socket.close(); } catch (IOException e) { e.printStackTrace(); } } socket = null; } } } ServerHandler.java package bhz.bio; import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import java.io.PrintWriter; import java.net.Socket; public class ServerHandler implements Runnable{ private Socket socket ; public ServerHandler(Socket socket){ this.socket = socket; } @Override public void run() { BufferedReader in = null; PrintWriter out = null; try { in = new BufferedReader(new InputStreamReader(this.socket.getInputStream())); out = new PrintWriter(this.socket.getOutputStream(), true); String body = null; while(true){ body = in.readLine(); if(body == null) break; System.out.println("Server :" + body); out.println("服务器端回送响的应数据."); } } catch (Exception e) { e.printStackTrace(); } finally { if(in != null){ try { in.close(); } catch (IOException e) { e.printStackTrace(); } } if(out != null){ try { out.close(); } catch (Exception e) { e.printStackTrace(); } } if(socket != null){ try { socket.close(); } catch (IOException e) { e.printStackTrace(); } } socket = null; } } } 伪异步IO一般都是通过线程池来实现的,它的效率比传统的网络IO要高,它是异步执行的。代码就是比上面的代码多了一个HandlerExecutorPool.java,而且Server.java也改写了一下。 HandlerExecutorPool.java import java.util.concurrent.ArrayBlockingQueue; import java.util.concurrent.ExecutorService; import java.util.concurrent.ThreadPoolExecutor; import java.util.concurrent.TimeUnit; public class HandlerExecutorPool { private ExecutorService executor; public HandlerExecutorPool(int maxPoolSize, int queueSize){ this.executor = new ThreadPoolExecutor( Runtime.getRuntime().availableProcessors(), maxPoolSize, 120L, TimeUnit.SECONDS, new ArrayBlockingQueue<Runnable>(queueSize)); } public void execute(Runnable task){ this.executor.execute(task); } } Server.java public class Server { final static int PORT = 8765; public static void main(String[] args) { ServerSocket server = null; BufferedReader in = null; PrintWriter out = null; try { server = new ServerSocket(PORT); System.out.println("server start"); Socket socket = null; HandlerExecutorPool executorPool = new HandlerExecutorPool(50, 1000); while(true){ socket = server.accept(); executorPool.execute(new ServerHandler(socket)); } } catch (Exception e) { e.printStackTrace(); } finally { if(in != null){ try { in.close(); } catch (Exception e1) { e1.printStackTrace(); } } if(out != null){ try { out.close(); } catch (Exception e2) { e2.printStackTrace(); } } if(server != null){ try { server.close(); } catch (Exception e3) { e3.printStackTrace(); } } server = null; } } } NIO编程 nio编程的核心是缓冲区,也就是Buffer对象,而传统的IO是流,也就是Stream对象。因为nio编程的操作比较繁琐,所以一般都是通过netty等网络编程框架来实现网络编程。 AIO编程

优秀的个人博客,低调大师

Git基础命令篇

一、Git介绍 (1)Git是一个开源(Linus Torvalds 为了帮助管理 Linux 内核开发而开发)的分布式版本控制系统,用于敏捷高效地处理任何或小或大的项目,与常用的版本控制工具 CVS, SVN等不同,它采用了分布式版本库的方式,不必服务器端软件支持。 (2)Git 的工作区、暂存区和版本库: 工作区:就是你在电脑里能看到的目录。 暂存区:英文叫stage, 或index。一般存放在 ".git目录下" 下的index文件(.git/index)中,所以我们把暂存区有时也叫作索引(index)。 版本库:工作区有一个隐藏目录.git,这个不算工作区,而是Git的版本库。 二、安装 Git 目前支持 Linux/Unix、Solaris、Mac和 Windows 平台上运行。 (1)Windows 上安装 Git 在 Windows 平台上安装 Git 很容易,有个叫做 msysGit 的项目提供了安装包,可以到 GitHub 的页面上下载 exe 安装文件并运行(安装包下载地址:https://gitforwindows.org/) 安装成功后,就可以使用命令行的 git 工具(已经自带了 ssh 客户端,右击->"Git Bash")进行Git操作,另外还有一个图形界面的 Git 项目管理工具 (2)其他安装参见菜鸟教程:http://www.runoob.com/git/git-install-setup.html 三、使用 (1)基本使用 1. git init 可以在任何时候/目录中创建新的 Git 仓库,完全是本地化的: git init //在目录中创建新的 Git 仓库,缺省情况下 Git 就会为你创建"master"分支 创建完后会在项目中生成“ .git ”这个子目录。 这就是你的 Git 仓库了,所有有关你的此项目的快照数据都存放在这里,eg: 2.git clone 拷贝一个 Git 仓库到本地进行查看修改: git clone [url] //默认,Git 会用此 URL 最后一个“/”之后的名称作为本地项目名称,你也可以在该命令后加上你想要的名称: git clone [url] <project name> eg.: 首先,去coding(较流行的一个Git服务器)随便找个项目,复制Git仓库地址: 然后,到本地计算机右击选择“git clone”: 3.git add 将文件添加到缓存 新项目可以使用 “git add . ”命令递归地添加当前工作目录中的所有文件。 4.git status 查看在你上次提交之后是否有修改 git status -s //查看状态, -s表示short,如果不加会详细输出内容 /** git status -s 状态码解析***************** A: 你本地新增的文件(服务器上没有). C: 文件的一个新拷贝. D: 你本地删除的文件(服务器上还在). M: 文件的内容或者mode被修改了. R: 文件名被修改了。 T: 文件的类型被修改了。 U: 文件没有被合并(你需要完成合并才能进行提交)。 X: 未知状态(很可能是遇到git的bug了,你可以向git提交bug report) ?:未被git进行管理,可以使用git add file1把file1添加进git能被git所进行管理 这些状态也会组合出现,eg: "AM" :意思是,这个文件在我们将它添加到缓存之后又有改动,改动后我们再执行 git add 命令将其添加到缓存中 "UU" : **/ 5.git diff 查看执行 git status 的结果的详细信息 git diff 比较工作目录中当前文件和暂存区域快照之间的差异,也就是修改之后还没有暂存起来的变化内容。git status 显示你上次提交更新后的更改或者写入缓存的改动, 而 git diff 则一行一行地显示这些改动具体是啥: 尚未缓存的改动:git diff 查看已缓存的改动:git diff --cached 查看已缓存的与未缓存的所有改动:git diff HEAD 显示摘要而非整个 diff:git diff --stat 6.git commit git add 将想要快照的内容写入缓存区,git commit 则将缓存区内容添加到仓库中。 git commit git commit -m "<message>" //使用 -m 选项以在命令行中提供提交注释 git commit -a //把unstaged的文件变成staged(不包括新建(untracked)的文件)然后commit,一般还是推荐先git add再git commit git commit -am "<message>"//或 git commit –a –m "<message>",相当于git add . + git commit –m "<message>"合并使用 git commit --amend //增补提交,会使用与当前提交节点相同的父节点进行一次新的提交,旧的提交将会被取消. Git 为你的每一个提交都记录你的名字与电子邮箱地址,所以第一步需要配置用户名和邮箱地址 7.git reset HEAD 取消之前 git add 已缓存的内容,但不包含在下一提交快照中的缓存。 HEAD关键字指的是当前分支最末梢最新的一个提交,也就是版本库中该分支上的最新版本. git reset HEAD //把add进去的文件从staged状态取出来,可以单独针对某一个文件操作: git reset HEAD <filename> git reset --mixed HEAD//--mixed是缺省参数,是将git的HEAD变了(也就是提交记录变了),但文件目录并没有改变, 取消了commit和add的内容. git reset --soft HEAD// 实际上,是git reset –mixed id 后,又做了一次git add.即取消了commit的内容. git reset --hard HEAD//是将git的HEAD变了,文件也变了. 按改动范围排序如下: soft (commit) < mixed (commit + add) < hard (commit + add + local working) 8.git revert HEAD: 撤销最近的一个提交: git revert会创建一个反向的新提交,可以通过参数-n来告诉Git先不要提交. 9.git rm从已跟踪文件清单中移除某个文件: 如果只是简单地从工作目录中手工删除文件,运行git status时就会在Changes not staged for commit的提示。要从 Git 中移除某个文件,就必须要从已跟踪文件清单中移除,然后提交: git rm <file> git rm -f <file> //如果删除之前修改过并且已经放到暂存区域的话,则必须要用强制删除选项-f git rm --cached <file>//仅从跟踪清单中删除,把文件从暂存区域移除但仍保留在当前工作目录中使用 git rm –r * //递归删除,即如果后面跟的是一个目录做为参数,则会递归删除整个目录中的所有子目录和文件 10.git mv 命令用于移动或重命名一个文件、目录、软连接: git mv <file> <new file> 11.gitclean是从工作目录中移除没有track的文件: git clean -d//-d表示同时移除目录 git clean -f// -f表示force,因为在git的配置文件中, clean.requireForce=true,如果不加-f,clean将会拒绝执行. 12.git stash把当前的改动压入一个栈: git stash将会把当前目录和index中的所有改动(但不包括未track的文件)压入一个栈,然后留给你一个clean的工作状态,即处于上一次最新提交处 git stash list//显示这个栈的list. git stash apply//取出stash中的上一个项目(stash@{0}),并且应用于当前的工作目录.也可以指定别的项目,如:git stash apply stash@{1} git stash pop//在应用stash中项目的同时想要删除它 git stash drop// 删除上一个,也可指定参数删除指定的一个项目 git stash clear// 删除所有项目 13.git reflog 对reflog进行管理 reflog是git用来记录引用变化的一种机制,比如记录分支的变化或者是HEAD引用的变化,git会将变化记录到HEAD对应的reflog文件中,其路径为 .git/logs/HEAD, 分支的reflog文件都放在 .git/logs/refs 目录下的子目录中 git reflog//不指定引用的时候,默认列出HEAD的reflog。HEAD@{0}代表HEAD当前的值,HEAD@{3}代表HEAD在3次变化之前的值. (2)Git 分支管理 几乎所有版本控制系统都支持分支。使用分支可以从开发主线上分离开来,在不影响主线的同时继续工作。 1.创建分支: git branch (branchname) //没有参数时,git branch 会列出你在本地的分支。 2.切换分支: 当你切换分支的时候,Git 会用该分支的最后提交的快照替换你的工作目录的内容, 所以多个分支不需要多个目录。 git checkout (branchname) //该分支存在则切换到分之下否则创建新分支并立即切换到该分支下 3.合并分支: Git 合并,不仅仅是简单的文件添加、移除的操作,也会合并修改。你可以多次合并到统一分支, 也可以选择在合并之后直接删除被并入的分支。 git merge (branchname) //将此分支合并到主分支去 git checkout -b (branchname) //创建并切换到新的分支,相当于git branch newbranch + git checkout newbranch 合并使用 git checkout <filename>//此命令会使用HEAD中的最新内容替换掉你的工作目录中的文件,已添加到暂存区的改动以及新文件都不会受到影响。会删除该文件中所有没有暂存和提交的改动,这个操作是不可逆的 合并出现冲突需要手动去修改它,然后: git add // 解决了冲突要告诉 Git 文件冲突已经解决 git merge --abort//或者你也可以取消merge 4.删除分支: git branch -d (branchname) 5.查看分支的最后一次提交: git branch -v (3)Git log查看提交日志 Git 最为出色的是它的合并跟踪(merge tracing)能力。使用 git log 命令查看提交历史: git log git log --oneline //查看历史记录的简洁的版本 git log --reverse --oneline //逆向显示所有日志 git log --oneline --number //显示number条,每条log只显示一行 git log --oneline --graph //图形化显示分支合并历史 git log branchname// 显示特定分支的log git log --oneline branch1 ^branch2//查看在分支1不在分支2中的log,^表示排除这个分支 git log --decorate//会显示出tag信息 git log --grep //根据commit信息过滤log: git log --grep=keywords 默认情况下, git log --grep --author是OR的关系,即满足一条即被返回,如果你想让它们是AND的关系,可以加上--all-match的option git log -S: filter by introduced diff ,如: git log -SmethodName (注意S和后面的词之间没有等号分隔). git log -p//每一个提交都是一个快照(snapshot),Git会把每次提交的diff计算出来,作为一个patch显示给你看,另一种方法是git show [SHA]. git log --stat//同样是用来看改动的相对信息的,--stat比-p的输出更简单一些. //--no-merges可以将merge的commits排除在外. 用 --graph 选项,开启了拓扑图选项,可以更清楚明了地查看历史中什么时候出现了分支、合并,eg.: $ git log --oneline --graph * 88afe0e Merge branch 'change_site' |\ | * d7e7346 changed the site * | 14b4dca 新增加一行 |/ * 556f0a0 removed test2.txt * 2e082b7 add test2.txt * 048598f add test.txt * 85fc7e7 test comment from runoob.com 如果只想查找指定用户的提交日志可以使用命令:git log --author ,eg.: $ git log --author=Linus --oneline -5 //找 Git 源码中 Linus 提交的部分 81b50f3 Move 'builtin-*' into a 'builtin/' subdirectory 3bb7256 make "index-pack" a built-in 377d027 make "git pack-redundant" a built-in b532581 make "git unpack-file" a built-in 112dd51 make "mktag" a built-in 如果你要指定日期,可以执行几个选项:--since 和 --before, --until 和 --after,eg.: $ git log --oneline --before={3.weeks.ago} --after={2010-04-18} --no-merges //看 Git 项目中三周前且在四月十八日之后的所有提交,我可以执行这个, --no-merges 选项以隐藏合并提交 5469e2d Git 1.7.1-rc2 d43427d Documentation/remote-helpers: Fix typos and improve language 272a36b Fixup: Second argument may be any arbitrary string b6c8d2d Documentation/remote-helpers: Add invocation section 5ce4f4e Documentation/urls: Rewrite to accomodate transport::address 00b84e9 Documentation/remote-helpers: Rewrite description 03aa87e Documentation: Describe other situations where -z affects git diff 77bc694 rebase-interactive: silence warning when no commits rewritten 636db2c t3301: add tests to use --format="%N" (4)Git 标签 1.如果你希望永远记住重要的阶段那个特别的提交快照,你可以使用 git tag 给它打上标签,eg.: git tag -a v1.0 //给最新一次提交打上(HEAD)"v1.0"的标签,-a 选项意为"创建一个带注解的标签",不用 -a 选项也可以执行的,但它不会记录这标签是啥时候打的,谁打的,也不会让你添加个标签的注解。推荐创建带注解的标签 2.查看标签: $ git tag//查看所有标签 v0.9 v1.0 3.如果我们忘了给某个提交打标签,又将它发布了,我们可以给它追加标签,eg.: $ git tag -a v0.9 85fc7e7 //给发布提交的 85fc7e7 追加标签 $ git log --oneline --decorate --graph * 88afe0e (HEAD, tag: v1.0, master) Merge branch 'change_site' |\ | * d7e7346 (change_site) changed the site * | 14b4dca 新增加一行 |/ * 556f0a0 removed test2.txt * 2e082b7 add test2.txt * 048598f add test.txt * 85fc7e7 (tag: v0.9) test comment from runoob.com 4.指定标签信息: git tag -a <tagname> -m "<message>" 5.PGP签名标签: git tag -s <tagname> -m "<message>" 6.删除标签: git tag -d <tagname> 7.查看某个标签版本所修改的内容: git show <tagname> 四、Git仓库 Git 并不像 SVN 那样有个中心服务器。Git 命令都是在本地执行,如果你想通过 Git 分享你的代码或者与其他开发人员合作。 你就需要将数据放到一台其他开发人员能够连接的服务器上。 (1)添加远程库 要添加一个新的远程仓库,可以指定一个简单的名字,以便将来引用,命令格式如下: git remote add [shortname] [url] 目前流行的Git仓库有很多,使用最多的有:GitHub、Coding(兼具SVN、Git)。具体的使用如同普通的软件一样很简单,可以直接上手 (2)使用Git仓库 1.查看当前的远程库 因为不需要每次都用完整的url,所以Git为每一个remote repo的url都建立一个别名,然后用git remote来管理这个list,如果你clone一个project,Git会自动将原来的url添加进来,别名就叫做:origin git remote// 列出remote aliases. git remote -v//查看每一个别名对应的实际url. git remote add [alias] [url]// 添加一个新的remote repo. git remote rm [alias]// 删除一个存在的remote alias. git remote rename [old-alias] [new-alias]//重命名 git remote set-url [alias] [url]//更新url, 可以加上—push和-fetch参数,为同一个别名set不同的存取地址. 2.提取远程仓库 git fetch //取所有你本地没有的数据,取下来的分支(remote branches)和本地分支一样(可以看diff、log、merge),但是Git不允许你checkout到它们 git fetch [alias]//取某一个远程repo git fetch --all//取到全部repo 3.推送到远程仓库 ① 从远程仓库下载新分支与数据 如果有多个人向同一个remote repo push代码, Git会首先在你试图push的分支上运行git log,检查它的历史中是否能看到server上的branch现在的tip,如果本地历史中不能看到server的tip,说明本地的代码不是最新的,Git会拒绝你的push,让你先fetch,merge,之后再push,这样就保证了所有人的改动都会被考虑进来 git push [alias] [branch] //把当前分支merge到alias上的[branch]分支,如果分支已经存在,将会更新,如果不存在,将会添加这个分支. git push (remote-name) (branch-name) //(local-branch)缺省就意味着删除remote-branch ② git merge从远端仓库提取数据并尝试合并到当前分支 git merge [alias]/[branch] git rebase不会产生合并的提交,它会将本地的所有提交临时保存为补丁(patch)放在”.git/rebase”目录中,然后将当前分支更新到最新的分支尖端、最后把保存的补丁应用到分支上。 //rebase的过程中,也许会出现冲突,Git会停止rebase并让你解决冲突,在解决完冲突之后,用git add去更新这些内容,然后无需执行commit,只需要: git rebase --continue//就会继续打余下的补丁 git rebase --abort//终止rebase,当前分支将会回到rebase之前的状态 4.删除远程仓库 git remote rm [别名] 5.git pull 缺省参数== fetch + merge FETCH_HEAD git pull//== git pull --merge,先执行git fetch,然后执行git merge把取来的分支的head merge到当前分支产生一个新的commit git pull --rebase//先执行git fetch,然后执行git rebase (3)自己搭建Git 仓库 你也可以搭建属于自己的Git服务器,参见:http://www.runoob.com/git/git-server.html 1、安装Git $ yum install curl-devel expat-devel gettext-devel openssl-devel zlib-devel perl-devel $ yum install git 创建一个git用户组和用户,用来运行git服务: $ groupadd git $ useradd git -g git 2、创建证书登录 收集所有需要登录的用户的公钥,公钥位于id_rsa.pub文件中,把我们的公钥导入到/home/git/.ssh/authorized_keys文件里,一行一个。如果没有该文件创建它: $ cd /home/git/ $ mkdir .ssh $ chmod 755 .ssh $ touch .ssh/authorized_keys $ chmod 644 .ssh/authorized_keys 3、初始化Git仓库 选定一个目录作为Git仓库: $ cd /home $ mkdir gitrepo $ chown git:git gitrepo/ $ cd gitrepo $ git init --bare runoob.git Initialized empty Git repository in /home/gitrepo/runoob.git/ 以上命令Git创建一个空仓库,服务器上的Git仓库通常都以.git结尾。然后,把仓库所属用户改为git: $ chown -R git:git runoob.git 4、克隆仓库 $ git clone git@192.168.45.4:/home/gitrepo/runoob.git Cloning into 'runoob'... warning: You appear to have cloned an empty repository. Checking connectivity... done. 五、目前主流的代码编译器都已集成了版本控制系统 以webstorm为例,安装了git后就可以使用: 分别是:拉取、提交 branch(分支)管理 右击项目名,就能看到git选项 ps:webstorm自身的local history可以看到编译日志(项目运行后存放在webstorm生成的“.idea文件夹”)。右击项目名,就能看到local history选项 打开后可以看到每次修改的记录,你还可以revert还原代码,如下: 博客地址:https://my.oschina.net/wangnian

优秀的个人博客,低调大师

python 基础教程

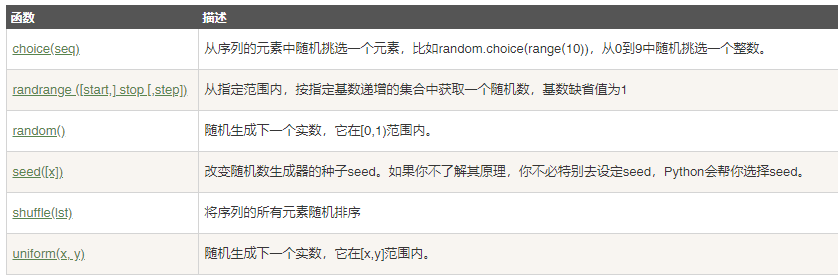
运算 !/usr/bin/python -- coding: UTF-8 -- a = 21 b = 10 c = 0 c = a + b print "1 - c 的值为:", c c = a - b print "2 - c 的值为:", c c = a * b print "3 - c 的值为:", c c = a / b print "4 - c 的值为:", c c = a % b print "5 - c 的值为:", c 修改变量 a 、b 、c a = 2 b = 3 c = a**b print "6 - c 的值为:", c a = 10 b = 5 c = a//b print "7 - c 的值为:", c python比较 !/usr/bin/python -- coding: UTF-8 -- a = 21 b = 10 c = 0 if ( a == b ): print "1 - a 等于 b" else: print "1 - a 不等于 b" if ( a != b ): print "2 - a 不等于 b" else: print "2 - a 等于 b" if ( a <> b ): print "3 - a 不等于 b" else: print "3 - a 等于 b" if ( a < b ): print "4 - a 小于 b" else: print "4 - a 大于等于 b" if ( a > b ): print "5 - a 大于 b" else: print "5 - a 小于等于 b" 修改变量 a 和 b 的值 a = 5 b = 20 if ( a <= b ): print "6 - a 小于等于 b" else: print "6 - a 大于 b" if ( b >= a ): print "7 - b 大于等于 a" else: print "7 - b 小于 a" 赋值 !/usr/bin/python -- coding: UTF-8 -- a = 21 b = 10 c = 0 c = a + b print "1 - c 的值为:", c c += a print "2 - c 的值为:", c c *= a print "3 - c 的值为:", c c /= a print "4 - c 的值为:", c c = 2 c %= a print "5 - c 的值为:", c c **= a print "6 - c 的值为:", c c //= a print "7 - c 的值为:", c 逻辑运算符: !/usr/bin/python -- coding: UTF-8 -- a = 10 b = 20 if ( a and b ): print "1 - 变量 a 和 b 都为 true" else: print "1 - 变量 a 和 b 有一个不为 true" if ( a or b ): print "2 - 变量 a 和 b 都为 true,或其中一个变量为 true" else: print "2 - 变量 a 和 b 都不为 true" 修改变量 a 的值 a = 0 if ( a and b ): print "3 - 变量 a 和 b 都为 true" else: print "3 - 变量 a 和 b 有一个不为 true" if ( a or b ): print "4 - 变量 a 和 b 都为 true,或其中一个变量为 true" else: print "4 - 变量 a 和 b 都不为 true" if not( a and b ): print "5 - 变量 a 和 b 都为 false,或其中一个变量为 false" else: print "5 - 变量 a 和 b 都为 true" in,not in !/usr/bin/python -- coding: UTF-8 -- a = 10 b = 20 list = [1, 2, 3, 4, 5 ]; if ( a in list ): print "1 - 变量 a 在给定的列表中 list 中" else: print "1 - 变量 a 不在给定的列表中 list 中" if ( b not in list ): print "2 - 变量 b 不在给定的列表中 list 中" else: print "2 - 变量 b 在给定的列表中 list 中" 修改变量 a 的值 a = 2 if ( a in list ): print "3 - 变量 a 在给定的列表中 list 中" else: print "3 - 变量 a 不在给定的列表中 list 中" 条件 !/usr/bin/python -- coding: UTF-8 -- 例1:if 基本用法 flag = False name = 'luren' if name == 'python': # 判断变量否为'python' flag = True # 条件成立时设置标志为真 print 'welcome boss' # 并输出欢迎信息 else: print name !/usr/bin/python -- coding: UTF-8 -- 例2:elif用法 num = 5 if num == 3: # 判断num的值 print 'boss' elif num == 2: print 'user' elif num == 1: print 'worker' elif num < 0: # 值小于零时输出 print 'error' else: print 'roadman' # 条件均不成立时输出 循环语句: !/usr/bin/python count = 0 while (count < 9): print 'The count is:', count count = count + 1 print "Good bye!" i = 1 while i < 10: i += 1 if i%2 > 0: # 非双数时跳过输出 continue print i # 输出双数2、4、6、8、10 i = 1 while 1: # 循环条件为1必定成立 print i # 输出1~10 i += 1 if i > 10: # 当i大于10时跳出循环 break !/usr/bin/python -- coding: UTF-8 -- for letter in 'Python': # 第一个实例 print '当前字母 :', letter fruits = ['banana', 'apple', 'mango'] for fruit in fruits: # 第二个实例 print '当前水果 :', fruit print "Good bye!" 获取用户输入:raw_input !/usr/bin/python -- coding: UTF-8 -- var = 1 while var == 1 : # 该条件永远为true,循环将无限执行下去 num = raw_input("Enter a number :") print "You entered: ", num print "Good bye!" range,len !/usr/bin/python -- coding: UTF-8 -- fruits = ['banana', 'apple', 'mango'] for index in range(len(fruits)): print '当前水果 :', fruits[index] print "Good bye!" import cmath cmath.sqrt(-1) 1j cmath.sqrt(9) (3+0j) cmath.sin(1) (0.8414709848078965+0j) cmath.log10(100) (2+0j) python数学函数: abs,cell,cmp,exp,fabs,floor,log,log10,max,min,mod,pow,round,sqrt randrange image.png image.png 访问字符串的值 !/usr/bin/python var1 = 'Hello World!' var2 = "Python Runoob" print "var1[0]: ", var1[0] print "var2[1:5]: ", var2[1:5] 转义字符 image.png 格式化输出 print "My name is %s and weight is %d kg!" % ('Zara', 21) image.png 字符串函数: image.png image.png image.png image.png 添加元素 !/usr/bin/python -- coding: UTF-8 -- list = [] ## 空列表 list.append('Google') ## 使用 append() 添加元素 list.append('Runoob') print list 删除元素 !/usr/bin/python list1 = ['physics', 'chemistry', 1997, 2000] print list1 del list1[2] print "After deleting value at index 2 : " print list1 列表操作 image.png 列表方法 image.png 删除字典 !/usr/bin/python -- coding: UTF-8 -- dict = {'Name': 'Zara', 'Age': 7, 'Class': 'First'}; del dict['Name']; # 删除键是'Name'的条目 dict.clear(); # 清空词典所有条目 del dict ; # 删除词典 print "dict['Age']: ", dict['Age']; print "dict['School']: ", dict['School']; 字典的函数: image.png image.png 当前时间戳: import time time.time() 格式化日期输出 !/usr/bin/python -- coding: UTF-8 -- import time 格式化成2016-03-20 11:45:39形式 print time.strftime("%Y-%m-%d %H:%M:%S", time.localtime()) 格式化成Sat Mar 28 22:24:24 2016形式 print time.strftime("%a %b %d %H:%M:%S %Y", time.localtime()) 将格式字符串转换为时间戳 a = "Sat Mar 28 22:24:24 2016" print time.mktime(time.strptime(a,"%a %b %d %H:%M:%S %Y")) 获取某个月日历:calendar !/usr/bin/python -- coding: UTF-8 -- import calendar cal = calendar.month(2016, 1) print "以下输出2016年1月份的日历:" print cal 当前日期和时间 !/usr/bin/python -- coding: UTF-8 -- import datetime i = datetime.datetime.now() print ("当前的日期和时间是 %s" % i) print ("ISO格式的日期和时间是 %s" % i.isoformat() ) print ("当前的年份是 %s" %i.year) print ("当前的月份是 %s" %i.month) print ("当前的日期是 %s" %i.day) print ("dd/mm/yyyy 格式是 %s/%s/%s" % (i.day, i.month, i.year) ) print ("当前小时是 %s" %i.hour) print ("当前分钟是 %s" %i.minute) print ("当前秒是 %s" %i.second) 不定长参数:* image.png lambda:匿名函数 image.png def.... python模块搜索路径 image.png 获取用户输入 !/usr/bin/python -- coding: UTF-8 -- str = raw_input("请输入:") print "你输入的内容是: ", str input可以接收表达式 image.png open参数 image.png image.png image.png write要自己添加换行符 读取10个字符 image.png 重命名:os.rename os.remove os.mkdir os.chdir os.getcwd os.rmdir open参数 image.png file的方法 image.png image.png 异常: !/usr/bin/python -- coding: UTF-8 -- try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") except IOError: print "Error: 没有找到文件或读取文件失败" else: print "内容写入文件成功" fh.close() !/usr/bin/python -- coding: UTF-8 -- try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") finally: print "Error: 没有找到文件或读取文件失败" 用户自定义异常: image.png Python OS 文件/目录方法 os 模块提供了非常丰富的方法用来处理文件和目录。常用的方法如下表所示: | 序号 | 方法及描述 | | 1 | os.access(path, mode) 检验权限模式 | | 2 | os.chdir(path) 改变当前工作目录 | | 3 | os.chflags(path, flags) 设置路径的标记为数字标记。 | | 4 | os.chmod(path, mode) 更改权限 | | 5 | os.chown(path, uid, gid) 更改文件所有者 | | 6 | os.chroot(path) 改变当前进程的根目录 | | 7 | os.close(fd) 关闭文件描述符 fd | | 8 | os.closerange(fd_low, fd_high) 关闭所有文件描述符,从 fd_low (包含) 到 fd_high (不包含), 错误会忽略 | | 9 | os.dup(fd) 复制文件描述符 fd | | 10 | os.dup2(fd, fd2) 将一个文件描述符 fd 复制到另一个 fd2 | | 11 | os.fchdir(fd) 通过文件描述符改变当前工作目录 | | 12 | os.fchmod(fd, mode) 改变一个文件的访问权限,该文件由参数fd指定,参数mode是Unix下的文件访问权限。 | | 13 | os.fchown(fd, uid, gid) 修改一个文件的所有权,这个函数修改一个文件的用户ID和用户组ID,该文件由文件描述符fd指定。 | | 14 | os.fdatasync(fd) 强制将文件写入磁盘,该文件由文件描述符fd指定,但是不强制更新文件的状态信息。 | | 15 | os.fdopen(fd[, mode[, bufsize]]) 通过文件描述符 fd 创建一个文件对象,并返回这个文件对象 | | 16 | os.fpathconf(fd, name) 返回一个打开的文件的系统配置信息。name为检索的系统配置的值,它也许是一个定义系统值的字符串,这些名字在很多标准中指定(POSIX.1, Unix 95, Unix 98, 和其它)。 | | 17 | os.fstat(fd) 返回文件描述符fd的状态,像stat()。 | | 18 | os.fstatvfs(fd) 返回包含文件描述符fd的文件的文件系统的信息,像 statvfs() | | 19 | os.fsync(fd) 强制将文件描述符为fd的文件写入硬盘。 | | 20 | os.ftruncate(fd, length) 裁剪文件描述符fd对应的文件, 所以它最大不能超过文件大小。 | | 21 | os.getcwd() 返回当前工作目录 | | 22 | os.getcwdu() 返回一个当前工作目录的Unicode对象 | | 23 | os.isatty(fd) 如果文件描述符fd是打开的,同时与tty(-like)设备相连,则返回true, 否则False。 | | 24 | os.lchflags(path, flags) 设置路径的标记为数字标记,类似 chflags(),但是没有软链接 | | 25 | os.lchmod(path, mode) 修改连接文件权限 | | 26 | os.lchown(path, uid, gid) 更改文件所有者,类似 chown,但是不追踪链接。 | | 27 | os.link(src, dst) 创建硬链接,名为参数 dst,指向参数 src | | 28 | os.listdir(path) 返回path指定的文件夹包含的文件或文件夹的名字的列表。 | | 29 | os.lseek(fd, pos, how) 设置文件描述符 fd当前位置为pos, how方式修改: SEEK_SET 或者 0 设置从文件开始的计算的pos; SEEK_CUR或者 1 则从当前位置计算; os.SEEK_END或者2则从文件尾部开始. 在unix,Windows中有效 | | 30 | os.lstat(path) 像stat(),但是没有软链接 | | 31 | os.major(device) 从原始的设备号中提取设备major号码 (使用stat中的st_dev或者st_rdev field)。 | | 32 | os.makedev(major, minor) 以major和minor设备号组成一个原始设备号 | | 33 | os.makedirs(path[, mode]) 递归文件夹创建函数。像mkdir(), 但创建的所有intermediate-level文件夹需要包含子文件夹。 | | 34 | os.minor(device) 从原始的设备号中提取设备minor号码 (使用stat中的st_dev或者st_rdev field )。 | | 35 | os.mkdir(path[, mode]) 以数字mode的mode创建一个名为path的文件夹.默认的 mode 是 0777 (八进制)。 | | 36 | os.mkfifo(path[, mode]) 创建命名管道,mode 为数字,默认为 0666 (八进制) | | 37 | os.mknod(filename[, mode=0600, device]) 创建一个名为filename文件系统节点(文件,设备特别文件或者命名pipe)。 | | 38 | os.open(file, flags[, mode]) 打开一个文件,并且设置需要的打开选项,mode参数是可选的 | | 39 | os.openpty() 打开一个新的伪终端对。返回 pty 和 tty的文件描述符。 | | 40 | os.pathconf(path, name) 返回相关文件的系统配置信息。 | | 41 | os.pipe() 创建一个管道. 返回一对文件描述符(r, w) 分别为读和写 | | 42 | os.popen(command[, mode[, bufsize]]) 从一个 command 打开一个管道 | | 43 | os.read(fd, n) 从文件描述符 fd 中读取最多 n 个字节,返回包含读取字节的字符串,文件描述符 fd对应文件已达到结尾, 返回一个空字符串。 | | 44 | os.readlink(path) 返回软链接所指向的文件 | | 45 | os.remove(path) 删除路径为path的文件。如果path 是一个文件夹,将抛出OSError; 查看下面的rmdir()删除一个 directory。 | | 46 | os.removedirs(path) 递归删除目录。 | | 47 | os.rename(src, dst) 重命名文件或目录,从 src 到 dst | | 48 | os.renames(old, new) 递归地对目录进行更名,也可以对文件进行更名。 | | 49 | os.rmdir(path) 删除path指定的空目录,如果目录非空,则抛出一个OSError异常。 | | 50 | os.stat(path) 获取path指定的路径的信息,功能等同于C API中的stat()系统调用。 | | 51 | os.stat_float_times([newvalue]) 决定stat_result是否以float对象显示时间戳 | | 52 | os.statvfs(path) 获取指定路径的文件系统统计信息 | | 53 | os.symlink(src, dst) 创建一个软链接 | | 54 | os.tcgetpgrp(fd) 返回与终端fd(一个由os.open()返回的打开的文件描述符)关联的进程组 | | 55 | os.tcsetpgrp(fd, pg) 设置与终端fd(一个由os.open()返回的打开的文件描述符)关联的进程组为pg。 | | 56 | os.tempnam([dir[, prefix]]) 返回唯一的路径名用于创建临时文件。 | | 57 | os.tmpfile() 返回一个打开的模式为(w+b)的文件对象 .这文件对象没有文件夹入口,没有文件描述符,将会自动删除。 | | 58 | os.tmpnam() 为创建一个临时文件返回一个唯一的路径 | | 59 | os.ttyname(fd) 返回一个字符串,它表示与文件描述符fd 关联的终端设备。如果fd 没有与终端设备关联,则引发一个异常。 | | 60 | os.unlink(path) 删除文件路径 | | 61 | os.utime(path, times) 返回指定的path文件的访问和修改的时间。 | | 62 | os.walk(top[, topdown=True[, onerror=None[, followlinks=False]]]) 输出在文件夹中的文件名通过在树中游走,向上或者向下。 | | 63 | os.write(fd, str) 写入字符串到文件描述符 fd中. 返回实际写入的字符串长度 |
优秀的个人博客,低调大师

JAVA基础知识

快速浏览 Sun公司在1991成立了一个名为Green的小组,这个小组开发了Oak,这正是java的前身,最初的开发目的是为了做家电的嵌入式应用,不过因为缺乏硬件市场的支持并没有受到大的关注。1995的时候,互联网开始崛起,这给了java机会。Sun公司首先推出了可以嵌入网页并且可以随同网页在网络上传输的Applet,并将Oak更名为Java。1996年1月,Sun公司发布了Java的第一个开发工具包,这个工具包被命名为JDK1.0,这标志着Java正式成为了一种独立的开发工具。1998年12月8日,第二代Java平台的企业版J2EE发布。1999年6月,Sun公司发布了第二代Java平台的第3个版本:J2ME。1999年4月27日,HotSpot虚拟机发布。HotSpot虚拟机发布时是作为JDK 1.2的附加程序提供的,后来它成为了JDK 1.3及之后所有版本的Sun JDK的默认虚拟机 。2000年5月,JDK1.3、JDK1.4和J2SE1.3相继发布,几周后其获得了Apple公司Mac OS X的工业标准的支持。2002年2月26日,J2SE1.4发布。自此Java的计算能力有了大幅提升,与J2SE1.3相比,其多了近62%的类和接口,其中比较重要的更新有XML、Socket、正则表达式改进的I/O等。2004年9月30日,J2SE1.5发布。为了表示该版本的重要性,J2SE 1.5更名为Java SE 5.0。更新中包含了从1996年发布1.0版本以来的最重大的更新,其中包括泛型、基本类型的自动装箱、改进的循环、枚举类型及可变参数。2006年11月13日,Java技术的发明者Sun公司宣布,将Java技术作为免费软件对外发布。从2007年3月起,全世界所有的开发人员均可对Java源代码进行修改。2009年,甲骨文公司宣布收购Sun。 Applet是一种将小程序嵌入到网页中进行执行的技术。 在申请注册商标时,Sun发现Oak已经被人使用了,再想了一系列名字之后,最终,使用了提议者在喝一杯Java咖啡时无意提到的Java词语。 技术架构 JAVASE:全称 Java Platform Standard Edition,Java 2平台的标准版,应用于桌面应用程序;JAVAEE:Java Platform Enterprise Edition,企业版,应用于WEB开发;JAVAME:Java Platform Micro Edition,微型版,应用于移动环境和嵌入式设备,例如安卓手机中的应用程序; 跨平台的秘密 java的底层依靠虚拟机,不同的操作系统对应不同的java虚拟机。所以只需要在不同的操作系统中安装对应虚拟机就可以实现不修改java源代码就可以运行。 JRE和JDK JDK:Java Development Kit,JDK中包含了JRE,JDK是java的开发工具。JRE:Java Runtime Environment,java程序的运行环境,包含Java运行的所需的类库和JVM。JVM:Java Virtual Machine,Java虚拟机,是一种用于计算设备的规范,它是一个虚构出来的计算机,是通过在实际的计算机上仿真模拟各种计算机功能来实现的。 环境搭建 配置环境变量:就是将在jdkbin目录下指令告知当前系统,在需要使用对应指令的时候由系统根据指定目录寻找指令。 经常被使用的两个指令是javac和java指令,它们分别负责编译和运行java程序。javac:当执行javac的时候会启动java的编译器对.java文件进行编译,也就是生成.class文件,这是jvm可以识别的字节码文件。java:会启动jvm,加载运行需要的类库,然后执行.class文件 永久配置方式:JAVA_HOME=%安装路径%Javajdkpath=%JAVA_HOME%binCLASSPATH=;%JAVA_HOME%lib 临时配置方式:path:C:ProgramJavajdkbin 在定义classpath环境变量时,如果没有定义环境变量classpath,java启动jvm后,会在当前目录下查找要运行的类文件;如果指定了classpath,那么会在指定的目录下查找要运行的类文件;如果classpath值中结尾处有分号那么在指定目录下没有找到类文件的时候,会默认在当前目录下找一次;如果classpath值中结尾处没有分号在指定目录下没有找到类文件的时候会报错。 一般写分号,如果在指定目录下没有找到的话就让它报错,这样方便调试程序。 注释 单行注释(single-line):// 一次只能注释一行,一般是简单注释,用来简短描述某个变量或属性,程序块。块注释(block):/ 为了进行多行简单注释,一般不使用。/ 文档注释:/* 可以使用多行,一般用来对类、接口、成员方法、成员变量、静态字段、静态方法、常量进行说明。Javadoc可以用它来产生代码的文档。为了可读性,可以有缩进和格式控制。 / 语法规则 约定俗成的书写规则 包名:package 的名字应该采用完整的英文描述符,由一个小写单词组成,并且包名的前缀是一个顶级域名,如com、net、org等类名:class 名应该是个一名词,采用大小写混合的方式,每个单词的首字母大写。一般保证类名简洁而富于描述。常量:全部采用大写字母,单词之间尽量使用下划线分割。变量:不可以使用数字和下划线开头;不可以使用关键字。 变量有分成员变量和局部变量。成员变量直接定义在类中,作用于当前类,存在于堆内存中;局部变量可以定义在参数列表和方法内部,作用于当前方法,存在于栈内存中。 所有对象在创建的时候都需要初始化才能使用,做这个工作的是构造函数,其实就是一个与类名称相同的方法,可以重载,不需要返回值。构造函数和一般函数之间的区别除了定义格式上之外还有就是构造函数只被执行一次。 数据类型 基本数据类型:byte、short、int、long、float、double、char、boolean引用数据类型: 字符串、数组、枚举、接口、对象。 运算符 算术运算符:+、-、*、/、%、+(连接符)、++、--赋值运算符:=、+=、-=、*=、/=、%=比较运算符(运算的结果要么是true,要么是false):>、<、==、>=、<=逻辑运算符(用于连接两个boolean表达式,除!之外):&、|、^、! (二元运算符)、&&(短路与) 、||(短路或)位运算符(用于操作二进制位的运算符):<<、>>、>>>(无符号右移) &: 只有两边都为true结果是true。否则就是false。 & 和 &&区别: & :无论左边结果是什么,右边都参与运算。 &&:短路与,如果左边为false,那么右边不参数与运算。 | : 只要两边都为false的时候结果才是false,否则就是true | 和|| 区别:|:两边都参加运算。||:短路或,如果左边为true,那么右边不参与运算。 流程控制语句 用于决定某个代码块是否可以被执行ifswitch 当判断固定个数的值的时候建议使用switch,效率相对较高。 需要循环执行某个代码块的时候do whilewhileforforeach while和for可以相互转换,如果需要定义变量控制循环次数,建议使用for,for循环完毕的时候变量会在内存中释放。 java还提供了两个关键字来帮助细粒化控制流程。break:作用于switch和循环语句,用于跳出当前循环。 在break关键字下面的代码不会被执行,当有嵌套的时候break只会跳出当前循环,如果需要跳出外部循环,可以给循环打个标记。 continue:作用于循环结构,含义是结束本次循环,开始下次循环。 数组 存储同一类型并且固定长度数据的容器,通过对容器元素编号的方式来访问元素,这样的容器就是数组。 dataType[] arrayRefVar = {value0, value1, ..., valuek}; 方法 为了提高代码的复用,可以将一个代码块抽取出一个方法,用于实现某一个或多个功能。 访问修饰符 返回值类型 方法名称(参数类型 形式参数0,参数类型 形式参数1,......){ 执行语句; return 返回值;} return的作用是结束方法。 如果方法的返回值是void,系统会自动帮你补上。 当方法没有具体的返回值时,返回值类型用void关键字表示。 形式参数对应着实际参数,前者的作用是占位,后者是当调用方法的时候传入的参数,这个参数是某个具体的值,因此称为实参。 参数的类型用于区分方法重载,方法重载指的是方法名相同参数列表不同,和返回值类型无关。 this this是java中的关键字,你可以用它来 调用本类中的属性,也就是类中的成员变量 调用本类中的其他方法 调用本类中的其他构造方法 在使用this关键字调用构造方法的时候需要放在构造方法的第一行,否则就会报错,因为构造方法用于初始化,初始化的动作需要一定被执行。 super super 用于限定本类调用从父类继承得到的实例变量或方法。 子类覆盖父类属性的时候可以使用super调用父类属性 子类覆盖父类方法的时候可以使用super调用父类方法 调用父类的构造方法,必须在首行调用 final final用于修饰类、方法和变量,被final修饰有如下特点 被final修饰的类不可以被继承,其中类中的成员变量都会隐式设置为final,String就是这样一个类。 被final修饰的方法不可以被覆盖,被private修饰的方法会隐式地被指定为final方法。 被final修饰的变量是一个常量,只能被赋值一次。 匿名内部类中使用的外部局部变量只能是final变量。 static static是一个用于修饰成员变量和方法的修饰符,被static修饰之后有如下特点 对象数据共享 成员变量可以被类名直接调用 静态优先于对象加载 static作用于成员变量时表示只保存一份副本,而final的作用是用来保证变量不可变。 使用static需要注意的地方 主函数是被静态修饰 静态优先对象加载,所以静态方法只能访问静态成员变量,不能访问非静态成员变量 this和super关键字也不能在静态中使用,理由同上 被静态修饰成员变量和方法会存储到单独的静态区也就是方法区,否则会当作对象的一部分存储在对象区也就是堆区 成员变量只能被对象调用而静态变量可以被对象和类名调用 这是面试中常常遇到的问题,如果静态代码块、构造函数、构造代码块同时存在,那么它们先后执行的顺序是: 静态代码块-->构造代码块-->构造函数 abstract abstract类用于标注一个类是抽象类,目的是不让类实例化,抽象类有如下特点 抽象方法只能定义在抽象类中,并且只能修饰方法和类不能修饰变量。 抽象方法不负责具体的实现 抽象类不可以被实例化 当子类通过继承的方式实现了抽象类中的所有抽象方法时,子类才可以实例化,否则该子类也是一个抽象类 抽象类有构造方法,是用来给子类对象初始化的 abstract不可以和final、private和static共存 抽象类的最佳实践是模板设计模式 interface interface用于修饰一个类为接口,接口用于设计上的好处是 功能扩展 降低耦合 规则约束 多继承 接口和抽象的区别 抽象类单继承,接口多实现 抽象类可以定义非抽象方法,子类继承使用;接口全是抽象方法需要子类实现 抽象类可以使用任意修饰符修饰,接口的成员都是public instanceof instanceof用于判断一个对象是否是指定的类型 内部类 为了方便访问,直接将B类定义在A类中,那么B类就是A类的内部类。A类可以通过创建B类对象访问B类属性,B类可以直接访问A类属性。如果内部类只需要被使用一次,那么可以定义为匿名类,就是没有命名的内部类,定义匿名内部类的前提是必须继承一个类或者实现一个接口。 异常 java中的异常可以分为运行时异常和编译时异常。在程序运行的时候产生的异常就是运行时异常。 异常被定义在java.lang.Throwable中。处理异常有两种方式,抛出和捕获。 抛出,使用throws关键字抛出异常,子类抛出的异常由父类处理,如果父类无法处理则可以继续往上抛 捕获,当一段代码可能会发生异常的时候或已经发生异常的时候可以使用try/catch处理。try {需要被检测的代码;}catch(异常类 变量名){异常处理代码;}fianlly{ 一定会执行的代码;}java提供了很丰富的异常子类,另外开发者还可以自定义异常类丰富异常。 I/O I/O就是Input/Output,在编程语言中就是输入输出流,编写一个好的输入输出流系统不是一个很好实现的工作。 File file是java中用于管理文件的类,使用它可以生成文件目录,修改文件名,删除文件,判断文件所在路径等,是I/O非流式的组成部分。 InputStream inputStream二进制字节输入流,是所有输入流抽象父类。定义输入流所具备的所有特征 OutputStream outputStream是inputStream的对位抽象类,是所有输出流的父类 Reader reader是基于字符输入流的抽象类 Writer writer是基于字符输出流的抽象类 所谓的”流“就是代表任何有能力产出数据的数据源对象或者是有能力接受数据的接收端对象,流的本质是数据传输,设计者将不同的数据类型传输抽象成各种不同的类进行数据操作,因此某某类被定义为流的含义就是为数据之间提供传输通道。 泛型 泛型是JDK1.5引入的新特性,这是java的提供的编译时安全检测机制,本质是参数化类型,将要操作的数据类型被指定为参数,也就是为集合存储的元素指定数据类型,在存储的时候必须存入指定的数据类型的数据。 泛型一般应用于集合,也可以使用在方法和类上,如果你不知道具体的数据类型的话也可以使用通配符"?"来表示未知数据类型。 集合

优秀的个人博客,低调大师

8.JSP基础

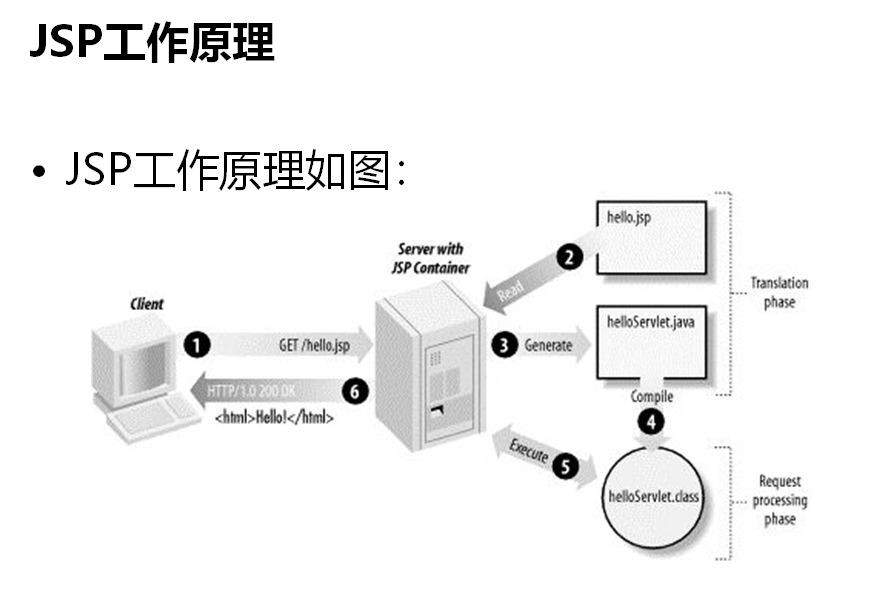
1.Servlet与JSP关系 JSP工作原理: 一个JSP文件第一次被请求时,JSP引擎把该JSP文件转换成为一个servlet JSP引擎使用javac把转换成的servlet的源文件编译成相应的class文件对每一个请求,JSP引擎创建一个新的线程来处理请求。 JSP的Servlet本质: 2.JSP页面生命周期 阶段 描述 转译 将JSP源文件转译成对应的Servlet源文件 编译 编译Java源文件为类文件 加载 将类加载至内存 实例化 创建一个Servlet类实例对象 初始化 调用_jspInit()方法,最终调用Servlet类的init()方法初始化 服务 调用_jspService()方法,最终调用Servlet类的service()方法,将请求和响应传递进对应的doXXX()方法 销毁 调用_jspDestroy()方法,最终调用destroy()方法,销毁Servlet 3.JSP与Servlet的内部转换: JSP转译Servlet(Java生命周期第一阶段) : 解析 校检 转译 4.page伪指令属性 import属性(相当于java中的import) 用于描述JSP页面中使用类的全包名,可选属性<%@page import=“java.io.*,java.sql.*”%>默认导入包:java.lang、javax.servlet、javax.servlet.jsp、javax.servlet.httpsession属性session属性指定页面是否需要一个http会话<%@page session=“true/false”%> errorPage和isErrorPage属性(JSP异常处理)JSP产生一个不能捕获的溢出时跳转到一个错误页面<%@page errorPage=“error.jsp”%>在error.jsp页面中必须加入<%@page isErrorPage=“true”%>才能进行错误处理 language和extends属性language属性指定JSP页面中声明、脚本、和表达式中使用语言,默认是Java<%@page language=“java” %>extends属性用于指定JSP页面对应Servlet类的基类,极少使用<%@page extends=“mypackage.BaseServlet”%> language和extends属性language属性指定JSP页面中声明、脚本、和表达式中使用语言,默认是Java<%@page language=“java” %>extends属性用于指定JSP页面对应Servlet类的基类,极少使用<%@page extends=“mypackage.BaseServlet”%> contentType和pageEncoding属性contentType属性指定页面响应的MIME类型和字符编码<%@page contentType =“text/html;charset=UTF-8” %>pageEncoding属性用于指定JSP页面字符编码格式,默认值为ISO-8859-1<%@page pageEncoding =“UTF-8”%>

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册