首页 文章 精选 留言 我的

精选列表

搜索[分布式能力],共10007篇文章
优秀的个人博客,低调大师

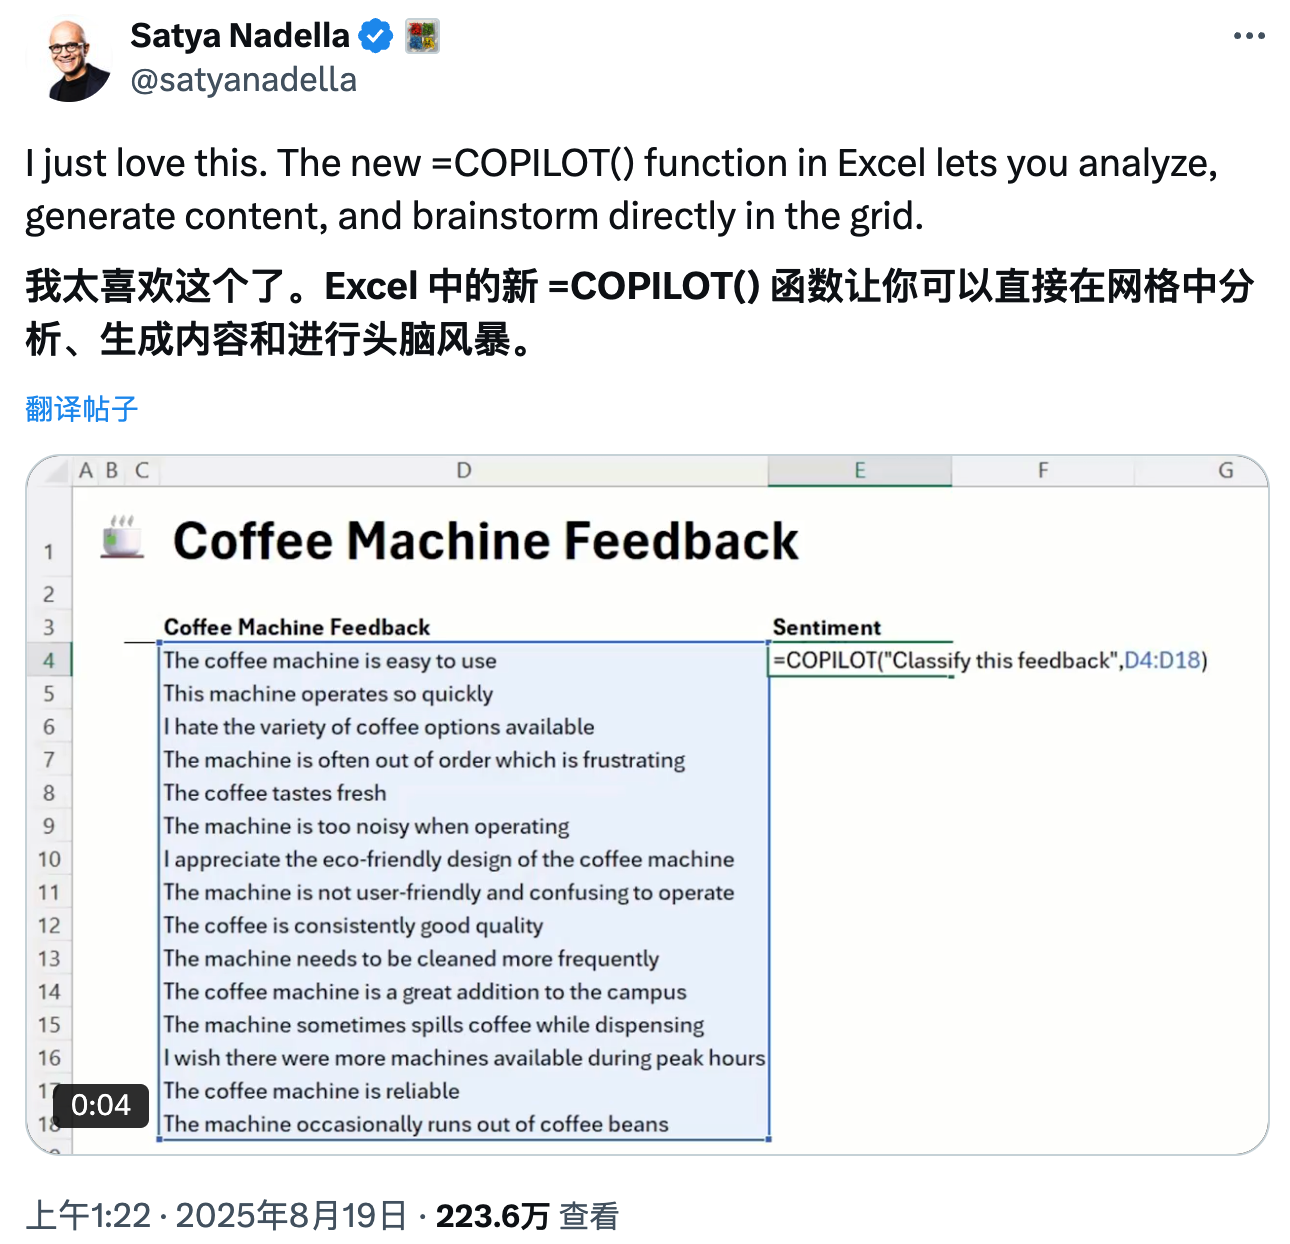
微软为 Excel 添加 =COPILOT() 函数,引入 LLM 能力

微软正在为 Excel 添加一项名为 =COPILOT() 的新函数,该功能将大型语言模型 (LLM) 的特性直接集成到电子表格的单元格中,可用于数据分析和内容生成。 用户可以直接在网格内使用此函数来帮助填充单元格。根据指定的一组单元格数据,=COPILOT() 函数可以利用 AI 进行分析、生成内容和头脑风暴。具体功能包括生成摘要、标签、表格等。 https://techcommunity.microsoft.com/blog/microsoft365insiderblog/bring-ai-to-your-formulas-with-the-copilot-function-in-excel/4443487

优秀的个人博客,低调大师

Grafana 收购开源项目 Pyroscope,提升代码分析能力

开源可观察性平台 Grafana Labs 近日宣布,他们已经收购了 Pyroscope 开源持续分析项目背后的同名公司。收购之后,Grafana 计划将 Pyroscope 与它的 Grafana Phlare 连续观察性数据库整合,合并后的服务将被更名为 Grafana Pyroscope。 Pyroscope 成立于 2020 年,创始人是 Ryan Perry 和 Dmitry Filimonov,该项目由知名的孵化器 Y Combinator 支持,并在 2021 年获得了种子轮融资。 Pyroscope 可以通过其代理和使用 eBPF 直接从 Linux 内核收集整个公司的基础设施的数据。将 Pyroscope 和 Phlare 整合在一起,可以加快在 Grafana Cloud 中推出持续分析的计划,这将使分析与指标、日志和追踪进行关联变得更加容易。这样也可以帮助工程团队更深入地了解他们的系统,快速识别和解决问题,并最终更快地交付更好的软件。 Grafana 认为持续分析是继指标、日志和追踪之后,可观察性的第四个支柱。 Grafana Labs 的首席技术官 Tom Wilkie 表示: 我们很欣赏 Pyroscope 团队所做的工作,Pyroscope、Phlare 和 Grafana 的结合将真正有助于将持续分析带给大众。他们已经围绕持续分析建立了一个优秀的社区,我们期待着与该团队和社区合作,推动分析技术的发展。 Pyroscope 首席执行官 Ryan Perry 表示: 在我们构建 Pyroscope 的过程中,我们意识到 Pyroscope 的 Grafana 插件,以及与 Grafana 生态的整合将在加速开源应用和支持 Pyroscope Cloud 用户方面发挥关键作用。随着我们与 Grafana 和 Phlare 团队的合作越来越密切,我们发现两个项目越来越一致,合并它们将是服务用户的最佳方式。 目前 Pyroscope 在 GitHub 上有 7.5k Stars,后续 Pyroscope 和 Grafana Phlare 的代码仓库也会合并到 Grafana Pyroscope 项目之下。Grafana Pyroscope 是一个新的项目,团队还需要一些时间才能完成代码库的合并,以及发布新项目下的第一个版本。 双方均没有透露此次收购的金额。

优秀的个人博客,低调大师

D 语言/DLang 2.096.0 发布,增强跨平台能力!

DMD 2.096.0 正式发布更新,DMD 是 D语言官方推出的编译器,此版本包含了 17 项主要变更,同时修复 81 个已知bug。相信过几天 LDC 也会跟进到本次大更新!这个版本有 54 个开发者进行参与,非常感谢他们为 DLang 的发展做出的贡献。 编译器变更 x86_64 Posix 平台下的 D ABI 有所更改 新增类型:__c_complex_float、__c_complex_double 和 __c_complex_real 不再支持构造函数复制和块复制(postblit) DMD 的 JSON 输出现在会包含保护级成员 DMD 的 JSON 输出现在会区分处理模块的构造方法和析构方法(包含有无shared的情形) 局部模板不再支持接收通过别名(alias)传入的局部符号 增强了 C++ 头文件的生成功能 新增编译器开关:-gdwarf=<version> 新增 __traits(getVisibility, Sym) 来替代 getProtection 无参的 synchronized 语句现在会使用运行时分配的互斥量 允许使用更短形式的函数实现(单一表达式函数) 运行时变更 移除了 druntime 里的参数选项 callStructDtorsDuringGC 在 mount 模块里,移除了与 FreeBSD 相关的 statvfs 声明 新增体验功能:基于 backtrace 输出的 llvm-libunwind 库变更 弃用 std.math 模块里的 approxEqual 方法 Dub变更 支持更多 DMD 的连接器参数 VisualD 的工程里允许使用 copyFiles 更多参考 DMD 2.096.0 – Changelog

优秀的个人博客,低调大师

Android 快速集成文档校正能力 超简单

前言 在之前的《超简单集成华为HMS ML Kit文本识别SDK,一键实现账单号自动录入》文章中,我们给大家介绍了华为HMS ML Kit文本识别技术如何通过拍照自动识别照片中的文本信息。那么有的小伙伴可能会问,如果拍照时不是正对着文本拍摄,拍出来的照片是歪斜的,那么还能准确识别文本吗?当然可以啦。HMS ML Kit文档校正技术可以自动识别文档位置,校正拍摄角度,并且支持用户自定义边界点位置,即使在倾斜角度也能够拍摄出文档的正面图像。 应用场景 文档校正技术在生活中有很多的应用场景。比如说在拍摄纸质文档时,相机处于倾斜的角度,导致阅读文档非常不方便。使用文档校正技术可以把文档调整到正对的视角,这样阅读起来就顺利多了。 再比如在记录卡证信息时,使用文档校正技术,不需要调整到正对卡证的视角,也可以拍摄出卡证的正面照片。 另外,在行程中因为身处于倾斜位置,道路旁的路牌难以准确识别,这时可以通过文档校正技术拍摄到路牌正面图片。 怎么样,是不是很方便呢?那我们接下来详细给大家介绍安卓如何快速集成文档校正技术。 开发实战 详细的准备步骤可以参考华为开发者联盟: https://developer.huawei.com/consumer/cn/doc/development/HMS-Guides/ml-process-4 这里列举关键的开发步骤。 1.1 项目级gradle里配置Maven仓地址 buildscript { repositories { ... maven {url 'https://developer.huawei.com/repo/'} } } dependencies { ... classpath 'com.huawei.agconnect:agcp:1.3.1.300' } allprojects { repositories { ... maven {url 'https://developer.huawei.com/repo/'} } } 1.2 应用级gradle里配置SDK依赖 dependencies{ // 引入基础SDK implementation 'com.huawei.hms:ml-computer-vision-documentskew:2.0.2.300' // 引入文档检测/校正模型包 implementation 'com.huawei.hms:ml-computer-vision-documentskew-model:2.0.2.300' } 1.3 在文件头添加配置 apply plugin: 'com.huawei.agconnect' apply plugin: 'com.android.application' 1.4 添加如下语句到AndroidManifest.xml文件中,自动更新机器学习模型到设备 <meta-data android:name="com.huawei.hms.ml.DEPENDENCY" android:value= "dsc"/> 1.5 申请摄像机权限和读本地图片权限 <uses-permission android:name="android.permission.CAMERA" /> <uses-permission android:name="android.permission.READ_EXTERNAL_STORAGE" /> 2. 代码开发 2.1 创建文本框检测/校正分析器 MLDocumentSkewCorrectionAnalyzerSetting setting = new MLDocumentSkewCorrectionAnalyzerSetting.Factory().create(); MLDocumentSkewCorrectionAnalyzer analyzer = MLDocumentSkewCorrectionAnalyzerFactory.getInstance().getDocumentSkewCorrectionAnalyzer(setting); 2.2 通过android.graphics.Bitmap创建MLFrame对象用于分析器检测图片,支持的图片格式包括:jpg/jpeg/png,建议图片尺寸不小于320320像素,不大于19201920像素。 MLFrame frame = MLFrame.fromBitmap(bitmap); 2.3 调用asyncDocumentSkewDetect异步方法或analyseFrame同步方法进行文本框的检测。当返回码是MLDocumentSkewCorrectionConstant.SUCCESS时,将会返回文本框的四个顶点的坐标值,该坐标值是相对于传入图像的坐标,若与设备坐标不一致,需调用者进行转换;否则,返回的数据没有意义。 // asyncDocumentSkewDetect异步调用。 Task<MLDocumentSkewDetectResult> detectTask = analyzer.asyncDocumentSkewDetect(mlFrame); detectTask.addOnSuccessListener(new OnSuccessListener<MLDocumentSkewDetectResult>() { @Override public void onSuccess(MLDocumentSkewDetectResult detectResult) { // 检测成功。 } }).addOnFailureListener(new OnFailureListener() { @Override public void onFailure(Exception e) { // 检测失败。 } }) // analyseFrame同步调用。 SparseArray<MLDocumentSkewDetectResult> detect = analyzer.analyseFrame(mlFrame); if (detect != null && detect.get(0).getResultCode() == MLDocumentSkewCorrectionConstant.SUCCESS) { // 检测成功。 } else { // 检测失败。 } 2.4 检测成功后,分别获取文本框四个顶点的坐标数据,然后以左上角为起点,按顺时针方向,分别把左上角、右上角、右下角、左下角加入到列表(List<Point>)中,最后构建MLDocumentSkewCorrectionCoordinateInput对象。 2.4.1 如果使用analyseFrame同步调用,先获取到检测结果,如下所示(使用asyncDocumentSkewDetect异步调用可忽略此步骤直接进行步骤2.4.2): MLDocumentSkewDetectResult detectResult = detect.get(0); 2.4.2 获取文本框四个顶点的坐标数据并构建MLDocumentSkewCorrectionCoordinateInput对象: Point leftTop = detectResult.getLeftTopPosition(); Point rightTop = detectResult.getRightTopPosition(); Point leftBottom = detectResult.getLeftBottomPosition(); Point rightBottom = detectResult.getRightBottomPosition(); List<Point> coordinates = new ArrayList<>(); coordinates.add(leftTop); coordinates.add(rightTop); coordinates.add(rightBottom); coordinates.add(leftBottom); MLDocumentSkewCorrectionCoordinateInput coordinateData = new MLDocumentSkewCorrectionCoordinateInput(coordinates); 2.5 调用asyncDocumentSkewCorrect异步方法或syncDocumentSkewCorrect同步方法进行文本框的校正。 // asyncDocumentSkewCorrect异步调用。 Task<MLDocumentSkewCorrectionResult> correctionTask = analyzer.asyncDocumentSkewCorrect(mlFrame, coordinateData); correctionTask.addOnSuccessListener(new OnSuccessListener<MLDocumentSkewCorrectionResult>() { @Override public void onSuccess(MLDocumentSkewCorrectionResult refineResult) { // 检测成功。 } }).addOnFailureListener(new OnFailureListener() { @Override public void onFailure(Exception e) { // 检测失败。 } }); // syncDocumentSkewCorrect同步调用。 SparseArray<MLDocumentSkewCorrectionResult> correct= analyzer.syncDocumentSkewCorrect(mlFrame, coordinateData); if (correct != null && correct.get(0).getResultCode() == MLDocumentSkewCorrectionConstant.SUCCESS) { // 校正成功。 } else { // 校正失败。 } 2.6 检测完成,停止分析器,释放检测资源。 if (analyzer != null) { analyzer.stop(); } Demo效果 下面这个demo展示了在倾斜角度扫描文档,文档校正技术可以把文档调整到正对视角。效果是不是很棒? 文档校正技术还可以辅助文档识别技术,将倾斜的文档调整到正面视角,快速实现从纸质文件到电子文件的转化,大幅度提升信息的录入效率。 Github源码 https://github.com/HMS-Core/hms-ml-demo/blob/master/MLKit-Sample/module-text/src/main/java/com/mlkit/sample/activity/DocumentSkewCorretionActivity.java 更详细的开发指南参考华为开发者联盟官网 https://developer.huawei.com/consumer/cn/hms/huawei-mlkit 欲了解更多详情,请参阅: 华为开发者联盟官网:https://developer.huawei.com/consumer/cn/hms 获取开发指导文档:https://developer.huawei.com/consumer/cn/doc/development 参与开发者讨论请到Reddit社区:https://www.reddit.com/r/HMSCore/ 下载demo和示例代码请到Github:https://github.com/HMS-Core 解决集成问题请到Stack Overflow:https://stackoverflow.com/questions/tagged/huawei-mobile-services?tab=Newest 文章来源:https://developer.huawei.com/consumer/cn/forum/topicview?tid=0202344452930050418&fid=18 作者:留下落叶

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。


用户登录
用户注册