首页 文章 精选 留言 我的

精选列表

搜索[eccv],共78篇文章
优秀的个人博客,低调大师

ECCV 2018 | Pixel2Mesh:从单帧RGB图像生成三维网格模型

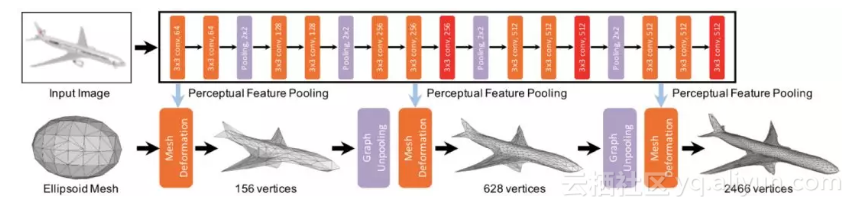
该论文由复旦大学、普林斯顿大学、Intel Labs 和腾讯 AI Lab 合作完成。文章提出了一种端到端的深度学习框架,可从单张彩色图片直接生成三维网格(3D Mesh)。 受深度神经网络特性的限制,以前的方法通常用 volume 或者 point cloud 表示三维形状,将它们转换为更易于使用的 mesh 并非易事。与现有方法不同,本文使用图卷积神经网络表示 3D mesh,利用从输入图像中提取的特征逐步对椭球进行变形从而产生正确的几何形状。本文使用由粗到精的模式进行生成,使得整个变形过程更加稳定。 此外,本文还定义了几种与 mesh 相关的损失函数捕捉不同级别的特性,以保证视觉上有吸引力并且物理上高重建精度。大量实验表明,本文的方法不仅定性上可以生成细节更加充分的 mesh 模型,而且与当前最好的方法相比也实现了更高的重建精度。 三维数据有多种表示形式,包括 volume、point cloud、mesh 等。volume 是一种规则的数据结构,即将物体表示为的 N3 格子,受分辨率和表达能力限制,这种表示方法通常缺乏细节。 point cloud 是一种不规则的数据结构,由于点之间没有局部连结关系,点云往往缺乏物体的表面信息;3D Mesh 同样是一种不规则的数据结构,由点、边和面组成,由于其轻量、形状细节丰富等特性,在虚拟现实、动画游戏、生产制造等实际产业中应用越来越广泛,本文研究如何从单张 RGB 图重建出对应的 3D mesh 模型。 模型架构 ▲ Figure 1: Pixel2Mesh的架构 Pixel2Mesh 的架构如图 1 所示。对于输入图像,设计一个多层的卷积神经网络,用于提取图片不同层次的特征。对于输出三维网格,设计了 3 个级联的变形模块,由图神经网络构成。Perceptual feature pooling 层可根据网格顶点坐标得到投影的图片特征,然后根据此特征不断对初始的椭球进行变形,以逼近真实形状。Graph unpooling 层用于增加三维网格节点和边的数量。 本文的目的在于提出一种生成结果光滑、重建精度高的利用单张彩色图生成物体三维网格模型的方法。本文没有直接采用生成 3D Mesh 的方法,而是采用将一个固定的椭球依据图像特征逐渐形变成目标形状的策略。本文针对两个三维网格重建难点给出了解决方案: 1. 3D Mesh 的表示问题—引入图卷积神经网络。3D mesh 一般使用非规则数据形式—图(Graph)来表示,而同时整个网络还需要对其输入的规则的图像数据进行特征抽取。本文使用图卷积网络(GCN)来处理三维网格,使用类似于 VGG-16 的网络来提取二维图像特征。为了将两者联系在一起,设计了一个投影层使得网格中的每个节点能对应获取相应的二维图像的特征。 上图(a)中 P 是从输入图片得来的特征,是顶点的位置,两者组合可得到相应的投影特征,再与 GCN 的特征简单合并送入网格形变模块(Mesh Deformation Block)中。整个网络包含若干该模块。上图(b)是依据相机参数进行投影的示意图。 2. 如何有效地更新网格的形状—引入图的上池化层。实验发现,直接训练网络使其预测 mesh 的效果并不好。一个原因是如果直接预测较大数量的点的网格,顶点的感受野会有受限,即 mesh 的顶点无法有效地检索邻近顶点的特征。为了解决这个问题,本文设计了一个图的上池化层(Graph unpooling layer),使得点的数量逐渐由少到多,相应的网格形状由粗到细,既保留了全局信息,又具有细节的表达。 上图是图的上池化过程。(a)中的黑色顶点即为新增的顶点,连接的虚线即为新增的边。这是 Edge-based 的方式,还有一种 Face-based 的方式,即在每个三角形中心添加一个顶点,但这样会造成网格顶点不均衡的问题,如(b)所示。在实际操作中,每个新增的点位于旧三角形的边的中点位置,特征的值取相邻两顶点的均值。 损失函数 本文定义了四种不同的损失函数来促使网格更好地形变。 本方法对输入图像进行的三维网格建模的结果: ▲ Qualitative results. (a) Input image; (b) Volume from 3D-R2N2 [1], converted using Marching Cube [4]; (c) Point cloud from PSG [2], converted using ball pivoting [5]; (d) N3MR[3]; (e) Ours; (f) Ground truth. 实验结果 F-score (%) 本文提出的方法在 ShapeNet 测试数据集上的表现,除了当阈值为时在 watercraft 类低于 PSG,其他指标均达到了最好水平。 CD 和 EMD 对于 CD 和 EMD,在 ShapeNet 测试集上,本文的方法在多数情况下都达到了最好水平。 原文发布时间为:2018-09-10 本文作者:让你更懂AI 本文来自云栖社区合作伙伴“PaperWeekly”,了解相关信息可以关注“PaperWeekly”。

优秀的个人博客,低调大师

ECCV 2026 | 让3DGS实时跑在手机上!Flux-GS:移动端3D重建的突围

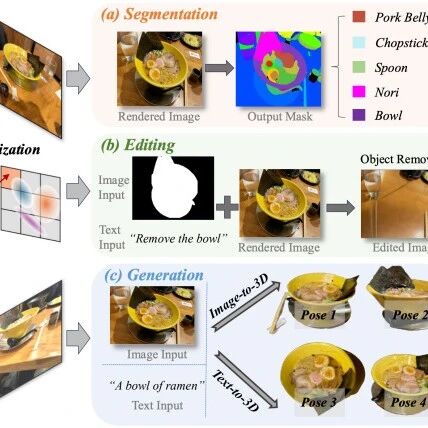
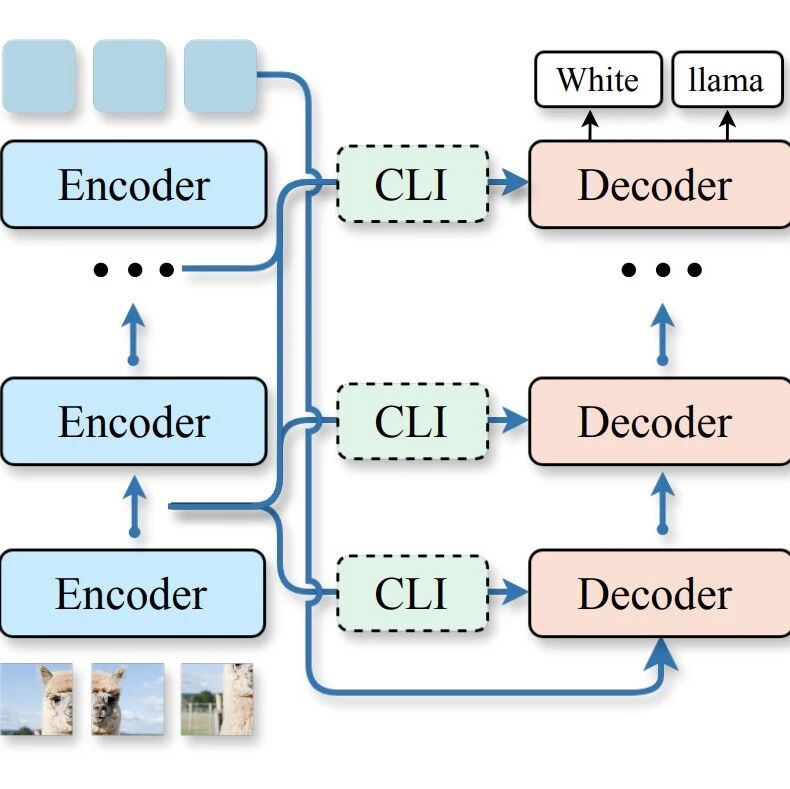
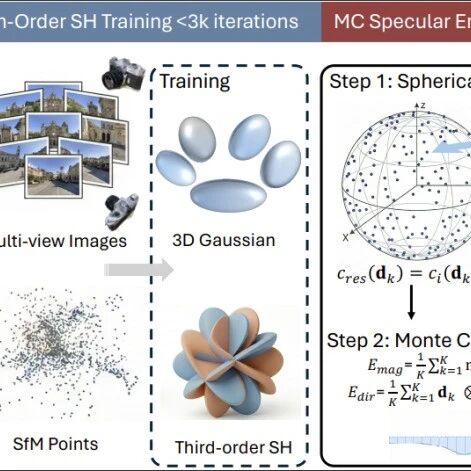
![](https://developer.qcloudimg.com/http-save/yehe-1638669/1bbb241810df0ce689350f8480d3248b.png) Project Page: https://xiaobiaodu.github.io/flux-gs-project/ Code(移动端与训练代码均已开源): https://github.com/xiaobiaodu/Flux-GS 在 3D 计算机视觉的宏大演变中,2023 年注定是被 **3D 高斯泼溅(3DGS)** 点亮的一年。这项技术以其显式的点云表达和惊艳的微分渲染,在桌面级高性能显卡上掀起了一场视听风暴,让静态照片跃升为可任意穿梭的真实动态场景。然而,当科学家们试图将这套华丽的视觉盛宴移植到人人都有的移动端(手机、平板)时,却迎头撞上了一堵由算力与显存构成的冷酷高墙。 由悉尼科技大学、百度以及阿德莱德大学的研究团队共同撰写的最新论文 `Flux-GS`,就讲述了一场让 3D 真实场景在资源受限的边缘设备上实现“瘦身与狂飙”的突围故事。他们带来的新主角 **Flux-GS**,成功突破了移动端性能的层层围剿。 --- ## **一、 沉重的背包与盲目的工匠:移动端的两大梦魇** 要想理解 Flux-GS 的破局之智,我们必须先回到传统 3DGS 曾置身其中的“泥潭”。在移动端渲染的微观世界里,有两个致命的瓶颈像大山一样压在手机 GPU 上: ### **1. 不堪重负的球谐函数(SH)背包** 为了在不同的观看视角下呈现出物体表面水润的反光、金属的色泽以及细腻的高光,传统的 3DGS 为每个高斯点都装备了一个多达 **三阶的球谐函数(SH)** 背包。这意味着,哪怕只是渲染一个极其微小的几何碎屑,都必须强行附带 48 个浮点数参数。当一个复杂的场景容纳了数百万个高斯点时,这个背包就会膨胀为数百兆乃至数吉字节的“内存巨兽”,在手机纤细的内存带宽通道里引发严重的交通瘫痪。 ### **2. 盲人摸象的“单视角”工匠** 在场景构建(稠密化)阶段,传统算法就像一个缺乏全局视野的工匠。它每次只盯着一张图片的渲染误差进行修补,一旦发现哪里画得不够精细,就盲目地在该区域疯狂堆砌新的高斯点。这种“单视角梯度驱动”的短视策略,导致场景中充斥着海量结构重复、视角过拟合的冗余高斯点。它们不仅拖慢了训练速度,更让手机渲染时每秒传输的帧数(FPS)直接跌入个位数的冰点。 ![](https://developer.qcloudimg.com/http-save/yehe-1638669/e92d1ef0190b1d7bde99592d2a371d43.png) --- ## **二、 破局者的解构主义:Flux-GS 的三大核心战术** 面对这头“性能怪兽”,研究团队没有选择硬碰硬的硬件对抗,而是像精密的解构主义大师,用数学和逻辑对 3DGS 进行了大刀阔斧的重构。 ![](https://developer.qcloudimg.com/http-save/yehe-1638669/9cdfb076843ee5b071a1b99f8a747aa1.png) ### **战术一:蒙特卡洛镜面能量聚合(MC-SEA)—— 优雅的打包压缩** 如果为了追求速度直接丢弃高阶球谐函数,原本波光粼粼的金属和镜面就会瞬间变成粗糙的哑光水泥,这在视觉体验上是无法接受的。 - **破局思路**:Flux-GS 提出了一个极具智慧的折中方案。它让模型在训练初期(前 3000 次迭代)自由地使用高阶 SH 来捕捉高频的光影细节。 - **核心数学操作**:随后,它在单位球面上均匀布下 个采样点,利用**蒙特卡洛球面采样(Uniform Spherical Sampling)**精准计算出高阶与低阶 SH 之间的“光影残差”。它摒弃了冗余的全球扰动,通过球面投影将这些散落的高频镜面能量精确提炼为第一阶方向矩,打包压缩进一个极为紧凑的潜在空间里。 - **结果**:原本 Bulky 的高阶参数被无情剥离,取而代之的是极为轻量的**一阶 SH 表达**(每个通道只需 4 个系数),成功为高斯点的物理内存踩了一脚暴减 61% 和 26% 的深刹车,同时奇迹般地保住了视点依赖的镜面反光。 ### **战术二:属性条件增强 —— 隐形的“静态烘焙”补丁** 参数压缩难免会带来微小的色彩和细节损失,如何补救? - **破局思路**:团队设计了一个Attribute-Conditioned SH Enhancement(属性条件 SH 增强)模块。它通过一个 4 层的轻量级多层感知机(MLP),根据高斯点本身的位置、缩放、旋转以及不透明度等内在几何属性,动态预测出一个用于修正一阶 SH 的“细节补丁”(Offset)。 - **惊艳的架构设计**:妙就妙在,这些属性完全是高斯点固有的,与你的相机在哪、从哪个角度看毫无关系。因此,在模型正式交付运行(推理)之前,这个细节补丁就已经被**一次性解码并静态烘焙(Bake)到了显式的高斯点参数中**。在手机端渲染时,该模块对应的网络完全不需要参与实时计算,实现了**真正的零推理计算成本**! ![](https://developer.qcloudimg.com/http-save/yehe-1638669/646fd6624fb80b053a492ce1d82a6c21.png) ### **战术三:多视角协同审视 —— 全局眼光精准删点** 为了把高斯点数的预算压到极致,Flux-GS 彻底解雇了那个“单视角工匠”,换上了具有全局视野的“协同审查委员会”。 - **分层相机采样**:算法首先把 3D 场景按方位角和仰角划分为多个格子,从训练相机阵列中精心挑选出 6 个角度分散度最大的代表性视角,形成一个具有全局 geometric 覆盖的相机子集。 - **多视角 Alpha 累积**:在训练中,它在 CUDA 内核层面对这 6 个视角的渲染误差进行联合审查,并结合高斯点对像素颜色的 Alpha(不透明度)可见性贡献进行加权误差累积。 - **精准增删**:它设立了严苛的门槛(设置分位数阈值 和 )。只有在多个视角下都被反复证明“对高误差区域有重大视觉贡献”的高斯点,才允许被克隆或分裂;而对于那些滥竽充数、对画面贡献极低或者处于低误差(已重建完好)区域的高斯点,则给予温和但坚决的裁剪。通过这种多视角联动,高斯点云的膨胀被彻底遏制,留下的全是最精炼的几何骨干。 --- ## **三、 在骁龙 8 Gen 3 上的性能狂飙** 这场技术突围的最终成效如何?在搭载高通骁龙 8 Gen 3 GPU 的商用智能手机上,以及 Mip-NeRF 360、Tanks and Temples 等主流评测数据集中,Flux-GS 展现出了令人惊叹的工业级性能表现。 我们可以通过下面这张详实的数据表,直观地感受这场技术变革带来的震撼: ![](https://developer.qcloudimg.com/http-save/yehe-1638669/51ea4c93cbf044018c42ee2c45482bf6.png) ![](https://developer.qcloudimg.com/http-save/yehe-1638669/3ec78c9b01dd638a1090a9cc7313d14c.png) **从具体的实测中,我们可以读出三个颠覆性的结论:** 1. **从 11 到 151 的速度神话**:在传统的 3DGS 下,由于巨大的显存带宽压力,骁龙手机每秒只能艰难地吐出 11 帧画面(如同幻灯片般卡顿)。而 Flux-GS 凭借极致精简的一阶 SH 和紧凑的点云结构,直接将速度推上了 **151 FPS** 的极速巅峰,甚至超越了去掉了实时 MLP 推理开销的 Mobile-GS 变体(137 FPS)。 1. **画质的无损坚守**:在把模型体积从 478MB 甚至几百兆的庞大身躯斩落至区区数兆字节后,Flux-GS 的画面渲染质量(室内 PSNR 达 30.21dB)依然能够与未压缩的三阶 3DGS 原型(30.14dB)难分伯仲,机械结构和局部纹理结构清晰可辨,完全没有出现其他轻量级方法常见的严重模糊现象。 1. **开发效率的断崖式跃升**:由于多视角剪枝策略从根本上削减了高斯点的庞大基数,Flux-GS 在台式机 RTX 4090 上的单场景训练收敛时间被狠狠压缩到了 **10 至 13 分钟左右**。相比之下,之前行业标杆 Mobile-GS 依赖繁重的知识蒸馏(Teacher-Student Distillation),训练一个场景动辄耗时 100 到 150 分钟,Flux-GS 带来了接近 10 倍的效率飞跃。 ![](https://developer.qcloudimg.com/http-save/yehe-1638669/eccdde783ec113cd2103c10d862122df.png) --- ## **四、 未来** Flux-GS 的出现,无疑为空间计算(Spatial Computing)走向大众日常硬件铺平了一条黄金通道,更通过无缝适配 **WebGL** 技术,让用户无需下载任何 App,只需在手机网页浏览器里动动手指,就能流畅探索高画质的 3D 虚拟世界。 然而,没有任何一项技术是绝对完美的,论文在结尾也展现了客观的学术诚实,指出了 Flux-GS 的几点局限: - **极端镜面的能力上限**:由于基底被强制约束在一阶 SH,面对像高光水面、光滑明镜等具有极端视点依赖性的“镜面反射”场景时,它对极致反光的还原上限依然略逊于完整的וכ三阶 SH。 - **初始训练的显存峰值**:因为算法在前 3000 次迭代中仍需借助三阶 SH 来捕捉高频辐射能量,这意味着虽然它的最终产物极其轻量,但最初训练那一刻的峰值显存消耗依然无法摆脱传统 3DGS 的高门槛。 - **死角几何的误剪风险**:多视角协同剪枝高度依赖分层相机采样的覆盖度,若场景中存在某些只在极度刁钻、狭窄的未采样视角下才可见的微小隐蔽结构,多视角机制有可能会误将其判定为 redundant(冗余)点而无情剔除。 **展望未来**,将 Flux-GS 的多视角精简智慧引入到基于码本(Codebook-based)的量化编码或熵编码中,有望将 3D 场景的体积进一步压缩到网络传输的极限。同时,将这套高效的一阶流式架构扩展到动态 4D 高斯领域,或许在不久的将来,我们就能在自己的手机上,无缝点播并流畅交互真正意义上的 3D 体积视频(Volumetric Video)。 **本文系学术转载,如有侵权,请联系CVer小助手删文**

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册