首页 文章 精选 留言 我的

精选列表

搜索[GPU算子],共6873篇文章
优秀的个人博客,低调大师

Spark 算子

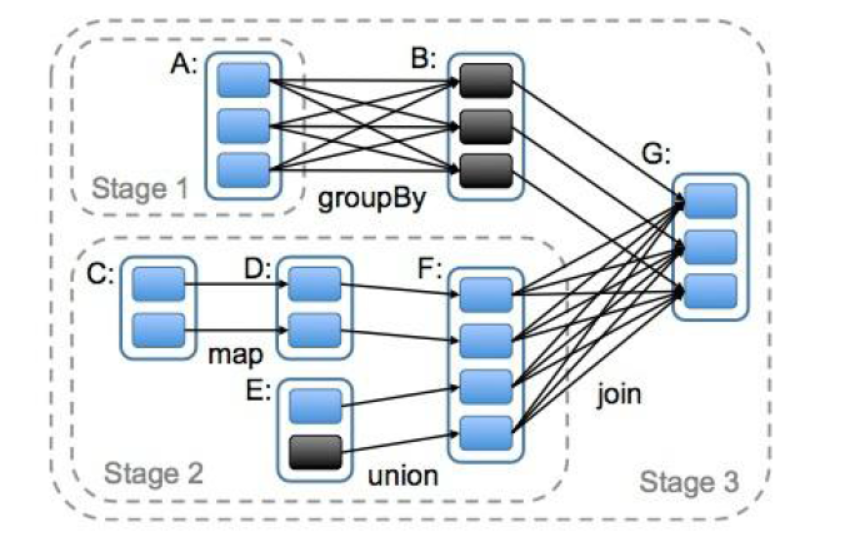
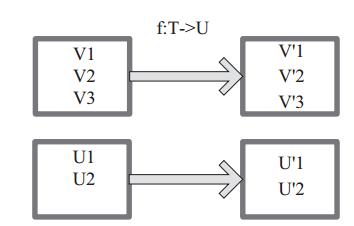
==>RDD是什么? ---> RDD(Resilient Distributed Dataset)弹性分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变,可分区,里面的元素可并行计算的集合 --->特点: ----自动容错 ----位置感知性高度 ----可伸缩性 ----允许用户在执行多个查询时显示的将工作集缓存在内存中,后续的查询能够重用工作集,极大的提升了查询速度 --->RDD的属性 ----A list of partitions 一个组分片,即数据集的基本组成单位 对于RDD来说,每个分片都会被一个计算任务处理,并决定并行计算的粒度,用户可以在创建RDD时指定 RDD的分片个数,如果没有指定,那么就会采用默认值,默认值就是程序所分配到的CPU Core的数目 ---- A function for computing each split 一个计算每个分区的函数 Spark中RDD的计算是以分片为单位的,每个RDD都会实现 compute函数以达到这个目的,compute函数会对迭代器进行复合,不需要保存每次计算的结果 ---- A list of dependencies on other RDDs RDD之间的依赖关系 RDD每次转换都会生成一个新的RDD,所以RDD之间就会形成类似于流水线一样的前后依赖关系。在部分数据丢失时,Spark可以通过这个依赖关系重新计算丢失的分区数据,而不是对RDD的所有分区进行重新计算 ---- Optionally, a Partitioner for key-value RDDs(e.g. to say that the RDD is hash-partitioned) 一个Partitioner,即RDD的分片函数 Spark中实现了两种类型的分片函数,一个是基于哈希的HashPartitioner,另外一个是基于RangePartitioner,只有对于key-value的RDD,才会有Partitioner,非key-value的RDD的Partitioner的值是None,Partitioner函数不但决定了RDD本身的分片数量,也决定了parentsRDDShuffle输出时的分片数量 ---- Optionally, a list of preferred locations to compute each split on (e.g. block locations for an HDFS file ) 一个列表,存储存取每个Partion的优先位置(preferredlocation) 对于一个 HDFS文件来说,这个列表保存的就是每个Partition所在的块的位置 按照“移动数据不如移动计算”的理念,Spark在进行任务调度的时候,会尽可能的将计算任务分配到其所要处理数据块的存储位置 ==>RDD的创建方式 --->通过外部的数据文件创建 (HDFS) 1 val rdd 1 = sc.textFile( "hdfs://192.168.10.210:9000/data/data.txt" ) --->通过 sc.parallelize进行创建 1 val rdd 2 = sc.parallelize(Array( 1 , 2 , 3 , 4 , 5 , 6 )) ==>RDD的基本原理 --->创建一个RDD: 1 2 //3代表分三个分区 val rdd 1 = sc.parallelize(Array( 1 , 2 , 3 , 4 , 5 , 6 , 7 , 8 ), 3 ) --->一个分区运行在一个Worker节点上,一个Worker上可以运行多个分区 ==> RDD 的类型 --->Trasformation RDD中的所有转换都是延迟加载的,即,不会返回计算结果,只记住这些应用到基础数据集(如,一个文件,一个列表等)上的转换动作,只有当发生一个要求返回结果给Driver时,这些转换才会执行(个人理解,与Scala中的 lazy (懒值)比较相似) 转换 含义 map(func) 返回一个新的RDD,该RDD由每一个输入元素经过 func函数转换后组成 filter(func) 返回一个新的RDD,该RDD由经过 func函数计算后返回值为 true的输入元素组成 flatMap(func) 类似于map ,但是每个输入元素可以被映射为 0或多个输出元素(返回一个序列) mapPartitions(func) 类似于map,但是独立的在RDD的每一个分片上运行,因此在类型为T 的RDD上运行时,func的函数类型必须是Iterator[T] => Iterator[U] mapPartitionsWithIndex(func) 类似于 mapPartitions,但func带有一个整数参数表示分片的索引值,因此在类型为T的RDD上运行时,func的函数类型必须是(Int, Interator[T])= > Iterator[U] sample(withReplacement, fraction, seed) 根据fraction指定的比例对数据进行采样,可以选择是否使用随机数进行替换, seed用于指定随机数生成器种子 union(otherDataset) 对源RDD和参数RDD求并集后返回一个新的RDD intersection(otherDataset) 对源RDD和参数RDD求交集后返回一个新的RDD distinct([numTasks]) 对源RDD去重后返回一个新的RDD groupByKey([numTasks]) 在 (k, v)的RDD上调用,返回一个(K, iterator[V])的RDD reduceByKey(func, [numTasks]) 在(k, v)的RDD上调用,返回一个(k, v)的RDD,使用指定的reduce函数,将相同key的值聚合到一起,与 groupByKey类似,reduce任务的个数可以通过第二个可选的参数来设置 aggregateByKey(zeroValue)(seqOp, combOp, [numTasks]) sortByKey([ascending], [numTasks]) 在一个(k, v)上调用,k必须实现Ordered接口,返回一个按照key进行排序的(k, v)的RDD sortBy(func, [ascending], [numTasks]) 与sortByKey类似,但是更灵活 join(otherDataset, [numTasks]) 在类型为(k, v)和(k, w)的RDD上调用,返回一个相同key对应的所有元素堆在一起的(k, (v, w))的RDD cogroup(otherDataset, [numTasks]) 在类型为(k, v)和(k, w)的RDD上调用 ,返回一个(k, (Iterable<v>, Iterable<w>))类型的RDD cartesian(otherDataset) 笛卡尔积 pipe(command, [envVars]) coalesce(numPartitions) repartitionAndSortWithinPartitions(partitions) --->Action reduce(fun) 通过func函数聚集RDD中的所有元素,这个功能必须是可交换且可并联的 collect() 在驱动程序中,以数组的形式返回数据集的所有元素 count() 返回元素个数 first() 反回RDD的第一个元素(类似于 take(1)) take(n) 返回一个由数据集的前 n个元素组成的数组 takeSample(withReplacement, num, [seed]) 返回一个数组,该数组由从数据集中随机采样的num个元素组成,可以选择是否用随机数替换不足的部分,seed用于指定随机数生成器种子 takeOrdered(n, [ordering]) saveAsTextFile(path) 将数据集的元素以textfile的形式保存到HDFS文件系统或者其它支持的文件系统,对每个元素,Spark将会调用toString方法将它转换为文件中的文本 saveAsSequenceFile(path) 将数据集中的元素以Hadoop sequencefile的格式保存到指定的目录下,可以使HDFS或者其它Hadoop支持的文件系统 saveAsObjectFile(path) countByKey() 针对(k, v )类型的RDD,返回一个(k, Int)的 map,表示每一个key对应的元素个数 foreach(func) 在数据集的每一个元素上运行函数 func进行更新 ==> RDD 的缓存机制 --->作用:缓存有可能丢失,或由于存储于内存中的数据由于内存不足而被删除,缓存容错机制保证了即使缓存丢失也能保证计算的正确执行 --->实现原理:通过基于RDD的一系列转换,丢失的数据会被重算,由于RDD的各个Partition是相对独立的,因此只需要计算丢失的部分即可,不用全部重新计算 --->运行方式:RDD通过 persist方法或 cache方法可以将前面的计算结果缓存,但并不会调用时便立缓存,而是触发后面的action时,此RDD会被缓存到计算机内存中,供后面重用 --->通过查看源码可以发现,cache最终调用的也是parsist 1 2 3 def persist() : this . type = persist(StorageLevel.MEMORY _ ONLY) def cache() : this . type = persist() --->缓存使用: 1 2 3 4 5 6 val rdd 1 = sc.textFile( "hdfs://192.168.10.210:9000/data/data.txt" ) rdd 1 .count //没有缓存,直接执行 rdd 1 .cache rdd 1 .count //第一次执行会慢一些 rdd 1 .count //第二次会很快 --->存储级别在object StorageLevel中定义 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 object StorageLevel{ val NONE = new StorageLevel( false , false , false , false ) val DISK _ ONLY = new StorageLevel( true , false , false , false ) val DISK _ ONLY _ 2 = new StorageLevel( true , false , false , false ) val MEMORY _ ONLY = new StorageLevel( false , true , false , true ) val MEMORY _ ONLY _ 2 = new StorageLevel( false , true , false , true ) val MEMORY _ ONLY _ SET = new StorageLevel( false , true , false , false ) val MEMORY _ ONLY _ SET _ 2 = new StorageLevel( false , true , false , false ) val MEMORY _ AND _ DISK = new StorageLevel( true , true , false , true ) val MEMORY _ AND _ DISK _ 2 = new StorageLevel( true , true , false , true ) val MEMORY _ AND _ DISK _ SET = new StorageLevel( true , true , false , false ) val MEMORY _ ADN _ DISK _ SET _ 2 = new StorageLevel( true , true , false , false ) val OFF _ HEAP = new StorageLevel = new StorageLevel( true , true , true , false ) } ==>RDD的Checkpoint(检查点)机制:容错机制 --->检查点本质是通过将RDD写入Disk做检查点 --->作用:通过做lineage做容错的辅助 --->运行机制:在RDD的中间阶段做检查点容错,之后如果有节点出现问题而丢失分区,从做检查点的RDD开始重新做Lineage,以达到减少开销的目的 --->设置检查点的方式:本地目录, HDFS ----本地目录(需要将spark-shell运行在本地模式上) 1 2 3 4 5 6 7 8 //设置检查点目录 sc.setCheckpointDir( "/data/checkpoint" ) //创建一个RDD val rdd 1 = sc.textFile( "hdfs://192.168.10.210:9000/data/data.txt" ) //设置检查点 rdd 1 .checkpoint //执行,触发Action,会在检查点目录生成检查点 rdd 1 .count ---- HDFS(需要将Spark-shell运行在集群模式上) 1 2 3 4 5 6 7 8 //设置检查点目录 sc.setCheckpointDir( "hdfs://192.168.10.210:9000/data/checkpoint" ) //创建一个RDD val rdd 1 = sc.textFile( "hdfs://192.168.10.210:9000/data/data.txt" ) //设置检查点 rdd 1 .checkpoint //执行,触发Action,会在检查点目录生成检查点 rdd 1 .count ==>RDD的依赖关系和Spark任务中的Stage ---> RDD依赖关系RDD和它的父RDD(s)的关系有两种不同的类型 ----窄依赖每个父RDD的partition只能被子RDD的一个partition使用一个子RDD ----宽依赖多个子RDD的partition会依赖同一个父RDD多个子RDD --->Stage划分Stage的依据是:宽依赖 本文转自 菜鸟的征程 51CTO博客,原文链接:http://blog.51cto.com/songqinglong/2074380

优秀的个人博客,低调大师

Spark学习之RDD简单算子

collect 返回RDD的所有元素 scala>varinput=sc.parallelize(Array(-1,0,1,2,2)) input:org.apache.spark.rdd.RDD[Int]=ParallelCollectionRDD[15]atparallelizeat<console>:27 scala>varresult=input.collect result:Array[Int]=Array(-1,0,1,2,2) count,coutByValue count返回RDD的元素数量,countByValue返回每个值的出现次数 scala>varinput=sc.parallelize(Array(-1,0,1,2,2)) scala>varresult=input.count result:Long=5 scala>varresult=input.countByValue result:scala.collection.Map[Int,Long]=Map(0->1,1->1,2->2,-1->1) take,top,takeOrdered take返回RDD的前N个元素 takeOrdered默认返回升序排序的前N个元素,可以指定排序算法 Top返回降序排序的前N个元素 varinput=sc.parallelize(Array(1,2,3,4,9,8,7,5,6)) scala>varresult=input.take(6) result:Array[Int]=Array(1,2,3,4,9,8) scala>varresult=input.take(20) result:Array[Int]=Array(1,2,3,4,9,8,7,5,6) scala>varresult=input.takeOrdered(6) result:Array[Int]=Array(1,2,3,4,5,6) scala>varresult=input.takeOrdered(6)(Ordering[Int].reverse) result:Array[Int]=Array(9,8,7,6,5,4) scala>varresult=input.top(6) result:Array[Int]=Array(9,8,7,6,5,4 ) Filter 传入返回值为boolean的函数,返回改函数结果为true的RDD scala>varinput=sc.parallelize(Array(-1,0,1,2)) scala>varresult=input.filter(_>0).collect() result:Array[Int]=Array(1,2) map,flatmap map对每个元素执行函数,转换为新的RDD,flatMap和map类似,但会把map的返回结果做flat处理,就是把多个Seq的结果拼接成一个Seq输出 scala>varinput=sc.parallelize(Array(-1,0,1,2)) scala>varresult=input.map(_+1).collect result:Array[Int]=Array(0,1,2,3) scala>varresult=input.map(x=>x.to(3)).collect result:Array[scala.collection.immutable.Range.Inclusive]=Array(Range(-1,0,1,2,3),Range(0,1,2,3),Range(1,2,3),Range(2,3)) scala>varresult=input.flatMap(x=>x.to(3)).collect result:Array[Int]=Array(-1,0,1,2,3,0,1,2,3,1,2,3,2,3) distinct RDD去重 scala>varinput=sc.parallelize(Array(-1,0,1,2,2)) scala>varresult=input.distinct.collect result:Array[Int]=Array(0,1,2,-1) Reduce 通过函数聚集RDD中的所有元素 scala>varinput=sc.parallelize(Array(-1,0,1,2)) scala>varresult=input.reduce((x,y)=>{println(x,y);x+y}) (-1,1)//处理-1,1,结果为0,RDD剩余元素为{0,2} (0,2)//上面的结果为0,在处理0,2,结果为2,RDD剩余元素为{0} (2,0)//上面结果为2,再处理(2,0),结果为2,RDD剩余元素为{} result:Int=2 sample,takeSample sample就是从RDD中抽样,第一个参数withReplacement是指是否有放回的抽样,true为放回,为false为不放回,放回就是抽样结果可能重复,第二个参数是fraction,0到1之间的小数,表明抽样的百分比 takeSample类似,但返回类型是Array,第一个参数是withReplacement,第二个参数是样本个数 varrdd=sc.parallelize(1to20) scala>rdd.sample(true,0.5).collect res33:Array[Int]=Array(6,8,13,15,17,17,17,18,20) scala>rdd.sample(false,0.5).collect res35:Array[Int]=Array(1,3,10,11,12,13,14,17,18) scala>rdd.sample(true,1).collect res44:Array[Int]=Array(2,2,3,5,6,6,8,9,9,10,10,10,14,15,16,17,17,18,19,19,20,20) scala>rdd.sample(false,1).collect res46:Array[Int]=Array(1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20) scala>rdd.takeSample(true,3) res1:Array[Int]=Array(1,15,19) scala>rdd.takeSample(false,3) res2:Array[Int]=Array(7,16,6) collectAsMap,countByKey,lookup collectAsMap把PairRDD转为Map,如果存在相同的key,后面的会覆盖前面的。 countByKey统计每个key出现的次数 Lookup返回给定key的所有value scala>varinput=sc.parallelize(List((1,"1"),(1,"one"),(2,"two"),(3,"three"),(4,"four"))) scala>varresult=input.collectAsMap result:scala.collection.Map[Int,String]=Map(2->two,4->four,1->one,3->three) scala>varresult=input.countByKey result:scala.collection.Map[Int,Long]=Map(1->2,2->1,3->1,4->1) scala>varresult=input.lookup(1) result:Seq[String]=WrappedArray(1,one) scala>varresult=input.lookup(2) result:Seq[String]=WrappedArray(two) groupBy,keyBy groupBy根据传入的函数产生的key,形成元素为K-V形式的RDD,然后对key相同的元素分组 keyBy对每个value,为它加上key scala>varrdd=sc.parallelize(List("A1","A2","B1","B2","C")) scala>varresult=rdd.groupBy(_.substring(0,1)).collect result:Array[(String,Iterable[String])]=Array((A,CompactBuffer(A1,A2)),(B,CompactBuffer(B1,B2)),(C,CompactBuffer(C))) scala>varrdd=sc.parallelize(List("hello","world","spark","is","fun")) scala>varresult=rdd.keyBy(_.length).collect result:Array[(Int,String)]=Array((5,hello),(5,world),(5,spark),(2,is),(3,fun)) keys,values scala>varinput=sc.parallelize(List((1,"1"),(1,"one"),(2,"two"),(3,"three"),(4,"four"))) scala>varresult=input.keys.collect result:Array[Int]=Array(1,1,2,3,4) scala>varresult=input.values.collect result:Array[String]=Array(1,one,two,three,four) mapvalues mapvalues对K-V形式的RDD的每个Value进行操作 scala>varinput=sc.parallelize(List((1,"1"),(1,"one"),(2,"two"),(3,"three"),(4,"four"))) scala>varresult=input.mapValues(_*2).collect result:Array[(Int,String)]=Array((1,11),(1,oneone),(2,twotwo),(3,threethree),(4,fourfour)) union,intersection,subtract,cartesian union合并2个集合,不去重 subtract将第一个集合中的同时存在于第二个集合的元素去掉 intersection返回2个集合的交集 cartesian返回2个集合的笛卡儿积 scala>varrdd1=sc.parallelize(Array(-1,1,1,2,3)) scala>varrdd2=sc.parallelize(Array(0,1,2,3,4)) scala>varresult=rdd1.union(rdd2).collect result:Array[Int]=Array(-1,1,1,2,3,0,1,2,3,4) scala>varresult=rdd1.intersection(rdd2).collect result:Array[Int]=Array(1,2,3) scala>varresult=rdd1.subtract(rdd2).collect result:Array[Int]=Array(-1) scala>varresult=rdd1.cartesian(rdd2).collect result:Array[(Int,Int)]=Array((-1,0),(-1,1),(-1,2),(-1,3),(-1,4),(1,0),(1,1),(1,2),(1,3),(1,4),(1,0),(1,1),(1,2),(1,3),(1,4),(2,0),(2,1),(2,2),(2,3),(2,4),(3,0),(3,1),(3,2),(3,3),(3,4)) 本文作者:Endless2010 来源:51CTO
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册