首页 文章 精选 留言 我的

精选列表

搜索[持久化],共10023篇文章
优秀的个人博客,低调大师

持久化方式

1.HttpContext.Items HttpContext抽象提供了一个简单的IDictionary<Object,Object>类型的字典集合,叫做Items。在每个请求中,这个集合从HttpRequest开始起就可以使用,直到请求结束后被丢弃。要存取集合,你可以直接给键赋值,或根据给定键查询值。 举个例子,一个简单的中间件Middleware可以在Items集合中添加一些内容 app.Use(async (context, next) => { context.Items["key"] = "gouwa"; await next.Invoke(); }); 我们可以在这次请求中在这次中间件之后使用这个值。 public IActionResult About() { ViewData["Message"] = HttpContext.Items["key"]; return View(); } 2.HttpContext.Session ASP.NET.Core中的Session使用方法与.NET中有所不同,core中Session是一个单独组件,必须添加并配置。 在项目中引用 Microsoft.AspNetCore.Session的程序包 install-package Microsoft.AspNetCore.Session 然后在Startup类进行Session配置 在ConfigureServices中添加Session服务 public void ConfigureServices(IServiceCollection services) { services.AddSession(); } 然后再在Configure中添加Session中间件 public void Configure(IApplicationBuilder app, IHostingEnvironment env) { app.UseSession(); app.UseMvc(routes => { routes.MapRoute( name: "default", template: "{controller=Home}/{action=Index}/{id?}"); }); } 注意:Session中间件必须添加在UseMvc()之前 在ISession接口中,只有存储byte[]类型和读取byte[]类型方法 public interface ISession { bool IsAvailable { get; } string Id { get; } IEnumerable<string> Keys { get; } Task LoadAsync(); Task CommitAsync(); bool TryGetValue(string key, out byte[] value); void Set(string key, byte[] value); void Remove(string key); void Clear(); IEnumerable<string> Keys { get; } } 当然由扩展方法可以在使用诸如String和Int32的简单类型时使用更加容易 context.Session.SetInt32("key1", 123); int? val = context.Session.GetInt32("key1"); context.Session.SetString("key2", "value"); string stringVal = context.Session.GetString("key2"); byte[] result = context.Session.Get("key3"); 如果要存储更复杂的对象,需要将对象序列化成一个byte[]字节流以便存储。 3.Memory Caching 使用Memory Caching必须也添加对应的组件 Install-package Microsoft.Extensions.Caching.Memory 在Startup类中ConfigureServices中添加服务 public void ConfigureServices(IServiceCollection services) { services.AddMemoryCache(); services.AddMvc(); } 然后我们就可以在程序中使用MemoryCache缓存了. public class HomeController : Controller { IMemoryCache _memoryCache; public HomeController(IMemoryCache memoryCache) {//使用注入 _memoryCache = memoryCache; } public IActionResult Index() { //添加缓存 _memoryCache.Set<String>("key", "val"); //获取缓存 _memoryCache.Get<String>("key"); //设置相2分钟对过期时间 _memoryCache.Set("key1", "val1", new MemoryCacheEntryOptions().SetAbsoluteExpiration(TimeSpan.FromMinutes(2))); //设置绝对过期时间两分钟 _memoryCache.Set("key2", "val2", new MemoryCacheEntryOptions().SetAbsoluteExpiration(TimeSpan.FromMinutes(2))); //设置缓存优先级(程序压力大时,会根据优先级自动回收) _memoryCache.Set("key3", "val3", new MemoryCacheEntryOptions().SetPriority(CacheItemPriority.NeverRemove)); //缓存回调 10秒过期会回调 _memoryCache.Set("key4", "val4", new MemoryCacheEntryOptions().SetAbsoluteExpiration(TimeSpan.FromMinutes(10)).RegisterPostEvictionCallback((key, value, reason, subatate) => { Console.WriteLine($"键{key}值{value}改变,因为{reason}"); })); return View(); } }

优秀的个人博客,低调大师

Python数据持久化-小测验

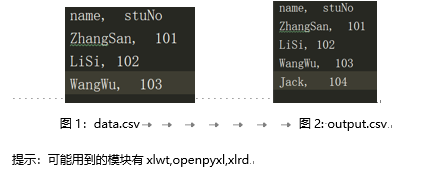
2018年7月13日考试 1.Python读写csv文件 现有如下图1所示的data.csv文件数据,请使用python读取该csv文件数据,并添加一条记录后输出如图2所示的output.csv文件(10分) 题1.png 这一题需要用到的csv文件 data.csv下载链接: https://pan.baidu.com/s/1JCUCU4vXBQNwOx2xhAjDqA 密码: pbpx 第1题 import csv def printCsv(csvName): with open(csvName) as csvFile: reader = csv.reader(csvFile) for i in reader: print(i) if __name__ == "__main__": inCsv = "data.csv" outCsv = "output.csv" with open(inCsv) as csvFile: reader = csv.reader(csvFile) data = list(reader) print("原csv文件data.csv的数据内容:") printCsv(inCsv) data.append(['Jack','104']) with open(outCsv,'w',\ newline='') as csvFile: writer = csv.writer(csvFile) writer.writerows(data) print("新产生的csv文件output.csv的数据内容:") printCsv(outCsv) 上面一段代码的运行结果如下: 原csv文件data.csv的数据内容: ['name', ' stuNo'] ['ZhangSan', ' 101'] ['LiSi', ' 102'] ['WangWu', ' 103'] 新产生的csv文件output.csv的数据内容: ['name', ' stuNo'] ['ZhangSan', ' 101'] ['LiSi', ' 102'] ['WangWu', ' 103'] ['Jack', '104'] 2.Python读写excel文件 如下所示的Excel表格数据,请编写python代码筛选出Points大于5的数据,并按Points进行排序后输出如图2所示的Excel文件结果 题2.png 这一题需要用到的excel文件 rank.xlsx下载链接: https://pan.baidu.com/s/1reS7yjxUjU1iqZc0rCjljA 密码: uymy import xlrd import xlwt if __name__ == "__main__": excel = xlrd.open_workbook("rank.xlsx") sheet = excel.sheet_by_index(0) #获取字段列表赋值给field_list,第2个字段大于5的数据列表赋值给data_list field_list = sheet.row_values(0) data_list = [] for i in range(1,sheet.nrows): if int(sheet.row_values(i)[2]) > 5: data_list.append(sheet.row_values(i)) #利用sorted内置函数排序 data_list = sorted(data_list,key=lambda x:x[2],reverse=True) #将获得的信息存入新表,命名为output.xlsx excel_w = xlwt.Workbook() sheet_w = excel_w.add_sheet("sheet1") for i in range(len(field_list)): sheet_w.write(0,i,field_list[i]) for i in range(len(data_list)): for j in range(len(data_list[i])): sheet_w.write(i+1,j,data_list[i][j]) excel_w.save("output.xls") 3.mysql数据库的sql语句 (1) 使用sql创建出如下图所示的数据表,数据库名为movies,表名为movieRank,表中包含MovieName、boxOffice、percent、days、totalBoxOffice五个字段,字段的信息如下图所示: 题3-1.png 创建语句.png (2)使用sql语句向movieRank表中添加若干条数据(材料中已提供movieData.txt) insert into movierank values("21克拉", 1031.92, 15.18, 2, 2827.06); insert into movierank values("狂暴巨兽", 2928.28, 43.07, 9, 57089.20); insert into movierank values("起跑线", 161.03, 2.37, 18, 19873.43); insert into movierank values("头号玩家", 1054.87, 15.52, 23, 127306.41); insert into movierank values("红海行动", 45.49, 0.67, 65, 364107.74); 插入数据的结果如下图所示: 插入结果图示.png (3)使用sql语句查询movieRank表中的数据并按照totalBoxOffice字段进行排序 select * from movierank order by totalboxoffice; (4)使用sql语句计算出字段totalBoxOffice字段的总和 select sum(totalboxoffice) from movierank; 4.Python操作mysql数据库 此题接第3题题干,在第三题的基础上完成以下需求: (1)编写python代码连接mysql数据库,并向movieRank表中新添加两条数据(已提供second.txt) import pymysql def getConn(database ="pydb"): args = dict( host = 'localhost', user = 'root', passwd = 'Leimysql8', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": conn = getConn("movies") cursor = conn.cursor() insert_sql = 'insert into movierank values'\ '("犬之岛", 617.35, 9.08, 2, 1309.09),'\ '("湮灭", 135.34, 1.99, 9 , 5556.77)' cursor.execute(insert_sql) conn.commit() conn.close() (2)编写python代码,查询出所有的电影数据,并输出到一个Excel表movieRank.xlsx中,如下图所示 题4-2.png import pymysql import xlwt def getConn(database ="pydb"): args = dict( host = 'localhost', user = 'root', passwd = 'Leimysql8', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": #从mysql数据库中取出数据赋值给data_list,其数据类型为元组 conn = getConn("movies") cursor = conn.cursor() select_sql = "select * from movierank " cursor.execute(select_sql) data_list = cursor.fetchall() field_list = [k[0] for k in cursor.description] #把data_list中的数据存入新的excel中,并命名为movieRank.xls excel = xlwt.Workbook() sheet = excel.add_sheet("sheet1") for i in range(len(field_list)): sheet.write(0,i,field_list[i]) for i in range(len(data_list)): for j in range(len(data_list[i])): sheet.write(i+1,j,data_list[i][j]) excel.save("movieRank.xls") 5.Python操作MongoDB数据库 (1)编写python代码连接MongoDB数据库,并新建一个building库,在building库下新建一个rooms表 from pymongo import MongoClient if __name__ == "__main__": conn = MongoClient("localhost") db = conn.building rooms = db.create_collection("rooms") (2)编写python代码读取rooms.csv文件的中的数据,并将数据插入到rooms表中,添加到rooms表中的数据结构如下图所示 image.png 这一题需要用到的csv文件rooms.csv下载链接: https://pan.baidu.com/s/10fyct-J3a0txtS-EZaaxAQ 密码: je33 from pymongo import MongoClient import csv if __name__ == "__main__": with open("rooms.csv") as csvFile: reader = list(csv.reader(csvFile)) field_list = reader[0] data_list = reader[1:] conn = MongoClient("localhost") db = conn.building rooms = db.rooms insert_list = [] for data in data_list: insert_list.append( {key:value for key,value in zip(field_list,data)}) rooms.insert_many(insert_list) 使用csv.DictReader方法 from pymongo import MongoClient import csv if __name__ == "__main__": conn = MongoClient("localhost") db = conn.building rooms = db.rooms with open("rooms.csv") as csvFile: reader = csv.DictReader(csvFile) for row in reader: rooms.insert_one(dict(row))

优秀的个人博客,低调大师

Python数据持久化-mysql篇

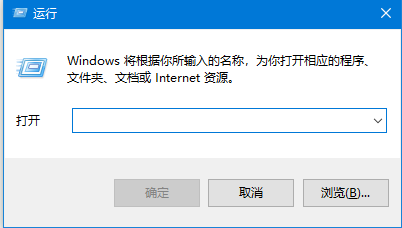
1.下载pymysql模块 pymysql模块对python3的支持比较好 安装命令:pip install pymysql 2.新建一个数据库 会用可视化工具hedisql或者navicat创建数据库则跳过此步 打开cmd或者PoweShell 打开方式是windows+R组合键 具体操作为:在按住windows键的情况,再按R键 windows键在键盘左下方,下方第一行从左往右数第二个有windows图标的键就是windows键 呼唤出窗口如下图所示: 图片.png-7kB 在 运行窗口中输入powershell 图片.png-6.9kB 点击上图中的确定后,如下图所示。 图片.png-4kB 在PowerShell中输入命令并运行: mysql -u root -p 图片.png-4.6kB 输入root用户对应的密码后,运行如下图所示: 图片.png-11.6kB 在mysql中输入命令并运行: create database pydb 图片.png-9.5kB 出现上图所示,则成功创建数据库。 3.编辑py文件 3.1插入数据 import pymysql if __name__ == "__main__": args = dict( host = 'localhost', user = 'root', passwd = '...your password', db = 'pydb', charset = 'utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("drop table if exists test") cursor.execute("create table test(id int,name varchar(20))") cursor.execute('insert into test values(1,"小明")') cursor.execute('insert into test values(2,"小红")') cursor.execute('insert into test values(3,"小王")') conn.commit() conn.close() 3.2查询数据 cursor.fetchall()函数示例: import pymysql if __name__ == "__main__": args = dict( host = 'localhost', user = 'root', passwd = '...your password', db = 'pydb', charset = 'utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("select * from test") data_list = cursor.fetchall() for data in data_list: print(data) conn.commit() conn.close() 上面一段代码的运行结果如下: (1, '小明') (2, '小红') (3, '小王') cursor.fetchmany()函数示例: import pymysql if __name__ == "__main__": args = dict( host='localhost', user='root', passwd='...your password', db='pydb', charset='utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("select * from test") data_list = cursor.fetchmany(2) for data in data_list: print(data) conn.commit() conn.close() 上面一段代码的运行结果如下: (1, '小明') (2, '小红') 小结 关键是mysql的sql语句要熟练,python连接mysql数据库后对相应的数据库利用cursor.execute()方法进行操作。 完成操作后要提交,即conn.commit();关闭连接,即conn.close()

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册