首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4446篇文章
优秀的个人博客,低调大师

GitHub 就是程序员的小红书:仓库、Star、Fork、Issues 一次说人话 #WorkBuddy#

> 数字口径声明:本文所有平台数据均来自 GitHub 官方 Newsroom 及 Universe 2024 官方发布("超过 1 亿开发者、4.2 亿+ 仓库"),未采用任何二手转述数字。 --- 先说结论:GitHub 没有任何一个概念是普通人理解不了的。你把整个网站当成一个「程序员版的小红书」,四个最劝退的名词——仓库、Star、Fork、Issues——就能一口气全说通。 这不是类比硬凑。上一篇我写过《我以为 GitHub 只属于程序员,直到让 AI 替我敲了第一行命令》,讲的是门槛的消亡;这一篇解决的是下一层障碍:**进去了,但看不懂界面上的词**。我第一次打开 GitHub 主页的时候也是这个感受——满屏英文按钮,Star 是什么?Fork 是什么?为什么每个页面都有个 Issues? 后来我天天用(我的选题素材、文章校验脚本、实测项目,一大半都从 GitHub 上来),回头再看,这四个词全部能在小红书里找到对应物。这篇就按「小红书对照法」把它们一次讲完,每个名词都配上我自己真实用过的一个例子——没有一个例子是转述的,全部是我本机跑过的事。 --- ## 一、先给全局地图:GitHub 官方口径下的体量 讲名词之前,先解决一个心理问题:这地方靠不靠谱、值不值得学。 GitHub 官方 Newsroom 的口径是:**超过 1 亿开发者**在用,**仓库总量超过 4.2 亿**,90% 以上的财富 100 强公司都在上面(GitHub Newsroom,gist.github.com/newsroom)。所谓仓库(Repository),就是「存放一个项目全部文件的地方」——这个词我们第一个讲。 1 亿开发者和 4 亿仓库意味着什么?意味着你在任何领域碰到的问题,几乎都有一条对应的「笔记」已经躺在里面了:教程、工具、模板、别人踩过的坑。**缺的从来不是内容,是你能不能看懂入口。**下面四个名词就是四扇门。 --- ## 二、Repository(仓库)= 一篇笔记 + 它的全部素材包 **说人话:仓库就是别人发的一篇「笔记」,只不过附带的东西更全——源文件、说明书、更新记录,全打包在一起。** 小红书上一条笔记 = 图 + 文字 + 评论区。GitHub 上一个仓库 = 项目的全部文件 + 一个叫 README 的「置顶说明」+ Issues「评论区」。对应关系严丝合缝。 README 值得多说一句:它是每个仓库首页自带的说明文档,相当于笔记的正文开头。判断一个仓库值不值得用,**先读 README**。写得清楚的 README 会在三段之内告诉你:这东西是干嘛的、怎么装、怎么跑起来。 **我自己的真实例子**:我那篇《一家 25 天刷出 17 万星》的文章,选题就是这么来的——我在 GitHub 上看到一个叫 storyTold 的项目,先读它的 README 和 Star 数,确认这波暴涨是真实的社区热度,才决定去实测。没有 GitHub 上的「笔记」,就没有那篇文章。 **新手要知道的唯一坑**:仓库有公开(Public)和私有(Private)之分。你搜到的、看得到的,全是公开仓库。这既是 GitHub 的价值,也是后面 Issues 部分要讲的「评论区为什么人人都能看」的原因。 --- ## 三、Star(星标)= 点赞 + 收藏,二合一 **说人话:Star 就是给仓库「点赞」,点了之后它进入你的收藏夹。小红书点赞过的内容会进「我的赞过」,GitHub 的 Star 进「你的 Star 列表」,逻辑一模一样。** 但 Star 多了一个小红书没有的功能:**它是一个公开的热度排行榜**。一个仓库有多少 Star,全网可见,所以媒体说「某个项目刷出 17 万星」,相当于说「某篇笔记被赞了 17 万次」。这也是为什么我把 Star 数当作选题筛选的第一道筛子——热度做不了假(刷星会留下痕迹,社区也会抓),至少比某些平台的数据干净。 **我自己的真实例子**:我的例行跟踪脚本里有一段,就是用 GitHub 的公开接口直接拉仓库数据——不登录、不敲命令,一个网址访问过去,Star 数、Fork 数、简介全回来。这件事的性质和「打开小红书看一条笔记有多少赞」没有任何区别,只是数据格式是给程序读的。 **新手要知道的唯一坑**:Star 不代表质量,代表热度。4 亿个仓库里,大量高 Star 项目其实早已停止维护。Star 是「发现」的入口,不是「使用」的保证——这个坑在下一篇(捡东西的三个坑)里我会展开。 --- ## 四、Fork(复刻)= 一键「转载到自己名下」,但附赠改动权 **说人话:Fork 就是把这个仓库原封不动复制一份,挂到你自己的账号下面。相当于你看到一篇好笔记,不只收藏,而是原样转载了一份到自己主页——并且你可以随便改它。** 这是四个名词里最「程序员」的一个,但本质特别好懂: - **收藏(Star)**:东西还是他的,你只是标记了喜欢; - **转载(Fork)**:东西复制了一份变成你的,你想怎么改怎么改。 改完之后还有一个原帖没有的机制:如果你在你的复制品上做了改进,可以发起一个 **Pull Request(合并请求)**,请原作者「把我的改进收回到原版里」。原作者同意,你的名字就进了原项目的贡献者名单。这套机制叫「协作」,是 GitHub 立身的根本——但对普通人来说,你只需要知道:**Fork = 复制一份归自己,改坏了也不影响原版。** **我自己的真实例子**:我实测过的开源项目里,有几个 README 是英文的、或者安装说明跟实际对不上。我给 AI 的指令就是「把这个仓库 Fork 的说明翻译整理成我能跑的步骤」——我本机不需要真的去 Fork,但这个机制决定了:**任何项目的使用说明,永远以官方仓库的版本为准**,网上转载的教程可能已经过时。这是我从「转载机制」里反推出来的使用习惯:找资料,只认原仓库。 **新手要知道的唯一坑**:Fork 出来的副本不会自动跟着原版更新。原版修了 bug,你的复制品还是旧的——所以「看」用原仓库,「自己改着玩」才 Fork。 --- ## 五、Issues(议题)= 评论区 + 客服工单,且全员可见 **说人话:Issues 是每个仓库自带的「评论区」,但它比小红书评论区正规——每条反馈是一个独立工单,有编号、有状态(开着/关着)、能分配给专人处理。** 你在小红书评论「这个方法我用着不行」,大概率石沉大海;你在 GitHub 的 Issues 里写「我这个版本安装报错 123」,作者和其他用户真的会看到,而且**历史上所有人碰过的同类问题都躺在里面,带编号、带讨论、带解法**。 这让它悄悄变成了普通人最好用的一个入口——**它就是免费的用户手册兼故障数据库**。你用任何开源工具碰到报错,第一件事不是去搜索引擎搜碎片回答,而是去这个项目的 Issues 里搜报错关键词。九成概率,前面已经有人摔过同一个跤,而且解法就在工单底下挂着。 **我自己的真实例子**:不是我去查别人,而是别人查到我头上——我那套自动发文流程出问题的时候,我就是先翻所用工具的 Issues,按报错关键词搜,前人贴出来的解法直接救活了流程。反过来讲,我给 AI 下指令也养成了固定句式:「先搜这个项目的 Issues 里有没有同类报错」——这句话比我描述半天报错现象都管用。 **新手要知道的唯一坑**:Issues 全员公开。所以**永远不要**把密钥、密码、真实姓名、手机号贴进 Issues——不仅作者看得到,全世界都看得到,搜索引擎也会收录。已经有大量真实泄露案例源于此,这是下一篇避坑文的重点,这里先记住红线。 --- ## 六、把四个词串成一次真实的使用流程 名词讲完,串一遍我上周真实发生的完整流程,你可以对照着看四个词各出现在哪一步: 1. **发现**:我想找工具管自己的订阅和数据 → 打开 GitHub 搜索(相当于小红书搜关键词); 1. **筛选**:按 Star 数排序、读 README(看赞数、读正文)→ 两个词; 1. **排雷**:装之前先翻 Issues 搜「报错关键词」(翻评论区看前人怎么踩的)→ 第三个词; 1. **本地化**:安装说明对不上时,以原仓库 README 为准,必要时让 AI 给出基于 Fork 副本的修正步骤(原文为准,转载存疑)→ 第四个词。 全程我没有写过一行命令——搜索、点击、阅读,剩下不会的丢给 AI。**GitHub 的门槛从来不在技术,在名词。**名词今天讲完了,门就开了。 --- ## 七、边界声明(每次实测文必附) 1. 本文四个名词的机制描述基于 GitHub 当前公开产品形态(2026-11 复核),官方若改版以官方文档为准; 1. 平台数据(1 亿+ 开发者、4.2 亿+ 仓库)引自 GitHub 官方 Newsroom 及 Universe 2024 官方发布,为官方口径而非第三方统计; 1. 文中「我自己的真实例子」均为本机真实操作,无虚构、无转述;涉及具体项目名的(storyTold)见于本账号已发布文章; 1. 本文不构成任何投资或订阅建议,按旧例:付费、注册、绑卡相关内容一律不写成教程,只写机制和坑。 --- > 下一篇预告(系列第 3 篇):《在 GitHub 上捡东西的三个坑:密钥、公开仓库、没人维护的项目》——本文第五节埋的红线,下篇展开,含公开报道佐证的泄露案例。

优秀的个人博客,低调大师

我用 WorkBuddy 做了个证照录入工具:一单 20 分钟的活,机器跑 141 秒

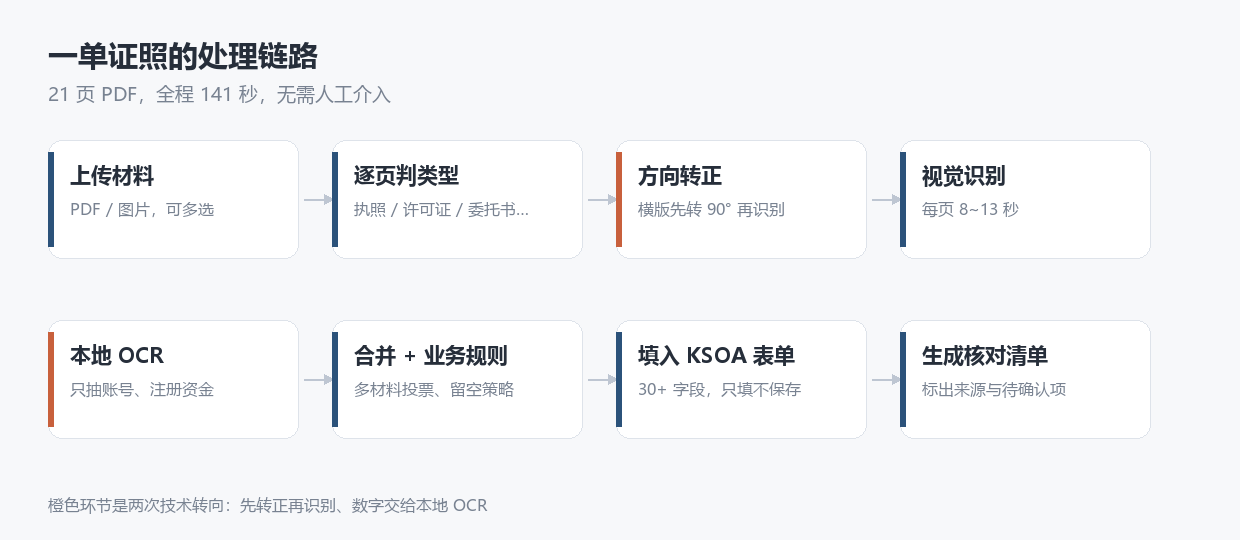
上个月帮朋友的公司弄了个东西。他们做客户开户,新客户要交一整套证照:营业执照、药品经营许可证、开户许可证、法人身份证、质量调查表、三份授权委托书、质保协议,十几份材料摞起来二十多页。收齐了还得一样样敲进时空 KSOA 的客户资质审核表,三十来个字段,其中十来个是统一社会信用代码、银行账号、注册资金这类长数字。 现在是人工干这活。一单 20 分钟左右,这个数是他们自己掐表算的:手快的 15 分钟,赶上扫描件糊、身份证要翻正反面,能拖到 25 分钟。没什么技术含量,本质是人肉 OCR,但抄错一位就得回头翻材料,返工比第一次填还烦。 我做了个桌面工具替掉敲键盘这一段。选文件,点开始,141 秒后表单填好,附一份核对清单,人核一遍、点保存。连核对带保存,一单五分钟左右。 先把话说清楚:省掉的是抄写和翻页,不是判断。材料缺页、印章压住字、规则本身还在变,这些还是得人看。 --- ## 先看结果 ![](https://developer.qcloudimg.com/http-save/yehe-12867078/6a4ee7bcac730f961fc868ea89b716f9.png) 输入可以是一个多页 PDF,也可以是十几张手机拍的图。整个流水线分四段:文档分类(判断每一页是执照、许可证、委托书还是别的)、方向校正(横着扫的先转正)、字段抽取、规则合并与填表。分类和"这一栏叫什么"交给视觉模型,方向校正和数字字段交给确定性算法。 21 页的 PDF,141 秒跑完。识别用的是免费模型,OCR 在本地跑,这一单不花钱。 ![](https://developer.qcloudimg.com/http-save/yehe-12867078/2f4447a332ab293ba2f1bc7f1677b70b.png) 跑完落一份清单,写清楚识别到哪些材料、每个字段填了什么、哪些留空需要人工补。上面这份是脱敏后的示例。每个值都带溯源:来自哪一页、由哪个通道(模型还是 OCR)读出。对复核的人来说,溯源信息比准确率数字本身更管用。 有个边界我一开始就定死了:程序只填、不保存。自动化的东西碰业务单据,最后那一下必须是人点。 效率这笔账我想算得老实一点。人工 20 分钟,工具 141 秒加人工核对两三分钟,一单实际省下十五分钟出头。一天十单就是两个多小时,不算惊天动地,但那两个多小时原来是纯手工的重复劳动。错漏率我没数据,不敢吹,能说的是以前填完凭印象,现在清单上写着哪个字段来自哪份材料、哪个留空,漏了什么一眼能看见,复核的人省心不少。 --- ## 技术栈没什么特别的 |环节|用了什么|为什么| | --- | --- | --- | |界面|PyQt5|单文件桌面工具,打包不折腾| |证照识别|GLM-4V-Flash|免费的多模态视觉语言模型,中文证照的版式基本看得懂| |数字字段|RapidOCR + onnxruntime|本地离线的判别式 OCR(PP-OCR 系模型转 ONNX),后面细说为什么非它不可| |接口调用|requests + 连接池|简单够用| |填表|pywinauto|KSOA 是老式 C/S 客户端,没开放接口,只能走 GUI 自动化| |打包|PyInstaller|客户的电脑上不能指望有 Python| |授权|Ed25519 签名|客户端只放公钥,注册码伪造不了| 五千八百行 Python,主程序占了四千二,剩下是首营品种流程、授权校验和签发工具。 选型上其实只有一条主线:概率性组件和确定性组件分开。凡是逐位抄录的字段走判别式模型,凡是需要"理解"的判断(这是什么文件、这一栏叫什么)走生成式模型。后面几个坑,追到根上都是这两种确定性被混在了一起。 --- ## 我平时怎么跟它配合 很多人用 AI 写代码的方式是丢一句需求,等它吐一坨东西出来,然后再改。这个项目跑下来,真正省时间的其实是另外几个习惯,每个都能对应到软件工程里现成的说法。 **给规则,别给形容词。** "识别准一点"这种话没有任何信息量。"质量负责人只从药品经营许可证里找,其他材料不许取""委托书按标题关键词分类,标题没有才看正文""识别不到就留空,不许编",这些是硬规则,得一条条列出来。说白了就是把隐性领域知识显式化成约束条件:AI 不知道你们质控部门怎么定的规矩,它只能从你给的约束里恢复语义。 **出错的时候给证据链。** 别说"填错了",说"银行账号填成了 123456789012345,真值是 123456789012,材料里只有一张开户许可证和一张电子发票"。有了输入、输出、可疑来源这三要素,定位问题就是几分钟的事。这就是写缺陷报告的基本功,只不过对象从编译器换成了模型。 **让项目自己记事。** 这是我觉得最值的一步。把架构、字段映射全表、打包流程,还有一份踩坑记录,都做成项目里的文档,每次开工先读。踩坑记录按"现象、根因、修复"三条写,目前攒了三十九条。形式上接近事后复盘(postmortem)文化,区别是读者不是人,是下一次会话里的 AI。它每次醒来都是白纸,这份文档就是它的组织记忆。 效果说不上神奇,但确实有:第一个坑查了大半天,到第三十几个坑的时候,基本是描述完现象就能改。 **改判定逻辑之前,先写反向用例。** 我建了一套离线 mock,用合成的识别结果直接调合并函数,不碰模型、不碰网络。关键是反向用例,比如"执照读对的时候不能被误杀"。这是回归测试的常规做法,但容易被忽略的一点是:对带概率性的系统,只测正向用例几乎等于没测,因为生成式组件的失败模式大多不在你设计的正向路径上。这个我吃过两次。 --- ## 五个坑 ### 一、横着扫的执照,模型会整页编造 ![](https://developer.qcloudimg.com/http-save/yehe-12867078/0632109c13ac2cd881de212bb853545c.png) 这个最吓人。横版扫描的营业执照,模型没报错,也没提示看不清,而是安安静静编了一整套:地址、法人、日期、注册资金全是假的。唯独统一社会信用代码读对了,我早期的校验只看代码格式,就这么被骗过去了。 这在文献里有名字:幻觉(hallucination)。机制上不难理解。自回归模型逐 token 生成,遇到信息量不足的输入(转了 90 度的字对它来说就是噪声),最自然的出路是回到训练分布里最"像"的内容。它不是在说谎,是在补全,只是补的是它见过的别的执照。文档理解任务上这类问题尤其常见,因为证照的版式先验太强了。 更绕的是 PDF 每一页都是 A4 竖版(595×842)。所谓"横版"其实是页面里的扫描内容转了 90 度,靠宽高比判断方向的代码永远不触发。 最后的方案是三层。第一层是本地初筛:对每一页做灰度投影剖面分析(projection profile analysis)。文字行方向变了,垂直投影的方差结构会明显不同,这是文档图像分析里的老办法,零成本,而且宁多勿漏、误报无害。第二层只对可疑页问模型方向,而且只让它回答 0/90/180/270,把开放问题收窄成四选一;输出空间越小,幻觉越难发生。第三层是转后本地复检,转坏了回滚原图。 再加一道业务防线:信用代码跨材料投票定共识,凡与共识不符、或者地址跟共识地址对不上(最长公共子串小于 5)的页面整页弃用。没有可信来源就留空,进人工清单。这个思路是从容错设计里借的朴素版本:不信任任何单一来源,靠独立来源交叉验证。 顺带说一句,模型判方向本身也不靠谱。实测 6 页只对 3 页,正着的协议页它说该转 90 度。两个弱信号串起来用,加个回滚,才勉强够用。弱信号组合加退路,比苦等一个强信号现实得多。 ### 二、让它读数字,等于逐位掷骰子 ![](https://developer.qcloudimg.com/http-save/yehe-12867078/f1d04f075bc21a8c0aca4b4fc559b02d.png) 同一张开户许可证,三轮读下来三个账号。真值 123456789012,它给我 987654321098765432、1234567890123、123456789010。temperature 调到 0.01 也不收敛。 这件事值得多说两句,因为它解释了为什么调参数没用。生成式模型每个位置输出的是 token 的概率分布,采样就是从这个分布里抽签;temperature 只是把分布削尖或摊平,削得再尖,长数字串相邻候选(比如 5 和 6、52 和 2)之间的概率差距还是很小,抽错是常态。这不是"不够聪明",是架构使然。 我先试的是"共识仲裁":两页材料交叉复核,同页两轮一致才采信。结果是能防错,但读不对。最后经常三个来源全打架,只能清空留给人工。 转折点是换成本地 RapidOCR。同一个 PDF,三轮逐字一致读出 123456789012,置信度 0.98,注册资本"贰仟万圆整"和信用代码也全对。每页 2.5 到 6 秒,比调模型还快,而且完全离线,一分钱不花。 为什么 OCR 行?因为它是判别式模型:检测、分类、识别三段各管各的,识别端用 CTC 解码,输出的就是"这一小块图最像哪个字符",没有生成、没有补全、没有上下文发挥,同一个输入永远同一个输出。OCR 在查表,生成式模型在算下一个 token 的概率。两种确定性,不能混着用。 有点讽刺,这活里最没技术含量的那部分恰恰最可靠。从那以后我定了一条:账号、信用代码、注册资金这类逐位抄录的字段,一律先走本地 OCR,模型只负责判断"这页是什么文件""这一栏叫什么"。 ### 三、兜底逻辑把别人的账号填了进来 有一轮填出来的账号是 123456789012345,15 位、格式完全合规,跟真值完全不搭。 查下来是这么回事:开户许可证那页没读出合格账号,代码的兜底链跑去"其他"类文档里抓账号,而材料里恰好有一张电子发票。发票上本来就印着销货方、购货方的开户行和账号。 单看每一环都没错:兜底链在扩大召回,格式校验也通过了,15 位纯数字,完全合法。错在系统层面缺了一个约束:字段的来源白名单。修法是账号只认开户许可证和账户证明两类页面,而且必须 9 到 25 位纯数字,不合格就留空。 这个教训换个说法就是最小权限原则:一个字段允许从哪里取值,应该白名单枚举,而不是"哪里像就从哪里取"。电子发票、调查表这类材料天然带着账号、税号、电话,任何"从其他材料兜底取数字字段"的写法,都可能抓到别人的信息。这事想想挺后怕的。 ### 四、弹窗怎么点都不出来 客户类别和客商分类是 lookup 字段,要双击弹出选择框。昨天能点,今天点四次都不弹。 两个原因叠在一起。KSOA 单据有浏览态和编辑态两个状态,控件行为跟着状态走,默认浏览态下控件根本不响应,得先点工具栏的"更新"。这本质是状态机问题:GUI 自动化必须显式跟踪应用状态,不能假设"界面长这样就代表能点"。二是 pyautogui 的 doubleClick 只是把鼠标挪过去双击,没先给控件键盘焦点,Windows 消息时序上就有竞争,时好时坏。换成 pywinauto 原生的 click_input(double=True),先 set_focus 再真实双击,之后没再失手。 结论是控件交互尽量用 pywinauto 的原生方法,pyautogui 只用来做不依赖焦点的事,比如滚回顶部、在弹窗里按方向键。 这类老式 C/S 客户端最磨人的地方就是没有文档。哪个按钮要先点、哪个字段要什么顺序,全靠一遍遍试出来,试完还得记下来,不然隔两周又忘。我踩坑记录里 GUI 这一段是最厚的,不是技术多难,是不可见的东西太多。 ### 五、想提速,别去压画质 ![](https://developer.qcloudimg.com/http-save/yehe-12867078/506ad4ec9ca28ade02067cc2b3dea5f6.png) 第一版 21 页跑 237.6 秒,其中逐页识别 165 秒。直觉是图片太大,压一压就好,结果发现服务端每页推理 8 到 13 秒,几乎不受图片体积影响。瓶颈在服务端推理,不在传输。先测量再动手,这是性能工程的第一课,我又交了一遍学费。 真正有用的是四件事:上传图转 JPEG q88(PNG 3.1MB 降到 886KB,识别结果完全一致,纯粹降传输成本);用 requests.Session 复用连接(一轮三十次调用,省掉重复握手);并发从 2 提到 3(165 秒降到 105 秒);把本地 OCR 和逐页识别做成流水线(pipelining,不是并行):OCR 那二十秒本来串行等在后面,现在被识别时间吸收掉,顺手还能拿 OCR 的信用代码反证首读有没有错。 237.6 秒到 141 秒,省 40%,一次限流都没有,抽查的账号、注册资金、登记机关、法人、地址跟优化前完全一致。 并发我试过 4 路,也是 0 限流,但只多省 7 秒,留 3 路更稳。收益递减的时候,别为了最后一个 7 秒增加系统性风险。 --- ## 如果重来一次 **先说清"不许编"这条底线。** 自动化填业务单据,宁可空着让人补,也不能填个看着合理的假值。所有可疑值都要在清单里标出来源和理由,人一眼能看出该核哪里。翻译成术语:每个字段要么有可信溯源,要么显式置空,不存在"看起来对"这个中间状态。 **数字交给 OCR 这件事应该更早做。** 我在共识仲裁上耗了差不多两天,才想明白问题不在校验,在源头选错了工具。白忙两天。校验链做得再厚,也救不了上游的随机性。先分清哪一层是概率性的,再谈哪一层需要防错。 **踩坑要写下来。** 三十九条"现象、根因、修复",下次开新会话,AI 先读完再动手,同一个坑没踩第二次。这一步把一次性的对话变成了能攒下来的东西。 --- ## 什么场景适合抄这套 要做大量固定格式单据录入的岗位,比如资质审核、客户开户、报销、合同台账、检验报告,都差不多。判断标准其实就两条:格式是否相对固定,以及错填的代价是否远高于漏填。这套"宁空勿错"的设计只为后者划算。 还有一类是被卡住过的:用的是老式 C/S 客户端(各类行业 ERP),厂家不给接口,以为没法自动化。pywinauto 这条路走得通,就是细节烦。 反过来说,如果录入规则本身还在天天变,或者材料质量实在太差(缺页、糊成一团),这东西帮不上太多。它的定位是替人把大部分字段填掉,剩下几个明确标出来请人看。指望它全自动,用不了三天就得关掉。 顺便吐槽一句:这类工具的价值天花板不在 AI,在材料质量。扫描件糊成一片的时候,换什么模型都是猜。 --- ## 附:延伸阅读 - Ji et al., *Survey of Hallucination in Natural Language Generation*, ACM Computing Surveys, 2023 —— 幻觉现象的系统综述,坑一、坑二的机制背景。 - Du et al., *PP-OCR: A Practical Ultra Lightweight OCR System*, arXiv:2009.09941 —— RapidOCR 所用模型的原始工作,检测/分类/识别三段式架构。 - Graves et al., *Connectionist Temporal Classification*, ICML 2006 —— CTC 解码,解释为什么 OCR 对同一输入是确定性的。 - 微软 *UI Automation* 官方文档与 pywinauto 文档 —— GUI 自动化的焦点与状态模型。 - 投影剖面分析是文档图像分析的经典方法,相关教材均有覆盖。 --- *文中材料为脱敏测试数据,文中所有账号、证号均为示意值,非真实号码。工具为内部自用,没做推广。*

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码