首页 文章 精选 留言 我的

精选列表

搜索[api],共10000篇文章
优秀的个人博客,低调大师

无需 GPS 模块,基站查询 API 解决物联网终端定位与异地风控

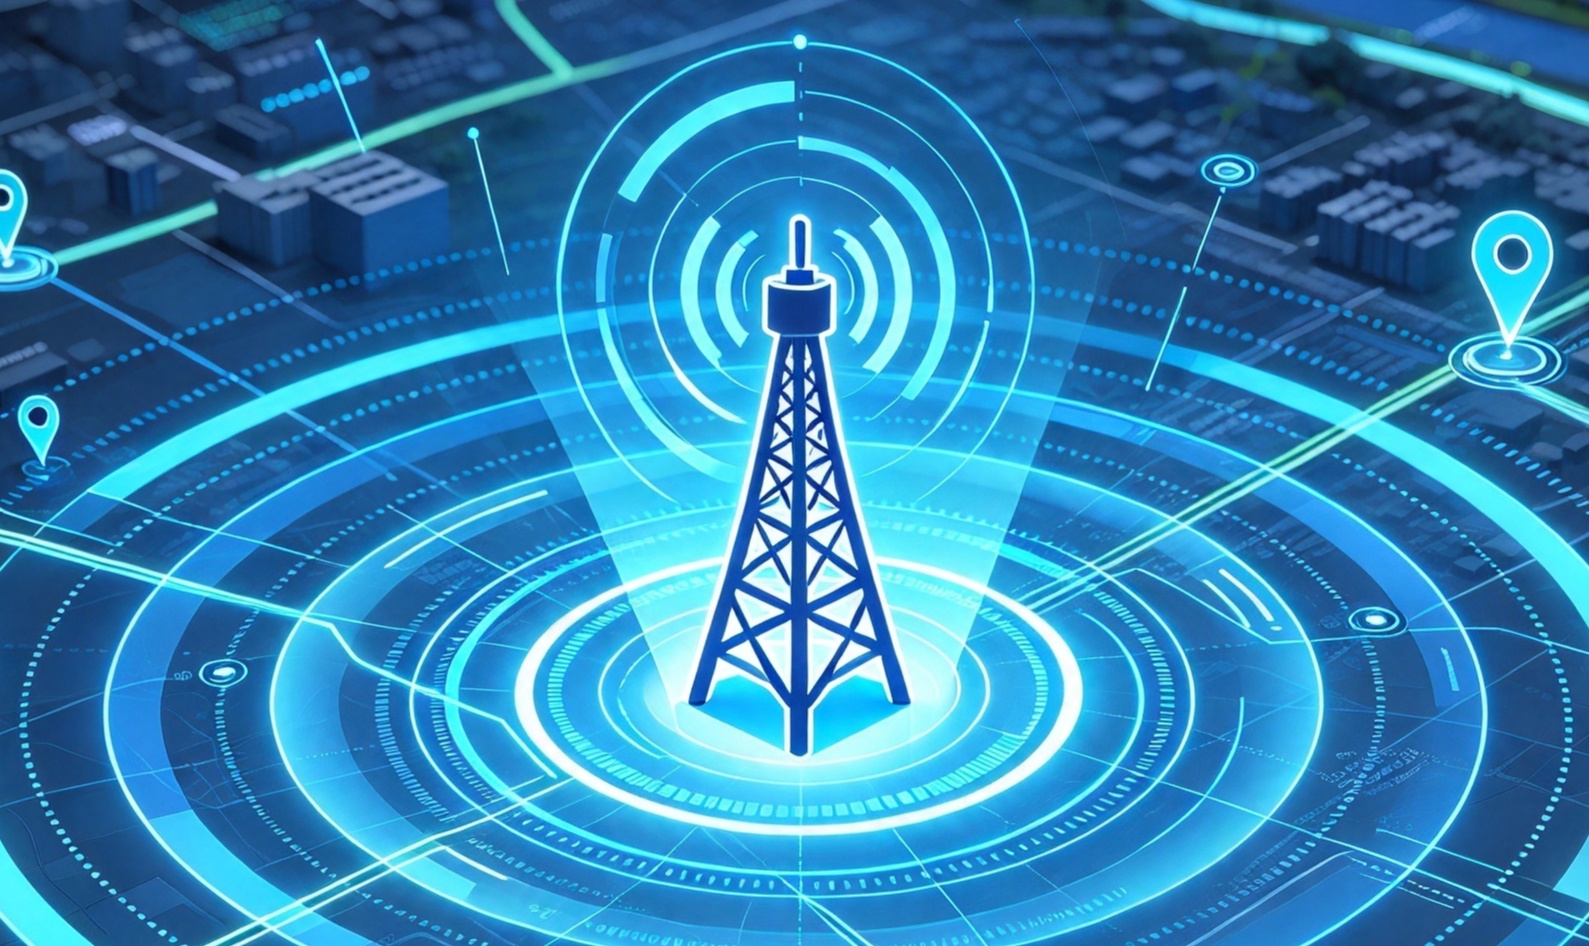
埋地物联网终端、室内电表一般不配备GPS,室内/地下环境也难以接收卫星信号。设备采集周边基站信息上报,就能获取所在片区的粗略位置;也可用于设备风控,一旦设备异地联网、偏离预设区域,即可触发位置告警。 ## 一、接口核心能力 接口核心逻辑:接收终端采集的基站参数(MCC/MNC/LAC/CellID),解析获取对应基站地理位置。 ### 定位原理 终端扫描周边通信基站,读取基站唯一标识编号;将采集到的基站信息提交至接口;服务端检索基站数据库,匹配基站对应的点位;结合基站信号强度,估算终端设备的大致位置。 >注意:该方案不依赖GPS卫星,仅能返回粗略位置,无法高精度定位。 ## 二、接口调用流程 ### 1. 请求入参 |参数名|是否必填|数据类型|参数说明| |:-:|:-:|:-:|:-:| |key|是|string|接口密钥,在个人中心获取| |mnc|是|int|运营商基站类型:0=中国移动,1=中国联通;电信CDMA场景传入SID| |lac|是|int|位置区小区编号;电信CDMA场景传入NID| |cellid|是|int|基站小区ID;电信CDMA场景传入BID| >接口支持移动、联通、电信2G/3G/4G基站查询。电信CDMA网络需按照上表规则映射参数提交。 ### 2. 返回响应字段 |参数名|数据类型|说明| |:-:|:-:|:-:| |lat|string|纬度,WGS84坐标系| |lng|string|经度,WGS84坐标系| |radius|string|定位半径,单位米,代表定位误差范围| |addr|string|基站对应的结构化地址| ### 返回示例 ``` { "data": { "lat": "31.056400", "lng": "105.110687", "radius": 736, "addr": "四川省绵阳市三台县潼川镇长林村;205省道与三象路路口东北659米" } } ``` **结果解读** 本次上传基站编号查询到基站位于四川绵阳三台县长林村一带,终端设备落在以该基站为圆心,**736米半径**的圆形范围内。 - lat、lng:是基站本身的坐标,**不是设备的精准位置**,设备仅在基站信号覆盖圈之内。 - radius:定位误差半径,数值越大,定位精度越低,郊区、农村基站稀疏场景下,误差可达上千米。 - addr:结构化地址文本,可直接用于前端页面展示。 ## 三、开发集成注意事项 1. 地图可视化展示时,不建议只标记单点,推荐绘制圆形误差圈,避免业务端误判为高精度定位。 2. 返回坐标为WGS84坐标系,对接高德、百度地图时,需要做坐标系转换。 3. 郊区基站密度低,radius会显著增大,业务层需要根据业务阈值处理误差。 ## 四、适用业务场景 1. **物联网设备厂商** NB水表、智能电表、资产定位标签、工业传感器等设备常部署在地下室、仓库,GPS无信号,依靠基站实现粗定位。 2. **车载硬件方案商** 车辆驶入隧道、地下车库时GPS容易丢失信号,基站定位作为兜底方案,失星状态下仍可获取车辆大致片区。 3. **安全风控企业** 账号与设备风控场景,终端登录时上报基站信息,解析位置识别异地登录,发现异常风险。 4. **运营商网络测绘** 批量解析大量基站坐标,绘制三大运营商基站分布图,评估区域信号覆盖质量,辅助基站站点规划与网络优化。
优秀的个人博客,低调大师

汇率查询 API 怎么接?币种列表、单币种查询与金额换算

跨境电商、财务系统、多币种商品展示等场景里,汇率查询看起来只是“把一种货币换成另一种货币”,但真正接进业务系统以后,通常还需要解决几个更具体的问题:系统支持哪些币种、某一种货币对应哪些汇率、两个币种之间怎么直接换算,以及当前这条汇率到底是什么时间更新的。 因此,一个完整的汇率功能不只是返回一个数值,更重要的是把“币种、汇率、换算金额、更新时间”这些信息组织清楚。 当前这套接口可以分成三部分:货币列表、单货币汇率列表、实时汇率查询换算。三个接口的用途不同,组合起来可以覆盖从币种选择到金额换算的完整流程。 ## 一、三个接口分别负责什么? 先把三个接口的关系理清楚,后续接入会简单很多。 货币列表接口主要用于获取系统支持的币种,例如人民币、美元、欧元、日元、英镑等,可以用来生成前端的货币选择器。 单货币列表接口则适合以某一种货币作为基准,查询它对应的多个货币汇率。例如以 CNY 为基准,查看 USD、EUR、JPY 等多个目标币种的汇率。 实时汇率查询换算接口更直接,适合指定两个币种以后查询当前汇率,或者输入一个具体金额直接得到换算结果。 可以简单理解为: 货币列表 → 选择 from / to → 查询实时汇率或换算金额 如果只是做简单的汇率换算器,实时换算接口就可以完成主要功能;如果要做完整的多币种页面,则可以再搭配货币列表和单货币查询。 ## 二、实时汇率换算怎么接? 实时汇率查询换算接口路径为: https://www.tanshuapi.com/market/detail-84 返回格式为 JSON,请求方式不限。 请求参数包括: |参数|必填|类型|说明| | --- | --- | --- | --- | |key|是|string|接口调用凭证| |from|是|string|换算前的货币代码| |to|是|string|目标货币代码| |money|否|string|需要换算的金额| 例如人民币换算美元,可以按照下面的参数结构提交: |参数|示例值| | --- | --- | |key|YOUR_KEY| |from|CNY| |to|USD| |money|1| 接口请求使用的是货币代码,而不是中文名称。例如 CNY 表示人民币,USD 表示美元,EUR 表示欧元,JPY 表示日元。 返回结果中比较重要的字段有: |字段|说明| | --- | --- | |from|原货币代码| |from_name|原货币名称| |to|目标货币代码| |to_name|目标货币名称| |exchange|当前汇率| |money|换算后金额| |updatetime|更新时间| 这里最容易混淆的是 exchange 和 money。 exchange 表示汇率本身,money 表示按照本次输入金额计算后的结果。当 money=1 时,两者数值可能看起来一样,但业务含义并不相同。 例如输入 100 CNY 换算 USD 时,前端最终应该重点展示 money,而不是把 exchange 当成最终换算金额。 ## 三、为什么 updatetime 和汇率值同样重要? 汇率和商品名称、车型名称这类相对稳定的数据不同,它会随着市场变化而更新。 当前实时换算接口会按一定频率更新数据,但部分币种可能受到上游数据发布时间影响出现延迟,因此实际展示时不能只看 exchange,还应该一起看 updatetime。 例如接口返回: exchange:0.148900 updatetime:2026-09-25 00:56:01 如果页面只显示: 1 CNY = 0.148900 USD 用户很容易理解成这是当前时刻刚刚产生的汇率。 更完整的展示方式是把更新时间一起放出来,例如: 1 CNY = 0.148900 USD 更新时间:2026-09-25 00:56:01 这样既能保留汇率值,也能让用户知道数据对应的时间点。 对于需要缓存汇率的系统,也建议同时保存汇率值和更新时间,而不是只保存一个数字。 ## 四、货币列表和单货币汇率怎么用? 货币列表接口路径为: https://www.tanshuapi.com/market/detail-84 它更适合用于前端的币种选择器。当前返回示例中可以看到人民币、美元、欧元、日元、港币、韩元、英镑、澳大利亚元、加拿大元等多种货币。 返回结构里主要关注货币代码和货币名称即可。 不过这里有一个接入时值得注意的细节:字段说明中写的是 `list.code`,而当前 JSON 示例中实际出现的是 `currency`。 例如: currency:CNY name:人民币 因此正式开发时,不建议只根据字段说明直接写死字段名,最好以实际接口返回完成一次联调,确认当前线上返回结构。 单货币汇率接口路径为: https://www.tanshuapi.com/market/detail-84 它适合查询某个基准货币对应的一组汇率。例如: from = CNY 可以用于获取以人民币为基准的多个目标货币汇率。 返回字段包括货币代码、货币名称、汇率和更新时间。 这一类接口比较适合做“汇率列表页”,而实时换算接口更适合做“金额转换器”。 两者可以同时存在: 列表页使用单货币接口 金额计算使用实时换算接口 这样页面职责会更清晰。 ## 五、跨境电商和财务系统应该怎么用? 跨境电商中,一个比较常见的需求是把商品基础价格换算成用户本地货币。 例如商品基础价格为: 100 CNY 用户切换到美元后,可以提交: from = CNY to = USD money = 100 然后使用接口返回的 money 作为汇率换算结果。 但这里需要区分“汇率换算价格”和“最终销售价格”。 实际跨境商品售价还可能包含物流、税费、平台费用、支付手续费和企业自身定价策略,因此汇率接口适合做货币转换,不适合直接承担整个商品定价逻辑。 财务系统也是类似。 接口返回的汇率可以作为业务查询或内部换算的数据来源之一,但企业正式记账、税务处理或结算可能有自己的汇率口径。是否直接使用某条汇率,需要结合企业自身的财务规则。 如果业务中涉及金额计算,还要注意 exchange、money、rate 这些字段当前都定义为 string。正式计算时更适合使用 Decimal、BigDecimal 等高精度数值方式,减少普通浮点运算带来的精度问题。 ## 六、接入时最值得注意的几个问题 首先,接口请求使用的是货币代码,例如 CNY、USD、EUR,而不是直接传“人民币”“美元”。 其次,exchange 是汇率,money 是换算后的金额,两个字段不能混用。 第三,汇率数据需要结合 updatetime 使用。接口按一定频率更新,不代表所有币种都完全没有数据延迟,因此页面最好保留更新时间。 第四,货币列表的字段说明和实际 JSON 示例存在 `code` 与 `currency` 的差异,正式上线前应该联调确认。 第五,单货币接口的请求示例中出现了 key,但当前参数表主要列出了 from,这类文档差异同样需要通过实际调用确认,不建议直接凭经验补字段。 第六,汇率换算结果不等于商品最终售价,也不一定等于企业正式记账或结算时采用的汇率。 如果页面面向普通用户展示汇率,还可以保留一句简短说明: **汇率信息仅供参考,实际结算价格以具体业务渠道为准。** ## 写在最后 一个完整的汇率功能,真正需要处理的并不只是“两个数字之间怎么换算”。 货币列表接口负责解决支持哪些币种,单货币接口适合展示某一基准货币对应的多个汇率,实时换算接口则负责两个币种之间的具体金额转换。 在实际接入时,再把 exchange、money 和 updatetime 的含义区分清楚,并处理好字段差异、金额精度和数据更新时间,整个汇率模块就会更容易进入跨境电商、财务辅助计算和其他多币种业务系统。

优秀的个人博客,低调大师

大模型 API 账单为什么总比预期高 30%:五个隐藏计费项

很多团队都遇到过同一件事:按 token 单价乘以预估用量的账单测算,和实际账单对不上——普遍高出 20~40%。不是厂商算错,是**测算时漏了隐藏计费项**。五个最常被漏的,逐个拆。 ### 一、系统提示词:每次请求都在重复付费 你的 system prompt 有 2000 token,每轮对话都会整体计费——10 轮对话,这 2000 token 被计了 10 次。测算时只按「用户输入+输出」估,系统提示词这部分直接漏掉。**优化:system prompt 瘦身+启用上下文缓存**(缓存命中部分按折扣计费,多数厂商支持)。 ### 二、失败请求的重试放大 超时重试、限流退避、格式错误重新生成——**每次重试都是一次全额计费**。5% 失败率配 3 次重试策略,实际消耗放大 10~15%。测算时按「理想请求」估,重试这一项就漏了。**优化:失败率进成本仪表盘+重试上限收紧**。 ### 三、多轮对话的上下文滚动 多轮对话里,历史消息每次都作为上下文重发——第 10 轮的输入是前 9 轮的全文加新输入。对话越长,单轮计费越贵,**成本随对话深度二次增长**。测算按「平均对话轮数×平均轮成本」估,会严重低估长对话用户。**优化:对话摘要压缩历史+超长对话强制开新会话**。 ### 四、流式输出的心跳与半包 流式输出(SSE)的计费粒度问题:部分厂商按 chunk 累计,部分按最终全文——**差异在「半包重传」场景**。网络不稳时客户端断线重连,服务端可能已经生成了内容(计费了)但客户端没收到(用户体验丢了)。**优化:重连走断点续传而非重新生成**(省钱且体验一致)。 ### 五、模型路由的隐式升舱 「自动选择模型」的路由策略,在复杂请求时悄悄切到贵的模型——**测算按便宜模型估,实际跑在贵的模型上**。路由日志要审计:每个请求实际用了哪个模型、为什么。**优化:路由规则显式化+按功能固定模型档位**。 ### 结语 账单偏差的本质:**单价是显性的,用量是隐性的**。把这五个隐藏项做成对账清单,每月跑一次「测算 vs 实际」的偏差分析——偏差稳定在 5% 以内,你的成本模型才算及格。

优秀的个人博客,低调大师

密码时间机器:把 git 历史变成密码 API 的可查时间轴

> FIBEMATE 系列。本系列另一篇《密码学时间账本》解决「证据在何时存在」;这一篇回答一个更日常的问题:`ml_kem768` 这个符号是哪天进仓的?`X3DH` 的实现被改过几次?某次审计说「我们 6 月就支持了 SM3」,怎么一句话证实或证伪?答案是 git 历史本身——只是要能查。工具已开源:`crypto-time-machine`(github.com/Lennonhaha/fibemate-tools,纯 Python 标准库)。 ## 一、git log 不够用 git 本身能回答一半问题:`git log -S` / `-G`(pickaxe)可以找「一个字符串何时进入或离开代码库」。问题在工程侧: - 输出是人读的,不是结构化的——没有表、没法聚合、没法画时间轴。 - 每次都要手工拼参数、选范围、翻提交。 - 审计要的是「某个符号的完整变更轨迹 + 谁改的 + 哪些文件」,一条命令给全。 crypto-time-machine 做的事:把 `git log -S/-G` 包成 CLI,结果写进 SQLite 的时间轴表(sha、日期、作者、主题、涉及文件),可查、可导出、可复现。 ## 二、一条命令 参数五个关键位: - `--pattern`:追踪的符号或字符串(`ml_kem768`、`X3DH`、`3329`、`sm3_compress`……)。 - `--mode=-S` / `--mode=-G`:直通 git 的两种 pickaxe 语义——`-S` 统计出现次数变化,`-G` 按正则比对新旧 diff。两种模式回答的问题不同,都保留。 - `--db`:SQLite 输出路径。 - `--since` / `--until` / `--query-after`:时间窗。 ## 三、实测 扫 fibemate 主仓(2026-09-27 实测): - `ml_kem768`,`-S` 模式:**6 个事件**——从 initial commit(`db81c7f`,2026-07-06,v3.1-preview 开源)到 2026-09-19 换用 @noble/post-quantum 参考实现(`cba1915`,#115),每个事件带完整 sha、时间戳、作者、主题。 - `X3DH`,`-S` 模式:**69 个事件**。 - `sm3_compress`,`-G` 模式:**0 个事件**——当前主仓没有这个符号的变更记录,查询本身就证伪了一句「我们改过 SM3 底层」。 注意这些数字会随仓库增长而漂移——`X3DH` 一周前还是 67,现在是 69。时间轴是活数据,引用时给查询日期。 ## 四、两个设计决定 **直通 git pickaxe,不自建索引。** `-S` 和 `-G` 的语义差异(出现次数 vs diff 内容)是 git 十几年打磨出来的,自己重写一遍只会引入分歧。工具的价值在结构化输出和时间窗,不在重新发明搜索。 **SQLite 单表。** `timeline(id, sha, date, author, subject, files)`——六个字段,够画时间轴、够做审计附件、够被别的脚本 join。多一层抽象都不加。 ## 五、测试与 CI - `test/local_test.py`:10 项(文件历史非空、不存在符号返回空等),对主仓实测 **ALL PASS**。 - `test/ci_test.py`:9 项(query 返回列表、条目含 files 等),**ALL PASS**。 - CI 挂 `time-machine-ci` workflow,截至 2026-09-27 累计 **51 次成功运行**。 - 零外部依赖:imports 只有 `json / os / re / sqlite3 / subprocess / datetime`,全标准库。`ctime/core.py` 当前 168 行。 ## 六、边界 - **只回答「何时出现、何时消失、改了哪些文件」,不解释动机。** 提交主题是作者写的,时间机器不猜测「为什么改」。 - **git 历史可重写。** rebase、重新签名都能改写过去——这正是《密码学时间账本》一篇讨论过的问题,两个工具是互补关系:时间机器管「查」,时间账本管「锚」。查询结果的可信度以 git 对象图的完整性为界。 - **模式匹配抓不到语义等价。** 符号改名(`kyber` → `ml_kem768`)会表现为一消一长两个事件,不会自动合并。 ## 七、结语 系列至此四条线:可观测性管运行时,TLA+ 管协议逻辑,时间账本管存证锚定,时间机器管历史查询。四条线共同的出发点:审计的人不该信任何一句口头断言——每句话都应该能变成一条可执行的查询。 工具页:`fibemate.net/tools/time-machine`。 **参考实践** - 工具:github.com/Lennonhaha/fibemate-tools → `crypto-time-machine/`(19 项测试 = 10 local + 9 ci,全 PASS,零外部依赖) - 查询示例:`ml_kem768` 6 事件 / `X3DH` 69 事件 / `sm3_compress` 0 事件(2026-09-27 实测) - CI:`.github/workflows/time-machine-ci.yml`(51 次 success) - 姊妹篇:时间账本(RFC 3161 锚定)——本篇查询层与其锚定层互补 **词汇注释** - **pickaxe(-S / -G)**:git 的历史搜索模式。-S 统计字符串出现次数的变化,-G 用正则比对新旧 diff 内容。 - **SQLite**:嵌入式单文件数据库,本文工具的输出格式。 - **事件(event)**:一个 commit 中目标符号发生增删改的一次记录。

优秀的个人博客,低调大师

天气预报API架构拆解:四接口解耦设计与应用场景

## 一、接口整体架构 这个接口有四个子接口: - **根据城市查询天气**:核心气象数据(温度、湿度、AQI、天气、风向等) - **根据城市查询生活指数**:衍生气象服务数据(穿衣、洗车、运动、紫外线等生活建议) - **天气种类列表**:天气编码映射表,用于前端图标渲染、数据统一标准化 - **支持城市列表**:城市数据源校验,提前规避无效城市查询报错 > 这种拆分方式可缓存**天气种类**和**城市列表**,减少重复请求,提升响应速度与稳定性。 ## 二、四大子接口技术详解 请求方式:GET / POST 请求, 返回格式: JSON ### 1. 根据城市查询天气(核心) - 技术场景:天气首页展示、实时温度卡片、多城市天气监控看板。 ![](https://developer.qcloudimg.com/http-save/yehe-12701231/a612f689cf4f97d0d65d711088541961.png) ### 2.根据城市查询生活指数(衍生服务接口) 更贴近用户生活的。该接口整合了日常高频使用的气象生活指数,每个指数包含等级状态+详细建议。 - 技术场景:出行提示、生活建议模块、公众号天气推送、民宿/旅游场景出行提醒。 ```json "code": 1, "msg": "操作成功", "data": { "city": "北京", "list": { "kongtiao": {/*空调开启*/ "v": "开启制暖空调",/*指数*/ "des": "您将感到有些冷,可以适当开启制暖空调调节室内温度,以免着凉感冒。"/*指数详情*/ }, "guomin": {/*过敏*/ "v": "极不易发", "des": "天气条件极不易诱发过敏,可放心外出,享受生活。" }, "shushidu": {/*舒适度*/ "v": "较不舒适", "des": "白天天气晴好,但仍会使您感觉偏冷,不很舒适,请注意适时添加衣物,以防感冒。" }, "chuanyi": {/*穿衣*/ "v": "冷", "des": "天气冷,建议着棉服、羽绒服、皮夹克加羊毛衫等冬季服装。年老体弱者宜着厚棉衣、冬大衣或厚羽绒服。" }, "diaoyu": {/*钓鱼*/ "v": "不宜", "des": "天气冷,不适合垂钓。" },…… ``` ### 3.天气种类列表 开发会遇到:后端返回天气文字(晴、多云、小雨),前端需要匹配对应图标,手动映射极易出错、且无法统一标准。该接口返回wid编码与天气名称的完整映射表。 - 项目首次启动调用一次,缓存至本地数据库/前端本地存储,无需重复请求。 ```json { "code": 1, "msg": "操作成功", "data": [ { "wid": "00", "weather": "晴" }, { "wid": "01", "weather": "多云" }, { "wid": "02", "weather": "阴" }, { "wid": "04", "weather": "雷阵雨" },…… ``` ### 4.支持城市列表 大部分天气接口报错,根源都是城市名称不规范、不在服务白名单。该接口返回全部可查询城市数据,包含省份、城市、区县、唯一城市ID。 - 前端下拉选择、后端参数校验,优先匹配缓存的城市列表。 ```json { "code": 1, "msg": "操作成功", "data": { "list": [ { "id": "1", "province": "北京", "city": "北京", "district": "北京" }, { "id": "2", "province": "北京", "city": "北京", "district": "海淀" }, { "id": "3", "province": "北京", "city": "北京", "district": "朝阳" },…… ``` ## 三、应用场景 - **轻量化前端应用**:旅游、民宿、本地生活、日历工具类小程序及H5页面,展示目的地气象数据与出行指数建议。 - **智能推送服务**:公众号、企业机器人、消息推送系统,实现定时城市气象播报、出行提醒自动化触达。 - **行业后台系统**:农业、物流、景区、物业等业务后台,搭建多城市气象监控看板,辅助生产运营决策。 ## 四、开发避坑 1. **优先使用城市ID精准查询** 城市文字名称存在别名、简称、重名等歧义问题,极易导致查询失败或数据错乱。生产环境建议统一采用城市ID作为查询唯一参数. 2. **基于WID编码做前端适配与数据统计** 中文描述存在语义差异、版本迭代变更风险,WID编码为全局唯一标准,是前端渲染、数据标准化的唯一依据。 3. **静态数据全局缓存,动态数据实时请求** 天气字典、城市列表属于极低变更静态数据,需全局缓存复用;实时天气、生活指数为动态业务数据,按需实时请求。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

用户登录
用户注册