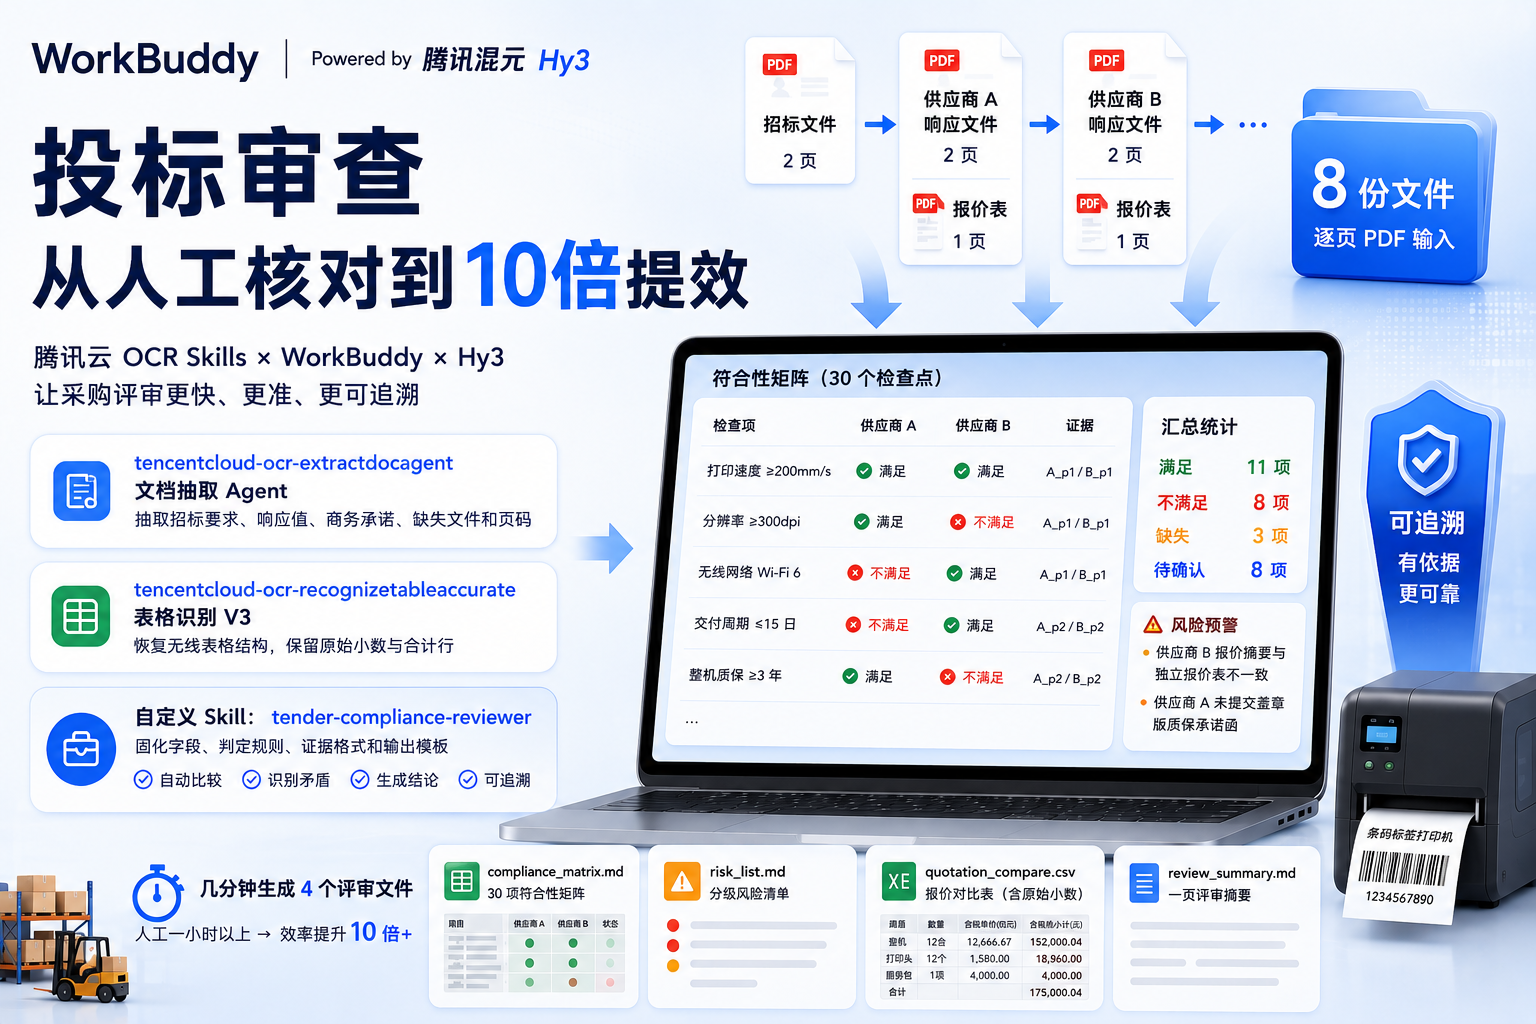
我一路问 WorkBuddy,用腾讯云 OCR Skills 在几分钟内完成了投标审查
采购评审最费时间的,并不是阅读某一份文件,而是在招标要求、技术响应和报价表之间反复核对。供应商写了“满足”未必真的满足,报价更低也未必能够推荐。 我用 WorkBuddy 从零搭了一套投标审查流程。**不懂密钥、OCR 开通、Python 依赖和 Skill 开发也可以直接问它**;它会给出入口、定位问题,并完成能够代办的本地操作。流程由腾讯混元 **Hy3** 驱动,在我测试期间处于[限时免费体验](https://cloud.tencent.com/developer/article/2720820)阶段,具体期限以官方页面为准。 结果很直接:**8 份逐页 PDF 生成 4 个评审文件,符合性矩阵覆盖 30 个检查点**。流程识别出供应商 B 的两份报价相差 **3,959.96 元**,还把其自评的“12 日不满足”纠正为 **`12 <= 15**`******,实际满足**。 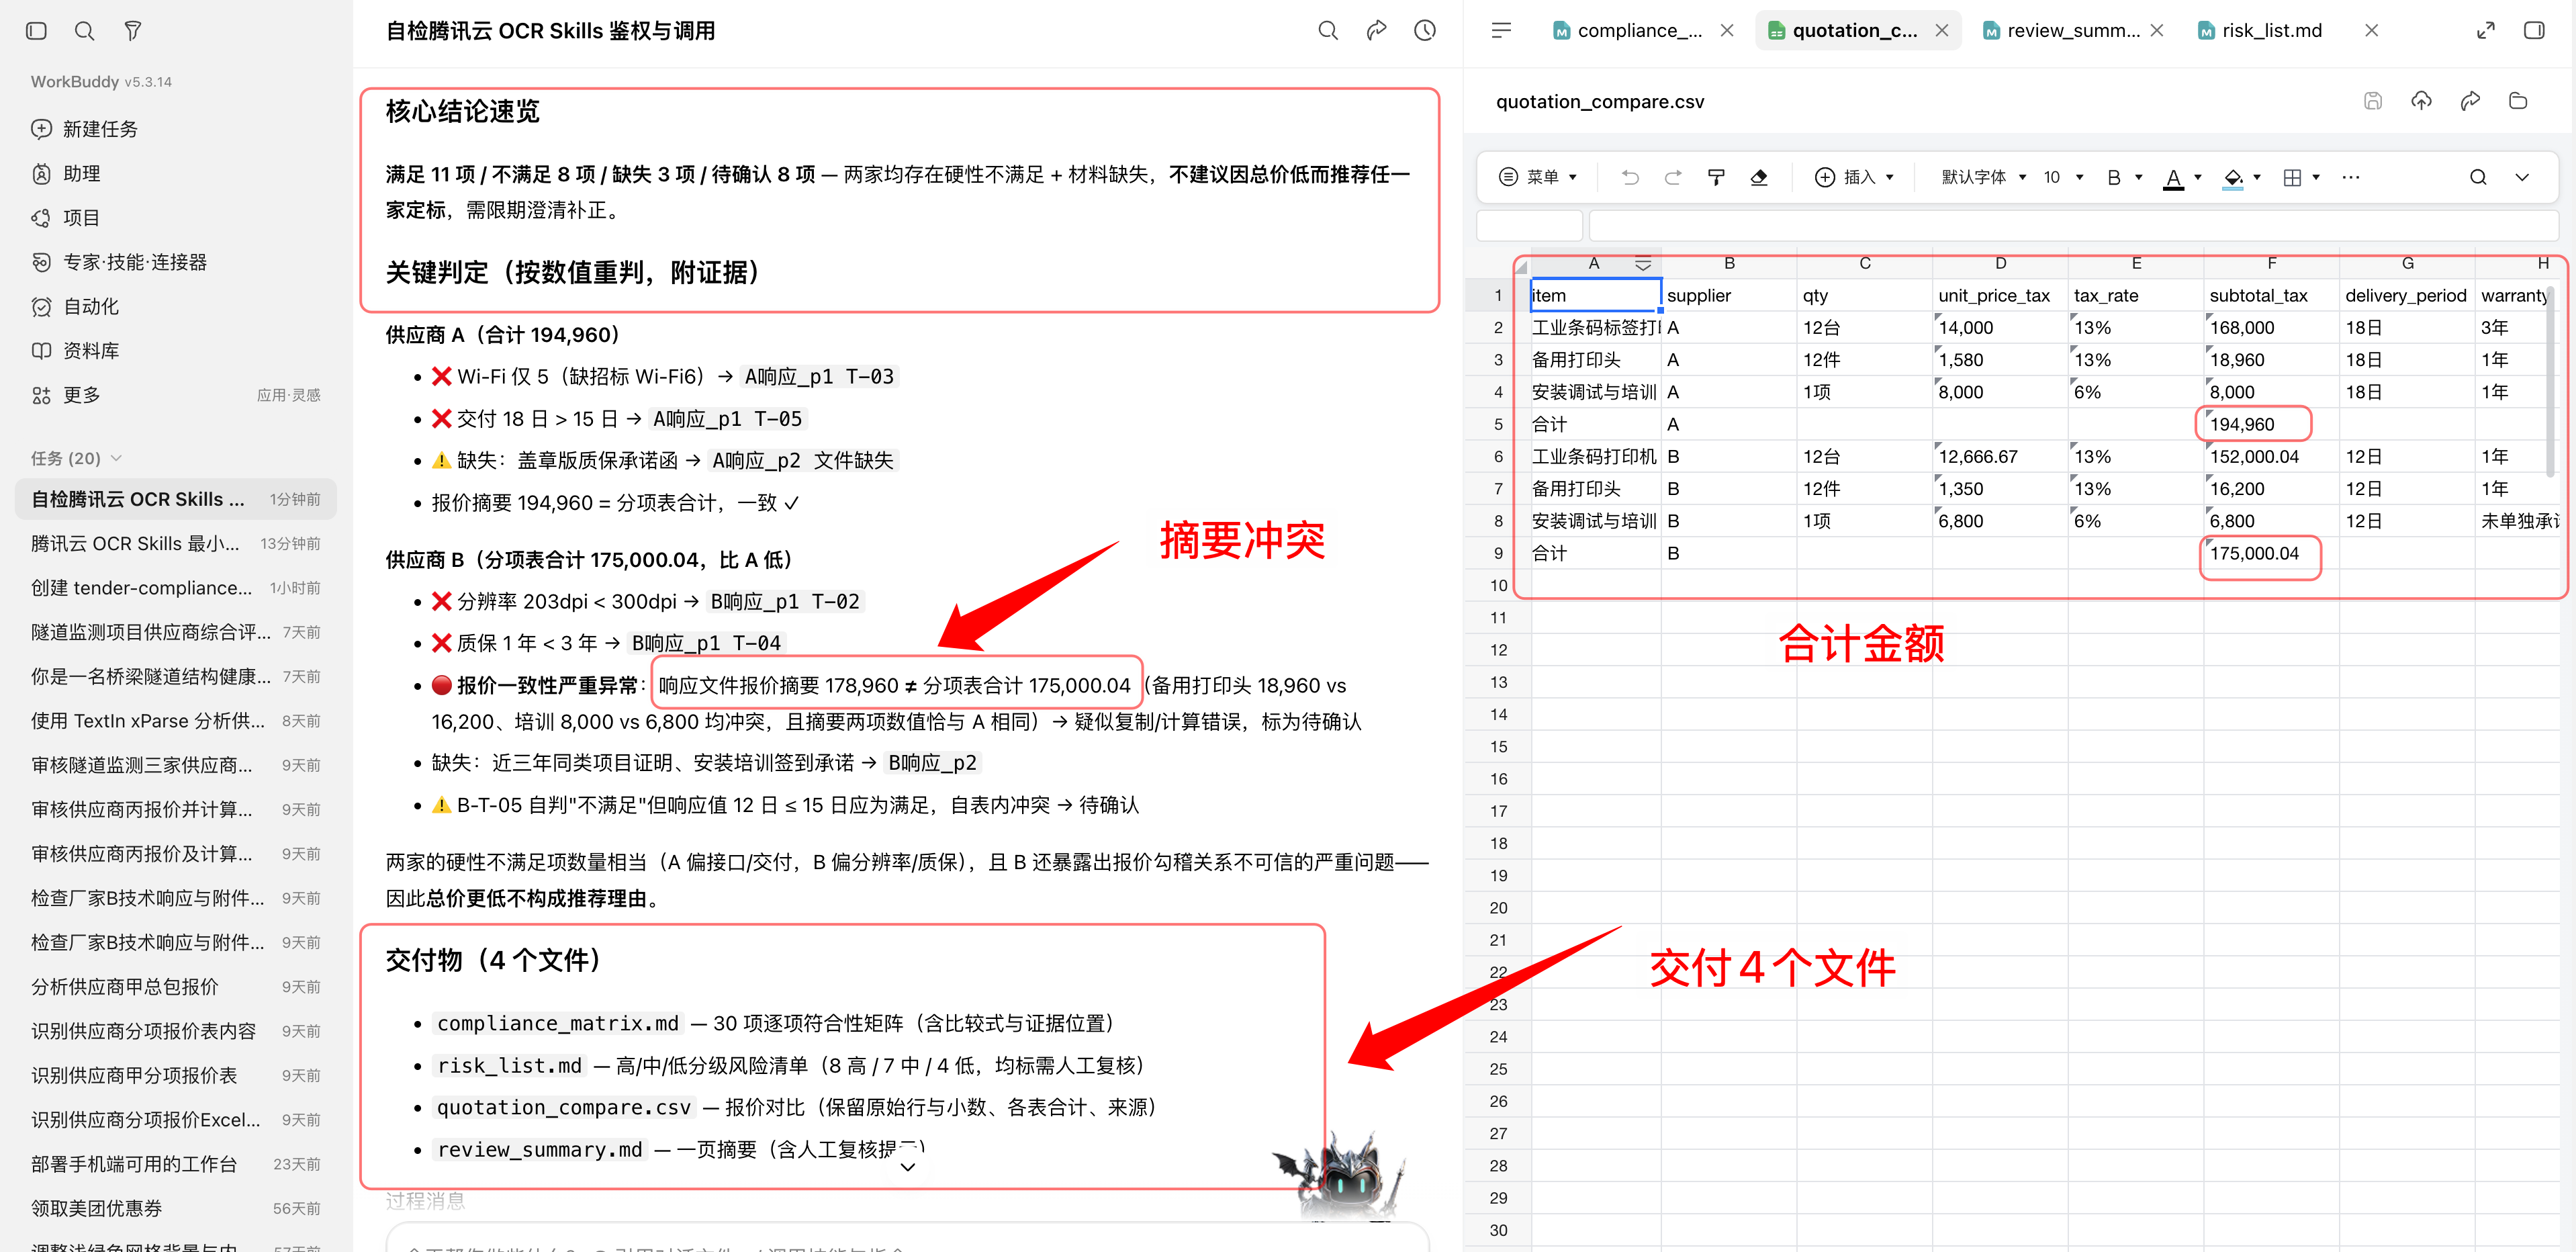 单组材料实际处理为**几十秒到几分钟**。若人工完成同等摘录、核算和整理需要一小时以上,效率会达到 **10 倍量级**;这是按人工基线换算的场景测算,不是严格的对照实验。 ## 先把业务问题说清楚 测试材料是一份虚构的智慧仓储标签打印设备采购项目。招标文件要求采购 **12 台工业条码标签打印机、12 个备用打印头**以及安装调试和培训服务,核心门槛包括:打印速度不低于 **200 mm/s**、分辨率不低于 **300 dpi**、支持 **Wi-Fi 6**、**15 个日历日**内完成交付、整机及打印头质保不少于 **3 年**,同时还要求提交技术响应表、分项报价表、交付计划、质保承诺函和类似项目说明。 我故意准备了两家不完全合格的供应商:A 的 Wi-Fi 是 **Wi-Fi 5**,交付要 **18 日**,盖章版质保承诺函没有提交;B 的分辨率只有 **203 dpi**,质保只有 **1 年**,报价摘要还和独立报价表对不上。B 的响应表把 12 日交付自评为“不满足”,但招标要求是最多 15 日,**`12 <= 15**`******,最终应该判定为满足**。这个错误专门用来检验流程会不会照抄供应商结论。 输入文件按页准备,是因为实时文档抽取接口对 PDF 使用页码参数,逐页上传更容易在不同 WorkBuddy 版本中复现。最终完整审查使用 **8 个文件**:招标文件 2 页,A 响应文件 2 页和报价表 1 页,B 响应文件 2 页和报价表 1 页。报价表虽然只有一页,也放在 `pages/` 目录中统一管理。 ## 先装两个识别 Skill,再确认分工 这套流程的分工很明确。 |层次 |负责内容 |本次产物 | | --- | --- | --- | |WorkBuddy + Hy3 |理解任务、拆分步骤、调用 Skill、读取本地文件、合并证据、生成交付物|compliance_matrix.md、risk_list.md、quotation_compare.csv、review_summary.md| |tencentcloud-ocr-extractdocagent |按字段抽取招标要求、响应值、商务承诺、缺失文件和页码 |招标要求与供应商响应结构化结果 | |tencentcloud-ocr-recognizetableaccurate|恢复无边框、多列报价表的单元格和合计行 |报价明细、Excel 文件和跨表金额核对 | |tender-compliance-reviewer |固化字段 schema、判定规则、证据格式和输出模板 |可反复调用的投标审查专用 Skill | 腾讯云的[表格识别(V3)接口](https://cloud.tencent.com/document/api/866/86721)支持常规表格、无线表格和多表格检测,能够返回单元格文字,并支持保存为 Excel。这个案例里的报价表没有边框,型号、数量、税率、小计和质保挤在同一行,先恢复单元格结构,后面的金额核对才有可靠输入。  搜索时我直接使用完整 slug `tencentcloud-ocr-recognizetableaccurate`。它在本案例中只负责报价页:保留 9 个业务列、三行明细和合计行,不负责判断供应商是否满足招标要求。 第二个安装的是 `tencentcloud-ocr-extractdocagent`。它处理招标文件和响应文件,把“15 日内”“不少于 3 年”这类自然语言约束抽成字段,同时返回来源页码。两个 Skill 的职责没有重叠:一个恢复表格,一个抽取文档字段。 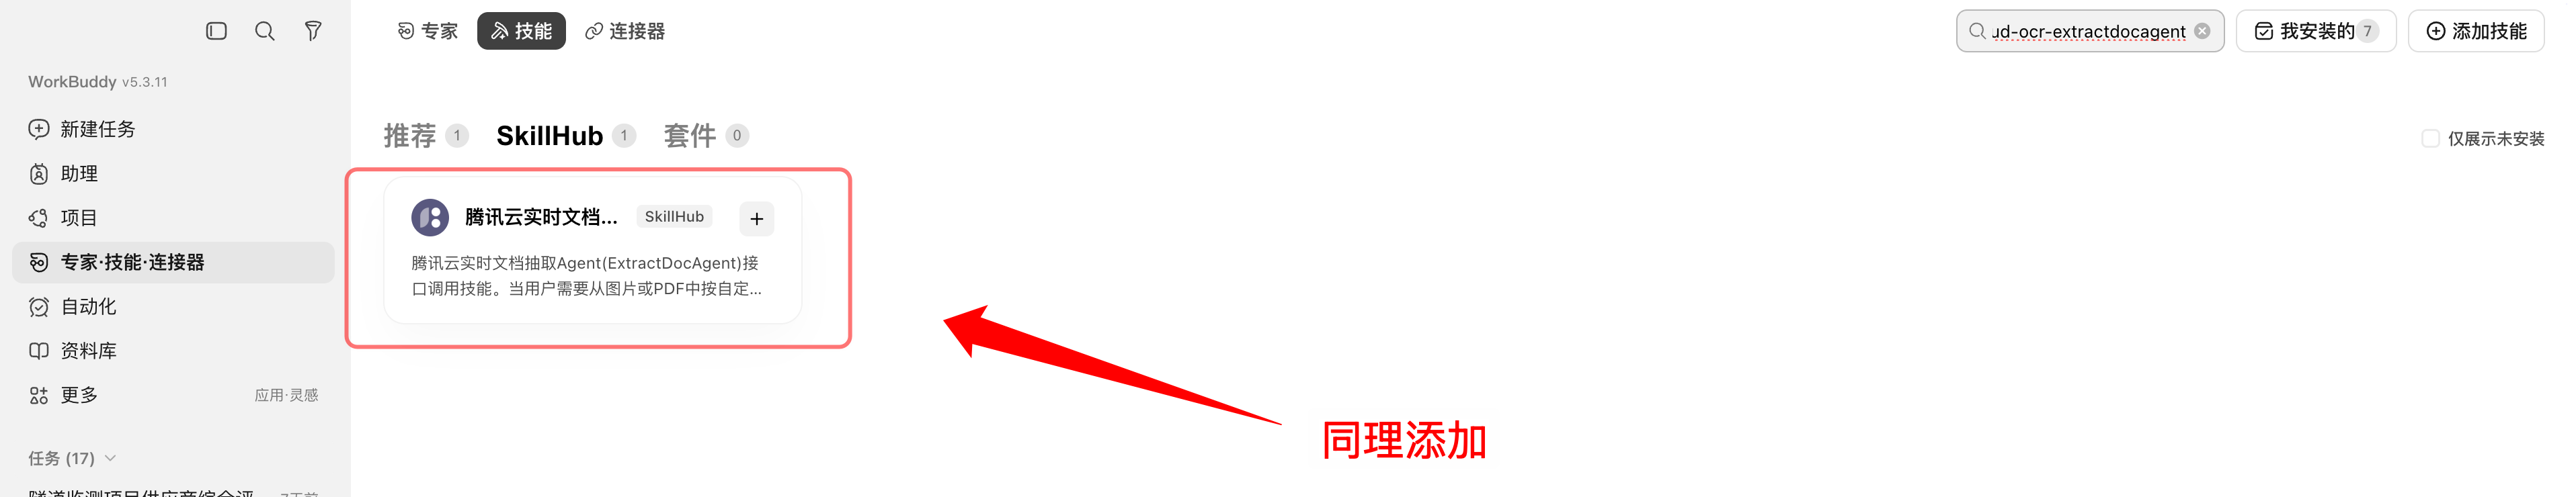 两个 Skill 安装后,我回到“我安装的”页面确认开关状态。此时文档抽取 Agent 和表格识别 V3 都已启用,后续自定义 Skill 才有可以调用的底层能力。安装阶段的客户端版本是 5.3.11,正式审查时升级到了 5.3.14,入口和调用方式没有变化。 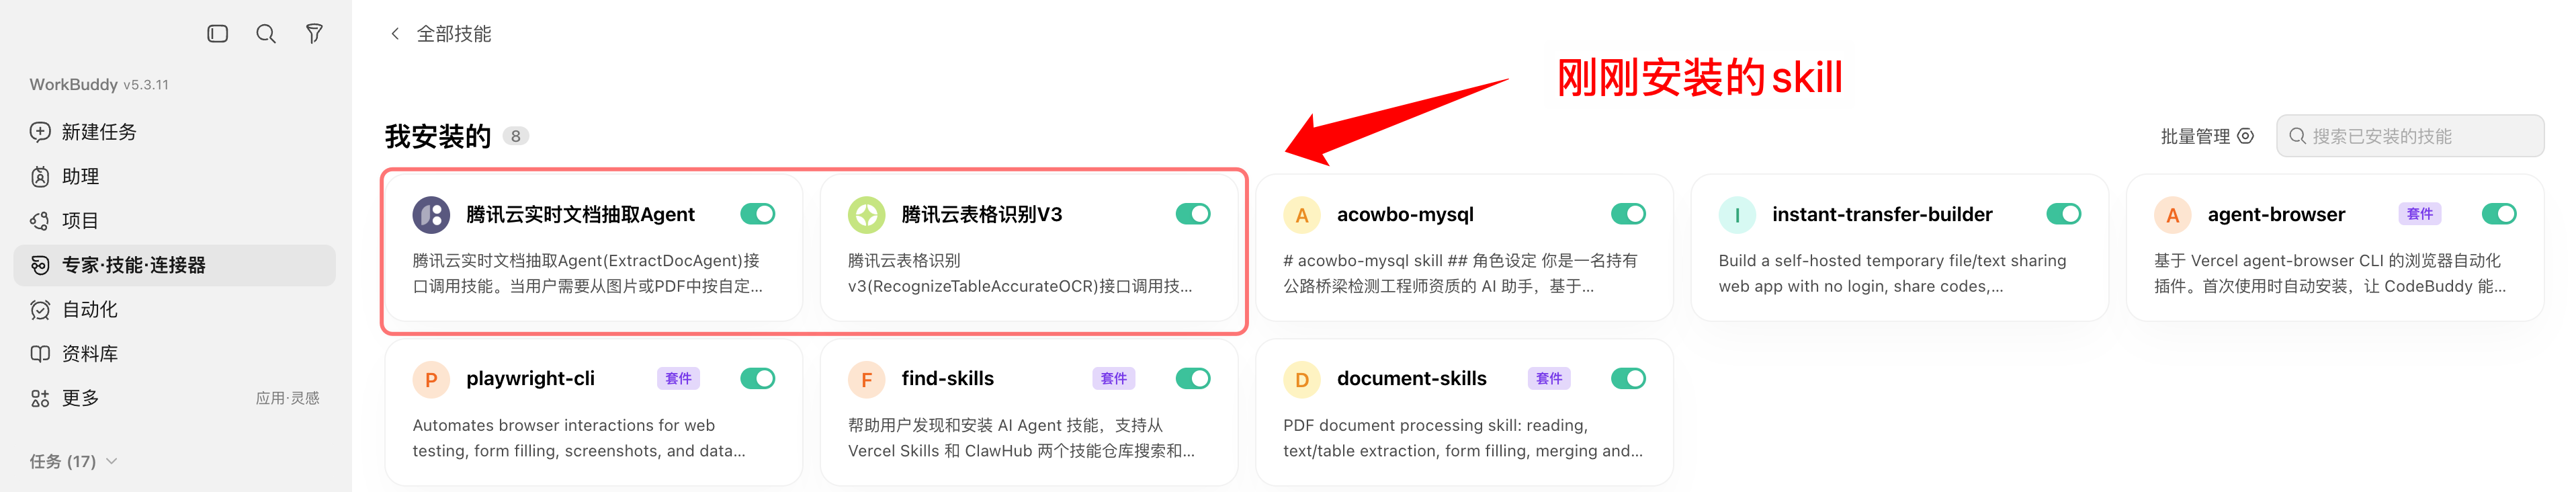 ## 从“不知道怎么配”开始,直接问 WorkBuddy 安装成功不等于能够调用腾讯云接口。我没有先查一遍配置教程,而是直接让 WorkBuddy 做一次不上传业务文件的最小自检。它检查了 Skill 文件、鉴权变量和运行依赖,随后把问题缩小到两处:`TENCENTCLOUD_SECRET_ID/KEY` 没有读到,`tencentcloud-sdk-python` 没有安装。原本模糊的“Skill 用不了”,到这里已经变成两个可以处理的具体问题。 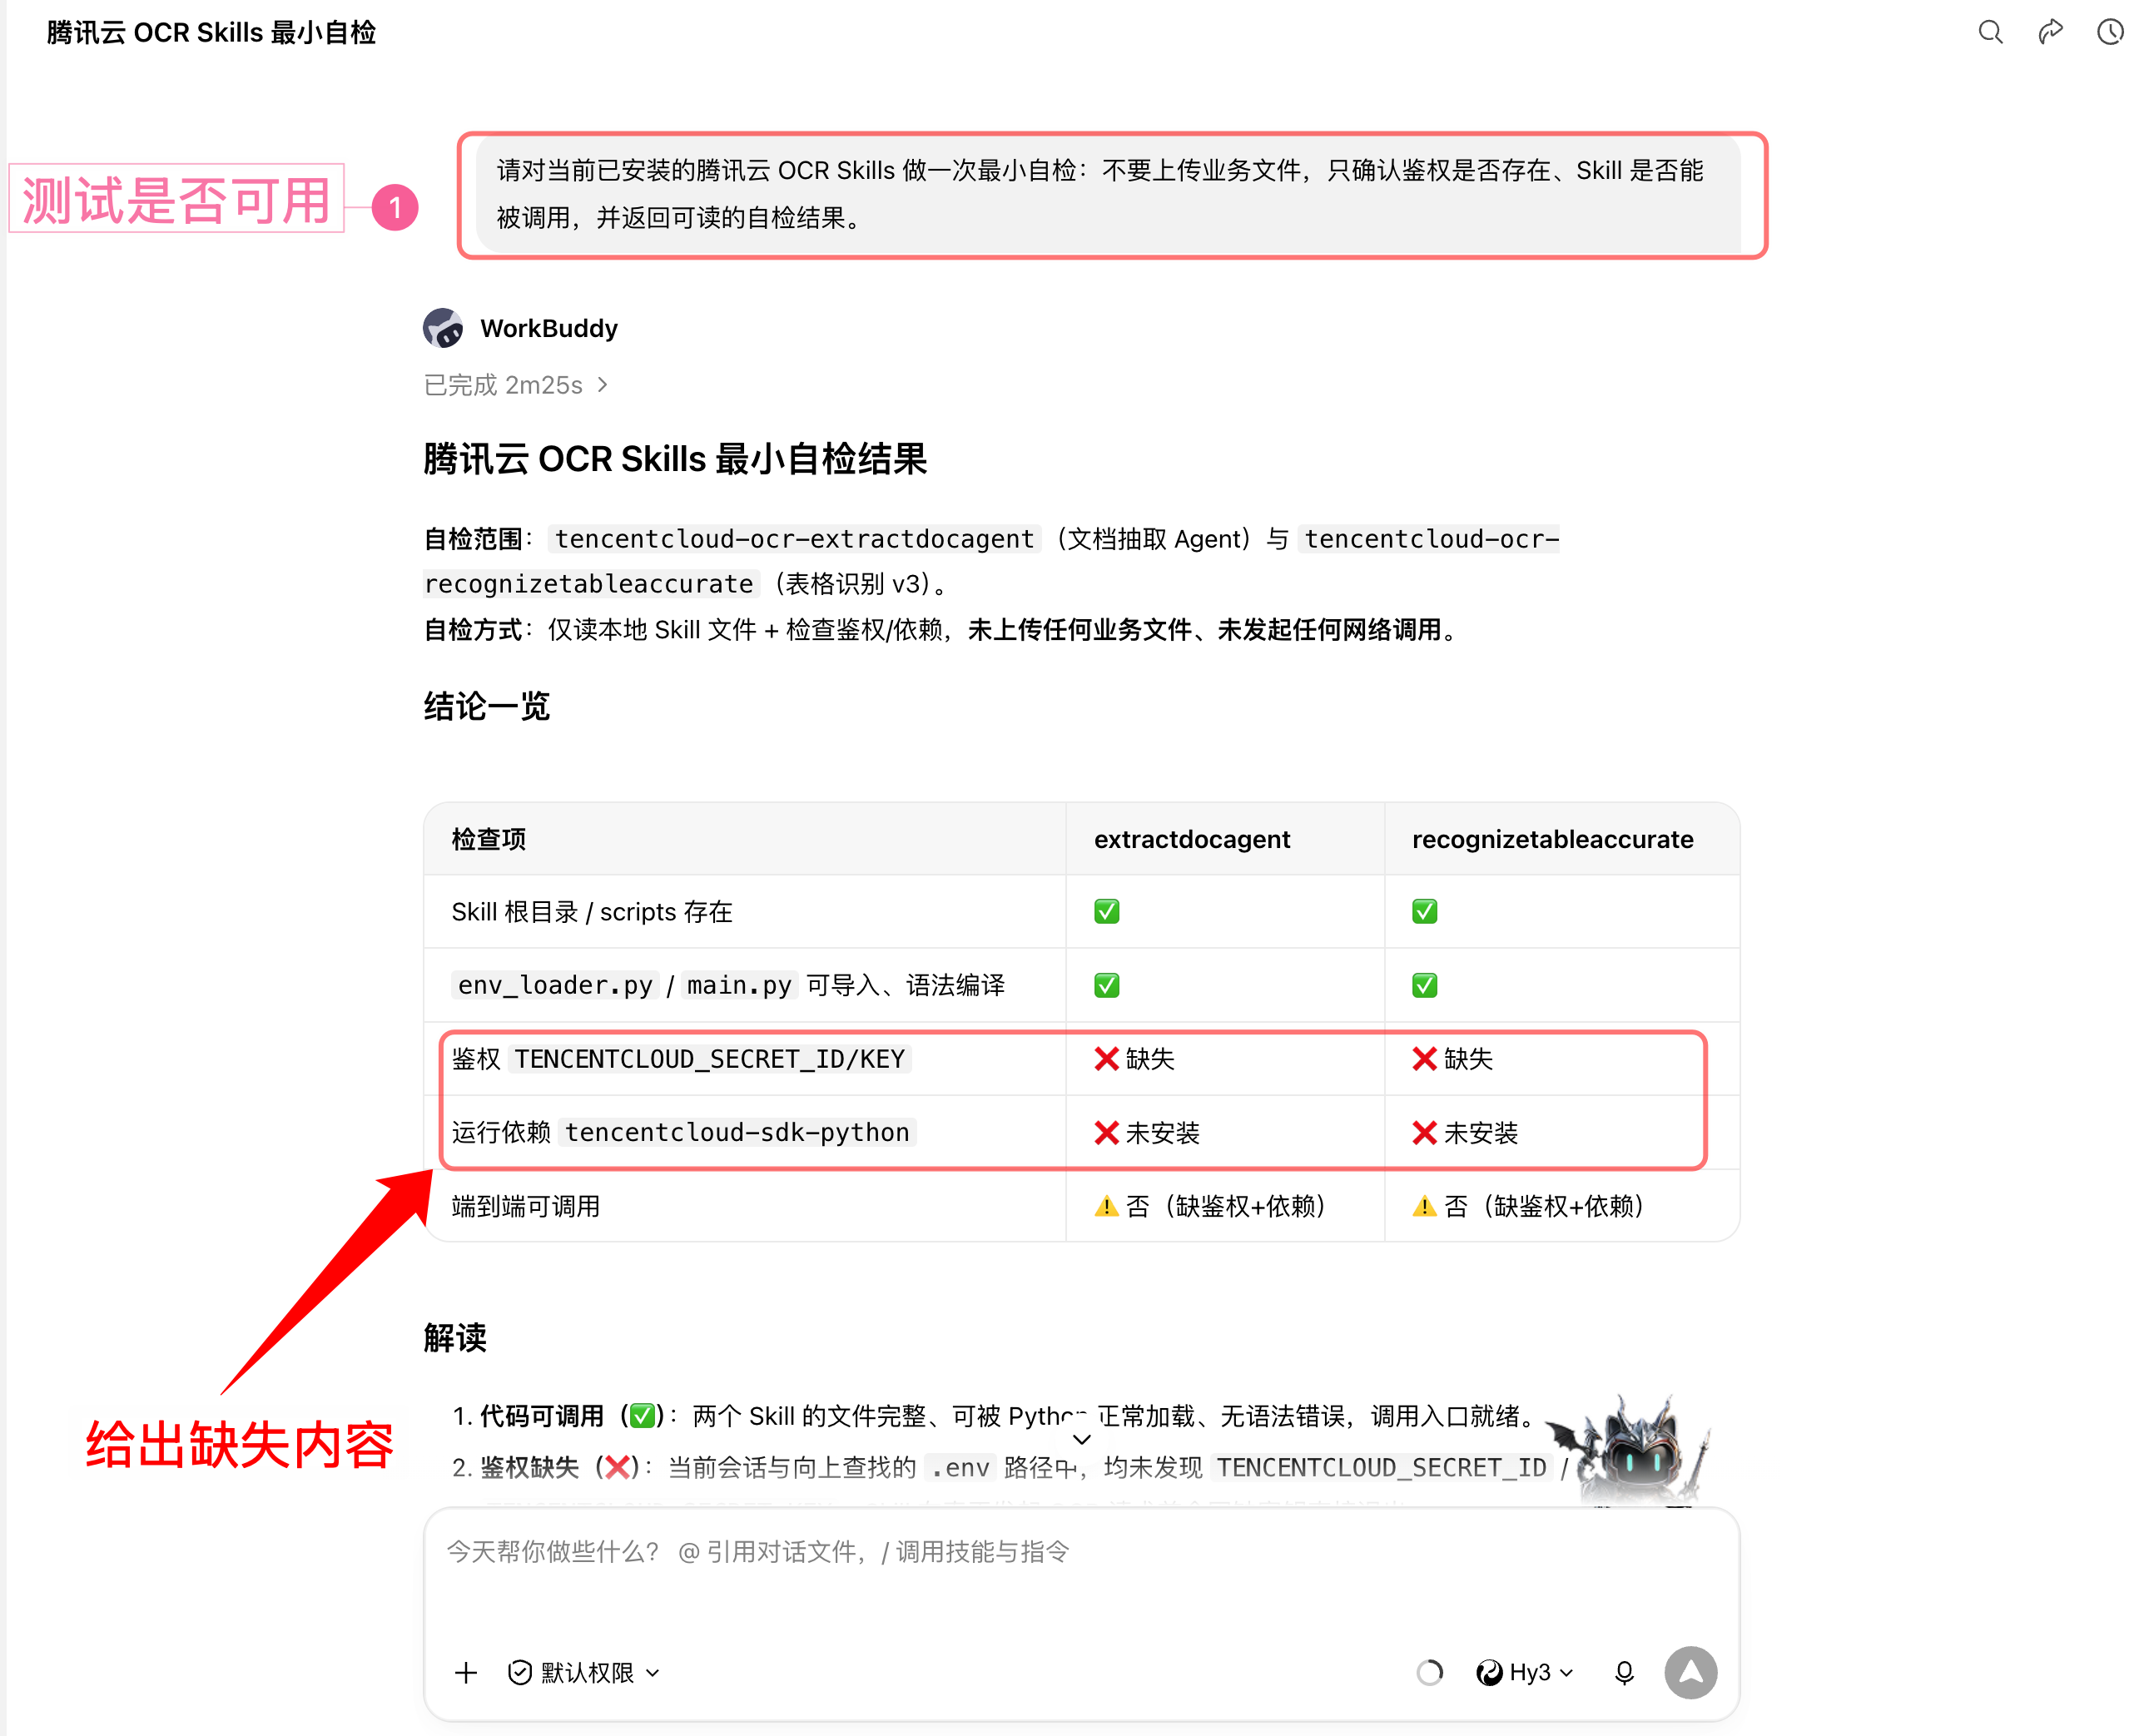 我当时并不知道这组密钥应该去哪里创建,于是直接追问:“从哪获取 `TENCENTCLOUD_SECRET_ID/KEY`?”WorkBuddy 给出了腾讯云访问管理 CAM 的直达地址、创建步骤、可用的配置位置,以及 SecretKey 只显示一次的注意事项。这里不需要用户先弄懂 CAM 是什么,先照着准确路径完成必要操作即可。 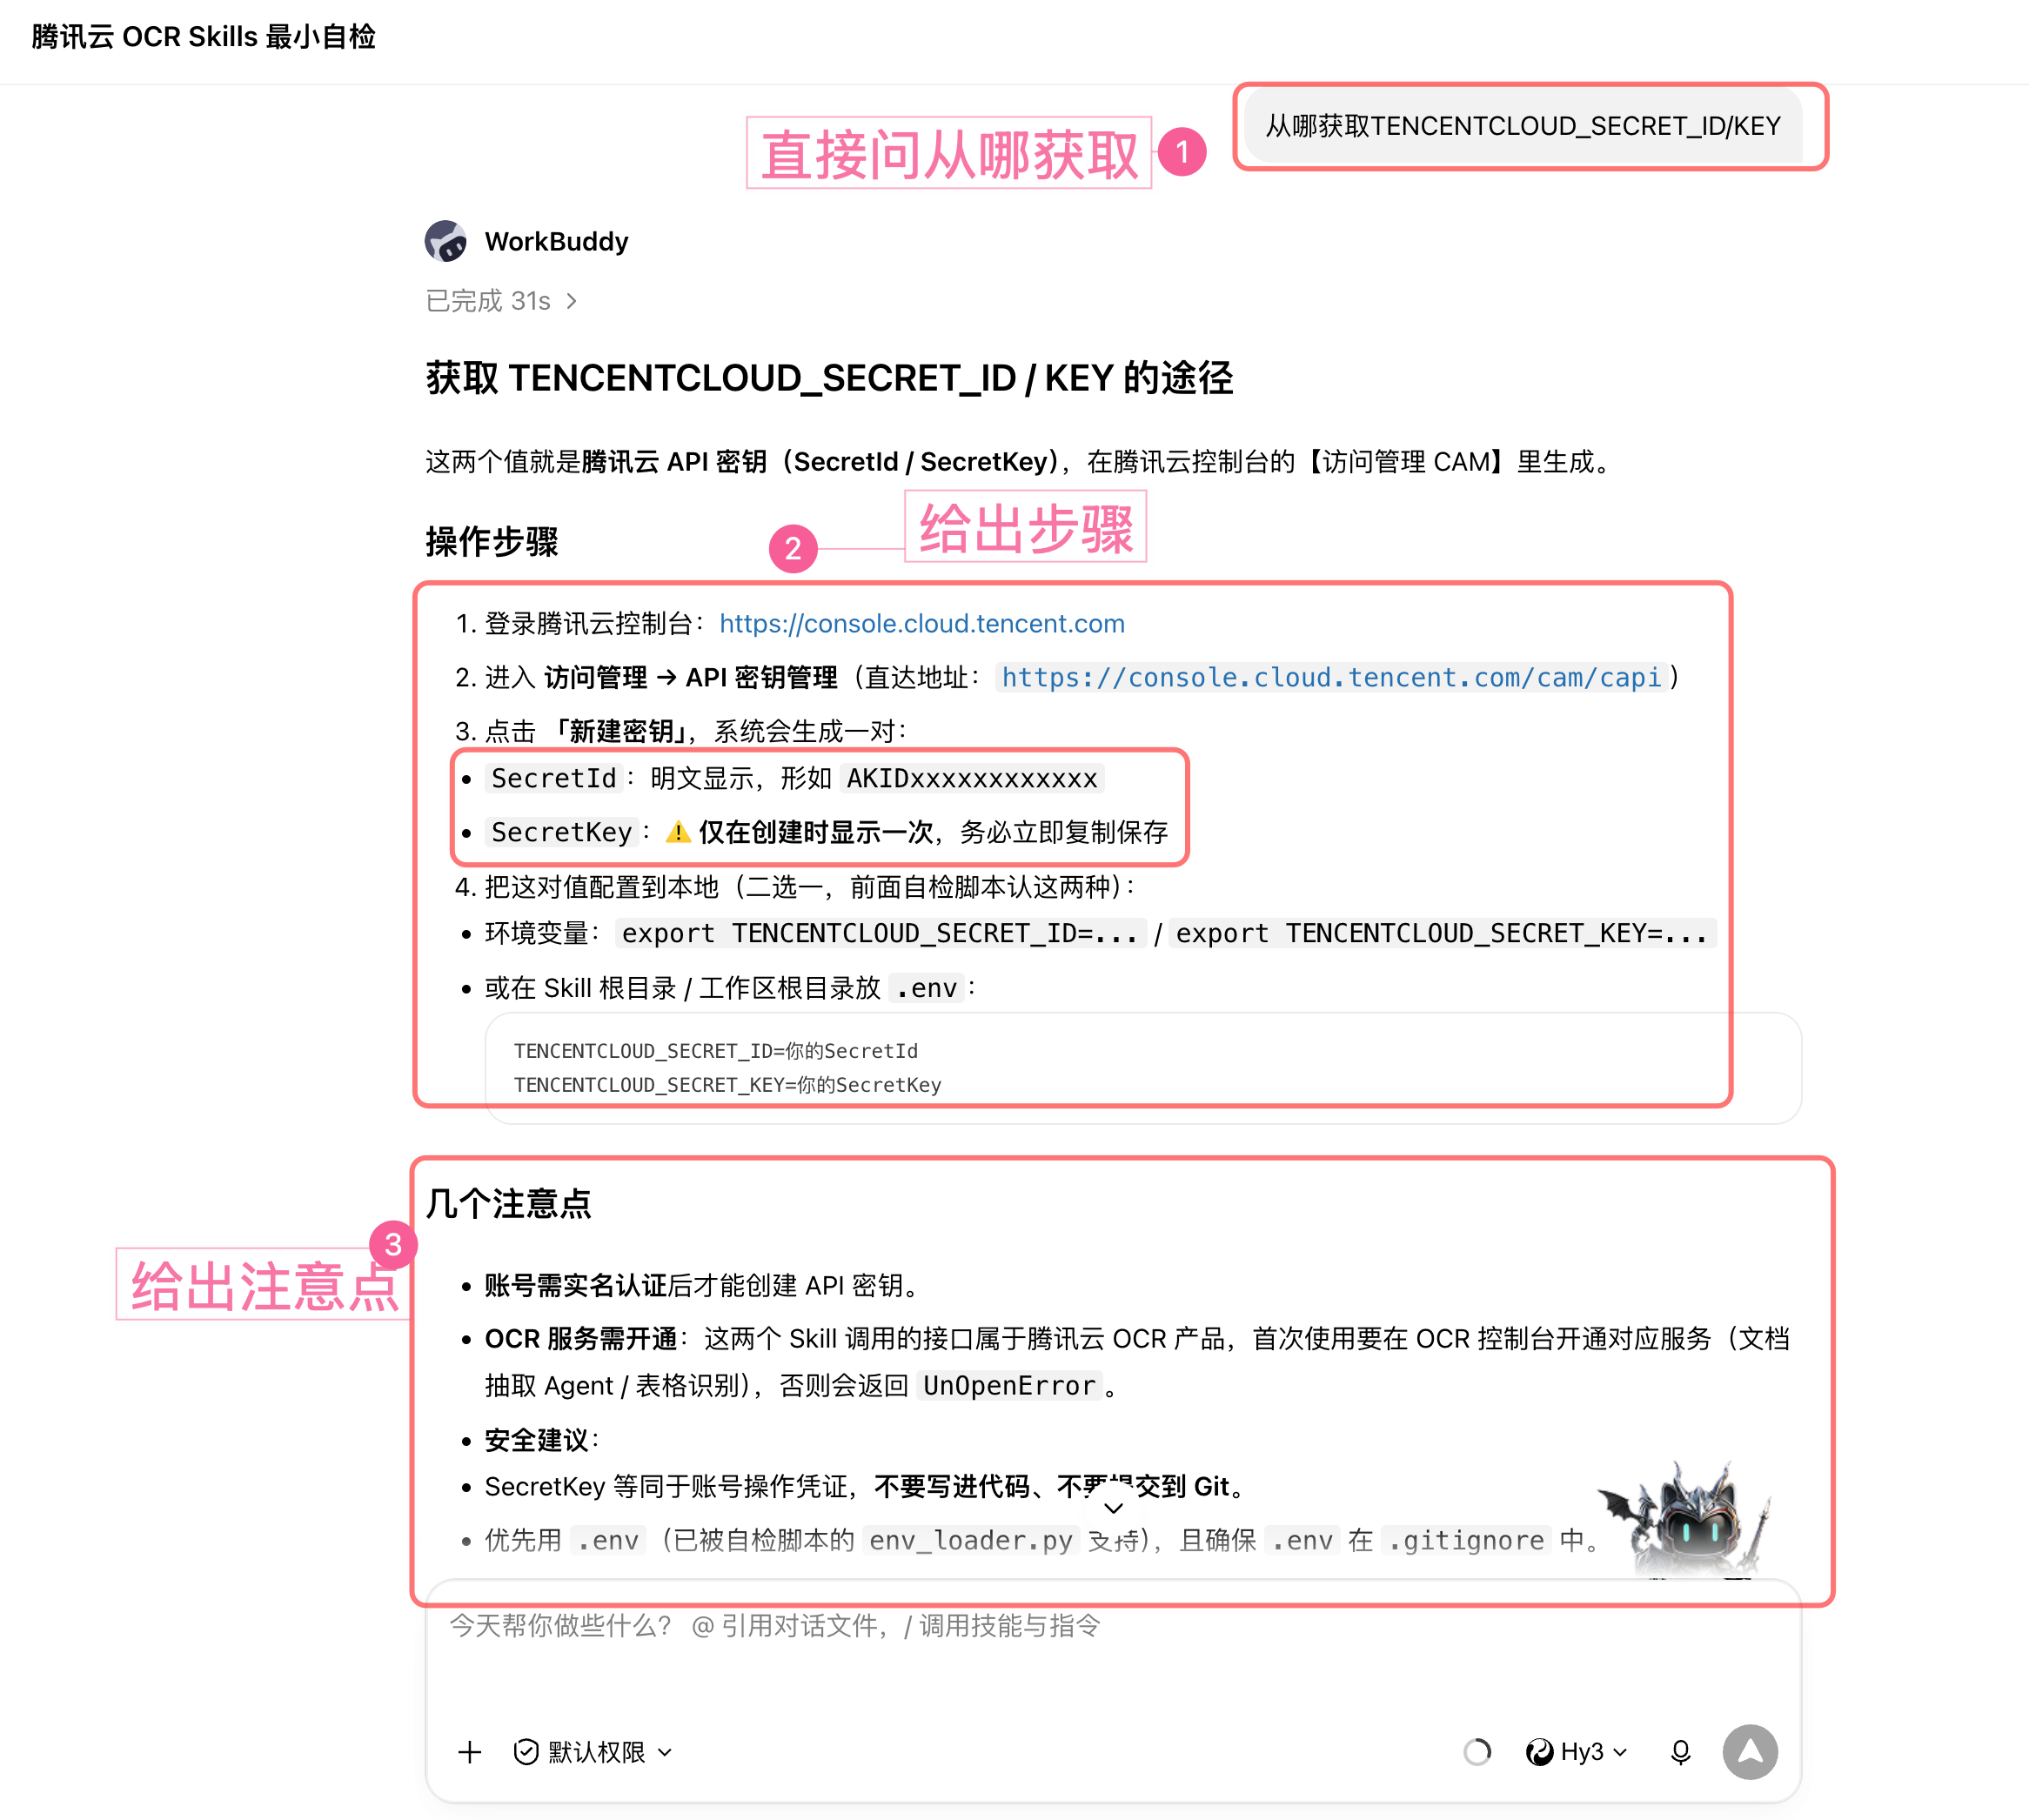 按照它给出的地址,我进入 CAM 的“API 密钥管理”页面创建密钥。这一步必须由账号本人完成;生产环境更适合使用仅授予 OCR 所需权限的子用户密钥,避免直接使用权限过大的主账号密钥。  创建密钥后,我仍然不知道 OCR 服务从哪里开通,继续问一句“开通链接有吗”。WorkBuddy 随即返回文字识别控制台、API 密钥管理、智能结构化 OCR 和表格识别 V3 文档地址,并把“一键开通文字识别服务”的步骤列了出来。  密钥最初被我写进了 `~/.zshrc`。我也分不清 Skill 具体从哪里加载环境变量,只告诉 WorkBuddy:“你现在看看呢,我配置好了。”它读取当前环境后发现,Skill 的 `env_loader` 不会自动 `source ~/.zshrc`,所以运行时依然拿不到凭证。接下来的修复由 WorkBuddy 完成:把同一组密钥落到加载器支持的 `$HOME/.env`,再把缺失的 `tencentcloud-sdk-python` 安装进托管 venv。再次自检时,两个 Skill 已能读取鉴权,Python SDK 也可以正常导入。 这段配置过程反而把 WorkBuddy 的作用体现得最直接:**不知道就问,出错就把现状交给它查。** 用户可以不知道 SecretId 在哪里创建,不知道 OCR 有没有开通,也不知道 Skill 如何加载环境变量。WorkBuddy 会根据实际检查结果给出下一步,并把它能执行的本地修复继续做完。它同时保留了必要的边界提醒:**代码层全绿不等于云端接口已经可用,OCR 服务仍需在控制台开通**。  ## 开通 OCR 后再核对免费资源包 按照 WorkBuddy 给出的链接打开文字识别控制台,页面提示当前账号尚未开通服务。勾选服务条款并点击“立即开通”,才算补齐云端接口的调用条件。这里的分工很清楚:WorkBuddy 负责诊断和带路,Skill 负责发起调用,涉及账号授权的创建密钥和开通服务仍由用户确认。  服务开通后,我进入数据报表查看实际资源包。控制台中,**表格识别 V3、文档抽取基础版和多模态版**均显示剩余免费额度;按照[官方免费额度说明](https://cloud.tencent.com/document/api/866/35945),表格识别 V3 归入共享的 **1000 次/月**资源包,文档抽取 Agent 则是首次开通后 **1000 次/用户、有效期 1 年**。页面呈现的是当前账号已到账的资源包,Agent 的额度规则仍以官方说明和账号实际到账为准。  ## 从两个 Skill 到一个业务 Skill 单独安装两个能力包还不够。采购人员不应该每次都重新解释“先抽招标文件,再抽响应文件,再识别报价表,最后按门槛比较”。我也没有从头学习 Skill 目录规范、手写 `SKILL.md` 和校验脚本,而是进入 WorkBuddy 的“创建技能”,用自然语言说明输入文件、必须调用的两个 OCR Skill、判定规则和四个输出文件,让 `skill-creator` 创建 `tender-compliance-reviewer`。  这个自定义 Skill 里固化了四类规则: 1. 招标文件抽取项目编号、采购范围、核心技术指标、交付周期、质保期限、付款方式和必交文件。 1. 供应商响应抽取型号、逐项技术参数、交付承诺、质保承诺和缺失文件。 1. 报价表逐行保留名称、型号、数量、含税单价、税率、含税小计、交付周期、质保和合计。 1. 每项结论必须带招标要求、响应值、比较表达式、状态、文件名和页码;没有出现的材料只能标记为“缺失”,不同文件出现不同值则标记“待确认”。  WorkBuddy 最终生成了完整的 Skill 目录、字段定义、判定规则、输出模板和构建脚本,并完成校验与打包。这里的“自定义”不是再训练一个模型,而是把业务字段、调用顺序和判定口径固定下来。Hy3 负责理解和组织任务,真正识别表格和文档的动作仍然落到两个腾讯云 Skill 上;流程既能用自然语言启动,又不会把专业识别全压在通用对话模型身上。 ## 第一轮:先把招标文件变成门槛 正式测试的第一轮只上传招标文件两页,不上传任何供应商材料,也不把人工基准 CSV 提前交给 WorkBuddy。提示语要求每个字段附原文件名和页码,先得到招标方的结构化要求。  右侧结果已经不是一段泛泛摘要,而是带来源的字段集合:打印速度至少 200 mm/s,分辨率至少 300 dpi,接口要求包含 USB、千兆以太网和 Wi-Fi 6,交付周期是合同生效后 15 个日历日,质保不少于 3 年,并且包含 4 小时响应、24 小时内给出处理方案的服务时限。 它还抽出了普通摘要容易漏掉的验收条件:支持 203 mm 外径纸卷、连续打印 500 张、断线重连后任务不丢失,以及安装 12 台设备并培训不少于 6 名仓库人员。每个条件都有来源页码,后面审查供应商时才有比较基准。 ## 第二轮:供应商 A 的表格先恢复,再谈符合性 A 的第二轮输入是响应文件 p1、p2 和 `供应商A_分项报价表_p1.pdf`。在自定义 Skill 的约束下,响应文件交给文档抽取 Agent,报价表交给表格识别 V3。结果页明确写出了两条调用路径,报价表还导出了可编辑的 Excel 文件。  A 的技术响应并不复杂,难的是把它和招标门槛放到同一张表里:打印速度 **250 mm/s**,分辨率 **300 dpi**,质保响应 **3 年**,这三项满足;**Wi-Fi 5 不等于 Wi-Fi 6,18 日也大于 15 日**。商务响应里还出现了 **48 小时**给出处理方案,而招标要求是 **24 小时**,不能因为付款比例一致就把商务部分判成“无偏差”。 报价表识别结果保留了三行明细:TL-3000 共 12 台,含税小计 168,000 元;PH-TL3000 共 12 件,含税小计 18,960 元;服务包-A 为 8,000 元;**合计 194,960 元**。更值得注意的是,响应表写了整机 3 年质保,但报价表里的备用打印头和安装培训只写了 1 年。这个问题不能直接判定为不满足,也不能忽略,正确状态是 **“待确认”**。 ## 第三轮:供应商 B 证明了为什么要保留原始值 B 的输入同样是两个响应页和一份单页报价表。这里我在提示语中特别加了一句:不要直接采信供应商填写的“满足/不满足”,同时保留供应商自评和基于招标门槛的独立核对。  B 的 **203 dpi 小于 300 dpi,1 年质保小于 3 年**,这两项硬性偏差没有争议;12 日交付则相反,**`12 <= 15**`******,数值上满足**。WorkBuddy 还指出 B 的响应文件报价摘要是 **178,960 元**,而独立报价表合计是 **175,000.04 元**,两份文件里的备用打印头和安装培训金额也不一致。 当我用完全相同的文件和要求重复运行时,WorkBuddy 直接复用了已经生成的 B 结果,避免再次消耗 OCR 调用。这个机制适合日常处理,但做性能测试时要新建会话并确认调用记录,不能把缓存命中算成一次新的接口执行。 ## 最终审查:四个文件和一次复核 完整审查把 **8 个逐页文件**一次性交给 WorkBuddy,要求先抽取招标门槛,再比较两家响应,最后核对报价明细。结果生成了四个可以继续流转的文件:**30 项符合性矩阵、分级风险清单、报价对比 CSV 和一页审查摘要**。  首轮汇总统计为 **满足 11 项、不满足 8 项、缺失 3 项、待确认 8 项**。A 的核心问题是无线网络、交付周期和服务响应时限;B 的核心问题是分辨率、质保期限、服务响应时限和报价文件冲突。WorkBuddy 没有把 B 的低价直接写成推荐,而是把 **“硬性不满足”** 和 **“需要澄清”** 分开交付,采购人员可以先处理影响资格的偏差,再处理材料补正和金额确认。 报价对比表保留了原始小数:B 的第一行单价是 **12,666.67 元**,小计是 **152,000.04 元**,三行相加得到 **175,000.04 元**。金额没有被格式化成整数,也没有用响应文件里的 **178,960 元**覆盖独立报价表。对于采购审查来说,这种可追溯的原始行比一句“B 报价更低”有用得多。 ## 最后一轮复核:把模型的判断拉回规则 我没有把完整审查的摘要当成最终结论,而是再发起一次只针对 7 个边界项的复核,要求逐项输出“招标要求|响应值|比较表达式|判定|证据文件及页码”。这一步把结论重新落到数字和原文上。  最终复核给出了清晰的结果:A 的 **Wi-Fi 5、18 日交付和 48 小时处理方案均不满足**;B 的 **203 dpi、1 年质保和 48 小时处理方案不满足**;B 的 **12 日交付满足**;B 未提交同类项目证明属于 **缺失**。结果中还保留了一个谨慎的提示:招标文本抽取结果只明确出现“类似项目说明”,是否严格要求“至少 2 个”的数量,仍应由采购人员回看完整招标文件确认。 这一步把流程的责任边界定得很清楚:它能把容易看错的数值重新算一遍,也能把两个文件的矛盾挑出来,但不会把“缺失”和“不满足”混成同一类,更不会替采购人员完成最终定标。 ## 这一套 Skill 最终达到了什么效果 |原本的人工动作 |Skill 组合后的结果 | | --- | --- | |逐页查找招标门槛 |抽取为带文件名、页码的结构化要求 | |手工恢复无线报价表 |保留 9 个业务列、原始小数和合计行,并导出 Excel/CSV | |复制两家响应逐项比较 |自动生成 30 项符合性矩阵,区分满足、不满足、缺失、待确认| |人工核算金额和查找矛盾|识别 178,960 与 175,000.04 的跨文件冲突 | |照着供应商自评录入结论|按门槛重新计算,将 B 的 12 日交付纠正为 满足 | |汇总评审材料 |一次生成矩阵、风险清单、报价对比、评审摘要 4 个交付物 | 采购人员留下来的工作更聚焦:确认质保口径、判断缺失材料能否补正、决定冲突报价以哪份文件为准,以及复核硬性偏差的处理方式。实时文档抽取对 PDF 页输入仍有约束,长文件需要拆页;免费额度也不是无限调用。涉及合同效力、盖章真实性、报价有效性和最终定标时,仍应回到原文和制度完成签字确认。 ## 结语 这次从空白 WorkBuddy 会话开始,整个过程没有要求我先弄清密钥获取、OCR 开通、环境变量加载或 Skill 开发。遇到不清楚的地方就直接问,遇到失败就让 WorkBuddy 检查当前状态;它给出入口、定位原因、完成本地修复,再把两个腾讯云 OCR Skill 组织成投标审查流程。最终,**8 份文件进入 WorkBuddy,输出 4 个可继续流转的评审文件**,每个关键判断都能回到原文、数字和证据。 对于采购、合同、验收和供应商准入这类材料密集型工作,我更愿意**把 WorkBuddy 当成流程编排台**,**把专业 Skill 当成可验证的工具节点**。模型可以快,输出可以自动生成,但最后一行结论仍然应该能回答三个问题:依据哪条要求,读到了哪个响应值,证据在文件第几页。