NVIDIA开源LocateAnything-3B深度解读,比Qwen3-VL快10倍,最强3B视觉定位大模型来了,真的“找对”了吗?
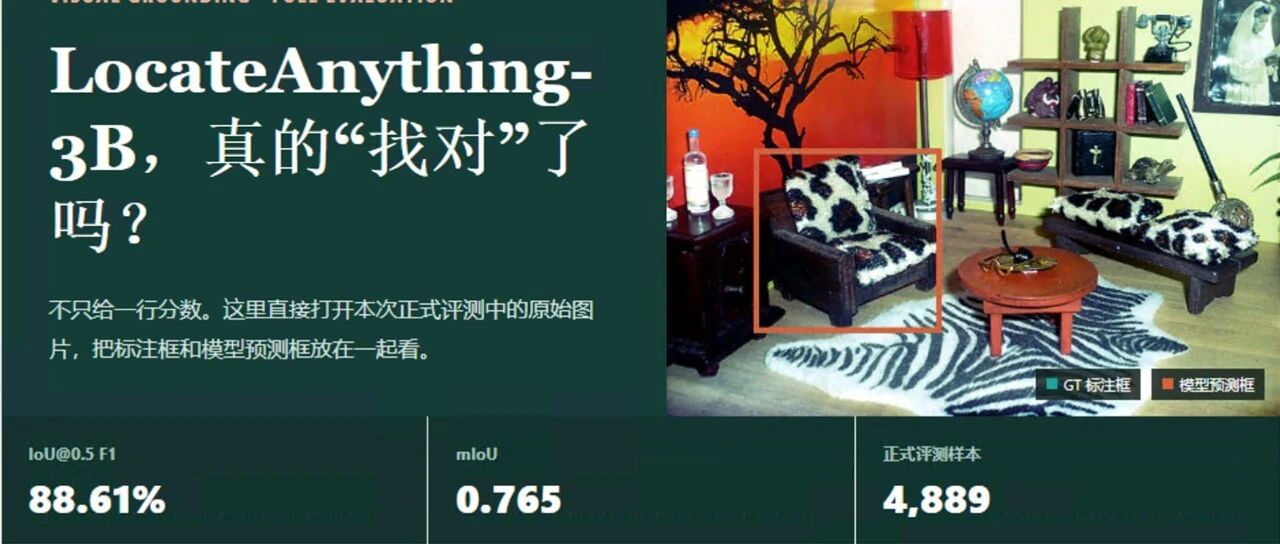
 在固定的官方模型、数据快照、推理与评分实现下,LocateAnything-3B 在 RefCOCOg validation 的 4,889 条指代表达上取得**88.6071% 的 IoU@0.5 F1**。但一张真实测试图比单个数字更有解释力:上图的目标是“带斑点坐垫的扶手椅”,GT 与预测的 IoU 为**0.9959**。 # 先看它到底找到了什么 视觉定位不是“图里有没有椅子”的分类题。输入是一句有指向性的描述,输出必须在图上落到正确对象的边界。以下三张都来自本次 4,889 条正式预测,原图未裁剪替换;青绿色框为数据集 GT,橙红色框为模型输出。  **图例:**GT 框来自 RefCOCOg 标注,预测框来自本次 NVIDIA 官方推理脚本输出。两种框相邻或重叠时,橙红和青绿色边缘会同时可见。 # 同一张图,换一句话就换一个目标 这是视觉定位和通用目标检测的区别:图像不变,指代改变,模型必须把框移动到新对象。下面是同一张正式测试原图的四条真实查询,点击右侧表达可切换 GT、预测框和对应 IoU。  **坐在沙发前的女孩** 原始 query:a girl sitting the sofa front of the table is cooldrinks GT 与预测框 IoU:**0.9696** **真实记录:**以上四组 query、GT、预测框和 IoU 分别对应全量结果的第 432、442、443、446 条(从 0 开始计数)。 # 好的结果之外,也要看失误 只展示高分样例会让结果失真。下面三个例子同样来自正式评测输出:一个刚好低于 IoU@0.5,两个更明显地暴露了定位模型的常见失误  # 回到全量成绩:不是只看一条线  # IoU 阈值越严,模型还能保住多少分? 官方 F1 逐阈值输出。所有点来自同一份 4,889 条预测,不是随机抽样。  # 全量 IoU 分布:高分并非偶然 下列分段由合并后的 4,889 条 GT 与预测框坐标直接计算,属于本地分析视图。官方主评分仍以other_metric.py的阈值结果为准。  # 完整官方阈值谱 |IoU 阈值|Precision|Recall|F1|达标预测| | --- | --- | --- | --- | --- | |0.50|88.6071%|88.6071%|88.6071%|4,332 / 4,889| |0.55|87.5435%|87.5435%|87.5435%|4,280 / 4,889| |0.60|86.1526%|86.1526%|86.1526%|4,212 / 4,889| |0.65|84.5163%|84.5163%|84.5163%|4,132 / 4,889| |0.70|82.7572%|82.7572%|82.7572%|4,046 / 4,889| |0.75|80.4254%|80.4254%|80.4254%|3,932 / 4,889| |0.80|77.6437%|77.6437%|77.6437%|3,796 / 4,889| |0.85|72.7347%|72.7347%|72.7347%|3,556 / 4,889| |0.90|64.1440%|64.1440%|64.1440%|3,136 / 4,889| |0.95|39.9877%|39.9877%|39.9877%|1,955 / 4,889| # 这次评测如何完成 # 01 / 固定输入 ## 锁定模型与数据 模型、评测数据均使用固定 revision。4,889 条查询覆盖 1,300 张 COCO train2014 图像,检查结果为零缺图。 # 02 / 13 个可恢复分片 ## 逐片推理与校验 前 12 片各 400 条,最后一片 89 条;每片均检查进程结束状态、输出行数和 JSON 可解析性。 # 03 / 官方脚本评分 ## 原序合并再计算 按数值顺序合并后,逐条核验数据集、任务、图像路径和 GT,4,889 条零错位,再交由 NVIDIA 指标脚本评分。