本文是 55873 生态系统技术白皮书第 4 篇 —— 双层安全风控架构。完整拆解我们在生产环境中落地 Rust 底层硬拦截 + Qwen3Guard AI 多语言语义研判的双层架构设计,包括踩过的坑、公开基准数据、以及诚实披露的能力边界。
导读
一、为什么我们要搞双层安全?
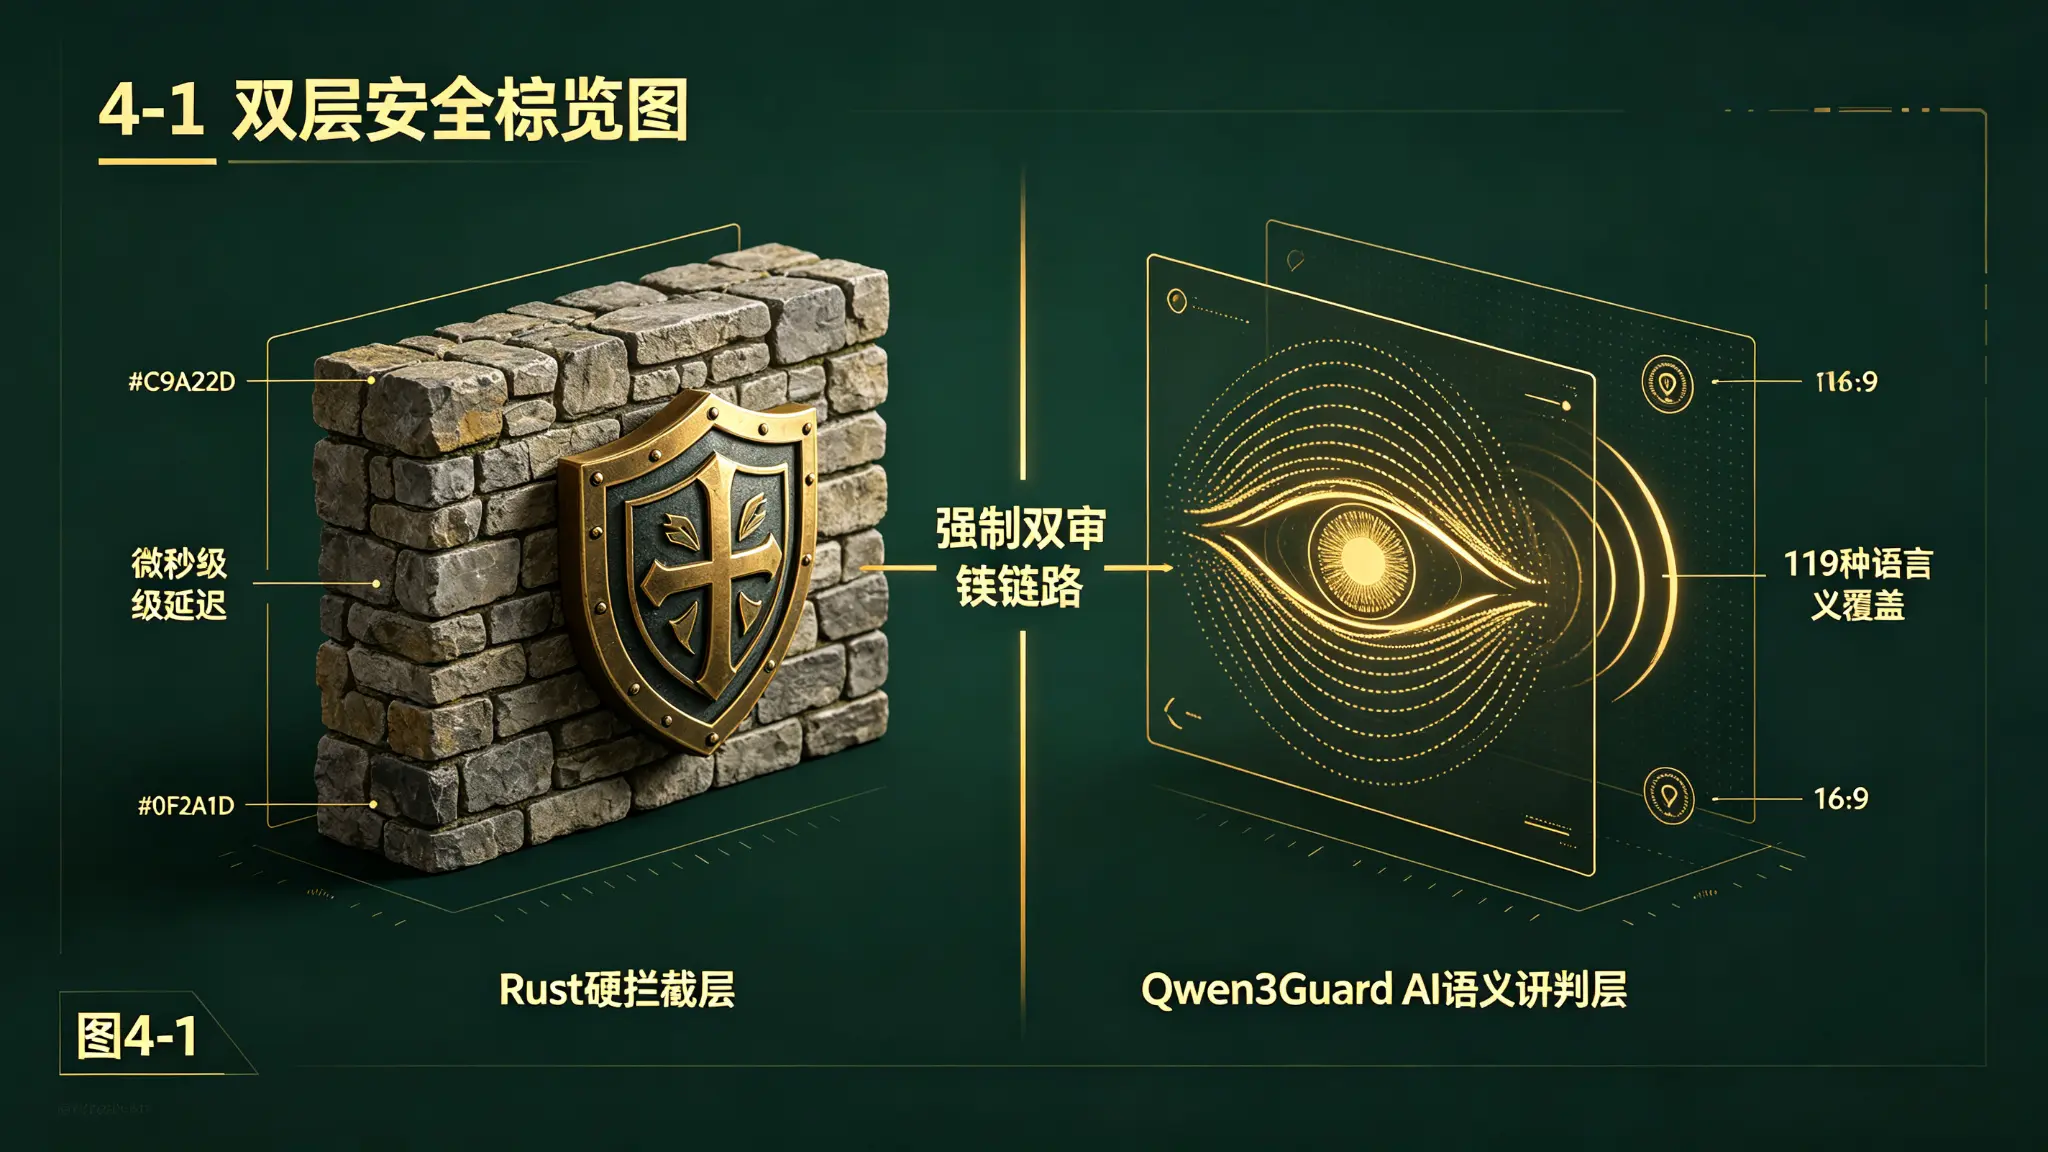
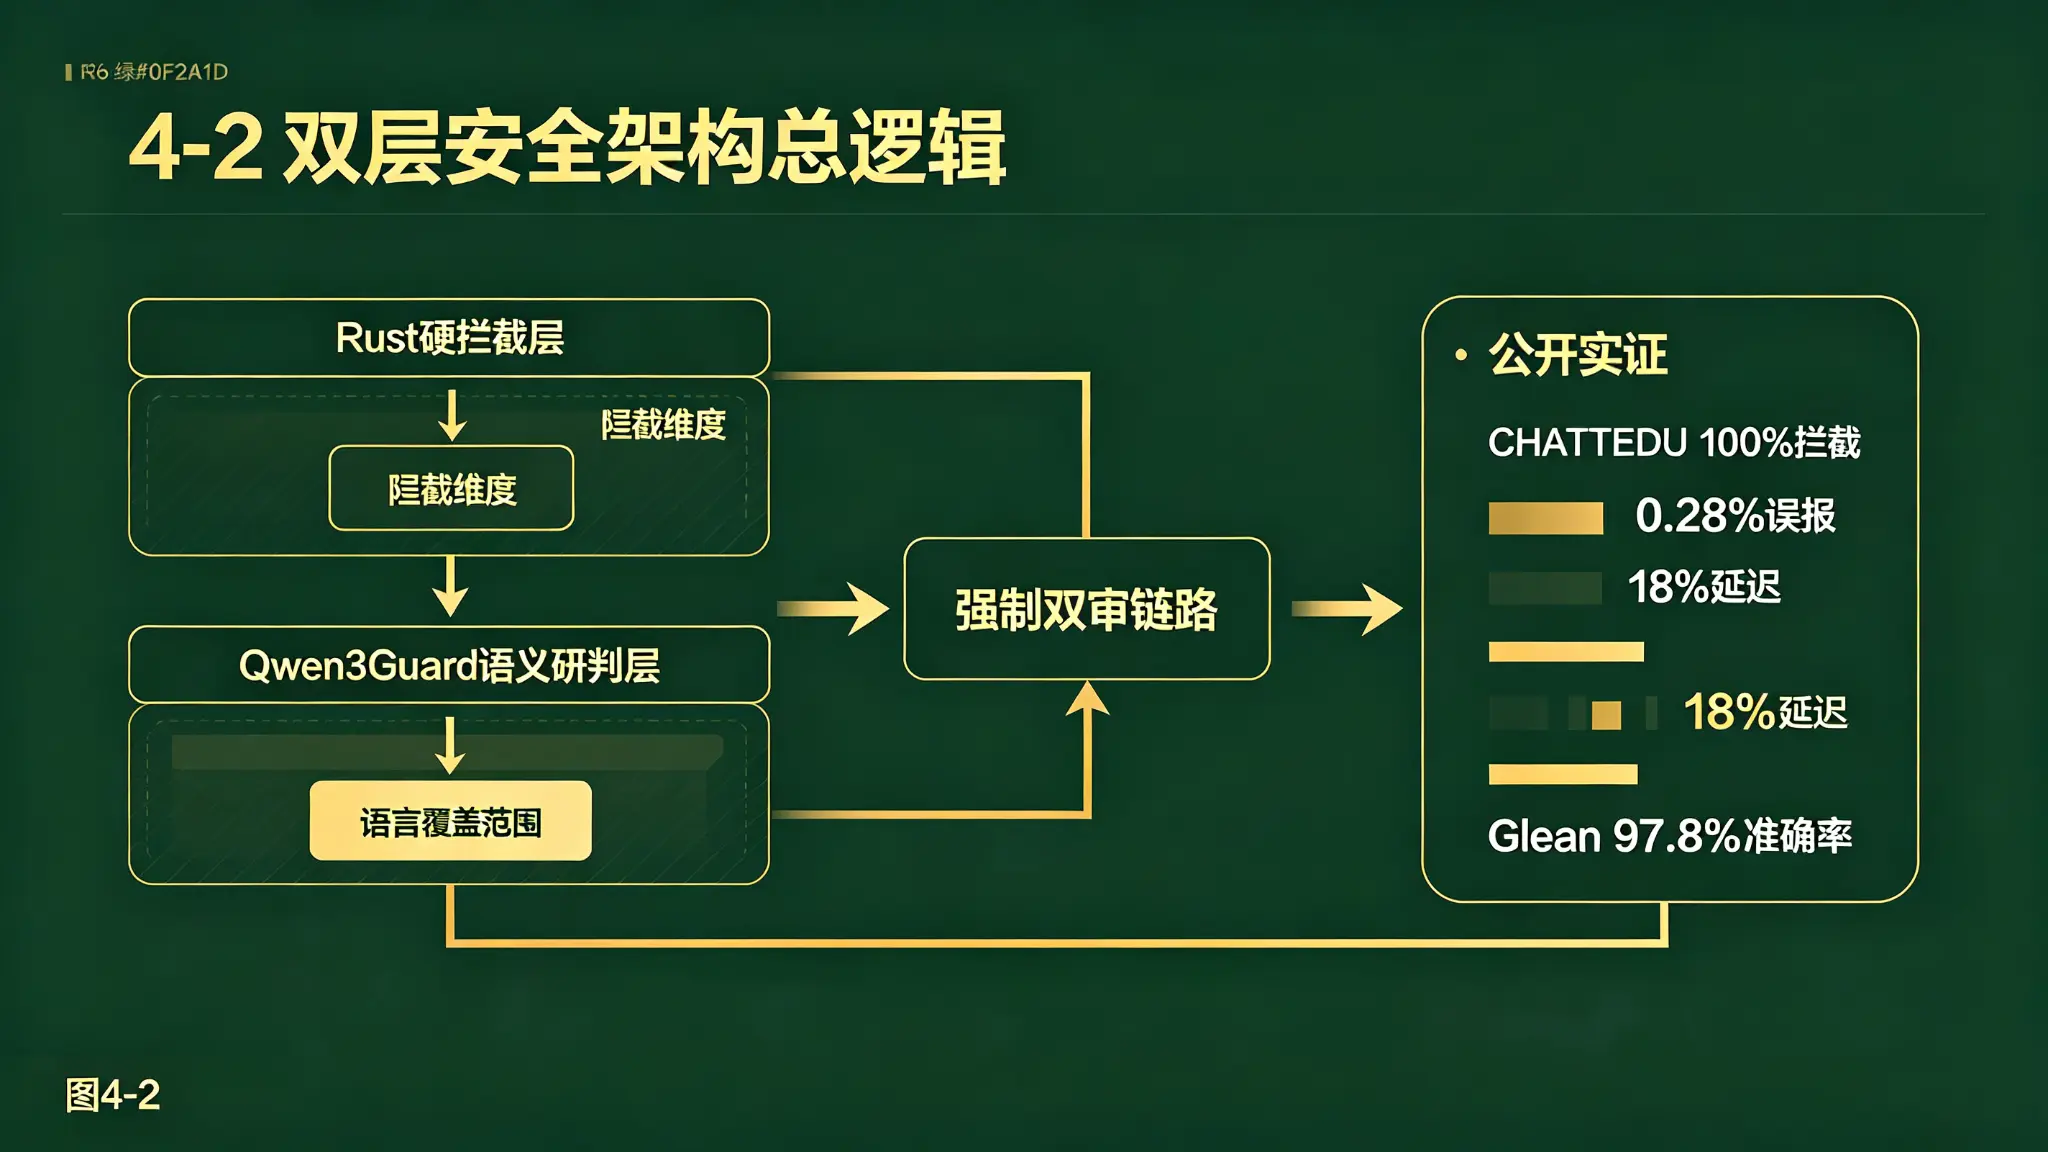
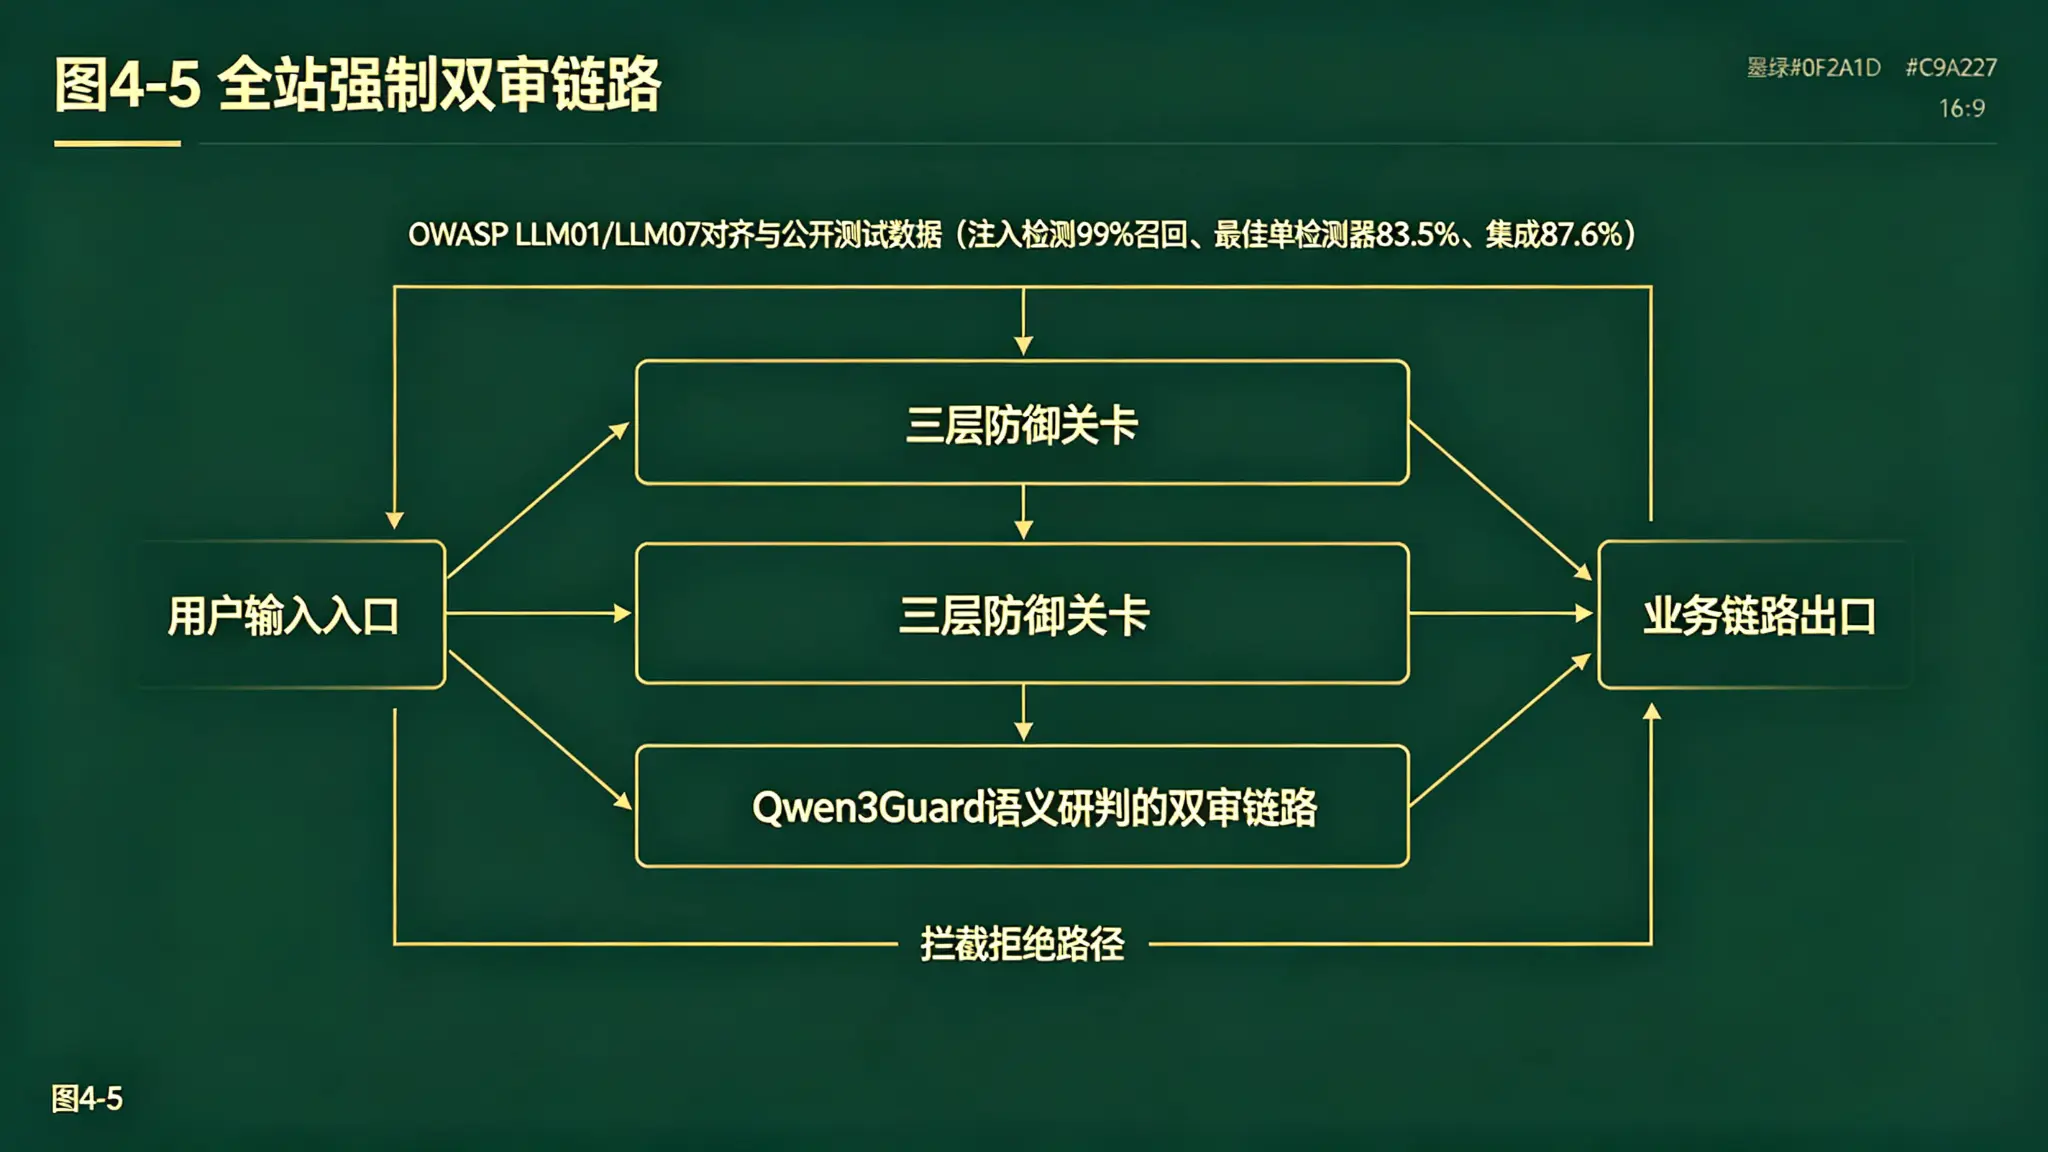
55873 安全风控采用 Rust 底层机器级硬拦截 + Qwen3Guard AI 多语言语义研判 的双层架构。
第一层:Rust 底层硬拦截
\\\  编译型底层引擎,在请求进入业务链路之前完成显性违规内容的强制拦截
\\\  覆盖:关键词过滤、违规字符检测、恶意格式拦截、脚本注入阻断、垃圾内容过滤
第二层:Qwen3Guard AI 语义研判
\\\  基于通义千问 Qwen3 基础架构专项微调的安全护栏模型
\\\  覆盖:隐性违规、诱导话术、多轮越狱、多语种隐蔽违规
核心设计原则
|
原则
|
说明
|
|
强制双审
|
所有用户输入必须完整经过两层审核,不存在白名单、免审接口或绕过通道
|
|
分层隔离
|
Rust 层与 AI 层独立部署,单层故障不扩散,有明确降级策略
|
|
可量化验证
|
每层均有明确的延迟、准确率、误拦率、越狱通过率指标,并引用公开基准
|
|
多语言全覆盖
|
Qwen3Guard 支持 119 种语言及方言,覆盖 55873 七国语言体系
|
|
诚实披露边界
|
对 Qwen3Guard 在轨迹级风险检测上的结构性短板进行量化披露,并有明确的补偿方案
|
双层架构公开实证数据
|
数据源
|
关键指标
|
说明
|
|
ChatTEDU (IEEE Access 2025)
|
100% 拦截,0.28% 误报,18% 延迟开销
|
4,501 条真实交互,180 条恶意尝试
|
|
Glean 双模型架构
|
97.8% 准确率
|
越狱检测准确率高于单模型方案
|
|
NeurIPS 2024 论文
|
双层级架构有效性验证
|
外部评判层发现模型内部安全系统错误标记为 "安全" 的违规内容
|
二、Rust 底层安全:我们为什么选 Rust?
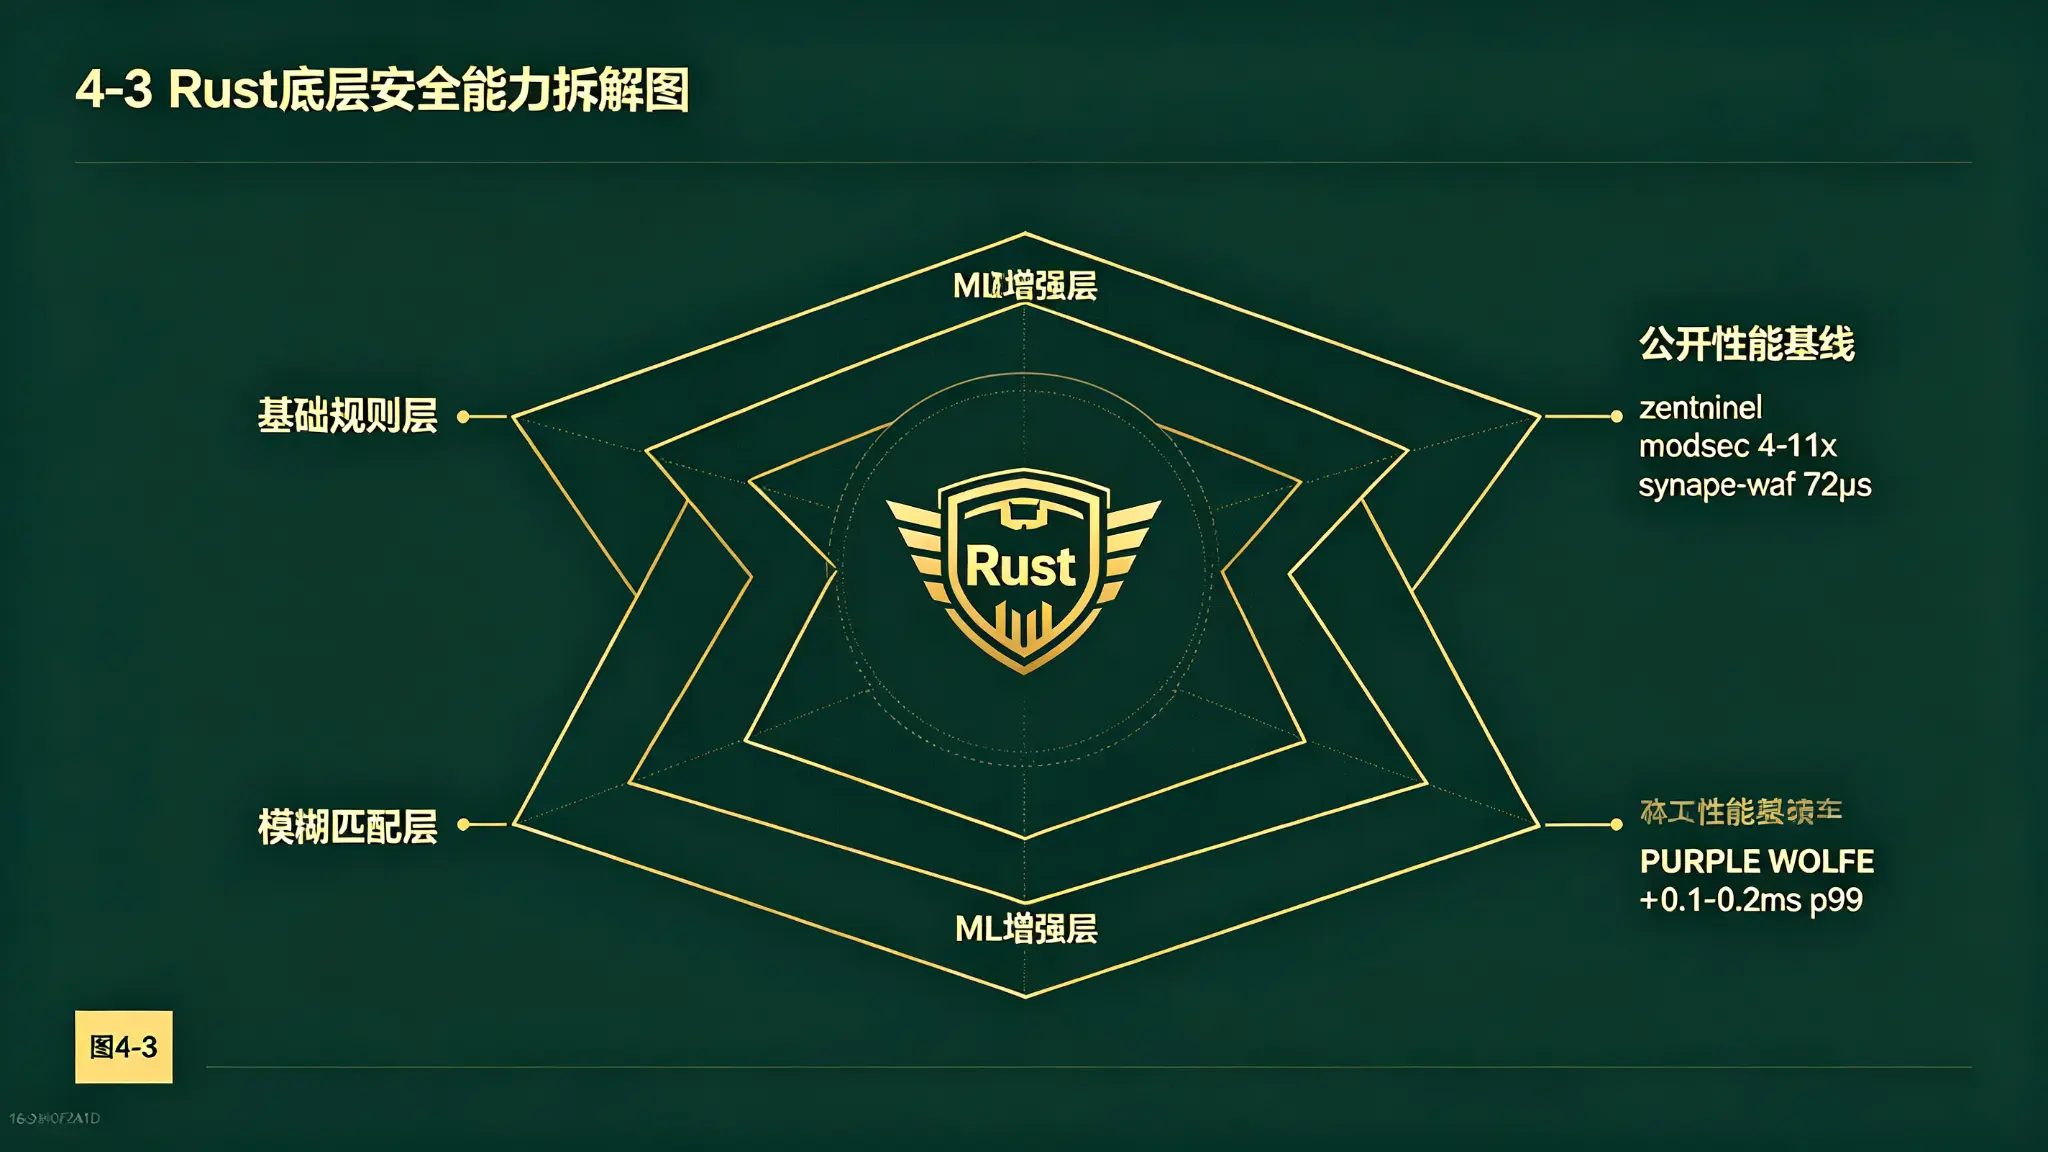
rust_security_engine 使用 Rust 语言开发,利用其编译期内存安全保证与零成本抽象特性,构建高吞吐、低延迟的底层安全过滤层。
三层防御架构
基础规则层:纯 Rust 实现,微秒级扫描
\\\  覆盖:prompt 注入、角色覆盖、密钥泄露、PII、IDN 同形异义、隐形文本、Markdown 走私
\\\  默认部署
模糊匹配层:trigram 包含检测,微秒级延迟
\\\  用于识别改写/释义类攻击
\\\  可选启用
ML 增强层:ONNX 分类器,CPU P99 约 3-10ms
\\\  用于检测改写攻击或新型攻击
\\\  按业务场景选择性启用
公开性能基线(zentinel-modsec 修正后基准)
|
基准项
|
Rust
|
C++
|
加速比
|
|
干净请求处理
|
1.34 µs
|
5.65 µs
|
4.2x
|
|
SQLi 检测
|
1.40 µs
|
16.03 µs
|
11.5x
|
|
请求体处理
|
1.45 µs
|
12.91 µs
|
8.9x
|
|
复杂规则解析
|
2.73 µs
|
10.58 µs
|
3.9x
|
|
干净请求吞吐
|
676K req/s
|
168K req/s
|
4.0x
|
|
攻击请求吞吐
|
701K req/s
|
62K req/s
|
11.3x
|
⚠️
重要说明
:zentinel-modsec 团队公开纠正了此前夸大的基准数据 —— 原先报告的 "10–30x" 和 "6.2M req/s" 源于规则阶段未在 Rust 侧执行的测量错误。修正后数据为 4–11x。我们以修正后数据为稳健基线,别被网上吹得天花乱坠的数据忽悠了。
设计目标
|
指标
|
目标值
|
说明
|
|
P99 过滤延迟
|
≤ 1ms
|
含规则层 + 可选模糊 / ML 层
|
|
单实例 QPS
|
≥ 50,000
|
纯规则层模式
|
|
拦截准确率
|
≥ 99%
|
针对已知攻击向量
|
|
误拦率
|
≤ 0.1%
|
针对正常业务请求
|
|
规则库热更新
|
不重启生效
|
支持动态规则加载
|
三、Qwen3Guard 语义研判:单轮 SOTA,但轨迹级有短板
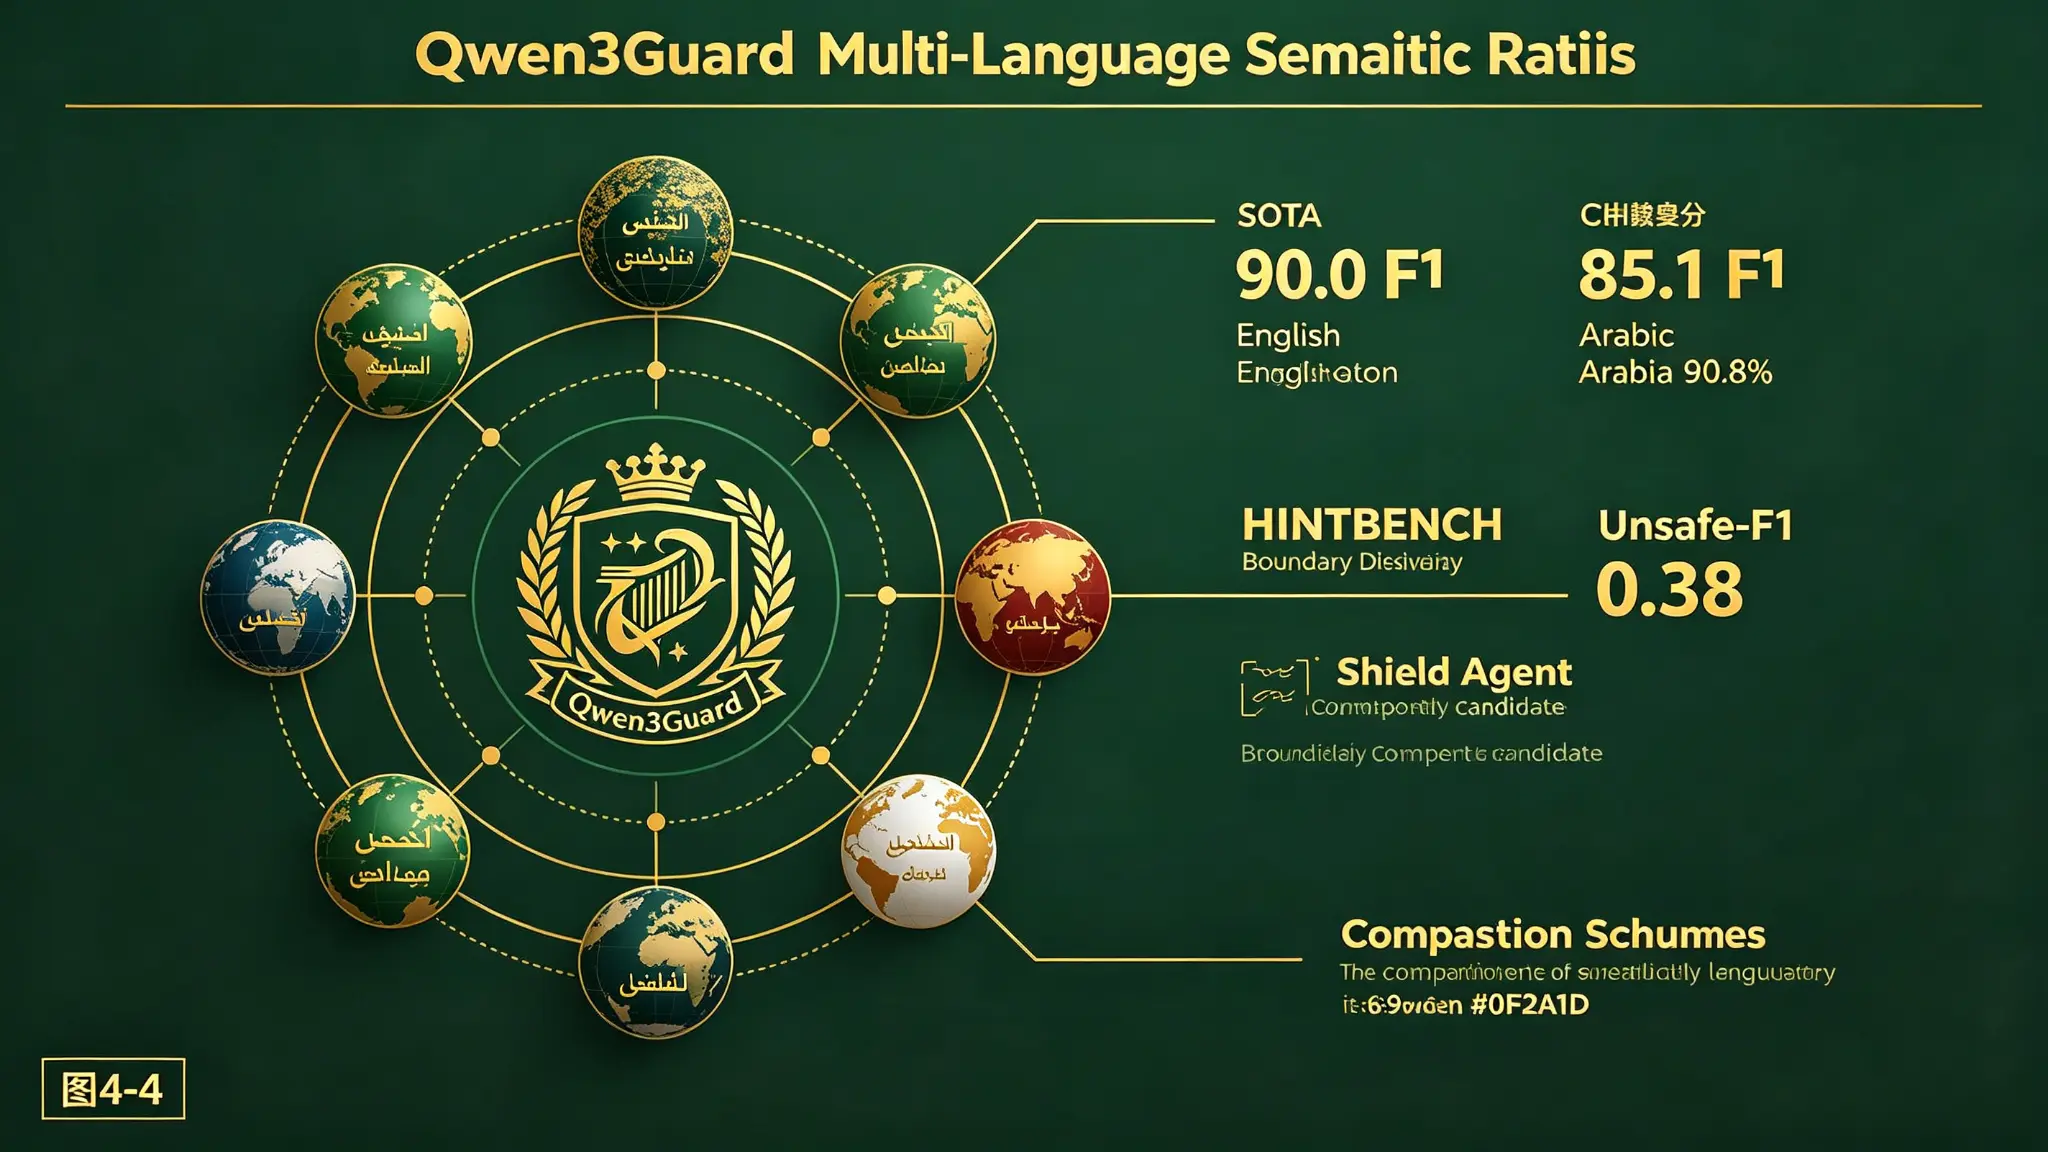
ai_judge_engine 依托 Qwen3Guard 多语言安全护栏模型。Qwen3Guard 基于 Qwen3-8B 骨干,在 119 种语言、119 万条 prompt-response 样本上进行微调,采用三分安全分类(safe /controversial/unsafe)。
单轮提示 / 回复分类的公开 SOTA 数据
|
基准
|
Qwen3Guard-8B
|
对比模型
|
领先幅度
|
|
英语提示分类 (Avg F1)
|
90.0
|
—
|
SOTA
|
|
中文提示分类 (Avg F1)
|
85.1
|
PolyGuard-Qwen-7B: 68.4
|
+16.7
|
|
中文回复分类 (Avg F1)
|
87.1
|
对比模型: 62.5
|
+24.6
|
|
阿拉伯语 SalamahBench
|
90.8%
|
Llama Guard 4: 83.3%
|
+7.5%
|
|
阿拉伯语 AraSafe
|
88.7%
|
Aya Expanse 32B: 91.0%
|
无显著差异
|
必须诚实披露的公开基准边界:多步轨迹风险检测短板
|
Guard 模型
|
Avg-F1
|
Acc
|
Safe-F1
|
Unsafe-F1
|
|
Qwen3Guard-8B
|
14.63
|
17.01
|
28.88
|
0.38
|
|
LlamaGuard3-8B
|
38.34
|
38.63
|
34.13
|
42.56
|
|
PolyGuard
|
36.45
|
36.72
|
32.31
|
40.60
|
|
ShieldGemma-9B
|
28.09
|
28.30
|
31.98
|
24.20
|
|
ShieldAgent
|
65.49
|
86.01
|
38.89
|
92.10
|
|
AgentDog-Qwen-7B
|
47.60
|
80.45
|
6.11
|
80.09
|
⚠️
关键发现
:Qwen3Guard-8B 的 Unsafe-F1 仅为 0.38,意味着它几乎无法识别轨迹级的不安全内容。
补偿方案
model\\\\\\\_eval 轨迹级审计:使用 HINTBench 标准化基准对私有化模型进行轨迹级安全评测
组合架构:在涉及多步任务执行的场景中,Qwen3Guard 负责单轮分类
\\\  额外部署 ShieldAgent 类模型形成互补
强制双审兜底:Rust 硬拦截层对轨迹中的每一步独立执行硬性规则校验
\\\  形成"逐步骤硬拦截 + 整体语义研判"的纵深防御
四、全站强制过审:没有白名单,没有免审接口
过审链路
用户输入 → business\\\\\\\_scheduler 接收 → rust\\\\\\\_security 三层防御 → 通过
\\\  → ai\\\\\\\_judge Qwen3Guard 语义研判 → 通过 → 进入业务链路
任一层拦截 → 返回安全拒绝
OWASP LLM Top 10 对齐与公开测试数据
|
测试项
|
公开结果
|
来源
|
|
Prompt Injection 排名
|
#1(2025,自 2023 起不变)
|
OWASP LLM Top 10
|
|
注入检测召回率
|
97.0%(32/33)
|
公开 WAF 记分卡
|
|
注入检测精确率
|
97.0%
|
同上
|
|
注入检测误报率
|
2.3%(1/44)
|
同上
|
|
最佳单检测器准确率
|
83.5%
|
公开评估
|
|
集成检测(多数投票)准确率
|
87.6%
|
公开评估
|
|
Llama 3.1 8B 攻击成功率
|
64–76%
|
garak 红队测试
|
💡
关键发现
:公开评估表明,无单一 prompt 注入检测器超过 83.5%,集成检测(多数投票)达到 87.6%。55873 的双层架构本质上是一种异构集成检测 ——Rust 规则层 + Qwen3Guard 语义层,两层采用完全不同的检测机制,互补性高于同构模型的多数投票集成。
五、防越狱、防注入、防滥用:我们踩过的坑
1. Prompt 注入防护
直接注入防护:对用户输入做预处理、边界校验,阻止用户篡改模型指令
间接注入防护:所有内容(文档、网页、工具输出、检索段落)视为潜在对抗性内容
\\\  在进入模型上下文前进行分隔、剥离或标记
最小权限原则:模型权限限定在功能所需的最小范围
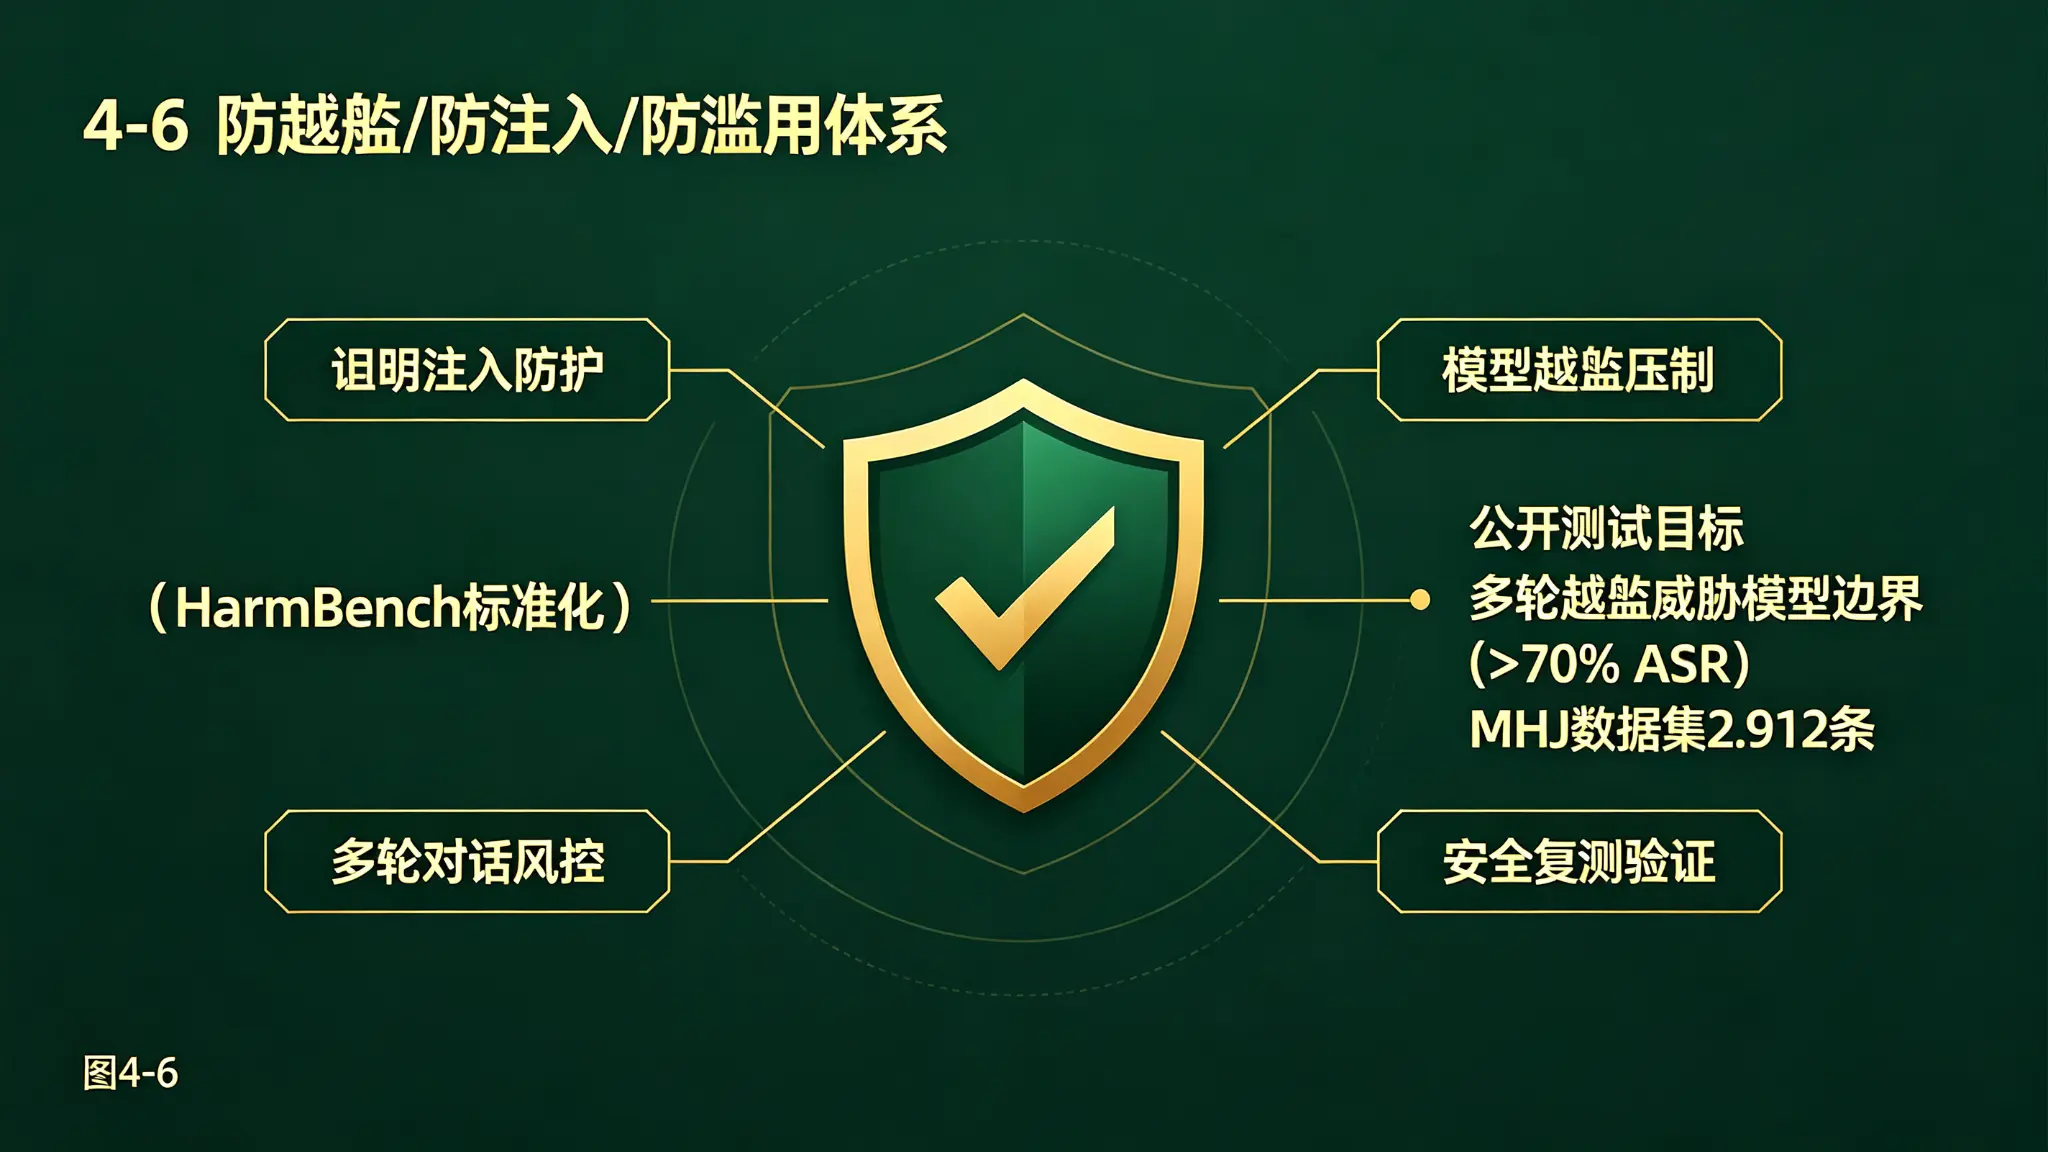
2. 模型越狱压制
-
Qwen3Guard 识别越狱类提示词,阻断越权、违规输出
-
越狱测试集基于 HarmBench 标准化协议(UC Berkeley、Google DeepMind 与 Center for AI Safety 联合发布,覆盖 400+ 种有害行为)
-
多轮对话风控:持续跟踪多轮上下文,识别逐步诱导类违规
3. 多轮越狱:必须披露的威胁模型边界
⚠️
55873 的会话级风险累积机制和多轮对话风控在设计上针对这一威胁,但需要在白皮书中明确标注 "多轮越狱" 作为持续监测中的威胁模型,并定期使用 HarmBench 多轮协议进行复测。
4. 安全复测与量化验证
|
测试类型
|
测试集
|
通过率目标
|
|
越狱检测
|
HarmBench(400+ 有害行为,标准化协议)
|
≥ 95%
|
|
Prompt 注入阻断
|
OWASP 注入载荷集、Garak
|
≥ 98%
|
|
多语言安全
|
七国语言逐语种测试集
|
各语种 ≥ 95%
|
|
阿拉伯语专项
|
SalamahBench + AraSafe + Arabizi 专项
|
MSA ≥ 90%,Arabizi 单独标注
|
|
多步轨迹风险
|
HINTBench 标准化基准
|
轨迹级 Avg-F1 单独报告
|
|
多轮人工越狱
|
HarmBench 多轮协议 / MHJ 数据集
|
持续监测,单独报告 ASR
|
六、行业对比与合规映射
行业优势
市面上绝大多数 AI 平台只依赖单一 AI 大模型做内容审核,缺少底层关键词硬拦截。55873 采用 Rust 底层硬防御(完整生命周期 4–11 倍吞吐优势)+ Qwen3Guard AI 语义软防御(119 种语言,单轮分类 SOTA)的双层闭环。
公开评估数据显示,无单一 prompt 注入检测器超过 83.5%,集成检测达到 87.6%。55873 的双层架构是异构集成检测 ——Rust 规则层与 Qwen3Guard 语义层采用完全不同的检测机制,互补性高于同构模型集成。
同时,55873 诚实披露 Qwen3Guard 在 HINTBench 轨迹级风险检测上的量化短板(Unsafe-F1 0.38),并设计 model_eval 轨迹级审计、ShieldAgent 类模型组合架构、强制双审兜底三项补偿方案。
合规映射
|
法规 / 标准
|
相关条款
|
55873 对齐措施
|
|
OWASP LLM Top 10 (2025)
|
LLM01 Prompt Injection
|
强制双审,trusted/untrusted 结构性分离
|
|
OWASP LLM Top 10 (2025)
|
LLM07 System Prompt Leakage
|
输入预处理,边界校验,系统提示词版本管理
|
|
等保 2.0 三级
|
安全审计日志保存不少于 180 天
|
审计日志独立留存,防篡改、可追溯
|
|
NIST AI RMF 1.0
|
Govern / Map / Measure / Manage
|
双层风控纳入 AI 风险管理框架
|
|
EU AI Act
|
高风险系统网络安全与鲁棒性要求
|
双层安全架构支撑稳健性与网络安全
|
|
生成式 AI 服务管理办法
|
内容安全审核
|
全站强制双审,无绕过通道
|
写在最后
双层风控是 55873 生态安全底座的核心。Rust 底层引擎以微秒级确定性延迟拦截显性风险,Qwen3Guard 以 119 种语言覆盖识别隐性语义风险,全站强制审核,从源头降低违规内容、提示注入、模型越狱带来的安全风险。
55873 在技术文档中引用公开测试数据,诚实披露 Qwen3Guard 在多步轨迹风险检测上的量化边界,并设计三项补偿方案。配合 6+1+3 混合模型体系、五引擎微内核架构、72 小时清理 + 永久存证双策略,双层安全风控为 18 个一级界面与 7 国语言生态提供可量化、可审计、可复现的安全保障。
👉 这是 55873 生态系统技术白皮书第 4 篇,后续将陆续发布更多专题。
觉得有收获的话,点个赞 + 收藏,不迷路 👇