首页 文章 精选 留言 我的

精选列表

搜索[notepad  ],共10025篇文章
优秀的个人博客,低调大师

SpringBoot 手写过滤器&加载第三方过滤器

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_36367789/article/details/81665638 如何手写一个过滤器呢。假设我现在需要一个计时过滤器,我想把每一次调用服务锁花费的时间打印到控制台,我该怎么做呢? 拦截机制有三种: 1. 过滤器(Filter)能拿到http请求,但是拿不到处理请求方法的信息。 2. 拦截器(Interceptor)既能拿到http请求信息,也能拿到处理请求方法的信息,但是拿不到方法的参数信息。 3. 切片(Aspect)能拿到方法的参数信息,但是拿不到http请求信息。 他们三个各有优缺点,需要根据自己的业务需求来选择最适合的拦截机制。 好了下面开始正文。 本教程大概目录: 1. 手写过滤器 2. 加载第三方过滤器 好了,开始正文。 1. 手写过滤器 特别容易,继承Filter ,然后根据需求重写它的三个方法。 /** * TimeFilter 计时过滤器 * Created by Fant.J. */ @Component public class TimeFilter implements Filter { @Override public void init(FilterConfig filterConfig) throws ServletException { System.out.println("time filter init"); } @Override public void doFilter(ServletRequest servletRequest, ServletResponse servletResponse, FilterChain filterChain) throws IOException, ServletException { System.out.println("time filter start"); long start = new Date().getTime(); filterChain.doFilter(servletRequest,servletResponse); System.out.println("耗时:"+(new Date().getTime() - start)); System.out.println("time filter finish"); } @Override public void destroy() { System.out.println("time filter destroy"); } } 其中 init方法是初始化方法,最先执行。 然后执行doFilter方法,熟悉servlet的应该都知道,它其实就是调用业务。 最后destroy方法,是最后执行的。 然后我们启动服务,随便调用一个controller,控制台打印如下: 2. 加载第三方过滤器 一般在开发的时候,我们可能用到第三方的过滤器,我们不可能在其源码上添加@Component注解。所以我们必须写一个配置类来引入它。 下面我们把上面的例子当作第三方过滤器,把TimeFilter类上面的@Component注解去掉。做一个模拟练习。 /** * 引入第三方过滤器 将其放入spring容器 * Created by Fant.J. */ @Configuration public class WebConfig { @Bean public FilterRegistrationBean timeFilter(){ //创建 过滤器注册bean FilterRegistrationBean registrationBean = new FilterRegistrationBean(); TimeFilter timeFilter = new TimeFilter(); registrationBean.setFilter(timeFilter); List urls = new ArrayList(); urls.add("/*"); //给所有请求加过滤器 //设置 有效url registrationBean.setUrlPatterns(urls); return registrationBean; } } 注意一定要去掉TimeFilter类上面的@Component注解,否则过滤器会失效。 介绍下我的所有文集: 流行框架 SpringCloud springboot nginx redis 底层实现原理: Java NIO教程 Java reflection 反射详解 Java并发学习笔录 Java Servlet教程 jdbc组件详解 Java NIO教程 Java语言/版本 研究

优秀的个人博客,低调大师

php防止sql注入漏洞代码 && 几种常见攻击的正则表达式

注入漏洞代码和分析 先上代码 sql 分析 如果使用这个函数的话,这个函数会绕开PHP的标准出错处理,所以说得自己定义报错处理程序(die())。 其次,如果代码执行前就发生了错误,那个时候用户自定义的程序还没有执行,所以就不会用到用户自己写的报错处理程序。 那么,PHP里有一套错误处理机制,可以使用set_error_handler()接管PHP错误处理,也可以使用trigger_error()函数主动抛出一个错误。 set_error_handler()函数设置用户自定义的错误处理函数。函数用于创建运行期间的用户自己的错误处理方法。它需要先创建一个错误处理函数,然后设置错误级别。 关于的用法: 1 function customError($errno, $errstr, $errfile, $errline) 2 3 { 4 5 echo "<b>错误代码:</b> [${errno}] ${errstr}\r\n"; 6 7 echo " 错误所在的代码行: {$errline} 文件{$errfile}\r\n"; 8 9 echo " PHP版本 ",PHP_VERSION, "(" , PHP_OS, ")\r\n"; 10 11 // die(); 12 13 } 14 15 set_error_handler("customError",E_ALL| E_STRICT); 在这个函数里,可以做任何要做的事情,包括对错误的详情进行格式化输出,记入log文件。 1 function slog($logs) 2 { 3 $toppath="log.htm"; 4 $Ts=fopen($toppath,"a+"); 5 fputs($Ts,$logs."\r\n"); 6 fclose($Ts); 7 } 自定义的错误处理函数一定要有这四个输入变量$errno、$errstr、$errfile、$errline。 errno是一组常量,代表错误的等级,同时也有一组整数和其对应,但一般使用其字符串值表示,这样语义更好一点。比如E_WARNING,其二进制掩码为4,表示警告信息。 接下来,就是将这个函数作为回调参数传递给set_error_handler。这样就能接管PHP原生的错误处理函数了。要注意的是,这种托管方式并不能托管所有种类的错误,如E_ERROR、E_PARSE、E_CORE_ERROR、E_CORE_WARNING、E_COMPILE_ERROR、E_COMPILE_WARNING,以及E_STRICT中的部分。这些错误会以最原始的方式显示,或者不显示。 StopAttack()函数是将传递过来的POST、GET、COOKIE进行正则表达式和调用slog()写入log文件。 几种常见攻击的正则表达式 1 $Exec_Commond = "( \\s|\\S)*(exec(\\s|\\+)+(s|x)p\\w+)(\\s|\\S)*"; 2 $Simple_XSS = "( \\s|\\S)*((%3C)|<)((%2F)|/)*[a-z0-9%]+((%3E)|>)(\\s|\\S)*"; 3 $Eval_XSS = "( \\s|\\S)*((%65)|e)(\\s)*((%76)|v)(\\s)*((%61)|a)(\\s)*((%6C)|l)(\\s|\\S)*"; 4 $Image_XSS = "( \\s|\\S)*((%3C)|<)((%69)|i|I|(%49))((%6D)|m|M|(%4D))((%67)|g|G|(%47))[^\\n]+((%3E)|>)(\\s|\\S)*" ; 5 $Script_XSS = "( \\s|\\S)*((%73)|s)(\\s)*((%63)|c)(\\s)*((%72)|r)(\\s)*((%69)|i)(\\s)*((%70)|p)(\\s)*((%74)|t)(\\s|\\S)*"; 6 $SQL_Injection = "( \\s|\\S)*((%27)|(')|(%3D)|(=)|(/)|(%2F)|(\")|((%22)|(-|%2D){2})|(%23)|(%3B)|(;))+(\\s|\\S)*"; 总结 PHP遇到错误时,就会给出出错脚本的位置、行数和原因,有很多人说,这并没有什么大不了。但泄露了实际路径的后果是不堪设想的,对于某些入侵者,这个信息可是非常重要,而事实上现在有很多的服务器都存在这个问题。 有些网管干脆把PHP配置文件中的 display_errors 设置为 Off 来解决,但本人认为这个方法过于消极。有些时候,我们的确需要PHP返回错误的信息以便调试。而且在出错时也可能需要给用户一个交待,甚至导航到另一页面。但是有了 set_error_handler()之后,这些矛盾也都可以解决掉了。 但是发现很少用这个函数。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3496855.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Elasticsearch hadoop使用示例 &amp; 运维实战之集群规划 &amp;presto-elasticsearch connecto...

elasticsearch-hadoop使用示例 在elasticsearch-hadoop的具体使用中碰到了几个问题,有必要记录一下,避免下次遇到时又要重新研究。 利用spark读取es数据源的简单示例 import org.elasticsearch.spark.sql._ val esOptions = Map("es.nodes"->"192.168.1.2,192.168.1.3", "es.scroll.size"->"1000", "es.field.read.as.array.include"->"SampleField") val esDF = sqlContext.read.format("org.elasticsearch.spark.sql").options(esOptions).load("sampleindex/es-spark") esDF.registerTempTable("esdemotbl") es.scroll.size一次性读入的记录数,默认是10, 如果不设置为大一点的值,要从es中读取1亿条数据,那将是一个漫长的过程 es.field.read.as.array.include有的字段在es中是以string类型存储,但其中包含逗号(,), spark默认认为这是数组类型,如果读取这种字段的话,就会报错,怎么办,那就用es.field.read.as.array.include来显式指明 spark读取es中数据的时候,partition数目取决于es中指定index的shard数目,为了获得比较高的并发读取性能,建议适当设置shard数目,为什么是适当,因为具体取决于集群规模等多种因素。 字段名的大小写问题 在hive中,字段名是_大小写不敏感_的, 但在ES中是大小写敏感的 你说,这又怎么样。 呵呵, 这意味着不做特殊处理,永远无法读出es中大写字段名的内容,你看到的将是满屏的_NULL_ 这该怎么破,很简单,指定es.mapping.names 比如在es中,字段名为DemoField, 要读出其中的内容,hive表的字义就该这样写 create external table es_demo_tbl( demofield string) STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler' TBLPROPERTIES('es.nodes'='192.168.1.2,192.168.1.3', 'es.resource'='demoindex/sample', 'es.mapping.names'='demofield:DemoField') 注意是先hive中的字段名,然后是es中的字段名 Elasticsearch 运维实战之集群规划 规划一个可用于生产环境的elasticsearch集群。 集群节点划分 整个集群的节点分为以下三种主要类型 Master nodes -- 负责维护集群状态,不保存index数据, 硬件要求: 一般性的机器就可以,给es进程分配16g内存 Data Nodes -- 只保存index的数据,不被选举为Master nodes 硬件要求: 配置要求越高越好,使用大硬盘,有条件可以上SSD硬盘 Client Nodes -- 主要用于负载均衡,不被选举为Master node, 也不保存index数据 硬件要求: 24核CPU, 64G内存或更高 一个合理的集群应该包含三个master nodes, 1到多个data nodes, 最少一个client node 安装与配置 通用配置,以centos为例,使用rpm安装包 sudo rpm -ivh elasticsearch-version.rpm sudo chkconfig --add elasticsearch 修改/etc/sysconfig/elasticsearch, 修改ES_HEAP_SIZE和JAVA_OPTS的内容,注意elasticsearch建议使用的最大内存是32G, ES_HEAP_SIZE=32g JAVA_OPTS="-Xms32g" 修改/etc/security/limits.conf, 添加如下内容 * hard memlock unlimited * soft memlock unlimited /etc/elasticsearch/elasticsearch.yml内容配置 master节点 node.master: true node.data: false discovery.zen.ping.unicast.hosts: ["master1","master2","master3"] network.host: ${HOSTNAME} data节点 node.master: false node.data: true discovery.zen.ping.unicast.hosts: ["master1","master2","master3"] network.host: ${HOSTNAME} 如果为elasticsearch配置了多块硬盘,可以修改DATA_DIR的值,多个目录使用逗号(,)分开 client节点 node.master: false node.data: false discovery.zen.ping.unicast.hosts: ["master1","master2","master3"] network.host: ${HOSTNAME} 启动elasticsearch sudo service elasticsearch start 需要注意的是elasticsearch在centos中使用service elasticsearch restart有时不能达到效果,需要分开来做 sudo kill -9 `pgrep -f elasticsearch` sudo service elasticsearch start nginx反向代理 为了记录针对集群的查询内容,建议使用nginx来做反向代理,nginx安装在client node上,conf.d/default.conf最简单的配置如下 upstream elasticsearch { server 127.0.0.1:9200; } server { gzip on; access_log /var/log/nginx/access.log combined; listen 80 default_server; server_name _; #charset koi8-r; #access_log logs/host.access.log main; # Load configuration files for the default server block. include /etc/nginx/default.d/*.conf; location / { root /usr/share/nginx/html; index index.html index.htm; proxy_set_header Host $http_host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header X-Forwarded-Proto $scheme; proxy_pass http://elasticsearch; } error_page 404 /404.html; location = /404.html { root /usr/share/nginx/html; } # redirect server error pages to the static page /50x.html error_page 500 502 503 504 /50x.html; location = /50x.html { root /usr/share/nginx/html; } } 插件安装 建议安装如下插件 kopf 兼容es 1.x, 2.x kopf ./elasticsearch/bin/plugin install lmenezes/elasticsearch-kopf/{branch|version} head 兼容es 1.x bigdesk 兼容es 1.x presto-elasticsearch connector elasticsearch搜索功能强劲,就是查询语法复杂,presto提供了非常open的plugin机制,我改进了下原有的presto-elasticsearch connector,现发布于github 功能改进点 自动加载elasticsearch schema 支持分片数据加载 predication pushdown,注意由于presto spi接口的原因,目前只支持and类型的过滤器下推,对于OR表达式不支持,不支持like类型的过滤器下推 避免重复加载schema 运行办法 在etc/catalog目录下添加es.properties即可,内容如下 connector.name=elasticsearch elasticsearch-server=localhost elasticsearch-port=9300 elasticsearch-clustername=elasticsearch_demo 时间仓促,错误在所难免,欢迎批评指正。

优秀的个人博客,低调大师

Apache Spark源码走读(三)Spark on Yarn &amp;Spark源码编译 &amp;在YARN上运行SparkPi

<一>Spark on Yarn 概要 Hadoop2中的Yarn是一个分布式计算资源的管理平台,由于其有极好的模型抽象,非常有可能成为分布式计算资源管理的事实标准。其主要职责将是分布式计算集群的管理,集群中计算资源的管理与分配。 Yarn为应用程序开发提供了比较好的实现标准,Spark支持Yarn部署,本文将就Spark如何实现在Yarn平台上的部署作比较详尽的分析。 Spark Standalone部署模式回顾 上图是Spark Standalone Cluster中计算模块的简要示意,从中可以看出整个Cluster主要由四种不同的JVM组成: Master 负责管理整个Cluster,Driver Application和Worker都需要注册到Master Worker 负责某一个node上计算资源的管理,如启动相应的Executor Executor RDD中每一个Stage的具体执行是在Executor上完成 Driver Application driver中的schedulerbackend会因为部署模式的不同而不同 换个角度来说,Master对资源的管理是在进程级别,而SchedulerBackend则是在线程的级别。 启动时序图 YARN的基本架构和工作流程 YARN的基本架构如上图所示,由三大功能模块组成,分别是1) RM (ResourceManager) 2) NM (Node Manager) 3) AM(Application Master)。 作业提交 用户通过Client向ResourceManager提交Application, ResourceManager根据用户请求分配合适的Container,然后在指定的NodeManager上运行Container以启动ApplicationMaster ApplicationMaster启动完成后,向ResourceManager注册自己 对于用户的Task,ApplicationMaster需要首先跟ResourceManager进行协商以获取运行用户Task所需要的Container,在获取成功后,ApplicationMaster将任务发送给指定的NodeManager NodeManager启动相应的Container,并运行用户Task 实例 上述说了一大堆,说白了在编写YARN Application时,主要是实现Client和ApplicatonMaster。实例请参考github上的simple-yarn-app. Spark on Yarn 结合Spark Standalone的部署模式和YARN编程模型的要求,做了一张表来显示Spark Standalone和Spark on Yarn的对比。 Standalone YARN Notes Client Client standalone请参考spark.deploy目录 Master ApplicationMaster Worker ExecutorRunnable Scheduler YarnClusterScheduler SchedulerBackend YarnClusterSchedulerBackend 作上述表格的目的就是要搞清楚为什么需要做这些更改,与之前Standalone模式间的对应关系是什么。代码走读时,分析的重点是ApplicationMaster, YarnClusterSchedulerBackend和YarnClusterScheduler 一般来说,在Client中会显示的指定启动ApplicationMaster的类名,如下面的代码所示 ContainerLaunchContext amContainer = Records.newRecord(ContainerLaunchContext.class); amContainer.setCommands( Collections.singletonList( "$JAVA_HOME/bin/java" + " -Xmx256M" + " com.hortonworks.simpleyarnapp.ApplicationMaster" + " " + command + " " + String.valueOf(n) + " 1>" + ApplicationConstants.LOG_DIR_EXPANSION_VAR + "/stdout" + " 2>" + ApplicationConstants.LOG_DIR_EXPANSION_VAR + "/stderr" ) ); 但在yarn.Client中并没有直接指定ApplicationMaster的类名,是通过ClientArguments进行了封装,真正指定启动类的名称的地方在ClientArguments中。构造函数中指定了amClass的默认值是org.apache.spark.deploy.yarn.ApplicationMaster 实例说明 将SparkPi部署到Yarn上,下述是具体指令。 $ SPARK_JAR=./assembly/target/scala-2.10/spark-assembly-0.9.1-hadoop2.0.5-alpha.jar \ ./bin/spark-class org.apache.spark.deploy.yarn.Client \ --jar examples/target/scala-2.10/spark-examples-assembly-0.9.1.jar \ --class org.apache.spark.examples.SparkPi \ --args yarn-standalone \ --num-workers 3 \ --master-memory 4g \ --worker-memory 2g \ --worker-cores 1 从输出的日志可以看出, Client在提交的时候,AM指定的是org.apache.spark.deploy.yarn.ApplicationMaster 13/12/29 23:33:25 INFO Client: Command for starting the Spark ApplicationMaster: $JAVA_HOME/bin/java -server -Xmx4096m -Djava.io.tmpdir=$PWD/tmp org.apache.spark.deploy.yarn.ApplicationMaster --class org.apache.spark.examples.SparkPi --jar examples/target/scala-2.9.3/spark-examples-assembly-0.8.1-incubating.jar --args 'yarn-standalone' --worker-memory 2048 --worker-cores 1 --num-workers 3 1> /stdout 2> /stderr 小结 spark在提交时,所做的资源申请是一次性完成的,也就是说对某一个具体的Application,它所需要的Executor个数是一开始就是计算好,整个Cluster如果此时能够满足需求则提交,否则进行等待。而且如果有新的结点加入整个cluster,已经运行着的程序并不能使用这些新的资源。缺少rebalance的机制,这点上storm倒是有。 参考资料 Launch Spark On YARN http://spark.apache.org/docs/0.9.1/running-on-yarn.html Getting started Writing YARN Application http://hortonworks.com/blog/getting-started-writing-yarn-applications/ 《Hadoop技术内幕 深入解析YARN架构设计与实现原理》 董西成著 YARN应用开发流程 http://my.oschina.net/u/1434348/blog/193374强烈推荐!!! <二>Spark源码编译 概要 本来源码编译没有什么可说的,对于java项目来说,只要会点maven或ant的简单命令,依葫芦画瓢,一下子就ok了。但到了Spark上面,事情似乎不这么简单,按照spark officical document上的来做,总会出现这样或那样的编译错误,让人懊恼不已。 今天闲来无事,又重试了一把,居然o了,做个记录,以备后用。 准备 我的编译机器上安装的Linux是archlinux,并安装后如下软件 scala 2.11 maven git 下载源码 第一步当然是将github上的源码下载下来 git clone https://github.com/apache/spark.git 源码编译 不是直接用maven也不是直接用sbt,而是使用spark中自带的编译脚本make-distribution.sh export SCALA_HOME=/usr/share/scala cd $SPARK_HOME ./make-distribution.sh 如果一切顺利,会在$SPARK_HOME/assembly/target/scala-2.10目录下生成目标文件,比如 assembly/target/scala-2.10/spark-assembly-1.0.0-SNAPSHOT-hadoop1.0.4.jar 使用sbt编译 之前使用sbt编译一直会失败的主要原因就在于有些jar文件因为GFW的原因而访问不了。解决之道当然是添加代理才行。 代理的添加有下面几种方式,具体哪种好用,一一尝试吧,对于最新的spark。使用如下指令即可。 export http_proxy=http://proxy-server:port 方法二,设置JAVA_OPTS JAVA_OPTS="-Dhttp.proxyServer=proxy-server -Dhttp.proxyPort=portNumber" 运行测试用例 既然能够顺利的编译出jar文件,那么肯定也改动两行代码来试试效果,如果知道自己的发动生效没有呢,运行测试用例是最好的办法了。 假设已经修改了$SPARK_HOME/core下的某些源码,重新编译的话,使用如下指令 export SCALA_HOME=/usr/share/scala mvn package -DskipTests 假设当前在$SPARK_HOME/core目录下,想要运行一下RandomSamplerSuite这个测试用例集合,使用以下指令即可。 export SPARK_LOCAL_IP=127.0.0.1 export SPARK_MASTER_IP=127.0.0.1 mvn -Dsuites=org.apache.spark.util.random.RandomSamplerSuite test <三>在YARN上运行SparkPi 概要 “spark已经比较头痛了,还要将其运行在yarn上,yarn是什么,我一点概念都没有哎,再怎么办啊。不要跟我讲什么原理了,能不能直接告诉我怎么将spark在yarn上面跑起来,I'm a dummy, just told me how to do it.” 如果你和我一样是一个对形而上的东西不是太感兴趣,而只纠结于怎么去做的话,看这份guide保证不会让你失望, :)。 前期准备 本文所有的操作基于arch linux,保证下述软件已经安装 jdk scala maven 搭建hadoop hadoop像它的Logo一样,真得是一个体形无比巨大的大象,如果直接入手去搞这个东东的话,肯定会昏上好长一段时间。个人取巧,从storm弄起,一路走来还算平滑。 hadoop最主要的是hdfs和MapReduce Framework,针对第二代的hadoop即hadoop 2这个Framework变成了非常流行的YARN, 要是没听说过YARN,都不好意思说自己玩过Hadoop了。 不开玩笑了,注意上面一段话中最主要的信息就是hdfs和mapreduce framework,我们接下来的所有配置都是围绕这两个主题来的。 创建用户 添加用户组: hadoop, 添加用户hduser groupadd hadoop useradd -b /home -m -g hadoop hduser 下载hadoop运行版 假设当前是以root用户登录,现在要切换成用户hduser su - hduser id ##检验一下切换是否成功,如果一切ok,将显示下列内容 uid=1000(hduser) gid=1000(hadoop) groups=1000(hadoop) 下载hadoop 2.4并解压 cd /home/hduser wget http://mirror.esocc.com/apache/hadoop/common/hadoop-2.4.0/hadoop-2.4.0.tar.gz tar zvxf hadoop-2.4.0.tar.gz 设置环境变量 export HADOOP_HOME=$HOME/hadoop-2.4.0 export HADOOP_MAPRED_HOME=$HOME/hadoop-2.4.0 export HADOOP_COMMON_HOME=$HOME/hadoop-2.4.0 export HADOOP_HDFS_HOME=$HOME/hadoop-2.4.0 export HADOOP_YARN_HOME=$HOME/hadoop-2.4.0 export HADOOP_CONF_DIR=$HOME/hadoop-2.4.0/etc/hadoop 为了避免每次都要重复设置这些变量,可以将上述语句加入到.bashrc文件中。 创建目录 接下来创建的目录是为hadoop中hdfs相关的namenode即datanode使用 mkdir -p $HOME/yarn_data/hdfs/namenode mkdir -p $HOME/yarn_data/hdfs/datanode 修改Hadoop配置文件 下列文件需要相应的配置 yarn-site.xml core-site.xml hdfs-site.xml mapred-site.xml 切换到hadoop安装目录 $cd $HADOOP_HOME 修改etc/hadoop/yarn-site.xml, 在<configuration>和</configuration>之间添加如下内容,其它文件添加位置与此一致: <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name> <value>org.apache.hadoop.mapred.ShuffleHandler</value> </property> etc/hadoop/core-site.xml <property> <name>fs.default.name</name> <value>hdfs://localhost:9000</value> <!--YarnClient会用到该配置项--> </property> etc/hadoop/hdfs-site.xml <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>file:/home/hduser/yarn_data/hdfs/namenode</value> <!--节点格式化中被用到--> </property> <property> <name>dfs.datanode.data.dir</name> <value>file:/home/hduser/yarn_data/hdfs/datanode</value> </property> etc/hadoop/mapred-site.xml <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> 格式化namenode $ bin/hadoop namenode -format 启动hdfs相关进程 启动namenode $ sbin/hadoop-daemon.sh start namenode 启动datanode $sbin/hadoop-daemon.sh start datanode 启动mapreduce framework相关进程 启动Resource Manager sbin/yarn-daemon.sh start resourcemanager 启动Node Manager sbin/yarn-daemon.sh start nodemanager 启动Job History Server sbin/mr-jobhistory-daemon.sh start historyserver 验证部署 $jps 18509 Jps 17107 NameNode 17170 DataNode 17252 ResourceManager 17309 NodeManager 17626 JobHistoryServer 运行wordCount 验证一下hadoop搭建成功与否的最好办法就是在上面跑个wordcount试试 $mkdir in $cat > in/file This is one line This is another line 将文件复制到hdfs中 $bin/hdfs dfs -copyFromLocal in /in 运行wordcount bin/hadoop jar ./share/hadoop/mapreduce/hadoop-mapreduce-examples-2.4.0.jar wordcount /in /out 查看运行结果 bin/hdfs dfs -cat /out/* 先歇一会,配置到这里,已经一头汗了,接下来将spark在yarn上的运行,再坚持一小会 在yarn上运行SparkPi 下载spark 下载spark for hadoop2的版本 运行SparkPi 继续以hduser身份运行,最主要的一点就是设置YARN_CONF_DIR或HADOOP_CONF_DIR环境变量 export YARN_CONF_DIR=$HADOOP_HOME/etc/hadoop SPARK_JAR=./assembly/target/scala-2.10/spark-assembly_2.10-0.9.1-hadoop2.2.0.jar \ ./bin/spark-class org.apache.spark.deploy.yarn.Client \ --jar ./examples/target/scala-2.10/spark-examples_2.10-assembly-0.9.1.jar \ --class org.apache.spark.examples.JavaSparkPi \ --args yarn-standalone \ --num-workers 1 \ --master-memory 512m \ --worker-memory 512m \ --worker-cores 1 检查运行结果 运行结果保存在相关application的stdout目录,使用以下指令可以找到 cd $HADOOP_HOME find . -name "*stdout" 假设找到的文件为./logs/userlogs/application_1400479924971_0002/container_1400479924971_0002_01_000001/stdout,使用cat可以看到结果 cat ./logs/userlogs/application_1400479924971_0002/container_1400479924971_0002_01_000001/stdout Pi is roughly 3.14028

优秀的个人博客,低调大师

保持Service不被Kill掉的方法--双Service守护 &amp;&amp; Android实现双进程守护 2

保持Service不被Kill掉的方法--双Service守护,代码如下: AndroidManifest.xml: [java] view plain copy <activity android:name=".MainActivity" android:label="@string/app_name"> <intent-filter> <actionandroid:name="android.intent.action.MAIN"/> <categoryandroid:name="android.intent.category.LAUNCHER"/> </intent-filter> </activity> <service android:name="ServiceOne" android:process=":remote"> <intent-filter> <actionandroid:name="com.example.servicedemo.ServiceOne"/> </intent-filter> </service> <service android:name="ServiceTwo" android:process=":remote"> <intent-filter> <actionandroid:name="com.example.servicedemo.ServiceTwo"/> </intent-filter> </service> MainActivity.java: [java] view plain copy packagecom.example.servicedemo; importjava.util.ArrayList; importandroid.app.Activity; importandroid.app.ActivityManager; importandroid.app.ActivityManager.RunningServiceInfo; importandroid.content.Context; importandroid.content.Intent; importandroid.os.Bundle; publicclassMainActivityextendsActivity{ @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); IntentserviceOne=newIntent(); serviceOne.setClass(MainActivity.this,ServiceOne.class); startService(serviceOne); IntentserviceTwo=newIntent(); serviceTwo.setClass(MainActivity.this,ServiceTwo.class); startService(serviceTwo); } publicstaticbooleanisServiceWorked(Contextcontext,StringserviceName){ ActivityManagermyManager=(ActivityManager)context.getSystemService(Context.ACTIVITY_SERVICE); ArrayList<RunningServiceInfo>runningService=(ArrayList<RunningServiceInfo>)myManager.getRunningServices(Integer.MAX_VALUE); for(inti=0;i<runningService.size();i++){ if(runningService.get(i).service.getClassName().toString().equals(serviceName)){ returntrue; } } returnfalse; } } ServiceOne.java: [java] view plain copy packagecom.example.servicedemo; importjava.util.Timer; importjava.util.TimerTask; importandroid.app.Service; importandroid.content.Intent; importandroid.os.IBinder; importandroid.util.Log; publicclassServiceOneextendsService{ publicfinalstaticStringTAG="com.example.servicedemo.ServiceOne"; @Override publicintonStartCommand(Intentintent,intflags,intstartId){ Log.e(TAG,"onStartCommand"); thread.start(); returnSTART_STICKY; } Threadthread=newThread(newRunnable(){ @Override publicvoidrun(){ Timertimer=newTimer(); TimerTasktask=newTimerTask(){ @Override publicvoidrun(){ Log.e(TAG,"ServiceOneRun:"+System.currentTimeMillis()); booleanb=MainActivity.isServiceWorked(ServiceOne.this,"com.example.servicedemo.ServiceTwo"); if(!b){ Intentservice=newIntent(ServiceOne.this,ServiceTwo.class); startService(service); Log.e(TAG,"StartServiceTwo"); } } }; timer.schedule(task,0,1000); } }); @Override publicIBinderonBind(Intentarg0){ returnnull; } } ServiceTwo.java: [java] view plain copy packagecom.example.servicedemo; importjava.util.Timer; importjava.util.TimerTask; importandroid.app.Service; importandroid.content.Intent; importandroid.os.IBinder; importandroid.util.Log; publicclassServiceTwoextendsService{ publicfinalstaticStringTAG="com.example.servicedemo.ServiceTwo"; @Override publicintonStartCommand(Intentintent,intflags,intstartId){ Log.e(TAG,"onStartCommand"); thread.start(); returnSTART_REDELIVER_INTENT; } Threadthread=newThread(newRunnable(){ @Override publicvoidrun(){ Timertimer=newTimer(); TimerTasktask=newTimerTask(){ @Override publicvoidrun(){ Log.e(TAG,"ServiceTwoRun:"+System.currentTimeMillis()); booleanb=MainActivity.isServiceWorked(ServiceTwo.this,"com.example.servicedemo.ServiceOne"); if(!b){ Intentservice=newIntent(ServiceTwo.this,ServiceOne.class); startService(service); } } }; timer.schedule(task,0,1000); } }); @Override publicIBinderonBind(Intentarg0){ returnnull; } } 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/5673965.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

保持Service不被Kill掉的方法--双Service守护 &amp;&amp; Android实现双进程守护 3

第二部分: 做过android开发的人应该都知道应用会在系统资源匮乏的情况下被系统杀死!当后台的应用被系统回收之后,如何重新恢复它呢?网上对此问题有很多的讨论。这里先总结一下网上流传的各种解决方案,看看这些办法是不是真的可行。 1.提高优先级 这个办法对普通应用而言,应该只是降低了应用被杀死的概率,但是如果真的被系统回收了,还是无法让应用自动重新启动! 2.让service.onStartCommand返回START_STICKY 通过实验发现,如果在adb shell当中kill掉进程模拟应用被意外杀死的情况(或者用360手机卫士进行清理操作),如果服务的onStartCommand返回 START_STICKY,在eclipse的进程管理器中会发现过一小会后被杀死的进程的确又会出现在任务管理器中,貌似这是一个可行的办法。但是如果 在系统设置的App管理中选择强行关闭应用,这时候会发现即使onStartCommand返回了START_STICKY,应用还是没能重新启动起来! 3.android:persistent="true" 网上还提出了设置这个属性的办法,通过实验发现即使设置了这个属性,应用程序被kill之后还是不能重新启动起来的! 4.让应用成为系统应用 实验发现即使成为系统应用,被杀死之后也不能自动重新启动。但是如果对一个系统应用设置了persistent="true",情况就不一样了。实验表明 对一个设置了persistent属性的系统应用,即使kill掉会立刻重启。一个设置了persistent="true"的系统应用,在 android中具有core service优先级,这种优先级的应用对系统的low memory killer是免疫的! OK,说了半天,只有core service优先级的应用才能保证在被意外杀死之后做到立刻满血复活。而普通应用要想成为系统应用就必须要用目标机器的签名文件进行签名,但这样又造成 了应用无法保证兼容所有不同厂商的产品。那么该怎么办呢?这里就来说一说双进程守护。网上也有人提到过双进程守护的办法,但是很少能搜索到类似的源码!如 果从进程管理器重观察会发现新浪微博或者360卫视都有两个相关的进程,其中一个就是守护进程,由此可以猜到这些商业级的软件也采用了双进程守护的办法。 什么是双进程守护呢?顾名思义就是两个进程互相监视对方,发现对方挂掉就立刻重启!不知道应该把这样的一对进程是叫做相依为命呢还是难兄难弟好呢, 但总之,双进程守护的确是一个解决问题的办法!相信说到这里,很多人已经迫切的想知道如何实现双进程守护了。这篇文章就介绍一个用NDK来实现双进程保护 的办法,不过首先说明一点,下面要介绍的方法中,会损失不少的效率,反应到现实中就是会使手机的耗电量变大!但是这篇文章仅仅是抛砖引玉,相信看完之后会 有更多高人指点出更妙的实现办法。 需要了解些什么? 这篇文章中实现双进程保护的方法基本上是纯的NDK开发,或者说全部是用C++来实现的,需要双进程保护的程序,只需要在程序的任何地方调用一下JAVA接口即可。下面几个知识点是需要了解的: 1.linux中多进程; 2.unix domain套接字实现跨进程通信; 3.linux的信号处理; 4.exec函数族的用法; 其实这些东西本身并不是多复杂的技术,只是我们把他们组合起来实现了一个双进程守护而已,没有想象中那么神秘!在正式贴出代码之前,先来说说几个实现双进程守护时的关键点: 1.父进程如何监视到子进程(监视进程)的死亡? 很简单,在linux中,子进程被终止时,会向父进程发送SIG_CHLD信号,于是我们可以安装信号处理函数,并在此信号处理函数中重新启动创建监视进程; 2.子进程(监视进程)如何监视到父进程死亡? 当父进程死亡以后,子进程就成为了孤儿进程由Init进程领养,于是我们可以在一个循环中读取子进程的父进程PID,当变为1就说明其父进程已经死亡,于是可以重启父进程。这里因为采用了循环,所以就引出了之前提到的耗电量的问题。 3.父子进程间的通信 有一种办法是父子进程间建立通信通道,然后通过监视此通道来感知对方的存在,这样不会存在之前提到的耗电量的问题,在本文的实现中,为了简单,还是采用了轮询父进程PID的办法,但是还是留出了父子进程的通信通道,虽然暂时没有用到,但可备不时之需! 腾讯的面试官问我:应用程序死了如何恢复?确实,双进程守护只能做到进程被杀死后重新启动,但是重启后如何恢复到之前的状态这是一个问题。因为进程 被意外杀死的情况,onSaveInstance是来不及执行的,所以程序的状态没法保存!对于双进程守护来说,不知道是不是可以再父进程进入后台以后 (onStop),把数据收集起来保存到子进程中,然后父进程重启以后从子进程中取出这些信息呢?这是一个办法,但是上面说明的双进程守护程序的实现中还 做不到,因为父进程重启以后,子进程也挂掉重新建立了,要想实现优雅的恢复,还得在做出点改进才是!只能实时保存数据到数据库等。 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/5673974.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

iOS 开发之 OOA (面向对象分析) &amp; OOD (面向对象设计)&amp; OOP (面向对象编程)

OOA OOA 基本概念 OOA 全称 Object-Oriented Analysis 面向对象分析 指的是在一个系统的开发过程中进行了系统业务调查以后,按照面向对象的思想来分析问题。OOA 与结构化分析有较大的区别。OOA 所强调的是在系统调查资料的基础上,针对 OO 方法所需要的素材进行的归类化分析和整理,而不是对管理业务现状和方法的分析。 OOA 模型由 5 个层次(主题层、对象类层、结构层、属性层和服务层)和 5 个活动(标识对象类、标识结构、定义主题、定义属性和定义服务)组成。在这种方法中定义了两种对象类之间的结构,一种称为分类结构,一种称为组装结构。分类结构就是所谓的一般与特殊的关系。组装结构则反映了对象之间的整体与部分的关系。 OOA 在定义属性的同时,要识别实例连接。实例连接是一个实例与另一个实例的映射关系。 OOA 在定义服务的同时要识别消息连接。当一个对象需要向另一个对象发送消息时,它们之间就存在消息连接。 OOA 中的 5 个层次和 5 个活动继续贯穿在 OOD(面向对象设计)过程中。OOD 模型由 4 各部分组成。它们分别是设计问题域部分、设计人机交互部分、设计任务管理部分、和设计数据管理部分。 OOA 的主要原则 抽象:从许多食物中舍弃个别的、非本质的特征,抽取共同的、本质性的特征,就叫做抽象。愁乡石形成概念的必须手段。 抽象原则有两个方面的意义: 1,尽管问题域中的事物是很复杂的,但是分析员并不需要了解和描述它们的一切,只需要分析其中与系统目标有关的事物及其本质性特征; 2,通过舍弃个体事物在细节上的差异,抽取其共同特性而得到一批事物的抽象概念; 抽象是面向对象方法中使用最为广泛的原则。抽象原则包括过程抽象和数据抽象两个方面。 过程抽象是指,任何一个完成确定功能的操作序列,其使用者都可以把它看做一个单一的实体,尽管实际上它可能是由一系列更低级的操作完成的。 数据抽象是根据施加于数据之上的操作来定义数据类型,并限定数据的值只能由这些操作来修改和观察。数据抽象是 OOA 的核心原则。它强调把数据(属性)和操作(服务)结合为一个不可分的系统单位(即对象),对象的外部只需要知道它做什么,而不必知道它如何做; 封装就是把对象的属性和服务结合为一个不可分的系统单位,并尽可能隐蔽对象的内部细节; 继承:特殊类的对象拥有的其一般类的全部属性与服务,称作特殊类对一般类的继承; 在 OOA 中运用继承原则,就是在每个由一般类和特殊类形成的一半特殊结构总,把一般类的对象实例和所有特殊类的对象实例都共同具有的属性和服务,一次性的在一般类中进行显式的定义。在特殊类中不在重复的定义一般类中已定义的东西,但是在语义上,特殊类却自动的、隐含地拥有它的一般类(以及所有更上层的一般类)中定义的全部属性和服务。继承原则的好处是:是系统模型比较简练也比较清晰; 分类: 就是把具有相同属性和服务的对象划分为一类,用类作为这些对象的抽象描述。分类原则实际上是抽象原则运用于对象描述时的一种表现形式。 聚合: 又称组装,其原则是:把一个复杂的事物看成若干比较简单的事物组装体,从而简化对复杂事物的描述; 关联: 是人类思考问题时经常运用的思想方法:通过一个事物联想到另外的事物。能使人发生联想的原因是事物之间确实存在着某些联系; 消息通信: 这一原则要求对象之间只能通过消息进行通信,而不允许在对象之外直接地存取对象内部的属性。通过消息进行通信是由于封装原则而引起的。在 OOA 中要求消息连接表示出对象之间的动态联系; 粒度控制: 一般来讲,人在面对一个复杂的问题域时,不可能在同一时刻既能纵观全局,又能洞察秋毫。因此需要控制自己的视野。考虑全局时,注意其大的组成部分,暂时不详查每一部分的具体的细节。考虑某部分的细节时则暂时撇开其余的部分。着就是粒度控制原则; 行为分析: 显示世界中事物的行为是复杂的。由大量的事物所构成的问题域中各种行为旺旺相互依赖交织; 面向对象分析产生三种模型 对象模型: 对用例模型进行分析,把系统分解成互相协作的分析类,通过类图\对象图描述对象\对象的属性\对象间的关系,是系统的静态模型; 动态模型: 描述系统的动态行为,通过时序图/协作图/描述对象的交互,以揭示对象间如何协作来完成每个具体的用例。单个对象的状态变化/动态行为可以通过状态图来表示; 功能模型: OOA 的主要优点 加强了对问题域和系统责任的理解; 改进与分析有关的各类人员之间的交流; 对需求的变化具有较强的适应性; 支持软件复用; 贯穿软件声明周期全过程的一致性; 实用性; 有利于用户参与; OOA 方法的具体步骤 在用 OOA 具体分析一个事物时。大致上遵循如下 5 个基本步骤: 确定对象和类 这里所说的对象是对数据及其处理方式的抽象,它反映了系统保存和处理现实世界总某些事物的信息能力。类是多个对象的共同属性和方法集合的描述,它包括如何在一个类中建立一个新对象的描述; 确定结构 structure 结构是指问题域的复杂性和连接关系。类成员结构反映了泛华—特化关系,整体-部分结构反映整体和局部之间的关系; 确定主题 subject 主题是指事物的总体概貌和总体分析模型; 确定属性 attribute 属性就是数据元素,可用来描述对象或分类结构的实例,可在图中给出,并在对象的存储中指定; 确定方法 method 方法是在收到消息后必须进行的一些处理方法:方法要在图中定义,并在对象的存储中指定。对于每个对象和结构来说,那些用来增加、修改、删除和选择一个方法本身都是隐含的(虽然它们是要在对象的存储中定义的,但并不在图上给出),而有些则是显示的; OOD OOD 基本概念 OOD 全称 Object-Oriented Design 面向对象设计 OOD 是 OO 方法中一个中间过渡环节。其主要作用是对 OOA 分析的结构作进一步的规范化整理,以便能够被 OOP 面向对象的编程 直接接受。 OOD 是一个软件设计方法,是一种工程化规范。这是毫无疑问的。按照 Bjarne Stroustrup 的说法,OOP 是决定你要的类,给每一个类提供完整的一组操作。 明确地使用继承来表现共同点。由这个定义,我们可以看出 OOD 就是“根据需求决定所需的类、类的操作以及类之间关联的过程”。 OOD 的目标是管理程序内部各部分的相互依赖。为了达到这个目标,OOD 要求将程序分成块,每个块的规模应该小到可以管理的程度,然后分别将各个块隐藏在接口 interface 的后面,让它们只通过接口相互交流。比如说,如果用OOD 的方法类设计一个服务器-客户端 client-server 应用,那么服务器和客户端之间不应该有直接地依赖,而是应该让服务器的接口和客户端的接口相互依赖。 这种依赖关系的转换使得系统的各部分具有了可复用性。还是拿上面那个例子来说,客户端就不必依赖于特定的服务器,所以就可以复用到其他的环境下。如果要复用某一个程序块,只要实现必须的接口就行了。 OOD 是一种解决软件问题的设计范式 paradigm,一种抽象的范式。使用 OOD 这种设计范式,我们可以用对象 object 来表现问题领域 problem domain 的实体,每个对象都有相应的状态和行为。 抽象可以分成很多层次,从非常概括的到非常特殊的都有,而对象可能处于任何一个抽象层次上。另外,彼此不同但又相互关联的对象可以共同构成抽象。只要这些对象之间有相似性,就可以把它们当成同一类的对象类处理。 OOP 基本概念 OOP 全称 Object Oriented Programming 面向对象编程 OOP 是一种实现的方法。在这种方法中,程序被组织成许多组互相协作的对象,每个对象代表某个类的一个实例,而类则属于一个通过继承关系形成的层次结构具体实现。 OOP 的三大特性: 封装: 就是将一个类使用和实现分开,只保留部分接口和方法与外部联系 。 继承: 子类自动继承其父级类中的属性和方法,并可以添加新的属性和方法或者对部分属性和方法进行重写。继承增加了代码的可重用性。 多态: 多个子类中虽然都具有同一个方法,但是这些子类实例化的对象调用这些相同的方法后却可以获得完全不同的结果,多态性增强了软件的灵活性。

优秀的个人博客,低调大师

Delta Lake Presto Integration &amp; Manifests 机制

原文链接 该功能与我们之前平台化 Delta Lake 平台化实践(离线篇) 的很多工作都较为相似,比如与 metastore 的集成,直接通过 manifest 读取 delta 存活文件等。Delta Lake 在 0.5 之前只支持通过 Spark 读取数据,在新版本中增加了其他处理引擎通过 manifest 文件访问 Delta Lake 的能力。下文以Presto 为例说明如何通过 manifest 文件访问数据,manifest 文件的生成及其一些限制。 01 使用 Presto 使用 manifest 文件从 hive 外部表中读取数据,manifest文件是一个文本文件,包含该表/分区所有存活数据的路径列表。 当使用 manifest 文件在 Hive metastore 中定义外部表时,Presto 将会先读取 mani

优秀的个人博客,低调大师

Protobuf&amp;GRPC 的基本使用

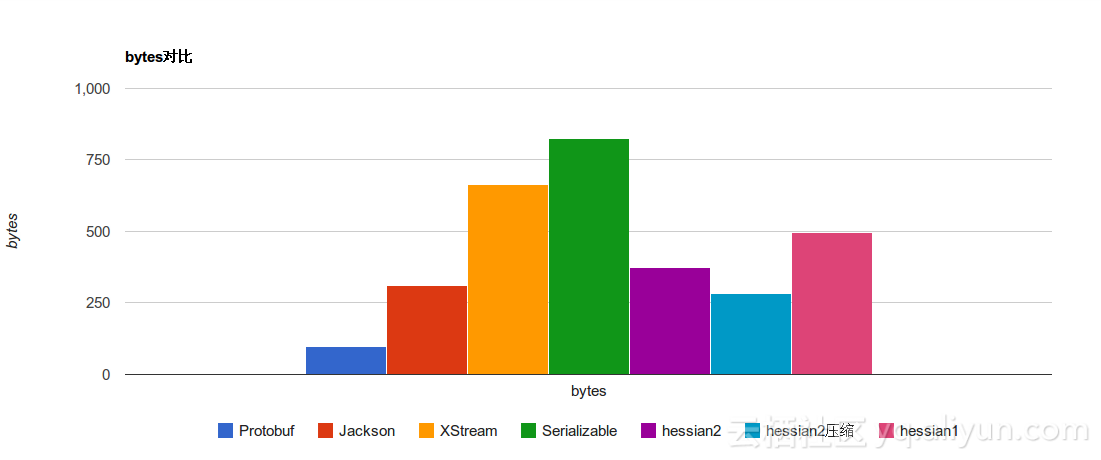
首先对比一下Java自带的序列化与Protobuf的序列化的大小差异 public static void main(String[] args) throws Exception { Person.User person = Person.User.newBuilder().setName("wangziqiang") .setAge(20) .setAddress("hebei") .setGender("男") .setTimestamp(System.currentTimeMillis()).build(); ObjectOutputStream os = new ObjectOutputStream(new FileOutputStream("javaobj")); os.writeObject(person); os.close(); person.writeTo(new FileOutputStream("protoobj")); } 之后的javaobj是217字节,而proto是34字节,很明显的大小差异,下面是proto的反序列化代码 public void test() throws Exception { Person.User user = Person.User.parseFrom(new FileInputStream("protoobj")); System.out.println(user); } /** * name: "wangziqiang" * age: 20 * address: "hebei" * gender: "\347\224\267" * timestamp: 1546783663870 */ 下面说一下序列化和反序列化的速度,直接上图,图来自网上 另附一篇protobuf的测试帖子: 即时通讯网,看完后只有一个结论:使用protobuf基本上是稳赚不亏的 之前自己接触过AVRO,也是可以进行序列化和RPC的框架,然后自己就产生了一个疑问:protobuf可以直接做RPC吗?网上的帖子大多是C的,自己就产生了一些误导,认为protobuf可以直接来做RPC的应用,但是这是错误的,经过请教,在钉钉群和云栖社区的问答都给了我很好的答案,如果你也有这个疑问,请移步到 我的云栖问答-protobuf 由于gRPC也是Google开源的RPC框架,所以我将使用这个框架做一个小demo,本质上是跟着网上贴的代码,先会用再说 maven <dependencies> <dependency> <groupId>io.grpc</groupId> <artifactId>grpc-netty</artifactId> <version>1.17.1</version> </dependency> <dependency> <groupId>io.grpc</groupId> <artifactId>grpc-protobuf</artifactId> <version>1.17.1</version> </dependency> <dependency> <groupId>io.grpc</groupId> <artifactId>grpc-stub</artifactId> <version>1.17.1</version> </dependency> </dependencies> <build> <extensions> <extension> <groupId>kr.motd.maven</groupId> <artifactId>os-maven-plugin</artifactId> <version>1.4.1.Final</version> </extension> </extensions> <plugins> <plugin> <groupId>org.xolstice.maven.plugins</groupId> <artifactId>protobuf-maven-plugin</artifactId> <version>0.5.0</version> <configuration> <protocArtifact>com.google.protobuf:protoc:3.0.0:exe:${os.detected.classifier}</protocArtifact> <pluginId>grpc-java</pluginId> <pluginArtifact>io.grpc:protoc-gen-grpc-java:1.0.0:exe:${os.detected.classifier}</pluginArtifact> </configuration> <executions> <execution> <goals> <goal>compile</goal> <goal>compile-custom</goal> </goals> </execution> </executions> </plugin> </plugins> </build> proto文件 syntax = "proto3"; option java_package = "com.qidai.proto"; option java_outer_classname = "MyThing"; message Request { string name = 1; } message Response { string name = 2; } service MyRPC { rpc sayHi(Request) returns(Response); } 到这后maven插件compile,进行编译proto文件 Server import com.qidai.proto.MyRPCGrpc; import com.qidai.proto.MyThing; import io.grpc.ServerBuilder; import io.grpc.stub.StreamObserver; import java.io.IOException; public class Server { private static final int PORT = 2222; private final io.grpc.Server server; public Server() throws IOException { //这个部分启动server this.server = ServerBuilder.forPort(PORT) .addService(new MyRPCImpl()) .build() .start(); System.out.println("Server Started ..."); } private void stop() { if (server != null) { server.shutdown(); } } private void blockUntilShutdown() throws InterruptedException { if (server != null) { server.awaitTermination(); } } public static void main(String[] args) throws IOException, InterruptedException { Server server = new Server(); //block Server防止关闭 server.blockUntilShutdown(); } static class MyRPCImpl extends MyRPCGrpc.MyRPCImplBase{ @Override //这个方法是在proto中定义的rpc方法名,client传来的rpc请求以怎样的逻辑处理 public void sayHi(MyThing.Request request, StreamObserver<MyThing.Response> responseObserver) { System.out.println("request -> " + request.getName()); MyThing.Response response = MyThing.Response.newBuilder() .setName("Client Hello "+ request.getName()) .build(); //包装返回信息 responseObserver.onNext(response); //等待结束一次请求 responseObserver.onCompleted(); } } } Client import com.qidai.proto.MyRPCGrpc; import com.qidai.proto.MyThing; import io.grpc.ManagedChannel; import io.grpc.ManagedChannelBuilder; import java.util.concurrent.TimeUnit; public class Client { private final ManagedChannelBuilder<?> managedChannelBuilder; private final MyRPCGrpc.MyRPCBlockingStub blockingStub; private final ManagedChannel channel; public Client(String name, int port) { managedChannelBuilder = ManagedChannelBuilder.forAddress(name, port); channel = managedChannelBuilder.usePlaintext().build(); blockingStub = MyRPCGrpc.newBlockingStub(channel); } public void shutdown() throws InterruptedException { channel.shutdown().awaitTermination(5, TimeUnit.SECONDS); } public void sayHi(String name){ MyThing.Request request = MyThing.Request.newBuilder().setName(name).build(); MyThing.Response response = blockingStub.sayHi(request); System.out.println(response.getName()); } public static void main(String[] args) throws Exception{ Client client = new Client("localhost", 2222); for (int i = 0; i < 10; i++) { Thread.sleep(1000); //进行rpc调用的真正逻辑 client.sayHi("Hello Server -> " + i); } client.shutdown(); } } 到这了就可以使用了,先启动server然后启动client,效果如下 Server request -> Hello Server -> 0 request -> Hello Server -> 1 request -> Hello Server -> 2 request -> Hello Server -> 3 request -> Hello Server -> 4 request -> Hello Server -> 5 request -> Hello Server -> 6 request -> Hello Server -> 7 request -> Hello Server -> 8 request -> Hello Server -> 9 Client Client Hello Hello Server -> 0 Client Hello Hello Server -> 1 Client Hello Hello Server -> 2 Client Hello Hello Server -> 3 Client Hello Hello Server -> 4 Client Hello Hello Server -> 5 Client Hello Hello Server -> 6 Client Hello Hello Server -> 7 Client Hello Hello Server -> 8 Client Hello Hello Server -> 9

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码