首页 文章 精选 留言 我的

精选列表

搜索[nodejs爬虫],共4927篇文章
优秀的个人博客,低调大师

Java爬虫——微博热搜

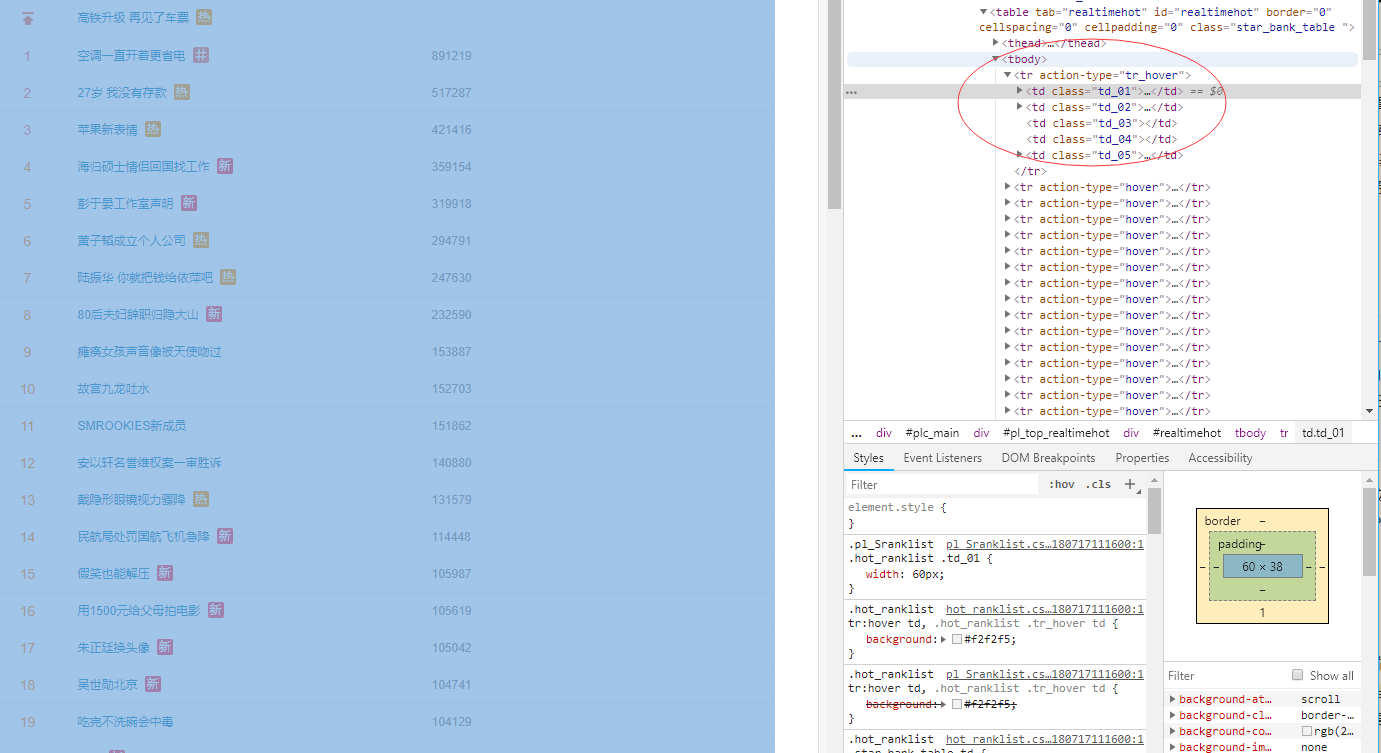
前言 自从写完关于Lifecycle的文章后就没有发现其他有兴趣的源码了,所以呢,我决定看看写写后台代码,尝试一波。经过大概一周的百度,SSM框架基本搭建完成。突发奇想,打算收集一下各种热搜。首先想到的那肯定是微博热搜了,so,我们来爬下微博热搜吧! 工具 Jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。 之前使用过Jsoup来抓取公交车实时到站信息,并且自己做了个简单的公交车到站查询APP。关于Jsoup的使用后面会讲到。 分析网页结构 在抓取数据的时候,首先要做的就是分析这个网页的结构,哪里是我们需要抓取的,哪些数据是我们需要的。我们先看下微博热搜,可以通过浏览器的开发者模式显示Html代码: 热搜html 我们可以看到,右边那<tbody>里面正是我们需要抓取的数据,话不多说,上码吧! 代码实现 先吐槽一波,微博在加载热搜的时候并没有直接用html加载,而是通过了一段js加载,如下图: 抓包结果 通过fiddler抓包可以看到,这里通过加载js来加载的热搜,而且里面有一段json,这段json就是我们需要的热搜数据(截图不好截图,后面再看吧)。 先写代码: 先根据json创建实体类: // 微博json对于的实体类 public class WeiboJsonEntity { private String pid; private List<String> js; private List<String> css; private String html; // get set } 真正热搜实体类: public class WeiboHotEntity { private Integer id = 0; private Integer sort = 0; private Integer num = 0; private String title; private String linkUrl; private String channel; private String date; // get set } 正式抓取网页: public static List<WeiboHotEntity> parseWeiboHot() { try { long currentTime = System.currentTimeMillis(); // 通过jsoup将对应url转为document Document doc = Jsoup.parse(new URL("http://s.weibo.com/top/summary?cate=realtimehot"), 10000); // 获取script标签对应的Element list Elements script = doc.select("script"); for (Element element : script) { String data = element.data(); // 这里是获取json开始的位置(最好的方式是正则匹配) int i = data.indexOf("("); if (i >= 0) { String substring = data.substring(i + 1, data.lastIndexOf(")")); try { // 通过Gson将json转成WeiboJsonEntity实体,出错肯定不是我们需要的 WeiboJsonEntity weiboJsonEneity = new Gson().fromJson(substring, WeiboJsonEntity.class); System.out.println(substring); // 热搜对应的部分 if (weiboJsonEneity.getPid().equals("pl_top_realtimehot")) { // 开始解析数据 return parseSearchTop(weiboJsonEneity, currentTime); } } catch (Exception e) { } } } } catch (IOException e) { e.printStackTrace(); } return null; } 获取到的热搜json: { "pid": "pl_top_realtimehot", "js": ["apps\/search_v6\/js\/pl\/top\/unLogin.js?version=20180717111600", "apps\/search_v6\/js\/pl\/searchHead.js?version=20180717111600", "apps\/search_v6\/js\/pl\/top\/realtimehot.js?version=20180717111600"], "css": ["appstyle\/searchV45\/css_v6\/pl\/pl_Sranklist.css?version=20180717111600", "appstyle\/searchV45\/css_v6\/pl\/pl_Srankbank.css?version=20180717111600", "appstyle\/searchV45\/css_v6\/patch\/Srank_hot.css?version=20180717111600"], "html": "<div class=\"hot_ranklist\">\n <table tab=\"realtimehot\" id=\"realtimehot\" border=\"0\" cellspacing=\"0\" cellpadding=\"0\" class=\"star_bank_table \">\n <thead>\n <tr class=\"thead_tr\">\n <th class=\"th_01\">序号<\/th>\n <th class=\"th_02\">关键词<\/th>\n <th class=\"th_03\">搜索热度<\/th>\n <th class=\"th_04\"><\/th>\n <th class=\"th_05\"><\/th>\n <\/tr>\n <\/thead>\n <tr action-type=\"tr_hover\">\n <td class=\"td_01\"><span class=\"icon_pinned\"><\/span><\/td>\n <td class=\"td_02\">\n <div class=\"rank_content\">\n <p class=\"star_name\">\n " } 可以看到我们需要的就是html里面的内容,这里面内容非为两部分: 中国特色主义推荐位,第一条: 推荐 普通热搜 剩下的那些 private static List<WeiboHotEntity> parseSearchTop(WeiboJsonEntity weiboJsonEneity, long currentTime) { List<WeiboHotEntity> weiboHotEntities = new ArrayList<>(); // 再次解析,将html代码转成document Document parse = Jsoup.parse(weiboJsonEneity.getHtml()); // 中国特色推荐!! Elements tbody = parse.getElementsByAttributeValue("action-type", "tr_hover"); for (Element element : tbody) { weiboHotEntities.add(parseDetail(element, currentTime)); } // 热搜 Elements hover = parse.getElementsByAttributeValue("action-type", "hover"); for (Element element : hover) { weiboHotEntities.add(parseDetail(element, currentTime)); } return weiboHotEntities; } 通过浏览器可以获取到其结构,我们需要提取action-type=tr_hover对应的元素 结构 之后,我们只需要根据需求获取td_01、td_02等里面的数据即可: private static WeiboHotEntity parseDetail(Element element, long currentTime) { WeiboHotEntity weiboHotEntity = new WeiboHotEntity(); Elements td01 = element.getElementsByClass("td_01"); // 排序 if (isListNotEmpty(td01)) { // 获取热度排名,如果没有的话,则是推荐设为0 Elements em = td01.get(0).getElementsByTag("em"); if (em != null && em.size() > 0) { // Integer integer = Integer.valueOf(em.get(0).text()); weiboHotEntity.setSort(integer); } else { weiboHotEntity.setSort(0); } } // 名称和链接 Elements td02 = element.getElementsByClass("td_02"); if (isListNotEmpty(td02)) { Elements a = td02.get(0).getElementsByTag("a"); if (isListNotEmpty(a)) { Element el = a.get(0); String href = el.attributes().get("href"); Elements i = td02.get(0).getElementsByTag("i"); if (isListNotEmpty(i)) { String text = i.get(0).text(); // 感觉就是个广告 if (text.equals("荐")) { weiboHotEntity.setLinkUrl(DOMAIN_WEIBO + "/weibo/" + el.text() + "&Refer=top"); } else { weiboHotEntity.setLinkUrl(DOMAIN_WEIBO + href); } } else { weiboHotEntity.setLinkUrl(DOMAIN_WEIBO + href); } weiboHotEntity.setTitle(el.text()); } } // 热度值 Elements td03 = element.getElementsByClass("td_03"); if (isListNotEmpty(td03)) { Elements span = td03.get(0).getElementsByTag("span"); if (isListNotEmpty(span)) { weiboHotEntity.setNum(Integer.valueOf(span.get(0).text())); } } weiboHotEntity.setChannel("微博"); weiboHotEntity.setDate(getDateStr(currentTime)); return weiboHotEntity; } 这里面都是比较简单的获取数据即可,比如获取排序,通过获取td_01里面的<em>标签的值即可。 排序 链接和名称以及热度值也是同理。这里说个比较有意思的,普通的热搜都是可以直接通过微博的域名+对应的链接跳转到相应的热搜,但是有一种标签,就是为 荐的标签需要配置特殊的跳转,这里已经处理了。 工具类: public static final String DOMAIN_WEIBO = "http://s.weibo.com"; public static boolean isListNotEmpty(List list) { return list != null && list.size() > 0; } public static String getDateStr(long currentTime) { Date time = new Date(currentTime); SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); return sdf.format(time); } 后记 写这个东西呢前面也说了,想做个热搜的整合,不过刚写没多少就没有了热度。最初是想爬取数据+百度搜索+爬取第一条图片+推送这种思路push到手机上,然后就可以开开心心看热搜了!(流产了,遂记于此,并没有后续)

优秀的个人博客,低调大师

python爬虫爬取豆瓣电影

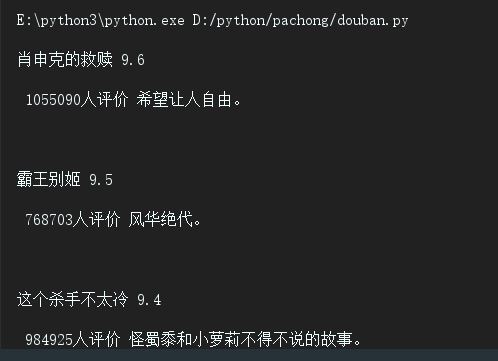
最近买了《python编程从入门到实践》,想之后写两篇文章,一篇数据可视化,一篇python web,今天这篇就当python入门吧。 一.前期准备: IDE准备:pycharm 导入的python库:requests用于请求,BeautifulSoup用于网页解析 二.实现步骤 1.传入url 2.解析返回的数据 3.筛选 4.遍历提取数据 三.代码实现 import requests # 导入网页请求库 from bs4 import BeautifulSoup # 导入网页解析库 # 传入URL r = requests.get("https://movie.douban.com/top250") # 解析返回的数据 soup=BeautifulSoup(r.content,"html.parser") #找到div中,class属性为item的div movie_list=soup.find_all("div",class_="item") #遍历提取数据 for movie in movie_list: title=movie.find("span",class_="title").text rating_num=movie.find("span",class_="rating_num").text inq=movie.find("span",class_="inq").text star = movie.find('div', class_='star') comment_num = star.find_all('span')[-1].text print(title, rating_num, '\n', comment_num, inq, '\n') 以title变量为例,我们找到了div中,class属性为item的div,然后在此div中,筛选出class名为title的span,获取文本内容,打印(comment_num比较特殊,因为其在star的div下,没有class属性,为div中最后一个span,所以我们取出star层级中最后一个span,变为文本),以下是输出结果。 豆瓣.JPG 四.对获取到的数据进行整合 1.整合成列表 2.整合成json文件 3.定义为函数形式 1.整合成列表 import requests # 导入网页请求库 from bs4 import BeautifulSoup # 导入网页解析库 import pprint # 规范显示列表的插件库 # 传入URL r = requests.get("https://movie.douban.com/top250") # 解析返回的数据 soup=BeautifulSoup(r.content,"html.parser") #找到div中,class属性为item的div movie_list=soup.find_all("div",class_="item") #创建存储结果的空列表 result_list=[] #遍历提取数据 for movie in movie_list: #创建字典 dict={} dict["title"]=movie.find("span",class_="title").text dict["dictrating_num"]=movie.find("span",class_="rating_num").text dict["inq"]=movie.find("span",class_="inq").text star = movie.find('div', class_='star') dict["comment_num"] = star.find_all('span')[-1].text result_list.append(dict) # 显示结果 pp = pprint.PrettyPrinter(indent=4) pp.pprint(result_list) 控制台显示的结果: 列表.JPG 2.整合成JSON文件 import requests # 导入网页请求库 import json# 用于将列表字典(json格式)转化为相同形式字符串,以便存入文件 from bs4 import BeautifulSoup # 导入网页解析库 # 传入URL r = requests.get("https://movie.douban.com/top250") # 解析返回的数据 soup=BeautifulSoup(r.content,"html.parser") #找到div中,class属性为item的div movie_list=soup.find_all("div",class_="item") #创建存储结果的空列表 result_list=[] #遍历提取数据 for movie in movie_list: #创建字典 dict={} dict["title"]=movie.find("span",class_="title").text dict["dictrating_num"]=movie.find("span",class_="rating_num").text dict["inq"]=movie.find("span",class_="inq").text star = movie.find('div', class_='star') dict["comment_num"] = star.find_all('span')[-1].text result_list.append(dict) # 显示结果 # 将result_list这个json格式的python对象转化为字符串 s = json.dumps(result_list, indent = 4, ensure_ascii=False) # 将字符串写入文件 with open('movies.json', 'w', encoding = 'utf-8') as f: f.write(s) 结果: json.JPG 3.定义成函数 import requests # 导入网页请求库 import json# 用于将列表字典(json格式)转化为相同形式字符串,以便存入文件 from bs4 import BeautifulSoup # 导入网页解析库 # 用于发送请求,获得网页源代码以供解析 def start_requests(url): r = requests.get(url) return r.content # 解析返回的数据 def parse(text): soup=BeautifulSoup(text,"html.parser") movie_list=soup.find_all("div",class_="item") result_list=[] for movie in movie_list: #创建字典 dict={} dict["title"]=movie.find("span",class_="title").text dict["dictrating_num"]=movie.find("span",class_="rating_num").text dict["inq"]=movie.find("span",class_="inq").text star = movie.find('div', class_='star') dict["comment_num"] = star.find_all('span')[-1].text result_list.append(dict) return result_list #将数据写入json文件 def write_json(result): s = json.dumps(result, indent = 4, ensure_ascii=False) with open('movies1.json', 'w', encoding = 'utf-8') as f: f.write(s) # 主运行函数,调用其他函数 def main(): url = 'https://movie.douban.com/top250' text = start_requests(url) result = parse(text) write_json(result) if __name__ == '__main__': main() 结果: 函数.JPG 觉得有用的话就给颗小吧~

优秀的个人博客,低调大师

前端技术探秘-Nodejs的CommonJS规范实现原理 | 京东物流技术团队

了解Node.js Node.js是一个基于ChromeV8引擎的JavaScript运行环境,使用了一个事件驱动、非阻塞式I/O模型,让JavaScript 运行在服务端的开发平台,它让JavaScript成为与PHP、Python、Perl、Ruby等服务端语言平起平坐的脚本语言。Node中增添了很多内置的模块,提供各种各样的功能,同时也提供许多第三方模块。 模块的问题 为什么要有模块 复杂的前端项目需要做分层处理,按照功能、业务、组件拆分成模块, 模块化的项目至少有以下优点: 便于单元测试 便于同事间协作 抽离公共方法, 开发快捷 按需加载, 性能优秀 高内聚低耦合 防止变量冲突 方便代码项目维护 几种模块化规范 CMD(SeaJS 实现了 CMD) AMD(RequireJS 实现了 AMD) UMD(同时支持 AMD 和 CMD) IIFE (自执行函数) CommonJS (Node 采用了 CommonJS) ES Module 规范 (JS 官方的模块化方案) Node中的模块 Node中采用了 CommonJS 规范 实现原理: Node中会读取文件,拿到内容实现模块化, Require方法 同步引用 tips:Node中任何js文件都是一个模块,每一个文件都是模块 Node中模块类型 内置模块,属于核心模块,无需安装,在项目中不需要相对路径引用, Node自身提供。 文件模块,程序员自己书写的js文件模块。 第三方模块, 需要安装, 安装之后不用加路径。 Node中内置模块 fs filesystem 操作文件都需要用到这个模块 const path = require('path'); // 处理路径 const fs = require('fs'); // file system // // 同步读取 let content = fs.readFileSync(path.resolve(__dirname, 'test.js'), 'utf8'); console.log(content); let exists = fs.existsSync(path.resolve(__dirname, 'test1.js')); console.log(exists); path 路径处理 const path = require('path'); // 处理路径 // join / resolve 用的时候可以混用 console.log(path.join('a', 'b', 'c', '..', '/')) // 根据已经有的路径来解析绝对路径, 可以用他来解析配置文件 console.log(path.resolve('a', 'b', '/')); // resolve 不支持/ 会解析成根路径 console.log(path.join(__dirname, 'a')) console.log(path.extname('1.js')) console.log(path.dirname(__dirname)); // 解析父目录 vm 运行代码 字符串如何能变成 JS 执行呢? 1.eval eval中的代码执行时的作用域为当前作用域。它可以访问到函数中的局部变量。 let test = 'global scope' global.test1 = '123' function b(){ test = 'fn scope' eval('console.log(test)'); //local scope new Function('console.log(test1)')() // 123 new Function('console.log(test)')() //global scope } b() 2.new Function new Function()创建函数时,不是引用当前的词法环境,而是引用全局环境,Function中的表达式使用的变量要么是传入的参数要么是全局的值 Function可以获取全局变量,所以它还是可能会有变量污染的情况出现 function getFn() { let value = "test" let fn = new Function('console.log(value)') return fn } getFn()() global.a = 100 // 挂在到全局对象global上 new Function("console.log(a)")() // 100 3.vm 前面两种方式,我们一直强调一个概念,那就是变量的污染 VM的特点就是不受环境的影响,也可以说他就是一个沙箱环境 在Node中全局变量是在多个模块下共享的,所以尽量不要在global中定义属性 所以,vm.runInThisContext可以访问到global上的全局变量,但是访问不到自定义的变量。而vm.runInNewContext访问不到global,也访问不到自定义变量,他存在于一个全新的执行上下文 const vm = require('vm') global.a = 1 // vm.runInThisContext("console.log(a)") vm.runInThisContext("a = 100") // 沙箱,独立的环境 console.log(a) // 1 vm.runInNewContext('console.log(a)') console.log(a) // a is not defined Node模块化的实现 node中是自带模块化机制的,每个文件就是一个单独的模块,并且它遵循的是CommonJS规范,也就是使用require的方式导入模块,通过module.export的方式导出模块。 node模块的运行机制也很简单,其实就是在每一个模块外层包裹了一层函数,有了函数的包裹就可以实现代码间的作用域隔离。 我们先在一个js文件中直接打印arguments,得到的结果如下图所示,我们先记住这些参数。 console.log(arguments) // exports, require, module, __filename, __dirname Node中通过modules.export 导出,require 引入。其中require依赖node中的fs模块来加载模块文件,通过fs.readFile读取到的是一个字符串。 在javascrpt中可以通过eval或者new Function的方式来将一个字符串转换成js代码来运行。但是前面提到过,他们都有一个致命的问题,就是变量的污染。 实现require模块加载器 首先导入依赖的模块path,fs,vm, 并且创建一个Require函数,这个函数接收一个modulePath参数,表示要导入的文件路径 const path = require('path'); const fs = require('fs'); const vm = require('vm'); // 定义导入类,参数为模块路径 function Require(modulePath) { ... } 在Require中获取到模块的绝对路径,使用fs加载模块,这里读取模块内容使用new Module来抽象,使用tryModuleLoad来加载模块内容,Module和tryModuleLoad稍后实现,Require的返回值应该是模块的内容,也就是module.exports。 // 定义导入类,参数为模块路径 function Require(modulePath) { // 获取当前要加载的绝对路径 let absPathname = path.resolve(__dirname, modulePath); // 创建模块,新建Module实例 const module = new Module(absPathname); // 加载当前模块 tryModuleLoad(module); // 返回exports对象 return module.exports; } Module的实现就是给模块创建一个exports对象,tryModuleLoad执行的时候将内容加入到exports中,id就是模块的绝对路径。 // 定义模块, 添加文件id标识和exports属性 function Module(id) { this.id = id; // 读取到的文件内容会放在exports中 this.exports = {}; } node模块是运行在一个函数中,这里给Module挂载静态属性wrapper,里面定义一下这个函数的字符串,wrapper是一个数组,数组的第一个元素就是函数的参数部分,其中有exports,module,Require,__dirname,__filename, 都是模块中常用的全局变量. 第二个参数就是函数的结束部分。两部分都是字符串,使用的时候将他们包裹在模块的字符串外部就可以了。 // 定义包裹模块内容的函数 Module.wrapper = [ "(function(exports, module, Require, __dirname, __filename) {", "})" ] _extensions用于针对不同的模块扩展名使用不同的加载方式,比如JSON和javascript加载方式肯定是不同的。JSON使用JSON.parse来运行。 javascript使用vm.runInThisContext来运行,可以看到fs.readFileSync传入的是module.id也就是Module定义时候id存储的是模块的绝对路径,读取到的content是一个字符串,使用Module.wrapper来包裹一下就相当于在这个模块外部又包裹了一个函数,也就实现了私有作用域。 使用call来执行fn函数,第一个参数改变运行的this传入module.exports,后面的参数就是函数外面包裹参数exports, module, Require, __dirname, __filename。/ // 定义扩展名,不同的扩展名,加载方式不同,实现js和json Module._extensions = { '.js'(module) { const content = fs.readFileSync(module.id, 'utf8'); const fnStr = Module.wrapper[0] + content + Module.wrapper[1]; const fn = vm.runInThisContext(fnStr); fn.call(module.exports, module.exports, module, Require,__filename,__dirname); }, '.json'(module) { const json = fs.readFileSync(module.id, 'utf8'); module.exports = JSON.parse(json); // 把文件的结果放在exports属性上 } } tryModuleLoad函数接收的是模块对象,通过path.extname来获取模块的后缀名,然后使用Module._extensions来加载模块。 // 定义模块加载方法 function tryModuleLoad(module) { // 获取扩展名 const extension = path.extname(module.id); // 通过后缀加载当前模块 Module._extensions[extension](module); // 策略模式??? } 到此Require加载机制基本就写完了。Require加载模块的时候传入模块名称,在Require方法中使用path.resolve(__dirname, modulePath)获取到文件的绝对路径。然后通过new Module实例化的方式创建module对象,将模块的绝对路径存储在module的id属性中,在module中创建exports属性为一个json对象。 使用tryModuleLoad方法去加载模块,tryModuleLoad中使用path.extname获取到文件的扩展名,然后根据扩展名来执行对应的模块加载机制。 最终将加载到的模块挂载module.exports中。tryModuleLoad执行完毕之后module.exports已经存在了,直接返回就可以了。 接下来,我们给模块添加缓存。就是文件加载的时候将文件放入缓存中,再去加载模块时先看缓存中是否存在,如果存在直接使用,如果不存在再去重新加载,加载之后再放入缓存。 // 定义导入类,参数为模块路径 function Require(modulePath) { // 获取当前要加载的绝对路径 let absPathname = path.resolve(__dirname, modulePath); // 从缓存中读取,如果存在,直接返回结果 if (Module._cache[absPathname]) { return Module._cache[absPathname].exports; } // 创建模块,新建Module实例 const module = new Module(absPathname); // 添加缓存 Module._cache[absPathname] = module; // 加载当前模块 tryModuleLoad(module); // 返回exports对象 return module.exports; } 增加功能:省略模块后缀名。 自动给模块添加后缀名,实现省略后缀名加载模块,其实也就是如果文件没有后缀名的时候遍历一下所有的后缀名看一下文件是否存在。 // 定义导入类,参数为模块路径 function Require(modulePath) { // 获取当前要加载的绝对路径 let absPathname = path.resolve(__dirname, modulePath); // 获取所有后缀名 const extNames = Object.keys(Module._extensions); let index = 0; // 存储原始文件路径 const oldPath = absPathname; function findExt(absPathname) { if (index === extNames.length) { return throw new Error('文件不存在'); } try { fs.accessSync(absPathname); return absPathname; } catch(e) { const ext = extNames[index++]; findExt(oldPath + ext); } } // 递归追加后缀名,判断文件是否存在 absPathname = findExt(absPathname); // 从缓存中读取,如果存在,直接返回结果 if (Module._cache[absPathname]) { return Module._cache[absPathname].exports; } // 创建模块,新建Module实例 const module = new Module(absPathname); // 添加缓存 Module._cache[absPathname] = module; // 加载当前模块 tryModuleLoad(module); // 返回exports对象 return module.exports; } 源代码调试 我们可以通过VSCode 调试Node.js 步骤 创建文件a.js module.exports = 'abc' 1.文件test.js let r = require('./a') console.log(r) 1.配置debug,本质是配置.vscode/launch.json文件,而这个文件的本质是能提供多个启动命令入口选择。 一些常见参数如下: program控制启动文件的路径(即入口文件) name下拉菜单中显示的名称(该命令对应的入口名称) request分为 launch(启动)和 attach(附加)(进程已经启动) skipFiles指定单步调试跳过的代码 runtimeExecutable设置运行时可执行文件,默认是 node,可以设置成 nodemon,ts-node,npm 等 修改launch.json,skipFiles指定单步调试跳过的代码 将test.js 文件中的require方法所在行前面打断点 执行调试,进入源码相关入口方法 梳理代码步骤 1.首先进入到进入到require方法:Module.prototype.require 2.调试到Module._load 方法中,该方法返回module.exports,Module._resolveFilename方法返回处理之后的文件地址,将文件改为绝对地址,同时如果文件没有后缀就加上文件后缀。 3.这里定义了Module类。id为文件名。此类中定义了exports属性 4.接着调试到module.load 方法,该方法中使用了策略模式,Module._extensions[extension](this, filename)根据传入的文件后缀名不同调用不同的方法 5.进入到该方法中,看到了核心代码,读取传入的文件地址参数,拿到该文件中的字符串内容,执行module._compile 6.此方法中执行wrapSafe方法。将字符串前后添加函数前后缀,并用Node中的vm模块中的runInthisContext方法执行字符串,便直接执行到了传入文件中的console.log代码行内容。 至此,整个Node中实现require方法的整个流程代码已经调试完毕,通过对源代码的调试,可以帮助我们学习其实现思路,代码风格及规范,有助于帮助我们实现工具库,提升我们的代码思路,同时我们知道相关原理,也对我们解决日常开发工作中遇到的问题提供帮助。 作者:京东物流 乔盼盼 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

Python爬虫入门教程 55-100 python爬虫高级技术之验证码篇

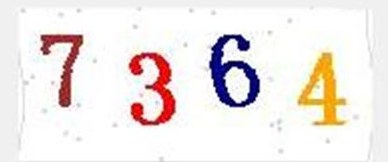
验证码探究 如果你是一个数据挖掘爱好者,那么验证码是你避免不过去的一个天坑,和各种验证码斗争,必然是你成长的一条道路,接下来的几篇文章,我会尽量的找到各种验证码,并且去尝试解决掉它,中间有些技术甚至我都没有见过,来吧,一起Coding吧 数字+字母的验证码 我随便在百度图片搜索了一个验证码,如下 今天要做的是验证码识别中最简单的一种办法,采用pytesseract解决,它属于Python当中比较简单的OCR识别库 库的安装 使用pytesseract之前,你需要通过pip 安装一下对应的模块 ,需要两个 pytesseract库还有图像处理的pillow库了 pip install pytesseract pip install pillow 如果你安装了这两个库之后,编写一个识别代码,一般情况下会报下面这个错误 pytesseract.pytes

优秀的个人博客,低调大师

Python爬虫入门教程 44-100 Charles的安装与使用-手机APP爬虫部分

1. 第二款抓包工具Charles安装与使用 Charles和Fiddler一样,也是一款抓包工具,比Fiddler界面更加清晰,支持多平台 1.1 官方网址 https://www.charlesproxy.com/ 1.2 下载地址 Charles工具下载地址:https://www.charlesproxy.com/download/ 自己去百度一款,我找了2个百度网盘的 链接挂了就不补了啊~ 链接: https://pan.baidu.com/s/1pMawsEv 密码:meuk 链接: https://pan.baidu.com/s/1kV3h0gf 密码: nqaa 下载之后,安装就比较简单了,常规操作即可 2. Charles基本操作 打开Charles在电脑上就可以使用了 2.1 PC设置抓包,包括HTTP和HTTPS 软件安装好了之

优秀的个人博客,低调大师

Python爬虫入门教程 51-100 Python3爬虫通过m3u8文件下载ts视频-Python爬虫6操作

什么是m3u8文件 M3U8文件是指UTF-8编码格式的M3U文件。M3U文件是记录了一个索引纯文本文件,打开它时播放软件并不是播放它,而是根据它的索引找到对应的音视频文件的网络地址进行在线播放。 原视频数据分割为很多个TS流,每个TS流的地址记录在m3u8文件列表中 比如我这里有一个m3u8文件,文件内容如下 #EXTM3U #EXT-X-VERSION:3 #EXT-X-MEDIA-SEQUENCE:0 #EXT-X-ALLOW-CACHE:YES #EXT-X-TARGETDURATION:15 #EXTINF:6.916667, out000.ts #EXTINF:10.416667, out001.ts #EXTINF:10.416667, out002.ts #EXTINF:1.375000, out003.ts #EXTIN

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码