首页 文章 精选 留言 我的

精选列表

搜索[知识资产沉淀],共10002篇文章
优秀的个人博客,低调大师

算法知识一一背包问题

背包问题深度讲解 一、算法本质解析 核心思想:在给定容量的背包中,从n个物品中选择若干物品装入,每个物品只能选或不选,使得总价值最大。 适用场景与边界条件: 适用于资源有限的最优选择问题 每个物品只能使用一次(0-1特性) 物品重量和价值均为正整数 背包容量为正整数 时间/空间复杂度推导: 时间复杂度:O(n×W),n为物品数量,W为背包容量,需要填充n×W的状态表 空间复杂度:O(n×W),使用

优秀的个人博客,低调大师

详解网络知识:iptables规则

本文分享自华为云社区《【理解云容器网络】1-基础篇-iptables介绍》,作者: 可以交个朋友。 iptables规则 下图为数据包到达linux主机网卡后,内核如何处理数据包的大致流程 什么是规则 规则是管理员对数据包制定的一种触发机制,即当数据包达到某种条件,就执行指定的动作。 条件:可以是数据包源地址、目的地址、协议等 动作:可以是拒绝、接受、丢弃等;详细介绍见下表 动作 说明 ACCEPT 将封包放行,进行完此处理动作后,将不再比对其它规则,直接跳往下一个规则链(nat:postrouting) REJECT 拦阻该封包,并传送封包通知对方,可以传送的封包有几个选择:ICMP port-unreachable、ICMP echo-reply 或是 tcp-reset(这个封包会要求对方关闭联机),进行完此处理动作后,将不再比对其它规则,直接 中断过滤程序。 DROP 丢弃封包不予处理,进行完此处理动作后,将不再比对其它规则,直接中断过滤程序。 MASQUERADE 改写封包来源 IP 为防火墙 NIC IP,可以指定 port 对应的范围,进行完此处理动作后,直接跳往下一个规则炼(mangle:postrouting)。这个功能与 SNAT 略有不同,当进行 IP 伪装时,不需指定要伪装成哪个 IP,IP 会从网卡直接读取,当使用拨接连线时,IP 通常是由 ISP 公司的 DHCP 服务器指派的,这个时候 MASQUERADE 特别有用。 SNAT 改写封包来源 IP 为某特定 IP 或 IP 范围,可以指定 port 对应的范围,进行完此处理动作后,将直接跳往下一个规则炼(mangle:postrouting)。 DNAT 改写封包目的地 IP 为某特定 IP 或 IP 范围,可以指定 port 对应的范围,进行完此处理动作后,将会直接跳往下一个规则炼(filter:input 或 filter:forward)。 MARK 将封包标上某个代号,以便提供作为后续过滤的条件判断依据,进行完此处理动作后,将会继续比对其它规则。 RETURN 结束在目前规则炼中的过滤程序,返回主规则炼继续过滤,如果把自订规则炼看成是一个子程序,那么这个动作,就相当于提早结束子程序并返回到主程序中。 使用iptables命令写入规则示例: iptables -t filter -A INPUT -i eth0 -p tcp -s 192.168.1.0/24 -m multiport --dports 443,80 -j ACCEPT #-t:操作那个表 #-A:在表末追加规则;-I为表首插入规则、-D为删除规则 #INPUT:链名称;该规则在那条链上生效 #-j:数据包处理动作;比如接受、拒绝等 整条命令解释:允许经过本机网卡eth0,访问协议是TCP,源地址是192.168.1.0/24 段的数据包访问本地端口是80和443的服务 什么是表 表主要用来存放具体的防火墙规则,而规则具有功能性,比如修改数据包源/目的ip、拒绝来自某个网段的数据包访问本机等;所以我们可以对规则进行分类,不同的功能存入不同的表 raw表:主要用于决定数据包是否被状态跟踪机制处理 mangle表:主要用于拆解报文修改数据包的 IP 头信息 nat表:主要用于修改数据包的源地址和目的地址、端口号等信息(实现网络地址转换,如SNAT、DNAT、MASQUERADE、REDIRECT)。 filter表:主要用于对过滤流入和流出的数据包,根据具体的规则决定是否放行该数据包 security 表:最不常用的表,用在 SELinux 上;用于强制访问控制(MAC)网络规则,由Linux安全模块(如SELinux)实现 其中nat表和filter表最常用 什么是链 上文提到表主要存放具体的规则,但是规则什么时候生效呢?比如客户端访问VIP,数据包到达本机后必须先用DNAT(网络地址转换)将vip转换成实际的后端实例ip,然后才能路由判断,因为后端实例可能有多个且分布在不同主机,直接用vip进行路由判断肯定是不行的。所以规则有生效时机,根据生效时机可以分为: PREROUTING:在数据包到达防火墙时,进行路由判断之前执行的规则 INPUT:路由判断之后确定数据包流入本机,应用其规则 FORWARD:路由判断之后确定数据包要转发给其他主机,应用其规则;linux主机需要开启ip_forward功能才支持转发,在/etc/sysctl.conf文件中配置参数net.ipv4.ip_forward=1 OUTPUT:本机应用向外发出数据包时,应用其规则 POSTROUTING:在数据包离开防火墙时进行路由判断之后执行的规则 在每条链中,规则按照从上到下的顺序进行匹配,当一个数据包与某个规则匹配成功后,就会按照该规则的动作进行处理,并且后续的规则将不再被考虑。 表、链、规则三者的关系是什么 表是区分相同链的上下顺序,规则在每条链中的上下顺序确定规则执行顺序: 如果规则来自不同表,通过表的优先级确定链的优先级: 比如完整的PREROUTING链中有来自raw表、mangle表、nat标的PREROUTING链规则,通过表优先级(raw>mangle>nat>filter>security)区分优先级。所以一个报文发送到某台虚拟机后,被虚拟机网卡接收,会进入的虚拟机网络协议栈处理,先经过PREROUTING链处理,具体来说先走raw表的PREROUTING规则、再走mangle表、最后在走nat表PREROUTING规则。 如果规则来自同一个表,则按规则插入表的顺序自上而下。 数据报文进/出节点经过哪些规则 对于客户端来说,发送报文过程 先进入OUTPUT链处理(raw、mangle、nat、filter、security表对应的PREROUTING规则依次匹配),如果没有被拦截则根据路由选择出网口,再进入POSTROUTING链处理(mangle、nat表对应的POSTROUTING规则依次匹配),最后从网卡出去 对于服务端来说,发送报文过程 先进入PREROUTING链处理(raw、mangle、nat表对应的PREROUTING规则依次匹配),根据路由判断数据报文发给本机,报文进入INPUT链处理(mangle、nat、filter、security表对应的INPUT规则依次匹配),如果没有被拦截则报文被应用程序处理 对于转发场景,发送报文过程 先进入PREROUTING链处理(raw、mangle、nat表对应的PREROUTING规则依次匹配),根据路由判断数据报文不是发给本机,报文进入FORWARD链处理(mangle、filter、security表对应的FORWARD规则依次匹配),如果没有被拦截则进入POSTROUTING链处理(mangle、nat表对应的POSTROUTING规则依次匹配),最后从网卡出去 *补充:转发场景需要Linux开启转发功能,否则数据报文进入FORWARD链直接丢弃;临时开启执行命令sysctl net.ipv4.ip_forward=1或者echo "1" >/proc/sys/net/ipv4/ip_forward;永久生效需要修改/etc/sysctl.conf,增加内容net.ipv4.ip_forward = 1保存,再执行命令:sysctl -p NAT(网络地址转换)介绍 NAT应用最广的场景就是解决局域网内设备访问互联网的问题。SNAT(源地址转换)主要用于修改数据包的源IP和源端口,一般在nat表的PREROUTING链中增加规则:局域网内所有设备要上外网,如果每个设备都分配一个公网ip成本太大,可以在路由器出口分配一个公网ip,局域网内的设备访问外网时统一走路由器出口,路由器此时需要做两件事: 数据包从出口出去之前,将数据包的源地址和源端口改成公网ip和随机端口 同时将转换关系记录保存,响应数据包返回时根据记录转发给局域网内的设备 SNAT示例: iptables -t nat -A POSTROUTING -d 192.168.1.11 -p tcp --dport 88 -j SNAT --to-source 122.9.3.47:88 # -j:值为SNAT需要静态指定修改后的值,值为MASQUERADE表示动态修改源地址为出口网卡地址 # --to-source:将数据包的源地址转换成指定值 # 整条命令解释:将发给192.168.1.11:88的数据包,其源地址改为122.9.3.47 DNAT(目的地址转换)主要用于修改数据包目的地址和端口路由器,一般在nat表中的PREROUTING链中增加规则:接收到数据包后,将目的地址和目的端口根据转换规则修改为实际的内网地址,规则需要提前在路由器上手动添加,如下图:将访问公网ip 100...155:10022的数据包转发给内网设备172.30.100.136:22 DNAT示例: iptables -t nat -A PREROUTING -d 202.12.10.100 -p tcp --dport 20022 -j DNAT --to-destination 192.168.10.11:22 # --to-destination:修改数据包的目的地址 # 整条命令解释:将发给202.12.10.100:20022的数据包,其目的地址改为192.168.10.11:22 注意:linux内核使用CONNTRACK表(连接跟踪)记录NAT转换关系,一个连接仅在首次经过iptables链条时会计算nat表,一旦conntrack记录下这次的改写关系,后续无论是去程包还是回程包都是依据conntrack表进行改写关系的处理,不会再重复执行nat表中的DNAT/SNAT规则 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

面试必备:nginx知识梳理

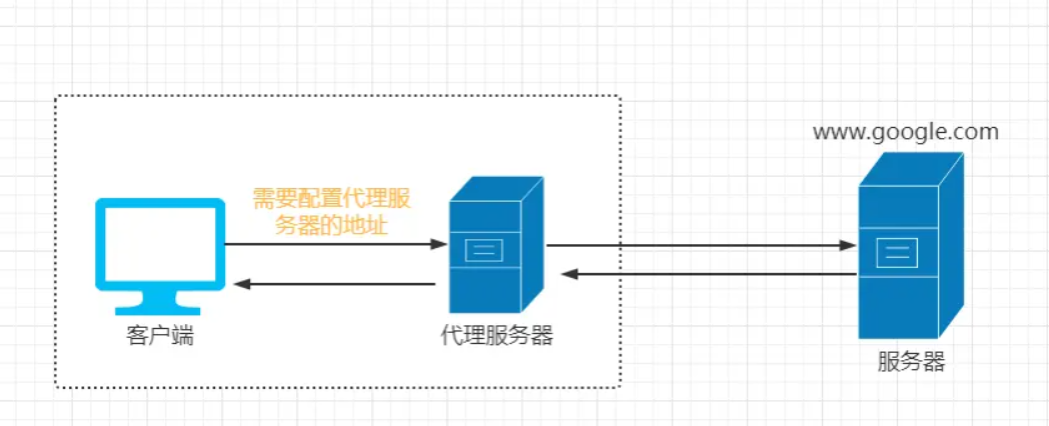
前言 完整实例可用于参考学习使用。地址: http://github.crmeb.net/u/defu Nginx概念 Nginx 是一个高性能的 HTTP 和反向代理服务。其特点是占有内存少,并发能力强,事实上nginx的并发能力在同类型的网页服务器中表现较好。 Nginx 专为性能优化而开发,性能是其最重要的考量指标,实现上非常注重效率,能经受住高负载的考验,有报告表明能支持高达50000个并发连接数。 在连接高并发的情况下,Nginx 是 Apache 服务不错的替代品:Nginx 在美国是做虚拟主机生意的老板们经常选择的软件平台之一。 反向代理 在说反向代理之前,先来说说什么是代理和正向代理。 代理 代理其实就是一个中介,A和B本来可以直连,中间插入一个C,C就是中介。刚开始的时候,代理多数是帮助内网client(局域网)访问外网server用的。 后来出现了反向代理,反向这个词在这儿的意思其实是指方向相反,即代理将来自外网客户端的请求转发到内网服务器,从外到内。 正向代理 正向代理即是客户端代理,代理客户端,服务端不知道实际发起请求的客户端。 正向代理类似一个跳板机,代理访问外部资源。 比如我们国内访问谷歌,直接访问访问不到,我们可以通过一个正向代理服务器,请求发到代理服服务上,代理服务器能够访问谷歌,这样由代理去访问谷歌取到返回数据,再返回给我们,这样我们就能访问谷歌了。 反向代理 反向代理即是服务端代理,代理服务端,客户端不知道实际提供服务的服务端。 客户端是感知不到代理服务器的存在。 是指以代理服务器来接受 Internet 上的连接请求,然后将请求转发给内部网络上的服务器,并将从服务器上得到的结果返回给 Internet 上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。 负载均衡 关于负载均衡,先来举个例子: 地铁大家应该都坐过吧,我们一般在早高峰乘地铁时候,总有那么一个地铁口人最拥挤,这时候,一般会有个地铁工作人员A拿个大喇叭在喊“着急的人员请走B口,B口人少车空”。而这个地铁工作人员A就是负责负载均衡的。 为了提升网站的各方面能力,我们一般会把多台机器组成一个集群对外提供服务。然而,我们的网站对外提供的访问入口都是一个的,比如www.taobao.com。那么当用户在浏览器输入www.taobao.com的时候如何将用户的请求分发到集群中不同的机器上呢,这就是负载均衡在做的事情。 负载均衡(Load Balance),意思是将负载(工作任务,访问请求)进行平衡、分摊到多个操作单元(服务器,组件)上进行执行。是解决高性能,单点故障(高可用),扩展性(水平伸缩)的终极解决方案。 Nginx提供的负载均衡主要有三种方式:轮询,加权轮询,Ip hash。 轮询 nginx默认就是轮询其权重都默认为1,服务器处理请求的顺序:ABCABCABCABC.... upstream mysvr { server 192.168.8.1:7070; server 192.168.8.2:7071; server 192.168.8.3:7072; } 复制代码 加权轮询 根据配置的权重的大小而分发给不同服务器不同数量的请求。如果不设置,则默认为1。下面服务器的请求顺序为:ABBCCCABBCCC.... upstream mysvr { server 192.168.8.1:7070 weight=1; server 192.168.8.2:7071 weight=2; server 192.168.8.3:7072 weight=3; } 复制代码 ip_hash iphash对客户端请求的ip进行hash操作,然后根据hash结果将同一个客户端ip的请求分发给同一台服务器进行处理,可以解决session不共享的问题。 upstream mysvr { server 192.168.8.1:7070; server 192.168.8.2:7071; server 192.168.8.3:7072; ip_hash; } 复制代码 动静分离 动态与静态页面区别 静态资源: 当用户多次访问这个资源,资源的源代码永远不会改变的资源(如:HTML,JavaScript,CSS,img等文件)。 动态资源:当用户多次访问这个资源,资源的源代码可能会发送改变(如:.jsp、servlet 等)。 什么是动静分离 动静分离是让动态网站里的动态网页根据一定规则把不变的资源和经常变的资源区分开来,动静资源做好了拆分以后,我们就可以根据静态资源的特点将其做缓存操作,这就是网站静态化处理的核心思路。 动静分离简单的概括是:动态文件与静态文件的分离。 为什么要用动静分离 为了加快网站的解析速度,可以把动态资源和静态资源用不同的服务器来解析,加快解析速度。降低单个服务器的压力。 Nginx安装 windows下安装 1、下载nginx nginx.org/en/download… 下载稳定版本。以nginx/Windows-1.20.1为例,直接下载 nginx-1.20.1.zip。 下载后解压,解压后如下: 2、启动nginx 直接双击nginx.exe,双击后一个黑色的弹窗一闪而过 打开cmd命令窗口,切换到nginx解压目录下,输入命令 nginx.exe ,回车即可 3、检查nginx是否启动成功 直接在浏览器地址栏输入网址 http://localhost:80 回车,出现以下页面说明启动成功! Docker安装nginx 我之前的文章也讲过Linux下安装的步骤,我采用的是docker安装的,很简单。 相关链接如下:Docker(三):Docker部署Nginx和Tomcat 1、查看所有本地的主机上的镜像,使用命令docker images 2、创建 nginx 容器 并启动容器,使用命令docker run -d --name nginx01 -p 3344:80 nginx 3、查看已启动的容器,使用命令docker ps 浏览器访问服务器ip:3344,如下,说明安装启动成功。 注意:如何连接不上,检查阿里云安全组是否开放端口,或者服务器防火墙是否开放端口! linux下安装 1、安装gcc 安装 nginx 需要先将官网下载的源码进行编译,编译依赖 gcc 环境,如果没有 gcc 环境,则需要安装: yum install gcc-c++ 复制代码 2、PCRE pcre-devel 安装 PCRE(Perl Compatible Regular Expressions) 是一个Perl库,包括 perl 兼容的正则表达式库。nginx 的 http 模块使用 pcre 来解析正则表达式,所以需要在 linux 上安装 pcre 库,pcre-devel 是使用 pcre 开发的一个二次开发库。nginx也需要此库。命令: yum install -y pcre pcre-devel 复制代码 3、zlib 安装 zlib 库提供了很多种压缩和解压缩的方式, nginx 使用 zlib 对 http 包的内容进行 gzip ,所以需要在 Centos 上安装 zlib 库。 yum install -y zlib zlib-devel 复制代码 4、OpenSSL 安装 OpenSSL 是一个强大的安全套接字层密码库,囊括主要的密码算法、常用的密钥和证书封装管理功能及 SSL 协议,并提供丰富的应用程序供测试或其它目的使用。 nginx 不仅支持 http 协议,还支持 https(即在ssl协议上传输http),所以需要在 Centos 安装 OpenSSL 库。 yum install -y openssl openssl-devel 复制代码 5、下载安装包 手动下载.tar.gz安装包,地址:nginx.org/en/download… 下载完毕上传到服务器上 /root 6、解压 tar -zxvf nginx-1.20.1.tar.gz cd nginx-1.20.1 复制代码 7、配置 使用默认配置,在nginx根目录下执行 ./configue make make install 复制代码 查找安装路径: whereis nginx 8、启动 nginx ./nginx 复制代码 启动成功,访问页面:ip:80 Nginx常用命令 注意:使用Nginx操作命令前提,必须进入到Nginx目录 /usr/local/nginx/sbin 1、查看Nginx版本号:./nginx -v 2、启动 Nginx:./nginx 3、停止 Nginx:./nginx -s stop 或者./nginx -s quit 4、重新加载配置文件:./nginx -s reload 5、查看nginx进程:ps -ef|grep nginx Nginx配置文件 Nginx配置文件的位置:/usr/local/nginx/conf/nginx.conf Nginx配置文件有3部分组成: 1、全局块 从配置文件开始到 events 块之间的内容,主要会设置一些影响 nginx 服务器整体运行的配置指令,比如:worker_processes 1。 这是 Nginx 服务器并发处理服务的关键配置,worker_processes 值越大,可以支持的并发处理量也越多,但是会受到硬件、软件等设备的制约。一般设置值和CPU核心数一致。 2、events块 events 块涉及的指令主要影响 Nginx 服务器与用户的网络连接,比如:worker_connections 1024 表示每个 work process 支持的最大连接数为 1024,这部分的配置对 Nginx 的性能影响较大,在实际中应该灵活配置。 3、http块 http { include mime.types; default_type application/octet-stream; sendfile on; keepalive_timeout 65; server { listen 80;#监听端口 server_name localhost;#域名 location / { root html; index index.html index.htm; } error_page 500 502 503 504 /50x.html; location = /50x.html { root html; } } } 复制代码 这算是 Nginx 服务器配置中最频繁的部分。 演示示例 反向代理/负载均衡 我们在windows下演示,首先我们创建两个springboot项目,端口是9001和9002,如下: 我们要做的就是将localhost:80代理localhost:9001和localhost:9002这两个服务,并且让轮询访问这两个服务。 nginx配置如下: worker_processes 1; events { worker_connections 1024; } http { include mime.types; default_type application/octet-stream; sendfile on; keepalive_timeout 65; upstream jiangwang { server 127.0.0.1:9001 weight=1;//轮询其权重都默认为1 server 127.0.0.1:9002 weight=1; } server { listen 80; server_name localhost; #charset koi8-r; #access_log logs/host.access.log main; location / { root html; index index.html index.htm; proxy_pass http://jiangwang; } } } 复制代码 我们先将项目打成jar包,然后命令行启动项目,然后在浏览器上访问localhost来访问这两个项目,我也在项目中打印了日志,操作一下来看看结果,是不是两个项目轮询被访问。 可以看到,访问localhost,这两个项目轮询被访问。 接下来我们将权重改为如下设置: upstream jiangwang { server 127.0.0.1:9001 weight=1; server 127.0.0.1:9002 weight=3; } 复制代码 重新加载一个nginx的配置文件:nginx -s reload 加载完毕,我们再访问其localhost,观察其访问的比例: 结果显示,9002端口的访问次数与9001访问的次数基本上是3:1。 动静分离 1、将静态资源放入本地新建的文件里面,例如:在D盘新建一个文件data,然后再data文件夹里面在新建两个文件夹,一个img文件夹,存放图片;一个html文件夹,存放html文件;如下图: 2、在html文件夹里面新建一个a.html文件,内容如下: <!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title>Html文件</title> </head> <body> <p>Hello World</p> </body> </html> 复制代码 3、在img文件夹里面放入一张照片,如下: 4、配置nginx中nginx.conf文件: location /html/ { root D:/data/; index index.html index.htm; } location /img/ { root D:/data/; autoindex on;#表示列出当前文件夹中的所有内容 } 复制代码 5、启动nginx,访问其文件路径,在浏览器输入http://localhost/html/a.html,如下: 6、在浏览器输入http://localhost/img/ Nginx工作原理 mater&worker master接收信号后将任务分配给worker进行执行,worker可有多个。 worker如何工作 客户端发送一个请求到master后,worker获取任务的机制不是直接分配也不是轮询,而是一种争抢的机制,“抢”到任务后再执行任务,即选择目标服务器tomcat等,然后返回结果。 worker_connection 发送请求占用了woker两个或四个连接数。 普通的静态访问最大并发数是:worker_connections * worker_processes/ 2 ,若是 HTTP 作为反向代理来说,最大并发数量应该是 worker_connections * worker_processes/ 4 。当然了,worker数也不是越多越好,worker数和服务器的CPU数相等时最适宜的。 优点 可以使用 nginx –s reload 热部署,利用 nginx 进行热部署操作每个 woker 是独立的进程,若其中一个woker出现问题,其他继续进行争抢,实现请求过程,不会造成服务中断。 总结 关于 Nginx 的基本概念、安装教程、配置、使用实例以及工作原理,本文都做了详细阐述。希望本文对你有所帮助。 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 !

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册