首页 文章 精选 留言 我的

精选列表

搜索[全栈壁垒],共10005篇文章
优秀的个人博客,低调大师

Python全栈 MySQL 数据库 (SQL查询、备份、恢复、授权)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 今天接着昨天的说 索引有4种: 普通 索引 : index 唯一索引: unique 主键索引: primary key 外键索引: foreign key 索引查询命令: show index from 表名\G; Non_Unique:1 :index Non_Unique:0 :unique 外键索引(foreign key): 定义:让当前字段的值 在另一个表的范围 内选择 语法: foreign key(参考字段名) references 主表(被参考字段名) on delete 级联动作 on update 级联动作 使用规则: 主表、 从表字段 数据类型要一致 主表 被参考字段一般是: 主键 删除外键: alter table 表名 drop foreign key 外键名; 外键名查询:show create table 表名; 级联动作: cascade 级联 删除、更新(只限于参考字段) restrict(默认) 从表有相关 记录, 不允许主表操作 set NULL 主表删除、更新, 从表关联记录 字段值为NULL 已有表添加外键: alter table 表名 add foreign key(参考字段)reference主表(被参考字段) on delete ... on update ... 表的复制 复制表: create table 表名 select... from where 表名; 表结构: create table 表名 select * from 表名 where false; 注意: 复制表的时候 不会把原表的 键(key)属性复制过来 SQL 查询(高级) 嵌套查询(子查询): 定义: 把内层 查询结果作为外层的 查询条件 语法格式: select ...from 表名 where 条件(select...); 多表查询: 两种方式 1. select 字段名列表 from 表名列表;(笛卡尔积) select * from t1,t2 select t1.name,t2.name from t1,t2; 2. select t1.name,t2.name from t1,t2 where 条件 链接查询: 1.内链接 select 字段名 from 表1 inner join 表2 on 条件 inner join 表3 on 条件...; 2.外链接 1.左链接 以左表为主显示查询结果 select 字段名 from 表1 left join 表2 on 条件 left join 表3 on 条件...; 2.右链接 以右表为主显示查询结果 select字段名 from 表1 right join 表2 on 条件 right join 表3 on 条件...; 数据备份: mysqldump 在Linux终端操作 完全备份: mysqldump -u用户 -p源库名 > ~/xxx.sql --all-databases 备份所有库 库名 备份单个库 -B 库1 库2.. 备份多个库 库名 表1 表2... 备份指定库指定表 数据恢复: 恢复单个库 mysql -uroot -p < 目标库名 xxx.sql 从所有库备份中恢复某一个库(-one-database) mysql -uroot -p --one-database 目标库名 < xxx.sql 注意: 1. 恢复库 时如果 恢复到原库会将 表中的 数据覆盖, 新增表不会删除 2.数据恢复时 如果恢复的 库不存在,则 必须先创建空库 MySQL的账户管理: 1.开启mysql的远程连接 sudo -i cd /etc/mysql/mysql.conf.d/ subl mysql.cnf #bind-address = 127.0.0.1 注释掉 /etc/init.d/mysql restart 2.添加授权用户 用root用户登录mysql mysql -uroot -p123456 授权: grant 授权列表 on 库.表 to “用户名“@”%” identified by “密码” with grant option 权限列表: all privileges、select、insert 库.表: *.* 所有库所有表 示例: 1、添加授权用户tiger,密码123,对所有库的所有表有所有权限 grant all privileges on *.* to "tiger"@"%" identified by "123" with grant option;

优秀的个人博客,低调大师

Python全栈 MySQL 数据库 (简述 、安装、基本命令)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 一个月的python已经结束了 下面就是数据库了 先说MySQL 这个数据库应该差不多是用户量最多的了 MySQL概述:1.什么是数据库: 存储数据的厂库2.有哪些公司在用数据库 金融机构、游戏网站、购物网站、论坛网站...3.提供数据库服务的软件: 1.软件的分类: MySQL、Oracle、SQL_Server、DB2、MongoDB、MariaDB 2.生产环境中,如何选择使用哪些数据库软件: 1.是否开源 1.开源软件:MySQL、Mariadb、MongoDB 2.商业软件:Oracle、DB2、SQL_Server 2.是否跨平台 1.不过平台:SQL_Server 2.跨平台:...... 3.公司的类型: 商业软件:政府部门、金融机构 开源软件:游戏网站、购物网站、论坛网址站 4.MySQL的特点: 1.关系型数据库 1.关系型数据库的特点 1.数据是以行和列(表格)的形式存储的 2.表格到的每一行是一条记录 ,没一列叫一个字段 3.表与表之间的逻辑关联叫关系 2.示例: 1.关系型数据库: 表1 学生信息表 姓名 年龄 班级 张三 25 三班 李四 25 六班 表2 班级信息表 班级 班主任 三班 大空翼 六班 松人 寻找张三的班主任是谁 通过两张表的关联关系能查询出来(查询功能强大) 2.非关系型数据库 {”姓名“:“张三”, ”年龄“:25, “班主任”} 以字典的形式存储 键值对形式纯在的 如果没有则则无法找到 (查询速度快) 2. 跨平台: 可以在Windows、Unix、Linux、上运行数据库服务 3. 支持多种编程语言 Python、Java、PHP.... 5.数据库软件、数据库、数据厂库的概念 1.数据库软件: 就是一个软件,看的见、可操作、是现实数据的逻辑功能 2.数据库: 是一种逻辑概念,用来存放数据的厂库,侧重于存储 3.数据厂库 从数据量来说,比数据库庞大的多,主要用于数据分析和数据挖掘 那个时间段用户登录最多,那个用户一年购物最多 MySQL的安装 1.Ubuntu安装MySQL服务 1.安装服务端 sudo apt-get install mysql-server apt-get系统自带到的安装服务 2.安装客户端 sudo apt-get install mysql-client 3.Ubuntu安装软件: 1.sudo apt-get update 访问源列表中的每个网址,读取软件列表,保存到本地 /var/lib/apt/lists 2.sudo apt-get upgrade 把本地已安装的软件与刚下的列表进行对比 如果发现已安装的软件版本低 则全部更新 3.sudo apt-get -f install 修复依赖关系 2.启动和链接MySQL服务 1.服务端启动 1.查看状态 sudo /etc/init.d/mysql status (查询) 2.启动 sudo /etc/init.d/mysql start (启动) sudo /etc/init.d/mysql stop (停止) sudo /etc/init.d/mysql restart(重启) sudo /etc/init.d/mysql reload(重新加载配置文件) 2.客户端链接 1.命令格式 mysql -h主机地址 -u用户名 -p密码 mysql -hlocalhost -uroot -p123456SQL命令的使用规则: 1.没填命令必须以 ; 结尾 2.SQL不区分大小写 3.使用\c 来终止当前命令执行2.库的管理: 1.库的基本操作 1.查看已有的库 show databases; 2.创建库 create database 库名; create database 库名 character set utf8;(字符编码) 3.查看创建库的语句(字符集) show create database 库名; 4.查看当前所在的库: select database(): 5.切换库 use 库名; 6.查看库中已有的表 show tables; 7.删除库 drop database 库名; 库名的命名规则: 1.数字、字母、下划线,但是不能使用纯数字 2.库的名字区分大小写 3.不能使用特殊字符和MySQL关键字 3. 表的管理2.表的基本操作 1.查看表 show tables 2.创建表 create table 表名( 字段名 数据类型, 字段名 数据类型, ....... ); 3.查看已有表的字符集 show create table 表名; 4.查看表结构 desc 表名; 5.删除表 drop table 表名;3.注意: 1.所有的数据都是以文件的形式存放在数据库根目录下 2.数据目录:/var/lib/mysql 4.mac安装mysql 1.cd 2.vi.bash_profile 添加:PATH=“$PATH”:/usr/local/myswl/bin 3.source .bash_profile5.表记录管理 1.插入(insert) 1.insert into 表名 values(值1),(值2).....; 2.insert into 表名(字段1,.....)values(值1),....; 2.查询(select) select * from 表名 [where 条件] 查询所有字段; select 字段名1,字段名2,... form 表名 [where 条件]; 6.如何更改默认字符集 1.方法(通过更改mysql配置文件实现) 2.步骤 1.获取root权限 sudo -i 2.cd /etc/mysql/mysql.conf.d/ 3.备份:cp mysql.cnf mysqld.cnf.bak 4.subl mysqld.cnf [mysqld] character_set_server = utf8 5.重启mysql服务 /etc/init.d/mysql7. 客户端把数据存储到数据库服务器上的过程 1.链接到数据库服务器 mysql -uroot -p123456 2.选择一个库 use 库名 3.创建表/修改表 update 表名... 4.断开与数据数据库链接 exit;| quit; | \q8.数据类型 1.数字类型 1.整型 1.int 大整型(4个字节) 取值范围:2**32 - 1(4294967295) 2.tinyint 微小整型(一个字节) 1.有符号(signed默认):-128 ~ 127 2.无符号(unsigned):0 ~ 255 3.smallint 小整型(2字节) 4.bigint 极大整型(8字节) 2.浮点型 1.float(4个字节,最多显示7个有效位) 1.用法: 字段名 float(m,n) m:总位数 n:小数位数 float(5,2)取值范围? -999.99 ~ 999.99 2.decimal(最多显示28个有效位) decimal(m,n) 存储空间(整数、小数分开存储) 规则:将9的倍数包装成4个字节 余数 字节 0 0 1-2 1 3-4 2 5-6 3 7-9 4 示例decimal(19,9) 整数部分: 10/9 = 1 % 1 4字节+1字节=5字节 小数部分: 9/9 = 1 % 0 4字节+0字节=4字节 共占:9字节 2.字符类型 1.char(定长) 1.取值范围:1~255 2.varcahr(变长) 1.取值范围:1~65535 3.text / longtext(存储范围:4G)/blob /longblob(4G)char和varchar的特点: 1.cahr:浪费储存空间,性能高 2.varchar:节省储存空间,性能低 3、练习 1、创建库testdb,指定字符集为 utf8 2、进入到库 testdb 3、查看当前所在库 4、创建库 testdb2,指定字符集为 latin1 5、进入到库 testdb2 6、查看 testdb2 的字符集(查看创建库的语句) 7、删除库 testdb 8、删除库 testdb2答案: create database testdb character set utf8; use testdb; select database(); create database testdb2 character set latin1; use testdb2; show create database testdb2; drop database testdb; drop database testdb2; 2、练习 1、创建库python1 2、在python1库中创建表 pymysql并指定字符集为utf8,字段有三个:id 、name char(15) 、 age 3、查看创建表pymysql的语句 4、查看pymysql的表结构 5、删除表pymysql 6、创建库python2 7、在python2中创建表t1并指定字符集为utf8,字段有 id 、name 、score,数据类型自己定义 8、查看t1的表结构 9、删除表t1 10、删除库 python2 答案: create database python1; use python1; create table pymysql( id int, name char(15), age int ) character set utf8; show create table pymysql; desc pymysql; drop table pymysql; create database python2; use python2; create table t1( id int, name char(15), score float(5,2) ) character set utf8; desc t1; drop table t1; drop database python2; 3、练习 1、查看所有的库 2、创建新库 studb 3、在 studb 中创建表 tab1 ,指定字符集utf8,字段有 id 、name、age 4、查看tab1的表结构 5、在tab1中随便插入2条记录 6、在tab1中的name、age两个字段插入2条记录 7、查看tab1中所有记录 8、查看tab1表中所有人的姓名和年龄 9、查看tab1表中年龄大于20的信息答案: show databases; create database studb; use studb; create table tab1( id int, name char(10), age int )character set utf8; desc tab1; insert into tab1 values (1,"张三丰",100),(2,"张无忌",30); insert into tab1(name,age) values ("金毛狮王",88),("紫衫龙王",87); select * from tab1; select name,age from tab1; select * from tab1 where age>20; 3、练习 1、创建库 studb2 ,并在库中创建表 stuinfo,要求: id :大整型 name :字符类型,宽度为15 age :微小整型,不能为负数 height :浮点型,小数位为2位(float) money :浮点型,小数位为2位(decimal) 2、查看stuinfo的表结构 3、查看stuinfo的默认字符集 4、在表中插入1条完整记录 5、查询所有表记录 6、在表中id 、name两个字段插入2条记录 7、查询所有学生的id和姓名答案: create table stuinfo( id int, name char(15), age tinyint unsigned, height float(5,2), money decimal(20,2) ); desc stuinfo; insert into stuinfo values (1,"Bob",23,176,88888.88); select * from stuinfo; insert into stuinfo(id,name) values (2,"Jim"),(3,"Tom"); select id,name from stuinfo; 8、作业1、MySQL中数据类型有:____ ____ 枚举类型 日期时间类型 整数型、字符型2、关系型数据库中的核心内容是 ___ 即 二维表 关系3、简述客户端把数据存储到数据库服务器上的过程 链接数据库 切换的相应的库 找到相应的表格进行操作 断开数据库链接4、char和varchar的区别,各自的特点 char:浪费储存空间 但性能高 varcchar:节省存储空间 但性能低5、操作 1、创建一个学校的库 school 2、在库中创建表 students 用来存储学生信息: id 大整型 姓名、年龄(不能为负)、性别、成绩(浮点) 3、查看students的表结构 4、在表中随意插入3条记录 5、在表中的 姓名、成绩两个字段插入3条记录 6、查看所有学生的姓名和成绩 8、查看成绩及格(>60分)的学生的姓名和成绩 答案: create database school; use school; create table students( id int, name char(15), age tinyint unsigned, gender char(2), score float(5,2) ); desc students; insert into students values (1,"张三",20,"男",95.56), (2,"李四",21,"男",98.30), (3,"王浅",21,"女",100); insert into students (name,score) values ("tom",60), ("lili",56), ("zhao",58.56); select name,score from sutdents; select name,score from students where score>=60;

优秀的个人博客,低调大师

Python全栈工程师(异常(高级)、运算符重载)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 对象的属性管理函数: getattr(obj, name[,default) 从对象得到对象的属性,getattr(x, “y”) 等同于x, y 当属性 不存在时 如果给出default参数则返回default 如果没有给出default ,则产生一个AttributeError错误 hasattr(obj, name)用给定的name返回对象obj是否有此属性 此种做法可以避免在getattr(obj,name)时引发错误 setattr(obj, name, value) 给对象obj的名为name的 属性设置相应的值value, set(x, 'y', v) 等同于 x.y = v delattr(obj, name) 删除对象obj中的name属性 , delattr(x, 'y') 等同于 del x.y 示例: class Dog: pass d = Dog() d.color = "白色" v = getattr(d, "color") # 等同于 v = d.color v = getattr(d, "kinds") # 出错,没有d.kinds属性 v = getattr(d, "kinds", "没有这个属性") # v= '没有这个属性' hasattr(d, 'color') # True hasattr(d, 'kinds') # False setattr(d, 'kinds', '京巴') # 等同于d.kinds ='京巴' hasattr(d, 'kinds') # True delattr(d, 'kinds') # 等同于 del d.kinds hasattr(d, 'kinds') # False 异常(高级): 可以用于异常的语句 try-except # 捕获异常,得到通知 try-finally # 左任何流程(正常/异常)都必须执行要执行的语句 raise # 发送异常 assert # 根据条件发送异常通知with 语句: 语法: with 表达式1[as 变量1], 表达式2[as 变量2].... 作用: 使用与对资源进行访问的场合,确保使用过程中不管 是否发生异常都会执行必要的“清理操作”,并释放资源 (如: 文件使用后自动关闭,线程中锁的自动获取和释放等) 说明: 执行表达式,as子句中的变量绑定生成的对象 with语句并不改变异常的状态示例: # with语句打开文件和自动关闭 try: with open("a.txt") as f: for x in f: print(x) int("abc") # 出现异常 except OSError: print("文件打开失败") except ValueError: print("文件操作过程中错误") # try-finally语句打开文件和关闭 try: f = open("a.txt") for x in f: print(x) except OSError: print("打开文件失败") except ValueError: print("文件操作过程中错误") finally: f.close() # 修改原来的copy文件功能 src_filename = input("请输入源文件路径名: ") dst_filename = input('请输入目标文件路径名: ') try: with open(src_filename, 'rb') as src,\ open(dst_filename, 'wb') as dst: # 打开源文件用来读数据 while True: b = src.read(4096) if not b: # 已经再也读不到数据了 break dst.write(b) print("复制成功") except OSError: print("复制失败") 环境管理器: 类内有__enter__和__exit__实例方法的类被称为环境管理器 能够用with进行管理的对象必须是环境管理器 说明: __enter__将在进入with语句时被调用并返回由as变量绑定的对象 __exit__将在离开with语句时被调用,且可以用参数来判断在 离开with语句时是否有异常发生并作出相应的处理示例: # 一个自定义的类创建的对象能够使用with语句 class A: '''此类的对象可用于with语句进行管理''' def __enter__(self): print("已经进入with语句中,资源分配成功") return self # <<<-- 此处返回的对象将由as变量绑定 def __exit__(self, exc_type, exc_val, exc_tb): print("离开with语句,资源释放成功") if exc_type is None: print("当离开with语句时没有异常") else: print("有异常发生 异常类型:",exc_type , "异常值:", exc_val) with A() as a: print("这是with语句中的语句") raise ValueError("故意制造的异常") 运算符重载: 什么是运算符重载 让自定义的类生成的对象(实例)能够使用运算符进行操作 作用: 1.让自定义的类的实例能够运行运算符操作 2.让程序简洁易读 3.对定义对象将运算符赋予新的运算规则 说明: 运算符重载方法的参数已经有固定含义,不建议改变原有的含义 算数运算符重载: 方法名 运算符和表达式 说明__add__(self, rhs) self + rsh 加法__sub__(self, rhs) self - rsh 减法__mul__(self, rhs) self * rsh 乘法__truediv__(self, rhs) self / rsh 除法__floordiv__(self, rhs) self // rsh 地板除__mod__(self, rhs) self % rsh 求模__pow__(self, rhs) self ** rsh 幂 rhs(self hand side) 右手边 示例: class MyNumber: def __init__(self, val): self.data = val def __repr__(self): return "%d" % self.data def __add__(self, rsh): v = self.data + rsh.data return MyNumber(v) def __sub__(self, rsh): return MyNumber(self.data - rsh.data) n1 = MyNumber(100) n2 = MyNumber(200) n3 = n1 + n2 # 等同于 n3 = n1.__add__(n2) # n3 = n1.__add__(n2) print(t(n1, "-", n2, "=", n1 - n2) 反向算术运算符的重载 当运算符的左侧为内建类型,右侧为自义类型的对象进行算术运算符运算时,会出现TypeError错误, 因无法修改内建类的代码来实现运算符重载,此时需要使用反向算术运算符重载 反向算术运算符重载 方法名 运算符和表达式 说明__radd__(self, lhs) lhs + self 加法__rsub__(self, lhs) lhs - self 减法__rmul__(self, lhs) lhs * self 乘法__rtruediv__(self, lhs) lhs / self 除法__rfloordiv__(self, lhs) lhs // self 地板除__rmod__(self, lhs) lhs % self 取模(求余)__rpow__(self, lhs) lhs ** self 幂 lhs(left hand side) 右手边 示例: # 此示例示意返向算述运算符的重载 class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' self.beta = [x for x in lst] # self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __mul__(self, rhs): return MyList(self.beta * rhs) print("__mul__ 被到调用") def __rmul__(self, lhs): print("__rmul__ 被到调用") return MyList(self.beta * lhs) # 反向传参 L1 = MyList([1, 2, 3]) L2 = MyList(range(4, 7)) L3 = 2 * L1 # L1.__rmul__(2) print(L3) L5 = L1 * 2 # L5 = L1.__mul__(2) print(L5) # MyList([1, 2, 3, 1, 2, 3]) 复合赋值算术运算符的重载 以复合赋值算术运算符 x += y 为例,此运算会优先调用x.__iadd__(y) 方法, 如果没有__iadd__方法时会将复合赋值运算拆解为 x = x + y,然后调用x = x.__add__(y) 方法 如果再不存在 __add__方法则会触发TypeError异常 其它复合赋值运算符也具有相同的规则 复合赋值算术运算符重载 方法名 运算符和表达式 说明__iadd__(self, lhs) lhs += self 加法__isub__(self, lhs) lhs -= self 减法__imul__(self, lhs) lhs *= self 乘法__itruediv__(self,lhs) lhs /= self 除法__ifloordiv__(self, lhs) lhs //= self 地板除__imod__(self, lhs) lhs %= self 取模(求余)__ipow__(self, lhs) lhs **= self 幂 示例: class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' # self.beta = [x for x in lst] self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __iadd__(self, rhs): self.beta += rhs.beta # id不变 return self def __add__(self, rhs): return MyList(self.beta + rhs.beta) # id会不变 L = MyList([1, 2, 3]) def f1(lst): lst += MyList([4, 5, 6]) f1(L) print(L) 复合赋值算术运算符重载 方法名 运算符和表达式 说明__lt__(self, rhs) self < rhs 小于__le__(self, rhs) self <= rhs 小于等于__gt__(self, rhs) self > rhs 大于__ge__(self, rhs) self >= rhs 大于等于__eq__(self, rhs) self == rhs 等于__ne__(self, rhs) self != rhs 不等于示例: # 此示例示意比较运算符的重载 class MyList: def __init__(self, iterable): self.data = list(iterable) def __repr__(self): return 'MyList(%s)' % self.data def __eq__(self, rhs): return self.data == rhs.data def __gt__(self, rhs): return self.data > rhs.data L1 = MyList([1, 2, 3]) L2 = MyList([1, 2, 3]) print(L1 == L2) # True print(L1 > L2) # False # print(L1 == L2) # 如果没有__eq__ 方法判断两个对象的id # print(L1 > L2) # 如果没有__gt__ 方法报错 位运算符重载 方法名 运算符和表达式 说明 __invert__(self) ~ self 取反(一元运算符) __and__(self, rhs) self & rhs 位与 __or__(self, rhs) self | rhs 位或 __xor__(self, rhs) self ^ rhs 位异或 __lshift__(self, rhs) self << rhs 左移 __rshift__(self, rhs) self >> rhs 右移 反向位运算符重载 方法名 运算符和表达式 说明 __rand__(self, lhs) lhs & self 位与 __ror__(self, lhs) lhs | self 位或 __rxor__(self, lhs) lhs ^ self 位异或 __rlshift__(self, lhs) lhs << self 左移 __rrshift__(self, lhs) lhs >> self 右移 复合赋值位运算符重载 方法名 运算符和表达式 说明 __iand__(self, rhs) self &= rhs 位与 __ior__(self, rhs) self |= rhs 位或 __ixor__(self, rhs) self ^= rhs 位异或 __ilshift__(self, rhs) self <<= rhs 左移 __irshift__(self, rhs) self >>= rhs 右移 一元运算符重载 方法名 运算符和表达式 说明 __invert__(self) ~ self 取反(一元运算符) __pos__(self) + self 正号 __neg__(self) - self 负号 语法: def __xxx__(self): 示例: # 此示例示意一元运算符的重载 class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' self.beta = [x for x in lst] # self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __neg__(self): return MyList((-x for x in self.beta)) def __pos__(self): return MyList((abs(x) for x in self.beta)) # L = [] # for x in self.beta: # if x > 0: # L.append(x) # else: # L.append(-x) # return MyList(L) L1 = MyList([1, -2, 3, -4, 5]) L2 = -L1 print(L2) # MyList([-1, 2, -3, 4, -5]) # 实现用正号运算符返回全部元素为正数的自定义列表 L3 = + L1 print(L3) # MyList([1, 2, 3, 4, 5]) in / not in 运算符重载重载方法:def __contains__(self, e):....示例: # in not in 重载 class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' self.beta = [x for x in lst] # self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __contains__(self, e): return e in self.beta L1 = MyList([1, 2, -3, 4, -5]) print(2 in L1) print(3 in L1) print(4 in L1) print(5 in L1) 索引和切片运算符的重载 方法名 运算符和表达式 说明 __getitem__(self, i) x = self[i] 索引/切片取值 __setitem__(self, i, val) self[i] = val 索引/切片赋值 __delitem__(self, i) del self[i] 删除索引/切片 作用:让自定义的类的对象能够支持索引和切片操作示例: # 此示例示意 索引/切片 运算符的重载 class MyList: def __init__(self, iterable): self.data = list(iterable) def __repr__(self): return 'MyList(%s)' % self.data def __getitem__(self, i): print("索引i的值是:", i) return self.data[i] def __setitem__(self, i, v): print("__setitem__被调用, i=", i, 'v=', v) self.data[i] = v def __delitem__(self, i): del self.data[i] L1 = MyList([1, -2, 3, -4, 5]) v = L1[2] # v = 3 print(v) # 3 L1[1] = 2 print(L1) # MyList([1, 2, 3, -4, 5]) del L1[3] print(L1) # MyList([1, 2, 3, 5]) slice 函数: 作用: 用于创建一个slice切片对象,此对象存储切片的信息 格式: slice(start=None, stop=None, step=None) slice对象的属性 s.start 切片的起始值, 默认为None s.stop 切片的终止值, 默认为None s.step 切片的步长, 默认为None示例: # 此示例示意 索引/切片 运算符的重载 class MyList: def __init__(self, iterable): self.data = list(iterable) def __repr__(self): return 'MyList(%s)' % self.data def __getitem__(self, i): print("索引i的值是:", i) if type(i) is int: print("正在进行索引操作") elif type(i) is slice: print("正在进行切片操作") print("起始值是:", i.start) print("终止值是:", i.stop) print("步长值是:", i.step) return self.data[i] def __setitem__(self, i, v): print("__setitem__被调用, i=", i, 'v=', v) self.data[i] = v def __delitem__(self, i): del self.data[i] L1 = MyList([1, -2, 3, -4, 5]) L2 = L1[::2] print(L2) 特性属性 @property 实现其它语言所拥有的 getter 和 setter 的功能 作用: 用来模拟一个属性 通过@property 装饰器可以对模拟属性的取值和赋值加以控制 示例见: 示例: class Student: def __init__(self, s): self.__score = s # 私有属性,不让其它人任意修改成绩 @property def score(self): '''伪装模拟私有一个成绩属性 并返回成绩''' return self.__score @score.setter def score(self, v): '''实现设置者setter , 对用户的复制加以限制''' assert 0 <= v <= 100, "成绩不合法" self.__score = v s = Student(59) print(s.score) # 希望有一个属性能得到成绩 虚拟属性不能复制 s.score = 80 # 通过s.score 来修改成绩 print(s.score) # 修改成功 s.score看似属性 是模拟属性 实际内部已经被替换 问题: L = [1, 2, 3] def f1(lst): lst += [4, 5, 6] f1(L) print(L) # [1, 2, 3, 4, 5, 6] 为什么 L = (1, 2, 3) def f1(lst): lst += (4, 5, 6) # lst = lst + (4, 5, 6) f1(L) print(L) # (1, 2, 3) 为什么 练习: 1. 实现两个自定义的列表相加 class MyList: .... 此处自己实现 L1 = MyList([1, 2, 3]) L2 = MyList(range(4, 7)) L3 = L1 + L2 print(L3) # MyList([1, 2, 3, 4, 5, 6]) L4 = L2 + L1 print(L4) # MyList([4, 5, 6, 1, 2, 3]) L5 = L1 * 2 print(L5) # MyList([1, 2, 3, 1, 2, 3]) 练习: 实现有序集合类 OrderSet() 能实现两个集合的交集 &,全集 |, 补集 - 对称补集 ^, ==/!= , in/ not in 等操作 要求集合内部用 list 存储 class OrderSet: ... s1 = OrderSet([1, 2, 3, 4]) s2 = OrderSet([3, 4, 5]) print(s1 & s2) # OrderSet([3, 4]) print(s1 | s2) # OrderSet([1, 2, 3, 4, 5]) print(s1 ^ s2) # OrderSet([1, 2, 5]) if OrderSet([1, 2, 3]) != OrderSet([3, 4, 5]): print("不相等") if s2 == OrderSet(3, 4, 5): print('s2 == OrderSet(3, 4, 5) is True') if 2 in s1: print("2在 s1中")

优秀的个人博客,低调大师

阿里平头哥发布首个 RISC-V AI 软硬全栈平台

阿里平头哥在2023 RISC-V 中国峰会上发布了首个自研 RISC-V AI 平台。该平台通过软硬件深度协同,较经典方案提升超 8 成性能,支持运行 170 余个主流 AI 模型,推动 RISC-V 进入高性能 AI 应用时代。 平头哥表示,他们通过更新自研一站式 AI 部署套件 HHB 实现了在典型网络性能比第三方工具平均提升 88%,并增加支持运行 Transformer、TensorFlow、PyTorch 等 170 余个主流框架 AI 模型。 该平台将 RISC-V 扩展性的新型 Vector、Matrix 及第三方硬件进行算力抽象,并接入 OpenCV 与 CSI-NN 等弹性计算库,融合多媒体处理流程,形成面向业务的流水线设计,方便用户在流水线的不同步骤上进行 AI 增强优化,为检测、分类、跟踪和超分等各类应用提速。 据了解,中国企业和机构是RISC-V国际社区的主要贡献者。目前,在RISC-V国际基金会中,平头哥参与了30余个技术方向的标准制定,主导负责了安卓、数据中心等12个关键技术小组,是公认投入力量最大的中国机构。 平头哥还是全球RISC-V软件生态计划“RISE”的创始董事会成员,与谷歌、英特尔、三星、英伟达、联发科等13家企业发起,推动RISC-V软件生态发展。

优秀的个人博客,低调大师

“云”端的语雀:用 JavaScript 全栈打造商业级应用

作者| 不四(死马)蚂蚁金服 语雀产品技术负责人 语雀是什么? 语雀是一个专业的云端知识库,面向个人和团队,提供与众不同的知识管理,打造轻松流畅的工作协同,它提供各种格式的在线文档(富文本、表格、设计稿等)编辑能力,支持实时在线多人协同编辑,数据云端保存不丢失。而语雀与其他文档工具最大的不同是,它通过知识库来对文档进行组织,让知识创作者更好的管理知识。 语雀技术架构演进 原型阶段 语雀诞生于 2016 年,当时蚂蚁金融云需要一个工具来承载它的文档。当时负责的技术同学利用业余时间,开始搭建这个文档工具。项目的初期,没有任何人员和资源支持,同时也为了快速验证原型,技术选型上选择了最低成本的方案。 底层服务完全基于体验技术部内部提供的 BaaS 服务和容器托管平台: Object 服务:一个类 MongoDB 的数据存储服务; File 服务:阿里云

优秀的个人博客,低调大师

Python全栈 Web(基于Flask框架的完整项目、项目搭建)

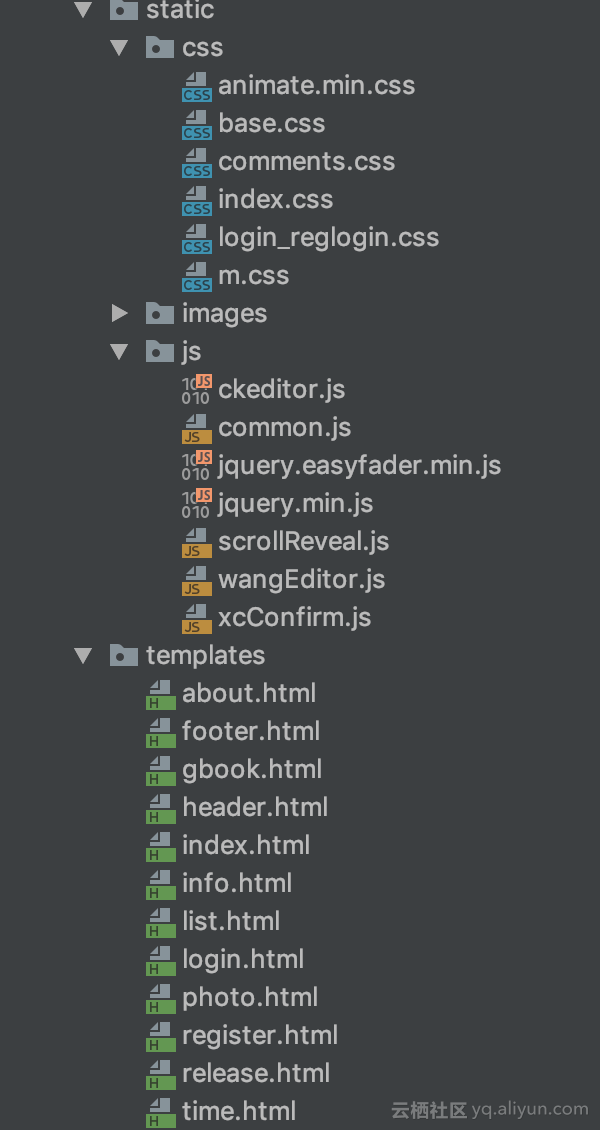
个人博客项目 前端模板目录结构 将动态网页放在templates模板目录中 将静态文件以及静态页面放在static目录中 项目的整体效果 搭建后端Flask项目 数据库的建模 初始化数据库 1 创建项目数据库 2 将构建好的表进行初始化 输入密码即可导入 验证数据库 blog.sql文件 /* Navicat MySQL Data Transfer Source Server : localhost Source Server Version : 50721 Source Host : localhost:3306 Source Database : blog Target Server Type : MYSQL Target Server Version : 50721 File

优秀的个人博客,低调大师

Python全栈 MySQL 数据库(SQL命令大全、MySQL 、Python调用)

梦想与了信仰 开局一张图 主要三个方面: 1.Linux终端命令 2.MySQL语句 3.Python调用 先删库 再跑路..... 终端命令: vi 文本编辑器 cat /etc/password | grep “用户名” 获取user表 sudo -i 获取root权限 sudo apt-get install python3-pip 安装pip3 sudo pip3 install pymysql 安装mysql sudo apt-get install mysql-server 安装服务端 sudo apt-get install mysql-client 安装客户端 sudo apt-get update 读取列表 保存到 /var/lib/apt/lists sudo apt-get upgrade 对比下载列表并更新 sudo /etc/init.d/mysql status 查询状态 sudo /etc/init.d/mysql stop 停止服务 sudo /etc/init.d/mysql restart 重启服务 sudo /etc/init.d/mysql reload 重新加载 mysql -h主机地址 -u用户名 -p密码 链接mysql 修改mysql默认字符集: sudo -i 1.获取root chmod 644 文件名 2.修改文件权限 cd etc/mysql/mysql.conf.d 3.进入配置文目录 cp etc/msql.cnf/mysqld.cnf.bak 4.备份 subl mysqld.cnf 5.vi打开源文件 [mysqld] 目录 character_set_server = utf8 6.添加命令 /etc/init.d/mysql mysqldump -u用户 -p源库名 > ~/xxx.sql 数据备份: 参数: --all-databases 1.备份所有库 库名 2.备份单个库 -B 库1 库2.. 3.备份多个库 库名 表1 表2... 4.备份指定库指定表 数据恢复: mysql -uroot -p < 目标库名 xxx.sql 1. 恢复备份库 mysql -uroot -p --one-database 目标库名 < xxx.sql 2. 恢复备份内某一个库 恢复:表不删除 表记录删除覆盖 MySQL远程连接: sudo -i 1.管理员模式 cd /etc/mysql/mysql.conf.d/ 2.cd到mysql目录 vi mysqld.cnf 3.打开注释掉默认IP #bind-address = 127.0.0.1 4.保存 /etc/init.d/mysql restart 5.重启服务 授权用户: grant 授权列表 on 库.表 to “用户名“@”%”identified by “密码” with grant option 1.命令格式 示例:grant all privileges on *.* to "tiger"@"%" identified by "123" with grant option; 2.示例 all privileges、select、insert ... 4.库.表: *.* 所有库所有表 3.权限列表 python3模块安装: 模块名 :pymysql 在线 :sudo pip3 install pymysql 离线 :pymysql-0.7.11.tar.gz $ tar -zxvf pymyql-0.7.11.tar.gz $ cd pymysql-0.7.11 $ sudo python3 setup.py install 验证: $ python3 >>> import pymysql >>> python2模块安装: 模块名 :MySQLdb 安装 :sudo pip install mysql-python sqlalchemy 框架 安装: 在线 :sudo pip3 install sqlalchemy 离线 : $ tar -zxvf SQLAlchemy-1.2.10.tar.gz $ cd SQLAlchemy-1.2.10 $ sudo python3 setup.py install 验证: $ python3 >>> import sqlalchemy >>> pymysql使用: from pymsql import * 导入模块 (db = pymysql.connect(...)) 1、建立数据库连接 c = db.cursor()) 2、创建游标对象 c.execute("insert ....") 3、游标方法: db.commit() 4、提交到数据库 c.close() 5、关闭游标对象 db.close() 6、断开数据库连接 : 7. connect对象: db = pymysql.connect(参数列表) 1、host :主机地址,本地 localhost 2、port :端口号,默认3306 3、user :用户名 4、password :密码 5、database :库 6、charset :编码方式,推荐使用 utf8 8. 连接对象的方法: 数据库连接对象(db)的方法 1、db.close() 关闭连接 2、db.commit() 提交到数据库执行 3、db.rollback() 回滚 4、cur = db.cursor() 返回游标对象,用于执行具体SQL命令 9. 游标对象的方法: 游标对象(cur)的方法 1、cur.execute(sql命令,[列表]) 执行SQL命令 2、cur.close() 关闭游标对象 3、cur.fetchone() 获取查询结果集的第一条数据 ((记录1),) 4、cur.fetchmany(n) 获取n条 ((记录1),(记录2)) 5、cur.fetchall() 获取所有记录 ORM:orm(Object Relation Mapping 对象关系映射) 定义:把对象模型映射到MySQL数据库中 SQL命令: /var/lib/mysql MySQL数据目录 show variables like "autocommit"; 查询commit事务 begin; 开启事务 commit; 提交事务(MySQL默认自动提交) rollback; 终止事务 system sudo -i 由数据直接进入终端 show databases; 查看已有库 create database 库名; 创建库 create database 库名 charcater set utf8; 指定字符集 show create database 库名; 查看库字符集 select database(); 查看当前所在库 use 库名; 切换库 drop database 库名; 删除库 show tables; 查看已有表 create table 表名(字段名1 数据类型,....); 创建表 show create table 表名; 查看表字符集 desc 表名; 查看表结构 drop table 表名; 删除表 insert into 表名 values(值1),(值2)...; 插入完整记录 insert into 表名 (字段名1,...) values(值1),...; 插入字段数据 select * from 表名 [where 条件]; 查询所有字段 select 字段名1,字段名2,...from 表名[where 条件]; 查看字段 alter table 表名 add 字段名 数据类型; 添加字段 alter table 表名 add 字段名 数据类型 first; 头插) alter table 表名 add 字段名 数据类型 after 字段名; 指定插入) alter table 表名 drop 字段名; 删除字段 alter table 表名 modify 字段名 新数据类型; 修改数据类型 alter table 表名 rename 表名; 表重命名 delete from 表名 where 条件; 删除表记录(必须加where) update 表名 set 字段1=值1,字段名2=值2,... where 条件 更改表记录(必须加where) alter table 表名 change 原名 新名 数据类型; 字段重命名 create table 表名 select .. from 表名 where 条件; 复制表(不复制key) create table 表名 select * from 表名 where false; 复制表结构(不复制key) sex enum(“M”,"F","S") not null defaulf "S" 约束 show variables like 变量名; 查询MySQL变量 select 字段名列表 from 表名列表; (笛卡尔积) select t1.name,t2.name from t1,t2 where 条件 多表查询 create index 索引名 on 表名(字段名); 添加普通索引 create table(....index(字段名),...) 创建表时创建普通索引 drop index 索引名 on 表名; 删除普通索引 show index from 表名; 查看普通索引 create unique index 索引名 on表名(字段名); 添加唯一索引 create table 表名( .... , unique key (字段名) ); 创建表时创建唯一索引 drop unique index 索引名 on 表名; 删除唯一索引 show unique index from 表名; 查看唯一索引 alter table 表名 add primary key(字段名); 添加主键索引 create table 表名( .... , id int, primary key (字段名) ); 创建表时创主键一索引 (id int primary key auto_increment,)auto_increment=10000; 设置自增长起始值 alter table 表名 modify id int auto_increment; 添加自增长 alter table 表名 auto_increment=20000; 修改自增长起始值 alter table 表名 modify id int; 删除自增长 alter table 表名 drop primary key; 删除主键索引 show index from 表名\G; 查看表索引 desc 表名; 查看表结构(key) Non_Unique:1 :index 普通索引(查询结果) Non_Unique:0 :unique 唯一索引(查询结果) alter table 表名 drop foreign key 外键名; 删除外键 show create table 表名; 查看外键名 创建外键: create......t1(); create table t2( ... ... foreign key(参考字段名) references 主表(被参考字段名) on delete 级联动作 on update 级联动作); 添加外键: alter table 表名 add foreign key(参考字段) references 主表(被参考字段) on delete ... on update ... 级联动作: restrict(默认)不允许主表操作从表 cascade :跟随删除、更新 set null:主表更改后从表值为NULL 内链接: select 字段名 from表1 inner join 表2 on 条件 inner join 表3 on 条件...; 外链接.左链接: 以左表为主显示查询结果 select 字段名 from 表1 left join 表2 on 条件 left join 表3 on 条件...; 右链接 以右表为主显示查询结果 数据导入: load data infile “文件名” into table 表名 fields terminated by “分隔符” lines terminated by “\n”; 数据导出: select ... from 表名 into outfile “/var/lib/mysql-files/文件名” fields terminated by “分隔符” lines terminated by “\n”; 数据恢复: 恢复单个库 mysql -uroot -p < 目标库名 xxx.sql 从所有库备份中恢复某一个库(-one-database) mysql -uroot -p --one-database 目标库名 < xxx.sql 恢复:表不删除 表记录删除覆盖 数据备份: mysqldump -u用户 -p源库名 > ~/xxx.sql --all-databases 备份所有库 库名 备份单个库 -B 库1 库2.. 备份多个库 库名 表1 表2... 备份指定库指定表 运行时间检测: 开启:set profiling=1; 关闭:set profiling=0; 查询执行记录:show profilings; SQL查询: 3.select ... 聚合函数 from 表名 1.where 2.group by... 4.having ... 5.order by ... 6.limit ...; select ... from 表名 where 条件(select ....); 查询嵌套: 2、找出每个国家攻击力最高的英雄的名字和攻击值 select name,gongji from sanguo where (country,gongji) in (select country,max(gongji) from sanguo group by country); where:只能操作表中实际存在的字段 group by:给查询结果进行分组 having:对查询结果进一步筛选 distinct:不显示字段重复值 show engines; 查看所有存储引擎 show create table 表名; 查看表的存储引擎 create table 表名(...)engine=myisam; 创建表时指定存储引擎 alter table 表名 engine=innodb; 添加储存引擎 InnoDB: InnoDB特点(2文件): 行级锁、支持外键、事务操作 .frm(表结构,索引)、.ibd(表记录) MyISAM特点(3文件): MyISAM: 独享表空间、表级锁 .frm(结构)、.myd(记录)、.myi(索引) 锁: select :加读锁之后别人不能更改表记录,但可以进行查询 insert、delete、update :加写锁之后别人不能查、不能改 锁粒度: 表级锁 :myisam 行级锁 :innodb 调优: 1.选择合适的存储引擎 2.常用字段建立索引 3.where 避免使用 !=、NULL判断、or链接、 like前置%、in、not in、*代替字段、 数据类型: 数据类型: int 大整型(4个字节) 2**32 - 1(4294967295) tinyint 微小整型(一个字节) 有符号(signed默认):-128 ~ 127 无符号(unsigned):0 ~ 255 smallint 小整型(2字节) bigint 极大整型(8字节) float 浮点数(4个字节,7个有效位) 字段名 float(m,n) m:总位数 n:小数位数 decimal 浮点数(28个有效位) 字段名 decimal(m,n)m:总位数 n:小数位数 将9的倍数包装成4个字节 余数 字节 0 0 1-2 1 3-4 2 5-6 3 7-9 4 字段名 enum(值1,值2...); 单选(enum) 字段名 set(值1,值2...); 多选(set) (多项放在一个字符串内用,号隔开) date:“YYYY-MM-DD” time:“HH:MM:SS” datetime:“YYYY-MM-DD HH:MM:SS” timestamp:“YYYY-MM-DD HH:MM:SS” datetime:不给值默认返回Null timestamp:不给值默认返回系统时间 时间函数 now() 返回服务器当前的时间 curdate() 返回当前时期 curtime() 返回当前日期 year(date) 返回指定时间的年份 date(date) 返回指定时间的日期 time(date) 返回指定时间的时间 聚合函数 avg(字段名):求该字段的平均值 sum(字段名):求和 max(字段名):最大值 min(字段名):最小值 count(字段名):统计该字段的个数 运算符:+ - * / % 时间运算符 select * from 表名 where 字段名 运算符(时间-interval 时间间隔单位); 时间间隔单位:1 day | 2hour | 1 minute | 2year | month 数值比较: = != > >= < <= 字符比较: = != 逻辑比较: and or 范围内比较: 1.where 字段名 between 值1 and 值2 2.where 字段名 in(值1,值2,....) 3.where 字段名 not in (值1,值2,...) 空:where name is null 非空:where name is not null NILL:空值,只能用is或is not取匹配 “” : 空字符串,用 = 或 != 去匹配 模糊比较: where 字段名 like 表达式 表达式 _ : 匹配单个字符 %:匹配0到多个字符 NULL不会被统计 排序:order by ASC | DESC 显示: limit 开始显示位置,条数 每页显示n条记录,显示第m页: limit(m-1)*n,n MySQL 与 Python 交互 # mysqlpython.py # 导入mysql模块 from pymysql import * class MysqlPython: def __init__(self, database, # 库 host="127.0.0.1", # ip地址 user="root", # 用户名 password="123456", # 密码 port=3306, # 端口 charset="utf8"): # 字符集 self.host = host self.database = database self.user = user self.password = password self.port = port self.charset = charset def open(self): # 创建数据库链接函数 self.db = connect(host=self.host, database=self.database, user=self.user, password=self.password, port=self.port, charset=self.charset) self.cur = self.db.cursor() # 创建游标对象 def close(self): # 创建断开数据库链接 关闭游标函数 self.cur.close() self.db.close() def zhixing(self, sql, L=[]): # 创建pymysql.execute() 方法函数 try: self.open() # 链接数据库 self.cur.execute(sql, L) # 参数化执行SQL命令 self.db.commit() # 提交数据 print("ok") except Exception as e: self.db.rollback() # 出错取消提交 print("Failed", e) self.close() # 断开数据库链接 关闭游标 def all(self, sql, L=[]): try: self.open() self.cur.execute(sql, L) result = self.cur.fetchall() return result except Exception as e: print("Failed", e) self.close() 数据库用户登录 from mysqlpython import Mysqlpython from hashlib import sha1 uname = input("请输入用户名:") pwd = input("请输入密码:") # 用sha1给pwd加密 s1 = sha1() # 创建sha1加密对象 s1.update(pwd.encode("utf8")) # 指定编码 pwd2 = s1.hexdigest() # 返回16进制加密结果 sqlh = Mysqlpython("db4") select = "select password from user where \ username=%s;" result = sqlh.all(select, [uname]) # print(result) # (('7c4a8d09ca3762af61e59520943dc26494f8941b',),) if len(result) == 0: print("用户名不存在") elif result[0][0] == pwd2: print("登录成功") else: print("密码错误") ORM sqlalchemy框架 # 创建一张表 # 连接数据库的模块 from sqlalchemy import create_engine from sqlalchemy.ext.declarative import declarative_base from sqlalchemy import Column, Integer, String engine = create_engine("mysql+pymysql://root:123456@localhost/db4", encoding="utf8") Base = declarative_base() # orm基类 class User(Base): # 继承Base基类 __tablename__ = "t123" id = Column(Integer, primary_key=True) name = Column(String(20)) address = Column(String(40)) Base.metadata.create_all(engine)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册