首页 文章 精选 留言 我的

精选列表

搜索[java ee],共10000篇文章
优秀的个人博客,低调大师

appium-java简单判断操作

/*** * 名片设置删除好友 不看他/她的动态 用例 1、点击我的、 2、点击设置 3、判断列表是否有,如果有就删除,如果没有就添加好友!! * */ public static void MoveFirends() throws Exception { Thread.sleep(2000); driver.findElement(GetByLocator.getLocator("MyInfo")).click(); Thread.sleep(2000); driver.findElement(GetByLocator.getLocator("BusinessCardSet")).click(); // 设置 driver.findElement(GetByLocator.getLocator("DoNotLookDynamic")).click(); // 点击不看他/她的动态 List<AndroidElement> AddNameList = driver.findElements(GetByLocator.getLocator("AddNameList")); if (AddNameList == null || AddNameList.size() == 0) { System.out.println("不看他/她的动态列表有没有可以删除的朋友"); driver.findElement(GetByLocator.getLocator("AddBusinessCard_DonWatch")).click();// 添加名片 driver.findElement(GetByLocator.getLocator("BusinessCardCearch")).click();// 添加名片 driver.findElement(GetByLocator.getLocator("SearchBoxTextInput")).sendKeys("美丽的开始"); // 输入要添加的名片 driver.findElement(GetByLocator.getLocator("SelectTheSearchResults")).click(); // 选中添加 driver.findElement(GetByLocator.getLocator("Click_ok")).click(); // 确定 System.out.println("添加名片成功"); driver.pressKeyCode(AndroidKeyCode.BACK); } else { for (AndroidElement as : AddNameList) { String namelist = as.getAttribute("text"); System.out.println("AddNameList:" + namelist); if (!namelist.equals("")) { driver.findElement(GetByLocator.getLocator("MoveBusinessCard_DonWatch")).click(); driver.findElement(GetByLocator.getLocator("BackgroundOK")).click(); System.out.println("不看他/她的动态列表有可以删除的朋友"); System.out.println("开始移除不看他/她的动态列朋友!"); } } } System.out.println("不看他/她的动态列表操作完毕!!"); driver.pressKeyCode(AndroidKeyCode.BACK); } 参考 沙陌 老师 资料 /** * 1. 首页点击文章标题 * 2. 进入文章详情页面点击关注 * 3. 如果是已关注,则取消关注 * 4. 遍历当前界面所有的文章 * @param args * @throws Exception * @throws Exception */ public void attention() throws Exception{ //*[@resource-id='com.zhihu.android:id/title'] List<AndroidElement> titleList=driver.findElementsByXPath("//*[@resource-id='com.zhihu.android:id/title']"); for(AndroidElement ae:titleList){ String title=ae.getText(); ae.click(); //*[@text='已关注'] //*[@text='关注'] Thread.sleep(2000); try { driver.findElementByXPath("//*[@text='已关注']").click(); System.out.println(title+"====关注取消成功"); } catch (Exception e) { // TODO: handle exception try { driver.findElementByXPath("//*[@text='关注']").click(); System.out.println(title+"====关注成功"); } catch (Exception e2) { // TODO: handle exception System.out.println("没找到关注,继续执行"); } } Thread.sleep(2000); //执行设备物理返回 driver.pressKeyCode(4); Thread.sleep(1000); } } public void nightMode(){ clickMenu(5); AndroidElement nightMode=driver.findElement(By.id("com.zhihu.android:id/night_mode_switch")); String status=nightMode.getAttribute("checked"); nightMode.click(); status=nightMode.getAttribute("checked"); if(status.equals("true")){ System.out.println("夜间模式打开成功"); }else{ System.out.println("夜间模式关闭成功"); } String text=nightMode.getAttribute("text"); String id=nightMode.getAttribute("resourceId"); String className=nightMode.getAttribute("className"); //String content_desc=nightMode.getAttribute("content-desc"); String checkable=nightMode.getAttribute("checkable"); String clickable=nightMode.getAttribute("clickable"); String enable=nightMode.getAttribute("enabled"); String longClickable=nightMode.getAttribute("longClickable"); //name参数优先获取content-desc属性的值,如果这个值为空字符串,那么会获取text属性的值 String name=nightMode.getAttribute("name"); //更新AppiumBootStrap包之后,可以实用contentDescription来获取content-desc的值 //String content_desc=nightMode.getAttribute("contentDescription"); String selected=nightMode.getAttribute("selected"); String displayed=nightMode.getAttribute("displayed"); //nightMode.isSelected();//这个方法没用,无法是否被选中 System.out.println(selected+"============="+displayed); } 本文转自 知止内明 51CTO博客,原文链接:http://blog.51cto.com/357712148/2048587,如需转载请自行联系原作者

优秀的个人博客,低调大师

Java反编译代码分析(一)

浅析如何读懂这种反编译过来的文件,不喜勿喷。 赋值 Node node; Node node1 = _$3.getChildNodes().item(0); node1; node1; JVM INSTR swap ; node; getChildNodes(); 0; item(); getChildNodes(); 0; item(); getNodeValue(); String s; s; 原始语句: Node node; Node node1 = currDocument.getChildNodes().item(0); node = node1; String s = node.getChildNodes().item(0).getChildNodes().item(0).getNodeValue(); //赋值语句 // JVM INSTR swap ; 不带参数创建对象 JVM INSTR new #244 <Class CrossTable>; JVM INSTR dup ; JVM INSTR swap ; CrossTable(); CrossTable crosstable; crosstable; CrossTable crosstable = new CrossTable(); 带参数创建对象 JVM INSTR new #262 <Class StringBuffer>; JVM INSTR dup ; JVM INSTR swap ; String.valueOf(s2); StringBuffer(); s.substring(j, i); append(); s6; append(); toString(); s2; s2 = (new StringBuffer(String.valueOf(s2))).append(s.substring(j, i)).append(s6).toString(); //s2 += s.substring(j, i) + s6; for循环 int k = 0; goto _L4 _L8: ... k++; _L4: if(k < as.length) goto _L8; else goto _L7 for(int k=0;k < as.length;k++) { ... } while循环 String s1 = ""; goto _L1 _L3: JVM INSTR new #262 <Class StringBuffer>; JVM INSTR dup ; JVM INSTR swap ; String.valueOf(s1); StringBuffer(); _$2(resultset, s, l); append(); toString(); s1; _L1: if(resultset.next()) goto _L3; else goto _L2 String s1 = ""; while(resultset.next()) { s1 = s1 + resultSetToString(resultset, s, l); } 我是天王盖地虎的分割线 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4314546.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Java应用架构的演化之路

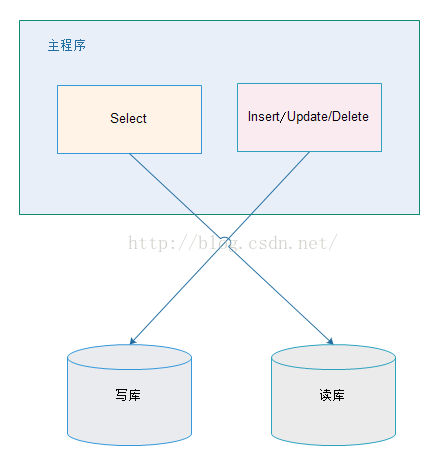
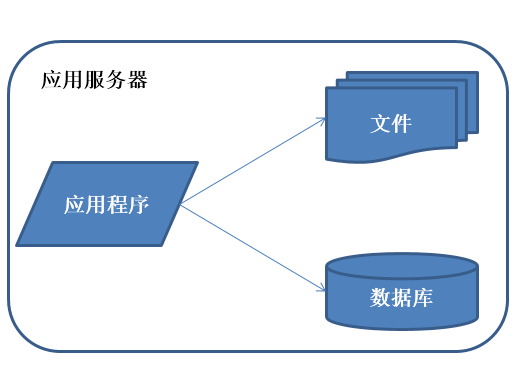
当我们架设一个系统的时候通常需要考虑到如何与其他系统交互,所以我们首先需要知道各种系统之间是如何交互的,使用何种技术实现。 1. 不同系统不同语言之间的交互 现在我们常见的不同系统不同语言之间的交互使用WebService,Http请求。WebService,即“Web 服务”,简写为 WS。从字面上理解,它其实就是“基于 Web 的服务”。而服务却是双方的,有服务需求方,就有服务提供方。服务提供方对外发布服务,服务需求方调用服务提供方所发布的服务。如果说得再专业一点,WS 其实就是建立在 HTTP 协议上实现异构系统通讯的工具。没错!WS 说白了还是基于 HTTP 协议的,也就是说,数据是通过 HTTP 进行传输的。最早我们是用CXF开发SOAP服务实现WS,后面我们是用REST服务实现WS(这个目前使用比较多,也最我用得最多的这一种)。基于 CXF也可以开发REST服务,不过我们一般直接使用springMVC或者其他MVC框架实现REST服务。 但是在很多人的印象中Web service的话一般指十来年前IBM主导的基于XML的各种交互技术,现在除了一些公司在用之外用得人也很少了。广义的话Webservice就是Web 服务了,一切皆服务。 2. 不同系统相同语言之间的交互 常见的不同系统相同语言之间的交互用RPC(远程过程调用),或者RMI(远程方法调用)实现,不用对外部提供服务,当然上面说的也可以使用在相同语言之间的交互,只是我常用的是RPC。 不同产品的架构 3. 单个产品的架构演进 一般我们只是一个产品的情况下的架构演进历程,如果需要对外提供webService,通常使用REST服务实现。 以下一段内容来源于知乎 1. 分布式架构的演进系统架构演化历程-初始阶段架构 初始阶段 的小型系统 应用程序、数据库、文件等所有的资源都在一台服务器上通俗称为LAMP 特征:应用程序、数据库、文件等所有的资源都在一台服务器上。 描述:通常服务器操作系统使用linux,应用程序使用PHP开发,然后部署在Apache上,数据库使用Mysql,汇集各种免费开源软件以及一台廉价服务器就可以开始系统的发展之路了。 2. 系统架构演化历程-应用服务和数据服务分离 好景不长,发现随着系统访问量的再度增加,webserver机器的压力在高峰期会上升到比较高,这个时候开始考虑增加一台webserver 特征:应用程序、数据库、文件分别部署在独立的资源上。 描述:数据量增加,单台服务器性能及存储空间不足,需要将应用和数据分离,并发处理能力和数据存储空间得到了很大改善。 3. 系统架构演化历程-使用缓存改善性能 特征:数据库中访问较集中的一小部分数据存储在缓存服务器中,减少数据库的访问次数,降低数据库的访问压力。 描述:系统访问特点遵循二八定律,即80%的业务访问集中在20%的数据上。缓存分为本地缓存和远程分布式缓存,本地缓存访问速度更快但缓存数据量有限,同时存在与应用程序争用内存的情况。 4. 系统架构演化历程-使用应用服务器集群 在做完分库分表这些工作后,数据库上的压力已经降到比较低了,又开始过着每天看着访问量暴增的幸福生活了,突然有一天,发现系统的访问又开始有变慢 的趋势了,这个时候首先查看数据库,压力一切正常,之后查看webserver,发现apache阻塞了很多的请求,而应用服务器对每个请求也是比较快 的,看来 是请求数太高导致需要排队等待,响应速度变慢 特征:多台服务器通过负载均衡同时向外部提供服务,解决单台服务器处理能力和存储空间上限的问题。 描述:使用集群是系统解决高并发、海量数据问题的常用手段。通过向集群中追加资源,提升系统的并发处理能力,使得服务器的负载压力不再成为整个系统的瓶颈。 5. 系统架构演化历程-数据库读写分离 享受了一段时间的系统访问量高速增长的幸福后,发现系统又开始变慢了,这次又是什么状况呢,经过查找,发现数据库写入、更新的这些操作的部分数据库连接的资源竞争非常激烈,导致了系统变慢 特征:多台服务器通过负载均衡同时向外部提供服务,解决单台服务器处理能力和存储空间上限的问题。 描述:使用集群是系统解决高并发、海量数据问题的常用手段。通过向集群中追加资源,使得服务器的负载压力不在成为整个系统的瓶颈。 6. 系统架构演化历程-反向代理和CDN加速 特征:采用CDN和反向代理加快系统的 访问速度。 描述:为了应付复杂的网络环境和不同地区用户的访问,通过CDN和反向代理加快用户访问的速度,同时减轻后端服务器的负载压力。CDN与反向代理的基本原理都是缓存。 7. 系统架构演化历程-分布式文件系统和分布式数据库 随着系统的不断运行,数据量开始大幅度增长,这个时候发现分库后查询仍然会有些慢,于是按照分库的思想开始做分表的工作 特征:数据库采用分布式数据库,文件系统采用分布式文件系统。 描述:任何强大的单一服务器都满足不了大型系统持续增长的业务需求,数据库读写分离随着业务的发展最终也将无法满足需求,需要使用分布式数据库及分 布式文件系统来支撑。分布式数据库是系统数据库拆分的最后方法,只有在单表数据规模非常庞大的时候才使用,更常用的数据库拆分手段是业务分库,将不同的业 务数据库部署在不同的物理服务器上。 8. 系统架构演化历程-使用NoSQL和搜索引擎 特征:系统引入NoSQL数据库及搜索引擎。 描述:随着业务越来越复杂,对数据存储和检索的需求也越来越复杂,系统需要采用一些非关系型数据库如NoSQL和分数据库查询技术如搜索引擎。应用服务器通过统一数据访问模块访问各种数据,减轻应用程序管理诸多数据源的麻烦。 9. 系统架构演化历程-业务拆分 特征:系统上按照业务进行拆分改造,应用服务器按照业务区分进行分别部署。 描述:为了应对日益复杂的业务场景,通常使用分而治之的手段将整个系统业务分成不同的产品线,应用之间通过超链接建立关系,也可以通过消息队列进行 数据分发,当然更多的还是通过访问同一个数据存储系统来构成一个关联的完整系统。纵向拆分:将一个大应用拆分为多个小应用,如果新业务较为独立,那么就直 接将其设计部署为一个独立的Web应用系统纵向拆分相对较为简单,通过梳理业务,将较少相关的业务剥离即可。横向拆分:将复用的业务拆分出来,独立部署为 分布式服务,新增业务只需要调用这些分布式服务横向拆分需要识别可复用的业务,设计服务接口,规范服务依赖关系。 10. 系统架构演化历程-分布式服务 特征:公共的应用模块被提取出来,部署在分布式服务器上供应用服务器调用。描述:随着业务越拆越小,应用系统整体复杂程度呈指数级上升,由于所有应用要和所有数据库系统连接,最终导致数据库连接资源不足,拒绝服务。 Q:分布式服务应用会面临哪些问题? (1) 当服务越来越多时,服务URL配置管理变得非常困难,F5硬件负载均衡器的单点压力也越来越大。 (2) 当进一步发展,服务间依赖关系变得错踪复杂,甚至分不清哪个应用要在哪个应用之前启动,架构师都不能完整的描述应用的架构关系。 (3) 接着,服务的调用量越来越大,服务的容量问题就暴露出来,这个服务需要多少机器支撑?什么时候该加机器? (4) 服务多了,沟通成本也开始上升,调某个服务失败该找谁?服务的参数都有什么约定? (5) 一个服务有多个业务消费者,如何确保服务质量? (6) 随着服务的不停升级,总有些意想不到的事发生,比如cache写错了导致内存溢出,故障不可避免,每次核心服务一挂,影响一大片,人心慌慌,如何控制故障的影响面?服务是否可以功能降级?或者资源劣化? 这个好像是《大型网站技术架构 核心原理与案例分析》开篇的内容,不过作者总结得不错,我就转载一下吧。 4. 产品线的架构 还有一种就是上面也有提到的业务拆分。现在我们需要做一个产品线,我们只需要一个数据层,一个通用业务逻辑层,前面还有各种应用和界面层,不需要对 外部系统(外部公司的系统)提供服务的情况以前我们一般会选择用EJB等来构建分布式应用,但是现在我们可以使用dobbo、thrift、avro、 hessian这类RPC框架来构建分布式应用实现不同应用和数据来源的交互。这种结构模式下我们需要对其他公司提供服务,可以专门写一个应用对外部系统 提供rest服务。一般大多数互联网服务背后都要访问十几个甚至几百个内部服务,它们之间的通信方式一般都是RPC:就像访问一个远程方法那样,输入参数 后等待返回结果。这对于构建复杂系统是最容易理解的方式。 如下图的模型,文件系统,缓存那些没有画出来,大家理解就行。 结语: 不管哪种架构我们都需要做好模块化(尽量做到模块复用)。 不要为了架构而架构导致过度设计。 不管何种架构都是为了更好满足业务需求,架构应该跟随业务的发展而发展。 当前的架构如果可以满足当前的业务发展,就可以考虑下一步的扩展了,不用一下子考虑3步4步甚至更多。 以上如果有误,还望大家不吝赐教! 来源:51CTO

优秀的个人博客,低调大师

ElasticSearch java api -单例模式

//单例模式 private static Settings getSettingInstance(){ if(settings==null){ synchronized (Settings.class) { if(settings==null){ settings = ImmutableSettings.settingsBuilder() // client.transport.sniff=true // 客户端嗅探整个集群的状态,把集群中其它机器的ip地址自动添加到客户端中,并且自动发现新加入集群的机器 .put("client.transport.sniff", true).put("client", true)// 仅作为客户端连接 .put("data", false).put("cluster.name", clustername)// 集群名称 .build(); } } } return settings; } //单例模式 private static TransportClient client; private static TransportClient getIstance() { if (client == null) { //同步代码块(对象未初始化时,使用同步代码块,保证多线程访问时对象在第一次创建后,不再重复被创建) synchronized (TransportClient.class) { if (client == null) { client = new TransportClient(getSettingInstance()).addTransportAddress(new InetSocketTransportAddress(hostname, Integer.parseInt(port1)))// TCP // 连接地址 .addTransportAddress(new InetSocketTransportAddress(hostname, Integer.parseInt(port2))); } } } return client; } /** * 创建索引 写入elasticsearch * * @param jsonlist * 要创建索引的jsonlist数据 */ public static void createIndex(List<JSONObject> jsonlist) { searchRequestBuilder = getIstance().prepareSearch(index); try { // 创建索引 for (int i = 0; i < jsonlist.size(); i++) { IndexResponse indexResponse = client.prepareIndex(index, type, jsonlist.get(i).getString("id")).setSource(jsonlist.get(i).toString()) .execute().actionGet(); if (indexResponse.isCreated()) { System.out.println("创建成功!"); } else { System.out.println("创建失败!"); } } } catch (Exception e) { e.printStackTrace(); } }

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册