首页 文章 精选 留言 我的

精选列表

搜索[MySQL],共10000篇文章
优秀的个人博客,低调大师

MySQL 批量更新时为什么建议用 CASE WHEN 而不是逐条 UPDATE

线上有个订单状态同步任务,需要把一批订单按照上游返回的结果更新成不同的状态。最初的实现很简单,循环里拼一条 UPDATE 语句,几百条订单跑下来接口耗时直接飙到几秒,数据库连接池也开始告警。排查后发现每条 UPDATE 都要走一次网络往返、解析、加锁和提交,即使开了事务,锁竞争和日志写入的代价也远高于预期。这类批量按不同值更新的场景在数据同步、定时任务、后台批处理里很常见,很多人第一反应是写循环,数据量一上来就会暴露问题。这篇内容从实际代码出发,说明为什么单条更新会慢,CASE WHEN 批量更新怎么写才安全,以及什么时候它并不适用。

优秀的个人博客,低调大师

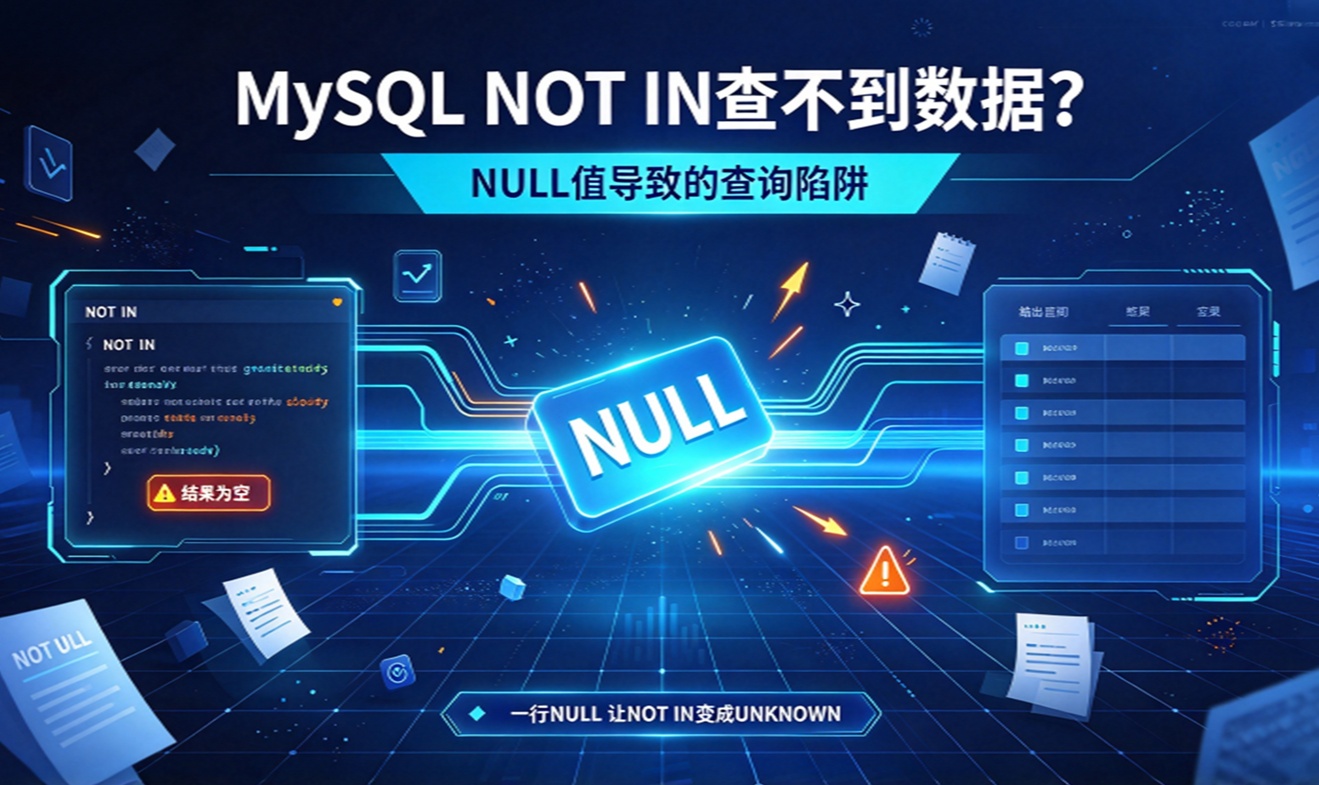
MySQL NOT IN为什么查不出数据?NULL值陷阱与三种改法

大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。 月初对账,结算表比支付表少了一批订单。我第一反应是同步漏了,先把同步任务翻了一遍。日志正常,延迟也正常,数据一条没丢。再跑对账 SQL,结果直接是空的。SQL 没报错,条件也没写错,问题出在子查询里的一行 NULL。 ## 一、 结果少了,先别怀疑数据 对账少了数,很多人的第一反应是同步丢数据。这个方向要查,但别只查这个。同步链路有问题,通常是少几行、错几列,或者延迟越来越大。整批结果直接为空,更像是查询条件把行全过滤了。 那天就是这样。支付表里有单,退款表里有记录,左右都能对上。对账 SQL 一跑,输出零行。我换了 `LEFT JOIN` 去核,数据又都在。同一批数据,换个写法结果不同。问题基本就落在 SQL 语义上,不在存储里。 确认也简单。把子查询单独拎出来,数一下空值有几行。再把 `NOT IN` 换成 `NOT EXISTS` 跑一遍。两次结果一对比,是不是 NULL 的问题,几分钟就能定。别急着翻同步日志。 ## 二、SQL 是三值逻辑 SQL 的逻辑不是两值,是三值。TRUE、FALSE,再加一个 UNKNOWN。NULL 参与比较,结果就是 UNKNOWN,不是 FALSE。`WHERE` 只保留 TRUE,FALSE 和 UNKNOWN 都被丢掉。这一条规则,是所有 NULL 陷阱的根。 所以 `NULL = NULL` 不成立,结果还是 UNKNOWN。`NULL != 1` 也不成立,结果也是 UNKNOWN。判断空值只能用 `IS NULL` 和 `IS NOT NULL`。写成 `= NULL`,永远查不到东西,也不报错。这类写法我在代码评审里见过不止一次。 NULL 还会传染。`NULL + 1` 是 NULL,`CONCAT('a', NULL)` 也是 NULL。整条表达式只要碰到 NULL,结果就废了。写报表时,先用 `IFNULL` 或 `COALESCE` 兜底。否则一个空字段,能让整列指标变成空。 ## 三、NOT IN 为什么会全军覆没 `NOT IN` 的坑,来自它展开的方式。`x NOT IN (1, 2)` 等价于 `x <> 1 AND x <> 2`。列表里加一个 NULL,就变成 `x <> 1 AND x <> 2 AND x <> NULL`。最后这一项永远是 UNKNOWN。AND 里只要有一项 UNKNOWN,整个条件就不可能是 TRUE。 结果就是整条查询返回空。不是少几行,是一行都不剩。哪怕左表的 `order_no` 每一行都合法,也救不回来。子查询里只要有一行 NULL,整个 `NOT IN` 就废了。这一点和 `IN` 不一样,`IN` 碰到 NULL 一般不会改变非空值的匹配结果。 如果左边这一列本身也可能是 NULL,情况一样。`NULL NOT IN (1, 2)` 也是 UNKNOWN。所以判断空值,别用 `NOT IN` 去兜。要么先判 `IS NOT NULL`,要么换一种写法。把 NULL 从比较里拿出去,逻辑才回到两值。 ```sql -- 一行 NULL,足以让整条 NOT IN 返回空 SELECT 1 NOT IN (2, NULL); -- 结果是 NULL SELECT o.order_no FROM t_order o WHERE o.pay_date = '2026-10-25' AND o.status = 'PAID' AND o.order_no NOT IN ( SELECT r.order_no FROM t_refund r ); ``` 那天退款表里正好有一条历史数据,`order_no` 是空的。导入时字段允许 NULL,没人注意。就这一行,让整个对账脚本静默返回空。没有报错,没有告警,只有一张对不上的报表。 ## 四、聚合和唯一索引也在悄悄改数 NULL 还会在聚合里悄悄改数。`COUNT(*)` 数行,`COUNT(col)` 只数非空。两者差多少,就是这一列有多少 NULL。`SUM` 和 `AVG` 也会跳过 NULL,`AVG` 的分母变小,均值就偏高。对账时用 `AVG` 对金额,差一点都可能是 NULL 造成的。 唯一索引也拦不住 NULL。InnoDB 里判断唯一,用的是等值比较。NULL 和 NULL 比较是 UNKNOWN,不算重复。所以一个唯一索引列,可以插进多个 NULL。联合唯一索引也一样,只要有一列是 NULL,这一行就能重复。想让业务字段真正唯一,先把列改成 `NOT NULL`。 `COUNT(DISTINCT col)` 同样跳过 NULL。做去重统计时,这个数会比实际少。`ON DUPLICATE KEY UPDATE` 也受它影响。唯一键里带 NULL,冲突判断不成立,语句会走插入。业务想要幂等,唯一键就别留可空列。 ```sql SELECT COUNT(*) AS rows_all, COUNT(coupon_id) AS rows_not_null FROM t_order; -- 唯一索引列可以插入多个 NULL CREATE UNIQUE INDEX uk_code ON t_user(code); INSERT INTO t_user(code) VALUES (NULL), (NULL); ``` ## 五、 索引、排序与分组 NULL 在索引里是有位置的。`IS NULL` 能走索引,执行计划里常见 `ref_or_null`。但 NULL 的选择性通常很差,一查就是一大片。它也不参与等值匹配,`col = 1` 不会带出 NULL。做统计时,NULL 的比例要单独看,别混进平均值里。 排序和分组也有自己的规则。`ORDER BY` 升序时,NULL 排在最前面。`GROUP BY` 会把所有 NULL 归成一组,`DISTINCT` 也把多个 NULL 当成一个。这些行为不报错,但和很多人的直觉不一样。报表里数字对不上,先想想有没有 NULL 被合并了。 `ORDER BY` 降序时,NULL 排在最后。分页查询如果按可空列排序,前后两页可能对不上。`GROUP BY` 的 NULL 组也容易被漏看。做报表时,先把 NULL 转成业务上的默认值。比如空城市统一写成未知,分组才不会漂。 ## 六、三种改法 改法有三条,按场景选。子查询里的列如果能保证非空,`NOT IN` 本身没问题,但要靠约束保证。拿不准的话,在子查询里加 `WHERE col IS NOT NULL`,先把 NULL 过滤掉。更稳的写法是 `NOT EXISTS`,它只看有没有匹配行,不受三值逻辑影响。 ```sql -- 写法一:先把子查询里的 NULL 过滤掉 SELECT o.order_no FROM t_order o WHERE o.pay_date = '2026-10-25' AND o.status = 'PAID' AND o.order_no NOT IN ( SELECT r.order_no FROM t_refund r WHERE r.order_no IS NOT NULL ); -- 写法二:NOT EXISTS,不依赖三值逻辑 SELECT o.order_no FROM t_order o WHERE o.pay_date = '2026-10-25' AND o.status = 'PAID' AND NOT EXISTS ( SELECT 1 FROM t_refund r WHERE r.order_no = o.order_no ); ``` `NOT EXISTS` 还有一个好处,执行计划更容易走反连接。`NOT IN` 遇到可空列,优化器不敢直接转反连接。它得先处理 NULL 语义,往往退化成物化子查询。数据量一大,差的就是几倍时间。写法上的一个小改动,能同时修正确性和性能。 根本的办法还是约束。业务上不允许空的列,建表时就写 `NOT NULL`,再给默认值。已经上线的表,先补数据,再改约束,顺序不能反。直接加 `NOT NULL`,老数据里的 NULL 会让变更失败。这一步要排窗口,别在业务高峰做。 改约束前,先跑一遍空值统计。`SELECT COUNT(*) FROM t WHERE col IS NULL`。有数据就先补,补完再改。大表别直接 `ALTER`,会锁表或吃满 IO。用在线改表工具,或者分批补、最后切约束。顺序反了,变更会卡在门槛上。 默认值也别乱给。`NOT NULL DEFAULT ''` 会把空字符串塞进业务里。后面统计时,空串和真实值混在一起。用 `0` 还是 `''`,要和业务确认。默认值填错,等于把 NULL 换了个名字。问题没消失,只是更难查。 ## 七、避坑清单 结果少了,先看条件里的 NULL,别先怀疑数据丢了。`NOT IN` 的子查询里,只要有一行 NULL,整条查询就会返回空。先过滤 NULL,或者直接换 `NOT EXISTS`。`IN` 相对安全,但别把两者混着记。 聚合的分母要看清。`COUNT(*)` 和 `COUNT(col)` 不是一回事,`AVG` 会跳过 NULL,均值会被抬高。唯一索引也不保证 NULL 唯一,多个 NULL 能同时存在。建约束之前,先把这些数核对一遍。 最后一条是我自己踩的。对账脚本里的 `NOT IN` 跑了半年没事,因为退款表当初没有 NULL。后来加了线下退款导入,`order_no` 允许空,脚本一夜之间全空。我第一反应是查数据,查了两小时才回头看 SQL。现在子查询只要可能为空,我一律加 `IS NOT NULL` 或改 `NOT EXISTS`。约束也会先补上。 ## 写在最后 NULL 最麻烦的地方,是它不报错。条件变成 UNKNOWN,行就悄悄没了。你以为数据丢了,其实是被 SQL 过滤掉了。查错方向,越查越慌。 结果少了,先看条件里的 NULL。再看聚合的分母,最后看唯一约束。这三处都干净,再去怀疑同步和存储。顺序对了,能省很多时间。 你们被 NULL 坑过吗?是 `NOT IN` 查空,还是 `COUNT` 少算?当时是怎么定位的?评论区聊聊。 我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋

优秀的个人博客,低调大师

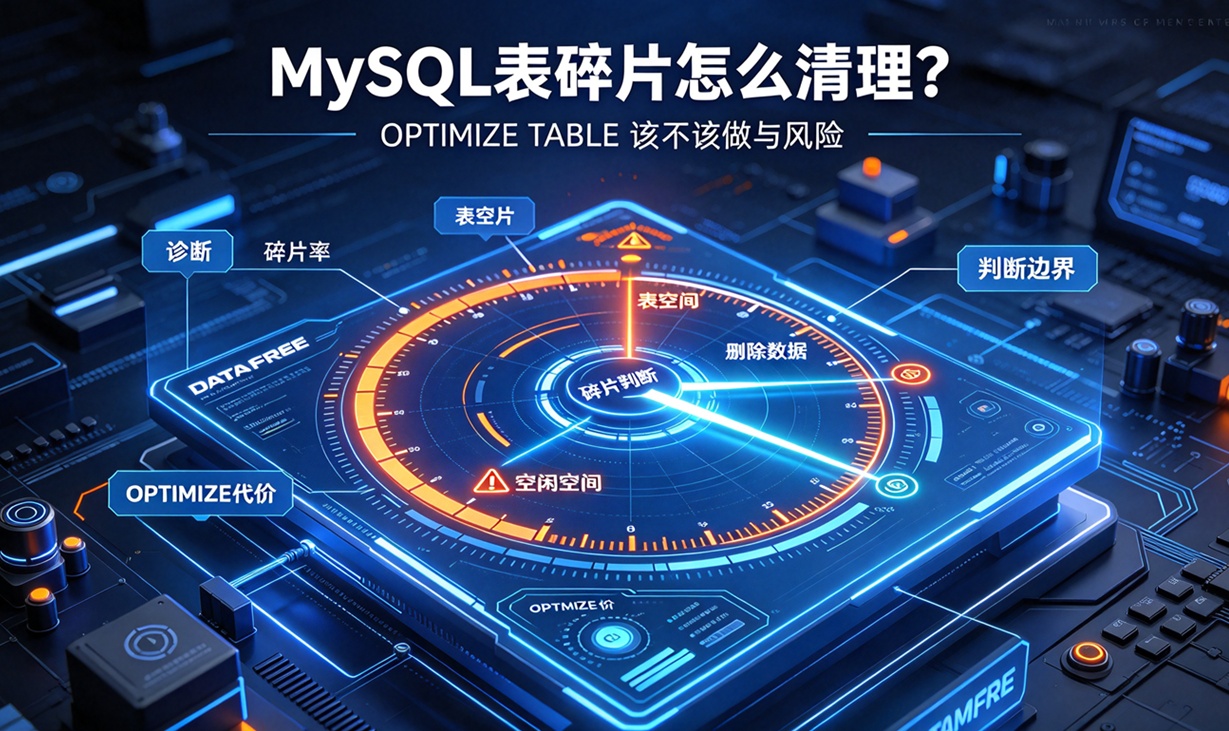
MySQL表碎片怎么清理?OPTIMIZE TABLE的3个代价与替代方案

大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。 有回清理历史数据,一张大表删掉了一大半。删完我去看磁盘,几乎没动。我以为删错了,又核对了一遍行数,确实少了。数据没了,空间却还占着。我第一反应是跑 OPTIMIZE TABLE,把空间收回来。结果那条命令跑了很久,磁盘更紧张了,业务也开始报慢查询。后来才分清楚,删数据和回收空间,中间隔着一道重建的成本。 ## 删了数据,空间去哪了 InnoDB 删一行,不是马上把它从磁盘上抹掉。它把对应的页标记成可复用,放进表空间的空闲列表。这些页还能被新数据用上。DELETE 之后继续写入,空间是能复用的。可它们不会自动还给操作系统。你看到磁盘没降,是正常的。 碎片也不全是删出来的。主键随机插入、变长字段更新,同样会留空洞。页装满了再插,InnoDB 会做页分裂,把一页拆成两页。行变长放不下,就迁到另一页,原位置留个指针。 空隙攒多了,同样的行数要读更多页。表占的空间变大,扫表的 IO 也跟着涨。还有更隐蔽的一层。页里空着一半,一页能装的有效行就少。buffer pool 缓存的数据跟着变少,命中率会往下掉。空间的问题,最后会变成内存的问题。不过说到底,这些空隙都会算进同一个数。`information_schema.tables` 里的 `DATA_FREE` 就是这块空间。 ```sql SELECT table_name, ROUND(data_length/1024/1024, 1) AS data_mb, ROUND(index_length/1024/1024, 1) AS index_mb, ROUND(data_free/1024/1024, 1) AS free_mb FROM information_schema.tables WHERE table_schema = 'app_db' ORDER BY data_free DESC; ``` `free_mb` 大,说明表里空着。但空着不等于能还回去,得先看它是不是在独立表空间里。顺便说一句,`TRUNCATE` 和 `DROP` 会把整张表的空间还给操作系统,`DELETE` 不会。所以要清空整表,别用 DELETE 一行一行删。 ## 先问一句:你缺的是空间,还是性能 很多人跑到这一步就直接 OPTIMIZE。先停一下,问自己缺什么。缺空间,才谈回收。缺性能,碎片多半不是主因。查询慢先去查执行计划、索引、统计信息,别拿 OPTIMIZE 当万能药。碎片带来的收益,通常远小于它花的代价。 缺空间也分两种。磁盘还宽裕,那不用管,这些页迟早被新数据复用。磁盘真的紧,才需要缩一次。这里有个前提。只有 `innodb_file_per_table=ON`,每张表才有自己的 `.ibd` 文件,缩表才有意义。要是还开着共享表空间,空间都在 `ibdata1` 里,OPTIMIZE 单表也缩不回操作系统。 ```sql SHOW VARIABLES LIKE 'innodb_file_per_table'; ``` ## 怎么量碎片,别被 DATA_FREE 骗 `DATA_FREE` 能看个大概,但它有个坑。它统计的是表空间里的空闲页,不完全等于碎片。有些空闲页是预留的,有些才是碎片,混在一起。所以别只盯一个数,先把比例算出来。如果表是分区表,`information_schema.tables`里的DATA_FREE是估算值,更准确的方式是查`INFORMATION_SCHEMA.PARTITIONS`,把各分区的DATA_FREE加起来。 ```sql SELECT table_name, ROUND(data_free / (data_length + index_length + data_free) * 100, 1) AS frag_pct FROM information_schema.tables WHERE table_schema = 'app_db' AND data_free > 0 ORDER BY frag_pct DESC; ``` 一般超过百分之二三十,才值得往下谈回收。可比例只是一个数,还得看两样: - 删掉了多少行,表实际行数降了多少 - 查询有没有真的变慢 只有「删了很多、空间吃紧、查询也受影响」同时成立,OPTIMIZE 才值得做。单独看 `DATA_FREE` 大就动手,多数时候是白忙。 ## OPTIMIZE 到底做了什么 它本质是一次表重建。8.0 里 InnoDB 的 OPTIMIZE 会映射成 `ALTER TABLE ... FORCE`,把表重新写一遍,把空洞挤掉。 ```sql OPTIMIZE TABLE t_order; -- 等价于重建表:ALTER TABLE t_order FORCE; ``` 默认走在线 DDL,允许并发写入。但这不代表没代价。第一,开始和结束要拿元数据锁。正好有长事务或慢查询在表上,它就排队等,后面的 DML 也跟着堵。第二,要额外空间。重建时得写一份新的表文件,大小接近原表。磁盘本来就紧,这一下可能直接写满。这也解释了我那次磁盘为什么更紧张。 第三,很吃 IO,也会产生大量 redo 和 binlog。大表重建,主从延迟跟着起来。第四,它是一次性的。表以后继续删、继续写,还会再产生空洞。别把它当日常保养。 还有个附带效果。重建会把二级索引一起重写,统计信息也重新采样。有些表重建后查询变快,不是碎片少了,是统计信息终于对了。这个收益换个方式也能拿到。别把功劳全算在碎片上,更别为了它去动一张大表。 ## 该不该做,看这张表 | 场景 | 建议 | | --- | --- | | 表不大、磁盘紧、低峰窗口够 | 可以 OPTIMIZE | | 大表、写入热点、窗口不够 | 别直接做,走在线工具或分区 | | 碎片占比不高 | 不值得,收益有限 | | 查询慢但碎片不是主因 | 先查索引和执行计划 | | 共享表空间(file_per_table=OFF) | OPTIMIZE 单表缩不回去 | | 刚删完、后面还有大量写入 | 先别做,空页很快被复用 | | 碎片高但表只有几十 MB | 收益太小,不值得开窗口 | 大表要重建,我更倾向两种做法。一种是分区滑动。按时间分区的表,历史分区直接 `DROP PARTITION`,空间立刻回来,不用重建整张表。前提是表和查询都按分区键走。 另一种是在线重建工具。gh-ost 或 pt-online-schema-change,边搬数据边限速,能控制对主库和主从的影响。 ```bash # pt-osc 在线重建,带限速 pt-online-schema-change \ --alter "ENGINE=InnoDB" \ --max-load Threads_running=30 \ --critical-load Threads_running=60 \ --sleep 0.5 \ D=app_db,t=t_order ``` `--max-load` 和 `--critical-load` 是两道刹车,压力高了自动停。比裸跑 OPTIMIZE 稳得多。两个工具的路子不一样,选之前先看清楚。 | 工具 | 怎么搬增量 | 代价 | | --- | --- | --- | | pt-osc | 建触发器,把增量同步进影子表 | 每行写入多一层触发器开销,外键场景受限 | | gh-ost | 订阅 binlog,把增量回放进影子表 | 依赖 ROW 格式,磁盘要留两份表的余量 | 两个都要额外磁盘,也都绕不开 cut-over 那一刻的短暂锁。工具能限速,省不掉空间。空间够不够,先算再决定。下面这条查出重建大致要多大,再拿 `df -h` 对一下余量。留不到原表的一点二倍,就别在这台机器上动手。 ```sql SELECT table_name, ROUND((data_length + index_length) / 1024 / 1024, 1) AS rebuild_mb FROM information_schema.tables WHERE table_schema = 'app_db' AND table_name = 't_order'; ``` ## 真要跑,盯住这几点 重建一开始,先确认别被元数据锁堵住。有长事务持着这张表的 MDL,OPTIMIZE 就得一直等,后面的 DML 跟着排队。 ```sql SELECT waiting_pid, waiting_table, blocking_pid, sql_kill_blocking_query FROM sys.schema_table_lock_waits; ``` waiting 里是 ALTER TABLE,blocking 是一条长事务,那就别干等。先把那条事务处理掉。跑起来之后,盯三样:主从延迟、`Threads_running`、剩余磁盘。哪个不对就停。要停可以 KILL。但在线 DDL 有回滚,回滚本身也要时间,别以为停一下就立刻干净。 ## 缺的是空间,才谈回收 OPTIMIZE 不是日常保养,是一次手术。手术要有指征,要备血,要挑时间。你缺的是磁盘,才谈回收。缺的是速度,先查别处。把两件事混在一起,就容易在不该动刀的时候动刀。结果业务也跟着慢。 还有一种情况容易被忽略。表定期清,机器却一直没扩容。每次靠 OPTIMIZE 硬挤,挤出几十 G,过两个月又满。这是在拿手术替代体检。空间规划得回到容量和分区设计上。一张表一张表地救,救不过来。 ## 避坑清单 删了数据磁盘不降是常态,InnoDB 不会自动把页还给操作系统。别一看没降就慌,先看磁盘还够不够。 OPTIMIZE 要额外空间、要拿 MDL、吃 IO。大表别直接跑,低峰、留足空间,或用在线工具限速。 最后一条是我自己踩的。我有回磁盘紧,直接对大表跑了 OPTIMIZE,没算临时空间。跑到一半磁盘更满了,业务查询也跟着慢。后来才知道,重建要一份接近原表大小的空间。现在我做之前,先看剩余空间够不够原表的一点二倍。不够就先扩容,或者换方案。 ## 写在最后 删数据容易,回收空间要算账。重建的成本、锁的等待、IO 的冲击,还有一份额外空间,全在账上。这笔账也让我重新认识了「删除」。在数据库里,大多数删除只是逻辑上的。行没了,空间还在,空洞替你记着发生过什么。 想让它真的回来,得有人挑时间、留余量、承担一次完整的重建。这件事没有捷径。代价不会消失,只会换个地方付。 所以碎片这道题,难在判断,不在命令。你缺的是磁盘还是速度,现在该动还是该等,都得自己拿主意。磁盘会满,业务会忙。能在这两件事之间做对一次选择,比会敲十条命令值钱。 你们的表碎片是定期清,还是磁盘告警了才清?评论区聊聊。 我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

用户登录
用户注册