首页 文章 精选 留言 我的

精选列表

搜索[notepad  ],共10025篇文章
优秀的个人博客,低调大师

Java并发编程笔记2-线程可见性&线程封闭&指令重排序

一.指令重排序 例子如下: public class Visibility1 { public static boolean ready; public static int number; } public class ReaderThread extends Thread { @Override public void run() { while (!Visibility1.ready){ Thread.yield(); System.out.println(Visibility1.number); } } } public class Test1 { public static void main(String[] args) { new ReaderThread().start(); Visibility1.number = 42; Visibility1.ready = true; } } 多次运行结果分别如下: 可以看到多次运行所得到三种结果,分别为0,42,没有输出结果。 程序一开始执行,默认将ready赋值为false,ready默认赋值为0,一开始执行时,在ReaderThread中符合循环条件,进入循环,遇到 Thread.yield();这语句是就是说当一个线程使用了这个方法之后,它就会把自己CPU执行的时间让掉,让自己或者其它的线程运行。如果自己先走出现结果为0的情况,因为,默认初始int的类型数据为0,如果让别的线程先走让这样就又回到了Main方法中的继续执行 Visibility1.number = 42;Visibility1.ready = true;这两条语句,问题来了,这两条语句会按照程序的顺序执行吗?答案是,并不一定的。这就涉及到指令重排序问题,也就是说 CPU一般采用流水线来执行指令。一个指令的执行被分成:取指、译码、访存、执行、写回、等若干个阶段。然后,多条指令可以同时存在于流水线中,同时被执行。 指令流水线并不是串行的,并不会因为一个耗时很长的指令在“执行”阶段呆很长时间,而导致后续的指令都卡在“执行”之前的阶段上。 重排序的目的是为了性能。 也就是说,有时候CPU认为 Visibility1.ready = true; 语句执行要快,所以让Visibility1.ready = true;先执行。这就导致了会出现了无输出结果。这就是涉及了指令重排序问题,虽然这里如果出现了指令重排序问题, 进入生产开发会造成严重的后果的。但是要注意一点,如下: 二.可见性 可见性,是指线程之间的可见性,一个线程修改的状态对另一个线程是可见的。也就是一个线程修改的结果。另一个线程马上就能看到。比如:用volatile修饰的变量,就会具有可见性。volatile修饰的变量不允许线程内部缓存和重排序,即直接修改内存。 所以对其他线程是可见的。但是这里需要注意一个问题,volatile只能让被他修饰内容具有可见性,但不能保证它具有原子性。比如 volatile int a = 0;之后有一个操作 a++;这个变量a具有可见性,但是a++ 依然是一个非原子操作,也就这这个操作同样存在线程安全问题。 先看如下程序: public class Visibility { private static boolean bChanged; public static void main(String[] args) throws InterruptedException { new Thread(){ @Override public void run() { for (; ; ){ if (bChanged == true){ System.out.println("!="); System.exit(0); } } } }.start(); Thread.sleep(10); new Thread(){ @Override public void run() { for (; ; ){ bChanged = true; } } }.start(); } } 运行结果为: 可以看到运行为死循环。按道理来说应该会输出!=结束的。但是为什么会出现死循环呢?原因是因为程序中bChanged如果没有手动赋值前,默认是false的,所以一开始没输出,但是第二线程命名修改了bChanged的值了,为什么还不退出呢,因为线程是CPU启动的,而CPU一开始从主存中取数据并没有立即将数据送到CPU,而是先送到了缓存中,而,另外一个线程修改bChanged的值,是就该主存中的值,而那个输出结果的线程并没有从主存中取bChanged的值,而是去缓存中取了bChanged的值,而缓存中bChanged的值是false,这就是为什么会死循环的原因。如下图: 解决办法: 1.在成员变量中加入关键字volatile,如下: private volatile static boolean bChanged; 这个关键字告诉线程一定要走内存,不要再从缓存中获取数据了。只要已修改,其他线程立马知道值已经被修改了,因为它们都是从主存中取的数据。修改后的结果如下图: 可以看到程序立马结束。并且有输出。因为这个关键字让这个成员变量都可见了。这就是线程的可见性。 其实volatile关键字还有一个功能就是:阻止指令排序。但是这只是相对的阻止。如下: 以前官方推荐是volatile,但是现在synchronized已经优化的很好了。不要刻意去用volatile。如果一个类加上volatile关键字,那么它的成员变量也会默认加上volatile关键字。 volatile只能解决可见性。一定程度上解决指令排序,但是是相对的。 但是volatile解决了可见性,就一定可以解决问题了吗?并不是的。例子如下: 如果你只希望单一变量可见性,volatile是可以的,但是如果关注的不是单一变量volatile就不管用了。 2.用synchronize加锁的办法。它能解决可见性,原子性。 三.线程封闭 实现好的并发是一件困难的事情,所以很多时候我们都想躲避并发。避免并发最简单的方法就是线程封闭。什么是线程封闭呢? 当访问共享变量时,往往需要加锁来保证数据同步。一种避免使用同步的方式就是不共享数据。如果仅在单线程中访问数据,就不需要同步了。这种技术称为线程封闭。在Java语言中,提供了一些类库和机制来维护线程的封闭性,例如局部变量和ThreadLocal类, 线程封闭其实就是不共享数据就行了。 线程封闭方法有: 1.不要共享变量,在变量中加final关键字 2.栈封闭:栈封闭是我们编程当中遇到的最多的线程封闭。什么是栈封闭呢?简单的说就是局部变量。多个线程访问一个方法,此方法中的局部变量都会被拷贝一分儿到线程栈中。所以局部变量是不被多个线程所共享的,也就不会出现并发问题。所以能用局部变量就别用全局的变量,全局变量容易引起并发问题。如果了解JVM应该懂得。 3.ThreadLocal线程绑定。ThreadLocal内部维护了一个Map,Map的key是每个线程的名称,而Map的值就是我们要封闭的对象。每个线程中的对象都对应着Map中一个值,也就是ThreadLocal利用Map实现了对象的线程封闭。 想要操作什么数据,可以先把数据放在ThreadLocal中绑定,用的时候才取出来。 例子如下: public class LocalTest { private int num; public int getNum() { return num; } public void setNum(int num) { this.num = num; } } public class ThreadLocalDemo { private static ThreadLocal<LocalTest> threadLocal = new ThreadLocal<LocalTest>(); public static void main(String[] args) throws InterruptedException{ final LocalTest local = new LocalTest(); new Thread(){ @Override public void run() { for (; ; ){ threadLocal.set(local); LocalTest l = threadLocal.get(); l.setNum(20); System.out.println(Thread.currentThread().getName() + "---" +threadLocal.get().getNum()); Thread.yield(); } } }.start(); new Thread(){ @Override public void run() { for (; ; ){ threadLocal.set(local); LocalTest l = threadLocal.get(); l.setNum(30); System.out.println(Thread.currentThread().getName() + "---" +threadLocal.get().getNum()); Thread.yield(); } } }.start(); } } 结果如下: 可以看到各个线程对应的值并没有乱。

优秀的个人博客,低调大师

Java并发编程笔记1-竞争条件&amp;初识原子类&amp;可重入锁

我们知道,在多线程访问一个共享变量的时候会发生安全问题。 首先看下面例子: public class Counter { private int count; public void add(){ try{ for (int i = 0;i<200;i++){ Thread.sleep(100); this.count++; System.out.println(this.count); } }catch (Exception e ){ e.printStackTrace(); } } } public class Test { public static void main(String[] args) { final Counter counter = new Counter(); new Thread(new Runnable() { public void run() { counter.add(); } }).start(); new Thread(new Runnable() { public void run() { counter.add(); } }).start(); new Thread(new Runnable() { public void run() { counter.add(); } }).start(); } } 运行结果如下: 如果没发生线程对数据的赃操作,3个线程执行,结果会累加到600的,看上面结果明显没有,并且出现一下重复的数据。这是因为存在3个线程同时操作同一个数字,导致输出重复数字。 解决办法: 1.在方法上加上synchronized关键字。如下图: 虽然结果不会出现重复,但是synchronized效率及其低下,运行速度明显被拖慢。原因是,for循环中的i变量是每个线程都有独自的局部变量,各不影响,但是每个线程都要排队进入这个方法,排队睡觉,这样就导致效率低下 2.在竞争条件上加synchronized,我们知道各个线程其实竞争的是count这个成员变量。因此在此地方加即可。如下图: 这样运行效率比方法一快了很多,因为省去了排队进入方法,排队睡觉。只需要排队取count值即可,这样效率比方法一快。 注意上图中,输出语句并不是竞争条件,并不一定要放在synchroized里面,这里放在里面是为了让线程取到值自增后立即输出,这样输出就不会发生混论,不发生抢占输出问题,一样能累加到600, 如果把输出放在synchronized外面会出现值有重复现象,因为累加后的值并没有立即输出,这样导致输出混乱,但仍然能加到600.知识输出不安全罢了。 3.使用原子类型,比如将上面的代码的int count类型改成AtomicInteger count类型,我们知道获取count的值然后再自加个1是可能会出现问题的,也就是结果出现重复数字。AtomicInteger类型是以同步的方法解决这个问题的。如下图: 结果如下图: 可以看到数字的输出没有严格的排队,但是数据确实给你保证的了,就是完整的加到600.这也恰恰因为不是严格的进行排队,才是的这种方法比前面两种方法的效率大大改进。 理论总结:synchronized是一种内部锁,就是所对象内部给我们提供的,因为每一个对象有一个状态变量,相当于一个锁,进入同步块,改变这个变量。别的线程进入之后就要判断这个变量有没有改变。 一个线程获取它本生已经持有的锁,这是可以成功的。我们知道多个线程同时抢占同一个锁它们是失败的。因为它们之间是互斥的。但是呢,一个线程再次获取一个自己已经拿过的锁是可以成功的,那么它是能够成功的。 看如下例子: public class Widget { public synchronized void doSth(){ } } public class ChildWidget extends Widget { @Override public synchronized void doSth() { super.doSth(); } } public class Test { public static void main(String[] args) { Widget w = new ChildWidget(); w.doSth(); } } 子类调用自己的方法的那个synchroized那个锁是w对象的这个锁,而在子类方法中的super.doSth()父类中的方法的synchronized的锁也是w对象的锁。因此不要被子类继承父类的方法中的锁所迷惑了。 因此这种方式叫做内部锁的可重入机制,也叫可重入锁。

优秀的个人博客,低调大师

如何提升mysql replication的性能&amp;&amp;多线程传输二进制日志

如何提升replication的性能: 延迟 : 对于mysql replication来说,在没有发生故障的情况下,出现master与slave数据不同步,延迟分为以下两种情况: 经常性延迟 : 异步同步的数据差距比较大 ,周期性的,循环。 暂时性延迟 : 突发情况,导致延迟 其主要原因就是: 网络带宽 I/O 如何减少replication延迟?? 1,最好使用内网或者专线链路传输binlog数据 (千兆网卡、还不够的话,bounding 技术,扩展带宽) 在my.cnf中强制使用内网ip传输数据bind-address=ip 2,将二进制保存在独立的存储介质上(提升I/O) 3,买多核CPU,使用多线程方式传输二进制日志 () 4,如果二进制日志不是row格式,则尽可能不要再insert 或者update的时候使用select ,statement模式会给master传输二进制时候造成大的压力 5,想尽办法减少master的写I/O(memcached)(既要写自己的二进制日志,也要负责读自己的二进制日志写给slave服务器),master上的I.O越低,越能快的将binlog传输给slave、 加memcached 缓存层,数据库上次做个缓冲池放到内存中,由memcached管理,周期性的将数据同步给数据库,把大并发的写操作,合并成小量的写操作。以此减少master写I/O 架构设计1: 主从服务器可以使用不同的存储引擎,master上使用innodb,利用事务,行锁等高级锁特性,slave上使用MYISAM,读性能更好,节省内存,容易备份。还可以使用不同的数据类型,例如 master上用varchar,slave上用char。不仅节省空间,还可以使用myisam的静态表特性。 M-S--Muti SLAVE方案中,中继slave还可以使用blackhole存储引擎,blackhole存储引擎值记录日志,不写数据,此特性可以让中继日志性能提升很多,但是,这种方案不支持GTIDs模式下的 replication,因为blackhole只能搭配statement格式的二进制日志使用,row和mixed格式都不支持。 在读写分离中,主存服务器采用不同索引采用不同方案,master可以只保留主键或者唯一索引等保证数据关系的索引,而slave针对查询做索引优化、 架构设计2: 让更新频繁,且需要实时的数据查询放到master上,再通过持久化session,让发生修改的用户先看到结果,其他人等待同步完后同步replication, 如果开发做不到,用下面的memcached,在数据之前加上memcached 让用户对数据库的更改先保存到memcached中,memcached是一种内存中的存储引擎(独立第三方技术),由于内存的读写性能很高 ,可以把读写特别频繁的更新数据保存到这里,每隔5分钟 ,再把数据同步到master,对于另一个客户端来说,让他优先到master找数据,即在master上的memcached中读数据,在读slave。这样可以优先将更改的数据由内存返回给用户,这样降低了 降低硬盘IO,对于那些已经同步后数据把他分离到slave,这样master就可以转们做有关于的数据更新的写操作,完全分离了master的读。 动态缓存是讲用户请求比较频繁的动态数据缓存到memcached中,使得后续的访问用户可以直接从memcached中取数据 replication容量: 是指:replication延迟程度、 将replication暂停一段时间(M),再重新开启,并观察slave多久可以达到于master一致(N) replication容量=N:M 建议保持容量在3倍以上,即1:3 (1小时的M,20分钟的N) 多线程传输二进制日志: mysql5.6开始支持多线程方式传输二进制日志 只能工作在GTIDs 模式下 只有对不同的库执行的操作才能采用多线程传输。同一个库不同表的操作只能单独用单进程传输。 my.cnf [mysqld] slave-parallel-workers=N 默认是0 表示不开启 线程数 N 根据CPU的核数来决定,几核就写几,和数据库的数量一一对应,几个库就是几个线程来传输二进制日志 ,qps上万的话,多线程传输会有很明显的性能提升 本文转自crazy_charles 51CTO博客,原文链接:http://blog.51cto.com/douya/1606236,如需转载请自行联系原作者

优秀的个人博客,低调大师

阿里云服务器 &amp;&amp; 如何window链接到阿里云服务器

现在的时间是:2016年10月11日 1:购买学生机 阿里云手机app上 -> 学生专区 -> 购买: 需要注意的是:如果没有自己需要的系统,比如没有linux操作系统的ecs,那么先随便选择一个,买以后再到pc端的官网了改操作系统 如果买的时候没有付款,第二次再买的时候价钱就会变成40.8元,这是需要在pc端官网里 费用中心 -> 订单管理 里支付第一笔订单就可以了 2: 链接阿里云服务器 ssh工具链接:xShell5、SecureCRT、MobaXterm

优秀的个人博客,低调大师

简述负载均衡&amp;CDN技术

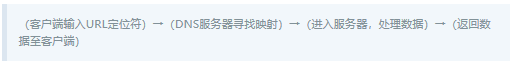
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 曾经见到知乎上有人问“为什么像facebook这类的网站需要上千个工程师维护?”,下面的回答多种多样,但总结起来就是:一个高性能的web系统需要从无数个角度去考虑他,大到服务器的布局,小到软件中某个文件的实现,甚至于某个循环内的运算如果出现不严谨都可能导致全盘崩溃。 上面提到web性能优化需要多个角度去考虑,我们无法考虑到所有的优化细节,但可以从我们已知的层面去优化,我们就先从网络层面说起。 ①网络请求路径: 在这个用例中我们可以很清晰的看出网络请求到返回的过程,虽然非常抽象,但足够我们以他为基础来进行优化了。 1)负载均衡 在计算机上负载均衡也类似如此,我们的大BOSS客户端将请求发送至服务器,然而一台服务器是无法承受很高的并发量的,我们就会将请求转发到其他服务器,当然真正的负载均衡架构并不是由一台server转发的另一台server,而在客户端与服务器端中间加入了一个负责分配请求的负载均衡硬件(软件)。 DNS 最早的负载均衡就是利用搭建本地DNS服务器实现的,实现方式简单易懂,为同一个主机名分配多个映射 ,可采用轮循,随机等方式分配请求。 看上去没什么问题,但是在使用过程中会发现,如果其中一个地址down机,我们是无法及时发现的,如果有用户被分配到这个主机就会出现访问失败的状况,同时我们也无法判断每个server的负载,可能会出现,某个server几乎闲置,另外一个server负载压力极高的情况。 硬件设备 负载均衡设备拥有非常好的负载均衡性能,他拥有众多的负载均衡策略(权重,动态比率,最快模式,最小连接数等),可以保证以相对较优的方式分配请求,不过好的东西总是有代价的,那就是价格,一台负载均衡器的售价往往高达十几万甚至几十万,许多企业并不愿意为它买单。 反向代理 第一次听到“反向代理”,可能有些陌生,但如果了解与之对应的正向代理就很好理解了,正向代理通常由客户端主动链接,比如我们的科学的上网方式就是使用正向代理,以达到间接访问网站的目。 而反向代理在服务器端,无需主动链接,当我们访问拥有反向代理的网站时,实际访问的是其反向代理服务器,而非真正的服务器,当请求到达反向代理服务器时,反向代理服务器再将请求转发至服务器。 反向代理是实现负载均衡的主流手段之一,通常使用Nginx等服务器搭建,Nginx同样拥有众多的分配策略,以保证平均分配压力。 2)CDN 视频总在缓冲,图片各种加载不出来,几年前是再正常不过的事了,在当时大家也没觉得是回事,但把这种情况放在现在,我想人们绝对直接就小红叉了吧,那么我们如何避免这样的情况呢?这就是我要说的,内容分发网络(Content Delivery Network),简称:CDN。CDN简单的来说就是存储一些静态文件的一台或多台服务器,通过复制,缓存等方式,将文件保存其中。 1.哪些是静态文件? css,html,图片,媒体都属于静态文件,也就是说用户发送的请求不会影响静态文件的内容,而jsp,php等文件就不属于静态文件,因为他们的内容会因我们的请求而发生改变。 2.CDN如何实现加速? 通常情况下,我们所要的数据都是从主服务器中获取,但假如我们的主服务器在南方,而访问用户在北方,那么访问速度就会相对变慢,变慢的原因有很多,例如传输距离,运营商,带宽等等因素,而使用CDN技术的话,我们会将CDN节点分布在各地,当用户发送请求到达服务器时,服务器会根据用户的区域信息,为用户分配最近的CDN服务器。 3.CDN数据从哪里来? 复制,缓存,CDN服务器可以在用户请求后缓存文件,也可以主动抓取主服务器内容。分布在各地的CDNS: 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-20本文作者:吴纹羽本文来自:“互联网架构师 微信公众号”,了解相关信息可以关注“互联网架构师”

优秀的个人博客,低调大师

Chromium Viz 浅析 - SkiaRenderer &amp; SkiaOutputSurface

关于 Viz 的系列文章 Chromium Viz 浅析 - 介绍篇Chromium Viz 浅析 - 合成器架构篇 Chromium 关于光栅化和合成的一些主要性能优化项目包括 OOPD (Out of Process Display Compositor,进程外 Display 合成器), OOPR (Out of Process Rasterization,进程外光栅化) 和 SkiaRenderer。 我们在Chromium Viz 浅析 - 合成器架构篇介绍过 OOPD,它的主要目的是将 Display Compositor 从 Browser 进程迁移到 Viz 进程(也就是原来的 GPU 进程),Browser 则变成了 Viz 的一个 Client,Renderer 跟 Viz 建立链接(CompositorFrameS

优秀的个人博客,低调大师

Centos&amp;Ubuntu 安装 Impala

环境如下 linux版本:ubuntu 14.04 LTS jdk版本:jdk1.7.0_67 hadoop版本:hadoop-2.0.0-cdh4.1.0.tar.gz impala版本:impala_1.4.0-1.impala1.4.0.p0.7~precise-impala1.4.0_all.deb hadoop-cdh下载地址:http://archive.cloudera.com/cdh4/cdh/4/ ubuntu impala下载地址:http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala/pool/contrib/i/impala/ 建议:hadoop的版本不要太高,还是用cdh4比较靠谱,之前我用了apache-hadoop2.7,hadoop2.6-cdh5,impala启动时都报了错误,原因为protobuf不兼容,该错误我查了几天。 为了方便,以下教程我在root用户下进行,及root作为使用用户。 1、安装hadoop # apt-get install openssh-server 设置免密码登录 # ssh-keygen -t rsa -P "" # cat .ssh/id_rsa.pub >> .ssh/authorized_keys 下载jdk-7u67-linux-x64.tar.gz,解压后配置环境变量 # tar -vzxf jdk-7u67-linux-x64.tar.gz # mkdir /usr/java # mv jdk1.7.0_67 /usr/java/ # vi /etc/profile export JAVA_HOME=/usr/java/jdk1.7.0_67 export PATH=$JAVA_HOME/bin:$JAVA_HOME/jre/bin:$PATH export CLASSPATH=$CLASSPATH:.:$JAVA_HOME/lib:$JAVA_HOME/jre/lib # tar -xvzf hadoop-2.0.0-cdh4.1.0.tar.gz # mv hadoop-2.0.0-cdh4.1.0 /usr/local/ # vi /etc/profile export HADOOP_HOME=/usr/local/hadoop-2.0.0-cdh4.1.0 export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export HADOOP_YARN_HOME=$HADOOP_HOME export HADOOP_LIB=$HADOOP_HOME/lib export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop export HADOOP_OPTS="-Djava.library.path=$HADOOP_HOME/lib" # source /etc/profile 2、配置hadoop,伪分布式配置 # cd /etc/local/hadoop-2.0.0-cdh4.1.0 # cd /etc/hadoop # vi hadoop-env.sh export JAVA_HOME=/usr/java/jdk1.7.0_67 # vi core-site.xml <configuration> <property> <name>hadoop.tmp.dir</name> <!-- 临时目录 --> <value>file:/root/hadoop/tmp</value> </property> <property> <name>fs.defaultFS</name> <value>hdfs://localhost:9000</value> </property> </configuration> # vi hdfs-site.xml <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.namenode.name.dir</name> <!-- namenode目录--> <value>file:/root/hadoop/tmp/dfs/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <!-- datanode目录 --> <value>file:/root/hadoop/tmp/dfs/data</value> </property> </configuration> # cd ~ # mkdir -p hadoop/tmp/dfs/name # mkdir hadoop/tmp/dfs/data 注:需要保证用户为hadoop-2.0.0-cdh4.1.0目录、namenode目录和datanode目录的拥有者 3、启动hadoop 格式化namenode # hadoop namenode -format # start-all.sh (该命令在$HADOOP_HOME/sbin) 测试 # hadoop fs -ls / #查看hdfs的/目录 # hadoop fs -mkdir /user #在hdfs创建目录user # hadoop fs -put a.out /user #在hdfs的/user下上传文件a.out # hadoop fs -get /user/a.out #下载a.out文件到本地 关闭hadoop # stop-all.sh 4、安装impala 修改源: # vi /etc/apt/sources.list.d/cloudera.list deb [arch=amd64] http://archive.cloudera.com/cm5/ubuntu/trusty/amd64/cm trusty-cm5 contrib deb-src http://archive.cloudera.com/cm5/ubuntu/trusty/amd64/cm trusty-cm5 contrib deb [arch=amd64] http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala precise-impala1 contrib deb-src http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala precise-impala1 contrib # apt-get update # apt-get install bigtop-utils 用apt-get下载impala太慢了,可在http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala/pool/contrib/i/impala/ 下载相应安装包。 # dpkg -i impala_1.4.0-1.impala1.4.0.p0.7~precise-impala1.4.0_all.deb # dpkg -i impala-server_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb # dpkg -i impala-state-store_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb # dpkg -i impala-catalog_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb # apt-get install python-setuptools 出错则根据错误修改(apt-get -f install) # dpkg -i impala-shell_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb impala安装完毕。 5、impala配置 # vi /etc/hosts 127.0.0.1 localhost 在$HADOOP_HOME/etc/hadoop下将core-site.xml及hdfs-site.xml拷贝到/etc/impala/conf # cd /usr/local/hadoop-2.0.0-cdh4.1.0/etc/hadoop/ # cp core-site.xml hdfs-site.xml /etc/impala/conf # cd /etc/impala/conf # vi hdfs-site.xml 增加: <property> <name>dfs.client.read.shortcircuit</name> <value>true</value> </property> <property> <name>dfs.domain.socket.path</name> <value>/var/run/hadoop-hdfs/dn._PORT</value> </property> <property> <name>dfs.datanode.hdfs-blocks-metadata.enabled</name> <value>true</value> </property> <property> <name>dfs.client.use.legacy.blockreader.local</name> <value>true</value> </property> <property> <name>dfs.datanode.data.dir.perm</name> <value>750</value> </property> <property> <name>dfs.block.local-path-access.user</name> <value>impala</value> </property> <property> <name>dfs.client.file-block-storage-locations.timeout</name> <value>3000</value> </property> # mkdir /var/run/hadoop-hdfs 注:保证/var/run/hadoop-hdfs为用户所有 6、impala启动 # service impala-state-store start # service impala-catalog start # service impala-server start 查看是否启动: # ps -ef | grep impala 错误信息查看日志 启动impala-shell # impala-shell -i localhost --quiet [localhost:21000] > select version(); ... [localhost:21000] > select current_database(); ... impala-shell操作见http://www.cloudera.com/documentation/enterprise/latest/topics/impala_tutorial.html#tutorial 7、impala日志错误处理 impala日志位置为:/var/log/impala impala启动错误1: Failed on local exception: com.google.protobuf.InvalidProtocolBufferException: Message missing required fields: callId, status; Host Details : local host is: "database32/127.0.1.1"; destination host is: "localhost":9000; 原因: hadoop2.6的protobuf版本为2.5,为impala用的版本为protobuf2.4 解决: 将hadoop的版本降低时与impala的版本匹配,这里impala采用二进制方式安装,无法 重新编译,解决为将hadoop的版本与impala版本一致。我下载的hadoop为hadoop-2.0.0-cdh4.1.0,impala为impala_1.4.0 impala启动错误2: dfs.client.read.shortcircuit is not enabled because - dfs.client.use.legacy .blockreader.local is not enabled 原因: hdfs-site.xml配置出错 解决: 将dfs.datanode.hdfs-blocks-metadata.enabled选项设为true impala启动错误3: Impalad services did not start correctly, exiting. Error: Couldn't open transport for 127.0.0.1:24000(connect() failed: Connection refused) 原因: 未启动impala-state-store,impala-catalog 解决: # service impala-state-store start # service impala-catalog start # service impala start Centos部分: 安装Impala过程 摘要:与Hive类似,Impala也可以直接与HDFS和HBase库直接交互。只不过Hive和其它建立在MapReduce上的框架适合需要长时间运行的批处理任务。例如:那些批量提取,转化,加载(ETL)类型的Job,而Impala主要用于实时查询。 与Hive类似,Impala也可以直接与HDFS和HBase库直接交互。只不过Hive和其它建立在MapReduce上的框架适合需要长时间运行的批处理任务。例如:那些批量提取,转化,加载(ETL)类型的Job,而Impala主要用于实时查询。 Hadoop集群各节点的环境设置及安装过程见使用yum安装CDH Hadoop集群,参考这篇文章。 1. 环境 CentOS 6.4 x86_64 CDH 5.0.1 jdk1.6.0_31 集群规划为3个节点,每个节点的ip、主机名和部署的组件分配如下: 192.168.56.121 cdh1 NameNode、Hive、ResourceManager、HBase、impala 192.168.56.122 cdh2 DataNode、SSNameNode、NodeManager、HBase、impala 192.168.56.123 cdh3 DataNode、HBase、NodeManager、impala 2. 安装 目前,CDH 5.0.1中 impala 版本为1.4.0,下载repo文件到 /etc/yum.repos.d/: 如果你安装的是 CDH4,请下载Red Hat/CentOS 6 如果你安装的是 CDH5,请下载Red Hat/CentOS 6 然后,可以执行下面的命令安装所有的 impala 组件。 $ sudo yum install impala impala-server impala-state-store impala-catalog impala-shell -y 但是,通常只是在需要的节点上安装对应的服务: 在 hive metastore 所在节点安装impala-state-store和impala-catalog 在 DataNode 所在节点安装 impala-server 和 impala-shell 3. 配置 3.1 修改配置文件 查看安装路径: $ find / -name impala /var/run/impala /var/lib/alternatives/impala /var/log/impala /usr/lib/impala /etc/alternatives/impala /etc/default/impala /etc/impala /etc/default/impala impalad的配置文件路径由环境变量IMPALA_CONF_DIR指定,默认为/usr/lib/impala/conf,impala 的默认配置在/etc/default/impala,修改该文件中的IMPALA_CATALOG_SERVICE_HOST和IMPALA_STATE_STORE_HOST IMPALA_CATALOG_SERVICE_HOST=cdh1 IMPALA_STATE_STORE_HOST=cdh1 IMPALA_STATE_STORE_PORT=24000 IMPALA_BACKEND_PORT=22000 IMPALA_LOG_DIR=/var/log/impala IMPALA_CATALOG_ARGS=" -log_dir=${IMPALA_LOG_DIR} " IMPALA_STATE_STORE_ARGS=" -log_dir=${IMPALA_LOG_DIR} -state_store_port=${IMPALA_STATE_STORE_PORT}" IMPALA_SERVER_ARGS=" \ -log_dir=${IMPALA_LOG_DIR} \ -catalog_service_host=${IMPALA_CATALOG_SERVICE_HOST} \ -state_store_port=${IMPALA_STATE_STORE_PORT} \ -use_statestore \ -state_store_host=${IMPALA_STATE_STORE_HOST} \ -be_port=${IMPALA_BACKEND_PORT}" ENABLE_CORE_DUMPS=false # LIBHDFS_OPTS=-Djava.library.path=/usr/lib/impala/lib # MYSQL_CONNECTOR_JAR=/usr/share/java/mysql-connector-java.jar # IMPALA_BIN=/usr/lib/impala/sbin # IMPALA_HOME=/usr/lib/impala # HIVE_HOME=/usr/lib/hive # HBASE_HOME=/usr/lib/hbase # IMPALA_CONF_DIR=/etc/impala/conf # HADOOP_CONF_DIR=/etc/impala/conf # HIVE_CONF_DIR=/etc/impala/conf # HBASE_CONF_DIR=/etc/impala/conf 设置 impala 可以使用的最大内存:在上面的IMPALA_SERVER_ARGS参数值后面添加-mem_limit=70%即可。 如果需要设置 impala 中每一个队列的最大请求数,需要在上面的IMPALA_SERVER_ARGS参数值后面添加-default_pool_max_requests=-1,该参数设置每一个队列的最大请求数,如果为-1,则表示不做限制。 在节点cdh1上拷贝hive-site.xml、core-site.xml、hdfs-site.xml至/usr/lib/impala/conf目录并作下面修改在hdfs-site.xml文件中添加如下内容: <property> <name>dfs.client.read.shortcircuit</name> <value>true</value> </property> <property> <name>dfs.domain.socket.path</name> <value>/var/run/hadoop-hdfs/dn._PORT</value> </property> <property> <name>dfs.datanode.hdfs-blocks-metadata.enabled</name> <value>true</value> </property> 同步以上文件到其他节点。 3.2 创建socket path 在每个节点上创建/var/run/hadoop-hdfs: $ mkdir -p /var/run/hadoop-hdfs 拷贝postgres jdbc jar: $ ln -s /usr/share/java/postgresql-jdbc.jar /usr/lib/impala/lib/ 3.3 用户要求 impala 安装过程中会创建名为 impala 的用户和组,不要删除该用户和组。 如果想要 impala 和 YARN 和 Llama 合作,需要把 impala 用户加入 hdfs 组。 impala 在执行 DROP TABLE 操作时,需要把文件移到到 hdfs 的回收站,所以你需要创建一个 hdfs 的目录 /user/impala,并将其设置为impala 用户可写。同样的,impala 需要读取 hive 数据仓库下的数据,故需要把 impala 用户加入 hive 组。 impala 不能以 root 用户运行,因为 root 用户不允许直接读。 创建 impala 用户家目录并设置权限: sudo -u hdfs hadoop fs -mkdir /user/impala sudo -u hdfs hadoop fs -chown impala /user/impala 查看 impala 用户所属的组: $ groups impala impala : impala hadoop hdfs hive 由上可知,impala 用户是属于 imapal、hadoop、hdfs、hive 用户组的 4. 启动服务 在 cdh1节点启动: $ service impala-state-store start $ service impala-catalog start 如果impalad正常启动,可以在/tmp/ impalad.INFO查看。如果出现异常,可以查看/tmp/impalad.ERROR定位错误信息。 5. 使用shell 使用impala-shell启动Impala Shell,连接 cdh1,并刷新元数据 >impala-shell [Not connected] >connect cdh1 [cdh1:21000] >invalidate metadata [cdh2:21000] >connect cdh2 [cdh2:21000] >select * from t 当在 Hive 中创建表之后,第一次启动 impala-shell 时,请先执行INVALIDATE METADATA语句以便 Impala 识别出新创建的表(在 Impala 1.2 及以上版本,你只需要在一个节点上运行INVALIDATE METADATA,而不是在所有的 Impala 节点上运行)。 你也可以添加一些其他参数,查看有哪些参数: # impala-shell -h Usage: impala_shell.py [options] Options: -h, --help show this help message and exit -i IMPALAD, --impalad=IMPALAD <host:port> of impalad to connect to -q QUERY, --query=QUERY Execute a query without the shell -f QUERY_FILE, --query_file=QUERY_FILE Execute the queries in the query file, delimited by ; -k, --kerberos Connect to a kerberized impalad -o OUTPUT_FILE, --output_file=OUTPUT_FILE If set, query results will written to the given file. Results from multiple semicolon-terminated queries will be appended to the same file -B, --delimited Output rows in delimited mode --print_header Print column names in delimited mode, true by default when pretty-printed. --output_delimiter=OUTPUT_DELIMITER Field delimiter to use for output in delimited mode -s KERBEROS_SERVICE_NAME, --kerberos_service_name=KERBEROS_SERVICE_NAME Service name of a kerberized impalad, default is 'impala' -V, --verbose Enable verbose output -p, --show_profiles Always display query profiles after execution --quiet Disable verbose output -v, --version Print version information -c, --ignore_query_failure Continue on query failure -r, --refresh_after_connect Refresh Impala catalog after connecting -d DEFAULT_DB, --database=DEFAULT_DB Issue a use database command on startup. 例如,你可以在连接时候字段刷新: $ impala-shell -r Starting Impala Shell in unsecure mode Connected to 192.168.56.121:21000 Server version: impalad version 1.1.1 RELEASE (build 83d5868f005966883a918a819a449f636a5b3d5f) Invalidating Metadata Welcome to the Impala shell. Press TAB twice to see a list of available commands. Copyright (c) 2012 Cloudera, Inc. All rights reserved. (Shell build version: Impala Shell v1.1.1 (83d5868) built on Fri Aug 23 17:28:05 PDT 2013) Query: invalidate metadata Query finished, fetching results ... Returned 0 row(s) in 5.13s [192.168.56.121:21000] > 使用 impala 导出数据: $ impala-shell -i '192.168.56.121:21000' -r -q "select * from test" -B --output_delimiter="\t" -o result.txt 版权声明:本文内容由互联网用户自发贡献,版权归作者所有,本社区不拥有所有权,也不承担相关法律责任。如果您发现本社区中有涉嫌抄袭的内容,欢迎发送邮件至: yqgroup@service.aliyun.com进行举报,并提供相关证据,一经查实,本社区将立刻删除涉嫌侵权内容。

优秀的个人博客,低调大师

MyCAT枚举分片规则 &amp; childTable

一、MyCAT简介和原理 MYCAT基于阿里开源的Cobar产品而研发,Cobar的稳定性、可靠性、优秀的架构和性能以及众多成熟的使用案例使得MYCAT一开始就拥有一个很好的起点,站在巨人的肩膀上,我们能看到更远。业界优秀的开源项目和创新思路被广泛融入到MYCAT的基因中,使得MYCAT在很多方面都领先于目前其他一些同类的开源项目,甚至超越某些商业产品。MyCAT作为通用代理设计的,后端是以Mysql协议和JDBC的方式连接数据库,可以支持Oracle、DB2、SQL Server 、 mongodb、mysql 这里简单分享一下 Mycat 中的概念及配置的相关基础 ,详细内容可以参考 官方文档 、 Mycat-Server 和 Get Start 数据库中间件 Mycat 其实只是一个数据中间件,或数据库代理 Tip: 所有难搞定的事情都可以通过中间件有效处理,中间件能有效解耦并专注于特定领域问题, LVM、LVS、MQ 都是这个思路(房屋中介,银行也都是这个思路) 所以Mycat没有存储引擎,本身并不存储数据,只是起到了请求分析,拆解,路由与结果聚合的作用,为前端应用提供统一接口,Mycat 与后端的数据库集群有机组合才一起构成一个分布式数据库系统 逻辑库(schema) 类似于LVM中VG的概念(VG由一个或多个PV构成),逻辑库是由一个或多个后端数据库构成的,展示给应用的是一个单一视图,是分布式数据库在逻辑上的一个抽象 逻辑表(table) 逻辑表 与数据库中表相对应的,分布式数据表在逻辑上的一个抽象 分片表 数据表切分后的一个部分(原表的一个真子集) 非分片表 没有分片的表,就是非分片表 ER表 保留了实体关系特性的表,就是ER表 关系型数据库是基于实体关系模型的相关理论来构建的数据库,表与表间有依赖关系,通过表分组(Table Group) 让有依赖的表在同一实例库中从而避免了数据Join不会跨库操作 全局表 全局表是所有分片上都有一份完整拷贝的表 字典表或符合字典特性的表可以被设置为全局表 有以下特点的表,被称作字典表: 变动不频繁 数据量总体变化不大 数据规模不大(很少超过十万条记录) 会与其它表发生关联 这类表可以通过冗余来解决join问题,也就是所有的分片都放上一份数据的拷贝来避免跨分片联查 Tip: 数据冗余和表分组是解决跨分片数据join的好思路,也是数据切分规划的重要规则 二、MyCAT使用测试 1、背景:schem.xml文件父表和子表,以及使用枚举分片规则 #vim ./schema.xml <table name="customer" primaryKey="ID" dataNode="dn1,dn2" rule="sharding-by-intfile"> <childTable name="orders" primaryKey="ID" joinKey="customer_id" parentKey="id"> <childTable name="order_items" joinKey="order_id" parentKey="id" /> </childTable> <childTable name="customer_addr" primaryKey="ID" joinKey="customer_id" parentKey="id" /> </table> #vim ./rule.xml <tableRule name="sharding-by-intfile"> <rule> <columns>sharding_id</columns> <algorithm>hash-int</algorithm> </rule> </tableRule> <function name="hash-int" class="io.mycat.route.function.PartitionByFileMap"> <property name="mapFile">partition-hash-int.txt</property> </function> #vim partition-hash-int.txt 1=0 2=1 10000=0 10010=1 2、登陆mycat后分别建立对应的表以及插入数据 mycat@TESTDB 08:08:56>show create table customer ; +----------+-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Table| Create Table| +----------+-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | customer | CREATE TABLE `customer` ( `SHARDING_ID` int(11) DEFAULT NULL, `id` int(11) NOT NULL, `customer_id` int(11) DEFAULT NULL, `order_id` int(11) DEFAULT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 | +----------+-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ 1 row in set (0.01 sec) mycat@TESTDB 07:19:09>insert into customer (SHARDING_ID, id ,customer_id,order_id) values (1,1,1,1); Query OK, 1 rows affected (0.05 sec) mycat@TESTDB 07:19:09>insert into customer (SHARDING_ID, id ,customer_id,order_id) values (2,2,2,2); Query OK, 1 rows affected (0.05 sec) mycat@TESTDB 07:54:27>select * from customer ; +-------------+----+-------------+----------+ | SHARDING_ID | id | customer_id | order_id | +-------------+----+-------------+----------+ |2 |2 |2 |2 | |1 |1 |1 |1 | +-------------+----+-------------+----------+ 2 rows in set (0.02 sec) mycat@TESTDB 07:43:10>show create table orders ; +--------+--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Table| Create Table| +--------+--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | orders | CREATE TABLE `orders` ( `SHARDING_ID` int(11) DEFAULT NULL, `id` int(11) NOT NULL, `customer_id` int(11) DEFAULT NULL, `customer_name` varchar(10) DEFAULT NULL ) ENGINE=InnoDB DEFAULT CHARSET=utf8 | +--------+--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ 1 row in set (0.00 sec) mycat@TESTDB 07:43:57>insert into orders (SHARDING_ID, id , customer_id ,customer_name) values (1,1,1,'qw'); Query OK, 1 row affected (0.24 sec) mycat@TESTDB 07:44:39>insert into orders (SHARDING_ID, id , customer_id ,customer_name) values (1,2,1,'qw'); Query OK, 1 row affected (0.25 sec) mycat@TESTDB 07:44:45>insert into orders (SHARDING_ID, id , customer_id ,customer_name) values (1,3,1,'qw'); Query OK, 1 row affected (0.24 sec) mycat@TESTDB 07:44:45>insert into orders (SHARDING_ID, id , customer_id ,customer_name) values (1,3,3,'qw'); ERROR 1064 (HY000): can't find (root) parent sharding node for sql:insert into orders(SHARDING_ID,id,customer_id,customer_name) values (1,3,3,'qw') mycat@TESTDB 07:45:50>select * from orders ; +-------------+----+-------------+---------------+ | SHARDING_ID | id | customer_id | customer_name | +-------------+----+-------------+---------------+ | 2 |1 | 1 | qw | | 2 |2 | 2 | qw | | 1 |3 | 2 | qw | +-------------+----+-------------+---------------+ 3 rows in set (0.01 sec) mycat@TESTDB 07:53:01>show create table order_items; +-------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Table| Create Table| +-------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | order_items | CREATE TABLE `order_items` ( `SHARDING_ID` int(11) DEFAULT NULL, `order_id` int(11) DEFAULT NULL, `order_name` varchar(15) DEFAULT NULL ) ENGINE=InnoDB DEFAULT CHARSET=utf8 | +-------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ 1 row in set (0.01 sec) mycat@TESTDB 07:53:59>insert into order_items (SHARDING_ID, order_id ,order_name) values (1,1,'qw'); Query OK, 1 row affected (0.05 sec) mycat@TESTDB 07:55:17>insert into order_items (SHARDING_ID, order_id ,order_name) values (1,2,'qw'); Query OK, 1 row affected (0.07 sec) mycat@TESTDB 07:55:30> insert into order_items (SHARDING_ID, order_id ,order_name) values (1,3,'qw'); Query OK, 1 row affected (0.07 sec) mycat@TESTDB 07:55:52>insert into order_items (SHARDING_ID, order_id ,order_name) values (1,4,'qw'); ERROR 1064 (HY000): can't find (root) parent sharding node for sql:insert into order_items(SHARDING_ID,order_id,order_name) values (1,4,'qw') mycat@TESTDB 07:56:21>select * from order_items ; +-------------+----------+------------+ | SHARDING_ID | order_id | order_name | +-------------+----------+------------+ | 1 | 2 | qw | | 1 | 3 | qw | | 1 | 1 | qw | +-------------+----------+------------+ 3 rows in set (0.02 sec) mycat@TESTDB 08:09:45> show create table customer_addr ; +---------------+--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Table| Create Table| +---------------+--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | customer_addr | CREATE TABLE `customer_addr` ( `SHARDING_ID` int(11) DEFAULT NULL, `customer_id` int(11) DEFAULT NULL, `customer_name` varchar(15) DEFAULT NULL ) ENGINE=InnoDB DEFAULT CHARSET=utf8 | +---------------+--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ 1 row in set (0.01 sec) mycat@TESTDB 07:57:59>insert into customer_addr (SHARDING_ID, customer_id ,customer_name) values (1,1,'qw'); Query OK, 1 row affected (0.26 sec) mycat@TESTDB 07:58:28>insert into customer_addr (SHARDING_ID, customer_id ,customer_name) values (1,2,'qw'); Query OK, 1 row affected (0.05 sec) mycat@TESTDB 07:58:32>insert into customer_addr (SHARDING_ID, customer_id ,customer_name) values (1,3,'qw'); ERROR 1064 (HY000): can't find (root) parent sharding node for sql:insert into customer_addr(SHARDING_ID,customer_id,customer_name) values (1,3,'yue') mycat@TESTDB 08:04:42>select * from customer_addr; +-------------+----+-------------+---------------+ | SHARDING_ID | id | customer_id | customer_name | +-------------+----+-------------+---------------+ |1 |1 |1 | qw | |1 |2 |2 | qw | |1 |3 |2 | qw | +-------------+----+-------------+---------------+ 3 rows in set (0.01 sec) 3、分片表子表配置 childTable标签: name属性 joinKey属性:插入子表的时候会使用这个列的值查找父表存储的数据节点。 parentKey属性:属性指定的值一般为与父表建立关联关系的列名。程序首先获取joinkey的值,再通过parentKey属性指定的列名产生查询语句,通过执行该语句得到父表存储在哪个分片上。从而确定子表存储的位置。 primaryKey属性:同table标签所描述的。 needAddLimit属性:同table标签所描述的。 总结:子表中的 joinKey="***_id" 字段取值取决于父表 primaryKey="ID"中的值,不然会报错(简单说 joinKey是 primaryKey的外键 )

优秀的个人博客,低调大师

人脸识别&amp;ORC的Demo

一.用到的jar包: face_sdk-1.3.4.jar json-20160810.jar ocr_sdk-1.3.4.jar 下载地址:https://files.cnblogs.com/files/DreamDrive/ocrdemo.rar 二.测试代码 FaceDetect.java 1 import java.util.HashMap; 2 3 import org.json.JSONObject; 4 5 import com.baidu.aip.face.AipFace; 6 /** 7 * 百度云人脸检测demo 8 * @author Administrator 9 * 10 */ 11 public class FaceDetect { 12 13 private static AipFace apiFace=null; 14 final static String APP_ID="9662379"; 15 final static String AIP_KEY="BGczNjdkZs5UQxUBlHzDWP6R"; 16 final static String AIP_TOKEN="lLL5C2nItGPnuXME2GM2PzfDRNtrCkRi"; 17 static { 18 if(apiFace==null){ 19 apiFace=new AipFace(APP_ID,AIP_KEY,AIP_TOKEN); 20 } 21 } 22 public void faceDetect(String path){ 23 HashMap<String,String> options=new HashMap<String,String>(); 24 options.put("max_face_num", "5"); 25 JSONObject response = apiFace.detect(path,options); 26 System.out.println(response.toString()); 27 28 // 参数为本地图片文件二进制数组 29 // byte[] file = readImageFile(path); // readImageFile函数仅为示例 30 // JSONObject response = apiFace.detect(file,options); 31 // System.out.println(response.toString()); 32 } 33 34 public static void main(String[] args){ 35 new FaceDetect().faceDetect("n:/timg3.jpg"); 36 } 37 } OcrDemo.java 1 import java.util.HashMap; 2 import org.json.JSONObject; 3 import com.baidu.aip.ocr.AipOcr; 4 public class OcrDemo { 5 6 7 //设置APPID/AK/SK 8 public static final String APP_ID = "9695214"; 9 public static final String API_KEY = "HxqwTu1M85G1UrG9DZKTNQzN"; 10 public static final String SECRET_KEY = "GVy7ah7MTRUczxS4hCuUvfCCV8oloRZX"; 11 12 public static void main(String[] args) { 13 // 初始化一个OcrClient 14 AipOcr client = new AipOcr(APP_ID, API_KEY, SECRET_KEY); 15 16 // 可选:设置网络连接参数 17 client.setConnectionTimeoutInMillis(2000); 18 client.setSocketTimeoutInMillis(60000); 19 HashMap<String, String> params=new HashMap<String,String>(); 20 // 调用身份证识别接口 21 String idFilePath = "n:/shenfenzheng1.jpg"; 22 JSONObject idcardRes = client.idcard(idFilePath, true,params); 23 System.out.println(idcardRes.toString(2)); 24 25 // 调用银行卡识别接口 26 String bankFilePath = "n:/bankcard.png"; 27 JSONObject bankRes = client.bankcard(bankFilePath); 28 System.out.println(bankRes.toString(2)); 29 30 // 调用通用识别接口 31 String genFilePath = "n:/words.png"; 32 JSONObject genRes = client.basicGeneral(genFilePath, new HashMap<String, String>()); 33 System.out.println(genRes.toString(2)); 34 35 // 调用通用识别(含位置信息)接口 36 // String genFilePath = "test_general.jpg"; 37 // JSONObject genRes = client.general(genFilePath, new HashMap<String, String>()); 38 // System.out.println(genRes.toString(2)); 39 } 40 } 本文转自SummerChill博客园博客,原文链接:http://www.cnblogs.com/DreamDrive/p/7603731.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop&amp;spark安装(上)

硬件环境: hddcluster1 10.0.0.197 redhat7 hddcluster2 10.0.0.228 centos7 这台作为master hddcluster3 10.0.0.202 redhat7 hddcluster4 10.0.0.181 centos7 软件环境: 关闭所有防火墙firewall openssh-clients openssh-server java-1.8.0-openjdk java-1.8.0-openjdk-devel hadoop-2.7.3.tar.gz 流程: 选定一台机器作为 Master 在 Master 节点上配置 hadoop 用户、安装 SSH server、安装 Java 环境 在 Master 节点上安装 Hadoop,并完成配置 在其他 Slave 节点上配置 hadoop 用户、安装 SSH server、安装 Java 环境 将 Master 节点上的 /usr/local/hadoop 目录复制到其他 Slave 节点上 在 Master 节点上开启 Hadoop 1 2 3 4 5 6 7 8 #节点的名称与对应的IP关系 [hadoop@hddcluster2~]$ cat /etc/hosts 127.0.0.1localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 ::1localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.0.0.228hddcluster2 10.0.0.197hddcluster1 10.0.0.202hddcluster3 10.0.0.181hddcluster4 1 2 3 4 5 创建hadoop用户 su #上述提到的以root用户登录 useradd -mhadoop-s /bin/bash #创建新用户hadoop passwd hadoop #设置hadoop密码 visudo #rootALL=(ALL)ALL这行下面添加hadoopALL=(ALL)ALL 1 2 3 4 5 6 7 8 9 10 11 #登录hadoop用户,安装SSH、配置SSH无密码登陆 [hadoop@hddcluster2~]$rpm-qa| grep ssh [hadoop@hddcluster2~]$ sudo yum install openssh-clients [hadoop@hddcluster2~]$ sudo yum install openssh-server [hadoop@hddcluster2~]$ cd ~/. ssh / #若没有该目录,请先执行一次sshlocalhost [hadoop@hddcluster2~]$ ssh -keygen-trsa #会有提示,都按回车就可以 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .publocalhost #加入授权 [hadoop@hddcluster2~]$ chmod 600. /authorized_keys #修改文件权限 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster1 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster3 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster4 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #解压hadoop文件到/usr/local/hadoop [hadoop@hddcluster2~]$ sudo tar -zxfhadoop-2.7.3. tar .gz-C /usr/local/ [hadoop@hddcluster2~]$ sudo mv /usr/local/hadoop-2 .7.3 /usr/local/hadoop [hadoop@hddcluster2~]$ sudo chown -Rhadoop:hadoop /usr/local/hadoop cd /usr/local/hadoop . /bin/hadoop version #安装java环境 [hadoop@hddcluster2~]$ sudo yum install java-1.8.0-openjdkjava-1.8.0-openjdk-devel [hadoop@hddcluster2~]$rpm-qljava-1.8.0-openjdk-devel| grep '/bin/javac' /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 /bin/javac [hadoop@hddcluster2~]$vim~/.bashrc export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 export HADOOP_HOME= /usr/local/hadoop export HADOOP_INSTALL=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export YARN_HOME=$HADOOP_HOME export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME /lib/native export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_OPTS= "-Djava.library.path=$HADOOP_PREFIX/lib:$HADOOP_PREFIX/lib/native" #测试java环境 source ~/.bashrc java-version $JAVA_HOME /bin/java -version #与直接执行java-version一样 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 #修改hadoop文件配置 [hadoop@hddcluster2hadoop]$ pwd /usr/local/hadoop/etc/hadoop [hadoop@hddcluster2hadoop]$ cat core-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>fs.defaultFS< /name > <value>hdfs: //hddcluster2 :9000< /value > < /property > <property> <name>hadoop.tmp. dir < /name > <value> file : /usr/local/hadoop/tmp < /value > <description>Abase for othertemporarydirectories.< /description > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ cat hdfs-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>dfs.namenode.secondary.http-address< /name > <value>hddcluster2:50090< /value > < /property > <property> <name>dfs.replication< /name > <value>3< /value > < /property > <property> <name>dfs.namenode.name. dir < /name > <value> file : /usr/local/hadoop/tmp/dfs/name < /value > < /property > <property> <name>dfs.datanode.data. dir < /name > <value> file : /usr/local/hadoop/tmp/dfs/data < /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat mapred-site.xml <?xmlversion= "1.0" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>mapreduce.framework.name< /name > <value>yarn< /value > < /property > <property> <name>mapreduce.jobhistory.address< /name > <value>hddcluster2:10020< /value > < /property > <property> <name>mapreduce.jobhistory.webapp.address< /name > <value>hddcluster2:19888< /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat yarn-site.xml <?xmlversion= "1.0" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <configuration> <!--SitespecificYARNconfigurationproperties--> <property> <name>yarn.resourcemanager. hostname < /name > <value>hddcluster2< /value > < /property > <property> <name>yarn.nodemanager.aux-services< /name > <value>mapreduce_shuffle< /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat slaves hddcluster1 hddcluster2 hddcluster3 hddcluster4 1 2 3 4 5 6 7 8 $ cd /usr/local $ sudo rm -r. /hadoop/tmp #删除Hadoop临时文件 $ sudo rm -r. /hadoop/logs/ * #删除日志文件 $ tar -zcf~ /hadoop .master. tar .gz. /hadoop #先压缩再复制 $ cd ~ $ scp . /hadoop .master. tar .gzhddcluster1: /home/hadoop $ scp . /hadoop .master. tar .gzhddcluster3: /home/hadoop $ scp . /hadoop .master. tar .gzhddcluster4: /home/hadoop 1 2 3 4 在salve节点上操作,安装软件环境并配置好.bashrc sudo tar -zxf~ /hadoop .master. tar .gz-C /usr/local sudo chown -Rhadoop /usr/local/hadoop 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [hadoop@hddcluster2~]$hdfsnamenode- format #首次运行需要执行初始化,之后不需要 接着可以启动hadoop了,启动需要在Master节点上进行启动命令: $start-dfs.sh $start-yarn.sh $mr-jobhistory-daemon.shstarthistoryserver 通过命令jps可以查看各个节点所启动的进程。正确的话, 在Master节点上可以看到NameNode、ResourceManager、SecondrryNameNode、JobHistoryServer进程, 另外还需要在Master节点上通过命令hdfsdfsadmin-report查看DataNode是否正常启动,如果Livedatanodes不为0,则说明集群启动成功。 [hadoop@hddcluster2~]$hdfsdfsadmin-report ConfiguredCapacity:2125104381952(1.93TB) PresentCapacity:1975826509824(1.80TB) DFSRemaining:1975824982016(1.80TB) DFSUsed:1527808(1.46MB) DFSUsed%:0.00% Underreplicatedblocks:0 Blockswithcorruptreplicas:0 Missingblocks:0 Missingblocks(withreplicationfactor1):0 ------------------------------------------------- Livedatanodes(4): 也可以通过Web页面看到查看DataNode和NameNode的状态:http: //hddcluster2 :50070/。如果不成功,可以通过启动日志排查原因。 1 在Slave节点操作可以看到DataNode和NodeManager进程 1 2 3 4 5 6 7 8 9 10 测试hadoop分布式实例 首先创建HDFS上的用户目录: hdfsdfs- mkdir -p /user/hadoop 将 /usr/local/hadoop/etc/hadoop 中的配置文件作为输入文件复制到分布式文件系统中: hdfsdfs- mkdir input hdfsdfs-put /usr/local/hadoop/etc/hadoop/ *.xmlinput 通过查看的DataNode的状态(占用大小有改变),输入文件确实复制到了DataNode中。 接着就可以运行MapReduce作业了: hadoopjar /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples- *.jar grep inputoutput 'dfs[a-z.]+' 等待执行完毕后的输出结果: 1 2 3 4 5 6 7 8 hadoop启动命令: start-dfs.sh start-yarn.sh mr-jobhistory-daemon.shstarthistoryserver hadoop关闭命令: stop-dfs.sh stop-yarn.sh mr-jobhistory-daemon.shstophistoryserver PS:如果集群有一两台无法启动的话,先尝试一下删除hadoop临时文件 cd /usr/local sudo rm -r ./hadoop/tmp sudo rm -r ./hadoop/logs/* 然后执行 hdfs namenode -format 再启动 本文参考了一下网站并实验成功: http://www.powerxing.com/install-hadoop-cluster/ 本文转自 yanconggod 51CTO博客,原文链接: http://blog.51cto.com/yanconggod/1884998

优秀的个人博客,低调大师

hadoop&amp;spark安装(下)

上一遍文章中其实最主要的就是JAVA环境变量以及hadoop环境变量的设置,这两个设置好了的话,运行hadoop基本上不会出问题。 在hadoop的基础上安装spark好简单。 安装Spark之前需要先安装Hadoop集群,因为之前已经安装了hadoop,所以我直接在之前的hadoop集群上安装spark。 硬件环境: hddcluster1 10.0.0.197 redhat7 hddcluster2 10.0.0.228 centos7 这台作为master hddcluster3 10.0.0.202 redhat7 hddcluster4 10.0.0.181 centos7 软件环境: scala-2.11.7 spark-2.0.2-bin-hadoop2.7.tgz #所有操作用hadoop 基本流程: 1、master解压scala-2.11.7和spark-2.0.2-bin-hadoop2.7.tgz到相应的目录 2、配置scala和spark环境变量 3、修改配置文件 4、拷贝scala和spark到各个节点,授权 5、启动spark集群 1 2 3 4 5 6 7 8 9 10 11 #hadoop用户下操作,下载scala,安装 wgethttp: //downloads .lightbend.com /scala/2 .11.7 /scala-2 .11.7.tgz tar -zxvfscala-2.11.7.tgz mv scala-2.11.7 /usr/local/scala sudo mv scala-2.11.7 /usr/local/scala vim.bashrc #添加 export SCALA_HOME= /usr/local/scala export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin source .bashrc [hadoop@hddcluster2~]$scala-version Scalacoderunnerversion2.11.7--Copyright2002-2013,LAMP /EPFL 1 2 3 4 5 6 7 #在官网下载spark-2.0.2-bin-hadoop2.7.tgz tar -zxvfspark-2.0.2-bin-hadoop2.7.tgz mv spark-2.0.2-bin-hadoop2.7spark sudo mv spark /usr/local/ vim.bashrc #添加 export SPARK_HOME= /usr/local/spark export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin :$SPARK_HOME 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 #修改spark配置文件 cd /usr/local/spark/conf cp spark- env .sh.templatespark- env .sh vi spark- env .sh #添加下面内容 ###jdkdir export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 ###scaladir export SCALA_HOME= /usr/local/scala ###theipofmasternodeofspark export SPARK_MASTER_IP=10.0.0.228 ###themaxmemorysizeofworker export SPARK_WORKER_MEMORY=8G ###hadoopconfigurationfiledir export HADOOP_CONF_DIR= /usr/local/hadoop/etc/hadoop/ #修改slave cp slaves.templateslaves vi slaves #把localhost改为下面内容 hddcluster1 hddcluster2 hddcluster3 hddcluster4 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 #把/usr/local/spark和/usr/local/scala打包,然后复制到slave节点、 cd /usr/local tar -zcf~ /master .spark. tar .gz. /spark tar -zcf~ /master .scala. tar .gz. /scala scp master.spark. tar .gzhddcluster1:~ scp master.scala. tar .gzhddcluster1:~ #登录各个节点进行解压到/usr/local tar -zxfmaster.spark. tar .gz-C /usr/local/ tar -zxfmaster.scala. tar .gz-C /usr/local/ chown -Rhadoop:hadoop /usr/local/spark chown -Rhadoop:hadoop /usr/local/scala 再配置.bashrc环境变量和master的一样。 加上hadoop上一篇的.bashrc内容是这样子: #scala export SCALA_HOME= /usr/local/scala #spark export SPARK_HOME= /usr/local/spark #javaandhadoop export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 export HADOOP_HOME= /usr/local/hadoop export HADOOP_INSTALL=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export YARN_HOME=$HADOOP_HOME export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME /lib/native export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin :$SPARK_HOME export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_OPTS= "-Djava.library.path=$HADOOP_PREFIX/lib:$HADOOP_PREFIX/lib/native" 到此Spark集群搭建完毕 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 .启动Spark集群: 启动Spark之前需要先将hadoop的dfs以及yarn启动。 /usr/local/spark/sbin/start-all .sh 启动所有服务之后,在命令行输入jps: [hadoop@hddcluster2~]$jps 29601ResourceManager 32098SparkSubmit 29188DataNode 29364SecondaryNameNode 29062NameNode 29915NodeManager 30251Master 30380Worker 30062JobHistoryServer 18767Jps 比hadoop集群启动时多了Master和worker /usr/local/spark/bin/spark-shell .sh 出现scala>时说明成功。 在浏览器中输入10.0.0.228:8080时,会看到如下图,有4个Worker 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1885082

优秀的个人博客,低调大师

华为手机升级HarmonyOS完全攻略:消费者公测&amp;内测&amp;线下升级

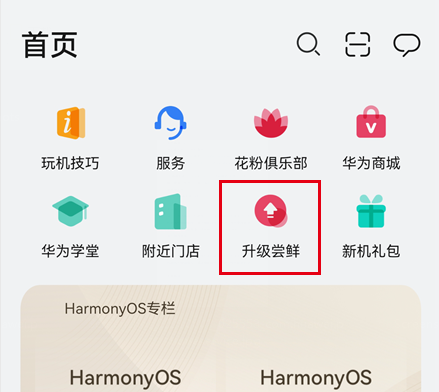
写在前面:本文旨在帮助社区各位小伙伴选择合适的渠道尽早升级HarmonyOS系统,深夜撸稿,还望三连支持一哈!! 目前正在进行的升级活动:消费者公测、消费者内测、HarmonyOS体验官(线下) 必要说明: 所有消费者公测渠道最终都会跳转到花粉俱乐部; 初期申请量巨大,花粉俱乐部很容易就挂掉,心急的小伙伴可尝试线下渠道或者多次尝试或者深夜(两点以后)申请; 申请前务必将“花粉俱乐部”、“我的华为”、“会员中心”升级到最新版本,尤其是“花粉俱乐部”。 ——消费者公测—— 包含机型: Mate X2 Mate40、Mate40E、Mate 40 Pro、Mate 40 Pro+、Mate 40 RS 保时捷设计 P40 5G、P40 4G、P40 Pro、P40 Pro+ Mate 30 4G、Mate 30 Pro 4G、Mate 30 5G、Mate 30 Pro 5G、Mate 30 RS保时捷设计、Mate 30E Pro 5G MatePad Pro、MatePad Pro 5G 我的华为/花粉俱乐部:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.打开“我的华为”,点击“升级尝鲜” / 打开“花粉俱乐部”,点击“公测尝鲜”。 △我的华为 △花粉俱乐部 2.页面加载完成后,点击“公测尝鲜”下的“立即尝鲜”按钮。(花粉俱乐部进入的请忽略此步骤,直接进入下步) 3.接下来在列表中找到当前手机型号对应的公测活动,点击“报名公测”。由于不同手机对应的系统版本不一样,请务必仔细核实你的机器型号。 4.此处会跳转到“花粉论坛”的一篇帖子,划到这篇帖子的末尾,点击“参加公测活动”。接下来系统会引导用户签订《华为公测协议》和《华为公测与隐私声明》,等待10秒点击通过。 5.通过两个协议后,系统会引导你下载协议文件。这个过程会验证你的机型是否符合要求,且下载的文件也是将来升级为正式版的必要文件,如果找到(反正我是没找到)请勿删除!! 6.下载并提示安装完描述文件后,就可以去检测系统更新,下载并更新HarmonyOS了。(P40系列当前版本116) ——消费者内测—— 包含机型: Mate XS、Mate 20、Mate 20 Pro、Mate 20 RS(保时捷)、Mate 20 X(4G) nova 8、nova 8 Pro、nova 8 SE、nova 7 5G、nova 7 Pro 5G、nova 7 SE 5G、nova 7 SE 5G活力版、nova 7 SE 5G乐活版、nova 6、nova 6 5G、nova 6 SE 华为畅享20 Plus 5G、华为畅享Z 5G、华为畅享20 Pro5G 华为麦芒9 5G MatePad 10.8、MatePad 5G 10.4、MatePad 10.4 内测时间:6月2日~6月9日上午10:00 渠道一 会员中心:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.打开会员中心,首页上找到“体验先锋”,点击进入。 2.点击顶部的HarmonyOS 2升级尝鲜。 3.进入页面点击报名。如果机型不符合,会弹出提示框。 4.接下来根据流程提示,填写信息,等待审核,坐等更新就好了。 渠道二 花粉俱乐部:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.进入首页点击内测报名 2.跳转后,点击立即报名 3.接下来根据流程提示,填写信息,等待审核,坐等更新就好了。 ——HarmonyOS体验官(线下)—— 包含机型: 我的华为:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 在APP首页点击“HarmonyOS体验官”海报,经过简单的互动问答即可参加。期间需要提交信息、预约门店时间和信息,最终会生成一张包含数字的海报,用户需要保存此海报才可参与活动。 活动仅在部分门店进行,具体店面和城市请在活动页面查询。到店会提供礼品,并可在线下由店面工作人员协助完成升级。 ——重要的补充说明—— 1.消费者公测仅审核设备型号是否合规,避免出现系统和硬件不适配的情况。 2.消费者内测仍然会存在审核机制,但仅审核设备型号是否合规,避免出现系统和硬件不适配的情况。 3.最终稳定的系统版本号预计为:HarmonyOS 2.0.0.116(以实际推送版本号为准!) 4.老荣耀系列机型不在本次消费者公测列表中。 想了解更多关于鸿蒙的内容,请访问: 51CTO和华为官方战略合作共建的鸿蒙技术社区 https://harmonyos.51cto.com/#bkwz

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册