首页 文章 精选 留言 我的

精选列表

搜索[过拟合],共10002篇文章
优秀的个人博客,低调大师

2021年三大运营商的云业务,会不会“干”过阿里、腾讯?

以前,在2G/3G/4G的演进中,尽管三大运营商在慢慢沦为管道,但起码活得还算过得去。 而随着移动互联网的深入发展,以及人口红利的消散殆尽,还有提速降费等大环境的变化,三大运营商的传统业务也越来越面临各种严峻的挑战。 特别是随着4G网络的成熟,越来越多的互联网企业和内容提供商参与互联网产业的价值链中。而三大运营商沦为只是给应用和内容提供流量管道的角色则越来越明朗化。 到了如今,运营商被管道化的现象愈发严重。三大运营商几乎要成为给互联网企业及内容提供商打工的“管道工”了。 于是,为了避免成为单纯的数据管道也为了今后自身的发展,转型就成为了三大运营商的必由之路。 在进入5G时代,伴随着大数据、云计算以及物联网的发展,云业务以及云网融合就成为三大运营商们不约而同的突破口及转型升级的关键路径。 在刚过去的2020年里,云网融合、云网一体、云网协同成为了运营商里的超级热词,也成为了运营商里高管们格外看中的“大战略”。 尽管,三大运营商各自推出了自家的云计算产品。移动有移动云,电信有天翼云,联通也有自己的沃云。但在具体实现方式和战略上,这三个老对手老冤家也还是各有不同。 其中,移动的5G+云,以N+31+X为布局推出“一朵云、一张网、一体化服务”的云网一体化策略,推动云+网IT系统深度融合。 电信的天翼云则发布智能边缘云平台、AI开放平台、企业应用开发平台(EADP)三大赋能平台。通过“+边缘”、“+AI”、“+平台”等方式打造云网融合体系。 联通则通过合建和自建云池、分层建设的方式,推动联通的云网融合转型来加速扩充自己在云市场里的规模。 此外,除了三大运营商,云服务的江湖里还有互联网企业、硬件提供商、IT系统集成商这些大咖级玩家在参与。 那么,进入2021,三大运营商能在云计算市场占的多大地位?又该用怎么策略和那些大咖们竞争呢? 其实,与互联网企业、硬件提供商、IT系统集成商们相比,运营商的优势资源非常明显。 特别是在网络出口带宽和数据中心资源这两个方面,可是说是互联网企业、硬件提供商、IT系统集成商们根本无法具备的。 但可惜的是,但在整个云服务生态中,最活跃的却是互联网企业和IT系统集成商。 例如阿里云、腾讯云及华为云等云服务商目前在国内云业务市场里占据着大部分的市场份额。而目前三大运营商们只在政务云上取得了较好的成果。 在小编看来,三大运营商想要再度拓展份额,在千亿云市场里分得一杯羹,光有产品还不够,也还必须得发挥自身独有的竞争优势才行。 虽然,三大运营商的云服务方式有体制、机制不够灵活的制约。但如果发挥好自身独有的竞争优势,在政务云之外取得更多的市场份额也并非没有大机会。 比如,三大运营商有覆盖全国的网络、IDC资源以及渠道、服务优势。而在二三线的下沉市场里,阿里云、腾讯云及华为云等云服务商目前还难以触及。 那么,如果能抢先在下沉市场为中小企业提供云服务。这何尝不是个机会呢?要知道,国内企业90%以上可是中小企业构成的。 此外,相对于一线发达地区,在二三线的下沉市场里的中小企业还是更希望有事即可“召之即来挥之即去”的服务体验。而其他云服务商如想在全国各地布点安排长期驻地服务人员则还需要面临人力资源成本、渠道建设等成本和时间的考量。 可这对与运营商来说,就更本不是个事。毕竟,那么多地市县区分公司可都是现成的。 虽然,下沉市场的中小企业有客单价低的缺点,但如果份额大,也是一笔不小的收入。 当下,面向社会经济生活的“五纵三横”的数字化转型需求,运营商们更应该抓住机遇,在从商业模式探索到快速爆发转变的关键时期,把自己的优势转化为实打实的服务能力,才能在转型升级的道路上快速打开局面。 目前,三大运营商的产品、体系都已经初具规模,后续如果找准了合适的推进拓展方向,云业务在2021年里取得更大的成果也应该不是难事。 那么,你认为三大运营商的云业务“干”得过阿里云、腾讯云及华为云吗?欢迎留言探讨。

优秀的个人博客,低调大师

大数据集群迁移的那一夜是怎么过的|回忆录

背景 大数据集群迁移这件事,不知道有多少同学做过(反正我是第一次)。我说的不是简单的把一个集群的数据拷贝到另一个集群上,我指的是整个数据处理平台与相关的前台业务的迁移工作,是从一个机房到另一个机房。 刚开始接到迁移通知,想着没什么问题,一个月应该可以搞定(毕竟无知者无畏)。可是当着手写迁移方案时,自己却不知道从何处下手。当第一次操作迁移讨论时,面对大家提出的问题,我才明白这是一个艰巨的任务啊,很有可能是一项吃力不讨好的工作。但是现有小机房,已经没有增加机柜的位置了。面对业务不断的增长,以及来自各个业务方的数据处理需求以及每天收到的几百条CPU告警和几十条存储告警,我们已经别无选择,就是一个字,干! 此次迁移是异地迁移。并且此次迁移带宽有限制。按照刚开始提供的带宽计算,迁移全部数据需要近半年。比较麻烦的事,迁移过程中还存在历史数据刷新问题,也就是说有部分数据,你迁了也是白迁。 方案 要说迁移这件事多么有趣,还得从那个寒冬晚上说起,只记得那天晚上的风特别的冷!一群小伙伴接到迁移平台的通知后,就开始了准备工作。大家每天晚上都是一通讨论,当时我们还提出了,直接下架服务器,搬迁到新机房,上架、上电、启动、恢复业务。现在想想也是不能这样做了,毕竟服务器这东西还是很脆弱的。(万一起不来,根本没法回退啊)。 还是老老实实的迁移数据吧。 整理思路就是,新集群部署完成后,先迁移历史近三个月数据进行各系统测试。测试后无问题,开始同步所有历史数据,待上线前,同步当前时段未迁移的数据。有没有很简单,是的,看着很简单。但是,我司大数据平台还和外部业务系统存在着千丝万缕的关系,还有些业务停服的时间窗口在一小时内,这好难了。毕竟不是一人吃饱,全家不饿啊。 先来看一下我司大数据平台现状吧,一张图,如下: 此次迁移涉及前端和后端,前端门户、报表、指标等需要在新环境重新部署,并且迁移历史数据,其中消息队列,关系型数据库等数据也需要迁移。后端主要是Hadoop、MPP和ETL工具。此次迁移并不是现有机器完全的迁移,实时处理业务暂不在本次迁移中。所以迁移内容和未迁移之前是否存在耦合,也是迁移工作需要解决的一部分。 在预期的时间内,风险可控的完成大数据平台迁移工作,单依赖网络这点带宽同步数据是不行的,所有我们制定了大致迁移流程如下: 先梳理任务运行中所需要的表的最小周期数据。 根据梳理出来的任务正常运行所需要的最小周期数据的表,同步对应表的周期数据到新集群。 然后每天对比差异数据,增量同步差异数据。 使用同步的历史数据,对新集群进行功能以及性能测试 开始对新老平台进行任务并行运行 核对任务并行期间数据质量 根据核对质量,选择时间窗口进行平台切换 问题 在实际迁移过程中,哪部分最难?不是新集群搭建,不是数据同步,是如何保障迁移新集群后数据的准确性。可能你会说,这不是也很简单,你不是两个集群并行运行了,头一天运行,第二天对比结果不就行了。然后现实总是残酷的,你会发现运行后,新老平台跑出来的数据差异太大。为什么呢?数据跑出来结果一样的前提是数据源必须一致,运行程序也一致。然而两者我们都很难保持一致。 首先是数据源,现有生产系统存在一个问题,就是数据每时每刻基本都在刷新,历史数据的也在刷新,我们很难实时监控数据是什么时候刷新的,刷新了哪些历史数据(依靠人工,难免会有疏漏,也需要大量的人力保障)。有些数据源结构甚至都会发生变化。运行的程序同样也可能随时发生变化。解决以上问题,我们就必须要对目前生产进行一些限制。数据源,我们每天会定时检查,同步历史差异。数据源表结构发生变化,我们通过解析变更的DDL语句在新环境进行同步。运行程序通过定时从老环境中拉取到新环境。 对于抽取生产库的数据源,由于不同时刻抽取的数据可能不一致,就会导致最终并行跑出来的结果对比不一致,针对该部分数据源,直接采用同步数据方式来保障数据源一致。针对很对文件接口的任务,由于文件接口涉及文件采集后删除源文件等操作,有人说修改为不删除,新老并行跑进行验证就好了。但是我们的文件接口太多了,修改的工作量较大,而且考虑到人工修改可能会影响到现在生产环境,就放弃了(此处提醒下各位在系统设计之初一定要考虑好方案,否则以后迁移一次,哭一次),该部分数据源也是直接同步了。但是该部分接口涉及到的脚本和网络策略,我们都要人工梳理出来,一个一个检查验证,虽然没有并行每天跑,但是还是经过验证的,心里也有底了。 本次迁移的总体目标 迁移期间,大数据平台的服务不能长时间下线(最多小时级别),不能对公司小时业务造成影响。 必须确保迁移完成后,影响生产业务的正确性和核心业务指标的正确性。 对于和外部系统重度耦合的业务,需要给业务方足够的时间,尽量减少业务方改造工作量,必须有模拟割接验证后才能上线。 本次迁移的原则 一切迁移工作和步骤,要以不影响线上业务为标准。 凡是可能出错,不能一步做到位的环节,都必须要有事前验证测试的手段。 能并行运行的业务尽量并行运行,核对数据无误后,才具备割接条件。 迁移工作中,能自动化的自动化,不能自动化的,要给出梳理验证标准,不能靠人工去猜。 要有回退方案,以防万一。 保障了这么多,大家似乎看出来了最难的部分,就是数据准确性保障!其实迁移所做的一切都是为了让迁移后,各个业务依然能够回去准确的指标数据,而不是仅仅使用新环境。但是,还有一样,我们最容易忽略的,就是操作步骤,我指的事真实割接时候的操作步骤,命令级别的。我们想要的效果就是割接当晚,任何一个人拿着操作步骤都能执行迁移过程。 现在想想这个太难了,虽然现在割接成功了,但是仍然不敢说已经达到这一标准。割接涉及主机、数据库、后端、前端等操作人员,割接当晚出现有模块没有严格按照操作步骤执行,有团队出现多业务操作步骤交叉而没有提前沟通。所以,割接时一定要安排有经验的,对系统整体较熟悉的同事在现场支撑,以防万一啊。 历史好文推荐 从0到1搭建大数据平台之计算存储系统 从0到1搭建大数据平台之调度系统 从0到1搭建大数据平台之数据采集系统 如何从0到1搭建大数据平台 你点的每个 在看 ,我都认真当成了喜欢 本文分享自微信公众号 - 数据社(DataClub)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

写Java这么久,JDK源码编译过没?编译JDK源码踩坑纪实

好奇害死羊 很多小伙伴们做Java开发,天天写Java代码,肯定离不开Java基础环境:JDK,毕竟我们写好的Java代码也是跑在JVM虚拟机上。 一般来说,我们学Java之前,第一步就是安装JDK环境。这个简单啊,我们一般直接把JDK从官网下载下来,安装完成,配个环境变量就可以愉快地使用了。 不过话说回来,对于这个天天使用的东西,我们难道不好奇这玩意儿它到底是怎么由源码编译出来的吗? 带着这个原始的疑问,今天准备大干一场,自己动动呆萌的小手,来编译一个属于自己的JDK吧! 对了,本文在开源项目:https://github.com/hansonwang99/JavaCollection中已收录,包含自学编程路线、面试题集合/面经、及系列技术文章等,资源持续更新中... 还有个待填的坑 记得之前不是出过一期关于《JDK源码阅读环境搭建》相关的视频以及文章嘛,细心的小伙伴,可能会发现一个很实际的问题: 我们将src.zip包里的JDK源码解压出来,关联到这份源码之后,调试时是可以进,但是我们在加注释的时候却只能在行尾添加,并不能改变原代码的行结构。换句话说,如果在源码中加了跨行的多行注释,则debug调试的时候就会出现当前行的运行错位问题,这个有点尴尬了。 当然那个视频的评论区,的确也有几个小伙伴提了这个问题: 原因也很简单,因为实际支撑调试运行的代码,并不是我们解压出来的那份JDK源码,那个仅仅是做关联用,实际运行用到的JDK,还是之前系统安装好的那个JDK环境。 要想解决这个问题,那就只能使用自己修改过的代码来自行编译生成自己的JDK,然后用到项目中去! 所以什么都憋说了,肝就完了! 环境准备 首选说在前面的是,编译前的软件版本关系极其重要,自己在踩坑时,所出现的各种奇奇怪怪的问题几乎都和这个有关,后来版本匹配之后,就非常顺利了。 我们来盘点和梳理一下编译一个JDK需要哪些环境和工具: 1、boot JDK 我们要想编译JDK,首先自己本机必须提前已经安装有一个JDK,官方称之为bootstrap JDK(或者称为boot JDK)。 比如想编译JDK 8,那本机必须最起码得有一个JDK 7或者更新一点的版本;你想编译JDK 11,那就要求本机必须装有JDK 10或者11。 所以鸡生蛋、蛋生鸡又来了... 2、Unix环境 编译JDK需要Unix环境的支持! 这一点在Linux操作系统和macOS操作系统上已经天然的保证了,而对于Windows兄弟来说稍微麻烦一点,需要通过使用Cygwin或者MinGW/MSYS这种软件来模拟。 就像官方所说:在Linux平台编译JDK一般问题最少,容易成功;macOS次之;Windows上则需要稍微多花点精力,问题可能也多一些。 究其本质原因,还是因为Windows毕竟不是一个Unix-Like内核的系统,毕竟很多软件的原始编译都离不开Unix Toolkit,所以相对肯定要麻烦一些。 3、编译器/编译工具链 JDK底层源码(尤其JVM虚拟机部分)很多都是C++/C写的,所以相关编译器也跑不掉。 一图胜千言,各平台上的编译器支持如下表所示,按平台选择即可: 4、其他工具 典型的比如: Autoconf:软件源码包的自动配置工具 Make:编译构建工具 freetype:一个免费的渲染库,JDK图形化部分的代码可能会用它 好,环境盘点就到这里,接下来具体列一下我在编译JDK 8和JDK 11时分别用到的软件详细版本信息: 编译JDK 8时: 操作系统:macOS 10.11.6 boot JDK:JDK 1.8.0 (build 1.8.0_201-b09) Xcode版本:8.2 编译器:Version 8.0.0 (at /usr/bin/clang) 编译JDK 11时: 操作系统:macOS 10.15.4 boot JDK:JDK 11.0.7 (build 11.0.7+8-LTS) Xcode版本:11.5 编译器:Version 11.0.3 (at /usr/bin/clang) 大家在编译时如果过程中有很多问题,大概率少软件没装,或者软件版本不匹配,不要轻易放弃,需要耐心自查一下。 下载JDK源码 下载JDK源码其实有两种方式。 方式一:通过Mercurial工具下载 Mercurial可以理解为和Git一样,是另外一种代码管理工具,安装好之后就有一个hg命令可用。 而OpenJDK的源码已经提前托管到http://hg.openjdk.java.net/。 因此,比如下载JDK 8,可直接hg clone一下就行,和git clone一样: hgclonehttp://hg.openjdk.java.net/jdk8/jdk8 同理,下载JDK 11: hgclonehttp://hg.openjdk.java.net/jdk/jdk11 但是这种方式下载速度不是很快。 方式二:直接下载打包好的源码包 下载地址:https://jdk.java.net/ 选择你想要的版本下载即可。 编译前的自动配置 源码包下载好,放到本地某个目录(建议路径纯英文,避免不必要的麻烦),解压之,然后进入源码根目录,执行: shconfigure 当然这里运行的是默认配置项。 这一步会进行一系列的自动配置工作,时间一般很快,最终如果能出现一下提示,那么很幸运,编译前的配置工作就完成了! 这里我给出我自己分别在配置JDK 11和JDK 8时候完成时的样子: 配置JDK 8完成: 配置JDK 11完成: 注:如果这一步出错,大概率是某个软件环境未装,或者即使装了,但版本不匹配,控制台打印日志里一般是会提醒的。 比如我在配置JDK 8的时候,就遇到了一个errof:GCC compiler is required的问题: 明明系统里已经有编译器,但还是报这个错误。通过后来修改jdk源码根目录/common/autoconf/generated-configure.sh文件,将相关的两行代码注释后就配置通过了 配置完成,接下来开始执行真正的编译动作了! 真正的编译动作 我们这里进行的是全量编译,直接在我们下载的JDK源码根目录下执行如下命令即可: makeall 这一步编译需要一点时间,耐心等待一下即可。编译过程如果有错误,会终止编译,如果能看到如下两个画面,那么则恭喜你,自己编译JDK源码就已经通过了,可以搞一杯咖啡庆祝一下了。 JDK 8编译完成: JDK 11编译完成: 从两张图的对比可以看出,编译JDK 8和JDK 11完成时在输出上还是有区别的。时间上的区别很大程度上来源于JDK 11的编译机配置要高不少。 验证成果 JDK源码编译完成之后肯定会产生和输出很多产物,这也是我们所迫不及待想看到的。 由于JDK 8和JDK 11的源码包组织结构并不一样,所以输出东西的内容和位置也有区别。我们一一来盘点一下。 1、JDK 8的编译输出 编译完成,build目录下会生成一个macosx-x86_64-normal-server-release目录,所有的编译成果均位于其中。 首先,编译出来的Java可执行程序可以在如下目录里找到: jdk源码根目录/build/macosx-x86_64-normal-server-release/jdk/bin 进入该目录后,可以输入./java -version命令验证: 其次,编译生成的成品JDK套装,可以在目录 jdk源码根目录/build/macosx-x86_64-normal-server-release/images 下找到,如图所示: 其中: j2sdk-image:编译生成的JDK j2re-image:编译生成的JRE 进入j2sdk-image目录会发现,里面的内容和我们平时从网络上下载的成品JDK内容一致。 2、JDK 11的编译输出 JDK 11的源码目录组织方式和JDK 8本身就有区别,编译生成的产物和上面编译JDK 8的输出有一定区别,但也不大。 JDK 11编译完成,同样在build目录下会生成一个macosx-x86_64-normal-server-release目录,所有的编译成果均位于其中。 同样编译出来的Java可执行程序可以在目录 JDK源码根目录/build/macosx-x86_64-normal-server-release/jdk/bin 下看到,进入该目录后,也可以输入./java -version命令验证: 其次,编译生成的成品JDK 11套装,可以在目录 JDK源码根目录/build/macosx-x86_64-normal-server-release/images 下找到,如图所示: 其中jdk目录就是编译生成的成品JDK 11套装。 使用自己编译的JDK 既然我们已经动手编译出了JDK成品,接下来我们得用上哇。 新建一个最最基本的Java工程,比如命名为JdkTest,目的是把我们自己编译出的JDK给用上。 我们点开Project Structure,选到SDKs选项,新添加上自己刚刚编译生成的JDK,并选为项目的JDK,看看是否能正常工作 点击确定之后,我们运行之: 可以看到我们自己编译出的JDK已经用上了。 关联JDK源码并修改 我们继续在上一步JdkTest项目的Project Structure→SDKs里将JDK源码关联到自行下载的JDK源码路径上: 这样方便我们对自己下载的JDK源码进行阅读、调试、修改、以及在源码里随意做笔记和加注释。 举个最简单的例子,比如我们打开System.out.println()这个函数的底层源码: 我们随便给它修改一下,加两行简单的标记,像这样: 为了使我们新加的代码行生效,我们必须要重新去JDK源码的根目录中再次执行make images重新编译生成JDK方可生效: 因为之前已经全量编译过了,所以再次make的时候增量编译一般很快。 重新编译之后,我们再次运行JdkTest项目,就可以看到改动的效果了: 多行注释的问题 记得之前搭建《JDK源码阅读环境》时,大家可能发现了一个问题:阅读源码嘛,给源代码做点注释或笔记很常见!但那时候有个问题就是做注释时不可改变代码的行结构(只能行尾注释,不能跨行注释),否则debug调试时会出现行号错位的问题。 原因很简单,因为我们虽然做了源代码目录的映射,但是实际支撑运行的JDK还是预先安装好的那个JDK环境,并不是根据我们修改后的源码来重新编译构建的,所以看到这里,解决这个问题就很简单,就像上面一样自行编译一下JDK即可。 实际在实验时,还有一个很典型的问题是,当添加了多行的中文注释后,再编译居然会报错! 比如,还是以上面例子中最简单的System.out.println()源码为例,我们添加几行中文注释: 这时候我们去JDK源码目录下编译会发现满屏类似这样的报错: 错误: 编码 ascii 的不可映射字符 顿时有点懵,毕竟仅仅是加了几行注释。对于我们来说,源码里写点多行的中文注释基本是刚需,然而编译竟会报错,这还能不能让人愉快的玩耍了... 当时后背有点发凉。 实不相瞒,就这个问题排查了一段时间,熬到了很晚。最终折腾了一番,通过如下这种方式解决了,顺便分享给小伙伴们,大家如果遇到了这个问题,可以参考着解决一下。 因为从控制台的报错可以很明显的看出,肯定是字符编码相关的问题导致的,而且都指向了ascii这种编码方式。 于是将JDK的源码从根目录导入了Vs Code,然后全目录查找encoding ascii相关的内容,看看有没有什么端倪,结果发现 jdk源码根目录/make/common/SetupJavaCompilers.gmk文件中有两处指定了ascii相关的编码方式: 于是尝试将这两处-encoding ascii的均替换成-encoding utf-8: 然后再次执行make images编译,编译顺利通过! 至此大功告成! 这样后面不管是阅读、调试还是定制JDK源码都非常方便了。 后记:这篇文章在开源项目:https://github.com/hansonwang99/JavaCollection中也已经收录了,包含自学编程路线、面试题集合/面经、及系列技术文章等,资源持续更新中... 每天进步一点点 慢一点才能更快

优秀的个人博客,低调大师

为什么个人量化者总在做数据工程:我踩过的三个坑

我做量化以后最大的一个感受是:策略代码可能只有几百行,但真正让我花时间最多的,往往是数据清洗、接口维护、字段统一和异常排查。本文从我实际做策略研究时遇到的数据源失效、市场代码不统一和批量数据维护问题出发,拆解个人量化者为什么很容易把大量时间浪费在数据工程上,并分享我后来采用的统一数据访问方式。

优秀的个人博客,低调大师

被 AI 的"幻觉"坑过的量化人,都该立这 5 条铁律!!!

我是用 AI 辅助做量化策略的散户。一开始觉得:大模型这么强,让它帮我写回测、拉数据、算指标,效率起飞。结果效率是起飞了,翻车也起飞了。做量化最怕什么?不是回测亏钱——亏钱起码是真的。最怕的是:你以为自己找到了赚钱策略,其实是 AI 给你编了一套"看起来很美"的假数据,把你骗了。踩了无数坑之后,我最大的体会是:大模型是个能力极强但会撒谎的实习生。你让它跑 10 次,有 8 次聪明得不像话,有 2 次能把你坑得怀疑人生。而那 2 次,往往就是让你亏真金白银、浪费大量心血的元凶。

优秀的个人博客,低调大师

AI 大会论文被中国刷榜,华为人不感觉意外:通信领域已出现过

杜克大学教授陈怡然公布了一个有趣的数据,称AAAI公布的数据显示,今年收到29000篇文章中,有20000篇是从中国来的。 这意味着AAAI大会上将近69%的论文都是国内的高校、公司及各种研究机构发,可以说刷榜了。 中国科学院计算技术研究所研究员、机器翻译领域专家刘群表示,他跟一个老华为人聊,说这种事不奇怪,同样的事情在通信领域也发生过,结果就是最牛的通信技术公司都是中国公司。AI只不过在重复同样的故事。 AAAI大会全称是Association for theAdvance of Artificial Intelligence,意为人工智能促进协会,前身美国人工智能协会,成立于1979年,2009年改为现名,该协会是全球AI领域的主要协会之一,AAAI大会也是全球顶级AI会议之一,也是中国计算机学会(CCF)推荐的A类国际学术会议。

优秀的个人博客,低调大师

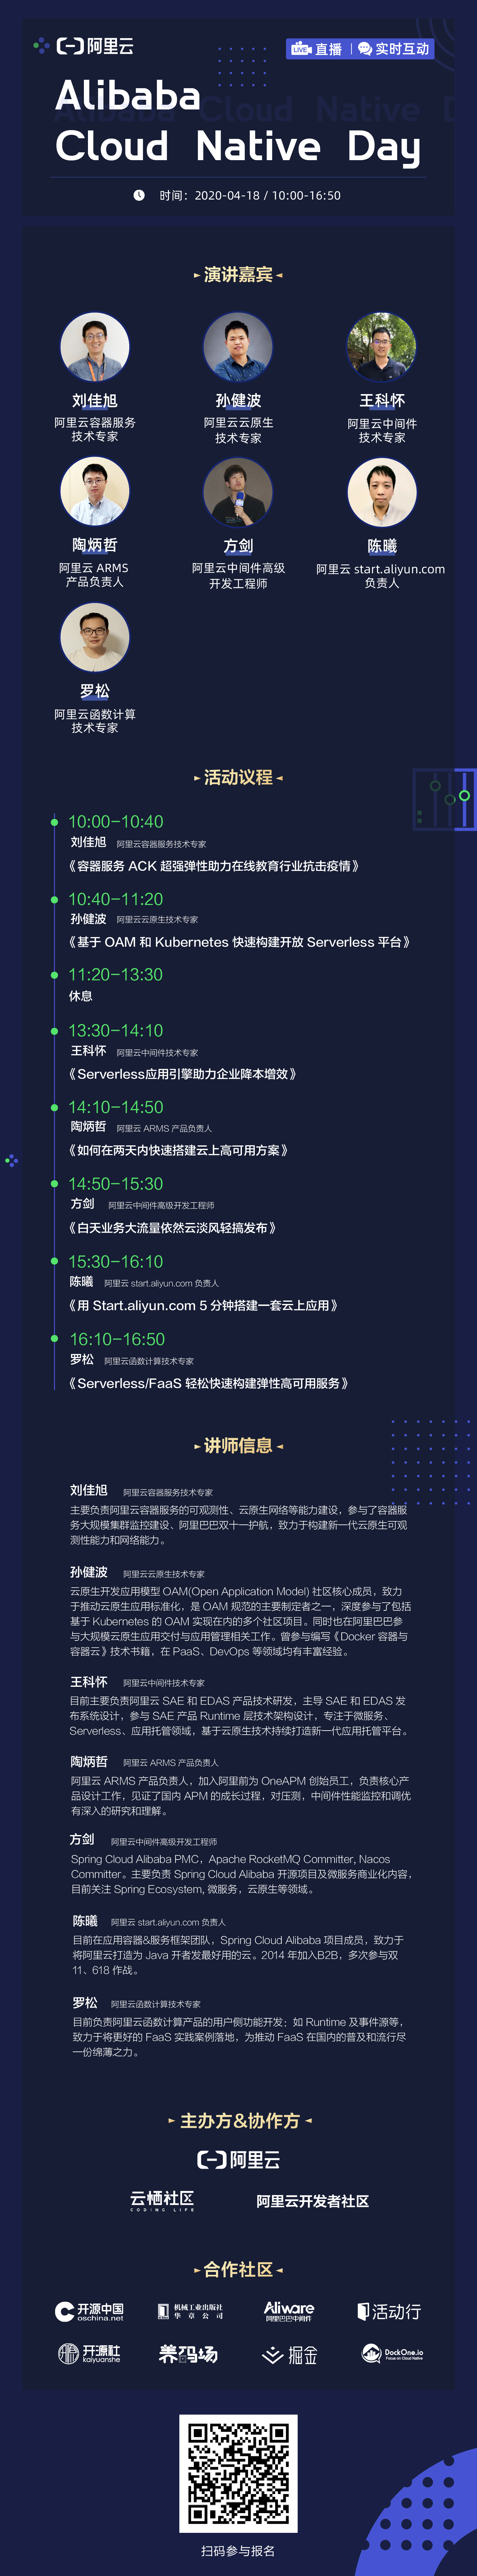
这个 14 万人参与过的云原生线下沙龙,即将在线开播

2019 年,我们在全国 5 个城市举办了 8 场 Kubernetes & Cloud Native Meetup, 我们邀请了来自阿里巴巴、蚂蚁金服、eBay中国、国泰君安等一线厂商的技术专家分享云原生技术心得和实战干货,有 145000 位云原生开发者参与到我们线下 Meetup 中,反响热烈。2020年,我们全新出发! 2020 年 4 月 18 日,我们首次将线下 Meetup 搬到线上,升级为 Alibaba Cloud Native Day 全天直播。本次 Alibaba Cloud Native Day 将齐聚 8 位阿里云技术专家,聚焦前沿云原生技术,分享最新 K8s、Serverless、微服务等技术落地案例,直击云原生开发者实践痛点,帮助开发者短时间内提升对云原生技术认知,加速成长。 活动亮点 8 位阿里云原生技术专家在线直播 系统输出“Spring 脚手架快速搭建云上应用方法 Serverless、微服务、K8s 企业实践案例精析 社区项目最新成果及趋势详解 如何观看 时间:4月18日 9:30 — 16:50 预约链接:https://yqh.aliyun.com/live/CloudNative 福利不断 直播过程中设置 2 轮抽奖,天猫精灵、淘公仔、充电宝大放送! 活动议程

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册