首页 文章 精选 留言 我的

精选列表

搜索[轻量级运维极速引擎],共10010篇文章
优秀的个人博客,低调大师

400+ 节点的 Elasticsearch 集群运维

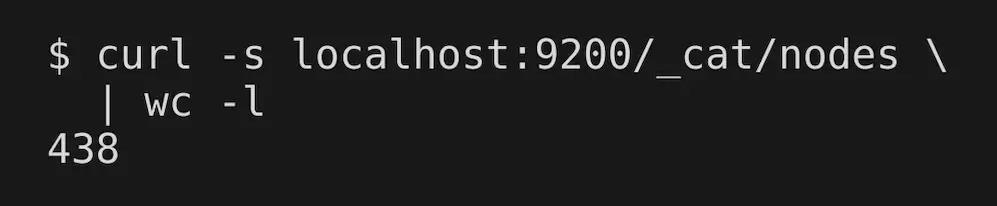
目录: 数据量 版本 节点配置 索引结构 性能 Meltwater每天要处理数百万量级的帖子数据,因此需要一种能处理该量级数据的存储和检索技术。 从0.11.X 版本开始我们就已经是Elasticsearch的忠实用户了。在经历了一些波折之后,最终我们认为做出了正确的技术选型。 Elasticsearch 用于支持我们的主要媒体监控应用,客户通过该应用可以检索和分析媒体数据,比如新闻文章、(公开的)Facebook帖子、Instagram帖子、博客和微博。我们通过使用一个混合API来收集这些内容,并爬取和稍作加工,使得它们可被 Elasticsearch 检索到。 本文将分享我们所学到的经验、如何调优 Elasticsearch,以及要绕过的一些陷阱。 如果想了解更多关于我们在Elasticsearch方面的点滴,可参考之前博文中的 numad issues 和 batch percolator。 1.数据量 每天都有数量相当庞大的新闻和微博产生;在高峰期需要索引大约300多万社论文章,和近1亿条社交帖子数据。其中社论数据长期保存以供检索(可回溯到2009年),社交帖子数据保存近15个月的。当前的主分片数据使用了大约200 TB的磁盘空间,副本数据大约600 TB。 我们的业务每分钟有3千次请求。所有的请求通过一个叫做 “search-service” 的服务,该服务会依次完成所有与 Elasticsearch 集群的交互。大部分检索规则比较复杂,包括在面板和新闻流中。比如,一个客户可能对 Tesla 和 Elon Musk 感兴趣,但希望排除所有关于 SpaceX 或 PayPal 的信息。用户可以使用一种与 Lucene 查询语法类似的灵活语法,如下: Tesla AND "Elon Musk" NOT (SpaceX OR PayPal) 我们最长的此类查询有60多页。重点是:除了每分钟3千次请求以外,没有一个查询是像在 Google 里查询 “Barack Obama” 这么简单的;这简直就是可怕的野兽,但ES节点必须努力找出一个匹配的文档集。 2.版本 我们运行的是一个基于 Elasticsearch 1.7.6 的定制版本。该版本与1.7.6 主干版本的唯一区别是,我们向后移植(backport)了 roaring bitsets/bitmaps 作为缓存。该功能是从 Lucene 5 移植到 Lucene 4 的,对应移植到了 ES 1.X 版本。Elasticsearch 1.X 中使用默认的 bitset 作为缓存,对于稀疏结果来说开销非常大,不过在 Elasticsearch 2.X 中已经做了优化。 为何不使用较新版本的 Elasticsearch 呢?主要原因是升级困难。在主版本间滚动升级只适用于从ES 5到6(从ES 2到5应该也支持滚动升级,但没有试过)。因此,我们只能通过重启整个集群来升级。宕机对我们来说几乎不可接受,但或许可以应对一次重启所带来的大约30-60分钟宕机时间;而真正令人担心的,是一旦发生故障并没有真正的回滚过程。 截止目前我们选择了不升级集群。当然我们希望可以升级,但目前有更为紧迫的任务。实际上该如何实施升级尚未有定论,很可能选择创建另一个新的集群,而不是升级现有的。 3.节点配置 我们自2017年6月开始在AWS上运行主集群,使用i3.2xlarge实例作为数据节点。之前我们在COLO(Co-located Data Center)里运行集群,但后续迁移到了AWS云,以便在新机器宕机时能赢得时间,使得我们在扩容和缩容时更加弹性。 我们在不同的可用区运行3个候选 master 节点,并设置 discovery.zen.minimum_master_nodes 为2。这是避免脑裂问题 split-brain problem 非常通用的策略。 我们的数据集在存储方面,要求80%容量和3个以上的副本,这使得我们运行了430个数据节点。起初打算使用不同层级的数据,在较慢的磁盘上存储较旧的数据,但是由于我们只有相关的较低量级旧于15个月的数据(只有编辑数据,因为我们丢弃了旧的社交数据),然而这并未奏效。每个月的硬件开销远大于运行在COLO中,但是云服务支持扩容集群到2倍,而几乎不用花费多少时间。 你可能会问,为何选择自己管理维护ES集群。其实我们考虑过托管方案,但最后还是选择自己安装,理由是: AWS Elasticsearch Service 暴露给用户的可控性太差了,Elastic Cloud 的成本比直接在EC2上运行集群要高2-3倍。 为了在某个可用区宕机时保护我们自身,节点分散于eu-west-1的所有3个可用区。我们使用 AWS plugin 来完成该项配置。它提供了一个叫做aws_availability_zone 的节点属性,我们把 cluster.routing.allocation.awareness.attributes 设置为 aws_availability_zone。这保证了ES的副本尽可能地存储在不同的可用区,而查询尽可能被路由到相同可用区的节点。 这些实例运行的是 Amazon Linux,临时挂载为 ext4,有约64GB的内存。我们分配了26GB用于ES节点的堆内存,剩下的用于磁盘缓存。为何是26GB?因为 JVM 是在一个黑魔法之上构建的 。 我们同时使用 Terraform 自动扩容组来提供实例,并使用 Puppet 完成一切安装配置。 4.索引结构 因为我们的数据和查询都是基于时间序列的,所以使用了 time-based indexing ,类似于ELK (elasticsearch, logstash, kibana) stack。同时也让不同类型的数据保存在不同的索引库中,以便诸如社论文档和社交文档类数据最终位于不同的每日索引库中。这样可以在需要的时候只丢弃社交索引,并增加一些查询优化。每个日索引运行在两个分片中的一个。 该项设置产生了大量的分片(接近40k)。有了这么多的分片和节点,集群操作有时变得更特殊。比如,删除索引似乎成为集群master的能力瓶颈,它需要把集群状态信息推送给所有节点。我们的集群状态数据约100 MB,但通过TCP压缩可减少到3 MB(可以通过 curl localhost:9200/_cluster/state/_all 查看你自己集群的状态数据)。Master 节点仍然需要在每次变更时推送1.3 GB数据(430 节点 x 3 MB 状态大小)。除了这1.3 GB数据外,还有约860 MB必须在可用区(比如 最基本的通过公共互联网)之间传输。这会比较耗时,尤其是在删除数百个索引时。我们希望新版本的 Elasticsearch 能优化这一点,首先从 ES 2.0支持仅发送集群状态的差分数据 这一特性开始。 5.性能 如前所述,我们的ES集群为了满足客户的检索需求,需要处理一些非常复杂的查询。 为应对查询负载,过去几年我们在性能方面做了大量的工作。我们必须尝试公平分享ES集群的性能测试,从下列引文就可以看出。 不幸的是,当集群宕机的时候,不到三分之一的查询能成功完成。我们相信测试本身导致了集群宕机。—— 摘录自使用真实查询在新ES集群平台上的第一次性能测试 为了控制查询执行过程,我们开发了一个插件,实现了一系列自定义查询类型。通过使用这些查询类型来提供Elasticsearch官方版本不支持的功能和性能优化。比如,我们实现了 phrases 中的 wildcard 查询,支持在 SpanNear 查询中执行;另一个优化是支持“*”代替 match-all-query ;还有其他一系列特性。 Elasticsearch 和 Lucene 的性能高度依赖于具体的查询和数据,没有银弹。即便如此,仍可给出一些从基础到进阶的参考: 限制你的检索范围,仅涉及相关数据。比如,对于每日索引库,只按相关日期范围检索。对于检索范围中间的索引,避免使用范围查询/过滤器。 使用wildcards时忽略前缀wildcards - 除非你能对term建立倒排索引。双端wildcards难以优化。 关注资源消耗的相关迹象 数据节点的CPU占用持续飙高吗?IQ等待走高吗?看看GC统计。这些可以从profilers工具或者通过 JMX 代理获得。如果 ParNewGC 消耗了超过15%的时间,去检查下内存日志。如果有任何的 SerialGC 停顿,你可能真的遇到问题了。不太了解这些内容? 没关系,这个系列博文很好地介绍了JVM性能 。记住,ES和G1垃圾回收器一起并非最佳 。 如果遇到垃圾回收问题,请不要尝试调整GC设置。这一点经常发生,因为默认设置已经很合理了。相反,应该聚焦在减少内存分配上。具体怎么做?参考下文。 如果遇到内存问题,但没有时间解决,可考虑查询Azul Zing。这是一个很贵的产品,但仅仅使用它们的JVM就可以提升2倍的吞吐量。不过最终我们并没有使用它,因为我们无法证明物有所值。 考虑使用缓存,包括 Elasticsearch 外缓存和 Lucene 级别的缓存。在 Elasticsearch 1.X 中可以通过使用 filter 来控制缓存。之后的版本中看起来更难一些,但貌似可以实现自己用于缓存的查询类型。我们在未来升级到2.X的时候可能会做类似的工作。 查看是否有热点数据(比如某个节点承担了所有的负载)。可以尝试均衡负载,使用分片分配过滤策略 shard allocation filtering ,或者尝试通过集群重新路由 cluster rerouting 来自行迁移分片。我们已经使用线性优化自动重新路由,但使用简单的自动化策略也大有帮助。 搭建测试环境(我更喜欢笔记本)可从线上环境加载一部分代表性的数据(建议至少有一个分片)。使用线上的查询回放加压(较难)。使用本地设置来测试请求的资源消耗。 综合以上各点,在 Elasticsearch 进程上启用一个 profiler。这是本列表中最重要的一条。 我们同时通过Java Mission Control 和 VisualVM 使用飞行记录器。在性能问题上尝试投机(包括付费顾问/技术支持)的人是在浪费他们(以及你自己)的时间。排查下 JVM 哪部分消耗了时间和内存,然后探索下 Elasticsearch/Lucene 源代码,检查是哪部分代码在执行或者分配内存。 一旦搞清楚是请求的哪一部分导致了响应变慢,你就可以通过尝试修改请求来优化(比如,修改term聚合的执行提示 ,或者切换查询类型)。修改查询类型或者查询顺序,可以有较大影响。如果不凑效,还可以尝试优化 ES/Lucene 代码。这看起来太夸张,却可以为我们降低3到4倍的CPU消耗和4到8倍的内存使用。某些修改很细微(比如 indices query ),但其他人可能要求我们完全重写查询执行。最终的代码严重依赖于我们的查询模式,所以可能适合也可能不适合他人使用。因此目前为止我们并没有开源这部分代码。不过这可能是下一篇博文的好素材。 图表说明:响应时间。有/没有 重写 Lucene 查询执行。同时也表明不再有节点每天多次发生内存不足。 顺便说明下,因为我知道会面临一个问题:从上一次性能测试我们知道通过升级到 ES 2.X 能小幅提升性能,但是并不能改变什么。话虽如此,但如果你已经从 ES 1.X 集群迁移到了 ES 2.X,我们很乐意听取关于你如何完成迁移的实践经验。 如果读到了这里,说明你对 Elasticsearch 是真爱啊(或者至少你是真的需要它)。我们很乐意学习你的经验,以及任何可以分享的内容。欢迎在评论区分享你的反馈和问题。 英文原文链接:http://underthehood.meltwater.com/blog/2018/02/06/running-a-400+-node-es-cluster/ 本文首发于InfoQ https://www.infoq.cn/article/1sm0Mq5LyY_021HGuXer作者:Anton Hägerstrand翻译:杨振涛

优秀的个人博客,低调大师

马哥运维学习作业(四)

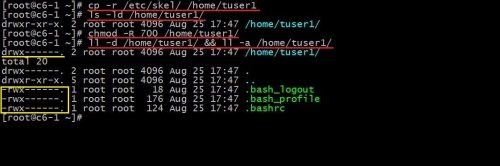
1、复制/etc/skel目录为/home/tuser1,要求/home/tuser1及其内部文件的属组和其它用户均没有任何访问权限。 1 2 3 4 5 6 7 8 9 10 11 12 [root@c6-1~] #cp-r/etc/skel//home/tuser1#使用cp-r递归复制文件夹内容到/home/tuser1下 [root@c6-1~] #ls-ld/home/tuser1/#查看/home下已有tuser1文件夹并看到默认权限为755 drwxr-xr-x.2rootroot4096Aug2517:47 /home/tuser1/ [root@c6-1~] #chmod-R700/home/tuser1/#使用chmod-R参数把/home/tuser1及其内部文件的权限都改为700。不使用-R递归参数,则只能改tuser1的权限 [root@c6-1~] #ll-d/home/tuser1/&&ll-a/home/tuser1/#同时验证tuser1和其内部文件权限都已改为属组和其它用户没有任何访问权限 drwx------.2rootroot4096Aug2517:47 /home/tuser1/ #文件夹权限 total20 drwx------.2rootroot4096Aug2517:47. drwxr-xr-x.5rootroot4096Aug2517:47.. -rwx------.1rootroot18Aug2517:47.bash_logout #下面是其内部文件的权限 -rwx------.1rootroot176Aug2517:47.bash_profile -rwx------.1rootroot124Aug2517:47.bashrc 图示: 2、编辑/etc/group文件,添加组hadoop。 方法一:手动vim编辑 1 2 3 4 5 [root@c6-1~] #vim/etc/group#使用vim编辑器打开/etc/group后,在末尾插入如下内容 ..........以上显示略 hadoop:x:2016: [root@c6-1~] #tail-1/etc/group#查看/etc/group最后一行已插入hadoop:x:2016: hadoop:x:2016: 注:使用vim编辑器打开/etc/group文件,按G(跳到行尾)-按yy(复制该行)-按p(粘帖该行到下一行)-按i(进入编辑状态),最后把第1,3列内容改为hadoop:x:2016: 注:也可直接打开vim编辑器到末尾输入hadoop:x:2016:保存退出,上面的操作是个人习惯,替换字符可减少错误的概率。 图示: 方法二:非交互式插入 1 2 3 [root@c6-2~] #echo"hadoop:x:2018">>/etc/group#非交互式插入内容 [root@c6-2~] #tail-1/etc/group#查看/etc/group最后一行已插入 hadoop:x:2018 图示: 3、手动编辑/etc/passwd文件新增一行,添加用户hadoop,其基本组ID为hadoop组的id号;其家目录为/home/hadoop。 1 2 3 4 5 [root@c6-1~] #vim/etc/passwd#按第2题的操作方法插入如下内容 ........以上显示略 hadoop:x:2016:2016:: /home/hadoop : /bin/bash [root@c6-1~] #idhadoop#idhadoop查看用户信息 uid=2016(hadoop)gid=2016(hadoop) groups =2016(hadoop) 图示: 4、复制/etc/skel目录为/home/hadoop,要求修改hadoop目录的属组和其它用户没有任何访问权限。 1 2 3 4 5 6 7 8 9 10 [root@c6-2~] #cp-r/etc/skel/home/hadoop#复制/etc/skel目录为/home/hadoop [root@c6-2~] #ll/home/#已复制完成,hadoop默认权限为755 total8 drwxr-xr-x.2rootroot4096Aug2421:06hadoop drwx------.4zdwzdw4096Jul2023:33zdw [root@c6-2~] #chmod700/home/hadoop/#按要求把hadoop目录改为属组和其它用户没有任何访问权限 [root@c6-2~] #ll/home/#再次查看,hadoop权限已设置好 total8 drwx------.2rootroot4096Aug2421:06hadoop drwx------.4zdwzdw4096Jul2023:33zdw 图示: 5、修改/home/hadoop目录及其内部所有文件的属主为hadoop,属组为hadoop。 1 2 3 4 5 [root@c6-2~] #chown-Rhadoop:hadoop/home/hadoop#使用chown-R命令把/home/hadoop目录及其内部所有文件属主、属组改为hadoop [root@c6-2~] #ll/home/#属主、属组已从原来的root,改为hadoop total8 drwx------.2hadoophadoop4096Aug2421:06hadoop drwx------.4zdwzdw4096Jul2023:33zdw 图示: 6、显示/proc/meminfo文件中以大写或小写S开头的行;用两种方式; 方法一: 1 2 3 4 5 6 7 8 [root@C7-1~] #grep^[sS]/proc/meminfo#^匹配以sS开头,[]设置范围 SwapCached:0kB SwapTotal:2097148kB SwapFree:2097148kB Shmem:8628kB Slab:55796kB SReclaimable:23544kB SUnreclaim:32252kB 方法二: 1 2 3 4 5 6 7 8 [root@C7-1~] #grep-i'^s'/proc/meminfo#使用-i参数忽略大小写 SwapCached:0kB SwapTotal:2097148kB SwapFree:2097148kB Shmem:8628kB Slab:55796kB SReclaimable:23544kB SUnreclaim:32252kB 图示: 7、显示/etc/passw d文件中其默认shell为非/sbin/nologin的用户; 1 [root@C7-1~] #grep-v"/sbin/nologin"/etc/passwd|cut-d:-f1 注:使用-v参数反向查找,cut -d: -f1指定分隔符为冒号,显示第一列用户名列 图示: 8、显示/etc/passw d文件中其默认shell为/bin/bash的用户; 方法一: 1 2 3 4 [root@C7-1~] #grep"/bin/bash$"/etc/passwd|cut-d:-f1 root zdw hadoop 注:$代表以/bin/bash结尾,适用于要搜索末尾的关键字后面有空格的,/bin/bash后面没有空格,直接使用下面的方法二即可。 方法二: 1 2 3 4 [root@C7-1~] #grep"/bin/bash"/etc/passwd|cut-d:-f1 root zdw hadoop 注:接上,cut -d: -f1指定分隔符为冒号,显示第一列用户名列,如果要看得更清楚,使用-f1,7把bash也显示出来 图示: 9、找出/etc/passwd文件中的一位数或两位数; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 [root@C7-1~] #grep"\<[0-9]\{1,2\}\>"/etc/passwd root:x:0:0:root: /root : /bin/bash bin:x:1:1:bin: /bin : /sbin/nologin daemon:x:2:2:daemon: /sbin : /sbin/nologin adm:x:3:4:adm: /var/adm : /sbin/nologin lp:x:4:7:lp: /var/spool/lpd : /sbin/nologin sync :x:5:0: sync : /sbin : /bin/sync shutdown :x:6:0: shutdown : /sbin : /sbin/shutdown halt:x:7:0:halt: /sbin : /sbin/halt mail:x:8:12:mail: /var/spool/mail : /sbin/nologin operator:x:11:0:operator: /root : /sbin/nologin games:x:12:100:games: /usr/games : /sbin/nologin ftp :x:14:50:FTPUser: /var/ftp : /sbin/nologin nobody:x:99:99:Nobody:/: /sbin/nologin dbus:x:81:81:Systemmessagebus:/: /sbin/nologin tss:x:59:59:Accountusedbythetrouserspackagetosandboxthetcsddaemon: /dev/null : /sbin/nologin postfix:x:89:89:: /var/spool/postfix : /sbin/nologin sshd:x:74:74:Privilege-separatedSSH: /var/empty/sshd : /sbin/nologin 注:\<[0-9]\{1,2\}\>指的是第一位是数字,\{1,2\}前面的数字出现至少1次,最多2次,\<,\>是词首和词尾锚定,限定了数字只能是1位数或二位数,就不会出现3位或4位的数字。如果不加上锚定,就会把3位、4位数字也显示出来。注:[0-9]和[[:digit:]]代表的意思一样。 图示: 10、显示/boot/grub/grub.conf中以至少一个空白字符开头的行; 方法一: 1 2 3 4 [root@c6-1~] #grep"^[[:space:]]\{1,\}"/boot/grub/grub.conf#\{1,\}是代表前面的字符至少出现一次 root(hd0,0) kernel /vmlinuz-2 .6.32-431.el6.x86_64roroot= /dev/mapper/VolGroup-lv_root rd_NO_LUKSLANG=en_US.UTF-8rd_NO_MDrd_LVM_LV=VolGroup /lv_swap SYSFONT=latarcyrheb-sun16crashkernel=autord_LVM_LV=VolGroup /lv_root KEYBOARDTYPE=pcKEYTABLE=usrd_NO_DMrhgbquiet initrd /initramfs-2 .6.32-431.el6.x86_64.img 方法二: 1 2 3 4 [root@c6-1~] #grep-E"^[[:space:]]+"/boot/grub/grub.conf#\+也是代表前面的字符至少出现一次,所以二个显示出的结果都一样 root(hd0,0) kernel /vmlinuz-2 .6.32-431.el6.x86_64roroot= /dev/mapper/VolGroup-lv_root rd_NO_LUKSLANG=en_US.UTF-8rd_NO_MDrd_LVM_LV=VolGroup /lv_swap SYSFONT=latarcyrheb-sun16crashkernel=autord_LVM_LV=VolGroup /lv_root KEYBOARDTYPE=pcKEYTABLE=usrd_NO_DMrhgbquiet initrd /initramfs-2 .6.32-431.el6.x86_64.img 图示: 11、显示/etc/rc.d/rc.sysinit文件中以#开头,后面跟至少一个空白字符,而后又有至少一个非空白字符的行; 方法一: 1 2 3 4 5 6 7 [root@ cat ~] #grep"^#[[:space:]]\+[^[:space:]]\+"/etc/rc.d/rc.sysinit #/etc/rc.d/rc.sysinit-runonceatboottime #TakeninpartfromMiquelvanSmoorenburg'sbcheckrc. #CheckSELinuxstatus #Printatextbanner. #Onlyreadthisonce. ....以下显示略 注:[[:space:]]+表示至少一个空白字符,[^[:space:]]+表示至少一个非空白字符 方法二: 1 2 3 4 5 6 7 8 [root@ cat ~] #grep-E^#[[:space:]]\{1\}[^[:space:]]\{1\}/etc/rc.d/rc.sysinit #/etc/rc.d/rc.sysinit-runonceatboottime #TakeninpartfromMiquelvanSmoorenburg'sbcheckrc. #CheckSELinuxstatus #Printatextbanner. #Onlyreadthisonce. #Initializehardware ....以下显示略 注:使用-E支持扩展的正则表达式,[[:space:]]\{1\}表示至少一个空白字符,[^[:space:]]\{1\}表示至少一个非空白字符 图示: 12、打出netstat -tan命令执行结果中以‘LISTEN’,后或跟空白字符结尾的行; 方法一: 1 2 3 4 5 [root@C7-1~] #netstat-tan|grep'LISTEN[[:space:]]*$'#*$以空白字符任意次为结尾 tcp000.0.0.0:220.0.0.0:*LISTEN tcp00127.0.0.1:250.0.0.0:*LISTEN tcp600:::22:::*LISTEN tcp600::1:25:::*LISTEN 方法二: 1 2 3 4 5 [root@C7-1~] #netstat-tan|grep"\<LISTEN\>[[:space:]]*$"#\<LISTEN\>表示词首词尾锚定 tcp000.0.0.0:220.0.0.0:*LISTEN tcp00127.0.0.1:250.0.0.0:*LISTEN tcp600:::22:::*LISTEN tcp600::1:25:::*LISTEN 方法三: 1 2 3 4 5 [root@C7-1~] #netstat-tan|grep'LISTEN[[:space:]]\+$'#\+$以空白字符至少1次为结尾 tcp000.0.0.0:220.0.0.0:*LISTEN tcp00127.0.0.1:250.0.0.0:*LISTEN tcp600:::22:::*LISTEN tcp600::1:25:::*LISTEN 图示: 13、添加用户bash, testbash, basher, nologin (此一个用户的shell为/sbin/nologin),而后找出当前系统上其用户名和默认shell相同的用户的信息; 1 2 3 4 5 6 7 8 9 10 [root@c6-1~] #useraddbash#新建用户bash [root@c6-1~] #useraddtestbash#新建用户testbash [root@c6-1~] #useraddbasher#新建用户basher [root@c6-1~] #useradd-s/sbin/nologinnologin#新建用户nologin使用-s指定其shell为/sbin/nologin [root@c6-1~] #grep"^\([[:alnum:]]\+\>\).*\1$"/etc/passwd#注释在最后有详细说明 sync :x:5:0: sync : /sbin : /bin/sync shutdown :x:6:0: shutdown : /sbin : /sbin/shutdown halt:x:7:0:halt: /sbin : /sbin/halt bash :x:2017:2017:: /home/bash : /bin/bash nologin:x:2020:2020:: /home/nologin : /sbin/nologin 注:"^\([[:alnum:]]\+\>\).*\1$"的意思是做分组中间可出现任意内容,结尾匹配行首。 详细解答:\(和\)把里面的多个字符分成一组,当作一个整体进行处理,[[:alnum:]]\+代表以一个数字或字母开头后面可以跟任意位数的字符,\>表示这个字符的结束。.*表示中间可出现任意长度字符。\1$表示结尾匹配行首。 图示: 本文转自cix123 51CTO博客,原文链接:http://blog.51cto.com/zhaodongwei/1841892,如需转载请自行联系原作者

优秀的个人博客,低调大师

马哥运维学习作业(三)

1、列出当前系统上所有已经登录的用户的用户名,注意:同一个用户登录多次,则只显示一次即可。 1 2 3 4 5 6 7 8 [root@c6-1~] #who rootpts /0 2016-08-2201:40(10.3.20.100) zdwpts /1 2016-08-2201:45(10.3.20.100) zdwpts /2 2016-08-2201:45(10.3.20.100) rootpts /3 2016-08-2201:46(10.3.20.100) [root@c6-1~] #who|cut-d''-f1|sort-u root zdw 2、取出最后登录到当前系统的用户的相关信息。 1 2 [root@c6-1~] #last|head-1 rootpts /3 10.3.20.100MonAug2201:46stilllogged in 3、取出当前系统上被用户当作其默认shell的最多的那个shell。 1 2 [root@c6-1~] #cat/etc/passwd|cut-d:-f7|sort|uniq-c|sort-n|tail-1 15 /sbin/nologin 4、将/etc/passwd 中的第三个字段数值最大的后10个用户的信息全部改为大写后保存至/tmp/maxusers.txt文件中。 1 2 3 4 5 6 7 8 9 10 11 12 [root@c6-1~] #sort-t:-k3-n/etc/passwd|tail-10|tr"a-z""A-Z">/tmp/maxusers.txt [root@c6-1~] #cat/tmp/maxusers.txt OPERATOR:X:11:0:OPERATOR: /ROOT : /SBIN/NOLOGIN GAMES:X:12:100:GAMES: /USR/GAMES : /SBIN/NOLOGIN GOPHER:X:13:30:GOPHER: /VAR/GOPHER : /SBIN/NOLOGIN FTP:X:14:50:FTPUSER: /VAR/FTP : /SBIN/NOLOGIN VCSA:X:69:69:VIRTUALCONSOLEMEMORYOWNER: /DEV : /SBIN/NOLOGIN SSHD:X:74:74:PRIVILEGE-SEPARATEDSSH: /VAR/EMPTY/SSHD : /SBIN/NOLOGIN POSTFIX:X:89:89:: /VAR/SPOOL/POSTFIX : /SBIN/NOLOGIN NOBODY:X:99:99:NOBODY:/: /SBIN/NOLOGIN SASLAUTH:X:499:76: "SASLAUTHDUSER" : /VAR/EMPTY/SASLAUTH : /SBIN/NOLOGIN ZDW:X:500:500:: /HOME/ZDW : /BIN/BASH 5、取出当前主机的IP地址,提示:对ifconfig命令的结果进行切分。 1 2 [root@c6-1~] #ifconfig|grepinet|cut-d:-f2|cut-d''-f1|head-1 10.3.20.80 6、列出/etc目录下所有以.conf结尾的文件的文件名,并将其名字转换为大写后保存至/tmp/etc.conf文件中。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 [root@c6-1~] #ls/etc/*.conf|tr"a-z""A-Z">/tmp/etc.conf [root@c6-1~] #cat/tmp/etc.conf /ETC/DRACUT .CONF /ETC/GAI .CONF /ETC/GRUB .CONF /ETC/HOST .CONF /ETC/KRB5 .CONF /ETC/LD .SO.CONF /ETC/LIBAUDIT .CONF /ETC/LIBUSER .CONF /ETC/LOGROTATE .CONF /ETC/MKE2FS .CONF /ETC/NSSWITCH .CONF /ETC/RESOLV .CONF /ETC/RSYSLOG .CONF /ETC/SESTATUS .CONF /ETC/SUDO .CONF /ETC/SUDO-LDAP .CONF /ETC/SYSCTL .CONF /ETC/YUM .CONF 7、显示/var目录下一级子目录或文件的总个数。 1 2 [root@c6-1~] #ls/var/|wc-l 16 8、取出/etc/group文件中第三个字段数值最小的10个组的名字。 1 2 3 4 5 6 7 8 9 10 11 [root@c6-1~] #sort-t:-k3-n/etc/group|head-10|cut-d:-f1 root bin daemon sys adm tty disk lp mem kmem 9、将/etc/fstab和/etc/issue文件的内容合并为同一个内容后保存至/tmp/etc.test文件中。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 [root@c6-1~] #cat/etc/{fstab,issue}>/tmp/etc.test [root@c6-1~] #cat/tmp/etc.test # #/etc/fstab #CreatedbyanacondaonMonFeb2901:31:342016 # #Accessiblefilesystems,byreference,aremaintainedunder'/dev/disk' #Seemanpagesfstab(5),findfs(8),mount(8)and/orblkid(8)formoreinfo # /dev/mapper/VolGroup-lv_root /ext4defaults11 UUID=e880d9c0-5a7e-4e59-a49b-06488a6e4208 /boot ext4defaults12 /dev/mapper/VolGroup-lv_swap swapswapdefaults00 tmpfs /dev/shm tmpfsdefaults00 devpts /dev/pts devptsgid=5,mode=62000 sysfs /sys sysfsdefaults00 proc /proc procdefaults00 CentOSrelease6.5(Final) Kernel\ronan\m 10、请总结描述用户和组管理类命令的使用方法并完成以下练习: (1)、创建组distro,其GID为2016; 1 2 3 [root@c6-1~] #groupadd-g2016distro [root@c6-1~] #tail-1/etc/group distro:x:2016: (2)、创建用户mandriva, 其ID号为1005;基本组为distro; 1 2 3 [root@c6-1~] #useradd-u1005-gdistromandriva [root@c6-1~] #idmandriva uid=1005(mandriva)gid=2016(distro) groups =2016(distro) (3)、创建用户mageia,其ID号为1100,家目录为/home/linux; 1 2 3 [root@c6-1~] #useradd-u1100-d/home/linuxmageia [root@c6-1~] #tail-1/etc/passwd mageia:x:1100:1100:: /home/linux : /bin/bash (4)、给用户mageia添加密码,密码为mageedu; 1 2 3 [root@c6-1~] #echo"password"|passwd--stdinmageia Changingpassword for usermageia. passwd :allauthenticationtokensupdatedsuccessfully. (5)、删除mandriva,但保留其家目录; 1 2 3 4 5 [root@c6-1~] #userdelmandriva [root@c6-1~] #ls/home/ linuxmandrivazdw [root@c6-1~] #idmandriva id :mandriva:Nosuchuser (6)、创建用户slackware,其ID号为2002,基本组为distro,附加组peguin; 1 2 3 4 [root@c6-1~] #groupaddpeguin [root@c6-1~] #useradd-u2002-gdistro-Gpeguinslackware [root@c6-1~] #idslackware uid=2002(slackware)gid=2016(distro) groups =2016(distro),2017(peguin) (7)、修改slackware的默认shell为/bin/tcsh; 1 2 3 [root@c6-1~] #usermod-s/bin/tcshslackware [root@c6-1~] #grep'slackware'/etc/passwd slackware:x:2002:2016:: /home/slackware : /bin/tcsh (8)、为用户slackware新增附加组admins; 1 2 3 4 [root@c6-1~] #groupaddadmins [root@c6-1~] #usermod-a-Gadminsslackware [root@c6-1~] #idslackware uid=2002(slackware)gid=2016(distro) groups =2016(distro),2017(peguin),2018(admins) (9)、为slackware添加密码,且要求密码最短使用期限为3天,最长为180天,警告为3天; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 [root@c6-1~] #echo"123456"|passwd--stdinslackware Changingpassword for userslackware. passwd :allauthenticationtokensupdatedsuccessfully. [root@c6-1~] #passwd-n3-x180-w3slackware Adjustingagingdata for userslackware. passwd :Success [root@c6-1~] #chage-lslackware Lastpasswordchange:Aug21,2016 Passwordexpires:Feb17,2017 Passwordinactive:never Accountexpires:never Minimumnumberofdaysbetweenpasswordchange:3 Maximumnumberofdaysbetweenpasswordchange:180 Numberofdaysofwarningbeforepasswordexpires:3 (10)、添加用户openstack,其ID号为3003, 基本组为clouds,附加组为peguin和nova; 1 2 3 4 5 [root@c6-1~] #groupaddclouds [root@c6-1~] #groupaddnova [root@c6-1~] #useradd-u3003-gclouds-Gpeguin,novaopenstack [root@c6-1~] #idopenstack uid=3003(openstack)gid=2019(clouds) groups =2019(clouds),2017(peguin),2020(nova) (11)、添加系统用户mysql,要求其shell为/sbin/nologin; 1 2 3 [root@c6-1~] #useradd-s/sbin/nologinmysql [root@c6-1~] #grep'mysql'/etc/passwd mysql:x:3004:3004:: /home/mysql : /sbin/nologin (12)、使用echo命令,非交互式为openstack添加密码。 1 2 3 [root@c6-1~] #echo"password"|passwd--stdinopenstack Changingpassword for useropenstack. passwd :allauthenticationtokensupdatedsuccessfully. 本文转自cix123 51CTO博客,原文链接:http://blog.51cto.com/zhaodongwei/1840876,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册