首页 文章 精选 留言 我的

精选列表

搜索[教程],共9654篇文章
优秀的个人博客,低调大师

iPhone入门学习系列教程

iPhone入门学习——TTS使用文档 iPhone入门学习——CoverFlow效果例子 iPhone入门学习——iPhone单元测试方法学习笔记 iPhone入门学习——iPhoneWeb开发学习笔记 Phone入门学习——iPhone私有API使用学习笔记 iPhone入门学习——半翻页动画效果例子 iPhone入门学习——CoreLocation定位学习笔记 iPhone入门学习——iPhone静态库学习笔记 iPhone入门学习——屏幕标记学习笔记 iPhone入门学习——NetworkReachable学习笔记 iPhone入门学习——屏幕标记学习笔记 iPhone入门学习——AddressBook学习笔记 iPhone入门学习——UITabBarController学习笔记 zt- iPhone入门学习——UITabBarController学习笔记 iPhone入门学习——Objective-C学习文档 iPhone入门学习——iPhone学习文档_快捷键 iPhone入门学习——MKMapView学习笔记 iPhone入门学习——AddressBook学习笔记 本文转自qianqianlianmeng博客园博客,原文链接:http://www.cnblogs.com/aimeng/archive/2012/02/15/2352165.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android--刷机教程

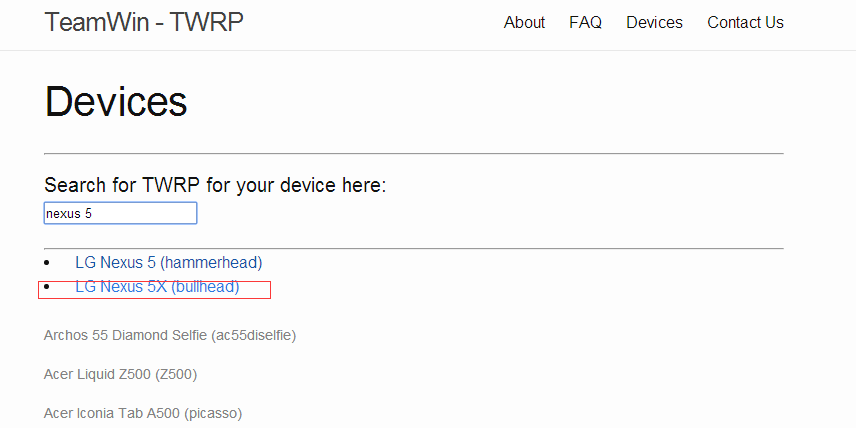
版权声明:本文为博主原创文章,转载请标明出处。 https://blog.csdn.net/chaoyu168/article/details/77982282 1、打开https://twrp.me/Devices/网站,输入手机型号下载recovery 2、刷入recovery 第一步:在电脑上下载并解压通用fastboot工具,下载地址:http://pan.baidu.com/s/1jHm5YgI这个小工具是一个绿色adb工具,刷入完成以后,直接删除即可,不会像刷机精灵那种软件还要怎么卸载、删除注册表之类。下载解压后,如图所示,我们把它放在一边,建议解压到桌面,方便查找。 第二步:第一步下载好的的img格式的recovery包,一定要是.img格式后缀的文件,我们把它重命名为recovery.img,如图所示,然后我们把这个img格式的文件复制到刚才解压好的“通用fastboot工具”里面,如图所示哦。 第三步:这个时候,就需要把手机进入到fastboot模式,将手机关机,同时按住音量下+电源键 即可进入到fastboot模式,相信部分发烧友对这个模式非常熟悉吧~当手机出现下面这个样子后,就代表已经进入到fastboot模式了。 第四步:将已经进入到fastboot模式下的手机连接电脑,如果电脑提示没有连接成功,基本上是驱动没有安装好造成的,建议先在电脑上安装好驱动。连接好后,双击打开通用fastboot工具文件夹,按住键盘上的shift键,同时鼠标在空白处右击,选择出现的对话框里的”在此处打开对话框窗口“,如图所示。 第五步:此时,手动输入”fastboot flash recovery recovery.img“(引号不需要输入),输入完毕后,按回车键确认。当屏幕上出现下方类似字符后,提示”okay、finished“等字样,即表示刷入成功。这时,拔掉数据线即可完成所有步骤!要检查的话,拔掉数据线,长按电源键出现mi标志重新启动时按住音量上+电源键 进入rec,否则还是官方rec哦~ 4、去ROM之家、ROM基地等网站查找下载自己手机型号的rom包(.zip格式),然后重命名为update.zip;传到手机SD卡。 5、然后手机关机,同时按住关机键和音量下键,进入recovery模式 双wipe: wipedata/factoryreset——Yes——deletealluserdata. wipecachepartition——Yes-WipeCache. 返回主界面,选择【Installzip from SDCARD】(从SD卡选择更新)然后再选择【choose zip from sdcard】(从SD卡选择升级包更新),接着选中你放入存储卡中的ROM包【update.zip】,选择是,等待完成,返回上级菜单,最后选择【Reboot system now】

优秀的个人博客,低调大师

Maven hive-jdbc教程

由于项目中需要用到hive-jdbc从数据仓库拉数据下来,所以简单的学一下hive,hive数据仓库建构在hadoop集群之上,数据存在hdfs文件系统中,hive中执行的操作会装换成mapreduce作业进行执行,hive支持类似SQL的语言HQL,hive采用元数据对表进行管理,元数据有三种存放模式:嵌入模式,远程模式,本地模式;hive提供了强大的编程接口,hive jdbc可以让你如使用普通的jdbc一般来操作hive表以及数据。 1.添加依赖 <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-hdfs</artifactId> <version>2.6.4</version> </dependency> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-common</artifactId> <version>2.6.4</version> </dependency> <dependency> <groupId>org.apache.hive</groupId> <artifactId>hive-exec</artifactId> <version>1.1.0</version> <exclusions> <exclusion> <artifactId> pentaho-aggdesigner-algorithm </artifactId> <groupId>org.pentaho</groupId> </exclusion> </exclusions> </dependency> <dependency> <groupId>org.apache.hive</groupId> <artifactId>hive-jdbc</artifactId> <version>1.1.0</version> </dependency> 2.jdbc连接hive public class TestHive { private static String driverName = "org.apache.hive.jdbc.HiveDriver";//jdbc驱动路径 private static String url = "jdbc:hive2://hiveserver.xxx.com:10000/dbName";//hive库地址+库名 private static String user = "username";//用户名 private static String password = "pwd";//密码 private static String sql = ""; private static ResultSet res; public static void main(String[] args) { Connection conn = null; Statement stmt = null; try { conn = getConn(); System.out.println(conn); stmt = conn.createStatement(); String tableName="tab_name";//hive表名 sql = "select * from " + tableName; System.out.println("Running:" + sql); res = stmt.executeQuery(sql); System.out.println("执行 select * query 运行结果:"); while (res.next()) { System.out.println(res.getInt(1) + "\t" + res.getString(2)); } } catch (ClassNotFoundException e) { e.printStackTrace(); System.exit(1); } catch (SQLException e) { e.printStackTrace(); System.exit(1); } finally { try { if (conn != null) { conn.close(); conn = null; } if (stmt != null) { stmt.close(); stmt = null; } } catch (SQLException e) { e.printStackTrace(); } } } private static Connection getConn() throws ClassNotFoundException, SQLException { Class.forName(driverName); Connection conn = DriverManager.getConnection(url, user, password); return conn; } } 3.查询hive表数据 这个就和普通的jdbc差不太多,也是用sql的方式进行查询,具体的查询语法,可以参考hive官网 4.封装hive工具类 写完了再贴上来 @落雨 ae6623.cn

优秀的个人博客,低调大师

Docker简明教程(转)

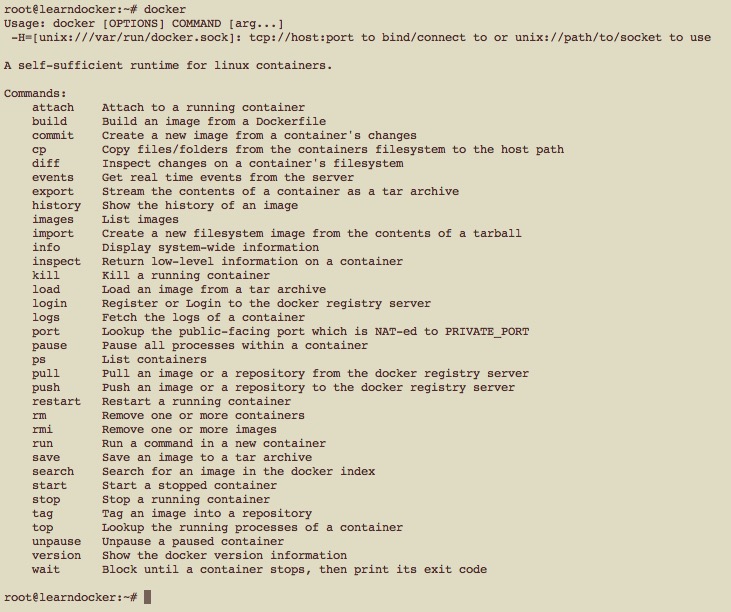
Docker自从诞生以来就一直备受追捧,学习Docker是一件很炫酷、很有意思的事情。我希望通过这篇文章能够让大家快速地入门Docker,并有一些学习成果来激发自己的学习兴趣。我也只是一个在Docker这条巨鲸上玩耍的小孩,全文如有不明确、不正确的地方,还请斧正。 Ubuntu上安装Docker Docker的基础是Linux容器技术,因此学习Docker最好是使用Linux。这里推荐64位Ubuntu系统,因为在写此文(2015-05-28)时,Docker还不支持32位,尽管民间有些土办法可以象征性的解决,但还是推荐初学Docker的尽量按照标准的来。如果手边没有Ubuntu系统可以去Digitalocean、Ucloud等云服务商去租用一个Linux服务器。这样即使玩坏了也可以随时重新开始。 在Ubuntu中只需要运行一行命令即可实现Docker的安装: sudo apt-get install docker.io 运行完后,可以在终端输入docker看到下面的界面证明我们安装成功了(注:提示权限问题就添加sudo,下文同): 从上图可以看到,Docker的命令并不多,只有三十几个。例如我们可以输入docker info来查看我们安装的Docker信息: 运行容器 安装好之后,我们就可以来开始Docker之旅了, 我们现在的Docker还是一个”裸”Docker,上面没有容器,等一下,什么是容器?所谓容器就是Docker中用来运行应用的,Docker的容器很轻量级,但功能却强悍的很。也没有镜像。镜像?镜像简单理解就是容器的只读版本,用来方便存储与交流。此时,我们可以通过官方提供给我们的镜像来进行学习。比如我们想在Docker中运行一个Ubuntu系统,很简单,Docker中得pull命令是用来获取镜像的,执行下面的命令,就会从官方仓库里获取Ubuntu 14.04版本的系统: docker pull ubuntu:14.04 images命令用来查看本机Docker中存在哪些镜像,运行docker images就会看到我们刚才获取的Ubuntu14.04系统: 现在,我们把刚刚的镜像运行起来,运行起来的镜像就叫做容器了,容器是可读写的,这样我们就可以在容器里做很多有意思的事情了。run命令就是将镜像运行起来的,运行: docker run -it ubuntu:14.04 仔细看,你会发现终端交互的用户名变掉了,说明我们进入到了容器的内部,效果如下: 现在我们所做的任何操作都是针对于目前容器而言的,不会影响到原来的系统,例如,我们在里面安装下nginx服务器,运行如下命令: sudo apt-get install -y nginx 完成后执行nginx -v就会发现我们已经将nginx安装成功: 将容器转化为镜像 在上一小节中,我们已经在容器里安装好了nginx,接下来我们希望将这个容器内容保存下来,这样我们下次就无需再次安装了。这就是Docker中将容器转换为镜像的技术。 如果您还在刚刚的安装了nginx的终端里,执行exit退出此终端,回到系统本身的终端: ps命令可以查看我们当前都运行了哪些容器,加上-a参数后就表示运行过哪些容器,因为我们刚刚已经退出了安装nginx的容器,因此我现在想查看它的话,需要使用-a参数,执行如下命令: docker ps -a 此时,就会显示出我们刚刚运行的容器,并且Docker会很贴心的随机给每个容器都起个Names方便标示。效果如下: commit命令用来将容器转化为镜像,运行下面的命令,我们可以讲刚刚的容器转换为镜像: sudo docker commit -m "Added nginx from ubuntu14.04" -a "saymagic" 79c761f627f3 saymagic/ubuntu-nginx:v1 其中,-m参数用来来指定提交的说明信息;-a可以指定用户信息的;79c761f627f3代表的是容器的id;saymagic/ubuntu-nginx:v1指定目标镜像的用户名、仓库名和tag 信息。创建成功后会返回这个镜像的ID信息。注意的是,你一定要将saymagic改为你自己的用户名。因为下文还会用到此用户名。 这是我们再次使用docker images命令就会发现此时多出了一个我们刚刚创建的镜像: 此时,如果运行docker run -it saymagic/ubuntu-nginx:v1就会是一个已经安装了nginx的容器: 存储镜像 我们刚刚已经创建了自己的第一个镜像,尽管它很简单,但这已经非常棒了,现在,我们希望它能够被更多的人使用到,此时,我们就需要将这个镜像上传到镜像仓库,Docker的官方Docker Hub应该是目前最大的Docker镜像中心,所以,我们就将我们的镜像上传到Docker Hub。 首先,我们需要成为Docker Hub的用户,前往https://hub.docker.com/进行注册。需要注意的是,为了方便下面的操作,你需要将你的用户名设为和我刚刚在上文提到的自定义用户名相同,例如我的刚刚将镜像的名字命名为是saymagic/ubuntu-nginx:v2,所以我的用户名为saymagic、注册完成后记住用户名、密码、邮箱。 login默认是用来登陆Docker Hub的,因此,输入如下命令来尝试登陆Docker Hub: docker login 此时,就会输出交互,让我们输入Username、Password、Email,成功输入我们刚才注册的信息后就会返回Login Success提示: 运行命令: docker push saymagic/ubuntu-nginx:v1 这就是我们为什么将刚刚的镜像命名为saymagic/ubuntu-nginx:v1的原因,如果你上面步骤都操作正确的正确的话,是会得到下面的内容: 此时,不出意外的话,我们的镜像已经被上传到Docker Hub上面了,去Docker Hub上面看看: 果然,我们在Docker Hub上有了我们的第一个镜像,此时,其它的用户就可以通过命令docker pull saymagic/ubuntu-nginx来直接获取一个安装了nginx的ubuntu系统了。不信?那就自己实践一下吧! Dockerfile使用 通过上面的学习,我们掌握了如何创建镜像、获取镜像、上传镜像、运行容器等等内容。有了上面的知识,我们来次实战。 我们刚刚使用了commit命令创建了一个安装nginx的镜像,但其实Docker创建镜像的命令还有build,build命令可以通过指定一个Dockerfile文件来实现将镜像创建过程自动化。Dockerfile文件有着特定的编写规则,但语法都还比较容易理解。这次我们不仅使用Dockerfile文件来创建一个像上文一样安装nginx的ubuntu镜像,还要发挥nginx的老本行来运行一个网页吧!DockFile可以很轻松的完成这个问题。首先将新建一个名字为www的文件夹,文件夹下面可以放一些HTML网页,比如新建一个index.html文件,随便写点内容: <html> <head> Learn Docker </head> <body> <h1>Enjoy Docker!</h1> </body> </html> 在www的同级目录下新建一个名为Dockerfile的文件,将DockerFile文件改写如下: FROM ubuntu:14.04 MAINTAINER saymagic saymagic@163.com RUN apt-get update RUN apt-get install -y nginx COPY ./www /usr/share/nginx/html EXPOSE 80 CMD ["nginx", "-g", "daemon off;"] 我来整体的解释下这个Dockerfile文件,第一行是用来声明我们的镜像是基于什么构建的,这里我们指定为ubuntu 14.04,第二行的作用在于告诉别人你的大名。第三行和第四行的RUN命令用来在容器内部的shell里执行命令。第五行将当前系统的www文件夹拷贝到容器的/usr/share/nginx/html目录下,第六行声明当前需要对外开放80端口,最后一行表示运行容器时开启nginx。不理解没关系,因为这都是固定的语法,感兴趣可以多看相关内容。此时我们通过build命令来构建镜像,运行: docker build -t="saymagic/ubuntu-nginx:v2" . 注意,最后的.表示Dockerfile在当前目录,也可指定其它目录。此时,再次运行docker images就会看到刚刚生成的镜像: 现在我们就可以运行刚刚的镜像了,和前面运行稍有不同,此时我们需要对外指定80端口,该行为通过-p参数指定,运行: docker run -p 80:80 saymagic/ubuntu-nginx:v2 此时,终端会卡住,这是正常的,因为Docker的思想是每个容器最好只开一个线程做一件事,此时我们打开了nginx服务器,所以终端卡住也没关系(当然是有办法来解决这个问题,但这里不做介绍)。现在我们可以通过浏览器访问localhost查看效果,如果是虚拟主机则需输入主机ip地址,然后就能看到了如下的页面: DaoCloud实战 如果我们自己没有服务器,刚刚的网页我们只能在本地访问,好可惜。别急,现在我要隆重介绍一个Docker的好伙伴——DaoCloud,官网传送门:https://www.daocloud.io/ 有了DaoCloud,我们只需要负责写Dockerfile,剩下的build、运行之类的东西都交给DaoCloud,我们只需要点一点按钮即可。 DaoCloud会将Github、GitCafe等git服务商作为代码源,这里我使用GitCafe,为了你下面的操作更加方便,你可以直接Fork我的项目,项目地址:https://gitcafe.com/saymagic/LearnDocker。 接着,我们需要去Daocloud注册一个账号,完成后,进入个人主页后选择代码构建->创建新项目->给项目起一个响亮的名字->同步GitCafe代码源->选择GitCafe下的LearnDocker项目: 最后,点击开始创建按钮。Daoloud就会马不停蹄的运行起来。如果细心的话你会发现,DaoCloud的build会比本地快很多,很迅速就会完成镜像的构建: 仅仅是构建镜像没什么意思, DaoCloud还可以将这个镜像在云端运行起来。我们点击绿色的查看镜像按钮,跳转到如下页面: 在DaoCloud中镜像需要运行在容器中,因为当前我们只构建了一个版本,所以选择部署最新版本和下面的部署按钮效果相同,点击任意一个,来到了这里: 我们给容器起一个霸气的名字learndocker,然后点击页面最下面的立即部署按钮,秒秒钟,我们的应用就运行了起来: 此时,注意到你自己运行成功的url后面的链接,将其复制到浏览器打开,你会发现,网页的内容就是本篇博客: 写在最后 Docker能做的事情远不止这些,更多有意思的事情还请读者慢慢用心去发现。 http://kb.cnblogs.com/page/536115/

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册