首页 文章 精选 留言 我的

精选列表

搜索[并行文件系统],共10003篇文章
优秀的个人博客,低调大师

通过javaAPI上传文件到HDFS文件系统

import java.io.BufferedInputStream; import java.io.FileInputStream; import java.io.InputStream; import java.io.OutputStream; import java.net.URI; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IOUtils; import org.apache.hadoop.util.Progressable; public class UploadFile { public static void main(String[] args) { try { String localSrc = "E://Temp/117227.jpg"; String dst = "hdfs://ip:8020/tmp/hadoop-xiaohu/117227.jpg"; InputStream in = new BufferedInputStream(new FileInputStream(localSrc)); Configuration conf = new Configuration(); FileSystem fs = FileSystem.get(URI.create(dst), conf); OutputStream out = fs.create(new Path(dst), new Progressable() { public void progress() { System.out.print("."); } }); IOUtils.copyBytes(in, out, 4096, true); System.out.println("success"); } catch (Exception e) { e.printStackTrace(); } } } 上传成功后通过浏览器打开50070查看,选择 Browse Directory 文件列表就显示出来了 本文转自 ChinaUnicom110 51CTO博客,原文链接:http://blog.51cto.com/xingyue2011/1904018

优秀的个人博客,低调大师

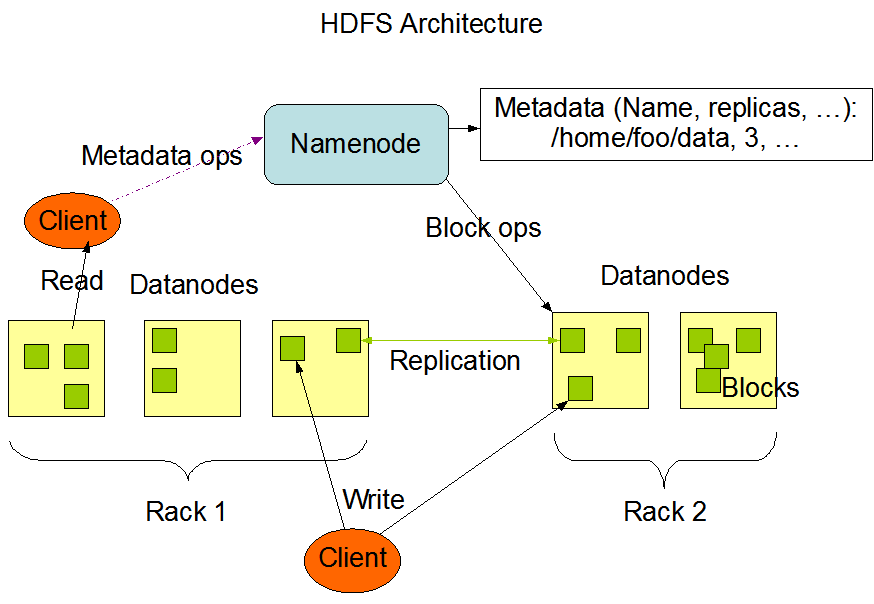
Hadoop分布式文件系统架构部署

前言*Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,如亚马逊、Facebook和Yahoo等等。对于我来说,最近的一个使用点就是服务集成平台的日志分析。服务集成平台的日志量将会很大,而这也正好符合了分布式计算的适用场景(日志分析和索引建立就是两大应用场景)。 今天我们来实际搭建一下Hadoop 2.2.0版,实战环境为目前主流服务器操作系统CentOS 5.8系统。 一、实战环境 1 2 3 4 5 6 系统版本:CentOS 5.8 x86_64 JAVA版本:JDK- 1.7 .0_25 Hadoop版本:hadoop- 2.2 . 0 192.168 . 149.128 namenode (充当namenode、secondary namenode和ResourceManager角色) 192.168 . 149.129 datanode1 (充当datanode、nodemanager角色) 192.168 . 149.130 datanode2 (充当datanode、nodemanager角色) 二、系统准备 1、Hadoop可以从Apache官方网站直接下载最新版本Hadoop2.2。官方目前是提供了linux32位系统可执行文件,所以如果需要在64位系统上部署则需要单独下载src源码自行编译。(如果是真实线上环境,请下载64位hadoop版本,这样可以避免很多问题,这里我实验采用的是32位版本) 1 2 3 4 Hadoop下载地址 http: //apache.claz.org/hadoop/common/hadoop-2.2.0/ Java 下载下载 http: //www.oracle.com/technetwork/java/javase/downloads/index.html 2、我们这里采用三台CnetOS服务器来搭建Hadoop集群,分别的角色如上已经注明。 第一步:我们需要在三台服务器的/etc/hosts里面设置对应的主机名如下(真实环境可以使用内网DNS解析) [root@node1 hadoop]# cat /etc/hosts 1 2 3 4 5 6 # Do not remove the following line, or var ious programs # that require network functionality will fail. 127.0 . 0.1 localhost.localdomain localhost 192.168 . 149.128 node1 192.168 . 149.129 node2 192.168 . 149.130 node3 (注*我们需要在namenode、datanode三台服务器上都配置hosts解析) 第二步:从namenode上无密码登陆各台datanode服务器,需要做如下配置: 1 2 3 4 在namenode 128 上执行ssh-keygen,一路Enter回车即可。 然后把公钥/root/.ssh/id_rsa.pub拷贝到datanode服务器即可,拷贝方法如下: ssh-copy-id -i .ssh/id_rsa.pub root@ 192.168 . 149.129 ssh-copy-id -i .ssh/id_rsa.pub root@ 192.168 . 149.130 三、Java安装配置 1 2 3 4 5 tar -xvzf jdk-7u25-linux-x64.tar.gz &&mkdir -p /usr/java/ ; mv /jdk1. 7 .0_25 /usr/java/ 即可。 安装完毕并配置java环境变量,在/etc/profile末尾添加如下代码: export JAVA_HOME=/usr/java/jdk1. 7 .0_25/ export PATH=$JAVA_HOME/bin:$PATH export CLASSPATH=$JAVE_HOME/lib/dt.jar:$JAVE_HOME/lib/tools.jar:./ 保存退出即可,然后执行source /etc/profile生效。在命令行执行java -version如下代表JAVA安装成功。 1 2 3 4 [root@node1 ~]# java -version java version "1.7.0_25" Java(TM) SE Runtime Environment (build 1.7 .0_25-b15) Java HotSpot(TM) 64 -Bit Server VM (build 23.25 -b01, mixed mode) (注*我们需要在namenode、datanode三台服务器上都安装Java JDK版本) 四、Hadoop版本安装 官方下载的hadoop2.2.0版本,不用编译直接解压安装就可以使用了,如下: 第一步解压: 1 2 tar -xzvf hadoop- 2.2 . 0 .tar.gz &&mv hadoop- 2.2 . 0 /data/hadoop/ (注* 先在namenode服务器上都安装hadoop版本即可,datanode先不用安装,待会修改完配置后统一安装datanode) 第二步配置变量: 1 2 3 4 5 在/etc/profile末尾继续添加如下代码,并执行source /etc/profile生效。 export HADOOP_HOME=/data/hadoop/ export PATH=$PATH:$HADOOP_HOME/bin/ export JAVA_LIBRARY_PATH=/data/hadoop/lib/ native / (注* 我们需要在namenode、datanode三台服务器上都配置Hadoop相关变量) 五、配置Hadoop 在namenode上配置,我们需要修改如下几个地方: 1、修改vi /data/hadoop/etc/hadoop/core-site.xml内容为如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 <?xml version= "1.0" ?> <?xml-stylesheet type= "text/xsl" href= "configuration.xsl" ?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>fs. default .name</name> <value>hdfs: //192.168.149.128:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/tmp/hadoop-${user.name}</value> <description>A base for other temporary directories.</description> </property> </configuration> 2、修改vi /data/hadoop/etc/hadoop/mapred-site.xml内容为如下: 1 2 3 4 5 6 7 8 9 <?xml version= "1.0" ?> <?xml-stylesheet type= "text/xsl" href= "configuration.xsl" ?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>mapred.job.tracker</name> <value> 192.168 . 149.128 : 9001 </value> </property> </configuration> 3、修改vi /data/hadoop/etc/hadoop/hdfs-site.xml内容为如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 <?xml version= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type= "text/xsl" href= "configuration.xsl" ?> <configuration> <property> <name>dfs.name.dir</name> <value>/data/hadoop/data_name1,/data/hadoop/data_name2</value> </property> <property> <name>dfs.data.dir</name> <value>/data/hadoop/data_1,/data/hadoop/data_2</value> </property> <property> <name>dfs.replication</name> <value> 2 </value> </property> </configuration> 4、在/data/hadoop/etc/hadoop/hadoop-env.sh文件末尾追加JAV_HOME变量: 1 echo "export JAVA_HOME=/usr/java/jdk1.7.0_25/" >> /data/hadoop/etc/hadoop/hadoop-env.sh 5、修改vi /data/hadoop/etc/hadoop/masters文件内容为如下: 1 192.168 . 149.128 6、修改vi /data/hadoop/etc/hadoop/slaves文件内容为如下: 1 2 192.168 . 149.129 192.168 . 149.130 如上配置完毕,以上的配置具体含义在这里就不做过多的解释了,搭建的时候不明白,可以查看一下相关的官方文档。 如上namenode就基本搭建完毕,接下来我们需要部署datanode,部署datanode相对简单,执行如下操作即可。 1 for i in `seq 129 130 ` ; do scp -r /data/hadoop/ root@ 192.168 . 149 .$i:/data/ ; done 自此整个集群基本搭建完毕,接下来就是启动hadoop集群了。 六、启动hadoop并测试 在启动hadoop之前,我们需要做一步非常关键的步骤,需要在namenode上执行如下命令初始化name目录和数据目录。 1 cd /data/hadoop/ ; ./bin/hadoop namenode -format 那如何算初始化成功呢,如下截图成功创建name目录即正常: 然后启动hadoop所有服务,如下命令: 1 [root@node1 hadoop]# ./sbin/start-all.sh 我们还可以查看相应的端口是否启动:netstat -ntpl 访问如下地址:http://192.168.149.128:50070/ 访问地址:http://192.168.149.128:8088/ 搭建完成后,我们简单的实际操作一下,如下图: 自此hadoop基本搭建完毕,接下来还有更深更多的东西需要去了解和学习,希望和大家一起学习,进步,分享、快乐。 本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1332340

优秀的个人博客,低调大师

HTTPFS: 基于HTTP操作hadoop hdfs文件系统

一、HTTPFS简介 1:httpfs是cloudera公司提供的一个hadoop hdfs的一个http接口,通过WebHDFS REST API 可以对hdfs进行读写等访问 2:与WebHDFS的区别是不需要客户端可以访问hadoop集群的每一个节点,通过httpfs可以访问放置在防火墙后面的hadoop集群 3:httpfs是一个Web应用,部署在内嵌的tomcat中 用这种方式在数据共享给其他系统时,网络安全上更容易实现,使用请参考: http://archive.cloudera.com/cdh4/cdh/4/hadoop/hadoop-project-dist/hadoop-hdfs/WebHDFS.html 二、启动服务(针对使用cloudera manager安装了CDH4或CDH5) 在cm控制台,打开hdfs实例页面,添加httpfs服务,然后启动即可。 三、安装可参考(手工安装) http://www.cloudera.com/content/cloudera-content/cloudera-docs/CDH4/latest/CDH4-Installation-Guide/cdh4ig_topic_25_8.html http://blog.csdn.net/ganglia/article/details/25902873 四、curl操作命令示例(需要将host替换为实际部署httpfs的服务器IP) curl -c ~/.httpsauth "http://host:14000/webhdfs/v1?op=gethomedirectory&user.name=hdfs" curl -b ~/.httpsauth "http://host:14000/webhdfs/v1?op=gethomedirectory" curl -b ~/.httpsauth "http://host:14000/webhdfs/v1/test/data1.txt?op=OPEN" curl -b ~/.httpsauth -X DELETE "http://host:14000/webhdfs/v1/test/data1.txt?op=DELETE" 创建和追加都是分为两步,测试都没有成功(注意,一定要追加--header参数,否则创建会失败) curl -b ~/.httpsauth -i -X PUT "http://172.168.63.221:14000/webhdfs/v1/test2?op=CREATE&buffersize=1000" curl -b ~/.httpsauth -i -X PUT -T data2.txt --header "Content-Type: application/octet-stream" "http://172.168.63.221:14000/webhdfs/v1/test2/data.txt?op=CREATE&user.name=hdfs&buffersize=1000&data=true" 五、基于JAVA操作httpfs的开源代码 开源项目地址,有什么问题可以直接反馈给我 https://github.com/gitriver/httpfs-client 说明 1 包com.catt.httpfs.client.httpclient是采用commons-httpclient.jar, 基于http请求实现的,没有使用到hadoop相关的jar 2 包org.apache.hadoop.fs.http.client根据httpfs项目的源代码, 根据需要修改了一下,使用了hadoop相关的jar

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册