首页 文章 精选 留言 我的

精选列表

搜索[小程序·即时通信 IM],共10028篇文章
优秀的个人博客,低调大师

人脸识别&ORC的Demo

一.用到的jar包: face_sdk-1.3.4.jar json-20160810.jar ocr_sdk-1.3.4.jar 下载地址:https://files.cnblogs.com/files/DreamDrive/ocrdemo.rar 二.测试代码 FaceDetect.java 1 import java.util.HashMap; 2 3 import org.json.JSONObject; 4 5 import com.baidu.aip.face.AipFace; 6 /** 7 * 百度云人脸检测demo 8 * @author Administrator 9 * 10 */ 11 public class FaceDetect { 12 13 private static AipFace apiFace=null; 14 final static String APP_ID="9662379"; 15 final static String AIP_KEY="BGczNjdkZs5UQxUBlHzDWP6R"; 16 final static String AIP_TOKEN="lLL5C2nItGPnuXME2GM2PzfDRNtrCkRi"; 17 static { 18 if(apiFace==null){ 19 apiFace=new AipFace(APP_ID,AIP_KEY,AIP_TOKEN); 20 } 21 } 22 public void faceDetect(String path){ 23 HashMap<String,String> options=new HashMap<String,String>(); 24 options.put("max_face_num", "5"); 25 JSONObject response = apiFace.detect(path,options); 26 System.out.println(response.toString()); 27 28 // 参数为本地图片文件二进制数组 29 // byte[] file = readImageFile(path); // readImageFile函数仅为示例 30 // JSONObject response = apiFace.detect(file,options); 31 // System.out.println(response.toString()); 32 } 33 34 public static void main(String[] args){ 35 new FaceDetect().faceDetect("n:/timg3.jpg"); 36 } 37 } OcrDemo.java 1 import java.util.HashMap; 2 import org.json.JSONObject; 3 import com.baidu.aip.ocr.AipOcr; 4 public class OcrDemo { 5 6 7 //设置APPID/AK/SK 8 public static final String APP_ID = "9695214"; 9 public static final String API_KEY = "HxqwTu1M85G1UrG9DZKTNQzN"; 10 public static final String SECRET_KEY = "GVy7ah7MTRUczxS4hCuUvfCCV8oloRZX"; 11 12 public static void main(String[] args) { 13 // 初始化一个OcrClient 14 AipOcr client = new AipOcr(APP_ID, API_KEY, SECRET_KEY); 15 16 // 可选:设置网络连接参数 17 client.setConnectionTimeoutInMillis(2000); 18 client.setSocketTimeoutInMillis(60000); 19 HashMap<String, String> params=new HashMap<String,String>(); 20 // 调用身份证识别接口 21 String idFilePath = "n:/shenfenzheng1.jpg"; 22 JSONObject idcardRes = client.idcard(idFilePath, true,params); 23 System.out.println(idcardRes.toString(2)); 24 25 // 调用银行卡识别接口 26 String bankFilePath = "n:/bankcard.png"; 27 JSONObject bankRes = client.bankcard(bankFilePath); 28 System.out.println(bankRes.toString(2)); 29 30 // 调用通用识别接口 31 String genFilePath = "n:/words.png"; 32 JSONObject genRes = client.basicGeneral(genFilePath, new HashMap<String, String>()); 33 System.out.println(genRes.toString(2)); 34 35 // 调用通用识别(含位置信息)接口 36 // String genFilePath = "test_general.jpg"; 37 // JSONObject genRes = client.general(genFilePath, new HashMap<String, String>()); 38 // System.out.println(genRes.toString(2)); 39 } 40 } 本文转自SummerChill博客园博客,原文链接:http://www.cnblogs.com/DreamDrive/p/7603731.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop&amp;spark安装(上)

硬件环境: hddcluster1 10.0.0.197 redhat7 hddcluster2 10.0.0.228 centos7 这台作为master hddcluster3 10.0.0.202 redhat7 hddcluster4 10.0.0.181 centos7 软件环境: 关闭所有防火墙firewall openssh-clients openssh-server java-1.8.0-openjdk java-1.8.0-openjdk-devel hadoop-2.7.3.tar.gz 流程: 选定一台机器作为 Master 在 Master 节点上配置 hadoop 用户、安装 SSH server、安装 Java 环境 在 Master 节点上安装 Hadoop,并完成配置 在其他 Slave 节点上配置 hadoop 用户、安装 SSH server、安装 Java 环境 将 Master 节点上的 /usr/local/hadoop 目录复制到其他 Slave 节点上 在 Master 节点上开启 Hadoop 1 2 3 4 5 6 7 8 #节点的名称与对应的IP关系 [hadoop@hddcluster2~]$ cat /etc/hosts 127.0.0.1localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 ::1localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.0.0.228hddcluster2 10.0.0.197hddcluster1 10.0.0.202hddcluster3 10.0.0.181hddcluster4 1 2 3 4 5 创建hadoop用户 su #上述提到的以root用户登录 useradd -mhadoop-s /bin/bash #创建新用户hadoop passwd hadoop #设置hadoop密码 visudo #rootALL=(ALL)ALL这行下面添加hadoopALL=(ALL)ALL 1 2 3 4 5 6 7 8 9 10 11 #登录hadoop用户,安装SSH、配置SSH无密码登陆 [hadoop@hddcluster2~]$rpm-qa| grep ssh [hadoop@hddcluster2~]$ sudo yum install openssh-clients [hadoop@hddcluster2~]$ sudo yum install openssh-server [hadoop@hddcluster2~]$ cd ~/. ssh / #若没有该目录,请先执行一次sshlocalhost [hadoop@hddcluster2~]$ ssh -keygen-trsa #会有提示,都按回车就可以 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .publocalhost #加入授权 [hadoop@hddcluster2~]$ chmod 600. /authorized_keys #修改文件权限 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster1 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster3 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster4 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #解压hadoop文件到/usr/local/hadoop [hadoop@hddcluster2~]$ sudo tar -zxfhadoop-2.7.3. tar .gz-C /usr/local/ [hadoop@hddcluster2~]$ sudo mv /usr/local/hadoop-2 .7.3 /usr/local/hadoop [hadoop@hddcluster2~]$ sudo chown -Rhadoop:hadoop /usr/local/hadoop cd /usr/local/hadoop . /bin/hadoop version #安装java环境 [hadoop@hddcluster2~]$ sudo yum install java-1.8.0-openjdkjava-1.8.0-openjdk-devel [hadoop@hddcluster2~]$rpm-qljava-1.8.0-openjdk-devel| grep '/bin/javac' /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 /bin/javac [hadoop@hddcluster2~]$vim~/.bashrc export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 export HADOOP_HOME= /usr/local/hadoop export HADOOP_INSTALL=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export YARN_HOME=$HADOOP_HOME export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME /lib/native export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_OPTS= "-Djava.library.path=$HADOOP_PREFIX/lib:$HADOOP_PREFIX/lib/native" #测试java环境 source ~/.bashrc java-version $JAVA_HOME /bin/java -version #与直接执行java-version一样 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 #修改hadoop文件配置 [hadoop@hddcluster2hadoop]$ pwd /usr/local/hadoop/etc/hadoop [hadoop@hddcluster2hadoop]$ cat core-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>fs.defaultFS< /name > <value>hdfs: //hddcluster2 :9000< /value > < /property > <property> <name>hadoop.tmp. dir < /name > <value> file : /usr/local/hadoop/tmp < /value > <description>Abase for othertemporarydirectories.< /description > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ cat hdfs-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>dfs.namenode.secondary.http-address< /name > <value>hddcluster2:50090< /value > < /property > <property> <name>dfs.replication< /name > <value>3< /value > < /property > <property> <name>dfs.namenode.name. dir < /name > <value> file : /usr/local/hadoop/tmp/dfs/name < /value > < /property > <property> <name>dfs.datanode.data. dir < /name > <value> file : /usr/local/hadoop/tmp/dfs/data < /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat mapred-site.xml <?xmlversion= "1.0" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>mapreduce.framework.name< /name > <value>yarn< /value > < /property > <property> <name>mapreduce.jobhistory.address< /name > <value>hddcluster2:10020< /value > < /property > <property> <name>mapreduce.jobhistory.webapp.address< /name > <value>hddcluster2:19888< /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat yarn-site.xml <?xmlversion= "1.0" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <configuration> <!--SitespecificYARNconfigurationproperties--> <property> <name>yarn.resourcemanager. hostname < /name > <value>hddcluster2< /value > < /property > <property> <name>yarn.nodemanager.aux-services< /name > <value>mapreduce_shuffle< /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat slaves hddcluster1 hddcluster2 hddcluster3 hddcluster4 1 2 3 4 5 6 7 8 $ cd /usr/local $ sudo rm -r. /hadoop/tmp #删除Hadoop临时文件 $ sudo rm -r. /hadoop/logs/ * #删除日志文件 $ tar -zcf~ /hadoop .master. tar .gz. /hadoop #先压缩再复制 $ cd ~ $ scp . /hadoop .master. tar .gzhddcluster1: /home/hadoop $ scp . /hadoop .master. tar .gzhddcluster3: /home/hadoop $ scp . /hadoop .master. tar .gzhddcluster4: /home/hadoop 1 2 3 4 在salve节点上操作,安装软件环境并配置好.bashrc sudo tar -zxf~ /hadoop .master. tar .gz-C /usr/local sudo chown -Rhadoop /usr/local/hadoop 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [hadoop@hddcluster2~]$hdfsnamenode- format #首次运行需要执行初始化,之后不需要 接着可以启动hadoop了,启动需要在Master节点上进行启动命令: $start-dfs.sh $start-yarn.sh $mr-jobhistory-daemon.shstarthistoryserver 通过命令jps可以查看各个节点所启动的进程。正确的话, 在Master节点上可以看到NameNode、ResourceManager、SecondrryNameNode、JobHistoryServer进程, 另外还需要在Master节点上通过命令hdfsdfsadmin-report查看DataNode是否正常启动,如果Livedatanodes不为0,则说明集群启动成功。 [hadoop@hddcluster2~]$hdfsdfsadmin-report ConfiguredCapacity:2125104381952(1.93TB) PresentCapacity:1975826509824(1.80TB) DFSRemaining:1975824982016(1.80TB) DFSUsed:1527808(1.46MB) DFSUsed%:0.00% Underreplicatedblocks:0 Blockswithcorruptreplicas:0 Missingblocks:0 Missingblocks(withreplicationfactor1):0 ------------------------------------------------- Livedatanodes(4): 也可以通过Web页面看到查看DataNode和NameNode的状态:http: //hddcluster2 :50070/。如果不成功,可以通过启动日志排查原因。 1 在Slave节点操作可以看到DataNode和NodeManager进程 1 2 3 4 5 6 7 8 9 10 测试hadoop分布式实例 首先创建HDFS上的用户目录: hdfsdfs- mkdir -p /user/hadoop 将 /usr/local/hadoop/etc/hadoop 中的配置文件作为输入文件复制到分布式文件系统中: hdfsdfs- mkdir input hdfsdfs-put /usr/local/hadoop/etc/hadoop/ *.xmlinput 通过查看的DataNode的状态(占用大小有改变),输入文件确实复制到了DataNode中。 接着就可以运行MapReduce作业了: hadoopjar /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples- *.jar grep inputoutput 'dfs[a-z.]+' 等待执行完毕后的输出结果: 1 2 3 4 5 6 7 8 hadoop启动命令: start-dfs.sh start-yarn.sh mr-jobhistory-daemon.shstarthistoryserver hadoop关闭命令: stop-dfs.sh stop-yarn.sh mr-jobhistory-daemon.shstophistoryserver PS:如果集群有一两台无法启动的话,先尝试一下删除hadoop临时文件 cd /usr/local sudo rm -r ./hadoop/tmp sudo rm -r ./hadoop/logs/* 然后执行 hdfs namenode -format 再启动 本文参考了一下网站并实验成功: http://www.powerxing.com/install-hadoop-cluster/ 本文转自 yanconggod 51CTO博客,原文链接: http://blog.51cto.com/yanconggod/1884998

优秀的个人博客,低调大师

hadoop&amp;spark安装(下)

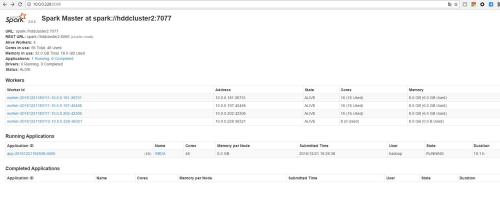
上一遍文章中其实最主要的就是JAVA环境变量以及hadoop环境变量的设置,这两个设置好了的话,运行hadoop基本上不会出问题。 在hadoop的基础上安装spark好简单。 安装Spark之前需要先安装Hadoop集群,因为之前已经安装了hadoop,所以我直接在之前的hadoop集群上安装spark。 硬件环境: hddcluster1 10.0.0.197 redhat7 hddcluster2 10.0.0.228 centos7 这台作为master hddcluster3 10.0.0.202 redhat7 hddcluster4 10.0.0.181 centos7 软件环境: scala-2.11.7 spark-2.0.2-bin-hadoop2.7.tgz #所有操作用hadoop 基本流程: 1、master解压scala-2.11.7和spark-2.0.2-bin-hadoop2.7.tgz到相应的目录 2、配置scala和spark环境变量 3、修改配置文件 4、拷贝scala和spark到各个节点,授权 5、启动spark集群 1 2 3 4 5 6 7 8 9 10 11 #hadoop用户下操作,下载scala,安装 wgethttp: //downloads .lightbend.com /scala/2 .11.7 /scala-2 .11.7.tgz tar -zxvfscala-2.11.7.tgz mv scala-2.11.7 /usr/local/scala sudo mv scala-2.11.7 /usr/local/scala vim.bashrc #添加 export SCALA_HOME= /usr/local/scala export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin source .bashrc [hadoop@hddcluster2~]$scala-version Scalacoderunnerversion2.11.7--Copyright2002-2013,LAMP /EPFL 1 2 3 4 5 6 7 #在官网下载spark-2.0.2-bin-hadoop2.7.tgz tar -zxvfspark-2.0.2-bin-hadoop2.7.tgz mv spark-2.0.2-bin-hadoop2.7spark sudo mv spark /usr/local/ vim.bashrc #添加 export SPARK_HOME= /usr/local/spark export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin :$SPARK_HOME 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 #修改spark配置文件 cd /usr/local/spark/conf cp spark- env .sh.templatespark- env .sh vi spark- env .sh #添加下面内容 ###jdkdir export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 ###scaladir export SCALA_HOME= /usr/local/scala ###theipofmasternodeofspark export SPARK_MASTER_IP=10.0.0.228 ###themaxmemorysizeofworker export SPARK_WORKER_MEMORY=8G ###hadoopconfigurationfiledir export HADOOP_CONF_DIR= /usr/local/hadoop/etc/hadoop/ #修改slave cp slaves.templateslaves vi slaves #把localhost改为下面内容 hddcluster1 hddcluster2 hddcluster3 hddcluster4 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 #把/usr/local/spark和/usr/local/scala打包,然后复制到slave节点、 cd /usr/local tar -zcf~ /master .spark. tar .gz. /spark tar -zcf~ /master .scala. tar .gz. /scala scp master.spark. tar .gzhddcluster1:~ scp master.scala. tar .gzhddcluster1:~ #登录各个节点进行解压到/usr/local tar -zxfmaster.spark. tar .gz-C /usr/local/ tar -zxfmaster.scala. tar .gz-C /usr/local/ chown -Rhadoop:hadoop /usr/local/spark chown -Rhadoop:hadoop /usr/local/scala 再配置.bashrc环境变量和master的一样。 加上hadoop上一篇的.bashrc内容是这样子: #scala export SCALA_HOME= /usr/local/scala #spark export SPARK_HOME= /usr/local/spark #javaandhadoop export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 export HADOOP_HOME= /usr/local/hadoop export HADOOP_INSTALL=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export YARN_HOME=$HADOOP_HOME export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME /lib/native export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin :$SPARK_HOME export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_OPTS= "-Djava.library.path=$HADOOP_PREFIX/lib:$HADOOP_PREFIX/lib/native" 到此Spark集群搭建完毕 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 .启动Spark集群: 启动Spark之前需要先将hadoop的dfs以及yarn启动。 /usr/local/spark/sbin/start-all .sh 启动所有服务之后,在命令行输入jps: [hadoop@hddcluster2~]$jps 29601ResourceManager 32098SparkSubmit 29188DataNode 29364SecondaryNameNode 29062NameNode 29915NodeManager 30251Master 30380Worker 30062JobHistoryServer 18767Jps 比hadoop集群启动时多了Master和worker /usr/local/spark/bin/spark-shell .sh 出现scala>时说明成功。 在浏览器中输入10.0.0.228:8080时,会看到如下图,有4个Worker 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1885082

优秀的个人博客,低调大师

K8S的名称空间创建&amp;&amp;版本的升级、回滚操作

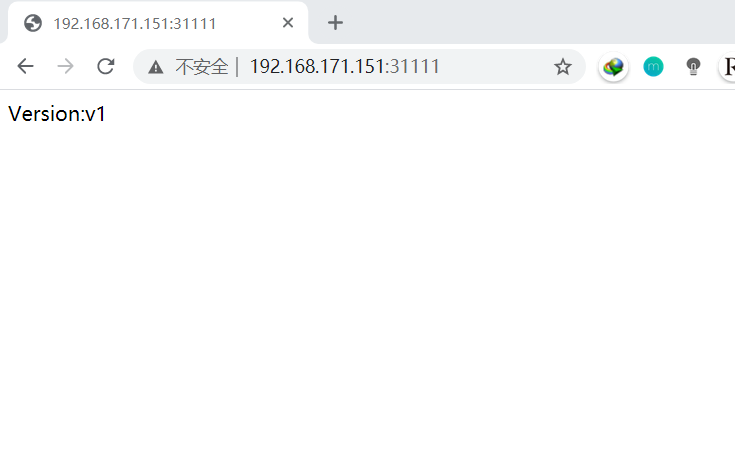
1、创建私有仓库 [root@docker-k8s01 ~]# docker run -itd --name registry -p 5000:5000 --restart always registry:latest #在所有需要使用私有仓库的docker主机上添加如下配置 [root@docker-k8s01 ~]# vim /usr/lib/systemd/system/docker.service ExecStart=/usr/bin/dockerd -H unix:// --insecure-registry 192.168.171.151:5000 #修改完文件后重启使之生效 [root@docker-k8s01 ~]# systemctl daemon-reload [root@docker-k8s01 ~]# systemctl restart docker 2、在master节点,自定义一个镜像,基于nginx镜像,默认界面内容改为:Version:v1,版本2内容为:Version:v2.版本3内容为:Version:v3 #编写dockerfile文件 [root@docker-k8s01 ~]# vim Dockerfile FROM nginx ADD index.html /usr/share/nginx/html #编辑v1版本的首页内容 [root@docker-k8s01 ~]# echo "Version:v1" > index.html #制作v1版本的镜像 [root@docker-k8s01 ~]# docker build -t 192.168.171.151:5000/zyz:v1 . #制作v2版本的镜像 [root@docker-k8s01 ~]# echo "Version:v2" > index.html [root@docker-k8s01 ~]# docker build -t 192.168.171.151:5000/zyz:v2 . #制作v3版本的镜像 [root@docker-k8s01 ~]# echo "Version:v3" > index.html [root@docker-k8s01 ~]# docker build -t 192.168.171.151:5000/zyz:v3 . #将制作好的三个版本的镜像上传至私有仓库 [root@docker-k8s01 ~]# docker push 192.168.171.151:5000/zyz:v1 [root@docker-k8s01 ~]# docker push 192.168.171.151:5000/zyz:v2 [root@docker-k8s01 ~]# docker push 192.168.171.151:5000/zyz:v3 创建一个Namespace.接下来的所有操作都在此名称空间之下 [root@docker-k8s01 ~]# mkdir test [root@docker-k8s01 ~]# cd test/ [root@docker-k8s01 test]# vim ns.yaml apiVersion: v1 kind: Namespace metadata: name: zyz [root@docker-k8s01 test]# kubectl apply -f ns.yaml # 运行yaml文件 namespace/zyz created [root@docker-k8s01 test]# kubectl get ns zyz # 查看创建的namespace NAME STATUS AGE zyz Active 30s 创建一个Deployment资源对象,镜像版本为v1 [root@docker-k8s01 test]# vim zyz.yaml apiVersion: extensions/v1beta1 kind: Deployment metadata: name: zyz namespace: zyz spec: revisionHistoryLimit: 5 # 规定记录多少个版本,这个字段通过 kubectl explain deploy.spec 命令找到revisionHistoryLimit <integer>行获得 replicas: 2 template: metadata: labels: name: zyz spec: containers: - name: zyz image: 192.168.171.151:5000/zyz:v1 # 镜像版本为1 ports: - containerPort: 80 #执行该yaml文件, --record表示记录版本历史 [root@docker-k8s01 test]# kubectl apply -f zyz.yaml --record [root@docker-k8s01 test]# kubectl get pod # 查看上面yaml文件运行的pod No resources found. #可以得出结论,如果在编写yaml文件时,指定了归属于哪个namespace, #那么执行上面的命令是查看不到运行的pod的,而不是没有运行的pod [root@docker-k8s01 test]# kubectl get pod -n zyz # 增加“-n”选项,指定名称空间,即可看对应的pod NAME READY STATUS RESTARTS AGE zyz-5d7cb64655-9pdcj 1/1 Running 0 98s zyz-5d7cb64655-zzqcv 1/1 Running 0 98s #查看zyz的namespace名称空间的名为zyz的deployment资源对象 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz deployment.extensions/zyz REVISION CHANGE-CAUSE 1 kubectl apply --filename=zyz.yaml --record=true #可以看到当前只有一个版本,也可以看到filename(文件名称) 创建一个Service资源对象,关联到上面的Deployment资源对象 [root@docker-k8s01 test]# vim zyz-svc.yaml apiVersion: v1 kind: Service metadata: name: zyz-service namespace: zyz spec: type: NodePort selector: name: zyz ports: - name: zyz-port port: 8080 # service的IP接口 targetPort: 80 # pod的端口 nodePort: 31111 # 映射到宿主机的端口 [root@docker-k8s01 test]# kubectl apply -f zyz-svc.yaml [root@docker-k8s01 test]# kubectl get svc # 若不指定名称空间,是查不到对应的service的 NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 9d [root@docker-k8s01 test]# kubectl get svc -n zyz # 使用“-n”选项查看指定的名称空间中的service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE zyz-service NodePort 10.100.89.145 <none> 8080:31111/TCP 55s 注意:创建的service资源对象必须和创建的deployment资源对象在同一个namespace中,否则无法进行关联!!! 客户端访问k8s群集中的任意一个节点的31111端口访问其pod提供的服务如果需要在线修改pod提供的网页文件,可以先查看到pod的name,然后直接在主节点上登录到此pod即可,命令如下 [root@docker-k8s01 httpd-web]# kubectl get pod -o wide #查看pod的name NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES httpd-devploy1-6f987c9764-5g92w 1/1 Running 0 8m35s 10.244.1.5 node01 <none> <none> httpd-devploy1-6f987c9764-wvgft 1/1 Running 0 [root@docker-k8s01 httpd-web]# kubectl exec -it httpd-devploy1-6f987c9764-5g92w /bin/bash #通过指定pod的name,进入pod 现在由1版本,滚动更新至2版本、再到3版本,最后回滚到指定1版本内容 [root@docker-k8s01 test]# sed -i 's/zyz:v1/zyz:v2/' zyz.yaml # 更新为版本2 [root@docker-k8s01 test]# kubectl apply -f zyz.yaml # 执行 deployment.extensions/zyz configured # 配置成功 #访问验证 [root@docker-k8s01 test]# curl 192.168.171.151:31111 Version:v2 #查看历史版本 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz deployment.extensions/zyz REVISION CHANGE-CAUSE 1 kubectl apply --filename=zyz.yaml --record=true 2 <none> #现在是有两个历史版本了 #接下来再次升级并验证 [root@docker-k8s01 test]# sed -i 's/zyz:v2/zyz:v3/' zyz.yaml [root@docker-k8s01 test]# kubectl apply -f zyz.yaml deployment.extensions/zyz configured #再次访问可以看到现在是版本3了 [root@docker-k8s01 test]# curl 192.168.171.151:31111 Version:v3 #查看历史版本信息 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz deployment.extensions/zyz REVISION CHANGE-CAUSE 1 kubectl apply --filename=zyz.yaml --record=true 2 <none> 3 <none> #接下来执行回滚操作 #回滚到版本1,需要指定namespace,“--to-revision”是指定回滚到哪个版本 [root@docker-k8s01 test]# kubectl rollout undo deployment -n zyz zyz --to-revision=1 deployment.extensions/zyz rolled back [root@docker-k8s01 test]# curl 192.168.171.151:31111 Version:v1 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz #再次查看历史记录,发现版本1变成了版本4,之前的1已经没有了 deployment.extensions/zyz REVISION CHANGE-CAUSE 2 <none> 3 <none> 4 kubectl apply --filename=zyz.yaml --record=true

优秀的个人博客,低调大师

Java并发编程笔记1-竞争条件&amp;初识原子类&amp;可重入锁

我们知道,在多线程访问一个共享变量的时候会发生安全问题。 首先看下面例子: public class Counter { private int count; public void add(){ try{ for (int i = 0;i<200;i++){ Thread.sleep(100); this.count++; System.out.println(this.count); } }catch (Exception e ){ e.printStackTrace(); } } } public class Test { public static void main(String[] args) { final Counter counter = new Counter(); new Thread(new Runnable() { public void run() { counter.add(); } }).start(); new Thread(new Runnable() { public void run() { counter.add(); } }).start(); new Thread(new Runnable() { public void run() { counter.add(); } }).start(); } } 运行结果如下: 如果没发生线程对数据的赃操作,3个线程执行,结果会累加到600的,看上面结果明显没有,并且出现一下重复的数据。这是因为存在3个线程同时操作同一个数字,导致输出重复数字。 解决办法: 1.在方法上加上synchronized关键字。如下图: 虽然结果不会出现重复,但是synchronized效率及其低下,运行速度明显被拖慢。原因是,for循环中的i变量是每个线程都有独自的局部变量,各不影响,但是每个线程都要排队进入这个方法,排队睡觉,这样就导致效率低下 2.在竞争条件上加synchronized,我们知道各个线程其实竞争的是count这个成员变量。因此在此地方加即可。如下图: 这样运行效率比方法一快了很多,因为省去了排队进入方法,排队睡觉。只需要排队取count值即可,这样效率比方法一快。 注意上图中,输出语句并不是竞争条件,并不一定要放在synchroized里面,这里放在里面是为了让线程取到值自增后立即输出,这样输出就不会发生混论,不发生抢占输出问题,一样能累加到600, 如果把输出放在synchronized外面会出现值有重复现象,因为累加后的值并没有立即输出,这样导致输出混乱,但仍然能加到600.知识输出不安全罢了。 3.使用原子类型,比如将上面的代码的int count类型改成AtomicInteger count类型,我们知道获取count的值然后再自加个1是可能会出现问题的,也就是结果出现重复数字。AtomicInteger类型是以同步的方法解决这个问题的。如下图: 结果如下图: 可以看到数字的输出没有严格的排队,但是数据确实给你保证的了,就是完整的加到600.这也恰恰因为不是严格的进行排队,才是的这种方法比前面两种方法的效率大大改进。 理论总结:synchronized是一种内部锁,就是所对象内部给我们提供的,因为每一个对象有一个状态变量,相当于一个锁,进入同步块,改变这个变量。别的线程进入之后就要判断这个变量有没有改变。 一个线程获取它本生已经持有的锁,这是可以成功的。我们知道多个线程同时抢占同一个锁它们是失败的。因为它们之间是互斥的。但是呢,一个线程再次获取一个自己已经拿过的锁是可以成功的,那么它是能够成功的。 看如下例子: public class Widget { public synchronized void doSth(){ } } public class ChildWidget extends Widget { @Override public synchronized void doSth() { super.doSth(); } } public class Test { public static void main(String[] args) { Widget w = new ChildWidget(); w.doSth(); } } 子类调用自己的方法的那个synchroized那个锁是w对象的这个锁,而在子类方法中的super.doSth()父类中的方法的synchronized的锁也是w对象的锁。因此不要被子类继承父类的方法中的锁所迷惑了。 因此这种方式叫做内部锁的可重入机制,也叫可重入锁。

优秀的个人博客,低调大师

如何提升mysql replication的性能&amp;&amp;多线程传输二进制日志

如何提升replication的性能: 延迟 : 对于mysql replication来说,在没有发生故障的情况下,出现master与slave数据不同步,延迟分为以下两种情况: 经常性延迟 : 异步同步的数据差距比较大 ,周期性的,循环。 暂时性延迟 : 突发情况,导致延迟 其主要原因就是: 网络带宽 I/O 如何减少replication延迟?? 1,最好使用内网或者专线链路传输binlog数据 (千兆网卡、还不够的话,bounding 技术,扩展带宽) 在my.cnf中强制使用内网ip传输数据bind-address=ip 2,将二进制保存在独立的存储介质上(提升I/O) 3,买多核CPU,使用多线程方式传输二进制日志 () 4,如果二进制日志不是row格式,则尽可能不要再insert 或者update的时候使用select ,statement模式会给master传输二进制时候造成大的压力 5,想尽办法减少master的写I/O(memcached)(既要写自己的二进制日志,也要负责读自己的二进制日志写给slave服务器),master上的I.O越低,越能快的将binlog传输给slave、 加memcached 缓存层,数据库上次做个缓冲池放到内存中,由memcached管理,周期性的将数据同步给数据库,把大并发的写操作,合并成小量的写操作。以此减少master写I/O 架构设计1: 主从服务器可以使用不同的存储引擎,master上使用innodb,利用事务,行锁等高级锁特性,slave上使用MYISAM,读性能更好,节省内存,容易备份。还可以使用不同的数据类型,例如 master上用varchar,slave上用char。不仅节省空间,还可以使用myisam的静态表特性。 M-S--Muti SLAVE方案中,中继slave还可以使用blackhole存储引擎,blackhole存储引擎值记录日志,不写数据,此特性可以让中继日志性能提升很多,但是,这种方案不支持GTIDs模式下的 replication,因为blackhole只能搭配statement格式的二进制日志使用,row和mixed格式都不支持。 在读写分离中,主存服务器采用不同索引采用不同方案,master可以只保留主键或者唯一索引等保证数据关系的索引,而slave针对查询做索引优化、 架构设计2: 让更新频繁,且需要实时的数据查询放到master上,再通过持久化session,让发生修改的用户先看到结果,其他人等待同步完后同步replication, 如果开发做不到,用下面的memcached,在数据之前加上memcached 让用户对数据库的更改先保存到memcached中,memcached是一种内存中的存储引擎(独立第三方技术),由于内存的读写性能很高 ,可以把读写特别频繁的更新数据保存到这里,每隔5分钟 ,再把数据同步到master,对于另一个客户端来说,让他优先到master找数据,即在master上的memcached中读数据,在读slave。这样可以优先将更改的数据由内存返回给用户,这样降低了 降低硬盘IO,对于那些已经同步后数据把他分离到slave,这样master就可以转们做有关于的数据更新的写操作,完全分离了master的读。 动态缓存是讲用户请求比较频繁的动态数据缓存到memcached中,使得后续的访问用户可以直接从memcached中取数据 replication容量: 是指:replication延迟程度、 将replication暂停一段时间(M),再重新开启,并观察slave多久可以达到于master一致(N) replication容量=N:M 建议保持容量在3倍以上,即1:3 (1小时的M,20分钟的N) 多线程传输二进制日志: mysql5.6开始支持多线程方式传输二进制日志 只能工作在GTIDs 模式下 只有对不同的库执行的操作才能采用多线程传输。同一个库不同表的操作只能单独用单进程传输。 my.cnf [mysqld] slave-parallel-workers=N 默认是0 表示不开启 线程数 N 根据CPU的核数来决定,几核就写几,和数据库的数量一一对应,几个库就是几个线程来传输二进制日志 ,qps上万的话,多线程传输会有很明显的性能提升 本文转自crazy_charles 51CTO博客,原文链接:http://blog.51cto.com/douya/1606236,如需转载请自行联系原作者

优秀的个人博客,低调大师

阿里云服务器 &amp;&amp; 如何window链接到阿里云服务器

现在的时间是:2016年10月11日 1:购买学生机 阿里云手机app上 -> 学生专区 -> 购买: 需要注意的是:如果没有自己需要的系统,比如没有linux操作系统的ecs,那么先随便选择一个,买以后再到pc端的官网了改操作系统 如果买的时候没有付款,第二次再买的时候价钱就会变成40.8元,这是需要在pc端官网里 费用中心 -> 订单管理 里支付第一笔订单就可以了 2: 链接阿里云服务器 ssh工具链接:xShell5、SecureCRT、MobaXterm

优秀的个人博客,低调大师

华为手机升级HarmonyOS完全攻略:消费者公测&amp;内测&amp;线下升级

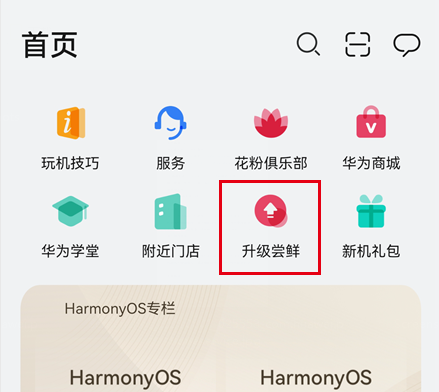
写在前面:本文旨在帮助社区各位小伙伴选择合适的渠道尽早升级HarmonyOS系统,深夜撸稿,还望三连支持一哈!! 目前正在进行的升级活动:消费者公测、消费者内测、HarmonyOS体验官(线下) 必要说明: 所有消费者公测渠道最终都会跳转到花粉俱乐部; 初期申请量巨大,花粉俱乐部很容易就挂掉,心急的小伙伴可尝试线下渠道或者多次尝试或者深夜(两点以后)申请; 申请前务必将“花粉俱乐部”、“我的华为”、“会员中心”升级到最新版本,尤其是“花粉俱乐部”。 ——消费者公测—— 包含机型: Mate X2 Mate40、Mate40E、Mate 40 Pro、Mate 40 Pro+、Mate 40 RS 保时捷设计 P40 5G、P40 4G、P40 Pro、P40 Pro+ Mate 30 4G、Mate 30 Pro 4G、Mate 30 5G、Mate 30 Pro 5G、Mate 30 RS保时捷设计、Mate 30E Pro 5G MatePad Pro、MatePad Pro 5G 我的华为/花粉俱乐部:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.打开“我的华为”,点击“升级尝鲜” / 打开“花粉俱乐部”,点击“公测尝鲜”。 △我的华为 △花粉俱乐部 2.页面加载完成后,点击“公测尝鲜”下的“立即尝鲜”按钮。(花粉俱乐部进入的请忽略此步骤,直接进入下步) 3.接下来在列表中找到当前手机型号对应的公测活动,点击“报名公测”。由于不同手机对应的系统版本不一样,请务必仔细核实你的机器型号。 4.此处会跳转到“花粉论坛”的一篇帖子,划到这篇帖子的末尾,点击“参加公测活动”。接下来系统会引导用户签订《华为公测协议》和《华为公测与隐私声明》,等待10秒点击通过。 5.通过两个协议后,系统会引导你下载协议文件。这个过程会验证你的机型是否符合要求,且下载的文件也是将来升级为正式版的必要文件,如果找到(反正我是没找到)请勿删除!! 6.下载并提示安装完描述文件后,就可以去检测系统更新,下载并更新HarmonyOS了。(P40系列当前版本116) ——消费者内测—— 包含机型: Mate XS、Mate 20、Mate 20 Pro、Mate 20 RS(保时捷)、Mate 20 X(4G) nova 8、nova 8 Pro、nova 8 SE、nova 7 5G、nova 7 Pro 5G、nova 7 SE 5G、nova 7 SE 5G活力版、nova 7 SE 5G乐活版、nova 6、nova 6 5G、nova 6 SE 华为畅享20 Plus 5G、华为畅享Z 5G、华为畅享20 Pro5G 华为麦芒9 5G MatePad 10.8、MatePad 5G 10.4、MatePad 10.4 内测时间:6月2日~6月9日上午10:00 渠道一 会员中心:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.打开会员中心,首页上找到“体验先锋”,点击进入。 2.点击顶部的HarmonyOS 2升级尝鲜。 3.进入页面点击报名。如果机型不符合,会弹出提示框。 4.接下来根据流程提示,填写信息,等待审核,坐等更新就好了。 渠道二 花粉俱乐部:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.进入首页点击内测报名 2.跳转后,点击立即报名 3.接下来根据流程提示,填写信息,等待审核,坐等更新就好了。 ——HarmonyOS体验官(线下)—— 包含机型: 我的华为:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 在APP首页点击“HarmonyOS体验官”海报,经过简单的互动问答即可参加。期间需要提交信息、预约门店时间和信息,最终会生成一张包含数字的海报,用户需要保存此海报才可参与活动。 活动仅在部分门店进行,具体店面和城市请在活动页面查询。到店会提供礼品,并可在线下由店面工作人员协助完成升级。 ——重要的补充说明—— 1.消费者公测仅审核设备型号是否合规,避免出现系统和硬件不适配的情况。 2.消费者内测仍然会存在审核机制,但仅审核设备型号是否合规,避免出现系统和硬件不适配的情况。 3.最终稳定的系统版本号预计为:HarmonyOS 2.0.0.116(以实际推送版本号为准!) 4.老荣耀系列机型不在本次消费者公测列表中。 想了解更多关于鸿蒙的内容,请访问: 51CTO和华为官方战略合作共建的鸿蒙技术社区 https://harmonyos.51cto.com/#bkwz

优秀的个人博客,低调大师

SpringBoot 手写过滤器&amp;amp;加载第三方过滤器

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_36367789/article/details/81665638 如何手写一个过滤器呢。假设我现在需要一个计时过滤器,我想把每一次调用服务锁花费的时间打印到控制台,我该怎么做呢? 拦截机制有三种: 1. 过滤器(Filter)能拿到http请求,但是拿不到处理请求方法的信息。 2. 拦截器(Interceptor)既能拿到http请求信息,也能拿到处理请求方法的信息,但是拿不到方法的参数信息。 3. 切片(Aspect)能拿到方法的参数信息,但是拿不到http请求信息。 他们三个各有优缺点,需要根据自己的业务需求来选择最适合的拦截机制。 好了下面开始正文。 本教程大概目录: 1. 手写过滤器 2. 加载第三方过滤器 好了,开始正文。 1. 手写过滤器 特别容易,继承Filter ,然后根据需求重写它的三个方法。 /** * TimeFilter 计时过滤器 * Created by Fant.J. */ @Component public class TimeFilter implements Filter { @Override public void init(FilterConfig filterConfig) throws ServletException { System.out.println("time filter init"); } @Override public void doFilter(ServletRequest servletRequest, ServletResponse servletResponse, FilterChain filterChain) throws IOException, ServletException { System.out.println("time filter start"); long start = new Date().getTime(); filterChain.doFilter(servletRequest,servletResponse); System.out.println("耗时:"+(new Date().getTime() - start)); System.out.println("time filter finish"); } @Override public void destroy() { System.out.println("time filter destroy"); } } 其中 init方法是初始化方法,最先执行。 然后执行doFilter方法,熟悉servlet的应该都知道,它其实就是调用业务。 最后destroy方法,是最后执行的。 然后我们启动服务,随便调用一个controller,控制台打印如下: 2. 加载第三方过滤器 一般在开发的时候,我们可能用到第三方的过滤器,我们不可能在其源码上添加@Component注解。所以我们必须写一个配置类来引入它。 下面我们把上面的例子当作第三方过滤器,把TimeFilter类上面的@Component注解去掉。做一个模拟练习。 /** * 引入第三方过滤器 将其放入spring容器 * Created by Fant.J. */ @Configuration public class WebConfig { @Bean public FilterRegistrationBean timeFilter(){ //创建 过滤器注册bean FilterRegistrationBean registrationBean = new FilterRegistrationBean(); TimeFilter timeFilter = new TimeFilter(); registrationBean.setFilter(timeFilter); List urls = new ArrayList(); urls.add("/*"); //给所有请求加过滤器 //设置 有效url registrationBean.setUrlPatterns(urls); return registrationBean; } } 注意一定要去掉TimeFilter类上面的@Component注解,否则过滤器会失效。 介绍下我的所有文集: 流行框架 SpringCloud springboot nginx redis 底层实现原理: Java NIO教程 Java reflection 反射详解 Java并发学习笔录 Java Servlet教程 jdbc组件详解 Java NIO教程 Java语言/版本 研究

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册