首页 文章 精选 留言 我的

精选列表

搜索[前端工程化],共10003篇文章
优秀的个人博客,低调大师

经验值的工程化,实现机械臂末端柔顺

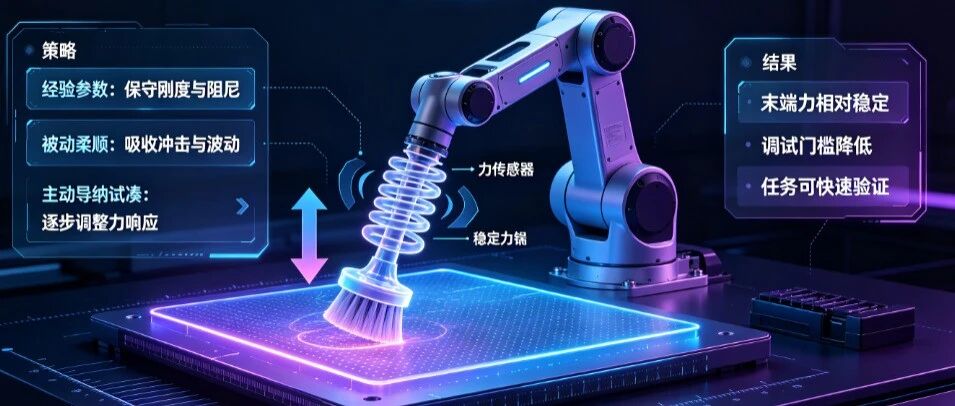
如果只关心末端力相对稳定,就可以大幅简化,甚至**绕过复杂标定**,采用“经验参数 + 被动柔顺 + 主动导纳试凑”的策略。 ![](https://developer.qcloudimg.com/http-save/yehe-2423478/fb544454a7e01feaf4bd8135c56608ec.png) ### 核心理念 - 利用 MIT 模式的**被动柔顺**:即使力控不太准,高阻尼和高刚度也能让接触力波动被机械柔顺吸收一部分。 - 力传感器只做最简单的处理:去零漂 + 低通滤波,不做重力/惯性补偿。 - 导纳参数靠**手调试凑**,不追求理论最优。 - 期望力可以是一个粗略范围,比如刚刚好接触、刷毛压缩量适中。 ### 极简实施步骤 #### 第 1 步:硬件与通信就绪 - 所有关节确认为 MIT 模式,CAN 周期 2ms,能收目标位置和 Kp,Kd,τ_ff。 - 六维力传感器能稳定读到数据(不要求补偿)。 - 机械臂末端装好清洁模组。 #### 第 2 步:设置统一的保守 MIT 参数(不单独整定) 为了避免逐关节调参,采用**统一的保守值**: - **Kp**:取一个中等值,确保机械臂能撑起自重且不抖动。经验值可以是 50~100 Nm/rad(取决于电机大小),可以先从小试起。 - **Kd**:取 Kp 的 0.02~0.05 倍,或者直接设一个较小固定值如 5~10 Nm/(rad/s)。 - **τ_ff**:暂时全设 0。 验证:发送一个缓慢的关节正弦摆动,观察是否抖动,若抖动,降低 Kp;若响应太慢,适当增加 Kp,最后取一个不抖的值固化给所有关节。 #### 第 3 步:力传感器处理 1. **零漂去除**:清洁模组悬空,记录 1 秒平均值作为偏置,之后每周期减去它。 1. **低通滤波**:对力信号做一个简单的移动平均或一阶低通(截止频率 20Hz),滤除高频噪声。 **不做重力补偿**:这会导致传感器读数包含了清洁模组的自重,没关系,我们后面通过试凑的期望力来包含这个重量。 #### 第 4 步:导纳参数经验取法与试凑 导纳公式只用最简单的一阶形式(忽略加速度项),然后积分得到位置修正量,只整定一个参数 **D**(阻尼),M 忽略或取 0。 ![](https://developer.qcloudimg.com/http-save/yehe-2423478/ff020481ad50cb596330cb854c76d6d8.png) - **期望力 F_des 的确定**:通过手动拖动或试贴,找到认为刚好贴紧但不过压的力传感器读数(注意此时传感器包含工具重量,所以 F_des 可能是 5N~10N 之类的值,包含了清洁模组的重力偏置)。记录下这个值作为期望力。 - **阻尼 D 的调试**:从很大的 D 开始(例如 500),此时力控很粘稠。执行贴合,观察力传感器读数,如果力波动大,说明太软,可减小 D;如果力响应极慢,可减小 D,慢慢找到一个力波动在可接受范围的 D 值。 #### 第 5 步:贴合运动(极简状态机) 1. **快速趋近**:用纯位置模式(MIT 高 Kp,Kd),让刷头移动到大致位置(预先示教或手拖记录几个关键点)。 1. **降速逼近**:以低速度(如 10mm/s)向釉面移动,同时开启导纳控制器(期望力设为上面获得的 F_des)。此时,一旦接触,导纳会自动将工具回退以维持力。 1. **恒力清洁**:保持导纳开启,沿着规划好的简单轨迹(比如来回直线或螺旋)移动,切向速度保持恒定。 1. **退出**:清洁完成,撤去期望力,让导纳自动脱开,然后快速退回。 #### 第 6 步:MIT 被动柔顺 在上述步骤中,即使导纳参数不太理想,MIT 模式的高 Kd 也会提供一定的阻尼,防止振荡。如果接触力突然增大,关节自身的弹性也会有一定退让,起到被动保护作用。 ![](https://developer.qcloudimg.com/http-save/yehe-2423478/02a645364445520b2ec37bef92100448.png) ### 核心原理 - 釉面不是高精度力控任务,更类似保持接触、轻微压力的场景,力波动几牛顿都不会影响清洁效果。 - 通过**直接试凑期望力**,避免了复杂的传感器补偿,把工具重量当成力控目标的一部分。 - MIT 模式的被动柔顺特性降低了主动力控的调试难度。 - 整套流程不需要任何标定实验,所有参数均可在线手调。 ### 效果评估标准 - 贴合过程中,力传感器读数波动在 ±2N 以内。 - 清洁头无明显弹跳或脱离釉面的现象。 - 清洁后釉面无划伤。 **优先采用极简方法**,快速实现恒力贴合。当未来需要更精确力控或更高效率时,再逐步引入补偿和标定。这个分步走的策略,最符合软件工程领域的敏捷实践——先跑通闭环,再优化性能。

优秀的个人博客,低调大师

云原生 AI 工程化实践之 FasterTransformer 加速 LLM 推理

01 背景 OpenAI 在 3 月 15 日发布了备受瞩目的 GPT4,它在司法考试和程序编程领域的惊人表现让大家对大语言模型的热情达到了顶点。人们纷纷议论我们是否已经跨入通用人工智能的时代。与此同时,基于大语言模型的应用也如雨后春笋般出现,为我们带来了协同办公、客服对话、语言翻译、内容生成等方面前所未有的畅快体验。 然而,当我们享受着大语言模型带来的普惠 AI 能力时,它也给开发者们带来了前所未有的挑战。随着模型不断增大,计算量也达到了空前的高度,直接导致推理时间变长。为了解决大语言模型推理的延迟问题,业界已经提供了一些解决方案,比如 Tensorrt、FasterTransformer 和 vllm。为了帮助用户解决云原生系统中的大语言模型推理加速问题,云原生 AI 套件引入了 FasterTransformer 推理加速方案。 本文将在 ACK 容器服务上,以 Bloom7B1 模型为例展示如何使用 FasterTransformer 进行推理加速。本例中会使用以下组件: Arena Arena 是基于 Kubernetes 的机器学习轻量级解决方案,支持数据准备、模型开发,模型训练、模型预测的完整生命周期,提升数据科学家工作效率。同时和阿里云的基础云服务深度集成,支持 GPU 共享、CPFS 等服务,可以运行阿里云优化的深度学习框架,最大化使用阿里云异构设备的性能和成本的效益。更多 arena 信息,可以参考云原生 AI 套件开发者使用指南[1]。 Triton Server Triton Server为Nvidia 提供了机器学习推理引擎,可以支持 Tensorflow、Pytorch、Tensorrt 和 Fastertransformer 多种 backend。云原生 AI 套件已经将 Triton Server 加入到 Arena 中,用户可以通过简单的命令行或 SDK 来在云原生系统中完成 Triton Server 服务的拉起、运维和监控。更多 AI 套件中使用 Triton Server 信息,可以参考部署 PyTorch 模型推理服务[2]。 FasterTransformer FasterTransformer 是真对于 Transofrmer 类型模型(也包括 encoder-only、decoder-only)的推理加速方案,其提供了 Kernel Fuse、Memory reuse、kv cache、量化等多种优化方案,同时也提供了 Tensor Parallel 和 Pipeline Parallel 两种分布式推理方案。本文将介绍如何在云原生 AI 套件中使用 FasterTransformer 进行模型的推理加速。 02 环境准备 环境准备分为两个部分,第一个部分是创建包含 GPU 的 Kubernetes 集群[3]和安装云原生 AI 套件[4],第二个部分是从 huggingface 官网下载 bloom-7b1 模型。 模型的下载命令如下: git lfs install git clone git@hf.co:bigscience/bloom-7b1 通过上面的命令,可以将 huggingface repo 中的文件下载到本地: 下载完成后,我们将 bloom-71 文件夹上传到 OSS 中,作为推理时的共享存储,OSS 的使用可以参考开始使用 OSS[5]。 上传到 OSS 之后,分别创建名称为 bloom7b1-pv 和 bloom7b1-pvc 的 PV 和 PVC,以用于推理服务的容器挂载。具体操作,请参见使用 OSS 静态存储卷[6]。 03 模型转换 FasterTransformer 本质上是对模型的重写,它通过 CUDA、cuDNN 和 cuBLAS 重写了 Transformer 模型结构,因此其具有自己的模型结构和模型参数的描述方式。而我们的模型一般是通过 Pytorch、Tesorflow、Megatron 或 huggingface 这样的训练框架产出,其往往又具有自己单独的一套模型结构和参数的表达,因此在使用FasterTransformer时,就需要将模型原有的 checkpoint 转换为 FasterTransformer 的结构。 FasterTransformer 中已经支持了多种类型的转换脚本,这里我们使用 FasterTransofrmer 提供的 examples/pytorch/gpt/utils/huggingface_bloom_convert.py。 云原生 AI 套件已经接入了上述的转换逻辑,因此,通过如下脚本即可完成一次模型的转换。 arena submit pytorchjob\ --gpus=1\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name convert-bloom\ --workers 1\ --namespace default-group\ --data bloom-pvc:/mnt\ 'python /FasterTransformer/examples/pytorch/gpt/utils/huggingface_bloom_convert.py -i /mnt/model/bloom-7b1 -o /mnt/model/bloom-7b1-ft-fp16 -tp 2 -dt fp16 -p 64 -v' 通过 arena log 来观察转换的日志: $arena logs -n default-group convert-bloom ======================= Arguments ======================= - input_dir...........: /mnt/model/bloom-7b1 - output_dir..........: /mnt/model/bloom-7b1-ft-fp16 - tensor_para_size....: 2 - data_type...........: fp16 - processes...........: 64 - verbose.............: True - by_shard............: False ========================================================= loading from pytorch bin format model file num: 2 - model.pre_decoder_layernorm.bias................: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.pre_decoder_layernorm.bias.bin - model.layers.0.input_layernorm.weight...........: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.input_layernorm.weight.bin - model.layers.0.attention.dense.bias.............: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.dense.bias.bin - model.layers.0.input_layernorm.bias.............: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.input_layernorm.bias.bin - model.layers.0.attention.query_key_value.bias...: shape (3, 2048) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.query_key_value.bias.0.bin (0/2) - model.layers.0.post_attention_layernorm.weight..: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.post_attention_layernorm.weight.bin - model.layers.0.post_attention_layernorm.bias....: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.post_attention_layernorm.bias.bin - model.layers.0.mlp.dense_4h_to_h.bias...........: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.mlp.dense_4h_to_h.bias.bin - model.layers.0.mlp.dense_h_to_4h.bias...........: shape (8192,) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.mlp.dense_h_to_4h.bias.0.bin (0/2) - model.layers.0.attention.query_key_value.bias...: shape (3, 2048) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.query_key_value.bias.1.bin (1/2) 通过 arena list 命令查看转换是否执行结束: NAME STATUS TRAINER DURATION GPU(Requested) GPU(Allocated) NODE convert-bloom SUCCEEDED PYTORCHJOB 3m 1 N/A 192.168.123.35 转换完成后,会在 OSS 上创建一个 model/arena/bloom-7b1-ft-fp16 文件夹,文件中会存储 FasterTransofrmer 所对应的 checkpoint。 04 性能对比 此时,我们的 OSS 上已经有两份 bloom-7b1 checkpoint,一份是 bloom-7b 文件夹存储了 huggingface 原生的 checkpoint,另一份是 bloom-7b-ft-fp16 文件夹存储了转换后的 FasterTransformer 的 checkpoint。我们将使用这两份 checkpoint 进行性能对比,看一下来 FasterTransformer 是否能够带来性能的提升。 性能对比使用 Fastertransformer 提供的 examples/pytorch/gpt/bloom_lambada.py,我们也已经集成到了 AI 套件中。这里我们分别提交两个性能评测命令。对 Huggingface Bloom-7b1 评测的命令: arena submit pytorchjob\ --gpus=2\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name perf-hf-bloom \ --workers 1\ --namespace default-group\ --data bloom7b1-pvc:/mnt\ 'python /FasterTransformer/examples/pytorch/gpt/bloom_lambada.py \ --tokenizer-path /mnt/model/bloom-7b1 \ --dataset-path /mnt/data/lambada/lambada_test.jsonl \ --batch-size 16 \ --test-hf \ --show-progress' 查看 HuggingFace 的结果: $arena -n default-group logs -t 5 perf-hf-bloom Accuracy: 57.5587% (2966/5153) (elapsed time: 173.2149 sec) 对 Fastertransformer Blooom-7b 评测的命令: arena submit pytorchjob\ --gpus=2\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name perf-ft-bloom \ --workers 1\ --namespace default-group\ --data bloom7b1-pvc:/mnt\ 'mpirun --allow-run-as-root -n 2 python /FasterTransformer/examples/pytorch/gpt/bloom_lambada.py \ --lib-path /FasterTransformer/build/lib/libth_transformer.so \ --checkpoint-path /mnt/model/2-gpu \ --batch-size 16 \ --tokenizer-path /mnt/model/bloom-7b1 \ --dataset-path /mnt/data/lambada/lambada_test.jsonl \ --show-progress' 查看 FasterTransformer 的结果,可以看见带来了 2.5 倍的性能提升。 $arena -n default-group logs -t 5 perf-ft-bloom Accuracy: 57.6363% (2970/5153) (elapsed time: 68.7818 sec) 通过结果对比可以看见,Fastertransformer 与原生的 Huggingface 相比有比较明显的性能提升。 05 模型部署 在这一小节,我们使用 Triton Server 对 FasterTransformer 进行部署,Triton Server 中原生并不支持 FasterTransformer 的 backend,需要我们配合 Nvidia 提供的 Fastertransformer backend 来使用。通过使用 FasterTransformer backend,Triton Server 不再进行 GPU 资源的分配,FasterTransformer backend 会根据 CUDA_VISIBLE_DEVICES 判断当前可用 GPU 资源,并分配给对应的 RANK 来执行分布式的推理。 FasterTransformer 对应的模型 Repo 目录如下所示: ├── model_repo │ └── fastertransformer │ ├── 1 │ │ └── config.ini │ └── config.pbtxt 使用功能 Arena 的如下命令来启动 FasterTransformer: arena serve triton \ --namespace=default-group \ --version=1 \ --data=bloom7b1-pvc:/mnt \ --name=ft-triton-bloom \ --allow-metrics \ --gpus=2 \ --replicas=1 \ --image=ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/triton_with_ft:22.03-main-2edb257e-transformers \ --model-repository=/mnt/triton_repo 通过 kubectl logs,我们可以看到 triton server 的部署日志,通过日志可以看到,triton server 启动了两个 gpu 来进行分布式推理。 I0721 08:57:28.116291 1 pinned_memory_manager.cc:240] Pinned memory pool is created at '0x7fd264000000' with size 268435456 I0721 08:57:28.118393 1 cuda_memory_manager.cc:105] CUDA memory pool is created on device 0 with size 67108864 I0721 08:57:28.118403 1 cuda_memory_manager.cc:105] CUDA memory pool is created on device 1 with size 67108864 I0721 08:57:28.443529 1 model_lifecycle.cc:459] loading: fastertransformer:1 I0721 08:57:28.625253 1 libfastertransformer.cc:1828] TRITONBACKEND_Initialize: fastertransformer I0721 08:57:28.625307 1 libfastertransformer.cc:1838] Triton TRITONBACKEND API version: 1.10 I0721 08:57:28.625315 1 libfastertransformer.cc:1844] 'fastertransformer' TRITONBACKEND API version: 1.10 I0721 08:57:28.627137 1 libfastertransformer.cc:1876] TRITONBACKEND_ModelInitialize: fastertransformer (version 1) I0721 08:57:28.628304 1 libfastertransformer.cc:372] Instance group type: KIND_CPU count: 1 I0721 08:57:28.628326 1 libfastertransformer.cc:402] Sequence Batching: disabled I0721 08:57:28.628334 1 libfastertransformer.cc:412] Dynamic Batching: disabled I0721 08:57:28.661657 1 libfastertransformer.cc:438] Before Loading Weights: +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Backend | Path | Config | +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ | fastertransformer | /opt/tritonserver/backends/fastertransformer/libtriton_fastertransformer.so | {"cmdline":{"auto-complete-config":"true","min-compute-capability":"6.000000","backend-directory":"/opt/tritonserver/backends","default-max-batch-size":"4"}} | +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ I0721 09:01:19.653743 1 server.cc:633] +-------------------+---------+--------+ | Model | Version | Status | after allocation : free: 7.47 GB, total: 15.78 GB, used: 8.31 GB +-------------------+---------+--------+ | fastertransformer | 1 | READY | +-------------------+---------+--------+ I0721 09:01:19.668137 1 metrics.cc:864] Collecting metrics for GPU 0: Tesla V100-SXM2-16GB I0721 09:01:19.668167 1 metrics.cc:864] Collecting metrics for GPU 1: Tesla V100-SXM2-16GB I0721 09:01:19.669954 1 metrics.cc:757] Collecting CPU metrics I0721 09:01:19.670150 1 tritonserver.cc:2264] +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Option | Value | +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | server_id | triton | | server_version | 2.29.0 | | server_extensions | classification sequence model_repository model_repository(unload_dependents) schedule_policy model_configuration system_shared_memory cuda_shared_memory binary_tensor_data statistics trace logging | | model_repository_path[0] | /mnt/triton_repo | | model_control_mode | MODE_NONE | | strict_model_config | 0 | | rate_limit | OFF | | pinned_memory_pool_byte_size | 268435456 | | cuda_memory_pool_byte_size{0} | 67108864 | | cuda_memory_pool_byte_size{1} | 67108864 | | response_cache_byte_size | 0 | | min_supported_compute_capability | 6.0 | | strict_readiness | 1 | | exit_timeout | 30 | +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ I0721 09:01:19.672326 1 grpc_server.cc:4819] Started GRPCInferenceService at 0.0.0.0:8001 I0721 09:01:19.672597 1 http_server.cc:3477] Started HTTPService at 0.0.0.0:8000 I0721 09:01:19.714356 1 http_server.cc:184] Started Metrics Service at 0.0.0.0:8002 06 服务请求 启动 forward 进行验证: # 使用 kubectl 启动port-forward kubectl -n default-group port-forward svc/ft-triton-bloom-1-tritoninferenceserver 8001:8001 这里我们使用 Triton Server 提供的 python SDK 所编写的脚本来向 Triton Server 发起请求。脚本中主要完成三件事情: 通过 huggingface 中 bloom-7b1 对应的分词器对 query 进行分词和 token 转换 通过 triton server SDK 向 triton server 发起请求 通过分词器对 output token 进行转换,拿到最终的结果 import os, sys #from tkinter import _Padding import numpy as np import json import torch #import tritongrpcclient import argparse import time from transformers import AutoTokenizer import tritonclient.grpc as grpcclient # create tokenizer tokenizer = AutoTokenizer.from_pretrained('/mnt/model/bloom-7b1', padding_side='right') tokenizer.pad_token_id = tokenizer.eos_token_id def load_image(img_path: str): """ Loads an encoded image as an array of bytes. """ return np.fromfile(img_path, dtype='uint8') def tokeninze(query): # encode encoded_inputs = tokenizer(query, padding=True, return_tensors='pt') input_token_ids = encoded_inputs['input_ids'].int() input_lengths = encoded_inputs['attention_mask'].sum( dim=-1, dtype=torch.int32).view(-1, 1) return input_token_ids.numpy().astype('uint32'), input_lengths.numpy().astype('uint32') if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument("--model_name", type=str, required=False, default="fastertransformer", help="Model name") parser.add_argument("--url", type=str, required=False, default="localhost:8001", help="Inference server URL. Default is localhost:8001.") parser.add_argument('-v', "--verbose", action="store_true", required=False, default=False, help='Enable verbose output') args = parser.parse_args() # 1.创建client try: triton_client = grpcclient.InferenceServerClient( url=args.url, verbose=args.verbose) except Exception as e: print("channel creation failed: " + str(e)) sys.exit(1) output_name = "OUTPUT" # 2) 设置input inputs = [] ## 2.1) input_ids query="deepspeed is" input_ids, input_lengths = tokeninze(query) inputs.append(grpcclient.InferInput("input_ids", input_ids.shape, "UINT32")) inputs[0].set_data_from_numpy(input_ids) ## 2.2) input_length inputs.append(grpcclient.InferInput("input_lengths", input_lengths.shape, "UINT32")) inputs[1].set_data_from_numpy(input_lengths) ## 2.3) output length output_len=32 output_len_np = np.array([[output_len]], dtype=np.uintc) inputs.append(grpcclient.InferInput("request_output_len", output_len_np.shape, "UINT32")) inputs[2].set_data_from_numpy(output_len_np) # 3) 设置output outputs = [] outputs.append(grpcclient.InferRequestedOutput("output_ids")) # 4) 发起请求 start_time = time.time() results = triton_client.infer(model_name=args.model_name, inputs=inputs, outputs=outputs) latency = time.time() - start_time # 5) 结果处理:转化为numpy 类型,计算max,转化label output0_data = results.as_numpy("output_ids") print(output0_data.shape) result = tokenizer.batch_decode(output0_data[0]) print(result) 发起 client 请求命令如下: $python3 bloom_7b_client.py (1, 1, 36) ['deepspeed is the speed of the ship at the time of the collision, and the\ndeepspeed of the other ship is the speed of the other ship at the time'] 07 总结 本文我们通过 Bloom-7b1 模型展示了如何在云原生 AI 套件中使用 FasterTransformer 对大语言模型进行加速,通过与 HuggingFace 的版本对比可以带来 2.5 倍的性能提升。后续我们会逐步推出更多大模型相关的推理加速方案,以满足不同的业务需求,大家敬请期待。 相关链接: [1] 云原生 AI 套件开发者使用指南 https://help.aliyun.com/zh/ack/cloud-native-ai-suite/getting-started/cloud-native-ai-component-set-user-guide [2] 部署 PyTorch 模型推理服务 https://help.aliyun.com/zh/ack/cloud-native-ai-suite/user-guide/deploy-a-pytorch-model-as-an-inference-service?spm=a2c4g.11186623.0.0.2267225carYzgA [3] 创建包含 GPU 的 Kubernetes 集群 https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/use-gpu-scheduling-in-ack-clusters#task-1664343 [4] 安装云原生 AI 套件 https://help.aliyun.com/document_detail/212117.htm#task-1917487 [5] 开始使用 OSS https://help.aliyun.com/zh/oss/getting-started/getting-started-with-oss [6] 使用 OSS 静态存储卷 https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/mount-statically-provisioned-oss-volumes 作者:颜廷帅(瀚廷) 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

AI 量化:从因子挖掘到组合优化的工程化实践

AI 量化不是"用 LSTM 预测股价"这么简单。专业做法是把机器学习嵌入完整的量化流水线:数据治理 → 因子构造 → 模型训练 → 信号生成 → 组合优化 → 风险控制 → 回测归因。模型只是其中一环,工程纪律与风控才是长期盈利的关键。 ## 一、数据层:干净的数据胜过复杂的模型 量化策略九成时间花在数据上。必须处理复权、停牌、退市、幸存者偏差。 ``` import pandas as pd import numpy as np def load_prices(path: str) -> pd.DataFrame: df = pd.read_parquet(path) df["date"] = pd.to_datetime(df["date"]) df = df.sort_values(["symbol", "date"]) # 前复权收盘价 df["adj_close"] = df["close"] * df["adj_factor"] # 剔除停牌与涨跌停不可交易样本 df = df[~df["suspended"]] # 计算未来一期收益作为标签 df["ret_fwd"] = df.groupby("symbol")["adj_close"].pct_change().shift(-1) return df.dropna(subset=["ret_fwd"]) ``` 注意标签必须 `shift(-1)` 对齐未来收益,且要防止用未来信息构造因子。 ## 二、因子构造:Alpha 的来源 因子是量化的核心。常见类别包括动量、反转、波动率、流动性、估值。以下构造三个经典因子: ``` def build_factors(df: pd.DataFrame) -> pd.DataFrame: g = df.groupby("symbol")["adj_close"] # 20日动量 df["mom20"] = g.pct_change(20) # 5日反转 df["rev5"] = -g.pct_change(5) # 20日波动率 df["vol20"] = g.pct_change().groupby(df["symbol"]).rolling(20).std().reset_index(0, drop=True) # 横截面标准化,消除量纲 for f in ["mom20", "rev5", "vol20"]: df[f] = df.groupby("date")[f].transform( lambda x: (x - x.mean()) / (x.std() + 1e-9)) return df.dropna() ``` 横截面标准化是专业实践的关键,让因子在不同日期可比。 ## 三、模型层:轻量模型 + 严格验证 金融数据信噪比极低,深度模型容易过拟合。推荐 LightGBM 或线性模型,配合时间序列交叉验证。 ``` import lightgbm as lgb from sklearn.model_selection import TimeSeriesSplit FEATURES = ["mom20", "rev5", "vol20"] def train_model(df: pd.DataFrame): X, y = df[FEATURES], df["ret_fwd"] tscv = TimeSeriesSplit(n_splits=5) models, scores = [], [] for train_idx, val_idx in tscv.split(X): model = lgb.LGBMRegressor( n_estimators=300, learning_rate=0.05, num_leaves=31, min_child_samples=50, subsample=0.8, colsample_bytree=0.8) model.fit(X.iloc[train_idx], y.iloc[train_idx]) pred = model.predict(X.iloc[val_idx]) ic = np.corrcoef(pred, y.iloc[val_idx])[0, 1] scores.append(ic) models.append(model) print(f"IC均值: {np.mean(scores):.4f}") return models ``` 评价指标用 IC(信息系数)与 ICIR,而非 MSE。IC 稳定在 0.03 以上就值得进一步验证。 ## 四、组合优化:从信号到持仓 预测值不能直接当仓位。需做横截面排序、行业中性、风险约束与成本控制。 ``` from scipy.optimize import minimize def optimize_weights(signals: pd.Series, cov: pd.DataFrame, max_weight: float = 0.05) -> pd.Series: n = len(signals) mu = signals.values # 目标:最大化预期收益 - 风险惩罚 def neg_utility(w): return -(mu @ w - 5 * w @ cov.values @ w) constraints = [{"type": "eq", "fun": lambda w: w.sum() - 1}] bounds = [(0, max_weight)] * n w0 = np.ones(n) / n res = minimize(neg_utility, w0, bounds=bounds, constraints=constraints) return pd.Series(res.x, index=signals.index) ``` 约束包括:单票上限、行业暴露、换手率惩罚。真实交易还要考虑冲击成本与最小交易单位。 ## 五、回测与归因:避免自欺欺人 回测必须模拟真实约束:T+1、涨跌停、手续费、滑点。 ``` def backtest(df: pd.DataFrame, signals: pd.Series, cost: float = 0.0015) -> pd.Series: weights = signals.groupby("date").apply( lambda s: s / s.abs().sum()).unstack().fillna(0) returns = df.pivot(index="date", columns="symbol", values="ret_fwd").fillna(0) turnover = weights.diff().abs().sum(axis=1).fillna(0) gross = (weights.shift(1) * returns).sum(axis=1) net = gross - turnover * cost return net.cumsum() ``` 关键指标:年化收益、夏普、最大回撤、换手率、容量估计。若扣费后夏普低于 1,策略不具备实盘价值。 ## 六、生产化要点 1. **防未来函数**:所有因子只能用 `t` 时刻及之前数据,标签对齐未来收益。 1. **滚动训练**:定期用最新数据重训,监控因子衰减与 IC 漂移。 1. **风控前置**:仓位上限、行业中性、止损、流动性过滤,写死在流程里。 1. **可复现**:数据版本、模型版本、参数全部记录,支持回滚。 1. **实盘验证**:先模拟盘,再小资金,逐步放大,监控实盘与回测偏差。 **总结**:AI 量化的核心竞争力不在模型复杂度,而在数据质量、因子逻辑、验证严谨与风控执行。代码只是载体,纪律才是护城河。

优秀的个人博客,低调大师

终端安全:从遥测采集到威胁狩猎的工程化实践

终端是攻击链的最后一环,也是数据泄露的起点。传统杀软依赖特征匹配,面对无文件攻击、内存马、白利用时形同虚设。现代终端安全的核心是**持续采集遥测、建立行为基线、检测异常偏离、并快速响应闭环**。本文从进程监控讲到持久化检测,给出可落地的代码。 ## 一、进程遥测:安全监控的地基 一切检测始于高质量的进程事件。Windows 用 ETW/Sysmon,Linux 用 eBPF。Linux 侧用 bpftrace 快速验证: ``` # 监控 execve,输出父进程、子进程与参数 bpftrace -e ' tracepoint:syscalls:sys_enter_execve { printf("[%d->%d] %s %s\n", pid, tid, comm, str(args->filename)); }' ``` 生产环境用 Python 封装 auditd 日志解析: ``` import re, json from dataclasses import dataclass, asdict @dataclass class ProcEvent: ts: float pid: int ppid: int exe: str cmdline: str uid: int AUDIT_RE = re.compile( r"type=EXECVE.*?ppid=(\d+).*?pid=(\d+).*?uid=(\d+).*?exe=\"([^\"]+)\"") def parse_audit(line: str) -> ProcEvent | None: m = AUDIT_RE.search(line) if not m: return None ppid, pid, uid, exe = m.groups() args = re.findall(r'a\d+="([^"]*)"', line) return ProcEvent(ts=0.0, pid=int(pid), ppid=int(ppid), exe=exe, cmdline=" ".join(args), uid=int(uid)) ``` 关键点:**采集父进程ID**,否则无法重建攻击链。 ## 二、行为基线:识别偏离而非匹配特征 规则只能覆盖已知攻击。基线用统计方法捕捉异常。 ``` from collections import defaultdict, Counter import math class Baseline: def __init__(self): self.pc = defaultdict(Counter) # parent -> child 频次 def train(self, events: list[ProcEvent]): for e in events: parent = e.exe.rsplit("/", 1)[-1] child = e.cmdline.split()[0].rsplit("/", 1)[-1] if e.cmdline else "?" self.pc[parent][child] += 1 def score(self, parent: str, child: str) -> float: """负对数似然,越大越异常""" c = self.pc.get(parent) if not c: return 8.0 prob = (c.get(child, 0) + 1) / (sum(c.values()) + len(c)) return -math.log(prob) # 使用 b = Baseline() b.train(events) print(b.score("nginx", "bash")) # 极高:Web 服务不应派生 shell print(b.score("bash", "ls")) # 极低:正常交互 ``` 典型高危组合:`nginx→bash`(WebShell)、`winword→powershell`(钓鱼)、`java→sh`(反序列化利用)。 ## 三、持久化检测:攻击者的"留后门" 持久化是攻击者立足的关键,覆盖多个位置。 ``` import os, subprocess, hashlib PERSIST_PATHS = { "cron": ["/etc/crontab", "/var/spool/cron"], "systemd": ["/etc/systemd/system", "/lib/systemd/system"], "ssh": ["/root/.ssh/authorized_keys", "/home"], "profile": ["/etc/profile.d", "/etc/rc.local"], } def scan_persistence() -> list[dict]: hits = [] for category, paths in PERSIST_PATHS.items(): for p in paths: if not os.path.exists(p): continue for root, _, files in os.walk(p) if os.path.isdir(p) else [(p, [], [p])]: for f in files: fp = os.path.join(root, f) try: content = open(fp, encoding="utf-8", errors="ignore").read() except (OSError, PermissionError): continue # 检测可疑命令 for kw in ("curl", "wget", "base64 -d", "/dev/tcp/", "nc -e"): if kw in content: hits.append({"path": fp, "keyword": kw, "category": category}) return hits ``` 更专业的做法是**对持久化位置做完整性基线**:首次记录哈希,后续变化即告警。 ``` def snapshot(paths: list[str]) -> dict[str, str]: snap = {} for p in paths: if os.path.isfile(p): snap[p] = hashlib.sha256(open(p, "rb").read()).hexdigest() return snap def diff(before: dict, after: dict) -> list[str]: changed = [] for k, v in after.items(): if k not in before: changed.append(f"新增: {k}") elif before[k] != v: changed.append(f"修改: {k}") for k in before: if k not in after: changed.append(f"删除: {k}") return changed ``` ## 四、内存与注入检测 无文件攻击常驻内存,不落盘,需检测异常内存区域。 ``` # 检测 Linux 进程的可疑内存映射(rwx 段) def scan_rwx_maps(pid: int) -> list[str]: suspicious = [] try: with open(f"/proc/{pid}/maps") as f: for line in f: if "rwx" in line: # 可读写可执行,高危 suspicious.append(line.strip()) except (FileNotFoundError, PermissionError): pass return suspicious # 遍历所有进程 def scan_all(): for pid in os.listdir("/proc"): if pid.isdigit(): hits = scan_rwx_maps(int(pid)) if hits: print(f"[PID {pid}] 可疑 RWX 段: {hits}") ``` Windows 侧对应检测 `VirtualAllocEx` + `WriteProcessMemory` + `CreateRemoteThread` 组合,这是进程注入的经典三部曲。 ## 五、网络连接监控 C2 通信是攻击者的生命线,监控异常外连至关重要。 ``` import psutil def suspicious_conns() -> list[dict]: out = [] for c in psutil.net_connections(kind="inet"): if c.status != "ESTABLISHED" or not c.raddr: continue ip, port = c.raddr.ip, c.raddr.port # 检测非常规端口 + 无进程归属 if port in (4444, 5555, 8888, 1337) or (port > 10000 and c.pid is None): out.append({"local": f"{c.laddr.ip}:{c.laddr.port}", "remote": f"{ip}:{port}", "pid": c.pid}) return out ``` 实际生产中,应结合威胁情报库做 IP 信誉匹配,而非仅靠端口猜测。 ## 六、响应闭环 检测只是开始,响应才是价值。自动化响应需谨慎,高危动作必须人工确认。 ``` def respond(alert: dict, auto: bool = False): severity = alert["severity"] pid = alert.get("pid") if severity == "critical" and auto: # 隔离进程:先挂起再取证 try: p = psutil.Process(pid) p.suspend() # 采集内存、打开文件、网络连接后再 kill print(f"[隔离] PID {pid} 已挂起") except psutil.NoSuchProcess: pass else: print(f"[告警] 需人工确认: {alert}") ``` **响应优先级**:取证 > 隔离 > 清除。直接 kill 会丢失内存证据,应先在挂起状态下 dump。 ## 七、工程护栏 1. **性能可控**:采集 CPU 占用 < 3%,避免拖垮业务。 1. **数据脱敏**:命令行中的密码、Token 入库前过滤。 1. **日志防篡改**:本地加密 + 远程实时转发。 1. **误报治理**:规则上线前用历史数据回放,评估误报率。 1. **权限最小**:采集器以降权运行,避免自身成为攻击目标。 1. **合规边界**:监控范围需符合法律与公司政策,员工知情。 ## 结语 终端安全的专业性,体现在**采集的精准、基线的可靠、检测的分层、响应的闭环**。规则覆盖已知,基线捕捉未知,内存与网络检测补盲,响应沉淀证据。把这套体系落地,终端才能从"被动查杀"升级为"主动狩猎"——这才是现代终端安全的核心竞争力。
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册