首页 文章 精选 留言 我的

精选列表

搜索[搭建],共10000篇文章
优秀的个人博客,低调大师

在元宇宙中搭建语聊房,设计思路和实现方法分享

目标 1. 制定目标 不妨大家想一下这个场景: 你走进一个咖啡厅,看到了一个美女或者帅哥,想要一个微信号,方便后续发展。 那我们要怎么做呢? 走到对方跟前,小声对他说:“你好,你长的很像我的前女友(前男友),可以加下你的微信吗?”。 对方有可能悄声的说,“我扫你”。 你这个时候你就需要把你的二维码展示给他。 当你们恋爱成功,求婚的时候,可能要找一个更加浪漫的环境,并且你们的对话希望给更多人看到、听到。 通过这个上面场景的想象,我们可以简单的确定一些基本的要素 可以更改的场景 (咖啡厅和求婚现场) 自主塑造形象功能(毕竟外貌是一见钟情的原点) 单聊 (要微信号不能一次要一群人得呀。不然可能被当成流氓给打得哟) 文件共享 (把自己得二维码展示给对方,让对方加好友) 群聊、群视频 (把求婚现场给其他用户看) 2. 拆解目标 为了满足上面提到得要求,我们需要以下功能: 支持unity的方便接入。毕竟unity是一个非常好的3D引擎,如果可以方便接入得话,在后续得场景创建和人物创造上都可以有更大的扩展空间 1 vs 1的视频,或者 1 vs 多的直播模式。可以满足单聊和群聊的需求 同步本地播放的本地视频或者远端视频给其他用户。可以满足共享二维码的需求。 3. 效果预览 如果要完整的实现一个完整的项目会花费比较多的时间,而我发现目前声网的 Demo 会提供简单的人物模型和素材,但是他们开放度较高,开发者可以根据需要使用自己定制化的模型素材,为了实现上述提到的需求,我只做了一些微小的修改,就满足了我们的需求。本次主要看下效果,为后续在生产环境中落地做一些技术上的储备。 以下是在demo上调整后显示出来的效果。 这是用unity来实现的一个咖啡厅的样子 这是一个服装店,我们可以给人物进行换装,这个也是由unity来实现的。 以上两个的接入都非常的方便,我们可以很好的对接unity,如果需要的话,后续有自己的unity场景也可以快速接入。 这个是我自己测试的1 vs 1的视频测试效果 这个是我自己测试的将本地视频分享给对方的一个效果 想象一下,是不是可以和你的对象一起看剧了呢? 简单实现 以上效果都是基于声网的sdk来实现的,如果你也想进行尝试或者使用,可以继续查看我的接入过程和中间遇到的问题以及解决方案。 1. 账号准备 我们既然使用了声网的sdk,那注册一个声网的账号做一些声网的账号配置也很合理吧。 注册账号 完成实名 创建项目 配置项目 然后进入详细配置 生成token,并将appid、证书、token复制保存。 注意!!!这里很重要,一定要看仔细,项目中会使用到! 至此,账号的准备已经完成了。 2. 配置项目 demo源码 通过声网官网客服,申请元宇宙 SDK、Unity工程文件、开发指南,同时申请开通使用权限,详情可访问 shengwang.cn 将sdk解压并配置到项目中 一定要注意目录,如果自己的项目中不存在当前的目录要自己创建 配置id一般情况下,这个文件是不会上传到远程仓库的,写到这里也主要是安全考虑。将在后台中申请的appid、证书,复制后粘贴到/Android/local.properties里面,如下: 配置channel 将在后台生成token的时候,填写的channel给写到类中,如下 配置项目权限 <uses-permission android:name="android.permission.INTERNET" /> <uses-permission android:name="android.permission.CAMERA" /> <uses-permission android:name="android.permission.RECORD_AUDIO" /> <uses-permission android:name="android.permission.MODIFY_AUDIO_SETTINGS" /> <uses-permission android:name="android.permission.ACCESS_WIFI_STATE" /> <uses-permission android:name="android.permission.ACCESS_NETWORK_STATE" /> <uses-permission android:name="android.permission.BLUETOOTH" /> <!-- 对于 Android 12.0 及以上设备,还需要添加如下权限: --> <uses-permission android:name="android.permission.BLUETOOTH_CONNECT" /> 注意: Manifest.permission.RECORD_AUDIO, Manifest.permission.CAMERA 需要动态申请权限,否则无法正常完成视频功能。 sdk本身是不会去申请权限的,所以需要我们自己在合适的位置帮sdk申请好权限。 混淆配置 咖啡厅 做形象 服装店 这里是直接使用了声网给的效果,如果自己项目需要的话,可以去自己去调整。 其中换装和捏脸都需要unity上的一些修改和native与unity的通信。整个可以参考换装和捏脸 3. 视频1vs1 前面已经完成了整体项目的构建。并且已经把unity内容跑起来了,那么接下来我们看下,如果要实现 1vs1的视频要怎么处理。为了方便处理,我单独写了一个页面来处理视频1vs1,效果如下: 视频聊天 这个流程图,建议大家多看几遍,在我们遇到问题的时候,这个图会给我们启发,帮助我们解决问题。 详细流程: 1. 创建RtcEngine对象 该对象管理了整个的视频等场景,是一个非常核心的对象。 try { RtcEngineConfig config = new RtcEngineConfig(); config.mContext = getBaseContext(); config.mAppId = appId; config.mEventHandler = mRtcEventHandler; config.mAudioScenario = Constants.AudioScenario.getValue(Constants.AudioScenario.DEFAULT); mRtcEngine = RtcEngine.create(config); } catch (Exception e) { throw new RuntimeException("Check the error."); } 2. 创建RtcEngine属性 // 视频默认禁用,你需要调用 enableVideo 启用视频流。 mRtcEngine.enableVideo(); // 录音默认禁用,你需要调用 enableAudio 启用录音。 mRtcEngine.enableAudio(); // 开启本地视频预览。 mRtcEngine.startPreview(); 3. 将本地摄像头内容显示到local_video_view_container上 FrameLayout container = findViewById(R.id.local_video_view_container); // 创建一个 SurfaceView 对象,并将其作为 FrameLayout 的子对象。 SurfaceView surfaceView = new SurfaceView (getBaseContext()); container.addView(surfaceView); // 将 SurfaceView 对象传入声网,以渲染本地视频。 mRtcEngine.setupLocalVideo(new VideoCanvas(surfaceView, VideoCanvas.RENDER_MODE_FIT, KeyCenter.RTC_UID)); 4. 设置当前的模式 ChannelMediaOptions options = new ChannelMediaOptions(); // 将用户角色设置为 BROADCASTER。 options.clientRoleType = Constants.CLIENT_ROLE_BROADCASTER; // 视频通话场景下,设置频道场景为 BROADCASTING。 options.channelProfile = Constants.CHANNEL_PROFILE_LIVE_BROADCASTING; 其中clientRoleType有两种,如果是CLIENT_ROLE_BROADCASTER就是可以播和收,如果是CLIENT_ROLE_AUDIENCE就只能收看,当前就成了主播模式。 5. 加入频道 // 使用临时 Token 加入频道。 // 你需要自行指定用户 ID,并确保其在频道内的唯一性。 int res = mRtcEngine.joinChannel(token, channelName, KeyCenter.RTC_UID, options); if (res != 0) { // Usually happens with invalid parameters // Error code description can be found at: // en: https://docs.agora.io/en/Voice/API%20Reference/java/classio_1_1agora_1_1rtc_1_1_i_rtc_engine_event_handler_1_1_error_code.html // cn: https://docs.agora.io/cn/Voice/API%20Reference/java/classio_1_1agora_1_1rtc_1_1_i_rtc_engine_event_handler_1_1_error_code.html Log.e("video","join err:"+RtcEngine.getErrorDescription(Math.abs(res))); } joinChannel方法有返回值,可以看到我们加入频道是否成功了,如果不成功的话,我们可以看下错误原因,并对照解决;如果成功了,就可以观察IRtcEngineEventHandler对象的回调方法,重点关注下 onError(int err) 和onJoinChannelSuccess(String channel, int uid, int elapsed) 如果收到 onJoinChannelSuccess方法的回调,我们就可以关注 onUserJoined(int uid, int elapsed) 方法,我们可以在这个方法里开始显示远端内容。 6. 显示远端内容 @Override // 监听频道内的远端主播,获取主播的 uid 信息。 public void onUserJoined(int uid, int elapsed) { Log.e(TAG, "onUserJoined->" + uid); runOnUiThread(new Runnable() { @Override public void run() { // 从 onUserJoined 回调获取 uid 后,调用 setupRemoteVideo,设置远端视频视图。 setupRemoteVideo(uid); } }); } private void setupRemoteVideo(int uid) { FrameLayout container = findViewById(R.id.remote_video_view_container); SurfaceView surfaceView = new SurfaceView (getBaseContext()); surfaceView.setZOrderMediaOverlay(true); container.addView(surfaceView); mRtcEngine.setupRemoteVideo(new VideoCanvas(surfaceView, VideoCanvas.RENDER_MODE_FIT, uid)); } 最终,远端的视频会显示在 remote_video_view_container 上。 4. 将本地播放的视频显示给远端用户 同步本地播放给远端 将本地视频怎么同步给远端的用户呢?其实从本质上来讲,将本地摄像头和将本地播放的视频给远端用户看,对远端用户都是一样的,不一样的是本地用户给远端用户的数据源是哪个。一个是摄像头,一个是播放器。 设置本地video的时候做下修改 FrameLayout container = findViewById(R.id.local_video_view_container); // 创建一个 SurfaceView 对象,并将其作为 FrameLayout 的子对象。 SurfaceView surfaceView = new SurfaceView (getBaseContext()); container.addView(surfaceView); // 将 SurfaceView 对象传入声网,以渲染本地视频。 VideoCanvas videoCanvas = new VideoCanvas(surfaceView, Constants.RENDER_MODE_HIDDEN, Constants.VIDEO_MIRROR_MODE_AUTO, Constants.VIDEO_SOURCE_MEDIA_PLAYER, mediaPlayer.getMediaPlayerId(), KeyCenter.RTC_UID); mRtcEngine.setupLocalVideo(videoCanvas); 在int res = mRtcEngine.joinChannel(token, channelName, KeyCenter.RTC_UID, options);是0的时候,调用如下方法: int res = mRtcEngine.joinChannel(token, channelName, KeyCenter.RTC_UID, options); if (res != 0) { // Usually happens with invalid parameters // Error code description can be found at: // en: https://docs.agora.io/en/Voice/API%20Reference/java/classio_1_1agora_1_1rtc_1_1_i_rtc_engine_event_handler_1_1_error_code.html // cn: https://docs.agora.io/cn/Voice/API%20Reference/java/classio_1_1agora_1_1rtc_1_1_i_rtc_engine_event_handler_1_1_error_code.html Log.e("video","join err:"+RtcEngine.getErrorDescription(Math.abs(res))); }else { mediaPlayer = mRtcEngine.createMediaPlayer(); mediaPlayer.registerPlayerObserver(this); mediaPlayer.open(MetaChatConstants.VIDEO_URL, 0); } 3.监听onPlayerStateChanged回调并在state是PLAYER_STATE_OPEN_COMPLETED的时候执行play方法,代码如下: public void onPlayerStateChanged(io.agora.mediaplayer.Constants.MediaPlayerState state, io.agora.mediaplayer.Constants.MediaPlayerError error) { if(state == io.agora.mediaplayer.Constants.MediaPlayerState.PLAYER_STATE_OPEN_COMPLETED){ mediaPlayer.play(); } } 至此,就完成了功能上的使用。 其它功能 除了上面提到的功能外,声网还提供了一些其他的功能,在需要的时候可以直接使用,或者少量修改就可以用的。 比如说空间音效功能,该功能基于声学原理,模拟声音在不同空间环境中的传播、反射、吸收效果。可以为用户提供旅游中路人聊天声、海浪声、风声等,让用户更沉浸式体验 再比如说实时共赏影音功能。该功能可以几乎无延时的实现,远程观影、听歌等功能。甚至可以实现k歌的能力。 更多的功能期待大家一起发掘! 参考资料 注册声网账号 声网官网 SDK下载 快速开始 - 实现音视频通话 媒体播放器
优秀的个人博客,低调大师

Sa-Token v1.29.0 更新,轻松搭建 OAuth2.0 服务

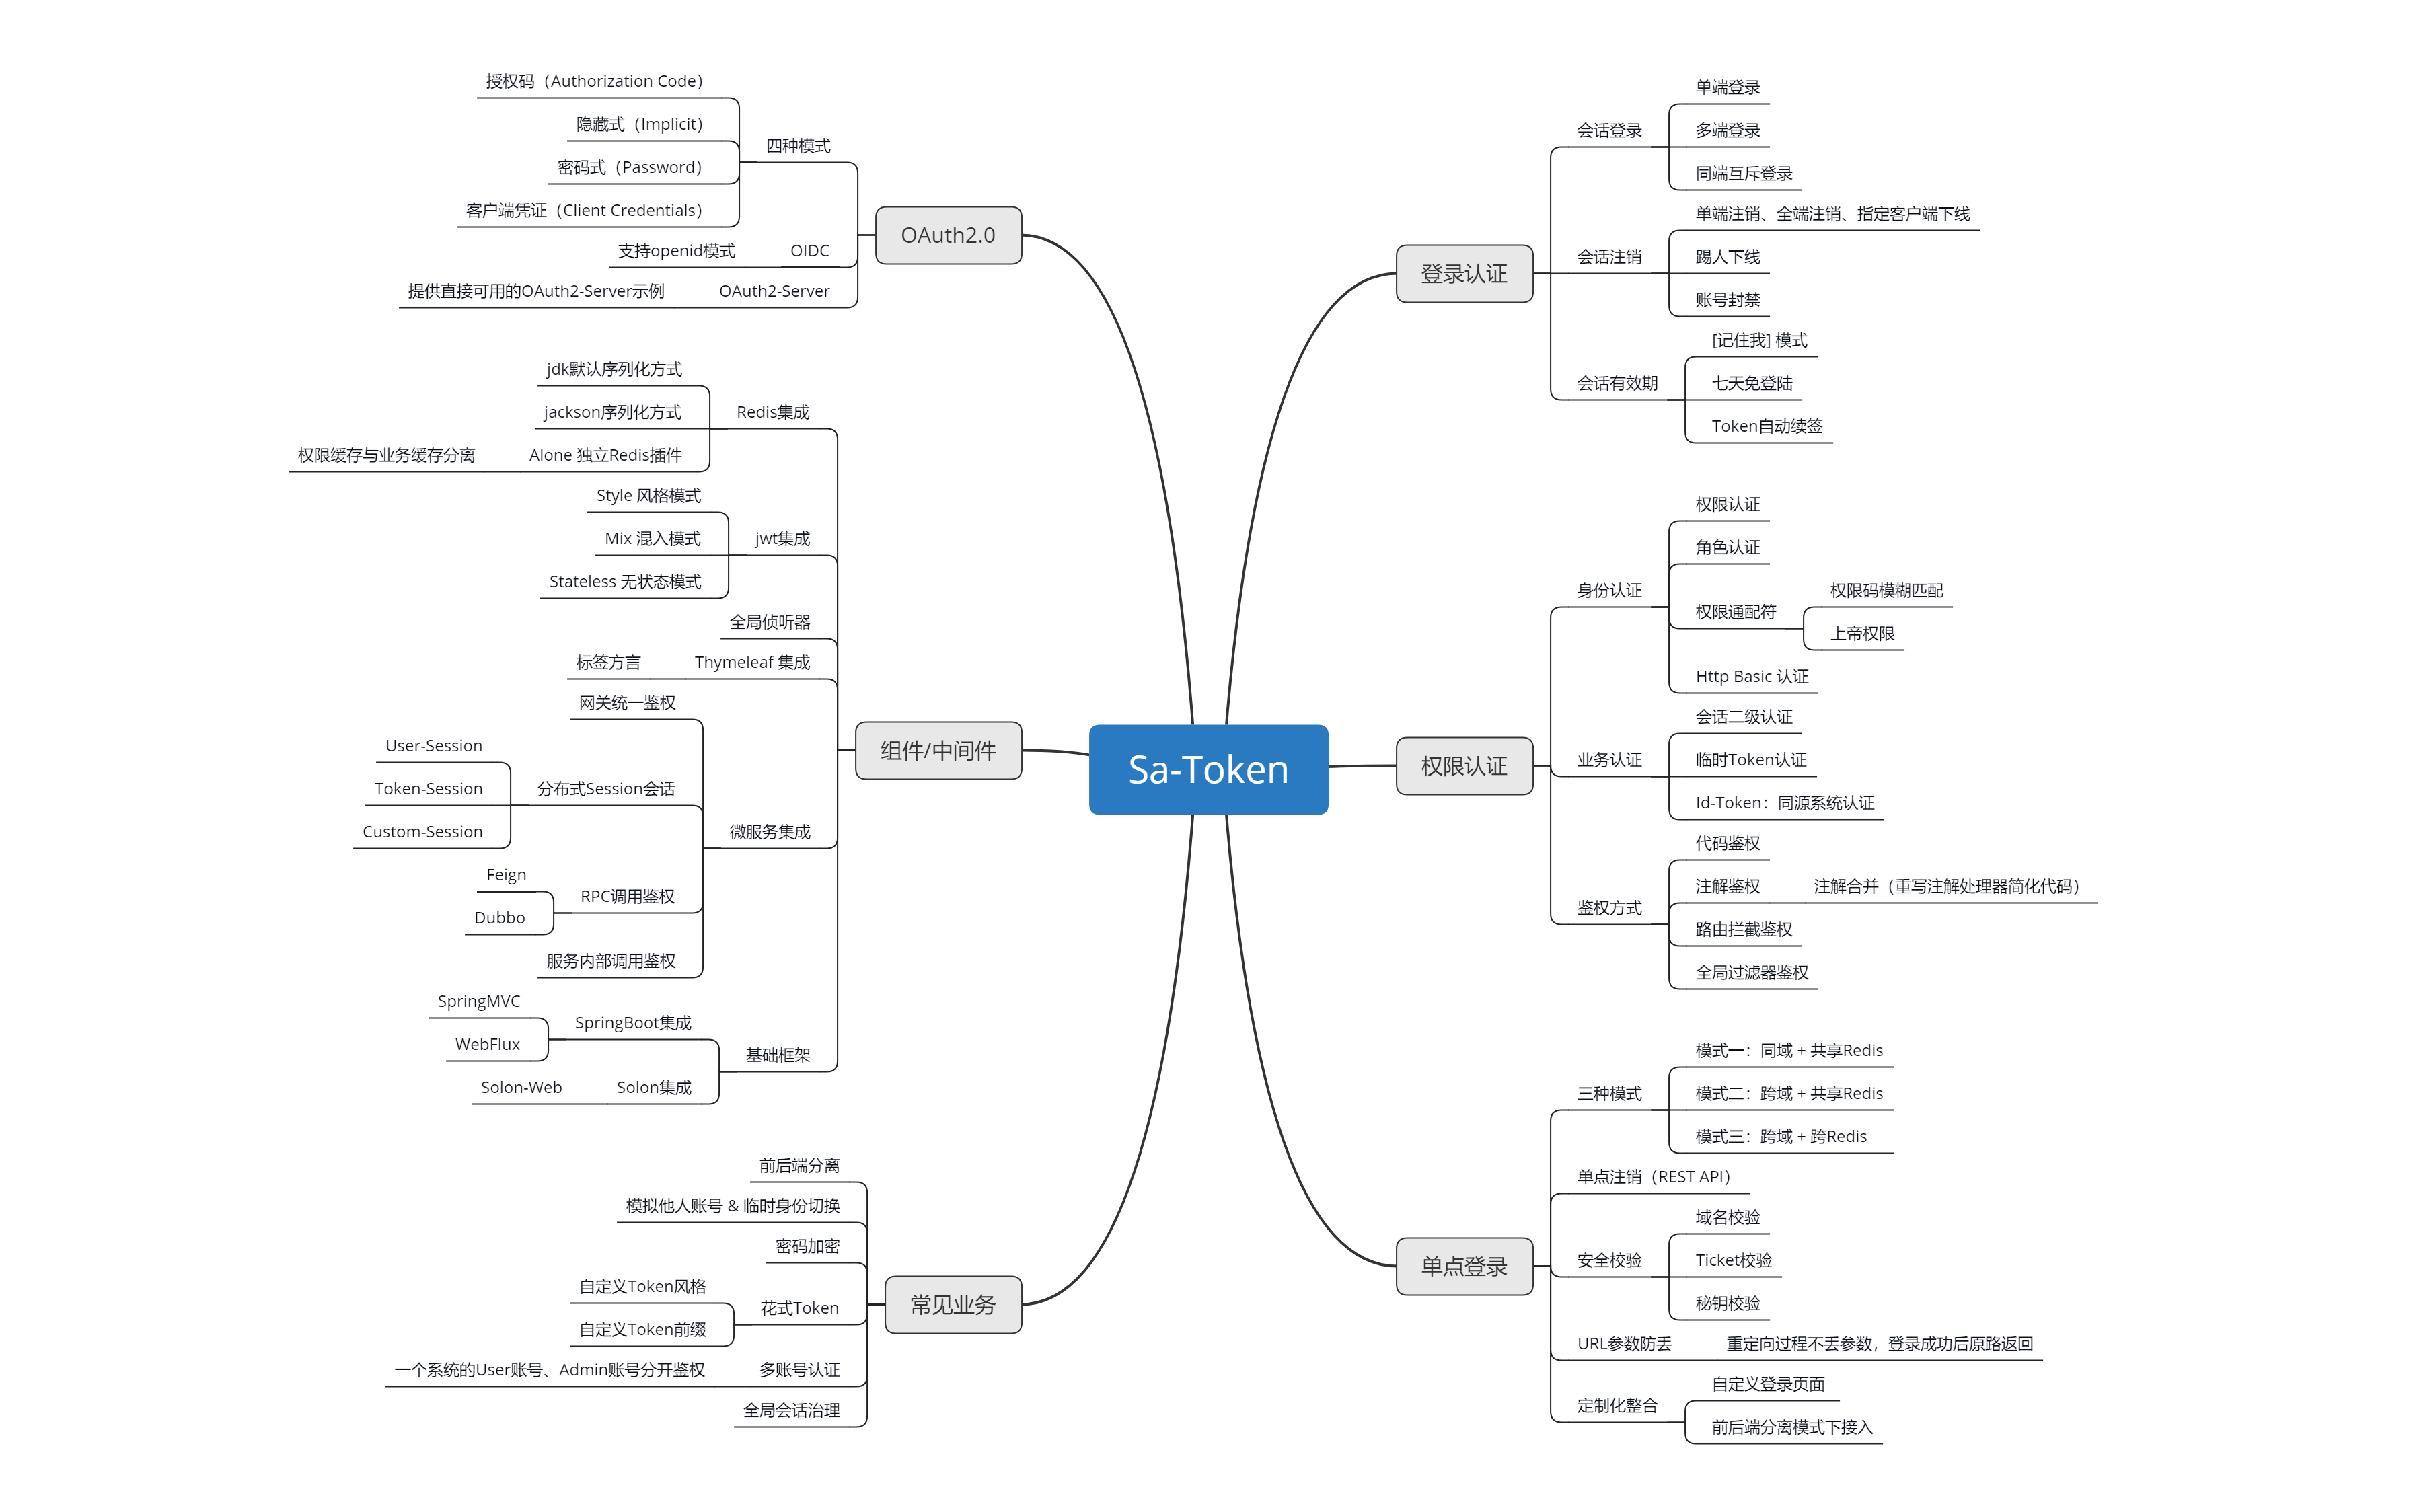
Sa-Token 是一个轻量级 Java 权限认证框架,主要解决:登录认证、权限认证、分布式 Session 会话、单点登录、OAuth2.0 等一系列权限相关问题。 框架针对踢人下线、自动续签、前后台分离、分布式会话……等常见业务进行N多适配,通过 Sa-Token,你可以以一种极简的方式实现系统的权限认证部分 Sa-Token v1.29.0 版本更新包括以下内容: 升级:sa-token-jwt插件可在登录时添加额外数据。 重构:优化Dubbo调用时向下传递Token的规则,可避免在项目启动时由于Context无效引发的bug。 重构:OAuth2 授权模式开放由全局配置和Client单独配置共同设定。 重构:OAuth2 模块部分属性支持每个 Client 单独配置。 重构:OAuth2 模块部分方法名修复单词拼写错误:converXxx -> convertXxx。 重构:修复 OAuth2 模块deleteAccessTokenIndex回收 token 不彻底的bug。 新增:OAuth2 模块新增pastClientTokenTimeout,用于指定 PastClientToken 默认有效期。 文档:常见报错章节增加目录树,方便查阅。 文档:优化文档样式。 新增:新增 BCrypt 加密。 修复:修复StpUtil.getLoginIdByToken(token) 在部分场景下返回出错的bug。 重构:优化OAuth2模块密码式校验步骤。 新增:新增Jackson定制版Session,避免timeout属性的序列化。 新增:SaLoginModel新增setToken方法,用于预定本次登录产生的Token。 新增:新增 StpUtil.createLoginSession() 方法,用于无Token注入的方式创建登录会话。 新增:OAuth2 与 StpUtil 登录会话数据互通。 新增:新增StpUtil.renewTimeout(100);方法,用于 Token 的 Timeout 值续期。 修复:修复默认dao实现类中updateObject无效的bug 完善:完善单元测试。 代码仓库:https://gitee.com/dromara/sa-token 框架功能结构图

优秀的个人博客,低调大师

每日一博 | 树莓派 4B 基于 Docker 搭建 DevOps 平台

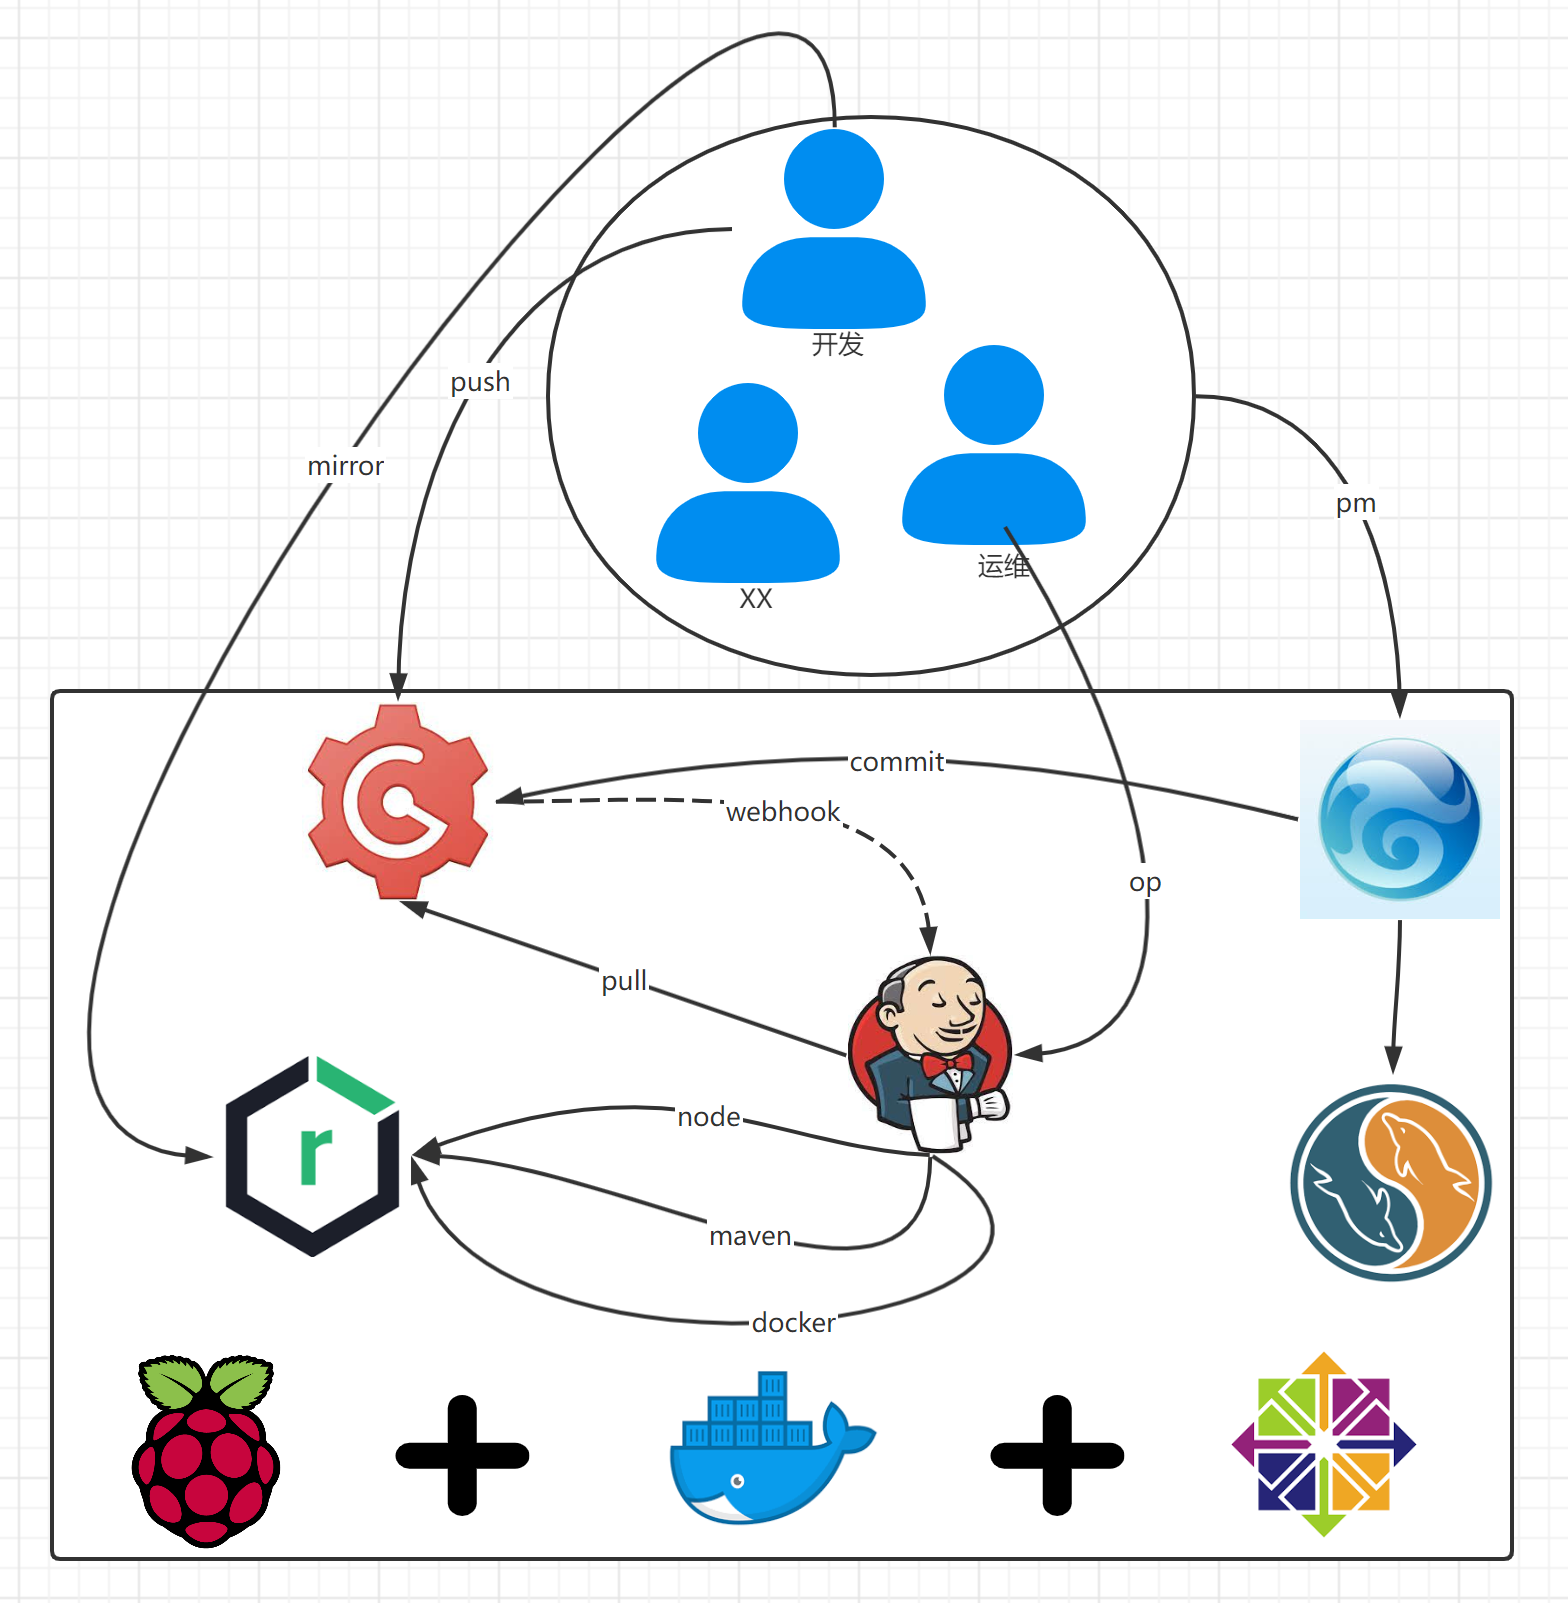
背景 在树莓派PI4B上用开源软件容器化部署一套devops平台,可以用来正常做代码管理、仓库管理、项目管理和CICD等开发、运维等研发活动。 准备 硬件:Raspberry Pi 4B(8g版本) OS:centos7.9 基础环境:19.03.8 IP:10.0.1.155 架构 工具链 用途 端口 MYSQL 服务于禅道 3306 禅道 项目管理 8085 gogs 代码管理 3000,100022 nexus maven、npm、docker私服 8081,8082,8083 jenkins 持续集成、持续部署 8080:5000 部署MYSQL 镜像 biarms/mysql:5.7.30-linux-arm64v8:支持arm64v8,树莓派可用 规划 配置目录:无 配置文件:/opt/server/mysql/my.cnf 数据目录:/opt/server/mysql/data/ 日志目录:/opt/server/mysql/data/ 开放端口:3306 配置文件 mkdir -p /opt/server/mysql vi /opt/server/mysql/my.cnf 写入 [mysqld] ## server_id=1 ## binlog-ignore-db=mysql ## log-bin=replicas-mysql-bin ## binlog_cache_size=1M ## binlog_format=mixed ## max_allowed_packet=125M max_connections=200 max_connect_errors=10000 datadir =/opt/mysql/data socket =/opt/mysql/data/mysql.sock lower_case_table_names = 1 #Encoding collation-server = utf8mb4_bin init-connect='SET NAMES utf8mb4' character-set-server = utf8mb4 log_error=error.log [client] default-character-set = utf8mb4 socket =/opt/mysql/data/mysql.sock :wq关闭保存 启动容器 docker run -d \ --name mysqld \ -p 3306:3306 \ --privileged=true --restart=always \ -e TZ=Asia/Shanghai -e MYSQL_ROOT_PASSWORD=Fast@1234 \ -v /opt/server/mysql/my.cnf:/etc/mysql/my.cnf \ -v /opt/server/mysql/data:/opt/mysql/data \ biarms/mysql:5.7.30-linux-arm64v8 部署禅道 镜像 pi4k8s/php-mysql:7.2-apache:支持arm64v8,树莓派可用 软件 https://dl.cnezsoft.com/zentao/16.0/ZenTaoPMS.16.0.zip 规划 配置目录:无 配置文件:无 数据目录:/opt/server/zentao/data/ 日志目录:无 开放端口:8085 启动容器 docker run -itd --name zentao \ -p 8085:80 \ --privileged=true --restart always \ -e TZ=Asia/Shanghai \ -v /opt/server/zentao/data:/var/www/html \ pi4k8s/php-mysql:7.2-apache 安装 cd /opt/server/zentao/data curl -O -L -s "https://dl.cnezsoft.com/zentao/16.0/ZenTaoPMS.16.0.zip" yum install -y unzip unzip ZenTaoPMS.16.0.zip rm -f ZenTaoPMS.16.0.zip 初始化服务 初始化服务 访问地址:http://10.0.1.155:8085/zentaopms/www/install.php 首次访问 点“开始安装”按钮,进入“授权协议”页面 点“下一步”,进入“系统检查”页面 继续点“下一步”,进入“生成配置文件”页面 在本页配置时区、默认语言和数据库服务器信息后,点“保存”按钮,如果配置没有问题,则进入配置文件确认页面 继续点“下一步”,禅道系统安装成功。 根据个人偏好可自行选择经典管理模式或者全新项目集群管理模式进行使用。 删除容器 docker stop zentao && docker rm zentao # 强制删除 docker rm -f zentao 日常运维 docker start zentao docker restart zentao docker stop zentao 备份相关 • 数据目录:opt/server/zentao/data/ 部署gogs 镜像 pi4k8s/gogs:0.12.3:支持arm64v8,树莓派可用 规划 配置目录:无 配置文件:/opt/server/gogs/data/gogs/conf/app.ini 数据目录:/opt/server/gogs/data 日志目录:/opt/server/gogs/data/logs 开放端口:3000,10022 启动容器 docker run -d --name=gogs \ -p 10022:22 -p 3000:3000 \ --privileged=true --restart=always \ -e TZ=Asia/Shanghai \ -v /opt/server/gogs/data:/data \ pi4k8s/gogs:0.12.3 初始化服务 访问地址:http://10.0.1.155:3000 首次访问主要需要配置三方面内容,分别是数据库配置、应用基本配置和可选配置,下面分别介绍 数据库配置 gogs可以选择支持的数据库类型为MySQL、PostgreSQL、SQLite3、MSSQL 或 TiDB,这里我们选择内置的SQLite3,具体配置如下: 应用基本配置 这部分基本采用默认值,域名和应用URL根据实际情况配置即可,本笔记中使用了宿主机IP作为记录。 可选配置 这部分主要提供了邮件服务器设置和一些其它设置,另外比较重要的就是需要设置一个管理员,其它设置根据实际情况配置即可。 配置完后,直接点“继续安装”按钮,就可以进入首页了。 变更服务 初始化服务后,会生成配置文件/opt/server/gogs/data/gogs/conf/app.ini,该文件内容完全对应初始化服务除管理员信息外的其它配置信息,如果后续需要修改具体配置,可以直接修改这个文件,修改后重启容器即生效。 删除容器 docker stop gogs && docker rm gogs # 强制删除 docker rm -f gogs 日常运维 docker start gogs docker restart gogs docker stop gogs 备份相关 数据目录:/opt/server/gogs/data/ 配置文件:/opt/server/gogs/data/gogs/conf/app.ini 部署nexus3 镜像 klo2k/nexus3:3.37.1-01:支持arm64v8,树莓派可用 规划 配置目录:无 配置文件:无 数据目录:/opt/server/nexus3/sonatype-work 日志目录:无 开放端口:8081,8082,8083 启动容器 mkdir -p /opt/server/nexus3/sonatype-work chown 200.200 /opt/server/nexus3/sonatype-work docker run -d --name=nexus3 \ -p 8081:8081 -p 8082:8082 -p 8083:8083 \ --privileged=true --restart=always \ -e TZ=Asia/Shanghai \ -v /opt/server/nexus3/sonatype-work:/opt/sonatype/sonatype-work \ klo2k/nexus3:3.37.1-01 初始化服务 访问地址:http://10.0.1.155:8081 首次访问 点sign in 弹出登录窗口如下 输入用户名和密码,点“sign in”按钮登录后显示安装窗口如下 点“Next”按钮进入下一步,显示设置新密码窗口如下 输入新密码后,点“Next”按钮进入下一步,显示设置是否允许匿名访问窗口如下 笔记中选择允许,点“Next”按钮进入下一步,显示安装完成界面如下 点“Finish”按钮,完成安装,接下来就可以正常使用nexus3了。 删除容器 docker stop nexus3 && docker rm nexus3 # 强制删除 docker rm -f nexus3 日常运维 docker start nexus3 docker restart nexus3 docker stop nexus3 备份相关 数据目录:/opt/server/nexus3/sonatype-work/ 部署jenkins 镜像 • pi4k8s/jenkins:openjdk8-2.327:支持arm64v8,树莓派可用 规划 • 配置目录:无 • 配置文件:无 • 数据目录:/opt/server/jenkins/data • 日志目录:无 • 开放端口:8080,50000 启动容器 docker run -d --name=jenkins \ -p 8080:8080 -p 50000:50000 \ --privileged=true --restart=always \ -e TZ=Asia/Shanghai \ -v $(which docker):/usr/bin/docker \ -v /var/run/docker.sock:/var/run/docker.sock \ -v /opt/server/jenkins/data:/root \ pi4k8s/jenkins:openjdk8-2.327 初始化服务 • 访问地址:http://10.0.1.155:8080 首次访问 输入密码后,点“继续”按钮 选择“安装推荐的插件”,进入下一步 根据网络情况,插件安装的时间各有差异,有可能会比较久。 但网络情况有时候是个比较忧伤的话题,如果确实安装没有什么进展,会显示下面一个令人有些沮丧的界面 如果安装顺利完成后,自动跳转下一步;如果真得离线了,那就跳过插件安装,也进入下一步如下 创建用户或者使用admin账户都可以,根据实际情况,继续进入下一步 根据实际情况配置jenkins URL,进入下一步 到这里,提示jenkins已就绪。 删除容器 docker stop jenkins && docker rm jenkins # 强制删除 docker rm -f jenkins 日常运维 docker start jenkins docker restart jenkins docker stop jenkins 备份相关 数据目录:opt/server/jenkins/data/ 关于离线安装 大多数情况下,因为网络原因,我们不得不选择离线安装模式。其实这里的离线安装主要指的就是插件离线安装,应对我们有两种方法:一个方法是通过修改插件更新中心地址,这个可以参考 https://jenkins-zh.cn/tutorial/management/plugin/update-center/ ;另外一个就是用其他方式下载插件,再把插件上传到jenkins。至于本笔记中需要用到的插件我已经打包 ,下载后解压到/opt/server/jenkins/jenkins_home即可。 另附解压命令供参考 cd /opt/server/jenkins/data/.jenkins tar -zxf plugins.tar.gz

优秀的个人博客,低调大师

CDN 搭建工具 GoEdge v0.2.9 发布,改进细节、修改 Bug

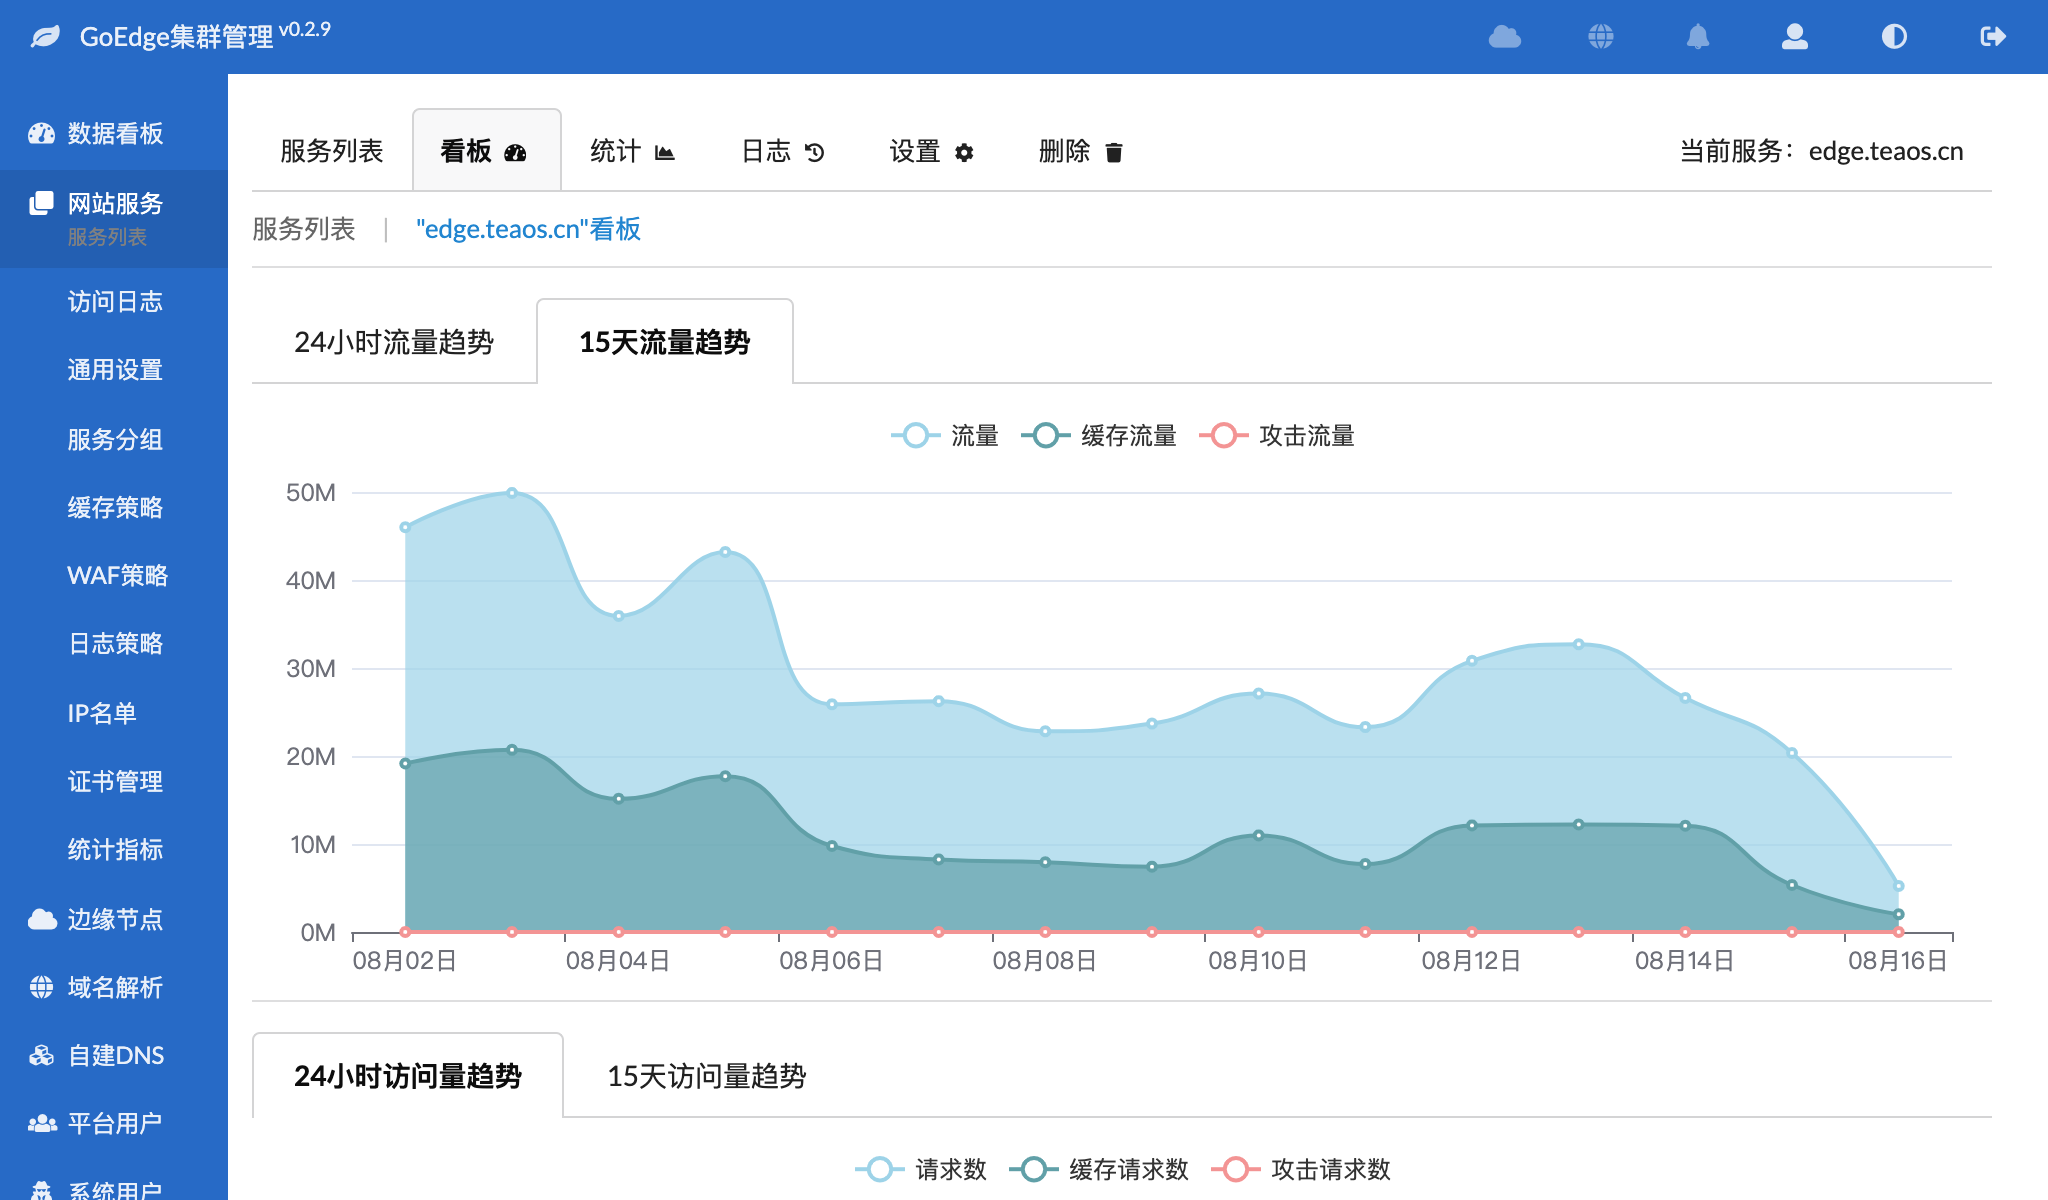
GoEdge是一款可以帮你快速构建 CDN & WAF 平台的工具,支持HTTP、HTTPS、TCP、TLS、UDP、IPv6、WAF等特性。 此版本主要改进细节、修复Bug。 注意:这个版本可能会重新记录一些统计数据。 EdgeAdmin 优化节点创建和安装流程 修复节点无法修改线路的Bug 优化代码/支持IP名单的更多格式的导入、导出 访问日志搜索增加域名和IP搜索 访问日志显示节点信息 增加全局服务访问日志 安全设置中增加允许记住登录选项 安全设置检查IP时同时也检查直接连接管理平台的上游IP 修复在MySQL8下安装提示无法创建edgeTest的问题 提升节点配置同步速度(从60秒提升到10秒以内) EdgeAPI 修复多个表unique key无法升级到问题 修复WAF检查IP状态可能会出现panic错误的Bug 边缘节点没有集群的时候视为删除 运行日志只显示已经设置集群的节点 下载:https://goedge.cn/downloads 文档:https://goedge.cn/docs

优秀的个人博客,低调大师

一文带你搭建简单的酒店推荐系统(附代码演练)

所有的在线旅行社都再努力满足亚马逊和Netflix制定的AI驱动的个性化标准。另外,世界各地的线上旅行系统竞争越发激烈,各个旅行商努力通过推荐、比较、匹配和分享来抓住我们的注意力和钱包。在这篇文章中,我们意在为那些在Expedia订旅馆的用户创建一个合适的旅店推荐系统。我们将该问题定义为一个多分类问题,然后建立并融合SVM模型和决策树模型取预测哪个“hotel cluster”是用户最想定的,并给予他详细的搜索信息。 1. 数据数据是匿名用户的,并且所有字段都是数字格式。数据可以在Kaggle中下载,train.csv中记录用户的行为,destinations.csv包含了用户的酒店信息。 import datetime import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns %matplotlib inline from sklearn.model_selection import cross_val_score from sklearn.ensemble import RandomForestClassifier from sklearn.pipeline import make_pipeline from sklearn import preprocessing from sklearn.preprocessing import StandardScaler from sklearn import svm 为了能够在本地运行,我们随机选取了1%的数据,但仍然有24179条数据。 df = pd.read_csv('train.csv.gz', sep=',').dropna() dest = pd.read_csv('destinations.csv.gz') df = df.sample(frac=0.01, random_state=99) df.shape 输出:(241179, 24) 2. 探索性分析该系统的目的是要根据用户的搜索信息,预测用户将会预定哪种旅馆。总共有100种。换言之,我们是要处理一个100分类问题。 plt.figure(figsize=(12, 6)) sns.distplot(df['hotel_cluster']) 图三可以看出每个类的分布很均匀。 3. 特征工程Checkin和checkout列的数据是时间格式的数据,不能直接使用。我们将从中提取出年份和月份。通过定义一个函数取抽取,并将他们合并到destination.csv中。 from datetime import datetime def get_year(x): if x is not None and type(x) is not float: try: return datetime.strptime(x, '%Y-%m-%d').year except ValueError: return datetime.strptime(x, '%Y-%m-%d %H:%M:%S').year else: return 2013 pass def get_month(x): if x is not None and type(x) is not float: try: return datetime.strptime(x, '%Y-%m-%d').month except: return datetime.strptime(x, '%Y-%m-%d %H:%M:%S').month else: return 1 pass def left_merge_dataset(left_dframe, right_dframe, merge_column): return pd.merge(left_dframe, right_dframe, on=merge_column, how='left') 处理时间格式的列: df['date_time_year'] = pd.Series(df.date_time, index = df.index) df['date_time_month'] = pd.Series(df.date_time, index = df.index) from datetime import datetime df.date_time_year = df.date_time_year.apply(lambda x: get_year(x)) df.date_time_month = df.date_time_month.apply(lambda x: get_month(x)) del df['date_time'] 处理srch_ci列: df['srch_ci_year'] = pd.Series(df.srch_ci, index=df.index) df['srch_ci_month'] = pd.Series(df.srch_ci, index=df.index) # convert year & months to int df.srch_ci_year = df.srch_ci_year.apply(lambda x: get_year(x)) df.srch_ci_month = df.srch_ci_month.apply(lambda x: get_month(x)) # remove the srch_ci column del df['srch_ci'] 处理srch_co列: df['srch_co_year'] = pd.Series(df.srch_co, index=df.index) df['srch_co_month'] = pd.Series(df.srch_co, index=df.index) # convert year & months to int df.srch_co_year = df.srch_co_year.apply(lambda x: get_year(x)) df.srch_co_month = df.srch_co_month.apply(lambda x: get_month(x)) # remove the srch_co column del df['srch_co'] 4. 初步分析在创建了一些新列和去除一些无用的列后,我们想要知道每一列跟类标是否有线性关系。这可以让我们更加关注一些特定的特征。 df.corr()["hotel_cluster"].sort_values() 图4可以看出所有的列都基本跟类标没什么线性关系。这意味着刚才的那些方法对这个问题并不合适。 5. 策略在快速的进行谷歌搜索之后,我们不难发现将目的地、旅馆国家、旅馆超市结合起来能够更加准确的帮助我们找到对应的类标。 pieces = [df.groupby(['srch_destination_id','hotel_country','hotel_market','hotel_cluster'])['is_booking'].agg(['sum','count'])] agg = pd.concat(pieces).groupby(level=[0,1,2,3]).sum() agg.dropna(inplace=True) agg.head() 图五 agg['sum_and_cnt'] = 0.85*agg['sum'] + 0.15*agg['count'] agg = agg.groupby(level=[0,1,2]).apply(lambda x: x.astype(float)/x.sum()) agg.reset_index(inplace=True) agg.head() 图六 agg_pivot = agg.pivot_table(index=['srch_destination_id','hotel_country','hotel_market'], columns='hotel_cluster', values='sum_and_cnt').reset_index() agg_pivot.head() 图七 df = pd.merge(df, dest, how='left', on='srch_destination_id') df = pd.merge(df, agg_pivot, how='left', on=['srch_destination_id','hotel_country','hotel_market']) df.fillna(0, inplace=True) df.shape 输出:(241179, 276) 6. 实现算法我们只对预定的样本有兴趣: df = df.loc[df['is_booking'] == 1] 得到特征和类标: X = df.drop(['user_id', 'hotel_cluster', 'is_booking'], axis=1) y = df.hotel_cluster 朴素贝叶斯: from sklearn.naive_bayes import GaussianNB clf = make_pipeline(preprocessing.StandardScaler(), GaussianNB(priors=None)) np.mean(cross_val_score(clf, X, y, cv=10)) 0.10347912437041926 KNN: from sklearn.neighbors import KNeighborsClassifier clf = make_pipeline(preprocessing.StandardScaler(), KNeighborsClassifier(n_neighbors=5)) np.mean(cross_val_score(clf, X, y, cv=10, scoring='accuracy')) 0.25631461834732266 随机森林: clf = make_pipeline(preprocessing.StandardScaler(), RandomForestClassifier(n_estimators=273,max_depth=10,random_state=0)) np.mean(cross_val_score(clf, X, y, cv=10)) 0.24865023372782996 多分类逻辑回归: from sklearn.linear_model import LogisticRegression clf = make_pipeline(preprocessing.StandardScaler(), LogisticRegression(multi_class='ovr')) np.mean(cross_val_score(clf, X, y, cv=10)) 0.30445543572367767支持向量机:很耗时,但是效果更好。 from sklearn import svm clf = make_pipeline(preprocessing.StandardScaler(), svm.SVC(decision_function_shape='ovo')) np.mean(cross_val_score(clf, X, y, cv=10)) 0.3228727137315005 看起来我们需要做更多的特征工程去优化结果。接下来将会进一步调优。 源代码在Github中找到。公众号后台回复 “1224” 获得Github直达链接。

优秀的个人博客,低调大师

深度解读展会场景智能推荐搭建之路 | 会展云技术解读

云妹导读: 在《会展云技术解读》专题中,我们已经推出了安全篇与设计篇,分别介绍了如何应对云上会展最严保障要求与线上展览中基于服务设计的方法,本篇文章云妹将继续为大家带来会展云中非常重要的一环——智能推荐系统。 在如今的互联网产品中智能推荐可谓无处不在,它可以根据用户每个人的性别、年龄、爱好等维度塑造静态用户画像,和用户每一次点击、点赞、评论、收藏等行为数据形成的动态用户画像相结合,来结合挖掘用户深层次兴趣需求维度。 我们常见的有新闻推荐和电商场景的商品推荐,展会场景推荐系统与之不同的是,它需要满足**参展商、采购商和个人用户**各方需求,尤其是像前不久举办的永不落幕的云上服贸会,首次采用线上+线下结合的模式,将服贸会影响辐射周期从集中的一周拉长至一整年,参展商、采购商以及正在寻找商机有需求的个人用户都可以随时随地浏览云上服贸会寻找有价值的商机。 服贸会注册展商近万家,涉及展品数量庞大,涉及**200多个子行业。如何让线上用户从大量的展商信息中快速找到自己想要的商机?如何保持有效商机的持续获取?这些问题是提升观展体验和逛展效率的关键行动。在这个过程中,京东智联云机器学习团队承担了云上服贸会智能推荐功能的开发**。 从上图可以看到,整个服贸会智能推荐系统包括四个模块的功能,同时服务官网2D店铺和手机APP端,可以做到用户级别的个性化推荐。针对服贸会的**展商、展台、展品、项目四项重要信息,智能推荐系统有对应的展商推荐、展台推荐、展品推荐和项目发布推荐**四个模块。 其中,展商、展台和展品推荐三个模块的功能引入了采购商和个人的用户画像、兴趣标签和行为等维度数据进行精准匹配。比较难实现的是项目发布的推荐,因为除了要考虑用户画像和兴趣标签等维度数据外,考虑到项目的及时性和强目的性,还需要高权重的引入内容维度的数据做推荐。 本次智能推荐功能落地过程中除了对于如何更精准的实现项目发布的推荐外,还有3大难题: 整个云上服贸,智能推荐呈现的内容承载近80%的用户“第一眼”,所以如何在第一时间给用户带来最佳的精准推荐是一个比较棘手的问题。加上本次是第一届云上服贸会,没有历史信息可以使用。怎么做才能最大价值用户的第一时间流量是整个项目期间持续思考的问题; 虽然整个云上服贸会注册参展商不如电商平台的量级大,但是在9月5日-9月9日线下展会期间是同样需要面对高并发和性能的挑战,好的架构系统设计是扛得住检验的坚实防线; 解决了“第一眼”的推荐,如何做好第二眼、第三眼……的推荐,除了做好用户画像,在参展内容刻画的不断探索。 同时,我们也在不断思考:对于“永不落寞的服贸会”如何持续做好后续的推荐?不同于互联网产品新闻推荐和电商场景的商品推荐,展会场景的推荐如何做出满足各方(参展商、采购商和个人用户)需求的推荐之路? 一,如何做好第一眼冷启动 目前市场上面向C端的用户产品如头条、淘宝和各家音乐APP等为了做好推荐过程的冷启动可谓各显神通——通过多途径尽可能地获取数据,比如首次注册的“关联微博/微信/QQ”账户;比如询问用户的偏好和感兴趣内容;比如基础的用户信息收集(性别、年龄、地域和所属行业等)。无论通过被动的信息获取还是主动的用户意向选择,都旨在补全对用户的认知,加上对分发内容精细化粒度的标签特征提取,可以实现冷启动的个性化推荐。 而冷启动推荐的另一个较高的门槛是:对用户场景和行为动机的深层理解,足够的知识库沉淀。 但云上服贸会的智能推荐场景,以上两条路似乎都不怎么好走。由于是首次参与展会类场景的推荐,即使看似推荐的产品和京东的商品相似,有展台和展品的划分,但是用户的群体画像和逛展意图有天壤之别。好在京东智联云长期以来一直赋能于ToB的业务,沉淀了对B端企业采购场景的认知。 尤其在2020年年初的疫情期间,为了给企业和政府提供高效的防疫装备采买,京东智联云推出了**“应急资源信息发布平台”。提供采购和发布供需信息的通道的同时,还为平台用户提供了基于供需诉求、地理位置、产品匹配度与数量、生产力和运输效率**等多维度的精准推荐。这些沉淀的供需场景知识刚好可以应用于本次云上服贸会的推荐。另一方面,我们对于用户画像和分发内容画像的理解和补全也做了很多功课,最终确保本次云上服贸会智能推荐的功能到成功亮相。 二,抗住高并发和性能挑战 面对高并发下的高性能要求,我们设计了基于Caffeine和Redis的多重缓存架构,接下来将从两个方面来介绍: 1,技术选型 为什么使用Caffeine+Redis?Redis不用多说,大家都太熟悉了。这里重点介绍下Caffeine,Caffeine是一个基于**Java8开发的提供了近乎最佳命中率的高性能缓存库。** 这里有人又会产生疑问,为什么不用Guava Cache呢?这种大家更熟悉基于LRU(The Least Recently Used)算法实现的本地化缓存难道不好吗? 虽然Guava Cache在过去应用更广泛,性能也还不错,但在日新月异的今天,总是会有更优秀、性能更好的缓存框架出现——就像Caffeine。另外再补充下,从Spring5(SpringBoot2)开始也使用Caffeine来取代Guava Cache。 为什么Caffeine的性能更好? 首先从淘汰算法说起,Guava Cache使用的是LRU。LRU实现比较简单,日常使用时也有着不错的命中率,它可以**有效的保护热点数据,**但对于偶发或周期性的访问,会导致偶发数据被保留,而真正的热点数据被淘汰,大大降低缓存命中率。为此Caffeine使用了Window TinyLFU算法。 在讲Window TinyLFU前,还需要再简单介绍下LFU。LFU算法解决了**LRU对于突发或周期性访问导致真实热点数据淘汰的问题,**但短时间对于某些数据的高频访问,会导致这些数据长时间驻留在内存中,进而在触发淘汰时,新加入的热点数据被错误的淘汰掉,最终导致命中率的下降。另外LFU还需要维护访问频次,每次访问都需要更新,造成巨大的资源开销。Window TinyLFU实际上吸取了LRU和LFU的优点,又规避了各自的缺点。 具体做法是:首先Window TinyLFU维护了一个近期访问记录的频次信息,作为一个过滤器,当新记录来时,只有满足TinyLFU要求的记录才可以被插入缓存。为了解决资源的高消耗问题,它通过**4-bit CountMinSketch**实现,这个算法类似于布隆过滤器,可以用很小的空间来存放大量的访问频次数据。这个设计给予每个数据项积累热度的机会,而不是立即过滤掉。这避免了持续的未命中,特别是在突然流量暴涨的的场景中,一些短暂的重复流量就不会被长期保留。为了刷新历史数据,一个时间衰减进程被周期性或增量的执行,给所有计数器减半。 而对于长期保存的数据,W-TinyLFU使用了Segmented LRU(缩写 SLRU)策略。在初始阶段,一个数据项会被存储在probationary segment中,在后续被访问时,它会被移到protected segment中。当protected segment内存不够时,有的数据会被淘汰回probationary segment,这也可能再次触发probationary segment的淘汰。这套机制确保了访问间隔小的热点数据被保存,而重复访问少的冷数据则被回收。 除此以外,在caffeine中读写都是通过异步操作,将事件提交至队列实现的,而队列的数据结构使用的是RingBuffer(高性能无锁队列Disruptor用的就是RingBuffer),所有的写操作共享同一个RingBuffer;而读取时,这块的设计思想是类似于Striped64,每一个读线程对应一个RingBuffer,从而避免竞争。 下面是官方性能测试对比: 1、读(100%) 2、读(75%) / 写 (25%) 3、写 (100%) 2,多级缓存设计 Redis作为常用的缓存,虽然性能非常优秀,但随着数据量的增长,数据结构的复杂,在叠加高并发场景时,不管是网络IO的消耗,还是Redis单节点的瓶颈,都会对整个调用链的性能造成不可忽视的影响。所以我们既需要Caffeine作为JVM级别的缓存,也需要Redis作为我们的二级缓存,这种多级的缓存设计才能最终满足我们的需要。 在Java世界中,我们最常用的就是基于Spring Cache来实现应用缓存,但Spring Cache仅支持单一缓存来源,并无法满足多级缓存的场景。因此我们需要**通过实现CacheManager接口来定义自己的多级缓存CacheManager,同时还需要实现自己的Cache类(继承AbstractValueAdaptingCache),**在这里面将CaffeineCache和RedisTemplate类以及相关的一些策略配置注入进去,这样我们就可以自己实现想要的get、put方法:多级缓存的读和写。 在数据一致性的设计上,这块主要依赖于**Redis的发布订阅模式,**也就是将所有的更新、删除都通过该模式通知其他节点去清理本地缓存,当然因为CAP的关系,这种设计是无法保证数据的强一致性的,所以我们也只能尽可能的去保证数据的最终一致性。 三,AI知你所想,推你所愿 在会展云中,我们采用了**用户画像、信息画像、关键词匹配**等技术实现个性化推荐。其中,用户画像是通过用户的注册信息、兴趣标签、浏览偏好等数据进行构建。信息画像包括了展商画像、展台画像、展品画像和项目画像四部分,前三部分各自构建又互相利用了对方的信息,如展商的收藏、浏览等数据会添加该企业对应展台和展品的数据,展品的行业信息需要从展商画像中获取,三部分数据融合建模,从而构建了更加丰富的画像。 关键词匹配技术主要应用于**行业名称和交易类型关键词的匹配,通过该技术可以将不标准的信息规范化。**该系统还针对冷启动场景进行了优化,当用户和信息数据不足时,系统可以根据仅有的用户注册信息和参展商的行业信息进行匹配,并考虑信息的热度进行排序。 本次服贸会实现了对数十万用户提供个性化推荐服务,针对新注册的用户和新发布的信息也可以通过冷启动方案快速实现智能推荐。推荐系统采用了通用的**召回和排序架构,召回部分将采用协同过滤、矩阵分解等模型,可以快速从海量数据中粗筛出候选集;排序部分采用更复杂且准确率较高的深度学习**模型,如业界常用的Wide&Deep、DeepFM等先进模型,实现对候选集每个信息的精准排序,为服贸会的用户和参展商提供准确和稳定的服务。 在模型选择上,我们使用DIN(Deep Interest Network)模型。在正式介绍模型之前,先来介绍一下Attention机制。 Attention机制是**模仿人类注意力而提出的一种解决问题的办法,**简单地说就是从大量信息中快速筛选出高价值信息,即一种将内部经验和外部感觉对齐从而增加部分区域的观察精细度的机制。 例如人的视觉在处理一张图片时,会通过快速扫描全局图像,获得需要重点关注的目标区域,也就是注意力焦点。然后对这一区域投入更多的注意力资源,以获得更多所需要关注的目标的细节信息,并抑制其它无用信息。图1中对Attention机制进行了图示,其中亮白色区域表示更关注的区域。 ▲图1 注意力机制直观展示图▲ Attention机制的具体计算过程见图2。对目前大多数Attention方法进行抽象,可以将其归纳为两个过程、三个阶段: 第一个过程是根据query和key计算权重系数: (1)第一个阶段根据query和key计算两者的相似性或者相关性; (2)第二个阶段对第一阶段的原始分值进行归一化处理。 第二个过程根据权重系数对value进行加权求和: ▲图2 三阶段计算Attention过程▲ 利用候选参展商品和用户历史行为之间的相关性计算出一个权重,这个权重就代表了“注意力”的强弱。DIN设计了局部激活单元,激活单元会计算候选参展商品与用户最近N个历史行为商品的相关性权重,然后将其作为加权系数对N个行为商品的embedding向量做sum pooling。 用户的兴趣由加权后的embedding来体现。权重是根据候选参展商品和历史行为共同决定的,同一候选商品对不同用户历史行为的影响是不同的,与候选商品相关性高的历史行为会获得更高的权重。可以看到,激活单元是一个多层网络,输入为用户画像embedding向量、信息画像embedding向量以及二者的叉乘。 DIN模型大致分为以下五个部分: **Embedding Layer:**原始数据是高维且稀疏的0-1矩阵,emdedding层用于将原始高维数据压缩成低维矩阵; **Pooling Layer :**由于不同的用户有不同个数的行为数据,导致embedding矩阵的向量大小不一致,而全连接层只能处理固定维度的数据,因此利用Pooling Layer得到一个固定长度的向量; **Concat Layer:**经过embedding layer和pooling layer后,原始稀疏特征被转换成多个固定长度的用户兴趣的抽象表示向量,然后利用concat layer聚合抽象表示向量,输出该用户兴趣的唯一抽象表示向量; **MLP:**将concat layer输出的抽象表示向量作为MLP的输入,自动学习数据之间的交叉特征; **Loss:**损失函数一般采用Logloss; DIN认为用户的兴趣不是一个点,而是一个多峰的函数。一个峰就表示一个兴趣,峰值的大小表示兴趣强度。那么针对不同的候选参展商品,用户的兴趣强度是不同的,也就是说随着候选商品的变化,用户的兴趣强度不断在变化。 总的来说,DIN通过**引入attention机制,**针对不同的商品构造不同的用户抽象表示,从而实现了在数据维度一定的情况下,更精准地捕捉用户当前的兴趣。 以上,是我们为本次服贸会智能推荐板块提供的技术支持和思考,本次服贸会作为首届**“永不落幕”**服贸会,同样,我们在技术之路的深耕和追逐的脚步一刻也不敢懈怠,不断思考持续探索,不忘初心未来可期。 推荐阅读: 基于服务设计的线上展览 | 会展云技术解读 多重安全保障护航云上会展 | 会展云技术解读 让黑产无处遁形:京东智联云推出风险识别服务 欢迎点击【京东智联云】,了解京东会展云服务 更多精彩技术实践与独家干货解析 欢迎关注【京东智联云开发者】公众号

优秀的个人博客,低调大师

阿里云服务器搭建及项目部署过程---小白篇

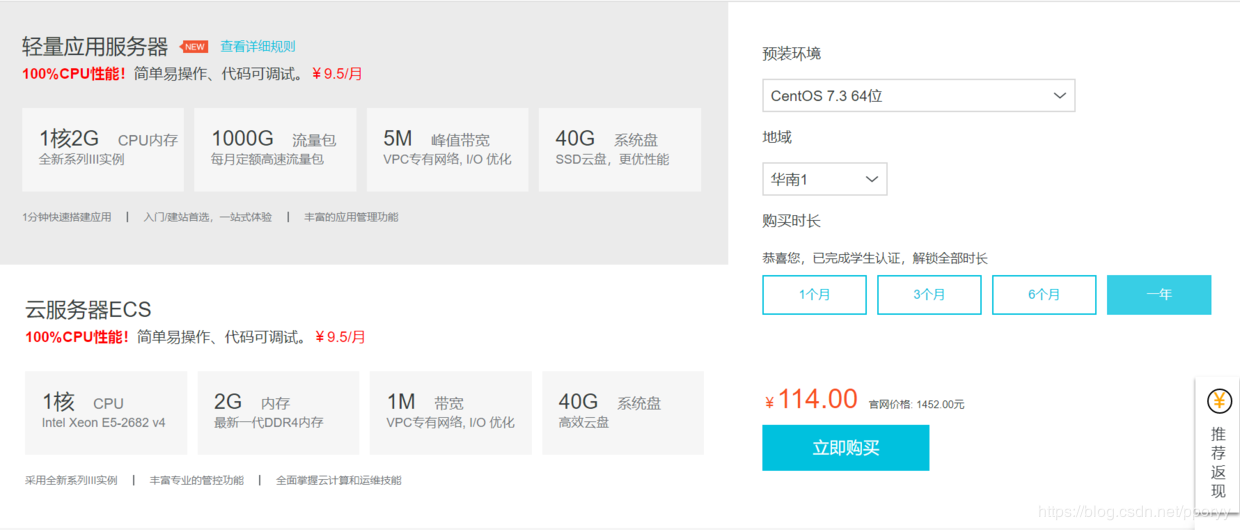
最近学习了前后端的相关技术,就想租一个服务器试一下,玩一玩,简单了解了一下阿里云的服务器,简单介绍一下: 一:什么是云服务器ECS 是阿里云产品体系中,最基础的计算服务,通常用作应用程序的运行环境,最重要的特点是弹性。 二:基础运行环境 用户的应用程序运行在实例的操作系统上1三:特点 弹性:容量不够可以直接在云服务器上扩展配置,只要直接补差价 1成本:0运维,支持包年包月或按量计费。无需服务器网络和硬件等维护 自动迁移: 通过快照备份恢复你的数据 OK,接下来简单说一下从购买到部署的全过程。 一、购买服务器 学生的话,阿里推出了一个叫云翼计划的产品,通过学生认证之后可以享受超便宜的价格,云翼计划的入口在这儿云翼计划,阿里云官网 1、首先要进行登录,如果没有账号可以进行免费注册,默认24岁以下都是学生,学生可以选择学生套餐,云翼计划 服务器购买如上图,我选择的下边这款服务器,操作系统选择的是linux版的centOS7.3 64位的操作系统,操作系统可以根据自己的习惯爱好来选择,Windows和linux各有优缺点,大家可以查阅资料去了解一下,选择适合自己的操作系统,然后进行购买即可。 如果有兴趣的话,可以再去注册购买自己的域名,后续我肯定也会的,今天为了简单,没有去注册域名。域名的注册和购买过程网上也有教程。1二、管理云服务器: 服务器实例购买完成后,看到的服务器样子应该是这样的,大家可以点击最后的更多来重置密码和设置远程登录密码。 管理云服务器的软件有很多,有XShell,Putty,SecureCRT等,大家可以根据自己的习惯来选择,我这里选择的是XShell,还有通过XFTP软件可以进行和云服务器的文件传输,附上下载地址 XShell 和Xftp下载地址(这两个软件可以免费试用一个月,可以购买,也有非商业用途的免费使用) 免费使用下载完成后,安装也很简单,没有特别要求的话,一切都默认即可 安装完成后,运行XShell 新建连接点击确定 然后输入自己的用户名用户名一般默认是root 输入密码然后输入自己的登录密码,可以在阿里云官网重置修改。 登录成功登录成功后,会出现如图界面,#代表当前是超级用户。然后就可以进行一些配置和操作了。 因为要部署java项目,所以必须有jdk和服务器,服务器用的是Tomcat。 当前目录在root目录下,关于linux的目录结构这里就不说了,我在root目录下新建了一个java目录,在java目录下,新建了两个文件夹,一个jdk,一个tomcat,如图 可以使用XFtp进行文件的传输,连接XFtp和连接XShell一样 XFtp创建的文件夹 Xshell终端窗口接下来需要下载jdk jdk下载(注意选择linux版本) 这是我选择的版本然后下载Tomcat,我下载的是Tomcat8 tomcat下载(注意下载tar.gz) 我下载的版本 下载完成后,分别进行解压 解压命令: tar-zxvf jdk-版本编号-linux-x64.tar.gz-C tar -xvf apache-tomcat-版本编号.tar.gz -C解压完成后,配置jdk的环境变量 vi /etc/profile export JAVA_HOME=/usr/java/jdk/jdk版本编号_121 export JRE_HOME=/usr/java/jdk/jdk版本编号_121/jre export CLASSPATH=.:JAVAHOME/lib JAVA_HOME/libJAVA H​ OME/lib:JRE_HOME/lib:$CLASSPATH export PATH=JAVAHOME/bin: JAVA_HOME/bin:JAVA H​ OME/bin:JRE_HOME/bin/JAVAHOME: JAVA_HOME:JAVA H​ OME:PATH 用的是vi编辑,输入i进行插入,输入完成后,按下esc键,然后输入:wq!就可以了。 编辑完成后,输入 source /etc/profile 然后输入java -version来检查是否环境变量配置成功 jdk配置成功后,然后就行tomcat的配置,进入tomcat的bin目录下, 输入 vi setclaspath.sh 添加以下两条命令 export JAVA_HOME=/usr/java/jdk/jdk版本编号 export JRE_HOME=/usr/java/jdk/jdk版本编号/jre 添加成功后,保存退出。 配置工作基本结束,然后在bin目录下,启动tomcat, 输入 ./startup.sh 启动tomcat可以看到tomcat已经成功启动,接下来就可以直接访问了,在浏览器中输入http://+自己的ip+:8080就可以看到小猫咪了(如果访问不了,就要去管理安全组,开放一下8080端口,怎么配置规则网上有,就不在这里说了)

优秀的个人博客,低调大师

可视化页面搭建平台码良更新,新增轮播组件

桌面端轮播组件 配置 显示指示器 切换是否显示轮播器下方的指示器 自动轮播 切换是否自动轮播 切页方式 切换通过指示器切页的方式,有点击和悬浮可选 箭头显示 切换轮播器左右的箭头的显示方式,有始终显示、始终不显示、鼠标进入即显示 风格 轮播器的展示风格,有卡片式和普通可选 切页回调 设置页面切换时的回调方法 千万不要选择“切换到上一页”或者“切换到下一页”,否则会造成死循环,浏览器不响应,千万不要尝试!!! 子组件 推荐使用“空容器”组件作为直接子组件,每一个直接子组件作为一个轮播页展示。 在组件树中点击上述子组件可以切换到相应轮播页 方法 本组件暴露出三个方法,可供其他组件或脚本调用。 “切换到上一页” 代码调用$vm.prev() “切换到下一页” 代码调用$vm.next() “切换到指定页” 代码调用$vm.setActiveItem(index) 项目代码:https://github.com/ymm-tech/gods-pen 官网:https://godspen.ymm56.com/

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册