AI:是猫还是狗,这是个问题
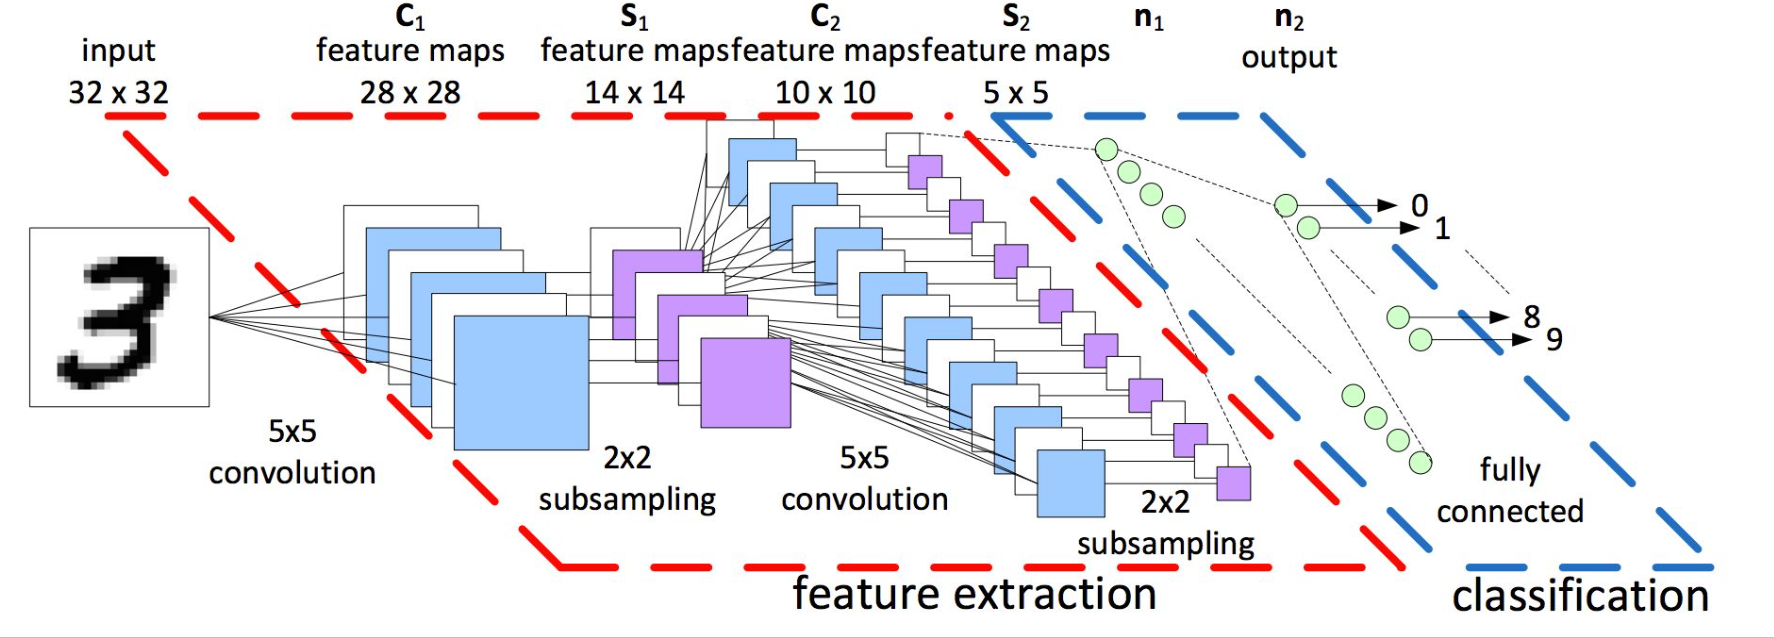
如果你不喜欢小猫和小狗,你可能不知道他们具体是哪一种品种,但是一般来说,你都能区分出这是猫还是狗,猫和狗的特征还是不一样的,那我们如何用机器学习的方法训练一个网络区分猫狗呢? 我们选用的是 Kaggle 的一个数据集(https://www.kaggle.com/c/dogs-vs-cats/data),用神经网络的方法进行模型的训练。下载下来的数据集对于我们测试来说数据有点大,这里面分别有 12500 个猫和狗的训练图片,我们先来缩小一下训练集,然后再进行模型的搭建和训练。我们的做法做法是猫和狗分别选择 1000 个训练图片,500 个验证集和 500 个测试集,我们可以手工完成这个工作,需要做的就是: // 如下非可执行代码,含义非常清楚的表达,最后会附上可执行代码 mkdir dog-vs-cats-small cp dog-vs-cats/train/cat/pic-{0-999}.jpg dog-vs-cats-small/train/cat/ cp dog-vs-cats/train/dog/pic-{0-999}.jpg dog-vs-cats-small/train/dog/ cp dog-vs-cats/validation/cat/pic-{1000-1499}.jpg dog-vs-cats-small/validation/cat/ cp dog-vs-cats/validation/dog/pic-{1000-1499}.jpg dog-vs-cats-small/validation/dog/ cp dog-vs-cats/test/cat/pic-{1500-1999}.jpg dog-vs-cats-small/test/cat/ cp dog-vs-cats/test/dog/pic-{1500-1999}.jpg dog-vs-cats-small/test/dog/ 从我们前面文章的经验中,我们可以知道,这个卷积神经网络我们可以用 relu 激活的 Conv2D 层与 MaxPooling2D 层堆叠而成,与之前相比稍微需要修改就是网络的大小,更大的网络处理更多是数据。 卷积神经网络网络的深度往往与特征图的尺寸负相关,越深的网络每个特征图的尺寸往往是越小的,我看到的数据往往是:深度 32-> 128,特征图尺寸 150x150 -> 7x7。如下,这是我们构架的网络: 优化器依旧采用 RMSprop,学习率由默认的 0.001 设置为 0.0001,后续我们也将 对不同的优化器进行介绍。由于需要输出的结果是“猫 or 狗”,所以我们最后一层激活参数为 sigmoid,自然损失函数就为 binary_crossentropy 了,如此一来,网络就构建好了,接下来就应该喂给网络数据了。 由于我们这里是一张又一张的图片,jpg 格式,这可不是我们网络所喜欢的格式,需要进行处理,读出图片,将其解码为 RGB 像素,再将 RGB 中的像素值转换成浮点数进行计算,又由于我们的网络对于处理 0-1 之间的数效果更好,因此我们需要将像素值转换区间,即从 0-255 转换到 0-1,是不是觉得有点麻烦,确实!Keras 之所以说是最容易上手的深度学习框架,就是因为它同样把这些繁琐但是使用的工具内置了,Image 包下的 ImageDataGenerator 就可以帮上大忙,这样我们就可以得到 RGB 图像与二进制标签组成的批量。 接下来,我们就要对数据进行拟合了,fit_generator,上面的生成器也将传给它,这样,这一个网络我们就建立完成了,可以进行训练了,与前文一样,我们仍然画出损失曲线和精度曲线。 训练精度逐渐接近百分之百,提醒我们注意过拟合的危险;训练精度在第五次(或六次)次后就维持在 70%左右不再上升了。 第五次或第十次后,验证损失就达到了最小值,嗯……,很显然,过拟合了,我们需要降低过拟合。 出现过拟合的原因是学习样本太少了,我们采用 **数据增强 **来解决这个问题。我们的做法就是在现有的训练数据中生成更多的训练数据,就是增加一些随机变换,这种随机变化生成的图片依然要保证是有效的。这样模型在训练的时候就可以看到不同的更多的图像了,这就使得训练出的模型泛化能力更好。怎么做呢,就可以把图片进行随机的旋转,缩放,平移和翻转等,ImageDataGenerator 提供了这样的能力。同时在密集层之前添加一个 Dropout 层,会更好的降低过拟合,如此一来,看看结果: 可以看出来,效果好了很多。训练精度至少可以到达 80%,再想大幅度提高精度,就需要一些其他的方法了,下一篇文章我们再聊。 老规矩,附上全部代码: #!/usr/bin/env python3 import os import shutil import time import matplotlib.pyplot as plt from keras import layers from keras import models from keras import optimizers from keras.preprocessing.image import ImageDataGenerator def make_small(): original_dataset_dir = '/Users/renyuzhuo/Desktop/cat/dogs-vs-cats/train' base_dir = '/Users/renyuzhuo/Desktop/cat/dogs-vs-cats-small' os.mkdir(base_dir) train_dir = os.path.join(base_dir, 'train') os.mkdir(train_dir) validation_dir = os.path.join(base_dir, 'validation') os.mkdir(validation_dir) test_dir = os.path.join(base_dir, 'test') os.mkdir(test_dir) train_cats_dir = os.path.join(train_dir, 'cats') os.mkdir(train_cats_dir) train_dogs_dir = os.path.join(train_dir, 'dogs') os.mkdir(train_dogs_dir) validation_cats_dir = os.path.join(validation_dir, 'cats') os.mkdir(validation_cats_dir) validation_dogs_dir = os.path.join(validation_dir, 'dogs') os.mkdir(validation_dogs_dir) test_cats_dir = os.path.join(test_dir, 'cats') os.mkdir(test_cats_dir) test_dogs_dir = os.path.join(test_dir, 'dogs') os.mkdir(test_dogs_dir) fnames = ['cat.{}.jpg'.format(i) for i in range(1000)] for fname in fnames: src = os.path.join(original_dataset_dir, fname) dst = os.path.join(train_cats_dir, fname) shutil.copyfile(src, dst) fnames = ['cat.{}.jpg'.format(i) for i in range(1000, 1500)] for fname in fnames: src = os.path.join(original_dataset_dir, fname) dst = os.path.join(validation_cats_dir, fname) shutil.copyfile(src, dst) fnames = ['cat.{}.jpg'.format(i) for i in range(1500, 2000)] for fname in fnames: src = os.path.join(original_dataset_dir, fname) dst = os.path.join(test_cats_dir, fname) shutil.copyfile(src, dst) fnames = ['dog.{}.jpg'.format(i) for i in range(1000)] for fname in fnames: src = os.path.join(original_dataset_dir, fname) dst = os.path.join(train_dogs_dir, fname) shutil.copyfile(src, dst) fnames = ['dog.{}.jpg'.format(i) for i in range(1000, 1500)] for fname in fnames: src = os.path.join(original_dataset_dir, fname) dst = os.path.join(validation_dogs_dir, fname) shutil.copyfile(src, dst) fnames = ['dog.{}.jpg'.format(i) for i in range(1500, 2000)] for fname in fnames: src = os.path.join(original_dataset_dir, fname) dst = os.path.join(test_dogs_dir, fname) shutil.copyfile(src, dst) def cat(): base_dir = '/Users/renyuzhuo/Desktop/cat/dogs-vs-cats-small' train_dir = os.path.join(base_dir, 'train') validation_dir = os.path.join(base_dir, 'validation') model = models.Sequential() model.add(layers.Conv2D(32, (3, 3), activation='relu', input_shape=(150, 150, 3))) model.add(layers.MaxPooling2D((2, 2))) model.add(layers.Conv2D(64, (3, 3), activation='relu')) model.add(layers.MaxPooling2D((2, 2))) model.add(layers.Conv2D(128, (3, 3), activation='relu')) model.add(layers.MaxPooling2D((2, 2))) model.add(layers.Conv2D(128, (3, 3), activation='relu')) model.add(layers.MaxPooling2D((2, 2))) model.add(layers.Flatten()) model.add(layers.Dropout(0.5)) model.add(layers.Dense(512, activation='relu')) model.add(layers.Dense(1, activation='sigmoid')) model.summary() model.compile(loss='binary_crossentropy', optimizer=optimizers.RMSprop(lr=1e-4), metrics=['acc']) # train_datagen = ImageDataGenerator(rescale=1. / 255) train_datagen = ImageDataGenerator( rescale=1. / 255, rotation_range=40, width_shift_range=0.2, height_shift_range=0.2, shear_range=0.2, zoom_range=0.2, horizontal_flip=True, ) test_datagen = ImageDataGenerator(rescale=1. / 255) train_generator = train_datagen.flow_from_directory( train_dir, target_size=(150, 150), batch_size=32, class_mode='binary') validation_generator = test_datagen.flow_from_directory( validation_dir, target_size=(150, 150), batch_size=32, class_mode='binary') history = model.fit_generator( train_generator, steps_per_epoch=100, epochs=100, validation_data=validation_generator, validation_steps=50) model.save('cats_and_dogs_small_2.h5') acc = history.history['acc'] val_acc = history.history['val_acc'] loss = history.history['loss'] val_loss = history.history['val_loss'] epochs = range(len(acc)) plt.plot(epochs, acc, 'bo', label='Training acc') plt.plot(epochs, val_acc, 'b', label='Validation acc') plt.title('Training and validation accuracy') plt.legend() plt.show() plt.figure() plt.plot(epochs, loss, 'bo', label='Training loss') plt.plot(epochs, val_loss, 'b', label='Validation loss') plt.title('Training and validation loss') plt.legend() plt.show() if __name__ == "__main__": time_start = time.time() # make_small() cat() time_end = time.time() print('Time Used: ', time_end - time_start) > 首发自公众号:RAIS