首页 文章 精选 留言 我的

精选列表

搜索[搭建],共10000篇文章
优秀的个人博客,低调大师

【Elasticsearch全文搜索引擎实战】之集群搭建及配置

文中Elasticsearch版本为6.0.1 1. 环境配置 把环境配置放在第一节来讲,是因为很多人按官网的Getting Started安装运行会有各种错误。其实都是因为一些配置不正确引起的。 首先,Elasticsearch不能以root账号运行,所以我们需要单独建立用户授权运行。 对于非root账号Linux可以进行并发操作,但是文件、线程都有限制,所以,部署Elasticsearc的机器需要进行相应配置。 修改文件限制 # 修改系统文件 vi /etc/security/limits.conf # 增加的内容 * soft nofile 65536 * hard nofile 65536 * soft nproc 2048 * hard nproc 4096 调整进程数 # 修改系统文件 vi /etc/security/limits.d/90-nproc.conf # 调整成以下配置 * soft nproc 4096 root soft nproc unlimited 调整虚拟内存&最大并发连接 # 修改系统文件 vi /etc/sysctl.conf # 增加的内容 vm.max_map_count=655360 fs.file-max=655360 保存之后执行 sysctl -p 生效 创建Elasticsearch专用用户 useradd es 创建ELK相关目录并赋权 #创建Elasticsearch APP目录 mkdir /usr/elasticsearch #创建Elasticsearch日志目录 数据目录 mkdir var/lib/elasticsearch #创建Elasticsearch日志目录 mkdir var/logs/elasticsearch #更改目录Owner chown -R es:es /usr/elasticsearch chown -R es:es var/lib/elasticsearch chown -R es:es var/logs/elasticsearch 下载Elasticsearch包并解压 https://www.elastic.co/guide/en/elasticsearch/reference/current/zip-targz.html #打开文件夹 cd /home/download #下载 wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.0.1.tar.gz #解压 tar -zvxf elasticsearch-6.0.0.tar.gz 2. Elasticsearch 部署 本次一共要部署两个Elasticsearch节点,所有文中没有指定机器的操作都表示每个Elasticsearch机器都要执行该操作 移动Elasticsearch到统一目录 #移动目录 mv /home/download/elasticsearch-6.0.1 /usr/elasticsearch #赋权 chown -R elk:elk /usr/elasticsearch/ 开放端口(CentOS7+) # 增加端口 firewall-cmd --add-port=9200/tcp --permanent firewall-cmd --add-port=9300/tcp --permanent 重新加载防火墙规则(CentOS7+) firewall-cmd --reload 切换账号 #账号切换到 es su - es 2. Elasticsearch集群配置 修改配置 #打开目录 cd /usr/elasticsearch #修改配置 vi config/elasticsearch.yml 主节点配置(192.168.180.1) cluster.name: es node.name: node-1 path.data: /var/lib/elasticsearch path.logs: /var/logs/elasticsearch network.host: 192.168.180.1 http.port: 9200 node.master: true node.data: true discovery.zen.ping.unicast.hosts: ["192.168.180.1:9300","192.168.180.2:9300"] discovery.zen.minimum_master_nodes: 2 从节点配置(192.168.180.2) cluster.name: es node.name: node-2 path.data: /var/lib/elasticsearch path.logs: /var/logs/elasticsearch network.host: 192.168.180.2 http.port: 9200 node.master: false node.data: true discovery.zen.ping.unicast.hosts: ["192.168.1.31:9300","192.168.1.32:9300"] discovery.zen.minimum_master_nodes: 2 配置参数说明 参数 说明 cluster.name 集群名 node.name 节点名 path.data 数据保存目录 path.logs 日志保存目录 network.host 节点host/ip http.port HTTP访问端口 node.master 是否允许作为主节点 node.data 是否保存数据 discovery.zen.ping.unicast.hosts 集群中的主节点的初始列表,当节点(主节点或者数据节点)启动时使用这个列表进行探测 discovery.zen.minimum_master_nodes master选举最少的节点数,这个一定要设置为N/2+1,其中N是:N是具有master资格的节点的数量,而不是整个集群节点个数 3. 启动Elasticsearch 运行 #进入elasticsearch根目录 cd /usr/elasticsearch #启动 (-d 为后台运行) ./bin/elasticsearch -d 验证 访问http://192.168.180.1:9200/,可以看到如下内容则表示成功: { name: "node-1", cluster_name: "es", cluster_uuid: "Tum8l98uQfK0LdS-KnsWxg", version: { number: "6.0.1", build_hash: "601be4a", build_date: "2017-12-04T09:29:09.525Z", build_snapshot: false, lucene_version: "7.0.1", minimum_wire_compatibility_version: "5.6.0", minimum_index_compatibility_version: "5.0.0" }, tagline: "You Know, for Search" } 健康状态检查 访问http://192.168.180.1:9200/,status返回green则表示正常。 { cluster_name: "es", status: "green", timed_out: false, number_of_nodes: 2, number_of_data_nodes: 2, active_primary_shards: 16, active_shards: 32, relocating_shards: 0, initializing_shards: 0, unassigned_shards: 0, delayed_unassigned_shards: 0, number_of_pending_tasks: 0, number_of_in_flight_fetch: 0, task_max_waiting_in_queue_millis: 0, active_shards_percent_as_number: 100 } 4. Head插件 Elasticsearch head是一个用浏览器跟ES集群交互的插件,可以查看集群状态、集群的doc内容、执行搜索和普通的Rest请求等。 具体安装配置请参考另外一篇博文:http://www.cnblogs.com/mantoudev/p/8269345.html

优秀的个人博客,低调大师

API一键搭建智能时光相册,记录你的美

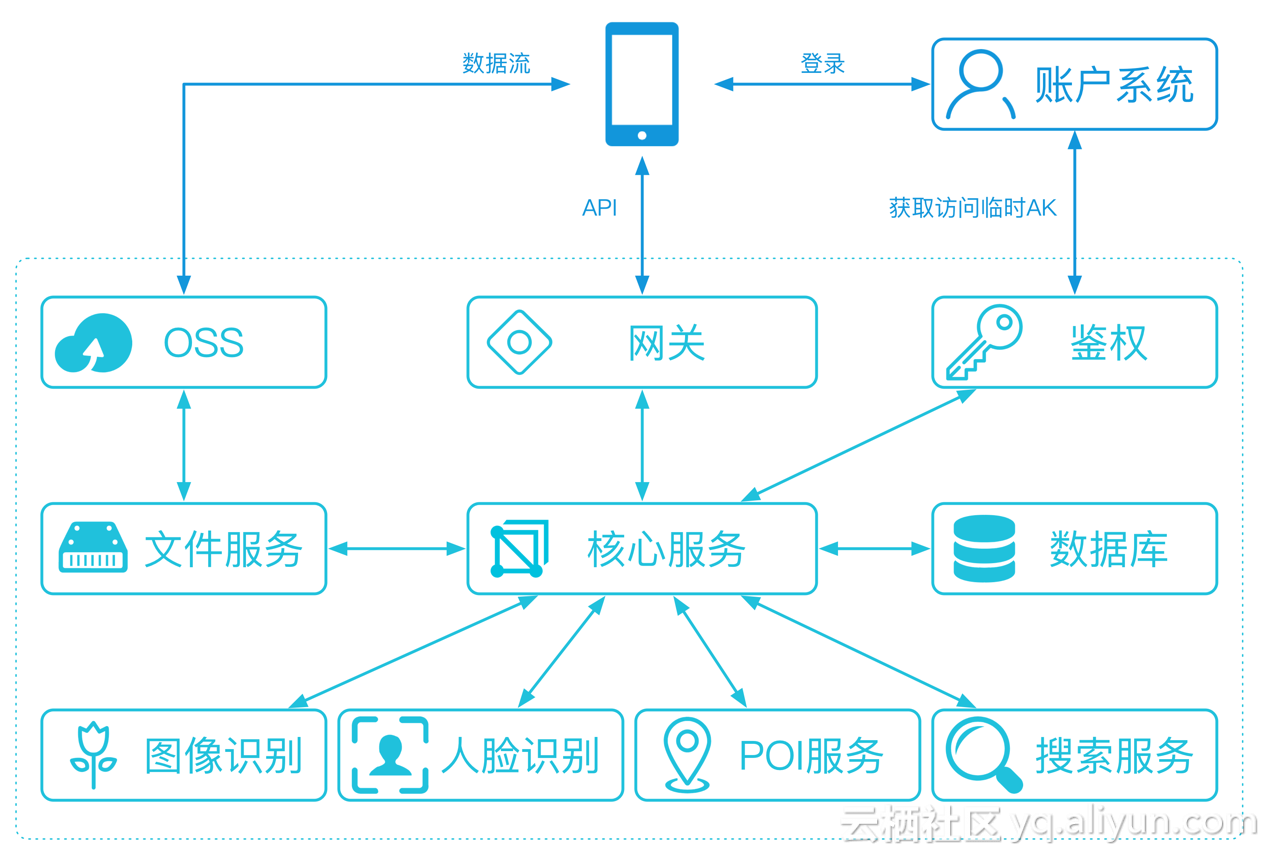
智能云相册是干什么用的? 智能云相册是阿里云专为影像类应用服务产品。是基于AliOS云相册成长起来的服务,根据历史数据经验,它可以支撑用户管理十亿级别的照片数量、PB级别的照片存储能力。相比之前的产品,智能云相册具有高集成能力,将照片的元数据存储在云端,并利用照片元数据为用户提取用户画像,用照片数据为用户创造价值。 除了提供影像文件存储、管理基础功能外,对影像内容进行分类打标、面孔识别等智能分析,并提供基于自然语言理解的智能搜索服务。 接下来我们举例来快速了解下智能云相册。 某公司租用写字楼里面的一个大房间,然后在大房间里面划分出独立的功能区(比如工位,会议室等),并将工位提供给员工。员工则可以在工位上放置其个人物品。 智能云相册服务就类似于例子中写字楼,购买了智能云相册服务的客户就类似于以上例子中的公司。 但今天我们不讲这个智能云相册是有那

优秀的个人博客,低调大师

大数据测试之hadoop单机环境搭建(超级详细版)

Hadoop的运行模式 单机模式是Hadoop的默认模式,在该模式下无需任何守护进程,所有程序都在单个JVM上运行,该模式主要用于开发和调试mapreduce的应用逻辑; 伪分布式模式下,Hadoop守护进程运行在一台机器上,模拟一个小规模的集群。该模式在单机模式的基础上增加了代码调试的功能,允许你检查NameNode,DataNode,Jobtracker,Tasktracker等模拟节点的运行情况; 单机模式和伪分布式模式均用于开发和调试的目的,真实Hadoop集群的运行采用的是完全分布式模式 单机模式安装步骤 一个干净的linux基础环境(重要,这个环境如果有问题后续就全是问题了) 为了方便大家我已经安装好了一个,大家只需下载导入到vm里即可使用。 下载地址:关注公众号【测试帮日记】对话框里回复“linux”或者加入QQ群522720170。 链接:https://pan.baidu.com/s/1qXRjaK8 密码:xjfk 关闭防火墙(适用于centos7,低版本不适用) 分别执行如下两条命令: systemctl stop firewalld.service systemctl disable firewalld.service 修改host name vi /etc/hosts 然后把自己虚机的名字追加到两行的末尾,如果用的是我们提供的虚机,名字就是linux,追加之后的效果如图 重启网络:/etc/rc.d/init.d/network restart 设置无密码登录(用于hadoop启动) cd ~ #进入当前用户的目录 mkdir -p /root/.ssh #我们用的root用户 cd ~/.ssh/ ssh-keygen -t rsa #如有提示,直接按回车 cat id_rsa.pub >> authorized_keys # 加入授权 安装jdk1.8并配置环境变量 tar解压 cp解压后的包到/usr/lib/java/(如果没有java目录就创建一下) vi /etc/profile,末尾添加如下内容: export JAVA_HOME=/usr/lib/java/jdk1.8.0_11 export JRE_HOME=/usr/lib/java/jdk1.8.0_11/jre export PATH=$JAVA_HOME/bin:$JAVA_HOME/jre/bin:$PATH export CLASSPATH=$CLASSPATH:.:$JAVA_HOME/lib:$JAVA_HOME/jre/lib 执行source /etc/profile使得环境变量生效 验证是否成功,如下图 安装hadoop2.7.4 tar解压 cp解压后的包到/usr/lib/hadoop/(如果没有hadoop目录就创建一下) 设置hadoop-env.sh vi /usr/lib/hadoop/hadoop-2.7.4/etc/hadoop/hadoop-env.sh 找到# The java implementation to use.这句话,在下面添加如下内容: #export JAVA_HOME=${JAVA_HOME} export JAVA_HOME=/usr/lib/java/jdk1.8.0_11 export HADOOP_HOME=/usr/lib/hadoop/hadoop-2.7.4 export PATH=$PATH:/usr/lib/hadoop/hadoop-2.7.4/bin export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop 执行source /usr/lib/hadoop/hadoop-2.7.4/etc/hadoop/hadoop-env.sh,使得环境变量生效 验证是否成功,如下图 配置相关的xml文件 vi /usr/lib/hadoop/hadoop-2.7.4/etc/hadoop/core-site.xml(hadoop全局配置) 内容如下: <configuration> <!--指定namenode的地址--> <property> <name>fs.defaultFS</name> <value>hdfs://127.0.0.1:9000</value> </property> </configuration> vi /usr/lib/hadoop/hadoop-2.7.4/etc/hadoop/hdfs-site.xml(hdfs配置) 内容如下: <configuration> <!--指定hdfs保存数据的副本数量--> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration> cd /usr/lib/hadoop/hadoop-2.7.4/etc/hadoop cp mapred-site.xml.template mapred-site.xml vi mapred-site.xml(MapReduce的配置) 内容如下: <configuration> <!--告诉hadoop以后MapReduce运行在YARN上--> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> </configuration> vi yarn-site.xml(yarn配置) 内容如下: <configuration> <!-- Site specific YARN configuration properties --> <!--nomenodeManager获取数据的方式是shuffle--> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> </configuration> 格式化hdfs文件系统 初次运行hadoop时一定要有该操作,命令如下: /usr/lib/hadoop/hadoop-2.7.4/bin/hadoop namenode -format 执行期间可能需要确认是否继续,如果有,就输入y回车即可 当你看到如下的内容时证明成功了 如果看到的是exiting with status 1,那么请运行如下命令,之后在进行hdfs的格式化 mkdir -pv /tmp/hadoop-root/dfs/name 启动hadoop(hdfs和yarn) sh /usr/lib/hadoop/hadoop-2.7.4/sbin/start-all.sh sh /usr/lib/hadoop/hadoop-2.7.4/sbin/stop-all.sh #停止 如果没有报错说明就成功了 使用jps命令查看进程,如果出现下面的内容就说明确定以及肯定成功啦 PS:如果修改了上面的xml文件需要重启服务哦 使用web查看Hadoop运行状态 http://你的服务器ip地址:50070/ 使用web查看集群状态 http://你的服务器IP地址:8088 可能会遇到的问题 如果你多次进行了hdfs的格式化操作,可能会无法启动datanode,原因是id不一致,一般的解决方法为将namenode clusterID和datanode clusterID改成一样的就行了。修改的文件为/tmp/hadoop-root/dfs/下的name or data文件下的VERSION里的内容 本文转自 小强测试帮 51CTO博客,原文链接:http://blog.51cto.com/xqtesting/2066724,如需转载请自行联系原作者

优秀的个人博客,低调大师

docker学习笔记(二)——本地私有仓库Registry的搭建与验证

Registry的部署 获取registry镜像 1 #dockerpullregistry:2.1.1 启动registry容器 1 2 3 4 5 6 7 8 9 #dockerrun-d-v/opt/registry:/var/lib/registry-p5000:5000--restart=always--nameregistryregistry:2.1.1 查看进程 #dockerps CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES ac291ed888feregistry:2.1.1 "/bin/registry/et..." 27minutesagoUp27minutes0.0.0.0:5000->5000 /tcp registry 验证服务是否正常 #curlhttp://127.0.0.1:5000/v2/ {} 上传镜像 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 查看本地已有镜像 #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE nginxv2570d531c994a4hoursago107MB nginxlatestb8efb18f159b3weeksago107MB centos6.80cd976dc0a9811monthsago195MB registry2.1.152bb991b482e22monthsago220MB 创建dockertag镜像 #dockertagnginx:v2127.0.0.1:5000/nginx:v2 即用ningx:v2创建127.0.0.1:5000 /nginx :v2的镜像 #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE 127.0.0.1:5000 /nginx v2570d531c994a4hoursago107MB nginxv2570d531c994a4hoursago107MB nginxlatestb8efb18f159b3weeksago107MB centos6.80cd976dc0a9811monthsago195MB registry2.1.152bb991b482e22monthsago220MB push镜像到本地仓库 #dockerpush127.0.0.1:5000/nginx:v2 Thepushreferstoarepository[127.0.0.1:5000 /nginx ] 04a8761254c7:Pushed af5bd3938f60:Pushed 29f11c413898:Pushed eb78099fbf7f:Pushed v2:digest:sha256:9586184eb142f8c66decfd4fd7b3a2b54abfcb0f0a25541e69ba3725c61ba8b3size:8522 查看是否已经上传 #curlhttp://192.168.12.109:5000/v2/_catalog { "repositories" :[ "nginx" ]} 下载镜像 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 先删除已经有的镜像 [root@DockServeropt] #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE 127.0.0.1:5000 /nginx v2570d531c994a4hoursago107MB nginxv2570d531c994a4hoursago107MB nginxlatestb8efb18f159b3weeksago107MB centos6.80cd976dc0a9811monthsago195MB registry2.1.152bb991b482e22monthsago220MB [root@DockServeropt] #dockerrmi-f570d531c994a Untagged:127.0.0.1:5000 /nginx :v2 Untagged:127.0.0.1:5000 /nginx @sha256:9586184eb142f8c66decfd4fd7b3a2b54abfcb0f0a25541e69ba3725c61ba8b3 Untagged:nginx:v2 Deleted:sha256:570d531c994a495b7cba536ac12f9d640141cbbaecd9ae8a114816681a8ca750 Deleted:sha256:f4a3f9102faadf3e941a05724ffe69e3aa3dc1fee5de3762c374ee337a27d60b [root@DockServeropt] #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE nginxlatestb8efb18f159b3weeksago107MB centos6.80cd976dc0a9811monthsago195MB registry2.1.152bb991b482e22monthsago220MB 确定已经删除后,我们下载 [root@DockServeropt] #dockerpull127.0.0.1:5000/nginx:v2 v2:Pullingfromnginx 94ed0c431eb5:Alreadyexists 9406c100a1c3:Alreadyexists aa74daafd50c:Alreadyexists 79afb5d63c06:Pullcomplete Digest:sha256:9586184eb142f8c66decfd4fd7b3a2b54abfcb0f0a25541e69ba3725c61ba8b3 Status:Downloadednewerimage for 127.0.0.1:5000 /nginx :v2 [root@DockServeropt] #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE 127.0.0.1:5000 /nginx v2d296335af0a94hoursago107MB nginxlatestb8efb18f159b3weeksago107MB centos6.80cd976dc0a9811monthsago195MB registry2.1.152bb991b482e22monthsago220MB 可以看到已经本地仓库 可以成功上传 下载镜像了 本文转自 jackjiaxiong 51CTO博客,原文链接:http://blog.51cto.com/xiangcun168/1957392

优秀的个人博客,低调大师

阿里云服务器怎么搭建sql server(即 MS SQL)?

注意,请先到阿里云官网 领取幸运券,除了价格上有很多优惠外,还可以参与抽奖。详见:https://promotion.aliyun.com/ntms/act/ambassador/sharetouser.html?userCode=2a7uv47d&utm_source=2a7uv47d 步骤1、配置远程桌面连接 首先确定自己的公网ip地址,这个在构建云服务器实例时,每一个实例会分配一个公网地址,一个内网地址。 然后, 开始-->运行 ,输入mstsc.exe,确定 将第一步确定的公网地址输入,点开选项 常规-->计算机中填入公网地址,用户名填入administrator。 显示可选择合适的远程桌面大小,如果不做本机操作,可以选全屏 本地资源中勾选“剪贴板”方便操作中本机与远程编辑,点详细信息 在“驱动器”中勾选本机的某驱动器,以便本机与服务器传输文件 全部设置完后,点连接 在点连接 出现要求密码的对话框时输入密码,即可进入远程桌面。 此时远程桌面配置完毕。 打开远程桌面上的计算机,会看到本机的驱动器,这样就可以将本机上需要传送的文件复制到服务器了,将来开发的程序也可上传过去。 END 步骤2、安装sqlserver2005Express 百度一个sqlserver2005Express,下载后上传到云服务器里,这是32位的。 如果出现如下对话框,选“运行程序”。 接受许可 点安装 下一步 姓名、公司随便填,“隐藏高级配置选项”前的勾去掉,以便后边进行自定义配置,初学者可以使用默认配置 客户端组件中连接组件要选,软件开发包根据需要自定 命名实例可以自定义,将来安装好后,在管理工具-->服务中可以看到这个服务名 选用“使用内置系统帐户”和“网络服务”,勾选“安装结束时启动服务”下的“SQL Server”和“SQL Brower”,这个也可以在安装后在管理工具-->服务中设置相应服务是否开机自动启动。 身份验证模式最好选“混合模式”,便于网络存取。如果用“混合模式”,则要设置sa的密码,sa是数据库的超级管理员的用户名。 继续下一步 接下来全是下一步,直到安装完毕 步骤3、查询刚才新建的实例 安装完成后,在管理工具-->服务中,找到自己刚才安装的实例。

优秀的个人博客,低调大师

springcloud微服务一:spring boot基础项目搭建及问题处理

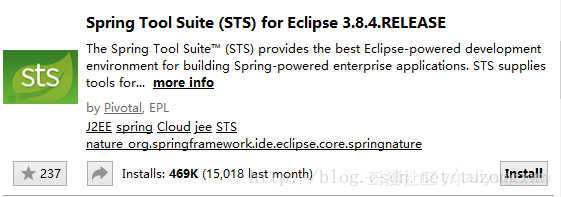
公司接下来某个项目打算使用微服务架构,使用springcloud以及它集成的一些相关项目,因此虽然在其他方面的很多技术上还感觉急需提高,却又不得不以工作为重,先放下其他来了解一下这方面的技术。 一番了解后发现,spring cloud是建立在spring boot的基础上的,而之前虽然听说过,也随便看了一下spring boot,却没有真正使用,因此还必须先花时间学一下spring boot。 spring boot的理念是“习惯优于配置”,我个人的理解就是尽量减少开发过程中手动的spring相关的配置文件。同时使用spring boot还有一个优点就是,它可以内嵌很多容器,例如tomcat,使得原本可能需要安装tomcat才能运行的web项目,可以直接以运行jar文件的形式启动运行。 spring boot项目创建有多种方式,鉴于目前工作中使用的是eclipse开发工具,因此整个学习过程中,也都是在eclipse中进行。 而eclipse中的创建实际上也是可以有两种方式的,一种是在安装了STS插件之后直接创建,另一种是创建简单的maven项目后,修改pom.xml文件,为了提高效率,我这里就安装了STS插件,以第一种方式创建。 这个过程中还有一个小插曲,我原本的eclipse版本是Mars.1 Release (4.5.1),安装STS的时候安装不成功,说是eclipse版本不匹配,于是安装了新版的eclipse,版本号Neon.3 Release (4.6.3)。但是当我在新版的eclipse中安装好STS后,再来尝试在旧版安装时,居然又一路畅通无阻的成功了。 eclipse中STS安装也有几种方式,我的STS的安装过程是这样的: help –> Eclipse Marketplace –>Popular,然后选择下图中的插件install。 这个插件安装成功以后,就可以看到在eclipse中new project时会有spring这个选项了(当然了,不知这一个地方有变化),打开之后还会有几个子选项,如图: 而我快速创建spring boot项目的时候,使用的就是上图中第三个子选项Spring Starter Project。具体步骤是:new –>Project –>Spring Starter Project –>出现的界面中name选项后输入项目名称 –>接下来出现如下图所示界面: 这里我主要是使用了两个地方,第一个就是选择spring boot version,第二个就是在标示2的位置选择要创建的具体spring boot项目,有很多选项可供选择,而我就选了一个web项目。 创建好的web项目基本结构如下图: 创建的时候它会自动生成一个带有main方法的类,这个main方法实际上就是spring boot项目的程序入口,我在里边加入了一个@RestController和这样一段代码: @RequestMapping("/") String index(){ return "Hello Spring Boot"; } 之后整个类的代码如下: package com.springTest.demo; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; @RestController @SpringBootApplication public class SpringBootDemo1Application { @RequestMapping("/") String index(){ return "Hello Spring Boot"; } public static void main(String[] args) { SpringApplication.run(SpringBootDemo1Application.class, args); } } 当安装好STS插件之后,创建一个简单的spring boot的web项目就是这么简单,不需要像传统的spring项目一样还要配置spring.xml等配置文件以及web.xml文件。 但是需要注意的是,我在第一次创建的时候,spring boot相关的jar包下载不下来,因为公司的maven仓库中没有对应版本的,于是自己修改了maven的配置文件,加入了阿里云的maven仓库: <mirror> <id>alimaven</id> <name>aliyun maven</name> <url>http://maven.aliyun.com/nexus/content/groups/public/</url> <mirrorOf>central</mirrorOf> </mirror> 当重新配置maven仓库,使得程序编译没有问题后,就可以启动项目了,eclipse中使用run as –>Spring Boot App就可以直接运行,不需要像传统web项目那样要加入到tomcat中才行。 启动成功后浏览器访问localhost:8080,会看到页面如下,一个简单的spring boot web项目就成功创建了。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册