首页 文章 精选 留言 我的

精选列表

搜索[全栈管理],共10000篇文章
优秀的个人博客,低调大师

【小白学ML】随机森林 全解 (从bagging到variance)

【前言】:公众号的AI初学者交流群已经建立啦,公众号后台回复【加群】可以加入。群里都是些一起学习的朋友,大家学习路上,结个伴。 【公众号资源汇总】:炼丹图书馆 | AI初学者所需要的资料合集(视频+PDF下载) 全文3155字,预计阅读时间10min 文章目录: 1 随机森林 2 bagging 3 神秘的63.2% 4 随机森林 vs bagging 5 投票策略 6 随机森林的特点 6.1 优点 6.2 bias 与 variance 6.3 随机森林降低偏差证明 为什么现在还要学习随机森林? 随机森林中仍有两个未解之谜(对我来说)。随机森林采用的bagging思想中怎么得到的62.3% 以及 随机森林和bagging的方法是否有区别。 随机森林(Random Forest)就是通过集成学习的思想将多棵决策树集成的一种算法。基本单元是决策树。随机森林算法的提出也是为了改善决策树容易存在过拟合的情况。 1 随机森林 习惯上,我们将众多分类器(SVM、Logistic回归、决策树等)所组成的“总的分类器”,叫做随机森林。随机森林有两个关键词,一个是“随机”,一个是“森林”。森林就是成百上千棵树,体现了集成的思想,随机将会在下面总结到。 2 bagging Bagging,其实就是bootstrap aggregating的缩写, 两者是等价的,其核心就是有放回抽样。 【bagging具体步骤】 从大小为n的样本集中有放回地重采样选出n个样本;(没错就是n个样本抽取n个) 在所有属性上,对这n个样本建立分类器(ID3信息增益、C4.5信息增益率、CART基尼系数、SVM、Logistic回归等) 重复以上两步m次,即获得了m个分类器; 将预测数据放在这m个分类器上,最后根据这m个分类器的投票结果,决定数据属于哪一类。 3 神秘的63.2% 一般被大家知晓的是:随机森林中每一次采样的比例是63.2%。 这个比例到底是怎么确定的呢? 在某手的面试中,我被问到了这个相关的问题,奈何学艺不精,哎。后来苦苦研究15分钟,终于得到答案,现在分享给大家。 bagging的最初的说法其实是:n个样本从中有放回抽样n次,这种条件下,势必会有抽取到相同样本的可能性,那么抽取到不同样本的期望值是多少呢?其实大家心里可能会有答案了,没错就是0.632n。 我们假设 表示第k次抽样抽取到不同样本的概率。那么 则表示第k-1次抽样抽取到不同样本的概率。 第k-1次抽样到不同样本的概率: 第k-1次抽样时,有 个样本还没有被抽取 第k次抽样时,还有 的样本没有抽取 因此 ,第一次抽样的数据一定不会重复 因此k次放回抽样的不同样本的期望值为: 利用等比数列的性质,得到: 当n足够大,并且k=n的情况下,上面的公式等于 所以证明完毕,每一次bagging采样重复抽取n次其实只有63.2%的样本会被采样到。 4 随机森林 vs bagging 随机森林(Random Forest)在Bagging基础上进行了修改。 具体步骤可以总结如下: 从训练样本集中采用Bootstrap的方法有放回地重采样选出n个样本,即每棵树的训练数据集都是不同的 ,里面包含重复的训练样本(这意味着随机森林并不是按照bagging的0.632比例采样 ); 从所有属性中有选择地选出K个属性,选择最佳属性作为节点建立CART决策树; 重复以上步骤m次,即建立了m棵CART决策树 这m个CART形成随机森林,通过投票表决分类结果,决定数据是属于哪一类。 随机森林(Random Forest)的随机性主要体现在两方面,一方面是样本随机,另一方面是属性随机。样本随机的原因是如果样本不随机,每棵树的训练数据都一样,那么最终训练出的分类结果也是完全一样的。 5 投票策略 少数服从多数 一票否决 听说还有贝叶斯平均的方法。但是我没有过多了解。一般还是用少数服从多数的吧。 6 随机森林的特点 6.1 优点 在当前的算法中,具有极好的准确率 能够运行在大数据上 能够处理具有高维特征的输入样本,不需要降维 能够计算各个特征的重要度 能够防止过拟合 其实在一些大数据竞赛中,随机森林也是我第一个会尝试的模型哦~ 6.2 bias 与 variance 说到机器学习模型的误差,主要就是bias和variance。 Bias:如果一个模型的训练错误大,然后验证错误和训练错误都很大,那么这个模型就是高bias。可能是因为欠拟合,也可能是因为模型是弱分类器。 Variance:模型的训练错误小,但是验证错误远大于训练错误,那么这个模型就是高Variance,或者说它是过拟合。 这个图中,左上角是低偏差低方差的,可以看到所有的预测值,都会落在靶心,完美模型; 右上角是高偏差,可以看到,虽然整体数据预测的好像都在中心,但是波动很大。 【高偏差vs高方差】 在机器学习中,因为偏差和方差不能兼顾,所以我们一般会选择高偏差、低方差的左下角的模型。稳定性是最重要的,宁可所有的样本都80%正确率,也不要部分样本100%、部分50%的正确率。个人感觉,稳定性是学习到东西的体现,高方差模型与随机蒙的有什么区别? 6.3 随机森林降低偏差证明 上面的可能有些抽象,这里用RandomForest(RF)来作为例子:随机森林是bagging的集成模型,这里: RF(x)表示随机森林对样本x的预测值; B表示总共有B棵树; 表示第i棵树所使用的训练集,是使用bagging的方法,从所有训练集中进行行采样和列采样得到的子数据集。 这里所有的 ,都是从所有数据集中随机采样的,所以可以理解为都是服从相同分布的。所以不断增加B的数量,增加随机森林中树的数量,是不会减小模型的偏差的。【个人感觉,是因为不管训练再多的树,其实就那么多数据,怎么训练都不会减少,这一点比较好理解】 【RF是如何降低偏差的?】 直观上,使用多棵树和bagging,是可以增加模型的稳定性的。怎么证明的? 我们需要计算 假设不同树的 之间的相关系数为 ,然后每棵树的方差都是 . 先复习一下两个随机变量相加的方差如何表示: Cov(X,Y)表示X和Y的协方差。协方差和相关系数不一样哦,要除以X和Y的标准差: 下面转成B个相关变量的方差计算,是矩阵的形式: 很好推导的,可以试一试。 这样可以看出来了,RF的树的数量越多,RF方差的第二项会不断减小,但是第一项不变。也就是说,第一项就是RF模型偏差的下极限了。 【总结】 增加决策树的数量B,偏差不变;方差减小; 增加决策树深度,偏差减小; 减小, 增加; 增加bagging采样比例,偏差减小; 增加, 增加; 【bagging vs boost】 之前的文章也提到过了boost算法。 GBDT中,在某种情况下,是不断训练之前模型的残差,来达到降低bias的效果。虽然也是集成模型,但是可以想到,每一个GBDT中的树,所学习的数据的分布都是不同的,这意味着在GBDT模型的方差会随着决策树的数量增多,不断地增加。 bagging的目的:降低方差; boost的目的:降低偏差 - END - 【机器学习炼丹术】的文章清单 <<小白学图像>> 小白学目标检测 | RCNN, SPPNet, Fast, Faster 小白学图像 | BatchNormalization详解与比较 小白学图像 | Group Normalization详解+PyTorch代码 小白学图像 | 八篇经典CNN论文串讲 图像增强 | CLAHE 限制对比度自适应直方图均衡化 小白学卷积 | 深入浅出卷积网络的平移不变性 小白学卷积 | (反)卷积输出尺寸计算 五分钟了解:端侧神经网络GhostNet(2019) 五分钟学会:焦点损失函数 FocalLoss 与 GHM <<小白学算法>> 小白学排序 | 十大经典排序算法(动图) 小白学优化| 最小二乘法与岭回归&Lasso回归 杂谈 | 正态分布为什么如此常见 Adam优化器为什么被人吐槽? <<小白学机器学习>> SVM三合一 | SVM优化推导 + 拉格朗日算子讲解(KKT条件) + hingeLoss 工程能力UP | LightGBM的调参与并行 小白学XGB | XGBoost推导与牛顿法 评价指标 | 详解F1-score与多分类MacroF1&MicroF1 小白学LGB | LightGBM = GOSS + histogram + EFB 小白学ML |Adaboost及手推算法案例 小白学ML | GBDT梯度提升树 机器学习不得不知道的提升技巧:SWA与pseudo-label <<小白学推荐>> 小白学推荐1 | 协同过滤 零基础到入门 <<小白面经>> 【小白面经】八种应对样本不均衡的策略 【小白面经】之防止过拟合的所有方法 【小白面经】梯度消失爆炸及其解决方法 【小白面经】判别模型&生成模型 其实上面所有专题中的内容都有可能出在面试中 <<小白学杂七杂八>> 小白写论文 | 技术性论文结构剖析 公众号回复【入群】,加入AI爱好者大学生交流群。你缺少的可能只是一起前行的同伴~ 也可以添加作者好友,进行交流学习经验、求职经验、竞赛经验、如何一顿饭吃两顿的量的经验、找女朋友经验等。 好文!卑微作者,在线求赞! 本文分享自微信公众号 - 机器学习炼丹术(liandanshu)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

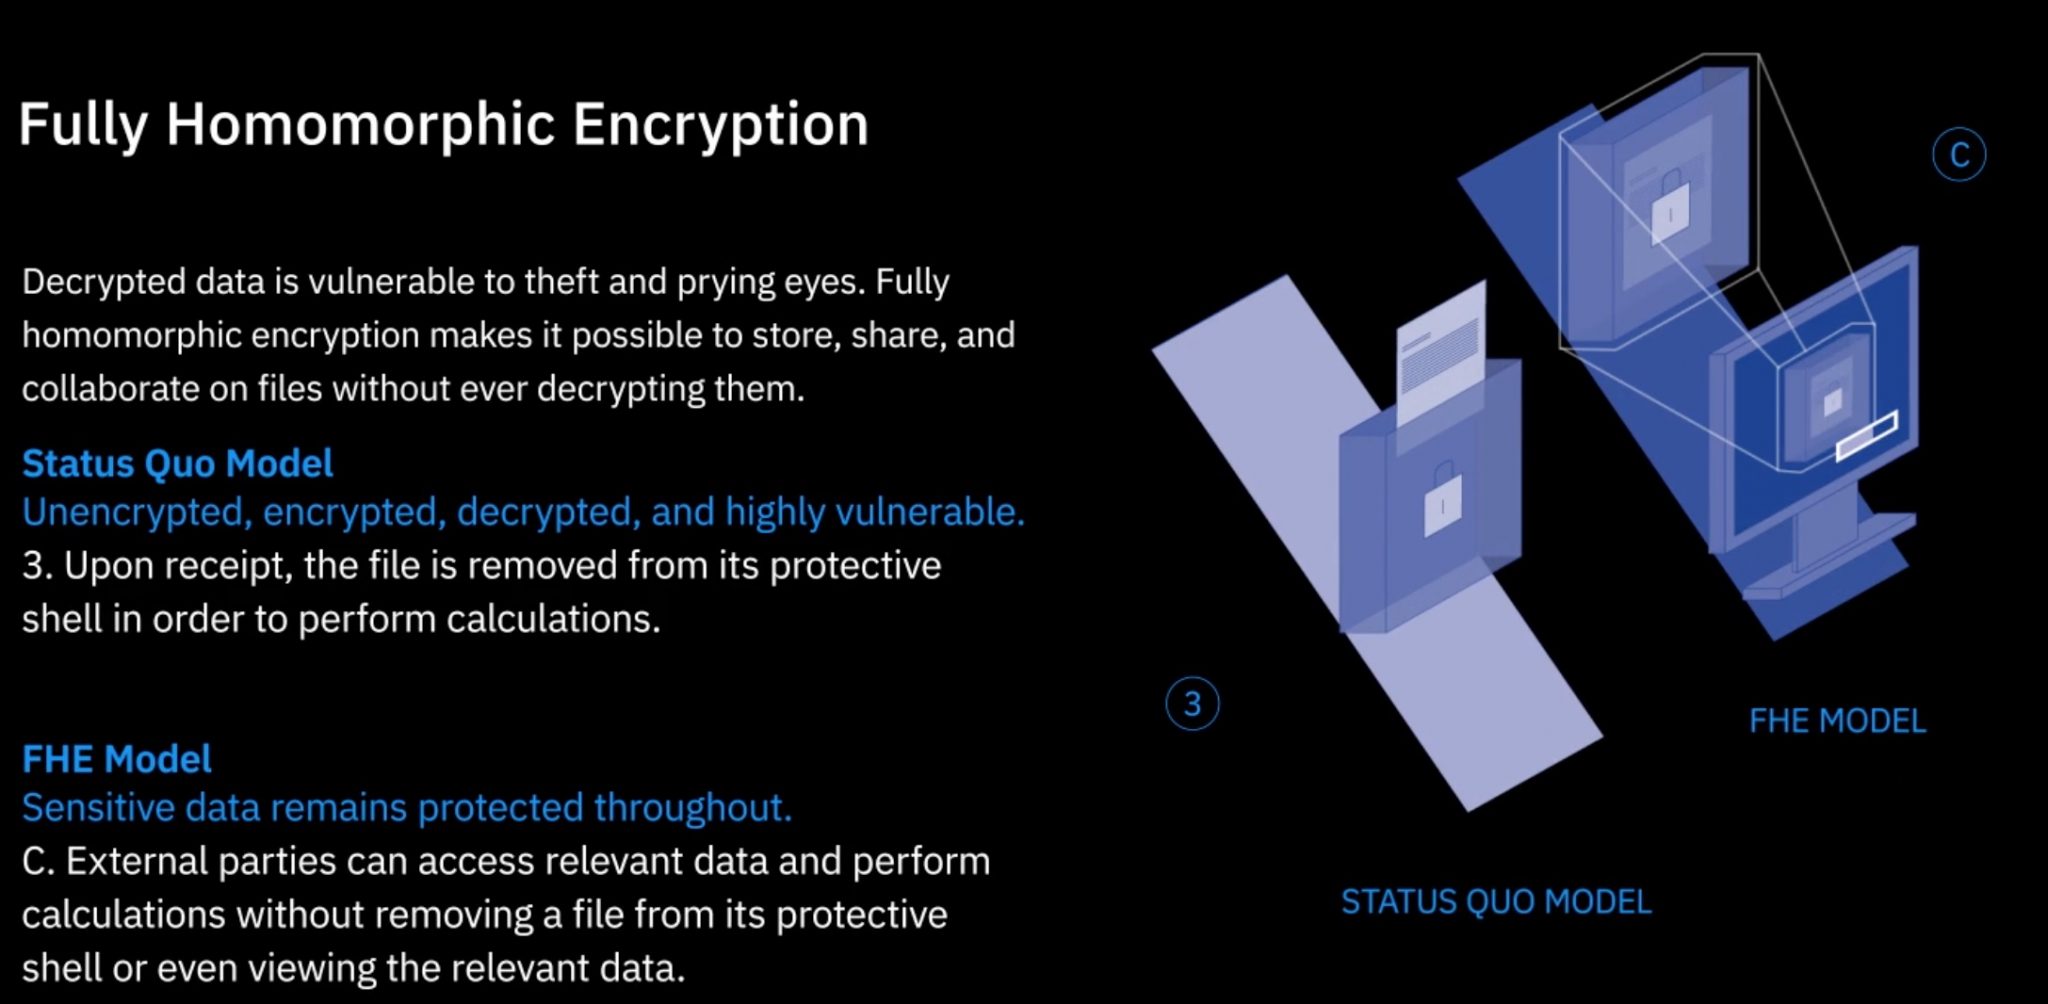
IBM 发布全同态加密(FHE)工具包 Linux 版本

6月初,IBM 发布了适用于MacOS和iOS的完全同态加密(Fully Homomorphic Encryption,FHE)工具包。现如今,该公司则宣布推出一个新的 Linux FHE 工具包,将 FHE 带到 IBM Z 和 x86 架构的多个 Linux 发行版中。 FHE 技术允许在保持加密状态的情况下对数据进行操作,最大程度上降低了数据暴露的风险。FHE 工具包旨在使开发人员更轻松地在其解决方案中使用 FHE。LinuxFHE 工具包的第一个版本只支持 IBM Z(s390x)客户端上的 Ubuntu。对于 x86 平台,该工具包则支持 Ubuntu、Fedora 和 CentOS。 IBM 表示,经验丰富的 Docker 开发人员可以轻松地将其移植到其他 GNU/Linux发行版中。每个工具包版本都将使用户可以通过其主机操作系统上的 Web 浏览器访问内置 IDE(集成开发环境)。 与MacOS和iOS工具包类似,Linux版本FHE 工具包中包含了一个使用欧洲国家及其首都城市的英文名称针对加密数据库进行隐私保护搜索的简单演示;选择国家将搜索匹配的首都。Linux 版本 FHE 工具包打包为 Docker镜像,因此应可在具有最新 Docker 的任何平台上使用。 此外,该团队还在LinuxFHE 工具包中为金融行业添加了第二个用户案例演示。具体来说,这个新案例专注于信用卡欺诈检测,开发人员可以通过在完全同态加密的数据集和模型上使用神经网络来检测基于匿名交易的欺诈活动。

优秀的个人博客,低调大师

【Kubernetes系列】第8篇 CI/CD之全流程实践

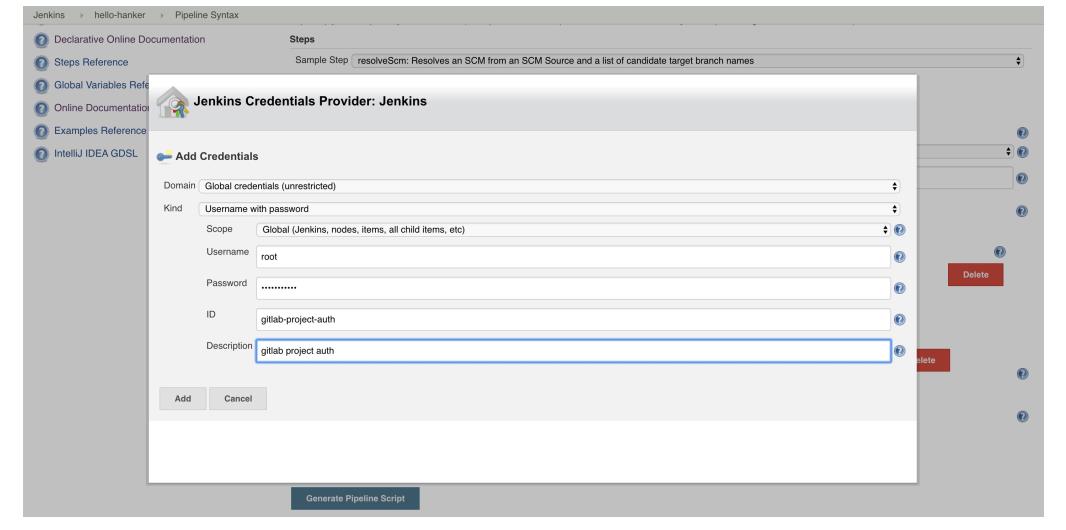
前言 本实践中已经的示例代码及jenkins-agent镜像已经推送归档至github,-->传送门 注意本实践中均为内网数据,你测试时一定要改为自己的环境的有效数据。 由于本实践涉及组件较多,若有操作不明确的话,你可以后台留言,我们一起完善。 具体操作时若有不清楚,或是错误可以留言,大家一起解决。 1. 准备基础数据 配置gitlab 创建项目 上传示例代码 _注_: 本次示例使用的gitlab项目地址为:http://gitlab.hanker.com/colynn/hanker-hello.git 配置harbor 创建项目, 用于存储构建的镜像 _注_: 本次示例使用的harbor地址为 10.0.0.185:5000/hanker/hanker-hello:v1 jenkins 验证信息 添加 gitlab 帐号信息 _操作指引_:【Credentials】-> 【System】-> 【Global credentials】-> 【Add Credentials】 harbor 信息 _操作指引_:【Credentials】-> 【System】-> 【Global credentials】-> 【Add Credentials】 k8s namespace验证信息 在你的k8s master节点上执行如下操作: 1.创建serviceaccount $ kubectl -n devops create serviceaccount jenkins-robot 命令输出: serviceaccount/jenkins-robot created 2.角色绑定 $ kubectl -n devops create rolebinding jenkins-robot-binding --clusterrole=cluster-admin --serviceaccount=devops:jenkins-robot 命令输出: rolebinding.rbac.authorization.k8s.io/jenkins-robot-binding created 3.获取 ServiceAccount $ kubectl -n devops get serviceaccount jenkins-robot -o go-template --template='{{range .secrets}}{{.name}}{{"\n"}}{{end}}' jenkins-robot-token-n8w6b 4.基于base64解码 ServiceToken $ kubectl -n devops get secrets jenkins-robot-token-n8w6b -o go-template --template '{{index .data "token"}}' | base64 --decode 命令输出: eyJhbGciOiJSUzI1NiIsImtpZCI6IiJ9.eyJpc3MiOiJrdWJlcm5ldGVzL3NlcnZpY2VhY2NvdW50Iiwia3ViZXJuZXRlcy5pby9zZXJ2aWNlYWNjb3VudC9uYW1lc3BhY2UiOiJkZXZvcHMiLCJrdWJlcm5ldGVzLmlvL3NlcnZpY2VhY2NvdW50L3NlY3JldC5uYW1lIjoiamVua2lucy1yb2JvdC10b2tlbi1uOHc2YiIsImt1YmVybmV0ZXMuaW8vc2VydmljZWFjY291bnQvc2VydmljZS1hY2NvdW50Lm5hbWUiOiJqZW5raW5zLXJvYm90Iiwia3ViZXJuZXRlcy5pby9zZXJ2aWNlYWNjb3VudC9zZXJ2aWNlLWFjY291bnQudWlkIjoiOTcyZTY0OGYtMTYxZC00NmM5LWI0ZjgtYjFkNTdlOWY4NTBjIiwic3ViIjoic3lzdGVtOnNlcnZpY2VhY2NvdW50OmRldm9wczpqZW5raW5zLXJvYm90In0.ArQvcaEqCaeU1ZcJ6nOC5rLaTZr_vLDrpLCt87asltMUWj2gSli_mXUTrl09hBnBDXI3A1D4rJXHKLHjIAA4nN8qRIRGbpqSNzDwmqJr-jmmmWWZFrZ3n3Al9-13KJnNOK8pcWr70rt3Rsigt4B6CIQ0-ZLK8BZhvROJSifeOfJ6xe2KBqdXBv1ccZZZfEhPLgGbaR5yWm5jLvOMr2MQiPDrZoHOEkcMt-C0xipytOp4sJCJ4bQhb-UoMu1owYydxbd6O7xO71fvqP_bMDpZXC601nA2ggK7h-vi6CJffHv5MM59q8X_DWe1NnZS6KXiMmkXqAmBn10Yu20PNj-kjg 5.添加 Secret text验证信息 _操作指引_:【首页】->【Credentials】-> 【System】-> 【Global credentials】-> 【Add Credentials】-> 选择【Secret text】类型 然后将上一步 解码的结果 更新至 Secret, Pipeline 中 2. 如何创建 jenkins pipeline 1. 创建jenkins pipeline item _操作指引_:【首页】->【New Item】 2. pipeline script 步骤说明 _注_: pipeline主要包含三个阶段(检出代码、制作镜像、部署服务),下面跟大家解释下,如何编写pipeline, 借助Pipeline Syntax生成的只是部分代码,你可以根据语言规范将其完善。 1.阶段1,检出代码 _操作指引_:【首页】->【hanker-hello-demo】-> 【Pipeline Syntax】 _注_: 本实践中选取的 git: Git 类型,当然你也可以选择 checkout: Check out from version control 获取到该步骤的脚本 git credentialsId: 'gitlab-project-auth', url: 'http://gitlab.hanker.com/colynn/hanker-hello.git' 2.阶段2,构建镜像 _操作指引_:类似于 阶段1, 完善获取该步骤脚本 script { withDockerRegistry(credentialsId: 'harbor-auth', url: 'http://10.0.0.185:5000') { def customImage = docker.build("10.0.0.185:5000/devops/hanker-hello:v1") customImage.push() } } _注_: 支持本阶段需要jenkins-agent镜像里包含docker命令。 3.阶段3. 部署服务 _参考_: jenkins kubernetes cli plugin _注_: 支持本阶段需要jenkins-agent镜像里包含kubectl命令。 3. 设置 pipeline _注_: General/ Build Triggers/ Advanced Project Options 这三块你可以根据自己需要设置,将各阶段的脚本合并,更新至 Pipline -> Script内。 合并后的pipeline脚本内容如下: pipeline { agent any stages { stage('checkout') { steps { git credentialsId: 'gitlab-project-auth', url: 'http://gitlab.hanker.com/colynn/hanker-hello.git' } } stage('docker-publish') { steps{ script { withDockerRegistry(credentialsId: 'harbor-auth', url: 'http://10.0.0.185:5000') { def customImage = docker.build("10.0.0.185:5000/devops/hanker-hello:v1") customImage.push() } } } } stage('application-deploy') { steps { withKubeConfig([credentialsId: '5a5517f3-3d38-459d-bafc-12b55beeb588', serverUrl: 'https://10.0.0.182:6443']) { sh '/usr/bin/kubectl apply -f k8s-setup.yml' } } } } } 3. 触发构建 4. 结果确认 1.确认 jenkina-agent 启动状态; $ kubectl -n devops get pods |grep jnlp jnlp-sh8zl 1/1 Running 0 14s // 查看jenkins-agent pod日志 $ kubectl -n devops logs -f [jenkins-agent-pod-name] _注_: 如果长时间没有启动jenkins-agent, 可以确认下集群内是否有足够的资源。 2.确认pipeline 执行状态; 3.确认harbor镜像仓库里是否已经有新推送的镜像 _注_: harbor里的项目是需要你先创建好的,不然推送时会报错。 4.确认部署的服务状态 k8s master节点上执行如下操作: $ kubectl -n devops get pod,deployment,svc,ingress |grep hanker-hello pod/hanker-hello-5b7586f86d-5j7kk 1/1 Running 0 173m deployment.extensions/hanker-hello 1/1 1 1 3h8m service/hanker-hello-svc ClusterIP 10.233.22.19 <none> 8080/TCP 3h8m ingress.extensions/hanker-hello-ingress hanker-hello-demo.dev.hanker.net 80 3h8m 附录 自定义jenkins-agent镜像 ## 基于 https://github.com/Kubernetes-Best-Pratice/jenkins-jnlp-agent.git $ git checkout https://github.com/Kubernetes-Best-Pratice/jenkins-jnlp-agent.git $ cd jenkins-jnlp-agent $ docker build . $ docker tag tag-name custom-private-repository-addr _注_: 你也可以基于基础镜像创建自定义的镜像 可以做的更完善 配置webhook, 自动触发jenkins job; 当前我们实践时构建的镜像版本使用的是固定的, 你是否可以将其替换为依赖pipeline环境变量或是传参的形式,将其变是更有意义; 上一篇文章中在设置【配置Kubernetes Pod Template】时,我们提到可以挂载主机或是网络共享存储,你是否可以通过这个将你的构建快起来; 我们的示例代码使用的go, 直接是镜像内打包,如何更好的就好的其他语言的构建,你可以参考Using Docker with Pipeline; 你想过如何下载构建过程中的产物吗,等等。 参考链接 : https://github.com/jenkinsci/kubernetes-cli-plugin/blob/master/README.md 下载kubectl: https://docs.docker.com/ee/ucp/user-access/kubectl/

优秀的个人博客,低调大师

基于Spring Boot + Dubbo的全链路日志追踪(二)

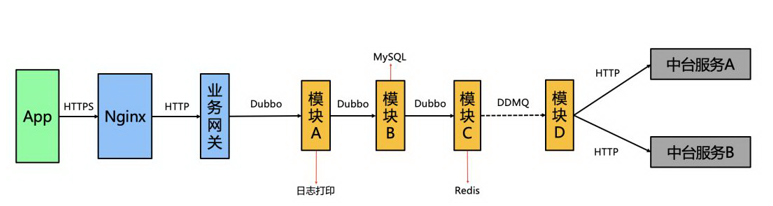
一、概要 紧接上一篇,完成分析之后,就要具体的实现了。 service-a: 实现dubbo服务。 service-b: 实现web服务,并调用service-a实现的服务。 二、实现 2.1 日志采集及存储 本例直接使用【阿里云·日志服务】进行数据存储和检索,使用Aliyun Log Logback Appender进行日志收集及上传。 其实就是阿里自己实现了一个Logback Appender。当然我们也可以自己实现,比如上传至自建的ELK中。 2.2 项目中traceId生成、传递、销毁 2.2.1 traceId生成、销毁 2.2.1.1 客户端请求等触发(外部) 外部类请求触发情况,使用拦截器处理。 请求过来之后,生成traceId,并写入org.slf4j.MDC。 请求完成之后,将traceId从org.slf4j.MDC中移除。 package com.example.dubboserviceb.interceptor; import com.example.dubboserviceb.constants.Constants; import org.slf4j.MDC; import org.springframework.web.servlet.HandlerInterceptor; import org.springframework.web.servlet.ModelAndView; import javax.servlet.http.HttpServletRequest; import javax.servlet.http.HttpServletResponse; import java.util.UUID; /** * @author lpe234 * @since 2019/5/25 14:43 */ public class TraceIdInterceptor implements HandlerInterceptor { @Override public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception { // generate traceId String traceId = UUID.randomUUID().toString().replace("-", ""); // put traceId MDC.put(Constants.TRACE_ID, traceId); return true; } @Override public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, ModelAndView modelAndView) throws Exception { } @Override public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) throws Exception { // clear traceId MDC.remove(Constants.TRACE_ID); } } 2.2.1.2 定时任务等触发(内部) (略...) 2.2.1 traceId传递 2.2.1.1 WEB类传递 简单的接口返回类,增加traceId字段。 package com.example.dubboserviceb.utils; import lombok.Data; /** * @author lpe234 * @since 2019/5/25 14:55 */ @Data public class RestResponse<T> { private Integer code; private String msg; private T data; private String traceId; public RestResponse() { } public RestResponse(Integer code, String msg, T data) { this.code = code; this.msg = msg; this.data = data; } public static <T> RestResponse<T> ok(T data) { return new RestResponse<>(200, "ok", data); } public static <T> RestResponse<T> error(T data) { return new RestResponse<>(400, "error", data); } } 当请求响应结果生成前,获取当前org.slf4j.MDC中的traceId,设置到RestResponse中。 package com.example.dubboserviceb.advice; import com.example.dubboserviceb.constants.Constants; import com.example.dubboserviceb.utils.RestResponse; import org.slf4j.MDC; import org.springframework.core.MethodParameter; import org.springframework.http.MediaType; import org.springframework.http.converter.HttpMessageConverter; import org.springframework.http.server.ServerHttpRequest; import org.springframework.http.server.ServerHttpResponse; import org.springframework.web.bind.annotation.ControllerAdvice; import org.springframework.web.servlet.mvc.method.annotation.ResponseBodyAdvice; /** * @author lpe234 * @since 2019/5/25 15:03 */ @ControllerAdvice public class ResponseModifyAdvice implements ResponseBodyAdvice<Object> { @Override public boolean supports(MethodParameter methodParameter, Class<? extends HttpMessageConverter<?>> aClass) { return true; } @Override public Object beforeBodyWrite(Object o, MethodParameter methodParameter, MediaType mediaType, Class<? extends HttpMessageConverter<?>> aClass, ServerHttpRequest serverHttpRequest, ServerHttpResponse serverHttpResponse) { // put traceId to response ((RestResponse) o).setTraceId(MDC.get(Constants.TRACE_ID)); return o; } } 最终,接口响应数据例如如下: { "code": 200, "msg": "ok", "data": "Hello apple", "traceId": "6c25de3422374d51be58555ae9c380e8" } 2.2.1.2 Dubbo类传递 traceId的存储使用org.apache.dubbo.rpc.RpcContext(内部使用InternalThreadLocal实现)。 借助Dubbo的过滤器来实现,traceId在Dubbo服务间的读取、写入和清除。 package com.example.dubboservicea.filter; import com.example.dubboservicea.constants.Constants; import org.apache.dubbo.common.extension.Activate; import org.apache.dubbo.rpc.*; import org.slf4j.MDC; /** * @author lpe234 * @since 2019/5/25 15:24 */ @Activate(group = {org.apache.dubbo.common.Constants.PROVIDER, org.apache.dubbo.common.Constants.CONSUMER}) public class DubboTraceIdFilter implements Filter { @Override public Result invoke(Invoker<?> invoker, Invocation invocation) throws RpcException { RpcContext rpcContext = RpcContext.getContext(); // before if (rpcContext.isProviderSide()) { // get traceId from dubbo consumer,and set traceId to MDC String traceId = rpcContext.getAttachment(Constants.TRACE_ID); MDC.put(Constants.TRACE_ID, traceId); } if (rpcContext.isConsumerSide()) { // get traceId from MDC, and set traceId to rpcContext String traceId = MDC.get(Constants.TRACE_ID); rpcContext.setAttachment(Constants.TRACE_ID, traceId); } Result result = invoker.invoke(invocation); // after if (rpcContext.isProviderSide()) { // clear traceId from MDC MDC.remove(Constants.TRACE_ID); } return result; } @Override public Result onResponse(Result result, Invoker<?> invoker, Invocation invocation) { return result; } } 另,需要在resources/META-INF/dubbo/文件夹下,创建com.alibaba.dubbo.rpc.Filter文本文件。内容为dubboTraceIdFilter=com.example.dubboservicea.filter.DubboTraceIdFilter。 而后,spring-boot配置文件中 配置dubbo的过滤器 #dubbo dubbo: scan: base-packages: com.example.dubboservicea.provider, com.example.dubboservicea.reference protocol: name: dubbo port: 12101 registry: address: zookeeper://118.190.204.150:20084 provider: filter: dubboTraceIdFilter consumer: filter: dubboTraceIdFilter 三、结果 3.1 HTTP请求结果返回 3.2 日志服务查询

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册