首页 文章 精选 留言 我的

精选列表

搜索[notepad  ],共10025篇文章
优秀的个人博客,低调大师

Manifest.xml 入门基础 (二) <uses-permission> 标签

Manifest.xml 入门基础 (二) <uses-permission> 标签 Android的权限在AndroidManifest.xml文件里配置。AndroidManifest文件中有四个标签与permission有关,它们分别是 <permission>、 <permission-group> 、<permission-tree> 和 <uses-permission>。其中最常用的是 <uses-permission>,当我们需要获取某个权限的时候就必须在我们的manifest文件中声明<uses-permission> 例如,短信和电话权限的定义: <uses-permission android:name="android.permission.CALL_PHONE" /> <uses-permission android:name="android.permission.SEND_SMS"/> 下面是收集到的 <uses-permission>的资料,方便用的时候查找: android.permission.ACCESS_CHECKIN_PROPERTIES 允许读写访问”properties”表在checkin数据库中,改值可以修改上传( Allowsread/write access to the “properties” table in the checkin database, to changevalues that get uploaded) android.permission.ACCESS_COARSE_LOCATION 允许一个程序访问CellID或WiFi热点来获取粗略的位置(Allowsan application to access coarse (e.g., Cell-ID, WiFi) location) android.permission.ACCESS_FINE_LOCATION 允许一个程序访问精良位置(如GPS) (Allows an application to accessfine (e.g., GPS) location) android.permission.ACCESS_LOCATION_EXTRA_COMMANDS 允许应用程序访问额外的位置提供命令(Allowsan application to access extra location provider commands) android.permission.ACCESS_MOCK_LOCATION 允许程序创建模拟位置提供用于测试(Allowsan application to create mock location providers for testing) android.permission.ACCESS_NETWORK_STATE 允许程序访问有关GSM网络信息(Allows applications to accessinformation about networks) android.permission.ACCESS_SURFACE_FLINGER 允许程序使用SurfaceFlinger底层特性(Allows an application to useSurfaceFlinger’s low level features) android.permission.ACCESS_WIFI_STATE 允许程序访问Wi-Fi网络状态信息(Allows applications to accessinformation about Wi-Fi networks) android.permission.ADD_SYSTEM_SERVICE 允许程序发布系统级服务(Allowsan application to publish system-level services). android.permission.BATTERY_STATS 允许程序更新手机电池统计信息(Allowsan application to update the collected battery statistics) android.permission.BLUETOOTH 允许程序连接到已配对的蓝牙设备(Allowsapplications to connect to paired bluetooth devices) android.permission.BLUETOOTH_ADMIN 允许程序发现和配对蓝牙设备(Allowsapplications to discover and pair bluetooth devices) android.permission.BRICK 请求能够禁用设备(非常危险)(Required to be able to disable thedevice (very *erous!).) android.permission.BROADCAST_PACKAGE_REMOVED 允许程序广播一个提示消息在一个应用程序包已经移除后(Allowsan application to broadcast a notification that an applicationpackage has been removed) android.permission.BROADCAST_STICKY 允许一个程序广播常用intents(Allowsan application to broadcast sticky intents) android.permission.CALL_PHONE 允许一个程序初始化一个电话拨号不需通过拨号用户界面需要用户确认(Allowsan application to initiate a phone call without going through the Dialer userinterface for the user to confirm the call being placed.) android.permission.CALL_PRIVILEGED 允许一个程序拨打任何号码,包含紧急号码无需通过拨号用户界面需要用户确认(Allowsan application to call any phone number, including emergency numbers, withoutgoing through the Dialer user interface for the user to confirm the call beingplaced) android.permission.CAMERA 请求访问使用照相设备(Requiredto be able to access the camera device. ) android.permission.CHANGE_COMPONENT_ENABLED_STATE 允许一个程序是否改变一个组件或其他的启用或禁用(Allowsan application to change whether an application component (other than its own)is enabled or not. ) android.permission.CHANGE_CONFIGURATION 允许一个程序修改当前设置,如本地化(Allowsan application to modify the current configuration, such as locale. ) android.permission.CHANGE_NETWORK_STATE 允许程序改变网络连接状态(Allowsapplications to change network connectivity state) android.permission.CHANGE_WIFI_STATE 允许程序改变Wi-Fi连接状态(Allows applications to change Wi-Ficonnectivity state) android.permission.CLEAR_APP_CACHE 允许一个程序清楚缓存从所有安装的程序在设备中(Allowsan application to clear the caches of all installed applications on the device.) android.permission.CLEAR_APP_USER_DATA 允许一个程序清除用户设置(Allowsan application to clear user data) android.permission.CONTROL_LOCATION_UPDATES 允许启用禁止位置更新提示从无线模块(Allowsenabling/disabling location update notifications from the radio. ) android.permission.DELETE_CACHE_FILES 允许程序删除缓存文件(Allowsan application to delete cache files) android.permission.DELETE_PACKAGES 允许一个程序删除包(Allowsan application to delete packages) android.permission.DEVICE_POWER 允许访问底层电源管理(Allowslow-level access to power management) android.permission.DIAGNOSTIC 允许程序RW诊断资源(Allows applications to RW to diagnosticresources. ) android.permission.DISABLE_KEYGUARD 允许程序禁用键盘锁(Allowsapplications to disable the keyguard ) android.permission.DUMP 允许程序返回状态抓取信息从系统服务(Allowsan application to retrieve state dump information from system services.) android.permission.EXPAND_STATUS_BAR 允许一个程序扩展收缩在状态栏,android开发网提示应该是一个类似Windows Mobile中的托盘程序(Allows an application to expand orcollapse the status bar. ) android.permission.FACTORY_TEST 作为一个工厂测试程序,运行在root用户(Run as a manufacturer test application,running as the root user. ) android.permission.FLASHLIGHT 访问闪光灯,android开发网提示HTC Dream不包含闪光灯(Allowsaccess to the flashlight ) android.permission.FORCE_BACK 允许程序强行一个后退操作是否在顶层activities(Allowsan application to force a BACK operation on whatever is the top activity. ) android.permission.FOTA_UPDATE 暂时不了解这是做什么使用的,android开发网分析可能是一个预留权限. android.permission.GET_ACCOUNTS 访问一个帐户列表在AccountsService中(Allows access to thelist of accounts in the Accounts Service) android.permission.GET_PACKAGE_SIZE 允许一个程序获取任何package占用空间容量(Allows an application to find out thespace used by any package. ) android.permission.GET_TASKS 允许一个程序获取信息有关当前或最近运行的任务,一个缩略的任务状态,是否活动等等(Allowsan application to get information about the currently or recently runningtasks: a thumbnail representation of the tasks, what activities are running init, etc.) android.permission.HARDWARE_TEST 允许访问硬件(Allowsaccess to hardware peripherals. ) android.permission.INJECT_EVENTS 允许一个程序截获用户事件如按键、触摸、轨迹球等等到一个时间流,android开发网提醒算是hook技术吧(Allowsan application to inject user events (keys, touch, trackball) into the eventstream and deliver them to ANY window.) android.permission.INSTALL_PACKAGES 允许一个程序安装packages(Allowsan application to install packages. ) android.permission.INTERNAL_SYSTEM_WINDOW 允许打开窗口使用系统用户界面(Allowsan application to open windows that are for use by parts of the system userinterface. ) android.permission.INTERNET 允许程序打开网络套接字(Allowsapplications to open network sockets) android.permission.MANAGE_APP_TOKENS 允许程序管理(创建、催后、 z- order默认向z轴推移)程序引用在窗口管理器中(Allowsan application to manage (create, destroy, Z-order) application tokens in thewindow manager. ) android.permission.MASTER_CLEAR 目前还没有明确的解释,android开发网分析可能是清除一切数据,类似硬格机 android.permission.MODIFY_AUDIO_SETTINGS 允许程序修改全局音频设置(Allowsan application to modify global audio settings) android.permission.MODIFY_PHONE_STATE 允许修改话机状态,如电源,人机接口等(Allowsmodification of the telephony state – power on, mmi, etc. ) android.permission.MOUNT_UNMOUNT_FILESYSTEMS 允许挂载和反挂载文件系统可移动存储(Allowsmounting and unmounting file systems for removable storage. ) android.permission.PERSISTENT_ACTIVITY 允许一个程序设置他的activities显示(Allow an application to make itsactivities persistent. ) android.permission.PROCESS_OUTGOING_CALLS 允许程序监视、修改有关播出电话(Allowsan application to monitor, modify, or abort outgoing calls) android.permission.READ_CALENDAR 允许程序读取用户日历数据(Allowsan application to read the user’s calendar data.) android.permission.READ_CONTACTS 允许程序读取用户联系人数据(Allowsan application to read the user’s contacts data.) android.permission.READ_FRAME_BUFFER 允许程序屏幕波或和更多常规的访问帧缓冲数据(Allowsan application to take screen shots and more generally get access to the framebuffer data) android.permission.READ_INPUT_STATE 允许程序返回当前按键状态(Allowsan application to retrieve the current state of keys and switches. ) android.permission.READ_LOGS 允许程序读取底层系统日志文件(Allowsan application to read the low-level system log files. ) android.permission.READ_OWNER_DATA 允许程序读取所有者数据(Allowsan application to read the owner’s data) android.permission.READ_SMS 允许程序读取短信息(Allowsan application to read SMS messages.) android.permission.READ_SYNC_SETTINGS 允许程序读取同步设置(Allowsapplications to read the sync settings) android.permission.READ_SYNC_STATS 允许程序读取同步状态(Allowsapplications to read the sync stats) android.permission.REBOOT 请求能够重新启动设备(Requiredto be able to reboot the device. ) android.permission.RECEIVE_BOOT_COMPLETED 允许一个程序接收到ACTION_BOOT_COMPLETED广播在系统完成启动(Allowsan application to receive the ACTION_BOOT_COMPLETED that is broadcast after thesystem finishes booting. ) android.permission.RECEIVE_MMS 允许一个程序监控将收到MMS彩信,记录或处理(Allowsan application to monitor incoming MMS messages, to record or performprocessing on them. ) android.permission.RECEIVE_SMS 允许程序监控一个将收到短信息,记录或处理(Allowsan application to monitor incoming SMS messages, to record or performprocessing on them.) android.permission.RECEIVE_WAP_PUSH 允许程序监控将收到WAPPUSH信息(Allows an applicationto monitor incoming WAP push messages. ) android.permission.RECORD_AUDIO 允许程序录制音频(Allowsan application to record audio) android.permission.REORDER_TASKS 允许程序改变Z轴排列任务(Allows an application to change theZ-order of tasks) android.permission.RESTART_PACKAGES 允许程序重新启动其他程序(Allowsan application to restart other applications) android.permission.SEND_SMS 允许程序发送SMS短信(Allows an application to send SMSmessages) android.permission.SET_ACTIVITY_WATCHER 允许程序监控或控制activities已经启动全局系统中(Allows an application to watch andcontrol how activities are started globally in the system.) android.permission.SET_ALWAYS_FINISH 允许程序控制是否活动间接完成在处于后台时(Allowsan application to control whether activities are immediately finished when putin the background.) android.permission.SET_ANIMATION_SCALE 修改全局信息比例(Modifythe global animation scaling factor.) android.permission.SET_DEBUG_APP 配置一个程序用于调试(Configurean application for debugging.) android.permission.SET_ORIENTATION 允许底层访问设置屏幕方向和实际旋转(Allowslow-level access to setting the orientation (actually rotation) of the screen.) android.permission.SET_PREFERRED_APPLICATIONS 允许一个程序修改列表参数PackageManager.addPackageToPreferred()和PackageManager.removePackageFromPreferred()方法(Allowsan application to modify the list of preferred applications with thePackageManager.addPackageToPreferred() andPackageManager.removePackageFromPreferred() methods.) android.permission.SET_PROCESS_FOREGROUND 允许程序当前运行程序强行到前台(Allowsan application to force any currently running process to be in the foreground.) android.permission.SET_PROCESS_LIMIT 允许设置最大的运行进程数量(Allowsan application to set the maximum number of (not needed) application processesthat can be running. ) android.permission.SET_TIME_ZONE 允许程序设置时间区域(Allowsapplications to set the system time zone) android.permission.SET_WALLPAPER 允许程序设置壁纸(Allowsapplications to set the wallpaper ) android.permission.SET_WALLPAPER_HINTS 允许程序设置壁纸hits(Allowsapplications to set the wallpaper hints) android.permission.SIGNAL_PERSISTENT_PROCESSES 允许程序请求发送信号到所有显示的进程中(Allowan application to request that a signal be sent to all persistent processes) android.permission.STATUS_BAR 允许程序打开、关闭或禁用状态栏及图标Allowsan application to open, close, or disable the status bar and its icons. android.permission.SUBSCRIBED_FEEDS_READ 允许一个程序访问订阅RSSFeed内容提供(Allows an applicationto allow access the subscribed feeds ContentProvider. ) android.permission.SUBSCRIBED_FEEDS_WRITE 系统暂时保留改设置,android开发网认为未来版本会加入该功能。 android.permission.SYSTEM_ALERT_WINDOW 允许一个程序打开窗口使用TYPE_SYSTEM_ALERT,显示在其他所有程序的顶层(Allowsan application to open windows using the type TYPE_SYSTEM_ALERT, shown on topof all other applications. ) android.permission.VIBRATE 允许访问振动设备(Allowsaccess to the vibrator) android.permission.WAKE_LOCK 允许使用PowerManager的 WakeLocks保持进程在休眠时从屏幕消失(Allows using PowerManager WakeLocks to keep processor from sleeping or screen fromdimming) android.permission.WRITE_APN_SETTINGS 允许程序写入API设置(Allows applications to write the apnsettings) android.permission.WRITE_CALENDAR 允许一个程序写入但不读取用户日历数据(Allowsan application to write (but not read) the user’s calendar data. ) android.permission.WRITE_CONTACTS 允许程序写入但不读取用户联系人数据(Allowsan application to write (but not read) the user’s contacts data. ) android.permission.WRITE_GSERVICES 允许程序修改Google服务地图(Allows an application to modify theGoogle service map. ) android.permission.WRITE_OWNER_DATA 允许一个程序写入但不读取所有者数据(Allowsan application to write (but not read) the owner’s data.) android.permission.WRITE_SETTINGS 允许程序读取或写入系统设置(Allowsan application to read or write the system settings. ) android.permission.WRITE_SMS 允许程序写短信(Allowsan application to write SMS messages) android.permission.WRITE_SYNC_SETTINGS 允许程序写入同步设置(Allowsapplications to write the sync settings) <permission>和 <uses-permission>的作用相似,两者之间的不同之处, <uses-permission>是android预定义的权限, <permission>是自己定义的权限。 <permission>用的相对较少, <permission-group> <permission-tree>这两个标签就更少见了,简单说 <permission-group> 就是声明一个标签,该标签代表了一组permissions,而 <permission-tree>是为一组permissions声明了一个namespace。 参考文档:http://www.jb51.net/article/95979.htm

优秀的个人博客,低调大师

Manifest.xml 入门基础 (三) &amp;lt;uses-sdk&amp;gt;标签

Manifest.xml 入门基础 (三) <uses-sdk>标签 <uses-sdk android:minSdkVersion="integer" android:targetSdkVersion="integer" android:maxSdkVersion="integer" /> 用于表明应用程序与一个或多个版本 Android 平台的兼容性,以整数型的 API 级别来表示。 应用程序声明的 API 级别将与给定的 Android 系统进行比较,不同 Android 设备的 API Level 可能各不相同。 不要去理会名称(指 uses-sdk),本元素是用于指定 API 级别 的,而不是指 SDK (软件开发包)或 Android 平台的版本号。 API 级别总是以一个整数值来表示。 API 级别是无法从相应的 Android 版本号推导出来的(比如,它既不是主版本号,也不是主版本号加小版本号)。 1.android:minSdkVersion 整数值,指定运行应用程序所需的最低 API 级别。 如果系统 API 级别低于本属性设定的值, Android 系统将阻止用户安装此应用程序。 本属性必需指定。 提醒: 如果未声明本属性,系统假定缺省值为“1”,这表示应用程序与所有版本的 Android 兼容。 如果应用程序无法兼容所有版本(比如,用到了 API 级别 3 才开始引入的 API ), 也没有声明正确的 android:minSdkVersion, 那么安装在低于 API 级别 3 的系统中后,一旦在运行过程中试图访问不可用的 API,应用程序就会崩溃。 因此,请确保在 minSdkVersion 属性中声明正确的 API 级别。 2.android:targetSdkVersion 整数值,指定应用程序的目标 API 级别。如果不设置本属性,缺省值等于已给定的 minSdkVersion。 本属性将告知系统应用程序已经针对此目标版本进行了测试,系统不会启用任何与此目标版本相关的向前兼容特性。 应用程序仍然能够在较低版本(最低至 minSdkVersion)的系统上运行。 随着 Android 的版本更新,某些特性甚至组件外观都会发生变化。 不过,当平台的 API 级别高于应用程序声明的 targetSdkVersion时,系统会启用兼容性特性,应用程序仍然可以按预计方式运行。 通过把 targetSdkVersion 设定为所需的平台版本,你可以禁用兼容特性。 比如,将本值设置为大于等于“11”,当运行于 Android 3.0 以上版本时, 系统就能在应用程序上使用新加入的默认主题(Holo),并且在大屏幕设备上时还会禁用 屏幕兼容模式 (因为 API 级别 11 隐含了对大屏幕的支持)。 根据本属性设定的值,有系统可能会启用很多兼容性特性。 有相当多的特性在参考文档 Build.VERSION_CODES 中分版本进行了说明。 为了能随着 Android 版本的发布而对应用程序进行维护,你应该及时调大本属性值以匹配最新的 API 级别, 然后在对应版本的平台上对程序进行充分的测试。 3.android:maxSdkVersion 整数值,指定应用程序设计可运行的最高 API 级别。 为了说明本属性在系统更新后对应用程序的影响,请参阅以下例子: 某应用程序在 manifest 中声明了 maxSdkVersion=”5” ,并已在 Google Play 进行了发布。 有一个用户下载并安装了此应用程序,他的设备运行的是 Android 1.6 (API 级别 4)。 几星期后,用户通过无线系统把系统升级到了 Android 2.0(API 级别 5)。 升级完成后,系统会检查应用程序的 maxSdkVersion 并成功进行了重新校验,应用程序能够正常工作。 但是一段时间之后,设备又收到了另一个系统更新,这次是升级到 Android 2.0.1(API 级别 6)。 这次更新后系统无法再对应用程序进行重新校验了,因为当前系统的 API 级别 (6)已经高于应用程序支持的最大版本(5)了。 系统会阻止用户使用此应用程序,实际上将会从设备上删除它。 警告: 不建议声明本属性。 首先,没有必要用本属性来阻止应用程序在新版本 Android 平台上的使用。 理论上讲,新版本的平台完全是向后全兼容的。 应用程序应该可以在新版本平台上正常运行,新版本不仅提供标准的API,还能开发最佳的体验。 其次请注意,在某些场合声明本属性,可能会 导致系统升级到高版本 API 后把应用程序删除。 大多数设备都会通过无线网络定期接收到系统更新,因此在设置本属性之前,你应该考虑对应用程序的影响。 什么是 API 级别 API 级别是一个整数值,它唯一标识了某版本 Android 平台所提供的 API 的版本。 Android 平台提供了一整套 API,应用程序可以用这些 API 与底层系统进行交互。 这套API由以下部分组成: 核心包和类 声明和访问资源时所用的 XML 格式的元素和属性 一些预设的 Intent 应用程序可请求的权限以及系统预设的权限 Android 平台每个较高版本都会包含之前的 API 更新。 API 的更新机制使得新版本的 API 可以与早期版本保持兼容。 也就是说,大部分的 API 改动都是新增功能,或是引入新 API ,或是替代原有功能。 作为 API 升级过程中的一部分工作,被替换的旧功能被视为过时功能但不会被删除。 因此,现有的应用程序仍然可以使用这些过时的功能。 在极少数情况下,一部分 API 可能会被修改或删除,通常这种改动只是为了确保 API 的稳定性及应用程序或系统的安全性。 早期版​​本的 API 剩余部分都将原封不动地带入新版本。 API 级别在 Android 中的用途 当用户尝试安装某应用程序时,或者在系统升级后对应用程序重新校验时, Android 系统首先会检查应用程序 manifest 中的 <uses-sdk> 属性, 并将其值与系统内部的 API 级别进行比较。 只有满足以下条件时,系统才会允许应用程序的安装: 如果声明了android:minSdkVersion属性,则其值必须小于等于当前系统的 API 级别值。 如果未声明,系统就会假定该应用程序运行需要的最低 API 级别是 1 。 如果声明了android:maxSdkVersion属性,则其值必须大于等于当前系统的 API 级别值。 如果未声明,系统就会假定该应用程序没有最高 API 级别的限制。

优秀的个人博客,低调大师

Apache Spark技术实战(二)KafkaWordCount &amp;PackratParsers实例 &amp;Spark Cassandra C...

<一>KafkaWordCount 概要 Spark应用开发实践性非常强,很多时候可能都会将时间花费在环境的搭建和运行上,如果有一个比较好的指导将会大大的缩短应用开发流程。Spark Streaming中涉及到和许多第三方程序的整合,源码中的例子如何真正跑起来,文档不是很多也不详细。 本篇主要讲述如何运行KafkaWordCount,这个需要涉及Kafka集群的搭建,还是说的越仔细越好。 搭建Kafka集群 步骤1:下载kafka 0.8.1及解压 wget https://www.apache.org/dyn/closer.cgi?path=/kafka/0.8.1.1/kafka_2.10-0.8.1.1.tgz tar zvxf kafka_2.10-0.8.1.1.tgz cd kafka_2.10-0.8.1.1 步骤2:启动zookeeper bin/zookeeper-server-start.sh config/zookeeper.properties 步骤3:修改配置文件config/server.properties,添加如下内容 host.name=localhost # Hostname the broker will advertise to producers and consumers. If not set, it uses the # value for "host.name" if configured. Otherwise, it will use the value returned from # java.net.InetAddress.getCanonicalHostName(). advertised.host.name=localhost 步骤4:启动Kafka server bin/kafka-server-start.sh config/server.properties 步骤5:创建topic bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test 检验topic创建是否成功 bin/kafka-topics.sh --list --zookeeper localhost:2181 如果正常返回test 步骤6:打开producer,发送消息 bin/kafka-console-producer.sh --broker-list localhost:9092 --topic test ##启动成功后,输入以下内容测试 This is a message This is another message 步骤7:打开consumer,接收消息 bin/kafka-console-consumer.sh --zookeeper localhost:2181 --topic test --from-beginning ###启动成功后,如果一切正常将会显示producer端输入的内容 This is a message This is another message 运行KafkaWordCount KafkaWordCount源文件位置 :examples/src/main/scala/org/apache/spark/examples/streaming/KafkaWordCount.scala 尽管里面有使用说明,见下文,但如果不是事先对Kafka有一定的了解的话,决然不知道这些参数是什么意思,也不知道该如何填写。 /** * Consumes messages from one or more topics in Kafka and does wordcount. * Usage: KafkaWordCount * is a list of one or more zookeeper servers that make quorum * is the name of kafka consumer group * is a list of one or more kafka topics to consume from * is the number of threads the kafka consumer should use * * Example: * `$ bin/run-example \ * org.apache.spark.examples.streaming.KafkaWordCount zoo01,zoo02,zoo03 \ * my-consumer-group topic1,topic2 1` */ object KafkaWordCount { def main(args: Array[String]) { if (args.length < 4) { System.err.println("Usage: KafkaWordCount ") System.exit(1) } StreamingExamples.setStreamingLogLevels() val Array(zkQuorum, group, topics, numThreads) = args val sparkConf = new SparkConf().setAppName("KafkaWordCount") val ssc = new StreamingContext(sparkConf, Seconds(2)) ssc.checkpoint("checkpoint") val topicpMap = topics.split(",").map((_,numThreads.toInt)).toMap val lines = KafkaUtils.createStream(ssc, zkQuorum, group, topicpMap).map(_._2) val words = lines.flatMap(_.split(" ")) val wordCounts = words.map(x => (x, 1L)) .reduceByKeyAndWindow(_ + _, _ - _, Minutes(10), Seconds(2), 2) wordCounts.print() ssc.start() ssc.awaitTermination() } } 讲清楚了写这篇博客的主要原因之后,来看一看该如何运行KafkaWordCount 步骤1:停止运行刚才的kafka-console-producer和kafka-console-consumer 步骤2:运行KafkaWordCountProducer bin/run-example org.apache.spark.examples.streaming.KafkaWordCountProducer localhost:9092 test 3 5 解释一下参数的意思,localhost:9092表示producer的地址和端口, test表示topic,3表示每秒发多少条消息,5表示每条消息中有几个单词 步骤3:运行KafkaWordCount bin/run-example org.apache.spark.examples.streaming.KafkaWordCount localhost:2181 test-consumer-group test 1 解释一下参数, localhost:2181表示zookeeper的监听地址,test-consumer-group表示consumer-group的名称,必须和$KAFKA_HOME/config/consumer.properties中的group.id的配置内容一致,test表示topic,1表示线程数。 <二>PackratParsers实例 概要 通过一个简明的Demo程序来说明如何使用scala中的PackratParsers DemoApp import scala.util.parsing.combinator.PackratParsers import scala.util.parsing.combinator.syntactical._ object Dotter extends StandardTokenParsers with PackratParsers { //定义分割符 lexical.delimiters ++= List(".",";","+","-","*") //合法的输入模式,支持加,减,乘 lazy val pgm : PackratParser[Int] = expr | minus|multiply //定义模式加 lazy val expr :PackratParser[Int]= num~"+"~num ^^ {case n1~"+"~n2 => n1.toInt + n2.toInt} //定义模式减 lazy val minus :PackratParser[Int]= num~"-"~num ^^ {case n1~"-"~n2 => n1.toInt - n2.toInt} lazy val multiply :PackratParser[Int]= num~"*"~num ^^ {case n1~"*"~n2 => n1.toInt * n2.toInt} lazy val num = numericLit def parse(input: String) = phrase(pgm)(new PackratReader(new lexical.Scanner(input))) match { case Success(result, _) => println("Success!"); println(result);Some(result) case n @ _ => println(n);println("bla"); None } def main(args: Array[String]) { //定义list,::表示添加,Nil表示list结束 val prg = "12*2"::"24-4"::"3+5"::Nil prg.map(parse) } } parser中的表达式说明 A<~B 只保留左侧内容 A<~B 只保留A A~>B 只保留右侧内容 A~>B 只保留B ^^ 根据匹配结果生成语法短语 ^^^ 将语法短语转换成为另外的值,注意与^^的区别 ~ 连接符 A ̃B 表示模式匹配是B紧跟于A之后 | 或者 A|B 表示模式要么由A组成,要么由B组成 编译执行 将上述源码保存到文件dotter.scala。 编译 scalac dotter.scala 执行 scala -cp . Dotter <三>Spark Cassandra Connector的安装和使用 前提 假设当前已经安装好如下软件: jdk sbt git scala 安装cassandra 以archlinux为例,使用如下指令来安装Cassandra: yaourt -S cassandra 启动cassandra: cassandra -f 创建keyspace和table, 运行/usr/bin/cqlsh进入cql console,然后执行下述语句创建keyspace和table: CREATE KEYSPACE test WITH replication = {'class': 'SimpleStrategy', 'replication_factor': 1 }; CREATE TABLE test.kv(key text PRIMARY KEY, value int); 添加记录,继续使用cql console: INSERT INTO test.kv(key, value) VALUES ('key1', 1); INSERT INTO test.kv(key, value) VALUES ('key2', 2); 验证记录已经插入成功,执行如下cql: select * from test.kv; 下载编译spark-cassandra-connector 下载最新的spark-cassandra-connector源码: git clone https://github.com/datastax/spark-cassandra-connector.git 编译: sbt package 这中间要等待比较长的时间,请保持足够的耐心。 运行spark-shell 首先请确保cassandra已经正常安装和运行,如有问题请返回开始的章节安装Cassandra。 如何添加相应的library来支持spark-cassandra-connector,并没有一个明确的文档说明,折腾了一个下午,终于弄出了一个最简的配置。 bin/spark-shell --driver-class-path /root/working/spark-cassandra-connector/spark-cassandra-connector/target/scala-2.10/spark-cassandra-connector_2.10-1.1.0-SNAPSHOT.jar: /root/.ivy2/cache/org.apache.cassandra/cassandra-thrift/jars/cassandra-thrift-2.0.9.jar: /root/.ivy2/cache/org.apache.thrift/libthrift/jars/libthrift-0.9.1.jar: /root/.ivy2/cache/org.apache.cassandra/cassandra-clientutil/jars/cassandra-clientutil-2.0.9.jar: /root/.ivy2/cache/com.datastax.cassandra/cassandra-driver-core/jars/cassandra-driver-core-2.0.4.jar: /root/.ivy2/cache/io.netty/netty/bundles/netty-3.9.0.Final.jar: /root/.ivy2/cache/com.codahale.metrics/metrics-core/bundles/metrics-core-3.0.2.jar: /root/.ivy2/cache/org.slf4j/slf4j-api/jars/slf4j-api-1.7.7.jar: /root/.ivy2/cache/org.apache.commons/commons-lang3/jars/commons-lang3-3.3.2.jar: /root/.ivy2/cache/org.joda/joda-convert/jars/joda-convert-1.2.jar: /root/.ivy2/cache/joda-time/joda-time/jars/joda-time-2.3.jar: /root/.ivy2/cache/org.apache.cassandra/cassandra-all/jars/cassandra-all-2.0.9.jar: /root/.ivy2/cache/org.slf4j/slf4j-log4j12/jars/slf4j-log4j12-1.7.2.jar 上述指令假设spark-cassandra-connector的源码是下载在$HOME/working目录下,请根据自己的情况作适当修改。 我是如何猜测到需要指定这些包依赖的呢?说白了,也很简单,就是执行以下指令,然后再查看相就的java进程中的运行参数。 #运行spark-cassandra-connector测试集 sbt test sbt it:test 当上述指令还在运行的时候,使用ps来查看java运行的参数,这样就反过来知道所需要的包依赖了。 ps -ef|grep -i java 测试程序 由于spark-shell会默认创建sc,所以首先需要停止掉默认的sc,然后利用新的配置来创建可以连接到cassandra的sc,示例代码如下: sc.stop import com.datastax.spark.connector._ import org.apache.spark._ val conf = new SparkConf() conf.set("spark.cassandra.connection.host", "127.0.0.1") val sc = new SparkContext("local[2]", "Cassandra Connector Test", conf) val table = sc.cassandraTable("test", "kv") table.count 如果一切正常会显示出如下结果: res3: Long = 2 小结 进入实战阶段,挑战会越来越多,保持足够的信心和耐心很重要。 本篇内容和实战一中的kafka cluster组织在一起的话,就会形成一个从前台到后台存储的完整处理链条。

优秀的个人博客,低调大师

Flink-Table-&amp;-SQL

简介 Apache Flink具有两个关系API - 表API和SQL - 用于统一流和批处理。Table API是Scala和Java的语言集成查询API,允许以非常直观的方式组合来自关系运算符的查询,Table API和SQL接口彼此紧密集成,以及Flink的DataStream和DataSet API。您可以轻松地在基于API构建的所有API和库之间切换。例如,您可以使用CEP库从DataStream中提取模式,然后使用Table API分析模式,或者可以在预处理上运行Gelly图算法之前使用SQL查询扫描,过滤和聚合批处理表数据。 Flink SQL的编程模型 创建一个TableEnvironment TableEnvironment是Table API和SQL集成的核心概念,它主要负责: 1、在内部目录中注册一个Table 2、注册一个外部目录 3、执行SQL查询 4、注册一个用户自定义函数(标量、表及聚合) 5、将DataStream或者DataSet转换成Table 6、持有ExecutionEnvironment或者StreamExecutionEnvironment的引用一个Table总是会绑定到一个指定的TableEnvironment中,相同的查询不同的TableEnvironment是无法通过join、union合并在一起。TableEnvironment有一个在内部通过表名组织起来的表目录,Table API或者SQL查询可以访问注册在目录中的表,并通过名称来引用它们。 在目录中注册表 TableEnvironment允许通过各种源来注册一个表: 1、一个已存在的Table对象,通常是Table API或者SQL查询的结果 Table projTable = tableEnv.scan("X").select(...); 2、TableSource,可以访问外部数据如文件、数据库或者消息系统 TableSource csvSource = new CsvTableSource("/path/to/file", ...); 3、DataStream或者DataSet程序中的DataStream或者DataSet //将DataSet转换为Table Table table= tableEnv.fromDataSet(tableset); 注册TableSink 注册TableSink可用于将Table API或SQL查询的结果发送到外部存储系统,例如数据库,键值存储,消息队列或文件系统(在不同的编码中,例如,CSV,Apache [Parquet] ,Avro,ORC],......): TableSink csvSink = new CsvTableSink("/path/to/file", ...); 2、 String[] fieldNames = {"a", "b", "c"}; TypeInformation[] fieldTypes = {Types.INT, Types.STRING, Types.LONG}; tableEnv.registerTableSink("CsvSinkTable", fieldNames, fieldTypes, csvSink); 实战案例一 基于Flink SQL的WordCount: public class WordCountSQL { public static void main(String[] args) throws Exception{ ExecutionEnvironment env = ExecutionEnvironment.getExecutionEnvironment(); BatchTableEnvironment tEnv = TableEnvironment.getTableEnvironment(env); List list = new ArrayList(); String wordsStr = "Hello Flink Hello TOM"; String[] words = wordsStr.split("\\W+"); for(String word : words){ WC wc = new WC(word, 1); list.add(wc); } DataSet<WC> input = env.fromCollection(list); tEnv.registerDataSet("WordCount", input, "word, frequency"); Table table = tEnv.sqlQuery( "SELECT word, SUM(frequency) as frequency FROM WordCount GROUP BY word"); DataSet<WC> result = tEnv.toDataSet(table, WC.class); result.print(); }//main public static class WC { public String word;//hello public long frequency;//1 // public constructor to make it a Flink POJO public WC() {} public WC(String word, long frequency) { this.word = word; this.frequency = frequency; } @Override public String toString() { return "WC " + word + " " + frequency; } } } 输出如下: WC TOM 1 WC Hello 2 WC Flink 1 实战案例二 本例稍微复杂,首先读取一个文件中的内容进行统计,并写入到另外一个文件中: public class SQLTest { public static void main(String[] args) throws Exception{ ExecutionEnvironment env = ExecutionEnvironment.getExecutionEnvironment(); BatchTableEnvironment tableEnv = BatchTableEnvironment.getTableEnvironment(env); env.setParallelism(1); DataSource<String> input = env.readTextFile("test.txt"); input.print(); //转换成dataset DataSet<Orders> topInput = input.map(new MapFunction<String, Orders>() { @Override public Orders map(String s) throws Exception { String[] splits = s.split(" "); return new Orders(Integer.valueOf(splits[0]), String.valueOf(splits[1]),String.valueOf(splits[2]), Double.valueOf(splits[3])); } }); //将DataSet转换为Table Table order = tableEnv.fromDataSet(topInput); //orders表名 tableEnv.registerTable("Orders",order); Table tapiResult = tableEnv.scan("Orders").select("name"); tapiResult.printSchema(); Table sqlQuery = tableEnv.sqlQuery("select name, sum(price) as total from Orders group by name order by total desc"); //转换回dataset DataSet<Result> result = tableEnv.toDataSet(sqlQuery, Result.class); //将dataset map成tuple输出 /*result.map(new MapFunction<Result, Tuple2<String,Double>>() { @Override public Tuple2<String, Double> map(Result result) throws Exception { String name = result.name; Double total = result.total; return Tuple2.of(name,total); } }).print();*/ TableSink sink = new CsvTableSink("SQLTEST.txt", "|"); //writeToSink /*sqlQuery.writeToSink(sink); env.execute();*/ String[] fieldNames = {"name", "total"}; TypeInformation[] fieldTypes = {Types.STRING, Types.DOUBLE}; tableEnv.registerTableSink("SQLTEST", fieldNames, fieldTypes, sink); sqlQuery.insertInto("SQLTEST"); env.execute(); } /** * 源数据的映射类 */ public static class Orders { /** * 序号,姓名,书名,价格 */ public Integer id; public String name; public String book; public Double price; public Orders() { super(); } public Orders(Integer id, String name, String book, Double price) { this.id = id; this.name = name; this.book = book; this.price = price; } } /** * 统计结果对应的类 */ public static class Result { public String name; public Double total; public Result() {} } }//

优秀的个人博客,低调大师

设计模式&amp;#183;Sunny

设计模式 Sunny在CSDN技术博客中陆续发表了100多篇与设计模式学习相关的文章,涵盖了七个面向对象设计原则和24个设计模式(23个GoF设计模式 + 简单工厂模式),为了方便大家学习,http://quanke.name现将所有文章的进行了整理,方便大家下载阅读,希望能给各位带来帮助! 阅读地址:http://gof.quanke.name/ 下载地址:https://www.gitbook.com/book/quanke/design-pattern-java/ 源码下载地址:https://github.com/quanke/design-pattern-java-source-code.git 课件下载地址:http://www.chinasa.info/download/DP-Slides.rar 作者:刘伟http://blog.csdn.net/lovelion 本书编辑:http://quanke.name 刘伟(Sunny),中南大学计算机应用技术博士,国家认证系统分析师(2005年),国家认证系统架构设计师(2009年,全国第四名),高级程序员,数据库系统工程师,MCSE,MCDBA,CASI专业顾问与企业内训讲师。具有十多年软件开发、项目管理及教育培训经验,曾在NIIT(印度国家信息技术学院)担任高级讲师,主持和参与30多个软件项目的开发工作,并给国内多家公司提供软件开发、软件设计等培训服务,现主要致力于软件工程、数据挖掘等领域的教学、推广和研究工作。技术专长:软件架构、设计模式、UML、OOAD、数据挖掘等。已出版设计模式书籍四本:《设计模式》(清华大学出版社,2011年)、《设计模式实训教程》(清华大学出版社,2012年)、《设计模式的艺术——软件开发人员内功修炼之道》(清华大学出版社,2013年)、《C#设计模式》(清华大学出版社,2013年)。架构师之家www.chinasa.info站长。 E-mail:weiliu_china@126.com微博地址:http://weibo.com/csusunny 更多干货,请关注:http://quanke.name

优秀的个人博客,低调大师

MS SQL巡检系列&amp;mdash;&amp;mdash;检查外键字段是否缺少索引

原文: MS SQL巡检系列——检查外键字段是否缺少索引 前言感想:一时兴起,突然想写一个关于MS SQL的巡检系列方面的文章,因为我觉得这方面的知识分享是有价值,也是非常有意义的。一方面,很多经验不足的人,对于巡检有点茫然,不知道要从哪些方面巡检,另外一方面,网上关于MS SQL巡检方面的资料好像也不是特别多。写这个系列只是一个分享,自己的初衷是一个知识梳理、总结提炼过程,有些知识和脚本也不是原创,文章很多地方融入了自己的一些想法和见解的,不足和肤浅之处肯定也非常多,抛砖引玉,也希望大家提意见和建议、补充,指正其中的不足之处。Stay Hungry Stay Foolish! MS SQL巡检系列——检查重复索引 MS SQL巡检系列——检查外键字段是否缺少索引 MS SQL巡检系列——检查数据库上一次DBCC CHECKDB的时间 对于绝大部分情况,外键字段都有必要建立对应的索引(注意,外键约束并不会自动建立索引),关于外键字段为什么要建立索引?下面从几个简单的例子来分析一下。我们先准备测试环境数据。 CREATETABLE PRIMARY_TB ( PRODUCT_CD VARCHAR(12) , PRODUCT_DATE DATE , PRODUCT_DESC VARCHAR(120) , CONSTRAINT PK_PRIMARY_TB PRIMARYKEYCLUSTERED (PRODUCT_CD) ); SET NOCOUNT ON; GO DECLARE @IndexINT=1; BEGINTRAN WHILE @Index <= 3000 BEGIN INSERT INTO dbo.PRIMARY_TB SELECT'Prd' + CAST(@IndexASVARCHAR(4)), GETDATE() - CEILING(RAND()*200), 'production description' + CAST(@IndexASVARCHAR(4)); SET @Index +=1; END COMMIT; CREATETABLE FK_TB ( FK_ID INTIDENTITY(1,1), SALES_REGION VARCHAR(32), SALES_CITY VARCHAR(32), PRODUCT_CD VARCHAR(12), SALIES_SUM INT, CONSTRAINT PK_FK_TB PRIMARYKEYCLUSTERED (FK_ID) ) GO ALTERTABLE [dbo].[FK_TB] WITHCHECKADD CONSTRAINT [FK_PRIMARY_TB_PRODUCT_CD] FOREIGNKEY([PRODUCT_CD]) REFERENCES [dbo].[PRIMARY_TB] ([PRODUCT_CD]) ON DELETECASCADE; GO SET NOCOUNT ON; GO DECLARE @IndexINT=1; BEGINTRAN WHILE @Index <=1000000 BEGIN INSERT INTO FK_TB SELECT'REGION'+CAST(CEILING(RAND()*20) ASVARCHAR(2)), CAST(CEILING(RAND()*300) ASVARCHAR(3)),'Prd'+ CAST(CEILING(RAND()*3000) ASVARCHAR(8)),CEILING(RAND()*100000); SET @Index +=1; END COMMIT; UPDATESTATISTICS dbo.PRIMARY_TB WITH FULLSCAN; UPDATESTATISTICS dbo.FK_TB WITH FULLSCAN; GO 1: 外键字段建立索引,在主表与子表JOIN操作时能提高性能,减少IO操作。 DBCC DROPCLEANBUFFERS; GO DBCC FREEPROCCACHE; GO SETSTATISTICS IO ON; SETSTATISTICSTIMEON; SELECT p.PRODUCT_CD , p.PRODUCT_DATE , f.SALES_REGION , f.SALES_CITY , f.SALIES_SUM FROM dbo.PRIMARY_TB p INNERJOIN dbo.FK_TB f ON p.PRODUCT_CD = f.PRODUCT_CD WHERE p.PRODUCT_CD ='Prd131'; SETSTATISTICS IO OFF; SETSTATISTICSTIMEOFF; 如下截图所示,如果外键字段缺少索引,这两个表关联查询时,子表就会走扫描(此处测试是聚集索引扫描),如果子表非常大(例如此处案例所示),IO开销就比较大。 我们对外键约束字段PRODUCT_CD建立下面非聚集索引IDX_FK_TB,然后对比两者的执行计划和IO开销 CREATEINDEX IDX_FK_TB ON dbo.FK_TB(PRODUCT_CD); DBCC DROPCLEANBUFFERS; GO DBCC FREEPROCCACHE; GO SETSTATISTICS IO ON; SETSTATISTICSTIMEON; SELECT p.PRODUCT_CD , p.PRODUCT_DATE , f.SALES_REGION , f.SALES_CITY , f.SALIES_SUM FROM dbo.PRIMARY_TB p INNERJOIN dbo.FK_TB f ON p.PRODUCT_CD = f.PRODUCT_CD WHERE p.PRODUCT_CD ='Prd131' SETSTATISTICS IO OFF; SETSTATISTICSTIMEOFF; 你会发现执行计划从原来的聚集索引扫描(Clustered Index Scan)变成了索引查找(Index Seek),IO的减少也是非常明显的。因为这里仅仅是测试数据,复杂的生产环境,性能的提升有可能比这更加明显。 2:如果外键约束为CASCADE(on update/delete)时,则当修改被引用行(referenced row)时,所有引用行(referencing rows )也必须修改(更新或级联删除)。外键列上的索引能减小锁的粒度和范围,从而提高效率和性能。如下所示: 我们先看看缺少索引的情况。 DROPINDEX IDX_FK_TB ON dbo.FK_TB; DBCC DROPCLEANBUFFERS; GO DBCC FREEPROCCACHE; GO SETSTATISTICS IO ON; SETSTATISTICSTIMEON; DELETEFROM dbo.PRIMARY_TB WHERE PRODUCT_CD IN ('Prd132','Prd133') GO SETSTATISTICS IO OFF; SETSTATISTICSTIMEOFF; CREATEINDEX IDX_FK_TB ON dbo.FK_TB(PRODUCT_CD); GO DBCC DROPCLEANBUFFERS; GO DBCC FREEPROCCACHE; GO SETSTATISTICS IO ON; SETSTATISTICSTIMEON; DELETEFROM dbo.PRIMARY_TB WHERE PRODUCT_CD IN ('Prd134','Prd135') GO SETSTATISTICS IO OFF; SETSTATISTICSTIMEOFF; 3:如果外键关系为NO ACTION(on update/delete)时,那么被引用的行不能被删除,因为这个操作会导致引用行变成“孤立”。删除之前,数据库会为了有效地查找、定位行,外键列上创建索引也非常有帮助。 上面肤浅的构造了简单案例,并对比外键约束字段拥有索引和缺少索引时,SQL的执行计划和IO的差异,那么接下来,我们进入正题,巡检的时候,我们必须通过脚本找到数据库里面外键字段没有索引的相关表和信息,并生成对应的创建索引的脚本。如下所示。 /* One or more tables found, with foreign key constraint defined but no supporting indexes created on the foreign key columns. SQL Server doesnt put an index on foreign key columns by default and indexing foreign key fields in referencing tables is not required. Foreign key columns usage must evaluated to determine whether or not indexing this column will help up increase the current workloads performance by enhancing join performance, reducing table locking (for full table scans) while cascading updates and deletes, etc. */ ; WITH FKTable AS ( SELECT SCHEMA_NAME(po.schema_id) AS'parent_schema_name' , OBJECT_NAME(fkc.parent_object_id) AS'parent_table_name' , OBJECT_NAME(constraint_object_id) AS'constraint_name' , SCHEMA_NAME(ro.schema_id) AS'referenced_schema' , OBJECT_NAME(referenced_object_id) AS'referenced_table_name' , ( SELECT '[' + COL_NAME(k.parent_object_id, parent_column_id) + ']'AS [data()] FROM sys.foreign_key_columns (NOLOCK) AS k INNERJOIN sys.foreign_keys (NOLOCK) ON k.constraint_object_id = object_id AND k.constraint_object_id = fkc.constraint_object_id ORDERBY constraint_column_id FOR XML PATH('') ) AS'parent_colums' , ( SELECT '[' + COL_NAME(k.referenced_object_id, referenced_column_id) + ']'AS [data()] FROM sys.foreign_key_columns (NOLOCK) AS k INNERJOIN sys.foreign_keys (NOLOCK) ON k.constraint_object_id = object_id AND k.constraint_object_id = fkc.constraint_object_id ORDERBY constraint_column_id FOR XML PATH('') ) AS'referenced_columns' FROM sys.foreign_key_columns fkc ( NOLOCK ) INNERJOIN sys.objects po ( NOLOCK ) ON fkc.parent_object_id = po.object_id INNERJOIN sys.objects ro ( NOLOCK ) ON fkc.referenced_object_id = ro.object_id WHERE po.type = 'U' AND ro.type = 'U' GROUPBY po.schema_id , ro.schema_id , fkc.parent_object_id , constraint_object_id , referenced_object_id ), /* Index Columns */ IndexColumnsTable AS ( SELECT SCHEMA_NAME(o.schema_id) AS'schema_name' , OBJECT_NAME(o.object_id) AS TableName , ( SELECT CASE key_ordinal WHEN 0 THENNULL ELSE'[' + COL_NAME(k.object_id, column_id) + ']' ENDAS [data()] FROM sys.index_columns (NOLOCK) AS k WHERE k.object_id = i.object_id AND k.index_id = i.index_id ORDERBY key_ordinal , column_id FOR XML PATH('') ) AS cols FROM sys.indexes (NOLOCK) AS i INNERJOIN sys.objects o ( NOLOCK ) ON i.object_id = o.object_id INNERJOIN sys.index_columns ic ( NOLOCK ) ON ic.object_id = i.object_id AND ic.index_id = i.index_id INNERJOIN sys.columns c ( NOLOCK ) ON c.object_id = ic.object_id AND c.column_id = ic.column_id WHERE o.type = 'U' AND i.index_id > 0 GROUPBY o.schema_id , o.object_id , i.object_id , i.name , i.index_id , i.type ), FKWithoutIndexTable AS ( SELECT fk.parent_schema_name AS SchemaName , fk.parent_table_name AS TableName , fk.referenced_schema AS ReferencedSchemaName , fk.referenced_table_name AS ReferencedTableName , fk.constraint_name AS ConstraintName , fk.referenced_columns AS Referenced_Columns , fk.parent_colums AS Parent_Columns FROM FKTable fk WHERE NOTEXISTS ( SELECT 1 FROM IndexColumnsTable ict WHERE fk.parent_schema_name = ict.schema_name AND fk.parent_table_name = ict.TableName AND fk.parent_colums = LEFT(ict.cols, LEN(fk.parent_colums)) ) ) SELECT @@SERVERNAME AS InstanceName , DB_NAME() AS DatabaseName , SchemaName , TableName , Parent_Columns , ReferencedSchemaName , ReferencedTableName , Referenced_Columns , ConstraintName INTO #ForeignKeyWithOutIndex FROM FKWithoutIndexTable ORDERBY DatabaseName , SchemaName , TableName; --输出临时表数据 SELECT * FROM #ForeignKeyWithOutIndex; --生成外键字段缺少的索引,请抽查、检验,确认后批量执行 SELECT 'CREATE INDEX IX_' + LTRIM(RTRIM(TableName)) + '_' + SUBSTRING(Parent_Columns, 2, LEN(Parent_Columns) - 2) + ' ON ' + LTRIM(RTRIM(SchemaName)) + '.' + LTRIM(RTRIM(TableName)) + '(' + Parent_Columns + ');' FROM #ForeignKeyWithOutIndex; --删除临时表 DROPTABLE #ForeignKeyWithOutIndex; 在创建这些索引前最好检查、确认一下,外键字段创建索引能提高性能,但是肯定也要特殊的场景和上下文不适合,所以最好根据实际情况决定。索引创建之后,通过监控工具监控一下数据库性能、等待事件的变化。 参考资料: http://stackoverflow.com/questions/3650690/should-every-sql-server-foreign-key-have-a-matching-index http://sqlblog.com/blogs/greg_low/archive/2008/07/29/indexing-foreign-keys-should-sql-server-do-that-automatically.aspx http://www.sqlskills.com/blogs/kimberly/when-did-sql-server-stop-putting-indexes-on-foreign-key-columns/

优秀的个人博客,低调大师

从头学起android&amp;lt;android基本的绘图.四十六.&amp;gt;

在一般的图形渲染用户通常只需要重写onDraw()该方法可以是。但是假设,才能真正完成绘图操作。此外,我们需要掌握的四大核心经营类: android.graphics.Bitmap:主要表示的是一个图片的存储空间。所包括的图片能够来自于文件或由程序创建; android.graphics.Paint:基本的画图工具类,能够指定画图的样式; android.graphics.Canvas:是一个操作画图以及Bitmap的平台,相当于提供了一个画板的功能,在onDraw()方法的參数中也定义了此类型的參数,能够依靠此类完毕详细的画图操作。 android.graphics.drawable.Drawable:绘制图形的公共父类,能够绘制各种图形、图层等。 自己定义MyView组件 <span style="font-size:18px;"><LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" tools:context=".MainActivity" > <com.example.paintpic.MyView android:id="@+id/Myview" android:layout_width="wrap_content" android:layout_height="wrap_content" ></com.example.paintpic.MyView> </LinearLayout> </span> 主界面 <span style="font-size:18px;">package com.example.paintpic; import android.os.Bundle; import android.app.Activity; import android.view.Menu; public class MainActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); } } </span> MyView设置 <span style="font-size:18px;">package com.example.paintpic; import android.content.Context; import android.graphics.Canvas; import android.graphics.Color; import android.graphics.Paint; import android.graphics.RectF; import android.util.AttributeSet; import android.view.View; public class MyView extends View { public MyView(Context context, AttributeSet attrs) { super(context, attrs); // TODO Auto-generated constructor stub } @Override protected void onDraw(Canvas canvas) { // TODO Auto-generated method stub // canvas是画板对象,背景是白色的 canvas.drawColor(Color.WHITE); // paint画笔工具 Paint paint = new Paint(); // 设置画笔颜色为蓝色 paint.setColor(Color.BLUE); // 为画板上画圆。圆心(50,50)半径50 canvas.drawCircle(50, 50, 50, paint); // 设置画笔颜色的颜色为红色 paint.setColor(Color.RED); // 画矩形 canvas.drawRect(100, 0, 160, 80, paint); // 画笔颜色为绿色 paint.setColor(Color.GREEN); // 画直线 canvas.drawLine(50, 110, 200, 110, paint); paint.setColor(Color.YELLOW); // Rect rect=new Rect(120, 120, 300, 300); // canvas.drawRect(rect, paint); // 使用RectF画多边形 RectF oval = new RectF(); oval.set(10.0f, 140.0f, 110.0f, 200.0f); canvas.drawOval(oval, paint); oval = new RectF(); oval.set(150.0f, 140.0f, 210.0f, 200.0f); canvas.drawArc(oval, 150.0f, 140.0f, true, paint); } } </span> 使用Canvas和point组件能够绘制出各种各样的图形,多用于游戏的开发。感兴趣的朋友能够自己了解下 根据第预测:bitmap图形组件 版权声明:本文博客原创文章,博客,未经同意,不得转载。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/4628322.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Manifest.xml 入门基础(一) 概述与&amp;lt;manifest&amp;gt;标签

Manifest.xml 入门基础 (一)概述与<manifest>标签 第零讲 概述 每个应用的根目录中都必须包含一个 AndroidManifest.xml 文件(且文件名精确无误)。 清单文件向 Android 系统提供应用的必要信息,系统必须具有这些信息方可运行应用的任何代码。 此外,清单文件还可执行以下操作: (1)为应用的 Java 软件包命名。软件包名称充当应用的唯一标识符。 (2)描述应用的各个组件,包括构成应用的 Activity、服务、广播接收器和内容提供程序。它还为实现每个组件的类命名并发布其功能,例如它们可以处理的 Intent 消息。这些声明向 Android 系统告知有关组件以及可以启动这些组件的条件的信息。 (3)确定托管应用组件的进程。 (4)声明应用必须具备哪些权限才能访问 API 中受保护的部分并与其他应用交互。还声明其他应用与该应用组件交互所需具备的权限 (5)列出 Instrumentation 类,这些类可在应用运行时提供分析和其他信息。这些声明只会在应用处于开发阶段时出现在清单中,在应用发布之前将移除。 (6)声明应用所需的最低 Android API 级别 (7)列出应用必须链接到的库 以上来自Android开发者中心 下面是一个AndroidManifest.xml示例: <?xml version="1.0" encoding="utf-8"?> <manifest> <uses-permission /> <permission /> <permission-tree /> <permission-group /> <instrumentation /> <uses-sdk /> <uses-configuration /> <uses-feature /> <supports-screens /> <compatible-screens /> <supports-gl-texture /> <application> <activity> <intent-filter> <action /> <category /> <data /> </intent-filter> <meta-data /> </activity> <activity-alias> <intent-filter> . . . </intent-filter> <meta-data /> </activity-alias> <service> <intent-filter> . . . </intent-filter> <meta-data/> </service> <receiver> <intent-filter> . . . </intent-filter> <meta-data /> </receiver> <provider> <grant-uri-permission /> <meta-data /> <path-permission /> </provider> <uses-library /> </application> </manifest> 第一讲 <manifest>标签 <manifest xmlns:android="http://schemas.android.com/apk/res/android" package="com.woody.test" android:sharedUserId="string" android:sharedUserLabel="string resource" android:versionCode="integer" android:versionName="string" android:installLocation=["auto" | "internalOnly" | "preferExternal"] xmlns:tools="http://schemas.android.com/tools"> <!--tools是后更新的,详情看H、tools的链接--> </manifest> A、xmlns:android 定义android命名空间,一般为 http://schemas.android.com/apk/res/android ,这样使得Android中各种标准属性能在文件中使用,提供了大部分元素中的数据。 B、package 指定本应用内java主程序包的包名,它也是一个应用进程的默认名称 C、sharedUserId 表明数据权限,因为默认情况下,Android给每个APK分配一个唯一的UserID,所以是默认禁止不同APK访问共享数据的。若要共享数据,第一可以采用Share Preference方法,第二种就可以采用sharedUserId了,将不同APK的sharedUserId都设为一样,则这些APK之间就可以互相共享数据了。 Android给每个APK进程分配一个单独的用户空间,其manifest中的userid就是对应一个Linux用户(Android 系统是基于Linux)的.所以不同APK(用户)间互相访问数据默认是禁止的.但是它也提供了2种APK间共享数据的形式: 1. Share Preference. / Content Provider APK可以指定接口和数据给任何其他APK读取. 需要自己实现接口和Share的数据. 本文对于这个不做详细解释 2. Shared User id 通过Shared User id,拥有同一个User id的多个APK可以配置成运行在同一个进程中.所以默认就是可以互相访问任意数据. 也可以配置成运行成不同的进程, 同时可以访问其他APK的数据目录下的数据库和文件.就像访问本程序的数据一样.比如某个公司开发了多个Android 程序, 那么可以把数据,图片等资源集中放到APK A中去. 然后这个公司的所有APK都使用同一个User ID, 那么所有的资源都可以从APK A中读取. 举个例子: APK A 和APK B 都是C公司的产品,那么如果用户从APK A中登陆成功.那么打开APK B的时候就不用 再次登陆. 具体实现就是 A和B设置成同一个User ID: 在2个APK的AndroidManifest.xml 配置User ID: <manifest xmlns:android="http://schemas.android.com/apk/res/android" package="com.android.demo.a1" android:sharedUserId="com.c"> 这个”com.c” 就是user id, 然后packagename APK A就是上面的内容, APK B可能 是”com.android.demo.b1” 这个没有限制 这个设定好之后, APK B就可以像打开本地数据库那样 打开APK A中的数据库了. APK A把登陆信息存放在A的数据目录下面. APK B每次启动的时候读取APK A下面的数据库 判断是否已经登陆: APK B中的代码: friendContext = this.createPackageContext( "com.android.demo.a1", Context.CONTEXT_IGNORE_SECURITY); 通过A的package name 就可以得到A的 packagecontext 通过这个context就可以直接打开数据库 D、sharedUserLabel 一个共享的用户名,它只有在设置了sharedUserId属性的前提下才会有意义 E、versionCode 是给设备程序识别版本(升级)用的必须是一个interger值代表app更新过多少次,比如第一版一般为1,之后若要更新版本就设置为2,3等等。。。 F、versionName 这个名称是给用户看的,你可以将你的APP版本号设置为1.1版,后续更新版本设置为1.2、2.0版本等等。。。 G、installLocation 安装参数,是Android2.2中的一个新特性,installLocation有三个值可以选择:internalOnly、auto、preferExternal 选择preferExternal,系统会优先考虑将APK安装到SD卡上(当然最终用户可以选择为内部ROM存储上,如果SD存储已满,也会安装到内部存储上) 选择auto,系统将会根据存储空间自己去适应 选择internalOnly是指必须安装到内部才能运行 (注:需要进行后台类监控的APP最好安装在内部,而一些较大的游戏APP最好安装在SD卡上。现默认为安装在内部,如果把APP安装在SD卡上,首先得设置你的level为8,并且要配置android:installLocation这个参数的属性为preferExternal) H、tools [链接](http://www.jcodecraeer.com/a/anzhuokaifa/androidkaifa/2015/0309/2567.html)

优秀的个人博客,低调大师

Spark的这些事&amp;lt;三&amp;gt;——spark常用的Transformations 和Actions

Transformations map,filter spark最长用的两个Transformations:map,filter,下面就来介绍一下这两个。 先看下面这张图: 从上图中可以清洗的看到 map和filter都是做的什么工作,那我们就代码演示一下。 val input = sc.parallelize(List(1,2,3,4)) val result1 = input.map(x=>x*x) val result2 = input.filter(x=>x!=1) print(result1.collect().mkString(",")) print("\n") print(result2.collect().mkString(",")) print("\n") 执行结果如下: 16/08/17 18:48:31 INFO DAGScheduler: ResultStage 0 (collect at Map.scala:17) finished in 0.093 s 16/08/17 18:48:31 INFO DAGScheduler: Job 0 finished: collect at Map.scala:17, took 0.268871 s 1,4,9,16 ........ 16/08/17 18:48:31 INFO DAGScheduler: ResultStage 1 (collect at Map.scala:19) finished in 0.000 s 16/08/17 18:48:31 INFO DAGScheduler: Job 1 finished: collect at Map.scala:19, took 0.018291 s 2,3,4 再回头看下上面那张图,是不是明白什么意思了! flatMap 另外一个常用的就是flatMap,输入一串字符,分割出每个字符 来用代码实践一下: val lines = sc.parallelize(List("hello world","hi")) val words = lines.flatMap (lines=>lines.split(" ")) print(words.first()) print("\n") 执行结果: 16/08/17 19:23:24 INFO DAGScheduler: Job 2 finished: first at Map.scala:24, took 0.016987 s hello 16/08/17 19:23:24 INFO SparkContext: Invoking stop() from shutdown hook 分隔符如果改一下的话: val words = lines.flatMap (lines=>lines.split(",")) 结果会怎样呢? 16/08/17 19:33:14 INFO TaskSchedulerImpl: Removed TaskSet 2.0, whose tasks have all completed, from pool hello world 16/08/17 19:33:14 INFO SparkContext: Invoking stop() from shutdown hook 和想象的一样吧~ distinct,distinct,intersection,subtract 还有几个比较常用的:distinct,distinct,intersection,subtract 来看看代码实践: val rdd1 = sc.parallelize(List("coffee","coffee","panda","monkey","tea")) val rdd2 = sc.parallelize(List("coffee","monkey","kitty")) rdd1.distinct().take(100).foreach(println) 结果: 16/08/17 19:52:29 INFO DAGScheduler: ResultStage 4 (take at Map.scala:30) finished in 0.047 s 16/08/17 19:52:29 INFO TaskSchedulerImpl: Removed TaskSet 4.0, whose tasks have all completed, from pool 16/08/17 19:52:29 INFO DAGScheduler: Job 3 finished: take at Map.scala:30, took 0.152405 s monkey coffee panda tea 16/08/17 19:52:29 INFO SparkContext: Starting job: take at Map.scala:32 代码: rdd1.union(rdd2).take(100).foreach(println) 结果: 6/08/17 19:52:29 INFO DAGScheduler: Job 5 finished: take at Map.scala:32, took 0.011825 s coffee coffee panda monkey tea coffee monkey kitty 16/08/17 19:52:30 INFO SparkContext: Starting job: take at Map.scala:34 16/08/17 19:52:30 INFO DAGScheduler: Registering RDD 11 (intersection at Map.scala:34) 16/08/17 19:52:30 INFO DAGScheduler: Registering RDD 12 (intersection at Map.scala:34) 代码: rdd1.intersection(rdd2).take(100).foreach(println) 结果: 16/08/17 19:52:30 INFO TaskSetManager: Finished task 0.0 in stage 9.0 (TID 9) in 31 ms on localhost (1/1) 16/08/17 19:52:30 INFO TaskSchedulerImpl: Removed TaskSet 9.0, whose tasks have all completed, from pool 16/08/17 19:52:30 INFO DAGScheduler: ResultStage 9 (take at Map.scala:34) finished in 0.031 s 16/08/17 19:52:30 INFO DAGScheduler: Job 6 finished: take at Map.scala:34, took 0.060785 s monkey coffee 16/08/17 19:52:30 INFO SparkContext: Starting job: take at Map.scala:36 代码: rdd1.subtract(rdd2).take(100).foreach(println) 结果: 16/08/17 19:52:30 INFO DAGScheduler: Job 6 finished: take at Map.scala:34, took 0.060785 s monkey coffee 16/08/17 19:52:30 INFO SparkContext: Starting job: take at Map.scala:36 再看看上面的图,很容易理解吧 Actions 常用的Transformations就介绍到这里,下面介绍下常用的Action: reduce,countByValue,takeOrdered,takeSample,aggregate 首先看一下:reduce val rdd5 = sc.parallelize(List(1,2,3,4)) print("reduce action:"+rdd5.reduce((x,y)=>x+y)+"\n") 16/08/18 11:51:16 INFO DAGScheduler: Job 15 finished: reduce at Function.scala:55, took 0.012698 s reduce action:10 16/08/18 11:51:16 INFO SparkContext: Starting job: aggregate at Function.scala:57 countByValue print(rdd1.countByValue() + "\n") 16/08/18 11:51:16 INFO DAGScheduler: Job 11 finished: countByValue at Function.scala:48, took 0.031726 s Map(monkey -> 1, coffee -> 2, panda -> 1, tea -> 1) 16/08/18 11:51:16 INFO SparkContext: Starting job: takeOrdered at Function.scala:50 takeOrdered rdd1.takeOrdered(10).take(100).foreach(println) 16/08/18 11:51:16 INFO DAGScheduler: Job 12 finished: takeOrdered at Function.scala:50, took 0.026160 s coffee coffee monkey panda tea 16/08/18 11:51:16 INFO SparkContext: Starting job: takeSample at Function.scala:52 aggregate 这个要重点介绍一下: Spark文档中aggregate函数定义如下 def aggregate[U](zeroValue: U)(seqOp: (U, T) ⇒ U, combOp: (U, U) ⇒ U)(implicit arg0: ClassTag[U]): U Aggregate the elements of each partition, and then the results for all the partitions, using given combine functions and a neutral “zero value”. This function can return a different result type, U, than the type of this RDD, T. Thus, we need one operation for merging a T into an U and one operation for merging two U’s, as in scala.TraversableOnce. Both of these functions are allowed to modify and return their first argument instead of creating a new U to avoid memory allocation. seqOp操作会聚合各分区中的元素,然后combOp操作把所有分区的聚合结果再次聚合,两个操作的初始值都是zeroValue. seqOp的操作是遍历分区中的所有元素(T),第一个T跟zeroValue做操作,结果再作为与第二个T做操作的zeroValue,直到遍历完整个分区。combOp操作是把各分区聚合的结果,再聚合。aggregate函数返回一个跟RDD不同类型的值。因此,需要一个操作seqOp来把分区中的元素T合并成一个U,另外一个操作combOp把所有U聚合。 val rdd5 = sc.parallelize(List(1,2,3,4)) val rdd6 = rdd5.aggregate((0, 0)) ((x, y) =>(x._1 + y, x._2+1), (x, y) =>(x._1 + y._1, x._2 + y._2)) print ("aggregate action : " + rdd6 + "\n" ) 我们看一下结果: 16/08/18 11:51:16 INFO DAGScheduler: Job 16 finished: aggregate at Function.scala:57, took 0.011686 s aggregate action : (10,4) 16/08/18 11:51:16 INFO SparkContext: Invoking stop() from shutdown hook 我们可以根据以上执行的例子来理解aggregate 用法: 第一步:将rdd5中的元素与初始值遍历进行聚合操作 第二步:将初始值加1进行遍历聚合 第三步:将结果进行聚合 根据本次的RDD 背部实现如下: 第一步:其实是0+1 1+2 3+3 6+4 然后执行:0+1 1+1 2+1 3+1 此时返回(10,4) 本次执行是一个节点,如果在集群中的话,多个节点,会先把数据打到不同的分区上,比如(1,2) (3,4) 得到的结果就会是(3,2) (7,2) 然后进行第二步combine就得到 (10,4) 这样你应该能理解aggregate这个函数了吧 以上就是对常用的Transformations 和Actions介绍,对于初学者来说,动手代码实践各个函数,才是明白其功能最好的方法。 PS :源码 Spark的这些事系列文章: Spark的这些事<一>——Windows下spark开发环境搭建 Spark的这些事<二>——几个概念 Spark的这些事<三>——spark常用的Transformations 和Actions

优秀的个人博客,低调大师

Spark的这些事&amp;lt;一&amp;gt;——Windows下spark开发环境搭建

一、首先准备需要安装的软件 scala-2.10.4 下载地址:http://www.scala-lang.org/download/2.10.4.html scala-SDK-4.4.1-vfinal-2.11-win32.win32.x86_64 下载地址:http://scala-ide.org/ spark-1.6.2-bin-hadoop2.6 下载地址:http://spark.apache.org/ 当然还有jdk这里就不说了 scala-2.10.4下载后直接安装~ scala-SDK-4.4.1-vfinal-2.11-win32.win32.x86_64和spark-1.6.2-bin-hadoop2.6下载后直接解压 scalaIDE解压后就是一个eclipse,这个大家都比较熟悉了。打开IDE,在解压后的spark包中的lib文件夹下找到spark-assembly-1.6.2-hadoop2.6.0,添加到IDE中。 然后环境就搭建完成了~ 下面就来开发一个测试程序试一下: package com.day1.spark import org.apache.spark.SparkConf import org.apache.spark.SparkContext object WordCount { def main(args: Array[String]): Unit = { val conf = new SparkConf() conf.setAppName("MY frist Spark App") conf.setMaster("local") var sc = new SparkContext(conf) val lines = sc.textFile("D:\\test.txt", 1) val words = lines.flatMap { line => line.split(" ") } val pairs = words.map { word => (word,1) } val WordCount = pairs.reduceByKey(_+_) WordCount.foreach(wordNumberPair=>println(wordNumberPair._1 + ":" + wordNumberPair._2)) sc.stop() } } 右键运行: Using Spark's default log4j profile: org/apache/spark/log4j-defaults.properties 16/07/18 19:07:04 INFO SparkContext: Running Spark version 1.6.2 16/07/18 19:07:13 INFO SecurityManager: Changing view acls to: qinchaofeng 16/07/18 19:07:13 INFO SecurityManager: Changing modify acls to: qinchaofeng 16/07/18 19:07:13 INFO SecurityManager: SecurityManager: authentication disabled; ui acls disabled; users with view permissions: Set(qinchaofeng); users with modify permissions: Set(qinchaofeng) 16/07/18 19:07:14 INFO Utils: Successfully started service 'sparkDriver' on port 50513. 16/07/18 19:07:14 INFO Slf4jLogger: Slf4jLogger started 16/07/18 19:07:14 INFO Remoting: Starting remoting 16/07/18 19:07:14 INFO Remoting: Remoting started; listening on addresses :[akka.tcp://sparkDriverActorSystem@192.168.108.207:50526] 16/07/18 19:07:14 INFO Utils: Successfully started service 'sparkDriverActorSystem' on port 50526. 16/07/18 19:07:14 INFO SparkEnv: Registering MapOutputTracker 16/07/18 19:07:14 INFO SparkEnv: Registering BlockManagerMaster 16/07/18 19:07:14 INFO DiskBlockManager: Created local directory at C:\Users\qinchaofeng\AppData\Local\Temp\blockmgr-25c047c4-505d-4cfb-addd-d777e5a430d7 16/07/18 19:07:14 INFO MemoryStore: MemoryStore started with capacity 797.6 MB 16/07/18 19:07:14 INFO SparkEnv: Registering OutputCommitCoordinator 16/07/18 19:07:15 INFO Utils: Successfully started service 'SparkUI' on port 4040. 16/07/18 19:07:15 INFO SparkUI: Started SparkUI at http://192.168.108.207:4040 16/07/18 19:07:15 INFO Executor: Starting executor ID driver on host localhost 16/07/18 19:07:15 INFO Utils: Successfully started service 'org.apache.spark.network.netty.NettyBlockTransferService' on port 50533. 16/07/18 19:07:15 INFO NettyBlockTransferService: Server created on 50533 16/07/18 19:07:15 INFO BlockManagerMaster: Trying to register BlockManager 16/07/18 19:07:15 INFO BlockManagerMasterEndpoint: Registering block manager localhost:50533 with 797.6 MB RAM, BlockManagerId(driver, localhost, 50533) 16/07/18 19:07:15 INFO BlockManagerMaster: Registered BlockManager 16/07/18 19:07:15 INFO MemoryStore: Block broadcast_0 stored as values in memory (estimated size 153.6 KB, free 153.6 KB) 16/07/18 19:07:15 INFO MemoryStore: Block broadcast_0_piece0 stored as bytes in memory (estimated size 13.9 KB, free 167.5 KB) 16/07/18 19:07:15 INFO BlockManagerInfo: Added broadcast_0_piece0 in memory on localhost:50533 (size: 13.9 KB, free: 797.6 MB) 16/07/18 19:07:15 INFO SparkContext: Created broadcast 0 from textFile at WordCount.scala:15 16/07/18 19:07:16 WARN : Your hostname, qinchaofeng1 resolves to a loopback/non-reachable address: fe80:0:0:0:0:5efe:c0a8:6ccf%12, but we couldn't find any external IP address! 16/07/18 19:07:24 INFO FileInputFormat: Total input paths to process : 1 16/07/18 19:07:24 INFO SparkContext: Starting job: foreach at WordCount.scala:23 16/07/18 19:07:24 INFO DAGScheduler: Registering RDD 3 (map at WordCount.scala:19) 16/07/18 19:07:24 INFO DAGScheduler: Got job 0 (foreach at WordCount.scala:23) with 1 output partitions 16/07/18 19:07:24 INFO DAGScheduler: Final stage: ResultStage 1 (foreach at WordCount.scala:23) 16/07/18 19:07:24 INFO DAGScheduler: Parents of final stage: List(ShuffleMapStage 0) 16/07/18 19:07:24 INFO DAGScheduler: Missing parents: List(ShuffleMapStage 0) 16/07/18 19:07:24 INFO DAGScheduler: Submitting ShuffleMapStage 0 (MapPartitionsRDD[3] at map at WordCount.scala:19), which has no missing parents 16/07/18 19:07:24 INFO MemoryStore: Block broadcast_1 stored as values in memory (estimated size 4.1 KB, free 171.6 KB) 16/07/18 19:07:25 INFO MemoryStore: Block broadcast_1_piece0 stored as bytes in memory (estimated size 2.3 KB, free 173.8 KB) 16/07/18 19:07:25 INFO BlockManagerInfo: Added broadcast_1_piece0 in memory on localhost:50533 (size: 2.3 KB, free: 797.6 MB) 16/07/18 19:07:25 INFO SparkContext: Created broadcast 1 from broadcast at DAGScheduler.scala:1006 16/07/18 19:07:25 INFO DAGScheduler: Submitting 1 missing tasks from ShuffleMapStage 0 (MapPartitionsRDD[3] at map at WordCount.scala:19) 16/07/18 19:07:25 INFO TaskSchedulerImpl: Adding task set 0.0 with 1 tasks 16/07/18 19:07:25 INFO TaskSetManager: Starting task 0.0 in stage 0.0 (TID 0, localhost, partition 0,PROCESS_LOCAL, 2108 bytes) 16/07/18 19:07:25 INFO Executor: Running task 0.0 in stage 0.0 (TID 0) 16/07/18 19:07:25 INFO HadoopRDD: Input split: file:/D:/test.txt:0+214 16/07/18 19:07:25 INFO deprecation: mapred.tip.id is deprecated. Instead, use mapreduce.task.id 16/07/18 19:07:25 INFO deprecation: mapred.task.id is deprecated. Instead, use mapreduce.task.attempt.id 16/07/18 19:07:25 INFO deprecation: mapred.task.is.map is deprecated. Instead, use mapreduce.task.ismap 16/07/18 19:07:25 INFO deprecation: mapred.task.partition is deprecated. Instead, use mapreduce.task.partition 16/07/18 19:07:25 INFO deprecation: mapred.job.id is deprecated. Instead, use mapreduce.job.id 16/07/18 19:07:25 INFO Executor: Finished task 0.0 in stage 0.0 (TID 0). 2253 bytes result sent to driver 16/07/18 19:07:25 INFO TaskSetManager: Finished task 0.0 in stage 0.0 (TID 0) in 156 ms on localhost (1/1) 16/07/18 19:07:25 INFO TaskSchedulerImpl: Removed TaskSet 0.0, whose tasks have all completed, from pool 16/07/18 19:07:25 INFO DAGScheduler: ShuffleMapStage 0 (map at WordCount.scala:19) finished in 0.156 s 16/07/18 19:07:25 INFO DAGScheduler: looking for newly runnable stages 16/07/18 19:07:25 INFO DAGScheduler: running: Set() 16/07/18 19:07:25 INFO DAGScheduler: waiting: Set(ResultStage 1) 16/07/18 19:07:25 INFO DAGScheduler: failed: Set() 16/07/18 19:07:25 INFO DAGScheduler: Submitting ResultStage 1 (ShuffledRDD[4] at reduceByKey at WordCount.scala:21), which has no missing parents 16/07/18 19:07:25 INFO MemoryStore: Block broadcast_2 stored as values in memory (estimated size 2.5 KB, free 176.3 KB) 16/07/18 19:07:25 INFO MemoryStore: Block broadcast_2_piece0 stored as bytes in memory (estimated size 1583.0 B, free 177.9 KB) 16/07/18 19:07:25 INFO BlockManagerInfo: Added broadcast_2_piece0 in memory on localhost:50533 (size: 1583.0 B, free: 797.6 MB) 16/07/18 19:07:25 INFO SparkContext: Created broadcast 2 from broadcast at DAGScheduler.scala:1006 16/07/18 19:07:25 INFO DAGScheduler: Submitting 1 missing tasks from ResultStage 1 (ShuffledRDD[4] at reduceByKey at WordCount.scala:21) 16/07/18 19:07:25 INFO TaskSchedulerImpl: Adding task set 1.0 with 1 tasks 16/07/18 19:07:25 INFO TaskSetManager: Starting task 0.0 in stage 1.0 (TID 1, localhost, partition 0,NODE_LOCAL, 1894 bytes) 16/07/18 19:07:25 INFO Executor: Running task 0.0 in stage 1.0 (TID 1) 16/07/18 19:07:25 INFO ShuffleBlockFetcherIterator: Getting 1 non-empty blocks out of 1 blocks 16/07/18 19:07:25 INFO ShuffleBlockFetcherIterator: Started 0 remote fetches in 16 ms avg_flow:1 avg_flow_fee:1 local_city_nm:1 cust_num:1 birthday:1 Gender:1 cust_nm:1 join_net_time:1 avg_call_fee:1 net_age:1 prov_code:1 cmpgn:1 buy_time:1 using_meal:1 chnl:1 arpu:1 term_brand:1 term_model:1 avg_call_times:1 flow_pkg:1 16/07/18 19:07:25 INFO Executor: Finished task 0.0 in stage 1.0 (TID 1). 1165 bytes result sent to driver 16/07/18 19:07:25 INFO DAGScheduler: ResultStage 1 (foreach at WordCount.scala:23) finished in 0.062 s 16/07/18 19:07:25 INFO TaskSetManager: Finished task 0.0 in stage 1.0 (TID 1) in 62 ms on localhost (1/1) 16/07/18 19:07:25 INFO TaskSchedulerImpl: Removed TaskSet 1.0, whose tasks have all completed, from pool 16/07/18 19:07:25 INFO DAGScheduler: Job 0 finished: foreach at WordCount.scala:23, took 0.356812 s 16/07/18 19:07:25 INFO SparkUI: Stopped Spark web UI at http://192.168.108.207:4040 16/07/18 19:07:25 INFO MapOutputTrackerMasterEndpoint: MapOutputTrackerMasterEndpoint stopped! 16/07/18 19:07:25 INFO MemoryStore: MemoryStore cleared 16/07/18 19:07:25 INFO BlockManager: BlockManager stopped 16/07/18 19:07:25 INFO BlockManagerMaster: BlockManagerMaster stopped 16/07/18 19:07:25 INFO OutputCommitCoordinator$OutputCommitCoordinatorEndpoint: OutputCommitCoordinator stopped! 16/07/18 19:07:25 INFO SparkContext: Successfully stopped SparkContext 16/07/18 19:07:25 INFO ShutdownHookManager: Shutdown hook called 16/07/18 19:07:25 INFO RemoteActorRefProvider$RemotingTerminator: Shutting down remote daemon. 16/07/18 19:07:25 INFO ShutdownHookManager: Deleting directory C:\Users\qinchaofeng\AppData\Local\Temp\spark-c54f4cb1-7351-47d1-9fd4-fbdac0fae228 可以看到已经执行成功了! 源码 Spark的这些事系列文章: Spark的这些事<一>——Windows下spark开发环境搭建 Spark的这些事<二>——几个概念 Spark的这些事<三>——spark常用的Transformations 和Actions

优秀的个人博客,低调大师

K8S的名称空间创建&amp;&amp;版本的升级、回滚操作

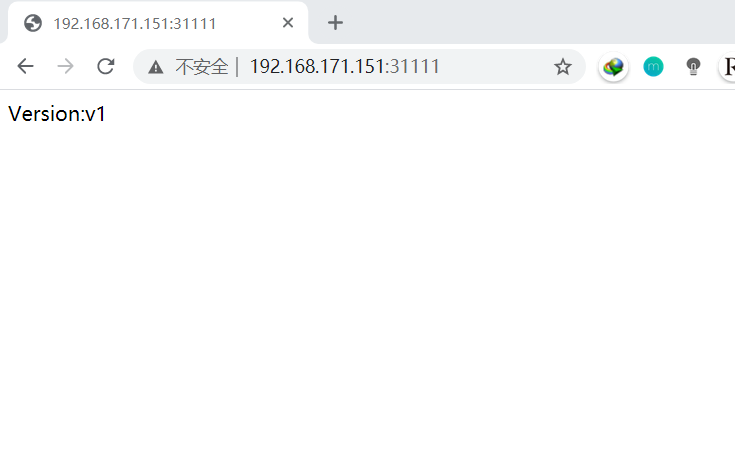
1、创建私有仓库 [root@docker-k8s01 ~]# docker run -itd --name registry -p 5000:5000 --restart always registry:latest #在所有需要使用私有仓库的docker主机上添加如下配置 [root@docker-k8s01 ~]# vim /usr/lib/systemd/system/docker.service ExecStart=/usr/bin/dockerd -H unix:// --insecure-registry 192.168.171.151:5000 #修改完文件后重启使之生效 [root@docker-k8s01 ~]# systemctl daemon-reload [root@docker-k8s01 ~]# systemctl restart docker 2、在master节点,自定义一个镜像,基于nginx镜像,默认界面内容改为:Version:v1,版本2内容为:Version:v2.版本3内容为:Version:v3 #编写dockerfile文件 [root@docker-k8s01 ~]# vim Dockerfile FROM nginx ADD index.html /usr/share/nginx/html #编辑v1版本的首页内容 [root@docker-k8s01 ~]# echo "Version:v1" > index.html #制作v1版本的镜像 [root@docker-k8s01 ~]# docker build -t 192.168.171.151:5000/zyz:v1 . #制作v2版本的镜像 [root@docker-k8s01 ~]# echo "Version:v2" > index.html [root@docker-k8s01 ~]# docker build -t 192.168.171.151:5000/zyz:v2 . #制作v3版本的镜像 [root@docker-k8s01 ~]# echo "Version:v3" > index.html [root@docker-k8s01 ~]# docker build -t 192.168.171.151:5000/zyz:v3 . #将制作好的三个版本的镜像上传至私有仓库 [root@docker-k8s01 ~]# docker push 192.168.171.151:5000/zyz:v1 [root@docker-k8s01 ~]# docker push 192.168.171.151:5000/zyz:v2 [root@docker-k8s01 ~]# docker push 192.168.171.151:5000/zyz:v3 创建一个Namespace.接下来的所有操作都在此名称空间之下 [root@docker-k8s01 ~]# mkdir test [root@docker-k8s01 ~]# cd test/ [root@docker-k8s01 test]# vim ns.yaml apiVersion: v1 kind: Namespace metadata: name: zyz [root@docker-k8s01 test]# kubectl apply -f ns.yaml # 运行yaml文件 namespace/zyz created [root@docker-k8s01 test]# kubectl get ns zyz # 查看创建的namespace NAME STATUS AGE zyz Active 30s 创建一个Deployment资源对象,镜像版本为v1 [root@docker-k8s01 test]# vim zyz.yaml apiVersion: extensions/v1beta1 kind: Deployment metadata: name: zyz namespace: zyz spec: revisionHistoryLimit: 5 # 规定记录多少个版本,这个字段通过 kubectl explain deploy.spec 命令找到revisionHistoryLimit <integer>行获得 replicas: 2 template: metadata: labels: name: zyz spec: containers: - name: zyz image: 192.168.171.151:5000/zyz:v1 # 镜像版本为1 ports: - containerPort: 80 #执行该yaml文件, --record表示记录版本历史 [root@docker-k8s01 test]# kubectl apply -f zyz.yaml --record [root@docker-k8s01 test]# kubectl get pod # 查看上面yaml文件运行的pod No resources found. #可以得出结论,如果在编写yaml文件时,指定了归属于哪个namespace, #那么执行上面的命令是查看不到运行的pod的,而不是没有运行的pod [root@docker-k8s01 test]# kubectl get pod -n zyz # 增加“-n”选项,指定名称空间,即可看对应的pod NAME READY STATUS RESTARTS AGE zyz-5d7cb64655-9pdcj 1/1 Running 0 98s zyz-5d7cb64655-zzqcv 1/1 Running 0 98s #查看zyz的namespace名称空间的名为zyz的deployment资源对象 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz deployment.extensions/zyz REVISION CHANGE-CAUSE 1 kubectl apply --filename=zyz.yaml --record=true #可以看到当前只有一个版本,也可以看到filename(文件名称) 创建一个Service资源对象,关联到上面的Deployment资源对象 [root@docker-k8s01 test]# vim zyz-svc.yaml apiVersion: v1 kind: Service metadata: name: zyz-service namespace: zyz spec: type: NodePort selector: name: zyz ports: - name: zyz-port port: 8080 # service的IP接口 targetPort: 80 # pod的端口 nodePort: 31111 # 映射到宿主机的端口 [root@docker-k8s01 test]# kubectl apply -f zyz-svc.yaml [root@docker-k8s01 test]# kubectl get svc # 若不指定名称空间,是查不到对应的service的 NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 9d [root@docker-k8s01 test]# kubectl get svc -n zyz # 使用“-n”选项查看指定的名称空间中的service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE zyz-service NodePort 10.100.89.145 <none> 8080:31111/TCP 55s 注意:创建的service资源对象必须和创建的deployment资源对象在同一个namespace中,否则无法进行关联!!! 客户端访问k8s群集中的任意一个节点的31111端口访问其pod提供的服务如果需要在线修改pod提供的网页文件,可以先查看到pod的name,然后直接在主节点上登录到此pod即可,命令如下 [root@docker-k8s01 httpd-web]# kubectl get pod -o wide #查看pod的name NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES httpd-devploy1-6f987c9764-5g92w 1/1 Running 0 8m35s 10.244.1.5 node01 <none> <none> httpd-devploy1-6f987c9764-wvgft 1/1 Running 0 [root@docker-k8s01 httpd-web]# kubectl exec -it httpd-devploy1-6f987c9764-5g92w /bin/bash #通过指定pod的name,进入pod 现在由1版本,滚动更新至2版本、再到3版本,最后回滚到指定1版本内容 [root@docker-k8s01 test]# sed -i 's/zyz:v1/zyz:v2/' zyz.yaml # 更新为版本2 [root@docker-k8s01 test]# kubectl apply -f zyz.yaml # 执行 deployment.extensions/zyz configured # 配置成功 #访问验证 [root@docker-k8s01 test]# curl 192.168.171.151:31111 Version:v2 #查看历史版本 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz deployment.extensions/zyz REVISION CHANGE-CAUSE 1 kubectl apply --filename=zyz.yaml --record=true 2 <none> #现在是有两个历史版本了 #接下来再次升级并验证 [root@docker-k8s01 test]# sed -i 's/zyz:v2/zyz:v3/' zyz.yaml [root@docker-k8s01 test]# kubectl apply -f zyz.yaml deployment.extensions/zyz configured #再次访问可以看到现在是版本3了 [root@docker-k8s01 test]# curl 192.168.171.151:31111 Version:v3 #查看历史版本信息 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz deployment.extensions/zyz REVISION CHANGE-CAUSE 1 kubectl apply --filename=zyz.yaml --record=true 2 <none> 3 <none> #接下来执行回滚操作 #回滚到版本1,需要指定namespace,“--to-revision”是指定回滚到哪个版本 [root@docker-k8s01 test]# kubectl rollout undo deployment -n zyz zyz --to-revision=1 deployment.extensions/zyz rolled back [root@docker-k8s01 test]# curl 192.168.171.151:31111 Version:v1 [root@docker-k8s01 test]# kubectl rollout history deployment -n zyz zyz #再次查看历史记录,发现版本1变成了版本4,之前的1已经没有了 deployment.extensions/zyz REVISION CHANGE-CAUSE 2 <none> 3 <none> 4 kubectl apply --filename=zyz.yaml --record=true

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册