首页 文章 精选 留言 我的

精选列表

搜索[龙虾管家],共886篇文章
优秀的个人博客,低调大师

三分钟带你了解一站式大数据平台运维管家ChengYing产品包制作

课件获取:关注公众号 “数栈研习社”,后台私信 “ChengYing” 获得直播课件 视频回放:点击这里 ChengYing 开源项目地址:github 丨 gitee 喜欢我们的项目给我们点个__ STAR!STAR!!STAR!!!(重要的事情说三遍)__ 技术交流钉钉 qun:30537511 产品包的构成 01 产品包制作前置条件 在制作产品包之前,我们首先要完成以下3个步骤: ChengYing已部署完成,ChengYing的部署内容可以参考【ChengYing安装原理】。 组件原料准备完成(组件原料主要是指已经编译完成的二进制包)。 当以上两个步骤完成之后,我们就可以开始产品包的制作。 02 产品包构成 产品包主要由schema.yml及各服务目录组成。Schema主要主要描述产品的组成,是一个编排文件,服务目录类似于工作目录,也有可能是静态组件,我们以下面两个产品包介绍为例: ● 基础服务包 上层应用所依赖的服务、例如mysql、zookeeper等服务,其目录结构如下: ● Java应用包 Java应用层产品包、包含的组件,前端,后端,sql组件、其目录结构如下: Schema解析&产品包制作 接下来我们来重点了解下Schema相关的内容。 01 Schema解析 Schema.yml是整个产品包的核心文件,其内容主要描述了产品包里所有组件信息以及配置变量。 产品所属父级名称(parent_product_name) 产品名称(product_name) 产品版本(product_version) 服务名(service) 配置文件(application.properties) schem语法参考: https://dtstack.github.io/chengying-web/docs/chengyingDocs/introduction/schema 02 部署流程 部署流程在上述的Schema解析中都有体现,主要是以下流程: ● 安装(install) 从ChengYing服务端下载组件,并执行post_deploy.sh脚本,成功则进行下一步。 ● 启动(running) 执行Schema文件中所定义的启动脚本,执行失败,脚本返回“1”则表示run failed ,反之则表示启动成功。 ● 健康检查(healthy-check) 定时执行健康检查脚本(health.sh)。 案例分享 接下来为大家分享两个ChengYing产品包制作的案例 01 Base包制作 以Base产品包为例,其中主要包含zookeeper,mysql,mysql_slaves等组件。 1.官网下载二进制安装包 2.脚本编写(启动脚本,监控脚本,部署脚本) 3.提取参数,编写Schema 4.使用Mero工具制作产品包 产品包地址: curl http://172.0.0.1:8864/api/v2/product/upload -F 'package=@DTBase_2.1.19.tar' 注意:IP为ChengYying所在服务的节点ip,产品包则是执行mero命令后所生成的文件 02 Taier产品包制作 Taier属于Java应用,前后端分离部署的架构模式。 1.下载前端代码,进行编译获取编译后的js文件 2.下载后端代码,进行编译后获取编译后jar包 3.按模块划分目录 4.提取参数,编写schema 5.使用mero工具制作产品包 产品包地址: curl http://172.0.0.1:8864/api/v2/product/upload -F 'package=@Taier_4.2.1_rel.tar' 注意:IP为ChengYying所在服务的节点ip,产品包则是执行mero命令后所生成的文件 03 附录 ● 关于Base产品包 Mysql二进制包: https://downloads.mysql.com/archives/community/ Zookeeper二进制包下载: https://dlcdn.apache.org/zookeeper/zookeeper-3.8.0/ ● 关于Taier产品包 Taier源码下载:https://github.com/DTStack/Taier 前端编译命令:npm run build 后端编译命令:mvn clean package -DskipTests -T 1C -pl taier-data-develop,taier-common,taier-worker/taier plugins -am –amd ● Mero下载地址 https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/mero 袋鼠云开源框架钉钉技术交流群(30537511),欢迎对大数据开源项目有兴趣的同学加入交流最新技术信息,开源项目库地址:https://github.com/DTStack/Taier

优秀的个人博客,低调大师

开源项目丨一文详解一站式大数据平台运维管家ChengYing如何部署Hadoop集群

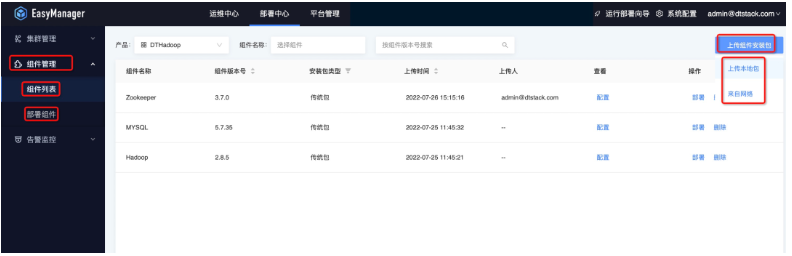
课件获取:关注公众号“数栈研习社”,后台私信 “ChengYing” 获得直播课件 视频回放:点击这里 ChengYing开源项目地址:github 丨 gitee 喜欢我们的项目给我们点个__ STAR!STAR!!STAR!!!(重要的事情说三遍)__ 技术交流钉钉 qun:30537511 本期我们带大家回顾一下海洋同学的直播分享《ChengYing部署Hadoop集群实战》 一、Hadoop集群部署准备 在部署集群前,我们需要做一些部署准备,首先我们需要按照下载Hadoop产品包: ● Mysql https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/Mysql_5.7.38_centos7_x86_64.tar ● Zookeeper https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/Zookeeper_3.7.0_centos7_x86_64.tar ● Hadoop https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/Hadoop_2.8.5_centos7_x86_64.tar ● Hive https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/Hive_2.3.8_centos7_x86_64.tar ● Spark https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/Spark_2.1.3-6_centos7_x86_64.tar 接着我们可以将下载好的产品包直接通过ChengYing界面上传,具体路径是:部署中心—组件管理—组件列表—上传组件安装包: 可以通过两种模式上传产品包: 本地上传方式 产品包在先下载到本机电脑存储中,点击本地上传,选在产品包上传。 网络上传模式 直接填写产品包网络地址上传(ChengYing的网络需要和产品包网络互通)。 Hadoop集群部署流程 做完准备后,我们可以开始进入集群部署,Hadoop集群部署流程包括以下步骤: 集群部署顺序说明 首先需要部署Mysql和zookeeper,因为Hadoop需要依赖zookeeper,Hive元数据存储使用的是Mysql; 其次需要部署Hadoop,Hive 最后部署Spark,因Spark依赖hivemetastore PS:部署顺序是不可逆的 Hadoop集群部署角色分布 产品包标准部署流程 选择需要部署的产品包,点击部署按钮,然后选择对应需要部署的集群,默认集群为dtstack,集群名称可配置; 下一步选择需要部署的服务,默认产品包下的服务都会部署,可以根据实际需求部署,在此阶段可以对服务的配置文件进行修改,例如:修改Mysql连接超时时间等; 最后点击部署,等待部署完成。 Mysql服务部署流程演示 接下来我们以Mysql服务部署流程来为大家实际演示下整体流程: ● 第一步:选择集群 ● 第二步:选择产品包 ● 第三步:选择部署节点 ● 第四步:部署进度查看 ● 第五步:部署后状态查看 Hadoop集群使用与运维 集群部署完毕后,若有需求可以进行配置变更操作。 ● 配置修改 例如:如果需要操作修改yarn的配置文件,可以先选择yarn-site.xml文件,可以在搜索框搜索需要修改的配置文件key,如cpu_vcores。 ● 配置保存 ● 配置下发 Taier对接Hadoop操作流程 ChengYing除了可自动部署运维外,还可以对接Taier部署Hadoop集群,Taier 是一个大数据分布式可视化的DAG任务调度系统,旨在降低ETL开发成本、提高大数据平台稳定性,大数据开发人员可以在 Taier 直接进行业务逻辑的开发,而不用关心任务错综复杂的依赖关系与底层的大数据平台的架构实现,将工作的重心更多地聚焦在业务之中。 利用ChengYing部署管理Taier服务,可以做到实时监控Taier的服务状态,随时界面修改Taier配置等。Taier对接Hadoop集群的操作流程如下: 首先需要在Taier控制台选择多集群配置,新增一个集群; 然后配置sftp、资源调度组件、存储组件和计算组件; 配置完成后需要保存并且测试连通性。 注意事项: 在对接过程中,sftp主机需要和Taier网络相通,并且sftp配置主机的路径需要存在,如果不存在,需要手动创建。 Taier的部署网络需要与Hadoop网络相通,如果运行任务,需要在Taier所在节点加入Hadoop集群的Host配置;编译/etc/hosts文件,增加IP Hostname。 ● 第一步:配置公共组件 首先进入Taier登陆界面,点击控制台,新增集群,然后进入多集群管理界面,配置公共组件,选择SFTP,进入SFTP配置界面。 ● 第二步:配置SFTP 然后配置SFTP的host,认证方式,默认采用用户名密码方式,输入用户名和密码,并且输入path路径,此路径需要在主机上存在,如果不存在,需要手动创建一个SFTP路径. ● 第三步:资源调度组件配置 需要到部署Hadoop服务器到/opt/dtstack/Hive/hive_pkg/conf目录下获取hive-site.xml文件,下载到本地; 到/opt/dtstack/Hadoop/Hadoop_pkg/etc/Hadoop目录下获取hdfs-site.xml、core-site.xml、yarn-site.xml文件,下载到本地; 这四个文件压缩成一个zip包,上传这个压缩包。 ● 第四步:计算组件配置 选择计算组件模块,选择需要对接的计算引擎Hive和Spark,选择Hive和Spark的版本,填写对应的jdbc(jdbc:hive://ip:port/)连接串,然后点击保存,测试连通性。 注意:jdbcurl中ip分别为Hive组件的hiveserver2和Spark中的thrifterserver所在节点ip。 ● 第五步:配置Hive和Spark 以下是配置完成Hive和Spark组件后,测试连通性的状态。 注意:本地演示环境Hadoop未开启安全,Hive和Spark只需要配置jdbcurl即可。 Hadoop集群近期规划 最后和大家聊聊Hadoop集群近期规划,近期主要有三大规划: ● 产品包制作 制作ChengYing部署产品包的流程及实践。 ● ChunJun&Taier产品包 制作可以用ChengYing部署的Taier和chunjun的产品包 ● Hadoop运维 通过ChengYing运维大数据集群; 通过ChengYing一键开启Hadoop集群安全。 袋鼠云开源框架钉钉技术交流群(30537511),欢迎对大数据开源项目有兴趣的同学加入交流最新技术信息,开源项目库地址:https://github.com/DTStack

优秀的个人博客,低调大师

龙虾还没玩明白,CLI已经杀疯了,同一周,钉钉、飞书、企微集体开源CLI,这不是技术新闻,这是AI时代的基建信号。

两个中国最大的办公平台,这两天做了同一件事,把自己的全部能力,拆成一条条命令行,交给AI Agent去调用。紧接着企业微信跟上,腾讯公司公关总监张军宣布,企业微信CLI开源项目上架GitHub社区,开放消息、日程、文档、智能表、会议、待办、通讯录七大核心产品能力。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册