首页 文章 精选 留言 我的

精选列表

搜索[自然语言生成],共10009篇文章
优秀的个人博客,低调大师

Jcseg 2.6.3 发布 - Java 轻量级开源自然语言处理包

Jcseg 是基于 mmseg 算法的一个轻量级中文分词器,同时集成了关键字提取,关键短语提取,关键句子提取和文章自动摘要等功能,并且提供了一个基于 Jetty 的 web 服务器,方便各大语言直接 http 调用,同时提供了最新版本的 lucene,solr 和 elasticsearch 的分词接口! 2.6.3 版本主要更新如下: 1、优化 mmseg 的过滤实现,主要是运行效率上的。 2、修复一个因为 “单字词条覆盖” 导致的 bug,这是一个隐藏很久的老 bug了,触发的情况会导致 “最大语素自由度” 的过滤异常,例如: # 怀旧时,词条 “时” 本身比 “怀” 的语素自由度高,也就是这个且分结果应该如下: jcseg~tokenizer:complex>> 怀旧时 分词结果: 怀旧[0,2]/v 时[2,1]/nhf Done, total:3, tokens:2, in 0.00000sec # 这个 bug 出现的时候且分结果会是错误的,例如:怀/ 旧时/ 3、词库更新:增加了一些新词条,例如 https 等。 2.6.3版本下载地址: 1、Gitee:https://gitee.com/lionsoul/jcseg/tree/v2.6.3-release 2、Github:https://github.com/lionsoul2014/jcseg/releases/tag/v2.6.3-release

优秀的个人博客,低调大师

Jcseg 2.6.2 发布 - Java轻量级开源自然语言处理包

Jcseg是基于mmseg算法的一个轻量级中文分词器,同时集成了关键字提取,关键短语提取,关键句子提取和文章自动摘要等功能,并且提供了一个基于Jetty的web服务器,方便各大语言直接http调用,同时提供了最新版本的lucene,solr和elasticsearch的分词接口! Jcseg 2.6.2版本主要功能都是为Gitee的搜索设计的,体验可以搓:https://search.gitee.com/?skin=rec&type=repository&q=%E5%88%86%E8%AF%8D 2.6.2版本主要更新内容如下: 1,升级到对lucene 8.20,solr 8.2.0和Elasticsearch的7.4.2版本的支持,Gitee搜索目前用的Elasticseach 7.4.2版本。 2,增加solr和elasticsearch索引级别的分词配置,可以不同索引使用不同的分词配置,具体可以参考Gitee搜索资源分享中的mapping:https://gitee.com/oschina/gitee-search-share。 3,部分已有词库的优化,拼音,词性,同义词等。 4,二次切分优化,增加中英混合词的的二次切分支持。 5,增加n-gram切分模式,可以自定义n,实现n-gram的切分,例如:”中文分词“ 1-gram会被切分成”中 文 分 词“,此功能在Gitee的搜索提示中用到了。 6,增加英文词条的切分,大部分的分词器对于英文都只是通过空格或者标点来切分,这个版本jcseg增加了对英文的切分,同时也是通过mmseg算法来去除歧义,例如: 英文组合词条: jcseg~tokenizer:complex>> openarkcompiler 分词结果: open[0,4]/n ark[4,3]/n compiler[7,8]/n Done, total:15, tokens:3, in 0.00000sec 例如Gitee搜索”openark“:https://search.gitee.com/?q=openark&skin=rec&type=repository 拼音组合词条: jcseg~tokenizer:complex>> guanyuwomen 分词结果: guanyu[0,6]/p women[6,5]/n Done, total:11, tokens:2, in 0.00105sec 例如:Gitee搜索"中文huancunxitong":https://search.gitee.com/?q=huancunxitong&skin=rec&type=repository 7,增加英文词库和拼音词库,用于支撑上述的英文切分,这个英文也包括拼音的切分,例如:Gitee搜索的拼音和汉语相互搜索: 搜索”fenci“:https://search.gitee.com/?q=fenci&skin=rec&type=repository 搜索”分词“:https://search.gitee.com/?q=%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”中文分词“:https://search.gitee.com/?q=%E4%B8%AD%E6%96%87%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”中文fenci“:https://search.gitee.com/?q=%E4%B8%AD%E6%96%87fenci&skin=rec&type=repository 8,同义词优化,同义词词库和offset逻辑无缝对接lucene的increasement设计,便于实现同义词的检索和高亮,例如:Gitee搜索的同义词效果如下: 搜索”中文分词“:https://search.gitee.com/?q=%E4%B8%AD%E6%96%87%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”汉语分词“:https://search.gitee.com/?q=%E6%B1%89%E8%AF%AD%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”普通话分词“:https://search.gitee.com/?q=%E6%99%AE%E9%80%9A%E8%AF%9D%E5%88%86%E8%AF%8D&skin=rec&type=repository 9,更改了Jcseg的API设计,使用函数接口来代替部分的class查找,使用更方便,API变更为如下: //创建SegmenterConfig分词配置实例,自动查找加载jcseg.properties配置项来初始化 SegmenterConfig config = new SegmenterConfig(true); //创建默认单例词库实现,并且按照config配置加载词库 ADictionary dic = DictionaryFactory.createSingletonDictionary(config); //依据给定的ADictionary和SegmenterConfig来创建ISegment //为了Api往后兼容,建议使用SegmentFactory来创建ISegment对象 ISegment seg = ISegment.COMPLEX.factory.create(config, dic); //备注:以下代码可以反复调用,seg为非线程安全 //设置要被分词的文本 String str = "研究生命起源。"; seg.reset(new StringReader(str)); //获取分词结果 IWord word = null; while ( (word = seg.next()) != null ) { System.out.println(word.getValue()); } 10,BUG修复: 英文切分的offset问题:https://gitee.com/lionsoul/jcseg/issues/I19IQ4 NLP日期实体识别问题:https://gitee.com/lionsoul/jcseg/issues/I17DMS maven仓库(中央仓库同步中...): <dependency> <groupId>org.lionsoul</groupId> <artifactId>jcseg-core</artifactId> <version>2.6.2</version> </dependency> 下载地址: Gitee:https://gitee.com/lionsoul/jcseg/tree/v2.6.2-release Github:https://github.com/lionsoul2014/jcseg/releases/tag/v2.6.2-release

优秀的个人博客,低调大师

Jcseg 2.5.0 发布,Java 轻量级开源自然语言处理包

Jcseg是基于mmseg算法的一个轻量级中文分词器,同时集成了关键字提取,关键短语提取,关键句子提取和文章自动摘要等功能,并且提供了一个基于Jetty的web服务器,方便各大语言直接http调用,同时提供了最新版本的lucene,solr和elasticsearch的分词接口! Jcseg 2.5.0更新如下: 1,修复NLP模式下部分“第xx”实体识别的position错误的bug (Reported by https://gitee.com/lionsoul/jcseg/issues/I10FKC)。 2,修复elasticsearch插件的词库autoload的bug(Reported by https://gitee.com/lionsoul/jcseg/issues/IWT2P)。 3,对于全部的切分模式增加同义词自动词性继承。 4,增加elasticsearch 7.2.0支持和lucene, solr 8.0.0支持 (Reported by https://gitee.com/lionsoul/jcseg/issues/IZ7GS)。 5,lucene,solr,elasticsearch检索同义词解决方案与Jcseg同义词方案结合。 6,修复了lucene以及其扩展产品Elasticsearch, solr等同义词以及派生词 (例如,中文数字转阿拉伯数字)的高亮的bug。 这个问题打Jcseg增加同义词以来一直都有的问题,issue中被提了很多次,感谢以下的issue和信息提供者,已经测试OK了: https://gitee.com/lionsoul/jcseg/issues/IM8GD https://gitee.com/lionsoul/jcseg/issues/IMBLD https://gitee.com/lionsoul/jcseg/issues/IRLA2 https://gitee.com/lionsoul/jcseg/issues/IRLA2 https://gitee.com/lionsoul/jcseg/issues/IXA40 https://gitee.com/lionsoul/jcseg/issues/I11505 https://github.com/lionsoul2014/jcseg/issues/46 7,jccseg-server更改jetty版本号为:9.4.18.v20190429。 8,词条格式调整为:“词条/词性集合/拼音/实体集合/自定义参数”。 9,少量词库优化 。 下载地址: Gitee:https://gitee.com/lionsoul/jcseg/tree/v2.5.0-release Github:https://github.com/lionsoul2014/jcseg/releases/tag/v2.5.0-release Maven仓库地址: <dependency> <groupId>org.lionsoul</groupId> <artifactId>jcseg-core</artifactId> <version>2.5.0</version> </dependency>

优秀的个人博客,低调大师

自然语言处理工具HanLP-基于层叠HMM地名识别

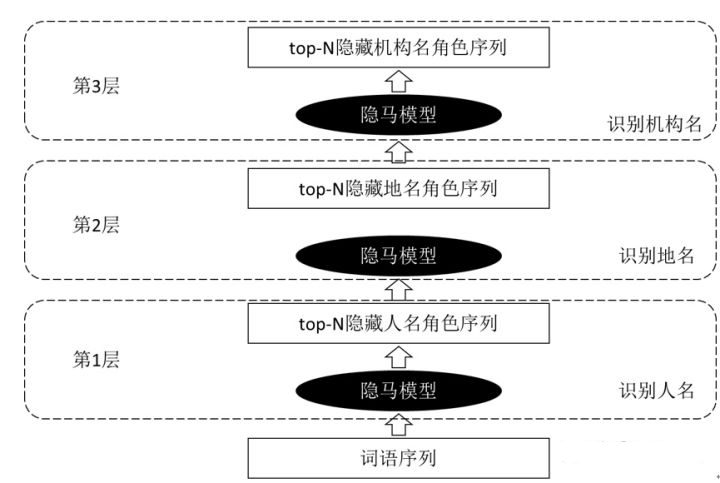
本篇接上一篇内容《HanLP-基于HMM-Viterbi的人名识别原理介绍》介绍一下层叠隐马的原理。首先说一下上一篇介绍的人名识别效果对比: 只有Jieba识别出的人名准确率极低,基本为地名或复杂地名组成部分或复杂机构名组成部分。举例如下: [1] 战乱的阿富汗地区,qiang zhi可随意买卖,AK47价格约500人民币“阿富汗”被识别为人名。[2] 安庆到桂林自驾游如何规划?“桂林”被识别为人名。[3] 2018天津市和平分局招聘社区戒毒、社区康复工作人员成绩查询入口“康复”被识别为人名。 只有HanLP识别出的人名除了特别常用姓氏的名字识别正确,其他的都识别错误。举例如下: [1] 纳溪区副区长李明带队到“花田酒地”景区检查节前安全工作“花田酒”被被识别为人名。[2] 秀英“线上线下”齐发力 助力贫困户“微互动”拓宽农产品销路“齐发力”被识别为人名。[3] 紧急通知:秦报融媒粉团祖山一日游日报名费大调整!“秦报”被识别为人名。 HanLP与Jieba都识别出的人名 非常用姓氏识别出的人名基本错误。[1] 房产高管薪酬大起底 万科郁亮年薪1189.9万仅排第二 [2] 生生不息 南通支云发布汶川地震十周年海报呼吁赛前默哀[3] 为什么伊郎不能有he wu qi,而美国有he wu qi? 名字本身构成词时基本错误。[1] 周口一村庄杨絮着火,对付杨絮用啥方法好呢? [2] 上联: 三国魏蜀吴,如何对下联?[3] 上联:灯火辉煌万家乐。求下联? 如何解决这些badcase呢,要看你的时间了,如果时间充裕的话,可以调整发射概率文件也就是nr.txt文件。如果时间不充裕的话,比如我现在的情况,那就只保留常用姓氏,以及特别需要关注的人名了。上一篇的内容先说到这里,介绍本篇的主题”基于层叠隐马的命名实体识别”我这里主要阅读的是这篇文章《基于层叠隐马尔可夫模型的中文命名实体识别》。层叠就是将模型级联起来的意思,因此系统的结构如下图所示: 如图所示,层叠隐马就是训练三个隐马模型,每个模型标注一种实体,三个模型采用级联形式连接。 不同的实体有不同的角色标注,实际就是特征,这些特征需要有语言学的知识,实际上就是你的阅读量,通过你大量阅读总结经验,比如姓氏可以作为名字的一个特征(张、王、李、赵),常用地名的后缀可以作为一个特征(省、市、区、县),机构名表处所的尾字可以作为一个特征(局、处、所、院)。这里地名的角色标注简表如下所示:

优秀的个人博客,低调大师

自然语言处理工具HanLP-N最短路径分词

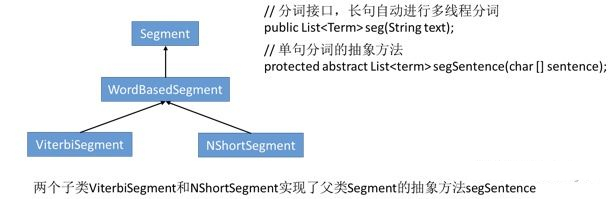
本篇给大家分享baiziyu 写的HanLP 中的N-最短路径分词。以为下分享的原文,部分地方有稍作修改,内容仅供大家学习交流!首先说明在HanLP对外提供的接口中没有使用N-最短路径分词器的,作者在官网中写到这个分词器对于实体识别来说会比最短路径分词稍好,但是它的速度会很慢。对此我有点个人看法,N-最短路径分词相较于最短路径分词来说只是考虑了每个节点下的N种最佳路径,在最后选出的至少N条路径中,作者并没有对他们进行筛选,而只是选择了一条最优的路径,只能说N-最短路径分词相较于最短路径分词对分词歧义会有一定作用,而对于未登录词它的效果应该和最短路径分词相差不多,这只是个人的猜测,并没有拿真实的语料验证。如果后边还有时间的话,我会把几种分词器在新闻语料上做一次对比评测。但是这种评测的意义可能不大,因为毕竟领域不同分词器的效果也会不同,同文本分类一样,至今依然没有一种普适的分词器。前边已经提到,在最短路径分词中,若每个结点处记录N种最短路径值,则该方法称为N-最短路径算法。在HanLP中通过两个类ViterbiSegment和NshortSegment分别实现了最短路径分词和N-最短路径分词。这里要说明一下为什么说是N种而不是N个,原因是算法会在每个字节点处对所有到达该节点的路径计算路径值,然后按照路径值做排序,所谓的“种”指的是路径值的种类数,因此当存在相等路径值的路径时,节点处保留的路径就不只有N个了。从上图的继承关系我们可以看到最短路径分词器和N最短路径分词器都继承了WordBasedSegment抽象类,也就是说他们从大类上讲都属于基于词语的分词器。后边我们还会介绍基于词典的分词器(极速词典分词器)以及基于字的分词器(感知机、条件随机场分词器)。这里再说明一下抽象类Segment它对外提供了分词方法Seg,所有HanLP中实现的分词方法类都继承了该抽象类,并且实现了抽象方法segSentence。Seg方法对输入的文本进行处理,当文本长度很长时,它会自动将其拆分为多个短文本,然后利用多线程技术,同步对多个短文本进行分词处理,最后得到分词后的文本,对于短文本Seg方法则直接用单线程处理。segSentence则会根据各种不同的分词方法对文本进行分词。这里Seg方法会调用segSentence方法,这就是两个方法的关系。拿我们现在的N-最短路径分词来说,segSentence实现的就是N-最短路径分词。如果是最短路径分词,则segSentence实现的是最短路径分词。写这些只是为了使刚接触面向对象编程方法的小伙伴能清楚。下边我们还是以例句“他说的确实在理”为例来说明N-最短路径分词。程序对外表现就是计算出下边的表 这里我们使N-最短路径分词中的N取2,可以看到算法从“实”字开始就开始有多种最优路径了,截取了前top2种,最后得到了下边的两种分词结果 至此,我们N-最短路径分词介绍结束,我们再来总结一下HanLP中两种方法的异同。(1) 第1个区别是节点上保留的最优路径前驱节点数。具体来说,当某个节点存在两个以上前驱时,N-最短路径一定会保留topN种路径值的所有前驱节点,而最短路径只会保留一个最短路径值的前驱节点。(2) HanLP在实现上对N-最短路径方法增加了数字、日期合并规则。(3) HanLP的N-最短路径方法最终返回的还是一个最优路径,并未对topN个分词结果做筛选策略,虽然在有多个前驱的节点处保留了多个候选前驱,但是个人感觉两者相差应该不多,可能对分词歧义有效果,但是对未登录词应该作用不大。说白了它也还是基于词典中单个词语的概率做的,其他的文本信息都没有用到。这里,还要再说明一下,我们看到了分词结果中含有了词性标注,关于词性标注我们会在后边继续介绍,它与分词方法是两个策略。程序也是先做了分词再根据用户配置做的词性标注。

优秀的个人博客,低调大师

中文自然语言处理工具hanlp隐马角色标注详解

本文旨在介绍如何利用HanLP训练分词模型,包括语料格式、语料预处理、训练接口、输出格式等。 目前HanLP内置的训练接口是针对一阶HMM-NGram设计的,另外附带了通用的语料加载工具,可以通过少量代码导出供其他训练工具使用的特定格式(如CRF++)。 语料格式 输入语料格式为人民日报分词语料库格式。该格式并没有明确的规范,但总体满足以下几点: 1、单词与词性之间使用“/”分割,如华尔街/nsf,且任何单词都必须有词性,包括标点等。 2、单词与单词之间使用空格分割,如美国/nsf 华尔街/nsf 股市/n。 3、支持用[]将多个单词合并为一个复合词,如[纽约/nsf 时报/n]/nz,复合词也必须遵守1和2两点规范。 你可以参考OpenCorpus/pku98/199801.txt(作者并无版权,请勿询问)。 语料预处理 语料预处理指的是将语料加载到内存中,根据需要增删改其中部分词语的一个过程。 在HanLP中,这是通过CorpusLoader.walk实现的: CorpusLoader.walk("path/to/your/corpus", new CorpusLoader.Handler() { @Override public void handle(Document document) { System.out.println(document); } }); 其中,document对象就是加载到内存的文档,对应某一个文本文件。用户可以通过document.getSimpleSentenceList等接口获取文档中的句子列表,每个句子都是单词的链表,具体参数请参考source.jar,不再赘述。而Handler是一个处理逻辑(lambda函数),在此可以编写自己的预处理代码。 · CRF分词采用BMES标注集,从人民日报转换到CRF训练语料的完整预处理代码请参考com.hankcs.test.model.TestCRF#testPrepareCRFTrainingCorpus。 · 若不使用上述预处理代码则请注意:由于在HanLP实现的CRF分词解码算法中,数词被转换为M,英文被转换为W;所以在训练CRF分词之前,需要用相同的逻辑预处理语料。转换代码请参考:com.hankcs.test.model.TestCRF#compile 训练HMM-NGram分词模型 HMM-NGram在HanLP中特意被处理为文本形式,方便用户理解、修改HMM-NGram模型(习惯上称为词典,但这并不代表它不是模型)。此处的训练就是为了得到分词所需的全部模型,而训练,只需一两行代码: finalNatureDictionaryMaker dictionaryMaker =newNatureDictionaryMaker(); CorpusLoader.walk("path/to/your/corpus", newCorpusLoader.Handler() { @Override publicvoidhandle(Document document) { dictionaryMaker.compute(CorpusUtil.convert2CompatibleList(document.getSimpleSentenceList(true))); } }); dictionaryMaker.saveTxtTo("data/test/CoreNatureDictionary"); 其中,document.getComplexSentenceList()代表获取复合词句子列表(即复合词原样输出),用户可以将其替换为CorpusUtil.convert2CompatibleList(document.getSimpleSentenceList(true))来将复合词拆分为单个词语。 输出格式 训练后一共得出3个文件: 1、CoreNatureDictionary.txt:单词词性词典 2、CoreNatureDictionary.ngram.txt:二元接续词典 3、CoreNatureDictionary.tr.txt:词性转移矩阵 接下来用户可以通过替换配置文件中的CoreDictionaryPath来使用新训练的词典。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册