首页 文章 精选 留言 我的

精选列表

搜索[自然语言生成],共10009篇文章
优秀的个人博客,低调大师

面向机器学习的自然语言标注2.2 背景研究

2.2 背景研究 既然你已经考虑了哪些语言学层次适合标注任务,那么可以对相关研究工作进行了解。虽然建立标注语料库要花费许多工夫,完全由自己单独地完成一个好的标注任务也是可能的,但是首先了解业界的相关研究与发展现状将可以节省大量的时间和精力。很可能已有的一些研究与你正在进行的工作有关,从而使你不必一切从头做起。 例如,如果对时间标注感兴趣,现在ISO-TimeML已成为时间与事件标注方面(包括时间关系)的国际标准化组织标准。这一事实并不要求所有的时间标注都必须原样不动地使用ISO-TimeML的标注方案。在诸如医学和生物医学文本分析的领域中,TimeML可作为有用的起点,但是在有些情况下它给标注人员提供了太多的选项,在另一些情况下则没有覆盖与所在领域相关的一些特殊用例。了解其他人在已有的标注方案中进行的工作,特别是与你的标注计划直接相关

优秀的个人博客,低调大师

自然语言处理工具python调用hanlp的方法步骤

Python调用hanlp的方法此前有分享过,本篇文章分享自“逍遥自在017”的博客,个别处有修改,阅读时请注意!1.首先安装jpype首先各种坑,jdk和python 版本位数必须一致,我用的是JPype1-py3 版本号0.5.5.2 、1.6jdk和Python3.5,win7 64位下亲测没问题。否则死翘翘,有可能虚拟机都无法启动: 出错调试,原因已说;测试成功会有输出。下面启动虚拟机跑hanlp2.下载各种安装包使用自定义的HanLP——HanLP由3部分组成:类库hanlp.jar包、模型data包、配置文件hanlp.properties,请前往项目主页下载最新版(最新版是1.7.4)的对于非portable版,下载后,你需要编辑配置文件第一行的root指向data的父目录,详见文档。 测试成功: 这里有可能JClass("com.hankcs.hanlp.HanLP")时,报错出现找不到类的问题,仔细查看配置文件和jar路径是否对;如果还出错,查看data里面的文件是否全。

优秀的个人博客,低调大师

Hanlp自然语言处理工具之词法分析器

本章是接前两篇《分词工具Hanlp基于感知机的中文分词框架》和《基于结构化感知机的词性标注与命名实体识别框架》的。本系统将同时进行中文分词、词性标注与命名实体识别3个任务的子系统称为“词法分析器”。 加载 对应的类为PerceptronLexicalAnalyzer,其构造方法为递增的3个模型地址: l public PerceptronLexicalAnalyzer(String cwsModelFile) throws IOException l public PerceptronLexicalAnalyzer(String cwsModelFile, String posModelFile) throws IOException l public PerceptronLexicalAnalyzer(String cwsModelFile, String posModelFile, String nerModelFile) throws IOException 用户根据自己要进行的任务,训练3个模型中的任意个数,然后灵活传入此类构造即可。此处假设训练了3个模型,那么传入这3个模型的路径即可构造词法分析器: public void testCWSandPOSandNER() throws Exception { PerceptronLexicalAnalyzer segmenter = new PerceptronLexicalAnalyzer(Config.CWS_MODEL_FILE, Config.POS_MODEL_FILE, Config.NER_MODEL_FILE); } 分析 词法分析器的分析接口如下: public static final String SENTENCE = "香港特别行政区的张朝阳说商品和服务是三原县鲁桥食品厂的主营业务"; public void testCWSandPOSandNER() throws Exception { PerceptronLexicalAnalyzer segmenter = new PerceptronLexicalAnalyzer(Config.CWS_MODEL_FILE, Config.POS_MODEL_FILE, Config.NER_MODEL_FILE); Sentence sentence = segmenter.analyze(SENTENCE); System.out.println(sentence); } 正常情况下输出: [香港/ns 特别/a 行政区/n]/ns 的/n 张朝阳/nr 说/v 商品/n 和/c 服务/vn 是/v [三原县/ns 鲁桥/nz 食品厂/n]/nt 的/z 主营/vn 业务/n Sentence结构是一个对人民日报语料格式的实现,用户可以方便地用for循环去遍历单词,用instanceof来判断单词属于复合词还是简单词。此处演示输出句子中所有复合词内部的简单词: for (IWord word : sentence) { if (word instanceof CompoundWord) System.out.println(((CompoundWord) word).innerList); } 结果: [香港/ns, 特别/a, 行政区/n] [三原县/ns, 鲁桥/nz, 食品厂/n] 通过此结构,我们可以捕捉语言的复合结构(简单词构成复合词)。此结构输出为文本后满足人民日报2014语料格式,形成了一个语料与文本之间的闭环。 与HanLP旧接口的兼容 本系统依然兼容HanLP的seg接口,与analyze接口比较如下: System.out.println(segmenter.seg(SENTENCE)); System.out.println(segmenter.analyze(SENTENCE)); 输出: [香港特别行政区/ns, 的/n, 张朝阳/nr, 说/v, 商品/n, 和/c, 服务/vn, 是/v, 三原县鲁桥食品厂/nt, 的/z, 主营/vn, 业务/n] [香港/ns 特别/a 行政区/n]/ns 的/n 张朝阳/nr 说/v 商品/n 和/c 服务/vn 是/v [三原县/ns 鲁桥/nz 食品厂/n]/nt 的/z 主营/vn 业务/n 注意上面两个结果中的命名实体有着本质的不同,seg接口无法输出层次结构,而analyze接口可以。 在线学习 本框架另一个特色功能是“在线学习”,或称“增量训练”。其适用场景如下: 线上系统的统计模型依然会犯错误,但重新训练的代价过大(比如耗时长,没有语料等等)。本系统支持在线学习新知识,实时修正统计模型的错误。这里举一个分词的例子,人民日报1998年1月份训练出来的模型无法分对“下雨天地面积水”这个句子: PerceptronSegmenter segmenter = new PerceptronSegmenter(Config.CWS_MODEL_FILE); System.out.println(segmenter.segment("下雨天地面积水")); 输出: [下雨, 天地, 面积, 水] 但本系统支持在线学习这个句子的正确分词方式: segmenter.learn("下雨天 地面 积水"); System.out.println(segmenter.segment("下雨天地面积水")); 通过learn接口,感知机模型学习到了这个句子的正确分词方式,并输出了正确结果: [下雨天, 地面, 积水] 对于类似的句子,也拥有了举一反三的泛化能力: System.out.println(segmenter.segment("下雨天地面积累了很多水")); 输出: [下雨天, 地面, 积累, 了, 很多, 水] 词性标注器和命名实体识别器也有类似的learn接口,用户可举一反三类似地调用,不再赘述。 模型压缩与持久化 在线学习或训练后的模型可以序列化到某个路径,其接口是: /** * @param ratio 压缩比c(压缩掉的体积,压缩后体积变为1-c) * @return */ public LinearModel compress(final double ratio) /** * 保存到路径 * * @param modelFile * @throws IOException */ public void save(String modelFile, final double ratio) throws IOException 比如压缩比为0.1,则压缩后的体积为原来的0.9。此处的“体积”指的是特征数量,并不一定等于文件体积。 命令行接口 如上文所述,本框架中的功能可以通过命令行调用: $ java -cp hanlp.jar com.hankcs.hanlp.model.perceptron.Main 缺少必需参数: -model 用法: com.hankcs.hanlp.model.perceptron.Main -task [TaskType] 任务类型:CWS|POS|NER (CWS) -train [flag] 执行训练任务 -test [flag] 执行预测任务 -evaluate [flag] 执行评估任务 -model [String] 模型文件路径 -input [String] 输入文本路径 -result [String] 结果保存路径 -gold [String] 标准分词语料 -reference [String] 训练集 -development [String] 开发集 -iter [Integer] 迭代次数 (5) -compressRatio [Double] 模型压缩比率 (0.0) -thread [int] 线程数 (8) 当用户按照上文所述训练了1到3个模型后,可以通过命令行接口交互式地观察效果: $ java -cp target/hanlp-1.6.0.jar:src/main/resources com.hankcs.hanlp.model.perceptron.Main -test 商品和服务 商品/n 和/c 服务/vn 上海华安工业(集团)公司董事长谭旭光和秘书胡花蕊来到美国纽约现代艺术博物馆参观 [上海/ns 华安/nz 工业/n (/w 集团/n )/w 公司/n]/nt 董事长/n 谭旭光/nr 和/c 秘书/n 胡花蕊/nr 来到/v [美国/ns 纽约/ns 现代/t 艺术/n 博物馆/n]/ns 参观/v l 默认加载配置文件指定的模型,可以通过-model your/cws.bin,your/pos.bin,your/ner.bin指定别的模型。 l 还可以将输入输出重定向到文件,形成一个pipeline。 l 更多信息,请参考《编译运行》。 未来工作 l 英文和数字最好要做特殊处理。 l 与hanlp-lucene-plugin的集成。 l 集成自定义词典。 l 索引分词等功能。 l 重构出新的分词、词性标注与命名实体识别接口,统一所有分词器,并逐步淘汰旧接口。 文章摘自:HanLP: Han Language Processing ——开源自由的汉语言处理包

优秀的个人博客,低调大师

自然语言处理工具python调用hanlp中文实体识别

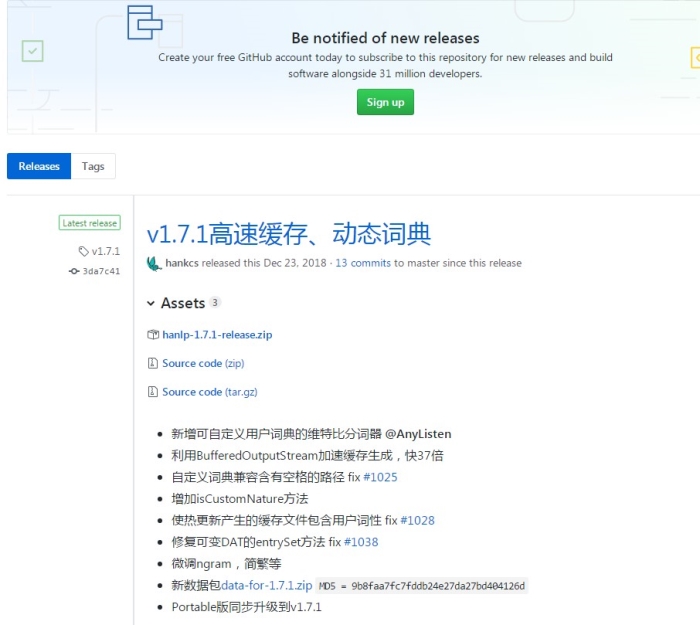
Hanlp作为一款重要的中文分词工具,在GitHub的用户量已经非常之高,应该可以看得出来大家对于hanlp这款分词工具还是很认可的。本篇继续分享一篇关于hanlp的使用实例即Python调用hanlp进行中文实体识别。 想要在python中调用hanlp进行中文实体识别,Ubuntu 16.04的系统环境 1.安装jpype1,在cmd窗口输入 pip install jpype1 2.下载hanlp的安装包 在github.com/hankcs/HanLP/releases (1)下载新的 hanlp-1.7.1-release.zip文件,里面包含hanlp-1.7.1.jar , hanlp-1.7.1-sources.jar , hanlp.properties (2)点击data-for-1.7.1.zip下载。(底下第8条) 注:如果你在hanlp.linrunsoft.com/services.html点击下载hanlp.jar,下载下来的是hanlp-1.2.8.jar。之后在使用过程中可能会出现“字符类型对应表加载失败”的错误,查看相应路径下也没有CharType.dat.yes文件。原因可能是hanlp-1.2.8版本过低,使用新版本应该不会出现这个问题。 3.新建一个文件夹Hanlp,放文件hanlp-1.7.1.jar和hanlp.properties文件 新建一个文件夹hanlp,放data-for-1.7.1.zip解压后的文件 配置hanlp.properties中的第一行的root为hanlp文件夹的位置,也就是data-for-1.7.1.zip解压后的文件放的位置。 4.写py文件调用hanlp进行中文分析。 用法可参考这个博客 blog.csdn.net/u011961856/article/details/77167546。 另,查看HanLP关于实体识别的文档hanlp.linrunsoft.com/doc.html 里面介绍说中文人名标注为“nr”,地名标注为“ns”,机构名标注为“nt”,所以使用用法参考链接里的NLPTokenizer.segment就可以标注出中文句子中的人名,地名和机构名。 比较使用jieba进行词性标注时,也可以标注出中文句子中的人名,地名和机构名。jieba分词的词性说明:

优秀的个人博客,低调大师

自然语言处理工具包HanLP的Python接口

pyhanlp: Python interfaces for HanLPHanLP的Python接口,支持自动下载与升级HanLP,兼容py2、py3。 安装pip install pyhanlp使用命令hanlp来验证安装,如因网络等原因自动安装HanLP失败,可参考《手动配置》。 命令行中文分词使用命令hanlp segment进入交互分词模式,输入一个句子并回车,HanLP会输出分词结果: $ hanlp segment商品和服务商品/n 和/cc 服务/vn当下雨天地面积水分外严重当/p 下雨天/n 地面/n 积水/n 分外/d 严重/a龚学平等领导说,邓颖超生前杜绝超生龚学平/nr 等/udeng 领导/n 说/v ,/w 邓颖超/nr 生前/t 杜绝/v 超生/vi还可以重定向输入输出到文件等: $ hanlp segment <<< '欢迎新老师生前来就餐' 欢迎/v 新/a 老/a 师生/n 前来/vi 就餐/vi依存句法分析命令为hanlp parse,同样支持交互模式和重定向: $ hanlp parse <<< '徐先生还具体帮助他确定了把画雄鹰、松鼠和麻雀作为主攻目标。' 1 徐先生 徐先生 nh nr 4 主谓关系 _2 还 还 d d 4 状中结构 _3 具体 具体 a a 4 状中结构 _4 帮助 帮助 v v 0 核心关系 _5 他 他 r rr 4 兼语 _6 确定 确定 v v 4 动宾关系 _7 了 了 u ule 6 右附加关系 _8 把 把 p pba 15 状中结构 _9 画 画 v v 8 介宾关系 _10 雄鹰 雄鹰 n n 9 动宾关系 _11 、 、 wp w 12 标点符号 _12 松鼠 松鼠 n n 10 并列关系 _13 和 和 c cc 14 左附加关系 _14 麻雀 麻雀 n n 10 并列关系 _15 作为 作为 p p 6 动宾关系 _16 主攻 主攻 v vn 17 定中关系 _17 目标 目标 n n 15 动宾关系 _18 。 。 wp w 4 标点符号 _服务器通过hanlp serve来启动内置的http服务器,默认本地访问地址为:http://localhost:8765 ;也可以访问官网演示页面:http://hanlp.hankcs.com/ 。 升级通过hanlp update命令来将HanLP升级到最新版。该命令会获取GitHub最新版本并自动下载安装。 欢迎通过hanlp --help查看最新帮助手册。 API通过工具类HanLP调用常用接口: from pyhanlp import * print(HanLP.segment('你好,欢迎在Python中调用HanLP的API'))testCases = [ "商品和服务", "结婚的和尚未结婚的确实在干扰分词啊", "买水果然后来世博园最后去世博会", "中国的首都是北京", "欢迎新老师生前来就餐", "工信处女干事每月经过下属科室都要亲口交代24口交换机等技术性器件的安装工作", "随着页游兴起到现在的页游繁盛,依赖于存档进行逻辑判断的设计减少了,但这块也不能完全忽略掉。"] for sentence in testCases: print(HanLP.segment(sentence)) 关键词提取 document = "水利部水资源司司长陈明忠9月29日在国务院新闻办举行的新闻发布会上透露," \ "根据刚刚完成了水资源管理制度的考核,有部分省接近了红线的指标," \ "有部分省超过红线的指标。对一些超过红线的地方,陈明忠表示,对一些取用水项目进行区域的限批," \ "严格地进行水资源论证和取水许可的批准。" print(HanLP.extractKeyword(document, 2)) 自动摘要 print(HanLP.extractSummary(document, 3)) 依存句法分析 print(HanLP.parseDependency("徐先生还具体帮助他确定了把画雄鹰、松鼠和麻雀作为主攻目标。"))更多功能更多功能,包括但不限于: 自定义词典极速词典分词索引分词CRF分词感知机词法分析臺灣正體、香港繁體关键词提取、自动摘要文本分类、情感分析请阅读HanLP主项目文档以了解更多。调用更底层的API需要参考Java语法用JClass引入更深的类路径。以感知机词法分析器为例,这个类位于包名com.hankcs.hanlp.model.perceptron.PerceptronLexicalAnalyzer下,所以先用JClass得到类,然后就可以调用了: PerceptronLexicalAnalyzer = JClass('com.hankcs.hanlp.model.perceptron.PerceptronLexicalAnalyzer')analyzer = PerceptronLexicalAnalyzer()print(analyzer.analyze("上海华安工业(集团)公司董事长谭旭光和秘书胡花蕊来到美国纽约现代艺术博物馆参观"))输出: [上海/ns 华安/nz 工业/n (/w 集团/n )/w 公司/n]/nt 董事长/n 谭旭光/nr 和/c 秘书/n 胡花蕊/nr 来到/v [美国/ns 纽约/ns 现代/t 艺术/n 博物馆/n]/ns 参观/v如果你经常使用某个类,欢迎将其写入pyhanlp/__init__.py中并提交pull request,谢谢! 与其他项目共享dataHanLP具备高度可自定义的特点,所有模型和词典都可以自由替换。如果你希望与别的项目共享同一套data,只需将该项目的配置文件hanlp.properties拷贝到pyhanlp的安装目录下即可。本机安装目录可以通过hanlp --version获取。 同时,还可以通过--config临时加载另一个配置文件: hanlp segment --config path/to/another/hanlp.properties配置自动配置默认在首次调用HanLP时自动下载jar包和数据包,并自动完成配置。 手动配置如因网络等原因自动配置失败,可以通过设置环境变量来自定义HanLP版本和数据位置。 变量名 默认值 备注HANLP_STATIC_ROOT pyhanlp所在安装路径的static文件夹 配置文件hanlp.properties所在的目录HANLP_JAR_PATH pyhanlp所在安装路径的static文件夹 HanLP jar 包位置HANLP_JVM_XMS 1g Java 虚拟机 初始申请内存大小HANLP_JVM_XMX 1g Java 虚拟机 可占用的最大内存HANLP_GOOGLE_UA UA-XXXXX-X Google Analytics 网站 idHANLP_VERBOSE 0 调试日志开关注意: 使用pip初次安装 pyhanlp 后,不设置上述变量,程序会自动下载所需依赖到默认位置。如果是设置了上述变量,则不进行下载。因为文件比较大,网络下载稳定性等原因,建议提前准备好jar包,配置文件和data,并使用环境变量进行配置。 保证 hanlp.properties 中的 root 是指向正确的data路径。 比如: export HANLP_JAR_PATH=/hanlp/hanlp-portable-1.6.0.jarexport HANLP_STATIC_ROOT=/hanlp就需要保证有如下的目录结构: hanlp├── data│ ├── README.url│ ├── dictionary│ └── model├── hanlp.properties└── hanlp-portable-1.6.0.jar测试git clone https://github.com/hankcs/pyhanlp.gitcd pyhanlppip install -r requirements.txt # 安装依赖export HANLP_JAR_PATH= # 配置环境变量export HANLP_STATIC_ROOT= # 配置环境变量python tests/test_hanlp.py # 执行测试授权协议Apache License 2.0 文章来源于hankcs的博客

优秀的个人博客,低调大师

NLPIR语义分词技术给自然语言处理带来新驱动

随着信息的快速速增长,让搜索引擎成了人们查找信息的首要工具。如今在中文搜索引擎领域,国内搜索引擎已经同国外搜索引擎效果上相差不大了。能形成现在这样的局面,是有一个重要的原因:英文和中文两种语言自身的书写方式不相同,其中在计算机涉及的技术就是中文分词技术。 分词技术发展至今,也已经有十几年的历史。目前在中文分词领域,已经有很多成熟的分词技术。中文是由连续文字组成,缺乏有效的间隔,虽然有句、段分隔,但在进行机器语言学习、文本语义理解分析过程中都需以词组为最小单位的。因此实现中文分词相对英语来讲,更加的复杂、困难。这其中对于计算机涉及的技术就是中文分词技术。 中文分词不仅是各种中文信息处理技术中使用最广泛的手段,也是信息检索和搜索引擎必不可少的基础性工作。现有的中文分词方法有很多,它们以字符串匹配、统计模型、理解、路径以及语义等

优秀的个人博客,低调大师

中文自然语言处理工具集:分词,相似度匹配

欢迎大家关注我们的网站和系列教程:http://www.tensorflownews.com/,学习更多的机器学习、深度学习的知识! 分词工具 结巴分词 https://github.com/fxsjy/jieba pullword http://www.pullword.com/ FudanNLP https://github.com/FudanNLP/fnlp 相似度匹配工具 gensim gensim – Topic Modelling in Python https://github.com/RaRe-Technologies/gensim starspace https://github.com/facebookresearch/StarSpace 项目 bosonnlp https://bosonnlp.com/ 欢迎大家关注我们的网站和系列教程:http://www.tensorflownews.com/,学习更多的机器学习、深度学习的知识!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册