首页 文章 精选 留言 我的

精选列表

搜索[程序员],共10001篇文章
优秀的个人博客,低调大师

程序员修炼之道系列 | 敏捷估算

交付这个项目需要多久? 存储一百万个客户信息需要多少磁盘空间? 压缩1000MB文本需要多长时间? …… 在软件项目中,我们经常要对即将开始的工作进行预估。而这其中有很多技术更新、需求变更等未知因素,都会使估算结果不是很精确。那么,我们为什么要进行敏捷估算呢? 视频链接:https://www.zentao.net/programmer/agile-estimation-80366.html 为什么要进行敏捷估算? 对决策者来说,需要根据估算结果,来调整需求优先级,进行资源安排,甚至决定是否要砍掉某个功能; 对客户来说,估算结果可以给出一个功能上线的预期或承诺; 对团队来说,提前讨论需求,可达到对需求有一致的理解,提升实际工作中的团队效率。 估算虽然是为了得到完成时间的预期,但最重要的价值在于,估算过程中对需求的深入理解,以及如何实现功能的思考过程。 如何进行敏捷估算? 在软件开发过程中,最常见的估算方法有两种。 工时估算 工时估算可以理解为,完成所需功能需要的时间,估算结果属于绝对值。工时估算是团队成员基于自身能力所做出的估算,可借助敏捷估算扑克牌进行估算,具体内容欢迎观看我们的往期视频。 故事点估算 故事点估算是用于预估,实现一个或多个用户故事所有工作量的估算结果。估算结果以点数度量,应考虑到影响工作量的所有因素,主要包括: 将要开展的工作数量 工作的复杂度 将要开展的工作中存在的任何风险或不确定性 故事点估算采用团队估算的方式进行,我们无法让多个能力不同的开发人员,就同一个开发任务的耗时达成一致,但可以做到对工作量多少的估算保持一致,描述开发工作量的单位就是故事点。 估算时,首先,选择一个比较小的用户故事,确定其故事点,并将该故事作为基准故事。然后再将其他用户故事和基准故事进行比较,得出其他用户故事的相对点数。 故事点估算主要为了明确要交付的任务。除了度量单位的差异,故事点估算和工时估算的方法相似,都可借助估算扑克牌来进行。不过,故事点估算比较常用斐波那契数列的形式,以避免陷入一直追求精确性的怪圈。 估算七不要 不要追求完美; 不要为满足预算而估算; 不要随意削减估算结果; 不要以客户目标作为估算结果; 不要藏匿不确定的成本; 不要贪多偷减; 不要过于依赖以往经验。 进行估算之前,多花点时间理解需求,总能得到更好的结果。 更多精彩视频分享:https://www.zentao.net/page/college.html

优秀的个人博客,低调大师

程序员都要懂点位运算

>原创公众号:[bigsai](https://mp.weixin.qq.com/s/IW_GNK254ijIuuupjJsKCA) >原创不易,如果有收获请不要吝啬你的**赞赞**! > 文章已收录在 [全网都在关注的数据结构与算法学习仓库](https://github.com/javasmall/bigsai-algorithm) 欢迎star > ## 前言 位运算隐藏在编程语言的角落中,其神秘而又强大,暗藏内力,有些人光听位运算的大名的心中忐忑,还有些人更是一看到位运算就远远离去,我之前也是。但狡猾的面试官往往喜欢搞偷袭,抓住我们的弱点搞我们,为了防患于未然,特记此篇! 本篇的内容为位运算的介绍和一些比较经典的位运算问题进行介绍分析,当然,位运算这么牛,后面肯定还是要归纳总结的。 ## 认识位运算 什么是位运算? > 程序中的所有数在计算机内存中都是以二进制的形式储存的。位运算就是直接对整数在内存中的二进制位进行操作。 位运算就是直接操作二进制数,那么有哪些种类的位运算呢? 常见的运算符有与(&)、或(|)、异或(^)、取反(~)、左移(<<)、右移(>>是带符号右移 >>>无符号右移动)。下面来细看看每一种位运算的规则。 **位运算 & (与)** 规则:二进制对应位两两进行逻辑AND运算(只有对应位的值都是 1 时结果才为 1, 否则即为 0)即 `0&0=0`,` 0&1=0`,` 1&1=1` 例如:2 & -2 ![image-20210103203435246](https://img-blog.csdnimg.cn/img_convert/899dfef6e7669a8e7184b18c36363af1.png) **位运算 | (或)** 规则:二进制对应位两两进行逻辑或运算(对应位中有一 个为1则为1) 即`0|0=0`,`0|1=1`,`1|1=1` 例如:2 | -2 ![image-20210103203852165](https://img-blog.csdnimg.cn/img_convert/2c4af066e23c53ec9ec30b5129c99305.png) **位运算 ^ (异或)** 规则:二进制对应位两两进行逻辑XOR (异或) 的运算(当对应位的值不同时为 1, 否则为 0)即`0^0=0`, `0^1=1`, ` 1^1=0` 例如:2 ^ -2 ![image-20210103204258194](https://img-blog.csdnimg.cn/img_convert/c6a4e8875ca91edea6df4324597568e9.png) **按位取反~** 规则:二进制的0变成1,1变成0。 ![image-20210103204832085](https://img-blog.csdnimg.cn/img_convert/687438186469bc1a7146ccfa73d95190.png) **移位运算符** 左移运算`<<`:左移后右边位补 0 右移运算`>>`:右移后左边位补**原最左位值(可能是0,可能是1)** 右移运算`>>>`:右移后左边位补 0 - 对于左移运算符`<<`没有悬念右侧填个零无论正负数相当于整个数乘以2。 - 而右移运算符就有分歧了,分别是左侧补0`>>>`和左侧补原始位`>>`,如果是正数没争议左侧都是补0,达到除以2的效果;如果是负数的话左侧补0`>>>`那么数值的正负会发生改变,会从一个负数变成一个相对较大的正数。而如果是左侧补原始位(负数补1)`>>`那么整个数还是负数,也就是相当于除以2的效果。 下面这张图可以很好的帮助你理解负数的移位运算符: ![image-20210111203911045](https://img-blog.csdnimg.cn/img_convert/cc86dc2bd95126e7e873596cda8c162e.png) 到这里,我想你应该对位运算有了初步的认识,在这里把上面提到的部分案例执行对比一下让你看一下可能会理解的更清晰: ![image-20210112233233639](https://img-blog.csdnimg.cn/img_convert/5b62bd9a65ea27bafb11b9fc63e57fa0.png) ## 位运算小技巧 在这里有些常用的位运算小技巧。 ### 判断奇偶数 正常判断奇数偶数的时候我们会这样写: ```java if( n % 2 == 1) // n 是个奇数 } ``` 使用位运算可以这么写: ```java if(n & 1 == 1){ // n 是个奇数。 } ``` 其核心就是判断二进制的**最后一位是否为1**,如果为1那么结果加上2^0=1一定是个奇数,否则就是个偶数。 ### 交换两个数 对于传统的交换两个数,我们需要使用一个变量来辅助完成操作,可能会是这样: ```java int team = a; a = b; b = team; ``` 但是使用位运算可以不需要借助额外空间完成数值交换: ```java a=a^b;//a=a^b b=a^b;//b=(a^b)^b=a^0=a a=a^b;//a=(a^b)^(a^b^b)=0^b=b ``` 原理已经写在注释里面了,是不是感觉非常diao呢? ### 二进制枚举 在遇到子集问题的处理时候,我们有时候会借助二进制枚举来遍历各种状态(效率大于dfs回溯)。这种就属于排列组合的问题了,对于每个物品(位置)来说,就是使用和不使用的两个状态,而在二进制中刚好可以用1和0来表示。而在实现上,通过枚举数字范围分析每个二进制数字各符号位上的特征进行计算求解操作即可。 ![image-20210122160614157](https://img-blog.csdnimg.cn/img_convert/dc234e197fd73aefcfd353bbde0b5210.png) 二进制枚举的代码实现为: ```java for(int i = 0; i < (1< 写一个函数,求两个整数之和,要求在函数体内不得使用+、-、*、/四则运算符号。 **分析**: 这道题咋一听可能没啥思路,简单研究一下位运算还是能独立推出来和理解的。 当然,解决这题前,需要了解上面的四种位运算。还要知道二进制的运算:**0+0=0,0+1=1,1+1=0(进位)** 对于加法的一个二进制运算。**如果不进位**那么就是非常容易的。这时候相同位都为0则为0,0和1则为1.满足这种运算的**异或(不相同取1,相同取0)和或(有一个1则为1)**都能满足. ![在这里插入图片描述](https://img-blog.csdnimg.cn/img_convert/2b7d193abd4e48577122db905a1bf10c.png) 但事实肯定有进位的运算啊!看到上面操作的不足之后,我们肯定还需要**解决进位的问题**对于进位的两数相加,**这种核心思想为**: - 用两个数,**一个正常m相加**(不考虑进位的)。用**异或a^b**就是满足这种要求,先不考虑进位(如果没进位那么就是最终结果)。另一个**专门考虑进位的n**。两个1需要进位。所以我们用**a&b与**记录需要进位的。但是还有个问题,进位的要往上面进位,所以就变成这个需要进位的数左移一位。 - 然后就变成**m+n**重新迭代开始上面直到不需要进位的(即n=0时候)。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/img_convert/06342a7bff0496e5d2d2e8df40b01bb0.png) 实现代码为: ```java public class Solution { public int Add(int num1,int num2) { /* * 5+3 5^3(0110) 5&3(0001) * 0101 * 0011 */ int a=num1^num2; int b=num1&num2; b=b<<1; if(b==0)return a; else { return Add(a, b); } } } ``` 当然,这里也可以科普一下二进制求加法:**average = (a&b) + ((a^b)>>1)** ; ### 二进制中1的个数 这是一道经典题,在剑指offer上也有对应题目,其具体题目要求**输入一个整数,输出该数二进制表示中1的个数(其中负数用补码表示)**。 对于这个问题,不用位运算将它转成二进制字符串直接枚举字符'1'的个数也可以直接求出来,但是这样做是没有灵魂的并且效率比较差。这里提供两种解决思路 **法一**: 大家知道每个**类型的数据它的背后实际都是二进制操作**。大家知道int的数据类型的范围是(-2^31,2^31 -1)。并且int有32位。但是并非32位全部用来表示数据。**真正用来表示数据大小的也是31位。最高位用来表示正负**。 首先要知道: > 1<<0=1 =00000000000000000000000000000001 > 1<<1=2 =00000000000000000000000000000010 > 1<<2=4 =00000000000000000000000000000100 > 1<<3=8 =00000000000000000000000000001000 > . . . . . . > 1<<30=2^30 =01000000000000000000000000000000 > **1<<31=-2^31 =10000000000000000000000000000000** 其次还要知道位运算`&`与。两个十进制与运算.**每一位同1为1**。所以我们用2的正数次幂与知道的数分别进行与运算操作。**如果结果不为0,那么就说明这位为1.**(前面31个都是大于0的最后一个与结果是负数但是如果该位为1那么结果肯定不为0) ![image-20210122170223380](https://img-blog.csdnimg.cn/img_convert/9f15d9c907858b88b6ed3206c2ab50b7.png) 具体代码实现为: ```java public int NumberOf1(int n) { int va=0; for(int i=0;i<32;i++) { if((n&(1< 给定一个非空整数数组,除了某个元素只出现一次以外,**其余每个元素均出现两次**。找出那个只出现了一次的元素。 > > 说明:你的算法应该具有线性时间复杂度。 你可以不使用额外空间来实现吗? **分析:** 这是一道简单的面试题,面试官常问怎么样用不太复杂的方法找出数组中仅出现一次的数字(其他均出现两次),暴力枚举或者使用其他的存储结构都不够优化,而这个问题最高效的答案就是使用位运算。首先你要注意两点: - 0和任意数字进行异或操作结果为数字本身. - 两个相同的数字进行异或的结果为0. 具体的操作就是用0开始和数组中每个数进行异或,得到的值和下个数进行异或,最终获得的值就是出现一次(奇数次)的值。 ![image-20210122002813297](https://img-blog.csdnimg.cn/img_convert/30e7721bb56f6762f3514937fa408e3b.png) ```java class Solution { public int singleNumber(int[] nums) { int value=0; for(int i=0;i 给定一个非空整数数组,除了某个元素只出现一次以外,**其余每个元素均出现了三次**。找出那个只出现了一次的元素。 > > 说明:你的算法应该具有线性时间复杂度。 你可以不使用额外空间来实现吗? **分析:** 这题和上一题的思路略有不同,这题其他数字出现了3次,那么我们如果直接使用位运算异或操作的话无法直接找到结果,就需要巧妙的运用二进制的其他特性:**判断整除求余**操作。即判断所有数字二进制1的总个数和0的总个数一定有一个不是三的整数倍,如果0不是三的整数倍那么就说明结果的该位二进制数字为0,同理否则为1. ![image-20210122122756549](https://img-blog.csdnimg.cn/img_convert/1370719dcca474e10f59c3108b3dee9f.png) 在具体的操作实现上,问题中给出数组中的数据在int范围之内,那么我们就可以在实现上可以对int的32个位每个位进行依次判断该位1的个数求余3后是否为1,如果为1说明结果该位二进制为1可以将结果加上去。最终得到的值即为答案。 具体代码为: ```java class Solution { public int singleNumber(int[] nums) { int value=0; for(int i=0;i<32;i++) { int sum=0; for(int num:nums) { if(((num>>i)&1)==1) { sum++; } } if(sum%3==1) value+=(1< 一个整型数组里除了两个数字之外,**其他的数字都出现了两次**。请写程序找出这两个只出现一次的数字。 **思路**: 上面的问题处理和理解起来可能比较容易,但是这个问题可能稍微复杂一点,但是这题可以通过特殊的手段转化为上面只出现一次的一个数字问题来解决,当然核心的位运算也是异或`^`。 具体思路就是想办法**将数组逻辑上一分为二**!先异或一遍到最后得到一个数,得到的肯定是`a^b`(假设两个数值分别为a和b)的值。在看异或`^`的属性:不同为1,相同为0. 也就是说最终这个结果的二进制为1的位置上a和b是不相同的。而我们可以找到这个第一个不同的位,然后将数组中的数分成两份,该位为0的进行异或求解得到其中一个结果a,该位为1的进行异或求解得到另一个结果b。 具体可以参考下图流程: ![image-20210121225712670](https://img-blog.csdnimg.cn/img_convert/ff485512e7d6368dcc7a1451b4699b9b.png) 实现代码为: ```java public int[] singleNumbers(int[] nums) { int value[]=new int[2]; if(nums.length==2) return nums; int val=0;//异或求的值 for(int i=0;i >index)&1)==0)//如果这个数第index为0 和num1异或 num1^=nums[i]; else//否则和 num2 异或 num2^=nums[i]; } value[0]=num1; value[1]=num2; return value; } private int getFirst1(int val) { int index=0; while (((val&1)==0&&index<32)) { val>>=1;// val=val/2 index++; } return index; } ``` ## 结语 当然,上面的问题可能有更好的解法,也有更多经典位运算问题将在后面归纳总结,希望本篇的位运算介绍能够让你有所收获,对位运算能有更深一点的认识。对于很多问题例如博弈问题等二进制位运算能够很巧妙的解决问题,日后也会分享相关内容,敬请期待! 原创不易,如果觉得有所收获,希望大家点赞、分享、在看一键三连帮忙扩散,谢谢! 咱们下次再见! ![image-20201114211553660](https://img-blog.csdnimg.cn/img_convert/3cd335655373276f330fa2c16b0e20f6.png)

优秀的个人博客,低调大师

好程序员-JavaScript学习笔记-- GULP

JavaScript学习笔记-- GULPGULPgulp是一个项目开发的自动化打包构建工具基于node环境来运行的什么是自动化打包构建工具比如我们在开发的过程中,会写到js文件,css文件,等等我们的项目如果想上线,那么一定要体积小一点,文件大小越小越好而我们在写js文件的时候,会有很多换行/空格之类的东西这些换行/空格都是占文件体积的一部分那么我们在上线之前就要吧这些换行/空格尽可能的删除掉我们又不能一个文件一个文件的去删除就要用到一个自动化工具来帮助我们把这些多余的东西干掉这个就是自动化工具的意义常见的自动化打包构建工具gulpwebpack安装 GULPgulp是一个依赖于node的环境工具所以我们需要先安装一个全局gulp依赖直接使用npm去安装就可以了 使用 npm 安装全局依赖 gulp 我们这里安装一个 3.9.1 版本的就好了 $ npm install --global gulp@3.9.1等待安装完毕就好了这个全局环境一个电脑安装一次就好了还是照例检查一下是否安装成功$ gulp --version使用 GULP安装完毕以后,我们就可以使用 GULP 对我们的项目进行自动化构建了首先我们要有一个项目 gulp_demo 项目文件夹 src 项目源码 css css 文件夹 js js 文件夹 pages html 文件夹 sass sass 文件夹 lib 第三方文件夹 static 静态资源文件夹目录结构不一定都是这个样子 但是最好是一个便于管理的文件夹目录结构因为是一个项目了,最好使用npm来帮我们管理一下这样可以记录我们的下载使用了那些依赖所以在项目文件夹gulp-demo里面执行一个npm初始化$ cd gulp_demo$ npm init -y执行完毕之后,再来看一下我们的项目目录 gulp_demo src package.json项目 GULP 配置 我们之前已经安装过gulp全局依赖了但是每一个项目都要在安装一次gulp的项目依赖因为每一个项目的打包构建规则都不一样,所以不能全都配置成一个所以我们要在项目里面再次进行gulp安装$ cd gulp_demo$ npm install -D gulp@3.9.1项目中的gulp依赖要和全局gulp环境保持版本一致接下来就是对这个项目进行打包构建的配置gulp的使用,要在项目目录下新建一个gulpfile.js在这个gulpfile.js文件里面进行配置然后使用gulp进行构建的时候就会按照gulpfile.js文件里面的规则进行打包构建再来看一下我们的目录结构 gulp_demo node_modules 依赖包目录 src 项目源码 gulpfile.js gulp 配置文件 package-lock.json 依赖下载版本 json 文件 package.json 项目管理 json 文件接下来我们就是在gulpfile.js文件里面进行配置,让我们的打包构建可以生效 打包 CSS 文件我们从简单的内容开始,先来打包构建css文件其实就是在gulpfile.js里面进行一些配置第一个事情就是引入gulp// 我是 gulpfile.js 文件​// 1. 引入 gulpconst gulp = require('gulp')gulp是基于任务来完成构建的所以我们要创建一个打包css的任务// 我是 gulpfile.js 文件​// 1. 引入 gulpconst gulp = require('gulp')​​// 2. 创建一个 css 的任务// gulp.task() 是用来创建任务的// 参数一: 任务名称// 参数二: 一个函数(这个任务要做什么事情)gulp.task('css', function () { })有了任务以后,我们就要在css这个任务里面写一些这个任务要做的事情了我们要把./src/css/所有css文件都进行压缩处理这个时候我们自己完成不了,就需要借助一个第三方依赖npm i -D gulp-cssmin下载完毕以后,去文件中进行配置// 我是 gulpfile.js 文件​// 1. 引入 gulpconst gulp = require('gulp')​// 2. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')​​// 2. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') // 对哪些文件进行操作 .pipe(cssmin()) // 都做什么,这里做的就是进行 css 压缩 .pipe(gulp.dest('./dist/css')) // 把压缩完毕的文件放在 dist 文件夹下的 css 文件夹 })gulp.src()是指找到那些文件对其操作gulp.pipe()是指要做什么gulp.dest()是指输出到哪个目录下,如果没有这个目录存在会自动创建这个目录所以上面哪个css任务的意思就是把./src/css/目录下的所有文件进行压缩压缩完毕后放在./dist/下的css/文件夹下接下来,就是执行一下这个叫做css的任务就行了直接在控制台使用指令 表示运行 gulpfils.js 配置文件中的 css 任务 $ gulp css 执行完毕以后,就会在gulp_demo目录下生成一个dist/文件夹里面就有我们压缩好的css文件自动添加前缀我们希望在css压缩之前,能帮我自动把需要前缀的属性自动把前缀添加上就好了这个是可以做到的我们又需要一个依赖了npm i -D gulp-autoprefixer安装完还是去到文件中进行配置// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-1. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer') // 2. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) 因为添加前缀需要在压缩之前添加所以我们就直接在任务里面多做一个事情就行了打包 SASS 文件接下来我们解决一下sass的问题因为有的时候我们开发要使用sass所以我们要解决一下sass的问题其实打包sass和css差不多,只不过先要把sass解析成css.把sass解析成css.自动添加前缀.压缩一下.放到对应的文件夹中使用gulp解析sass文件需要用到一个依赖npm i -D gulp-sass然后我们就去到配置文件里面进行配置就好了// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-1. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-2. 引入 gulp-sassconst sass = require('gulp-sass') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) 我们的sass文件编译完以后也是css文件,所以就也放在css文件夹下就好了就是要注意一下别和本来css文件夹下的文件重名就好了然后就可以去命令行执行sass这个任务了 执行 sass 任务 $ gulp sass打包 JS 文件接下来就是打包一下js文件了其实套路是一样的先来做最简单的操作压缩一下js文件需要用到一个依赖npm i -D gulp-uglify 然后依旧是去到配置文件中进行配置// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) 然后我们去命令行执行js这个任务 执行 js 任务 $ gulp js 编译 ES6 语法之前我们学习es6的时候就说过很多浏览器不是很认识es6的语法我们要把他编译成es5的语法所以我们在打包js文件的时候,就要转换一下我们依旧是使用依赖来完成,只不过es6转es5需要三个依赖npm i -D gulp-babel@7.0.1npm i -D babel-corenpm i -D babel-preset-es2015 然后我们就去配置文件里面进行配置就可以了// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) 引入以后,只要在压缩之前执行一下转码就可以了注意要传递一个参数然后再次执行js任务就可以了 执行 js 任务$ gulp js 打包 HTML 文件接下来就要把html文件解决一下了还是一个套路压缩html文件需要一个依赖npm i -D gulp-htmlmin 下载好以后去到配置文件中进行配置// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) 这样就配置完毕了接下来就是去命令行运行一下html任务 运行 html 任务 $ gulp html 处理 LIB 和 STATIC 文件接下来我们就是处理lib和static里面的文件了因为这些都是第三方的文件和一些图片之类的信息不需要压缩处理,只要给我转到dist文件夹下就可以了所以不需要依赖,直接处理就行// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) // 5. 创建一个 lib 任务gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) // 6. 创建一个 static 任务gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) 接下来就是去命令行执行lib任务和static任务 执行 lib 任务 $ gulp lib​ 执行 static 任务 $gulp static批量执行任务我们的几个和文件相关的任务都配置完毕了但是我们不能在开发过程中一个任务一个任务的去执行不方便也不是很只能所以我们要统一执行任务这个时候就需要进行一个配置,让几个任务一起执行一下这个不需要依赖,我们只需要配置一个叫做default的任务gulp在运行的时候会默认执行default任务// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) // 5. 创建一个 lib 任务gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) // 6. 创建一个 static 任务gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) // 7. 配置一个默认任务gulp.task('default', ['css', 'sass', 'js', 'html', 'lib', 'static'])这样配置完毕以后,当你运行gulp的时候,会自动执行default任务然后default任务就会把后面数组中写的几个任务并行执行了接下来就是去命令行里面运行gulp 运行 gulp,会默认执行 default 任务 $ gulp清除 DIST 文件夹当你在编译的时候,如果第一次编译有一个叫做a.css的文件,他会帮你编译后来你把a.css文件改名字了,改叫b.css,再次进行编译的时候会给你新生成一个b.css文件在dist文件夹中之前的a.css文件也不会消失那么这样就不是很好了我们比较好的做法是在执行所有的编译之前先把dist文件夹删除掉然后再执行所有的编译操作这样就不会用多余的文件留下了这个时候我们就要使用一个依赖npm i -D gulp-clean然后去配置文件里面配置一个任务// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin')// 5. 引入 gulp-cleanconst clean = require('gulp-clean') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) // 5. 创建一个 lib 任务gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) // 6. 创建一个 static 任务gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) // 8. 创建一个 clean 任务gulp.task('clean', function () { return gulp .src('./dist') .pipe(clean())}) // 7. 配置一个默认任务gulp.task('default', ['css', 'sass', 'js', 'html', 'lib', 'static'])接下来我们执行任务的时候就应该先执行clean任务,再执行default任务 执行 clean 任务 $ gulp clean​ 执行 default 任务 $ gulp按顺序执行任务因为每次打包都要执行一个clean任务那么我们就可以把clean任务也加到default任务的队列里面执行gulp.task('default', ['clean', css', 'sass', 'js', 'html', 'lib', 'static']) 这样我们运行的时候,每次就都会帮我们执行clean任务了但是会出现一个问题因为后面队列里面的任务是并行的那么有的时间长有的时间短那么就会出现有一些文件已经压缩完毕放在dist/文件夹里面了然后clean任务执行完毕的时候又给直接清除掉了这样不是很好我们就需要让这些任务出现先后顺序先执行一下clean任务clean执行完毕以后,剩下的几个压缩文件的任务可以并行执行这个时候我们就需要用到一个依赖npm i -D run-sequence这个依赖是逐步执行任务的一个包这个时候我们修改一下default任务就好了// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin')// 5. 引入 gulp-cleanconst clean = require('gulp-clean')// 6. 引入 run-sequenceconst runSequence = require('run-sequence') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) // 5. 创建一个 lib 任务gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) // 6. 创建一个 static 任务gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) // 8. 创建一个 clean 任务gulp.task('clean', function () { return gulp .src('./dist') .pipe(clean())}) // 7. 改写 default 任务gulp.task('default', function () { // 里面的每一个参数都可以是一个任务或者一个任务队列 // 再执行任务的时候,会把前一个任务队列完成的情况下再执行下一个任务队列 runSequence('clean', ['css', 'sass', 'js', 'html', 'lib', 'static'])}) 这样依赖,每次都是先执行clean任务执行完毕之后再并行执行那些压缩的任务就不会出现问题了然后我们就去命令行中运行gulp执行一下default任务就可以了 运行 gulp $ gulp自动打开浏览器我们的打包工作已经完成了接下来要是能再打包完毕自动帮我把浏览器打开就好了省的我自己去开了这个时候是可以做到的需要一个依赖npm i -D gulp-webserver然后进行配置// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin')// 5. 引入 gulp-cleanconst clean = require('gulp-clean')// 6. 引入 run-sequenceconst runSequence = require('run-sequence')// 7. 引入 gulp-webserverconst webserver = require('gulp-webserver') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) // 5. 创建一个 lib 任务gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) // 6. 创建一个 static 任务gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) // 8. 创建一个 clean 任务gulp.task('clean', function () { return gulp .src('./dist') .pipe(clean())}) // 9. 创建一个 webserver 任务gulp.task('webserver', function () { return gulp .src('./dist') .pipe(webserver({ host: 'localhost', // 配置打开浏览器的域名 port: 3000, // 配置打开浏览器的端口号 livereload: true, // 自动刷新浏览器 open: './pages/index.html' // 默认打开 dist 文件夹下的哪个文件 }))}) // 7. 改写 default 任务gulp.task('default', function () { // 里面的每一个参数都可以是一个任务或者一个任务队列 // 再执行任务的时候,会把前一个任务队列完成的情况下再执行下一个任务队列 runSequence( 'clean', ['css', 'sass', 'js', 'html', 'lib', 'static'], 'webserver')}) 因为我们打开浏览器应该再所有压缩任务都完成以后再把浏览器打开所以我们把他排在任务的第三个队列上这个webserver会自动帮我们启动一个服务器是一个node的服务器所以我们的页面也相当于是在服务器上打开的修改内容自动刷新我们刚才再配置webserver的时候有一个自动刷新的功能被我们开启了但是我们修改一些文件的时候发现并没有自动刷新这个是因为,我们只是开启了自动刷新,但是你修改文件以后并没有自动帮我们重新编译那么dist/文件夹下的内容就不会更改,那么刷新就没有意义所以我们应该再制作一个任务,当文件夹下的内容修改的时候,自动帮我们从新编译这个不需要任何依赖,我们只需要配置一个监控文件改变的任务就行了// 我是 gulpfile.js 文件// 1. 引入 gulpconst gulp = require('gulp')// 2-1. 引入 gulp-cssminconst cssmin = require('gulp-cssmin')// 2-2. 引入 gulp-autoprefixer const autoPrefixer = require('gulp-autoprefixer')// 2-3. 引入 gulp-sassconst sass = require('gulp-sass')// 3-1. 引入 gulp-uglifyconst uglify = require('gulp-urlify')// 3-2. 引入 gulp-babel// es6 转 es5 虽然需要下载三个依赖,但是只需要引入一个 gulp-babel 就可以了const babel = require('gulp-babel')// 4. 引入 gulp-htmlminconst htmlmin = require('gulp-htmlmin')// 5. 引入 gulp-cleanconst clean = require('gulp-clean')// 6. 引入 run-sequenceconst runSequence = require('run-sequence')// 7. 引入 gulp-webserverconst webserver = require('gulp-webserver') // 2-1. 创建一个 css 的任务gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) // 2-2. 创建一个 sass 任务gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) // 3. 创建一个 js 任务gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) // 4. 创建一个 html 任务gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, // 移出所有空属性 collapseWhitespace: true // 压缩 html })) .pipe(gulp.dest('./dist/pages'))}) // 5. 创建一个 lib 任务gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) // 6. 创建一个 static 任务gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) // 8. 创建一个 clean 任务gulp.task('clean', function () { return gulp .src('./dist') .pipe(clean())}) // 9. 创建一个 webserver 任务gulp.task('webserver', function () { return gulp .src('./dist') .pipe(webserver({ host: 'localhost', // 配置打开浏览器的域名 port: 3000, // 配置打开浏览器的端口号 livereload: true, // 自动刷新浏览器 open: './pages/index.html' // 默认打开 dist 文件加下的哪个文件 }))}) // 10. 创建一个 watch 任务gulp.task('watch', function () { gulp.watch('./src/css/**', ['css']) gulp.watch('./src/sass/**', ['sass']) gulp.watch('./src/js/**', ['js']) gulp.watch('./src/pages/**', ['html']) gulp.watch('./src/lib/**', ['lib']) gulp.watch('./src/static/**', ['static'])}) // 7. 改写 default 任务gulp.task('default', function () { // 里面的每一个参数都可以是一个任务或者一个任务队列 // 再执行任务的时候,会把前一个任务队列完成的情况下再执行下一个任务队列 runSequence( 'clean', ['css', 'sass', 'js', 'html', 'lib', 'static'], ['webserver', 'watch'])}) 因为再文件压缩完毕以后,我们就可以开始监控了所以把这个watch任务和webserver任务并行就可以了接下来我们就可以再命令行运行gulp了、 运行 gulp $ gulp这个时候,我们只要进行代码书写就可以了随着我们写完,会自动帮我们打包编译,并且自动进行浏览器刷新的使用 GULP 配置代理我们的gulp自动打包构建已经完成了我们的正常开发已经可以进行下去了我们就剩最后一个功能没有实现了那就是跨域请求的问题因为我们的项目中肯定有一些数据是向后台请求过来的那么我们就要发送请求我们又不能保重服务端接口和我们是同源的所以我们就要配置一个代理gulp给我们启动的这个服务器是node的服务器所以也可以直接配置代理不需要任何依赖,只要再webserver任务中多加一个配置就可以了gulp.task('webserver', function () { return gulp .src('./dist') .pipe(webserver({ host: 'localhost', port: 3000, livereload: true, open: './pages/index.html', proxies: [ // 配置所有代理 { // 其中一个代理配置 source: '/login', // 使用的关键字 target: 'http://localhost:80/login.php' // 代理的路径 } ] }))}) 这个时候你就可以正常发送请求了当你要请求代理地址的时候,只要再这里配置一下,使用代理关键字进行请求就可以了GULP完整配置文件(简单版)所有需要用到的依赖.gulp@3.9.1.gulp-cssmin.gulp-autoprefixer.gulp-sass.gulp-uglify.gulp-babel@7.0.1.babel-core.babel-preset-es2015.gulp-htmlmin.gulp-clean.run-sequence.gulp-webservergulpfile.js文件内容// 我是 gulpfile.js 文件const gulp = require('gulp')const cssmin = require('gulp-cssmin')const autoPrefixer = require('gulp-autoprefixer')const sass = require('gulp-sass')const uglify = require('gulp-urlify')const babel = require('gulp-babel')const htmlmin = require('gulp-htmlmin')const clean = require('gulp-clean')const runSequence = require('run-sequence')const webserver = require('gulp-webserver')gulp.task('css', function () { return gulp .src('./src/css/**') .pipe(autoPrefixer({ browsers: ['last 2 versions'] })) .pipe(cssmin()) .pipe(gulp.dest('./dist/css')) }) gulp.task('sass', function () { return gulp .src('./src/sass/**') .pipe(sass()) .pipe(autoPrefixer()) .pipe(cssmin()) .pipe(gulp.dest('./dist/css'))}) gulp.task('js', function () { return gulp .src('./src/js/**') .pipe(babel({ presets: ['es2015'] })) .pipe(uglify()) .pipe(gulp.dest('./dist/js'))}) gulp.task('html', function () { return gulp .src('./src/pages/**') .pipe(htmlmin({ removeEmptyAttibutes: true, collapseWhitespace: true })) .pipe(gulp.dest('./dist/pages'))}) gulp.task('lib', function () { return gulp .src('./src/lib/**') .pipe(gulp.dest('./dist/lib'))}) gulp.task('static', function () { return gulp .src('./src/static/**') .pipe(gulp.dest('./dist/static'))}) gulp.task('clean', function () { return gulp .src('./dist') .pipe(clean())}) gulp.task('webserver', function () { return gulp .src('./dist') .pipe(webserver({ host: 'localhost', port: 3000, livereload: true, open: './pages/index.html', proxies: [ { source: '/login', target: 'http://localhost:80/login.php' } ] }))}) gulp.task('watch', function () { gulp.watch('./src/css/**', ['css']) gulp.watch('./src/sass/**', ['sass']) gulp.watch('./src/js/**', ['js']) gulp.watch('./src/pages/**', ['html']) gulp.watch('./src/lib/**', ['lib']) gulp.watch('./src/static/**', ['static'])}) gulp.task('default', function () { runSequence( 'clean', ['css', 'sass', 'js', 'html', 'lib', 'static'], ['webserver', 'watch'])})


优秀的个人博客,低调大师

Java程序员学习资料—Git Flow

在Java程序开发中的定制开发规范,想要把项目正规高效的跑起来。引入 Git 版本控制,Git-Flow 便成为了首选。今天动力节点Java学院来带你了解一下。一、为什么使用 git-flow当在团队开发中使用版本控制系统时,商定一个统一的工作流程是至关重要的。Git的确可以在各个方面做很多事情,然而,如果在你的团队中还没有能形成一个特定有效的工作流程,那么混乱就将是不可避免的。基本套路:你可以定义一个完全适合你自己项目的工作流程,或者使用一个别人定义好的。二、安装 git-flow我们使用Homebrew来安装git-flow:1.brew install git-flow之后,通过git-flow来初始化项目:1.git flow init这时候就会有一些配置的操作,先默认操作:1.Initialized empty Git repository in /Users/jartto/Documents/git-flow-demo/.git/2.No branches exist yet. Base branches must be created now.3.Branch name for production releases: [master]4.Branch name for "next release" development: [develop]5.6.* Please tell me who you are.7.8.Run9. git config --global user.email "you@example.com" git config --global user.name "Your Name"12. 13.to set your account's default identity.14.Omit --global to set the identity only in this repository.15.16.fatal: unable to auto-detect email address (got 'jartto@bogon.(none)')17.fatal: Not a valid object name: 'master'.18.error: pathspec 'develop' did not match any file(s) known to git.19.20.How to name your supporting branch prefixes?21.Feature branches? [feature/]22.Release branches? [release/]23.Hotfix branches? [hotfix/]24.Support branches? [support/]25.Version tag prefix? []需要强调一点:git-flow 只是封装了 git 的命令。所以在我们初始化的时候,对仓库并没有其他改动,只是创建了几个分支。当然,如果你不想继续使用git-flow,那么只需要简单的停用git-flow的命令即可,不需要修改或者删除任何文件。为了验证一下,我们看下目前的分支,执行:1.git branch输出:1.* develop master很简单,develop分支是我们日常开发的分支,会有很多改动。而master主要针对线上分支,下面会细说。 这里补充一点,我们可以通过 help 命令来查看用例。1.git flow help输出如下:1.usage: git flow 2.3.Available subcommands are: init Initialize a new git repo with support for the branching model. feature Manage your feature branches. release Manage your release branches. hotfix Manage your hotfix branches. support Manage your support branches. version Shows version information.10. 11.Try 'git flow help' for details.如果我要看feature相关命令呢?1.git flow feature help使用规范就会列出来:1.usage: git flow feature [list] [-v] git flow feature start [-F] [] git flow feature finish [-rFk] git flow feature publish git flow feature track git flow feature diff [] git flow feature rebase [-i] [] git flow feature checkout [] git flow feature pull []三、分支模式 git-flow模式会预设两个主分支在仓库中: 1.master只能用来包含产品代码 我们不能直接工作在这个master分支上,而是在其他指定的,独立的特性分支中。不直接提交改动到 master 分支上也是很多工作流程的一个共同的规则。2.develop是你进行任何新的开发的基础分支 当你开始一个新的功能分支时,它将是开发的基础。另外,该分支也汇集所有已经完成的功能,并等待被整合到master分支中。 上面说到的这两个分支被称作为长期分支,它们会存活在项目的整个生命周期中。而其他的分支,例如针对功能的分支,针对发行的分支,仅仅只是临时存在的。它们是根据需要来创建的,当它们完成了自己的任务之后就会被删除掉。 四、明确分支功能1.master分支 最为稳定功能比较完整的随时可发布的代码,即代码开发完成,经过测试,没有明显的bug,才能合并到master中。请注意永远不要在master分支上直接开发和提交代码,以确保master上的代码一直可用;2.develop分支 用作平时开发的主分支,并一直存在,永远是功能最新最全的分支,包含所有要发布 到下一个release的代码,主要用于合并其他分支,比如feature分支; 如果修改代码,新建feature分支修改完再合并到develop分支。所有的feature、release分支都是从develop分支上拉的。3.feature分支 这个分支主要是用来开发新的功能,一旦开发完成,通过测试没问题,我们合并回develop分支进入下一个release。4.release分支 用于发布准备的专门分支。当开发进行到一定程度,或者说快到了既定的发布日,可以发布时,建立一个release分支并指定版本号(可以在finish的时候添加)。开发人员可以对release分支上的代码进行集中测试和修改bug。(这个测试,测试新功能与已有的功能是否有冲突,兼容性)全部完成经过测试没有问题后,将release分支上的代码合并到master分支和develop分支。5.hotfix分支 用于修复线上代码的bug。从master分支上拉。完成hotfix后,打上tag我们合并回master和develop分支。需要注意:所有开发分支从develop分支拉。所有hotfix分支从master拉。所有在master上的提交都必要要有tag,方便回滚。只要有合并到master分支的操作,都需要和develop分支合并下,保证同步。master和develop分支是主要分支,主要分支每种类型只能有一个,派生分支每个类型可以同时存在多个。五、关于 Feature 分支在Git-flow中,通过使用Feature分支,使得我们在同一时间开发多个分支更加简单。 我们接到了一个Test1需求,使用feature start来启动:git flow feature start test1当我们开始一个新的feature开发后:1.Switched to a new branch 'feature/test1'2.3.Summary of actions:4.- A new branch 'feature/test1' was created, based on 'develop'5.- You are now on branch 'feature/test1'6.7.Now, start committing on your feature. When done, use:8. git flow feature finish test1我们自动切到了feature/test1分支下,正好开始我们的开发,建一个文件先: 1.vi main.js写入console.log('hello jartto');接着提交我们的变更:1.git add .2.git commit -m 'feat: add console.log'好了,现在我们开发完了,结束 feature 开发:1.git flow feature finish test1控制台输出了:1.Switched to branch 'develop'2.Updating d975789..27e920c3.Fast-forward4.main.js | 1 +5.1 file changed, 1 insertion(+)6.create mode 100644 main.js7.Deleted branch feature/test1 (was 27e920c).8.9.Summary of actions:10.- The feature branch 'feature/test1' was merged into 'develop'11.- Feature branch 'feature/test1' has been removed12.- You are now on branch 'develop'这里做了几件事情: 1.将feature/test1分支合并到了develop分支; 2.删除了feature/test1; 3.切换到develop分支;需要注意:git-flow使用的命令是:1.git merge —no-ff feature/test1这样,在我们移除feature分支之前,是不会丢失任何历史记录的。如果你还不了解--no-ff相关知识,可以先看看:Git merge 的 –ff 和 –no-ff。接着,我们看一下变更记录:1.git log --oneline输出:1.27e920c (HEAD -> develop) feat: add console.log2.d975789 (master) Initial commit六、release 分支-版本发布当我们开发完毕,需要去发布新版本的时候,我们可以使用:1.git flow release start 0.1.0控制台会有一些提示:1.Switched to a new branch 'release/0.1.0'2.3.Summary of actions:4.- A new branch 'release/0.1.0' was created, based on 'develop'5.- You are now on branch 'release/0.1.0'6.7.Follow-up actions:8.- Bump the version number now!9.- Start committing last-minute fixes in preparing your release10.- When done, run:11. git flow release finish '0.1.0'很清晰,我们简单说一下: 1.基于develop分支新建了release/0.1.0分支; 2.切换至release/0.1.0分支; 又出现了新问题: 1.这是什么意思:Bumpthe version number now!2.last-minute fixes又是什么意思?那接下来我们要做什么呢?不着急,按照提示一步步来。我们修改了代码,进行add,和 commit 之后,执行:1.git flow release finish 0.1.0这个过程中间可能出现异常:1.fatal: no tag message?2.Tagging failed. Please run finish again to retry.输出:1.Switched to branch 'develop'2.Merge made by the 'recursive' strategy.3.test.js | 04.1 file changed, 0 insertions(+), 0 deletions(-)5.create mode 100644 test.js6.Deleted branch release/0.1.0 (was 0426707).7.8.Summary of actions:9.- Latest objects have been fetched from 'origin'10.- Release branch has been merged into 'master'11.- The release was tagged '0.1.0'12.- Release branch has been back-merged into 'develop'13.- Release branch 'release/0.1.0' has been deleted这里主要有几个操作: 1.首先,git-flow会拉取远程仓库,以确保目前是最新的版本。 2.然后,release的内容会被合并到master和develop两个分支中去,这样不仅产品代码为最新的版本,而且新的功能分支也将基于最新代码。 3.为便于识别和做历史参考,release提交会被标记上这个release的Tag。 4.清理操作,版本分支会被删除,并且回到develop。七、Hotfix 线上代码如果线上代码有问题,这时候你需要紧急修复呢?我们可以使用git flow hotfix:1.git flow hotfix start jartto看一下执行了什么:1.Switched to a new branch 'hotfix/jartto'2.3.Summary of actions:4.- A new branch 'hotfix/jartto' was created, based on 'master'5.- You are now on branch 'hotfix/jartto'6.7.Follow-up actions:8.- Bump the version number now!9.- Start committing your hot fixes10.- When done, run:11. git flow hotfix finish 'jartto'接着我们新建了目录: 1.mkdir assets放入一张图片,修改完毕,提交并结束hotfix:1.git add .2.git commit -m 'fix: assets img'3.git flow hotfix finish 'jartto'看一下git-flow有哪些操作:1.Switched to branch 'master'2.Merge made by the 'recursive' strategy.3.assets/git-flow.png | Bin 0 -> 25839 bytes4.1 files changed, 0 insertions(+), 0 deletions(-)5.create mode 100644 assets/git-flow.png6.Switched to branch 'develop'7.Merge made by the 'recursive' strategy.8.assets/git-flow.png | Bin 0 -> 25839 bytes9.1 files changed, 0 insertions(+), 0 deletions(-)10.create mode 100644 assets/git-flow.png11.Deleted branch hotfix/jartto (was a734849).12.13.Summary of actions:14.- Latest objects have been fetched from 'origin'15.- Hotfix branch has been merged into 'master'16.- The hotfix was tagged 'jartto'17.- Hotfix branch has been back-merged into 'develop'18.- Hotfix branch 'hotfix/jartto' has been deleted查看一下目前的Tag情况:1.git tag正是我们上面添加的两个标签:1.0.1.02.jartto总结一下: 1.完成的改动会被合并到master中,同样也会合并到develop分支中,这样就可以确保这个错误不会再次出现在下一个release中。 2.这个hotfix程序将被标记起来以便于参考。 3.这个hotfix分支将被删除,然后切换到develop分支上去。八、git-flow 流程图示恭喜你,到这里你已经完成了git-flow的基本流程。为了更加整体的理解工作流,我们来看看下面这张流程图:Java清清楚楚,是不是和我们上面的过程一模一样。九、参考动力节点Java架构师班深度剖析Java底层原理,热门技术深入探讨,前沿技术深入解读,大项目实战重构,从0到1做架构,从全局思维出发,带你把控大型项目中别人忽略的重要细节节点,站在巨人肩膀上学习架构师,带你领会架构师不一样的视野

优秀的个人博客,低调大师

程序员笔记|详解Eureka 缓存机制

引言 Eureka是Netflix开源的、用于实现服务注册和发现的服务。Spring Cloud Eureka基于Eureka进行二次封装,增加了更人性化的UI,使用更为方便。但是由于Eureka本身存在较多缓存,服务状态更新滞后,最常见的状况是:服务下线后状态没有及时更新,服务消费者调用到已下线的服务导致请求失败。本文基于Spring Cloud Eureka 1.4.4.RELEASE,在默认region和zone的前提下,介绍Eureka的缓存机制。 一、AP特性 从CAP理论看,Eureka是一个AP系统,优先保证可用性(A)和分区容错性(P),不保证强一致性(C),只保证最终一致性,因此在架构中设计了较多缓存。 <center>Eureka高可用架构</center> 二、服务状态 Eureka服务状态enum类:com.netflix.appinfo.InstanceInfo.InstanceStatus 状态 说明 状态 说明 UP 在线 OUT_OF_SERVICE 失效 DOWN 下线 UNKNOWN 未知 STARTING 正在启动 三、Eureka Server 在Eureka高可用架构中,Eureka Server也可以作为Client向其他server注册,多节点相互注册组成Eureka集群,集群间相互视为peer。Eureka Client向Server注册、续约、更新状态时,接受节点更新自己的服务注册信息后,逐个同步至其他peer节点。 **【注意】**如果server-A向server-B节点单向注册,则server-A视server-B为peer节点,server-A接受的数据会同步给server-B,但server-B接受的数据不会同步给server-A。 3.1 缓存机制 Eureka Server存在三个变量:(registry、readWriteCacheMap、readOnlyCacheMap)保存服务注册信息,默认情况下定时任务每30s将readWriteCacheMap同步至readOnlyCacheMap,每60s清理超过90s未续约的节点,Eureka Client每30s从readOnlyCacheMap更新服务注册信息,而UI则从registry更新服务注册信息。 <center>![](./缓存机制.png)</center> 三级缓存 缓存 类型 说明 registry ConcurrentHashMap 实时更新,类AbstractInstanceRegistry成员变量,UI端请求的是这里的服务注册信息 readWriteCacheMap Guava Cache/LoadingCache 实时更新,类ResponseCacheImpl成员变量,缓存时间180秒 readOnlyCacheMap ConcurrentHashMap 周期更新,类ResponseCacheImpl成员变量,默认每30s从readWriteCacheMap更新,Eureka client默认从这里更新服务注册信息,可配置直接从readWriteCacheMap更新 缓存相关配置 配置 默认 说明 eureka.server.useReadOnlyResponseCache true Client从readOnlyCacheMap更新数据,false则跳过readOnlyCacheMap直接从readWriteCacheMap更新 eureka.server.responsecCacheUpdateIntervalMs 30000 readWriteCacheMap更新至readOnlyCacheMap周期,默认30s eureka.server.evictionIntervalTimerInMs 60000 清理未续约节点(evict)周期,默认60s eureka.instance.leaseExpirationDurationInSeconds 90 清理未续约节点超时时间,默认90s 关键类 类名 说明 com.netflix.eureka.registry.AbstractInstanceRegistry 保存服务注册信息,持有registry和responseCache成员变量 com.netflix.eureka.registry.ResponseCacheImpl 持有readWriteCacheMap和readOnlyCacheMap成员变量 四、Eureka Client Eureka Client存在两种角色:服务提供者和服务消费者,作为服务消费者一般配合Ribbon或Feign(Feign内部使用Ribbon)使用。Eureka Client启动后,作为服务提供者立即向Server注册,默认情况下每30s续约(renew);作为服务消费者立即向Server全量更新服务注册信息,默认情况下每30s增量更新服务注册信息;Ribbon延时1s向Client获取使用的服务注册信息,默认每30s更新使用的服务注册信息,只保存状态为UP的服务。 二级缓存 缓存 类型 说明 localRegionApps AtomicReference 周期更新,类DiscoveryClient成员变量,Eureka Client保存服务注册信息,启动后立即向Server全量更新,默认每30s增量更新 upServerListZoneMap ConcurrentHashMap 周期更新,类LoadBalancerStats成员变量,Ribbon保存使用且状态为UP的服务注册信息,启动后延时1s向Client更新,默认每30s更新 缓存相关配置 配置 默认 说明 eureka.instance.leaseRenewalIntervalInSeconds 30 Eureka Client 续约周期,默认30s eureka.client.registryFetchIntervalSeconds 30 Eureka Client 增量更新周期,默认30s(正常情况下增量更新,超时或与Server端不一致等情况则全量更新) ribbon.ServerListRefreshInterval 30000 Ribbon 更新周期,默认30s 关键类 类名 说明 com.netflix.discovery.DiscoveryClient Eureka Client 负责注册、续约和更新,方法initScheduledTasks()分别初始化续约和更新定时任务 com.netflix.loadbalancer.PollingServerListUpdater Ribbon 更新使用的服务注册信息,start初始化更新定时任务 com.netflix.loadbalancer.LoadBalancerStats Ribbon,保存使用且状态为UP的服务注册信息 五、默认配置下服务消费者最长感知时间 Eureka Client 时间 说明 上线 30(readOnly)+30(Client)+30(Ribbon)=90s readWrite -> readOnly -> Client -> Ribbon 各30s 正常下线 30(readonly)+30(Client)+30(Ribbon)=90s 服务正常下线(kill或kill -15杀死进程)会给进程善后机会,DiscoveryClient.shutdown()将向Server更新自身状态为DOWN,然后发送DELETE请求注销自己,registry和readWriteCacheMap实时更新,故UI将不再显示该服务实例 非正常下线 30+60(evict)*2+30+30+30= 240s 服务非正常下线(kill -9杀死进程或进程崩溃)不会触发DiscoveryClient.shutdown()方法,Eureka Server将依赖每60s清理超过90s未续约服务从registry和readWriteCacheMap中删除该服务实例 考虑如下情况 0s时服务未通知Eureka Client直接下线; 29s时第一次过期检查evict未超过90s; 89s时第二次过期检查evict未超过90s; 149s时第三次过期检查evict未续约时间超过了90s,故将该服务实例从registry和readWriteCacheMap中删除; 179s时定时任务从readWriteCacheMap更新至readOnlyCacheMap; 209s时Eureka Client从Eureka Server的readOnlyCacheMap更新; 239s时Ribbon从Eureka Client更新。 因此,极限情况下服务消费者最长感知时间将无限趋近240s。 <center>![](./最长感知时间.png)</center> 六、应对措施 服务注册中心在选择使用Eureka时说明已经接受了其优先保证可用性(A)和分区容错性(P)、不保证强一致性(C)的特点。如果需要优先保证强一致性(C),则应该考虑使用ZooKeeper等CP系统作为服务注册中心。分布式系统中一般配置多节点,单个节点服务上线的状态更新滞后并没有什么影响,这里主要考虑服务下线后状态更新滞后的应对措施。 6.1 Eureka Server 1.缩短readOnlyCacheMap更新周期。缩短该定时任务周期可减少滞后时间。 eureka.server.responsecCacheUpdateIntervalMs: 10000 # Eureka Server readOnlyCacheMap更新周期 2.关闭readOnlyCacheMap。中小型系统可以考虑该方案,Eureka Client直接从readWriteCacheMap更新服务注册信息。 eureka.server.useReadOnlyResponseCache: false # 是否使用readOnlyCacheMap 6.2 Eureka Client 1.服务消费者使用容错机制。如Spring Cloud Retry和Hystrix,Ribbon、Feign、Zuul都可以配置Retry,服务消费者访问某个已下线节点时一般报ConnectTimeout,这时可以通过Retry机制重试下一个节点。 2.服务消费者缩短更新周期。Eureka Client和Ribbon二级缓存影响状态更新,缩短这两个定时任务周期可减少滞后时间,例如配置: eureka.client.registryFetchIntervalSeconds: 5 # Eureka Client更新周期 ribbon.ServerListRefreshInterval: 2000 # Ribbon更新周期 3.服务提供者保证服务正常下线。服务下线时使用kill或kill -15命令,避免使用kill -9命令,kill或kill -15命令杀死进程时将触发Eureka Client的shutdown()方法,主动删除Server的registry和readWriteCacheMap中的注册信息,不必依赖Server的evict清除。 4.服务提供者延迟下线。服务下线之前先调用接口使Eureka Server中保存的服务状态为DOWN或OUT_OF_SERVICE后再下线,二者时间差根据缓存机制和配置决定,比如默认情况下调用接口后延迟90s再下线服务即可保证服务消费者不会调用已下线服务实例。 七、网关实现服务下线实时感知 在软件工程中,没有一个问题是中间层解决不了的,而网关是服务提供者和服务消费者的中间层。以Spring Cloud Zuul网关为例,网关作为Eureka Client保存了服务注册信息,服务消费者通过网关将请求转发给服务提供者,只需要做到服务提供者下线时通知网关在自己保存的服务列表中使该服务失效。为了保持网关的独立性,可实现一个独立服务接收下线通知并协调网关集群。下篇文章将详细介绍网关如何实现服务下线实时感知,敬请期待! 作者:冯永彪 内容来源:宜信技术学院

优秀的个人博客,低调大师

程序员随想-快速熟悉业务

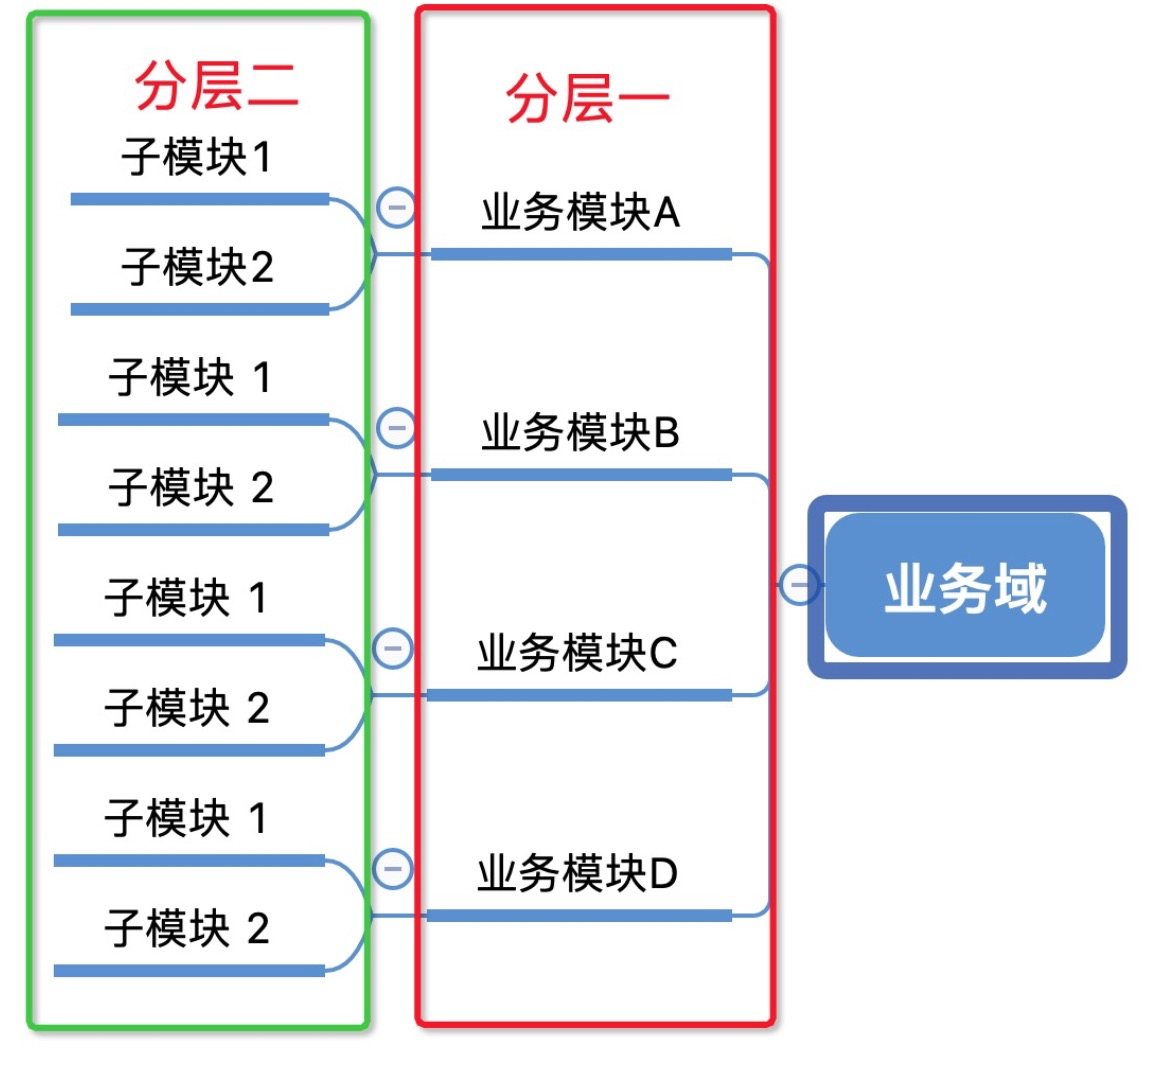
前言 作为一名开发,经常面临着主动或被动切换业务做,有些时候切换至有一定相关联的另一个业务,本来做余额宝的被调到做证券。一些情况下是切换至完全相关的业务,如从商品切换到交易,甚至从电商业务切换至金融业务。在经常遇到这种的情况下,建立一个“快速熟悉陌生业务”的方法论就很重要了。下面经过个人思考,提出的一些不完善的想法。 一、划分模块 人的记忆和关系型数据库有些类型,较容易记住的大的关键点,而具体的细节可能想很久,甚至记不住。根据人的这种记忆方式,我们接触一个新的事务最好的方式应该就是分层,按照一定逻辑分几层,每层分多个模块,了解每层各个模块概念,然后再细分下一层子模块概念。这种思维方式有点像数据库的索引,符合人的思维习惯。 划分模块方式 模块是基于一定逻辑组织形式来划分的,只要按照逻辑来划分的话,划分模块的方式肯定有很多种,这里我提两种最容易的方式:业务功能,应用架构。 业务功能 按照业务功能性,对业务进行拆解,把复杂的业务进行拆分成功能单元,各功能单元再根据场景进行更细粒度的拆分。拆分有一个原则,要做到高内聚,低耦合。 应用架构 基本上应用都是分层的,下图就是最常见的应用的组织形式,当然很多应用组织形式会根据具体情况进行变化 二、梳理业务领域模型 对于大部分人结束新的业务的时候,相信最麻烦的就是周围人谈论的“专业词汇”,像之前听得什么,直销、代销,转托管,卡账,户帐这类词汇对于第一次听到人肯定蒙蔽。对于这一类词汇其实很多都是特定业务领域形成的简化术语,如果连这些业务领域内的概念的不清楚,那么根本不知道在讨论一个什么事。这类词汇存在于特定业务领域中,了解业务领域是相当重要的,统一大家的概念认知,统一大家在讨论的是一件什么事,在做的是一件什么事!! 所以我说的要了解业务领域,并不是指得DDD,充血、贫血模型。而是对业务进行一定抽象成一个或多个有关联的业务模型,对于这个模型有一定认知是需求讨论和方案设计的前提,很多时候某个业务域用到了其他业务域的模型,那么相对于相关联业务域的模型也要有一定认知。 如何梳理业务领域模型? 业务领域模型最底层的是数据库表极其字段,把表和表之间的关系,字段含义理清楚后,会有大概的业务轮廓。接着通过熟悉模块中核心的POJO的类极其字段能更对业务有更清晰一点的认知。当然这还不够,还需要花时间去看一些集团,网上的文章,关于其他人对业务的理解,其他人在技术如何设计和实现的。这个过程不是一蹴而就的,慢慢的会找到更深的理解,等到了能发现当前这个业务领域模型优点缺点,并构思出改进的方向,基本上就意味已经进入这块业务领域的专家了。 三、梳理业务调用链路 寻找业务入口,然后看代码。一般来说业务代码迭代很快,很多在写代码的时候没有考虑以后,经常被之后的需求给推翻调,亦或者经历过多个团队多人接手过,每个人命名、设计等等习惯不一样,所以这个过程比较痛苦。 如何梳理业务调用链路? 这里必须要提一下,traceId是个神器,自己实际操作一笔拿到traceId,在集团鹰眼或者蚂蚁云图上应用的调用链路基本上呼之欲出,但是具体逻辑细节还是要自己去看代码。这里看代码我理解两种模式,一种是自下而上,另一种是自上而下。我比较喜欢自上而下的看,这样顺着业务链路来理解比较简单,大部分情况下两者结合效果比较好。 自上而下 前后端不分离的PC页面,顺着页面实际操作入口去看,很简单 前后端分离的PC页面、Ajax接口、无线端,和前端同学打好关系,多聊聊,喝喝咖啡,让前端同学帮忙去找入口,另外就是通过网络抓包找到调用入口,顺着代码往下看吧,少年。通过日志里面的traceId可以查到调用链路甚至到接口级别,这就更方便找到入口。一般情况下相同功能模块、对外的接口会放在一个大包或者pom模块下面。 自下而上 从数据库表入手,理解表模型,各字段含义,建立各表和字段之间的关系。 四、需求入手 一般情况下,公司不太会给太多空闲时间去看代码,且直接看代码多数情况下也没有那么直观感受,这时候结合一些比较完整的需求去搞,效果反而会更好。所谓完整的需求是指:尽量是完整模块的需求,或者能串联部分或整个链路的需求。切身体验零散的需求没有鸟用。

优秀的个人博客,低调大师

Java程序员致命的误区:“努力”

努力的所有目的和意义都在于提升认知。这是非常重要的一个观点,深入理解这个概念,就可以解决职场中70%以上的问题。 在职场中,通常会遇到的情况是:“我也很努力呀,为什么升职不是我呢?”“在我们组里,我的加班也很多,为什么加薪的不是我”,诸如此类的问题,最重要的原因在于对努力认识的不够所导致的。 大家更倾向于将“努力”笼统的认为:用尽全力的去做事情,或者就是用来描述一种状态,从而却忽略了“努力”更深层次的含义,那就是提升认知。在不能深刻理解这一观点的情况下,“努力”就丧失了其宝贵的内涵。 如何正确的理解“努力” 1、单纯的消耗精力并不是“努力” 我们通常情况下,会把流程性的繁琐的事情当成努力;把工作时间的延长当成努力,这是一个误区,在这样的环境下,无论你付出多少时间,体力和脑力都不能让我们有所提升,很大程度上仅仅是持续的消耗而已,无助于个体的成长和进步。 不幸的是,包括笔者在内,我们绝大多数的付出仅就是消耗,在不能深入理解努力的意义时,我们很难跳出这个怪圈。 2、只有精进和挑战才能关联到“努力” 只有在挑战一项自己并不擅长的工作或项目的时候,才能提到“努力”这个概念,正是因为这件事情在某种程度上超越了舒适完成的能力,或者远远超越自身资源的时候,才会有用尽全力的概念。 因此,一个重要的观点就是,当你觉得自己很努力了,那么就要反问自己是否在挑战一个超越自己常规能力的事情。如果是,那么这件事情从提升自身能力上是有意义的,至少已经超越了单纯消耗的误区。 3、“努力”不是你想就可以的 持续的努力的是不容易的,怎么理解这个观点。我们可以在一两件自己认为比较有挑战的事情上付出并达成,但是却很难在一个方向或领域中持续的努力。 原因在于你需要在这个领域要有前瞻性,要对自己和自身所处领域有深刻的理解,只有这样才能在一个方向上不断的挑战新的项目。也就是你需要在一个方向上不断的提出好的问题,同时再通过自己的努力解决问题。 这就是职场上的最核心问题,我们通常能够在1-2件事情上付出辛劳,却不能在一个方向上持续的挑战和努力的原因。最后,不自觉的将常规工作和不必要的加班当成“努力”,产生努力得不到认可的错觉。 4、没有认知提升的“努力”终究毫无意义 换一句话来说,如果你“努力”完成后,在重新复盘这件事情的时候,突然发现原来之前的自己好笨啊,竟然这么简单的事情也要花费这么多的精力。如果你有这样的感觉,那么恭喜你,这才是找到努力的真正意义。 在所努力的事件完成后,应该伴随你的就是这样的认知提升,如果没有这样的感觉,那就要不断的警醒自己是不是又陷入了无止境的消耗。 总结 我们通常会给自己加戏,从而让自己产生“好辛苦”的错觉,这样的“努力”是无意义的。真正的努力通常伴随着明显的认知提升,总会伴随着恍然大悟的感觉,总是能够不同程度的优化效率,总是能体会到一览众山小的意境。 认知是每个人都无法冲破的枷锁,人一生所有的成就都在提升认知中获得的,正因如此,努力才有意义。 学习也是如此,盲目的努力一年不如有认知的努力一个月 下面就给大家推荐一份集 点.线.面.于一体的Java架构进阶思维导图,大家可以自行按照里面的顺序学习,也可以加入Java填坑之路:860113481获取大牛直播教学地址以及免费视频学习资料电子书学习资料,悄悄告诉你们都是免费的喔! 一.架构筑基篇 深入内核,直击故障,拒绝蒙圈 二.开源框架解析篇 站在巨人肩膀,收获不一样的视野 三.高性能架构篇 成为互联网架构师,你要的都在这里 四.微服务架构篇 你还不知道微服务?那怎么加(zhuang)薪(bi) 五.团队协作开发篇 让你的团队开发效率提高十倍 六.B2C商城项目实战 撸起袖子干实事,项目经验那点事 以上六大专题都是目前最主流的技术,有兴趣学习的可以加入Java填坑之路:860113481获取免费学习以上技术点的地址以及完整版高清架构进阶思维导图和视频学习资料电子书学习资料。每一个知识点都是从点到线到面全面讲解底层原理让你对每一个知识点都有一个新的认知,小伙伴们赶紧行动起来吧!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册