首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10005篇文章
优秀的个人博客,低调大师

前端学习路线

第一步 安装开发工具:sublime(文本编辑器)、webstorm(JS IDE)、Visual Studio Code(web代码编辑器),Hbuilder(我比较喜欢用的国产IDE)。 HTML:理解如何浏览和创建网页、基本的语法规范、常用的标签及属性(包括HTML5新增的标签及属性,如块级标签等)、网页之间的链接和跳转(三种方式:a标签、link标签、form表单)、标签节点和层级节点。 CSS:基本语法和三种书写位置(行内CSS、内部CSS、外部CSS)、选择器(标签选择器、id选择器、类选择器)和格式化排版(利用块级元素以及定位属性进行排版)、盒模型的高级用法(padding、margin以及元素大小)、常用布局模型(流动模型、浮动模型、层模型)。 JS:基础语法以及变量(所有变量都用var定义)、数据类型和数据类型转换、条件判断(if、switch)、循环语句(while、for)、函数(函数的定义方式、js的内置函数)、数组和集合等js的内置对象。 第二步 DOM(文档对象模型)+BOM(浏览器对象模型):DOM的基本结构(父子关系、兄弟关系)、节点对象操作(getElementByName、getElementById等)、事件的特性及使用(change、click、blur等)、常见的DOM内置对象(alert、confirm等)、常见的BOM功能(open、close等)。 网页特效与进阶:在网页特效中常用的编程接口(onFocus、onSelect等)、动画编程(onload、hover等)、事件对象和冒泡(useCapture)、缓动框架封装(参考:https://www.cnblogs.com/yongshaoye/p/7102644.html)和旋转木马案例(参考:https://www.cnblogs.com/forlina/p/4313065.html)、正则表达式及其应用。 Jquery:选择器、基本操作API(中文API网址:https://www.jquery123.com/)、插件机制(jQuery.extend():扩展对象方法)、原理分析(参考:https://blog.csdn.net/liupc123123/article/details/2661 4337)。 第三步 HTML5+CSS3:语义化结构、多媒体、本地存储(HTML5连接本地数据库)、常见API(HTML5:http://www.dcloud.io/docs/api/index.html、CSS3:http://phpstudy.php.cn/css3/)、CSS3选择器(参考:http://www.w3school.com.cn/cssref/css_selectors.asp)、CSS3边框、背景、阴影、CSS3过渡和动画(参考:https://blog.csdn.net/XIAOZHUXMEN/article/details/52003135)、CSS3伸缩布局(参考:https://www.cnblogs.com/fxycm/p/4649648.html)、Canvas(画布元素)。 服务端编程:端的概念、web服务器的概念、服务器搭建(参考:https://www.cnblogs.com/W-Kr/p/5455862.html)、XML与json。 PHP:PHP基础语法(参考:http://www.w3school.com.cn/php/php_syntax.asp)、PHP服务端编程基础(参考:https://www.cnblogs.com/hope666/p/6919487.html)。 AJAX:基本编程接口(参考:https://blog.csdn.net/u013279840/article/details/52786348)、异步数据交互(参考:https://blog.csdn.net/bug_money/article/details/54645396)、模板引擎的使用(参考:https://www.cnblogs.com/sw1990/p/5851377.html)。 借鉴:https://www.cnblogs.com/chengjian-physique/p/8076356.html

优秀的个人博客,低调大师

Java底层学习

最近在看几本Java的书,也做了很多笔记,主要是关于Java虚拟机、Java GC、Java 并发编程等方面,参考的主要几本书籍有: 《深入理解Java虚拟机》——周志明 《深入理解Java虚拟机 第二版》——美 Bill Venners 《Java性能调优指南》——也是老美的 《Java高并发程序设计》——葛一鸣 本来想自己把这些书的pdf传上来的,可惜已经有人上传了,大家自己去找资源吧 当然在写作过程中也参考了很多大神的文章,下面给几个链接,大家也可以看看: 【Java成神之路】—-死磕Java系列博客 《成神之路系列文章》 JVM调优总结 等全部写完,我就写个目录方便大家查看

优秀的个人博客,低调大师

Storm学习总结

分享的目的 让大家更加深入了解Storm的架构以及运用JStorm之类的流式计算框架解决业务开发过程中遇到的问题能够有所帮助 分享大纲 Storm介绍和系统架构Storm核心类Storm trident框架Storm重要参数 Storm介绍和系统架构 1. Twitter将Storm正式开源了,这是一个分布式的、容错的实时计算系统 2. Storm为分布式实时计算提供了一组通用原语,可被用于“流处理”之中,实时处理消息并更新数据 3. Storm可以方便地在一个计算机集群中编写与扩展复杂的实时计算,Storm用于实时处理。Storm保证每个消息都会得到处理,而且它非常快,在一个小集群中,每秒可以处理数以百万计的消息 4. 开发者可以使用任意编程语言来做开发 主要特点: 1. 简单的编程模型 类似于MapReduce降低了并行批处理复杂性,Storm降低了进行实时处理的复杂性; 2. 容错性 Storm会管理工作进程和节点的故障; 3.水平扩展 计算是在多个线程、进程和服务器之间并行进行的; 4.可靠的消息处理 Storm保证每个消息至少能得到一次完整处理。任务失败时,它会负责从消息源重试消息, 如何判断一条消息是否处理成功或失败,通过异或来判断; 5.快速 系统的设计保证了消息能得到快速的处理,使用ØMQ作为其底层消息队列storm系统架构图 Storm 名词 1.Nimbus 任务的中央调度器(相当于Yarn中 ResourceManager) 2.Supervisor worker的代理, 负责管理Worker的生命周期(相当于Yarn中NodeManager, AppMaster) 3.Stream 被处理的数据 4.Spout 数据源(Map或Reduce) 5.Bolt 处理数据(Map或Reduce) 6.Task 运行于Spout或Bolt中的线程(Container) 7.Executor worker进程中的线程,默认情况下,一个executor对应一个task 8.Worker 运行Task线程的进程(容器) 9.Tuple 流数据 10.Stream Grouping 定义了Bolt接收什么东西作为输入数据 11.Topology Stream Grouping连接起来的Spout和Bolt节点网络 Storm数据流—Tuple 1. Tuple(元组)是Storm最主要的数据结构,一个元组就是一个命名的值列表,其中的每一个值可以是任何类型; 2. Tuple(元组)都是动态类型——字段的类型不需要提前被声明; 3. Tuple(元组)有一些方法像getInteger 和getString之类 得到字段的值的方法,而不需要强制转换结果类型(和JDBC的ResultSet非常类似); Storm 的容错 工作进程worker 失效: 如果一个节点的工作进程worker死掉,supervisor 进程会尝试重启该worker。如果连续重启worker 失败或者worker 不能定期向Nimbus 报告心跳,Nimbus 会分配该任务到集群其他的节点上执行; 集群节点失效: 如果集群中某个节点失效,分配给该节点的所有任务会因超时而失败,Nimbus 会将分配给该节点的所有任务重新分配给集群中的其他节点; Nimbus 或者supervisor 守护进程失败: Nimbus 和supervisor 都被设计成快速失败(遇到未知错误时迅速自我失败)和无状态的(所有的状态信息都保存在Zookeeper 上或者是磁盘上)。Nimbus 和supervisor 守护进程必须在一些监控工具(例如,daemontools 或者monitor)的辅助下运行,一旦Nimbus 或者supervisor 失败,可以立刻重启它们,整个集群就好像什么事情也没发生。最重要的是,没有工作进程worker 会因为Nimbus 或supervisor 的失败而受到影响,Storm 的这个特性和Hadoop 形成了鲜明的对比,在Hadoop中如果JobTracker 失效,所有的任务都会失败; Nimbus 所在的节点失效: 如果Nimbus 守护进程驻留的节点失败,工作节点上的工作进程worker 会继续执行计算任务,如果worker 进程失败,supervisor 进程会在该节点上重启失败的worker 任务。但是,没有Nimbus的影响时,所有worker 任务不会分配到其他的工作节点机器上,即使该worker所在的机器失效; storm异步并发运行模式 在前面提到task、executor、worker、node,这四者的关系如下: 一个node上可以启动多个worker进程 一个work进程上可以执行多个executor线程3.一个executor上可以执行1个或多个task, 即bolt或spout实例,默认情况下一个executor对应一个task 这就是Storm并发运行的模式,可以在创建topology的时候设置node, work 、executor和task的并发度模型, 下面拿单词统计程序来详细说明。 默认并发度 运行的并发模型如下: 调整并发度 Tuple消息分组路由机制 Storm定义了7种内置数据流分组方式,分别是: 1. Shuffle Grouping(随机分组): 随机分发tuple给bolt的各个task,每个bolt接收到相同数量的tuple,代码中是用shuffleGrouping这个方法; 2. Fields Grouping(按字段分组): 根据给定的字段进行分组。比如说一个数据流根据word字段进行分组,所有具有相同的word字段值的tuple会路由到同一个bolt中(用得最多),代码中是用fieldsGrouping这个方法; 3. All Grouping(广播发送): 将所有tuples复制后分发给所有bolt task,这样每个订阅数据流的task都会收到tuple的一个copy,代码中是用allGrouping这个方法; 4. Global Grouping(全局分组): 将所有tuples路由到唯一的一个task上,Storm按照最小的task ID来选取接收数据的task,代码中是用globalGrouping这个方法; 5. Non Grouping(不分组): Shuffle Grouping 是一样的效果,有一点不同的是Storm 会把这个Bolt 放到此Bolt 的订阅者同一个线程里面去执行,代码中是用noneGrouping这个方法; 6. Direct Grouping(指向型分组): 这种分组意味着消息的发送者指定由消息接收者的哪个Task 处理这个消息。只有被声明为Direct Stream 的消息流可以声明这种分组方法。而且这种消息tuple 必须使用emitDirect 方法来发送,代码中是用directGrouping这个方法; 7.Local or shuffle grouping(本地或随机分组): 和随机分组类似,但是会将tuple分发给同一个worker内的bolt task。其它情况下,采用随机分组的方式,这取决于topology的并发度,本地或随机分组可以减少网络人传输,从而且提高topology的性能,代码中是用localOrShuffleGrouping这个方法; 自定义分组路由 可以通过实现CustomStreamGrouping的接口来自定义分组方式:prepare()会在运行时间调用, 用来初始化分组信息,分组的个体实现会在这些信息决定如何向接收task分发tuple.chooseTasks()方法返回一个tuple发送目标的task的标识符列表,它的两个参数是发送tuple的组件的id和tuple的值. Storm核心类 1.BaseRichSpout 重写nextTuple、declareOutputFields、 open、ack、 fail方法open : 一般是初始化SpoutOutputCollector对象nextTuple : 从数据源接受数据,并向下游的bolt发射数据流declareOutputFields : 声明发射数据的输出字段ack : 成功的处理fail : 失败的处理 2.BaseRichBolt 重写execute 、declareOutputFields、 prepare、 cleanup方法prepare:一般是初始化SpoutOutputCollector对象declareOutputFields :声明发射数据的输出字段execute : 处理数据,并向下游发送tuplecleanup : 清除工作 3.TopologyBuilder 通过setSpout、setBolt构建topology Storm trident框架 Storm Trident的数据模型 Storm Trident的核心数据模型是小批量去处理流数据(相当于Spark Stream组件),流分区在集群的节点上,对流的操作也是并行的在每个分区上进行; 官方的描述是: Trident is an alternative interface to Storm. Tuples are processed as small batches(小批量). It provides exactly-once processing (刚好一次的处理), “transactional" datastore persistence(事物的持久化), and a set of common stream analytics operations.)。Trident对事物处理方案如下: 1. 一批数据被分配指定一个唯的id 称作为“transaction id”. 如果一批数据被重复处理,将会得到是同 一个transaction id(唯一、幂等); 2. 在各批数据之中,状态更新是保序的,例如:批次3的状态更新不会在批次2状态更新成功之前(保序); Storm trident数据流 Trident数据流是分批次的,如下图所示,而普通bolt或spout数据流是一个接一个连续的, trident数据每一批的大小,取决输入数据量的大小 Trident API Trident有五种对流的操作的API: 1.不需要网络传输的本地批次运算,每个分区(partion)的运算是互相独立的 Functions Filters partitionAggregate stateQuery and partitionPersist projection 2.需要网络传输的重分布操作,不改变数据的内容; shuffle broadcast partitionBy global batchGlobal partition 3. 聚合操作,网络传输是该操作的一部分 aggregate 4. 流分组(groupby)操作 groupby 5. 合并和关联操作 merge join 一个Trident topology完整的示例 示例中包含:filterfunctiongroupbypersistentAggregate filter function projection 投影操作是对数据上进行列裁剪用法:如果你有一个流有【“a”,“b”,“c”,“d”】四个字段,执行下面的代码:mystream.project(new Fields("b","d"))输出流将只有【“b”,“d”】两个字段 Repartition(重分区) 重分区操作是通过一个函数改变元组(tuple)在task之间的分布。也可以调整分区数量(比如,如果并发的hint在repartition之后变大)重分区(repatition)需要网络传输,以下是重分区函数: 1. shuffle: 使用随机算法在目标分区中选一个分区发送数据;用法: inputStream.shuffle(); 2. broadcast: 每个元组重复的发送到所有的目标分区。这个在DRPC中很有用。如果你想做在每个分区上做一个statequery;用法: inputStream.broadcast(); 3.paritionBy: 根据一系列分发字段(fields)做一个语义的分区。通过对这些字段取hash值并对目标分区数取模获取目标分区。paritionBy保证相同的分发字段(fields)分发到相同的目标分区;用法: inputStream.partitionBy(new Fields("event", "city")); 4.global: 所有的tuple分发到相同的分区。这个分区所有的批次相同;用法: inputStream.global(); 5.batchGobal: 本批次的所有tuple发送到相同的分区,不通批次可以在不通的分区;用法: inputStream.batchGlobal(); 6.patition: 这个函数接受用户自定义的分区函数,很少用。用户自定义函数事项 backtype.storm.grouping.CustomStreamGrouping接口; 用法: inputStream.partition(grouping); Aggregation(聚合) 1. Trident有aggregate和persistentAggregate函数对流做聚合, aggregate在每个批次上独立运行;persistentAggregate聚合流的所有的批次并将结果存储下来,然后现在一个流上做全局的聚合 2. 如果使用reducerAggregator或者aggretator,这个流先被分成一个分区,然后聚合函数在这个分区上运行。 3. 如果使用CombinerAggreator,Trident会在每个分区上做一个局部的汇总,然后重分区聚合到一个分区,在网络传输结束后完成聚合。CombinerAggreator非常有效,在尽可能的情况下多使用.下面是一个做批次内聚合的例子:mystream.aggregate(new Count(), new Fields("count"))和partitionAggregate一样,聚合的aggregate也可以串联。如果将CombinerAggreator和非CombinerAggreator串联,trident就不能做局部汇总的优化。 Trident流分组操作 1. groupBy操作根据特殊的字段对流进行重分区,分组字段相同的元组(tuple)被分到同一个分区,如果对分组的流进行聚合,聚合会对每个组聚合而不是这个批次聚合。(和关系型数据库的groupby相同). 2 persistentAggregate也可以在分组的流上运行,这种情况下结果将会存储在MapState里面,key是分组字段,和普通聚合一样,分组流的聚合也可以串联。 Trident—merge和join 合并: 将不同的流合并,最简单的方式就是合并(meger)多个流成为一个流, 用法如下:topology.merge(stream1, stream2, stream3);Trident合并的流字段会以第一个流的字段命名 关联: 类似SQL的join都是对固定输入的。而流的输入是不固定的,所以不能按照sql的方法做join。Trident中的join只会在spout发出的每个批次见进行,下面是个join的例子: 一个流包含字段【“key”,“val1” ,“val2”】,另一个流包含字段【“x”,“val1”】:topology.join(stream1, new Fields("key"), stream2, new Fields("x"), new Fields("key","a","b","c"));Stream1的“key”和stream2的“x”关联。Trident要求所有的字段要被名字,因为原来的名字将会会覆盖。Join的输入会包含:1.首先是join字段。例子中stream1中的“key”对应stream2中的“x”。2.接下来,会吧非join字段依次列出来,排列顺序按照传给join的顺序。例子中” a”,” b”对应stream1中 的“val1”和“val2”,“c”对应stream2中的“val1”。 注意:当join的流分别来自不同的spout,这些spout会同步发射的批次,也就是说,批次处理会包含每 个spout发射的tuple。 partitionAggregate 有三种不同的聚合接口:CombinerAggreator,ReduceAggregator和Aggregator Aggregator(聚合器) CombinerAggregator CombinerAggregator用来将一个集合的tuple组合到一个单独的字段中,Storm 对每一个tuple调用init方法,然后重复调用combine()方法直到一个分片的数据处理完成为止。传递给combine方法的两个参数是局部聚合的结果,以及调用了init()返回的值。Storm将tuple生成的值进行组合之后,Storm发送组合结果作为一个新的字段,如果分片是空的,Storm会发送zero()方法执行的返回。 ReducerAggregator Storm调用init()方法来获取原始值。然后为分片中每一个tuple调用reduce()方法,直到分片的数据处理完成。第一个参数是局部聚合的结果,这个方法需要将第二个参数tuple合并到局部聚合结果中并返回。 Aggregator Aggregators能发射任何类型和任何字段的tuple, 在执行期间,他能发射任何tuple,执行的方式如下:在处理一批数据之前,就调用init(), init()方法的返回值对象代表aggregation的state, 并且会传递到aggregate和complete方法中去;针对一批数据中的每一个tuple,都会调用aggregator方法,这个方法能够更新state和选择性的发射tuple流;当一批数据处理完成的时候,就会调用complete方法; 编程中三种聚合器的选择 共同点:都可以实现一些简单、复杂的计数、统计功能、在partitionAggregate操作方法上性能、功能都差不多; 区别: CombinerAggregator: 比较灵活,每一个tuple的初始值都可以根据实际情况灵活设置,适合流的 aggregate操作,此时trident会有自动优化机制(在网络传输之前就会做局转换合并) ReducerAggregator: 最容易使用, 初始值可以根据实际情况灵活设置,适合比较简单处理的场景 Aggregator: 最灵活, 批次的初始值可以灵活设置, 常用在多次统计处理,一次发射的场景 要求:学会用三种Aggregator实现各自的计数功能, Trident State Trident State有如下三个组件: StateFactory : 该接口定义了Trident用来建立持久state对象的方法; State : 该接口定义了beginCommit()和commit()方法,分别在Trident一批分区数据写到后端存储之前和之后调用。如果写入成功,意味着,所有的处理都没有报错,Trident会调用commit()方法; StateUpdater : 该接口定义了updateState()方法用来调用更新state,假定处理了一批tuple,Trident将三个参数传递给这个方法,需要更新的State对象,一个批次分区数据中TridentTuple对象的列表和TridentCollector实例用来视需要发送额外的tuple作为state更新的结果; Trident State事物 在Storm中,有三种类型的状态,每个类型的描述如下:在写Storm脚本的时候,这三种事物对应的MapState接口的实现,分别是: 重复事物型:TransactionalMap 不透明事物型:OpaqueMap 非事物型:NonTransactionalMap重复事物和不透明事物详细看附件 Trident事物和幂等性 StateUpdater 从数据流中的tuple更新状态(state)信息, updateState()调用的时机是在state对象的beginCommit()和commit()方法调用之间进行,接口定义如下: 使用的场景:主要是在Stream类的partitionPersist的各种方法中,主要的作用是允许topology从数据流中的tuple更新状态(state)信息,部分重载方法如下: StateQuery stateQuery方法从State实现类对象生成一个输入数据流, 操作示例如下: TridentTopology topology = new TridentTopology(); topology.newDRPCStream("words") .each(new Fields("args"), new Split(), new Fields("word")) .groupBy(new Fields("word")) .stateQuery(wordCounts, new Fields("word"), new MapGet(), new Fields("count")) .each(new Fields("count"), new FilterNull()) ; StateQueryProcessor核心源码如下:由上面的代码可以看出,在流在执行stateQuery方法的时候,针对每一批数据中的每一个tuple,都会执行QueryFunction实现类的execute方法 persistentAggregate persistentAggregate: 持久化聚合的的操作过程,它是GroupedStream类的 一个方法,它一般是用来在Stream对象通过groupby分组聚合操作之后生成的GroupedStream方法之后,在每个分片数据的每个分组上运行这方法,方法的各个参数,以及返回值如下: 1. 方法第一个参数传入的StateFactory对象生成的State对象,结合前面介绍的State三种事物中某一种事物来进行持久化操作操作处理,一般持久化操作需要实现IBackingMap这个接口,比例持久化到本地文件、Memcache、redis、HBase、LevelDB、HDFS、mysql等,通常在开发环境 下为了方便写入到一个Map中即可; 2. 方法的第二参数一般是一个Aggregator对象,在分片上执持persistentAggregate的时候,会去执行这个Aggregator对象的初始化方法、多次迭代方法、完成方法,比例ReducerAggregator对象,在这个分片上先执行ReducerAggregator的init方法,然后针对每一个tuple,执行ReducerAggregator的 reduce方法,直到完成; 3. 第三参数是由第二个参数聚合操作指定产生的新字段, 如Count聚合,一般会设置成count字段; 4. 返回值的类型是一个TridentState对象,一般情况下返回的TridentState对象会再生成一个新的Stream对象,继续往下游处理; partitionPersist partitionPersist : 是在一个在分区上进行持久化的操作方法,不需要网络通信, 它是Stream类的一个方法,在每个分片数据的每个分组上运行这方法,方法的各个参数,以及返回值如下: 1. 第一个参数是一个StateFactory类型,和persistentAggregate的第一个参数一样,功能也一样; 2. 第二个参数是输入的字段集合; 3. 第三个参数是一个StateUpdater实例, storm在一个数据分片上调用这个方法时,会在state对象的beginCommit和commit这两个方法之间会调用这个StateUpdater实例的updateState去更新状态 ,数据批次的状态是方法的第一个参数,该批次数据的集合是第二个参数, 第三个参数是一个TridentController控制器对象,方法调用的部分核心源码如下: 4. 第四个参数是一个方法操作的字段; Storm重要参数 worker.childopts: 默认情况下,Storm启动worker进程时,JVM的最大内存是768M,但是在线上环境中,由于会在Bolt中加载大量数据,768M内存无法满足需求,会导致内存溢出程序崩溃,可以通过在Strom的配置文件storm.yaml中设置worker的启动参数, 例如可以这样设置:"-Xmn1024m -Xms2048m -Xmx2048m -XX:+UseConcMarkSweepGC -XX:+UseCMSInitiatingOccupancyOnly" Supervisor.slots.ports: Storm的Slot,最好设置成OS核数的整数倍;同时由于Storm是基于内存的实时计算,Slot数不要大于每台物理机可运行Slot个数; storm.messaging.netty.buffer_size: 传输的buffer大小,默认1MB,当Spout发射的消息较大时,此处需要对应调整###storm.messaging.netty.max_retries:建议设置为3 storm.messaging.netty.max_wait_ms: 建议设置为10000; storm.messaging.netty.min_wait_ms: 建议设置为3000; Topology.acker.executors: 由于Acker基本消耗的资源较小,强烈建议将此参数设置在较低的水平, 建议设置为1; Topology.max.spout.pending: 一个SpoutTask中处于pending状态的最大的Tuple数量。该配置应用于单个Task,而不是整个Spout或Topology,可在Topology中进行覆盖, 通常情况下,建议设置为1024; Storm应用 1. 日志分析 2. 消息转化器 3. 实时统计分析 1. 阿里双11交易大屏 2. 腾讯网2015年 9.3阅兵在线人数实时统计(lamba架构) 3. 搜索引擎中热点词频 4.人工智能 5. NLP(语音合成处理,高德导航上林志玲的导航语言提示) 6. 股票实事趋势分析 7. 互联网风控 8. 广告推荐 推荐资料 Storm 官方文档 : http://storm.apache.org/ Storm分布式实时计算模式 Storm源码分析 问题 Storm是如何确定一条消息是否处理成功?原值和返回值进行异或计算,如下:

优秀的个人博客,低调大师

Hadoop学习路径

一、平台基础 1.1、大数据 了解什么是大数据,大数据入门,以及大数据介绍。 以及大数据中存在的问题,包括存储,计算的问题,有哪些解决策略。 1.2、Hadoop平台生态圈 熟悉了解开源Hadoop平台生态圈,以及第三方大数据平台,查找一些Hadoop入门介绍博客或者官网,了解: What’s Hadoop Why Hadoop exists How to Use Hadoop 1.3、Hadoop家族成员 Hadoop是一个庞大的家族,包含存储,计算等一系列产品组件,需要了解其中的一系列组件,包括HDFS,MapReduce,Yarn,Hive,HBase,ZooKeeper,Flume,Kafka,Sqoop,HUE,Phoenix,Impala,Pig,Oozie,Spark等,知道其干什么,维基百科定义。 1.4、HDFS 分布式存储HDFS,了解HDFS架构,HDFS的存储机制,各节点协作关系需理解清楚。 1.5、Yarn 分布式资源管理Yarn,熟悉Yarn架构,以及如何进行资源管理的机制。 1.6、MapReduce 分布式计算MapReduce,对MapReduce底层架构,处理方案进行了解,计算架构方案,了解MapReduce计算的优势,以及劣势。 1.7、HBase 大数据高效存储HBase,了解HBase底层架构,HBase的应用场景,存储方案。 1.8、Hive 大数据仓库Hive,了解Hive的存储机制,Hive的事务型变迁,Hive的应用场景,以及Hive底层计算。 1.9、Spark 内存计算平台Spark,熟悉Spark内存计算架构,计算流程,Spark的运行模式,以及应用场景。 二、平台进阶 2.1、HDFS 通过命令行操作HDFS,文件查看,上传,下载,修改文件,赋权限等。 通过java demo连接操作HDFS,实现文件读取,上传,下载功能。 通过DI工具,配置HDFS操作流程,实现关系型数据库文件到HDFS存储,HDFS文件保存到本地目录中。 2.2、MapReduce Eclipse绑定Hadoop环境,添加MapReduce Location,用eclipse运行MapReduce的经典实例WordCount,看其中原理,尝试修改为中文词汇统计,并排除不相关词汇。 2.3、Hive 通过命令行操作Hive,进行beeline连接,SQL语句操作Hive数据仓库。 通过java demo连接操作Hive,实现建表,插入数据,查询,删除数据记录,更新数据,删除表等操作。 通过DI工具,配置关系型数据库抽取到Hive事务表流程,不通过直接驱动连接Hive,通过HDFS以及Hive外表进行过度实现。 2.4、HBase 在命令行中访问操作使用HBase,建立列族,每列添加数据,修改更新数据查看变化。 通过java demo,用phoenix驱动,连接HBASE,实现对HBASE的建表,增删改查数据操作。 DI工具需要修改源码,或者添加phoenix组件,才能使用,因为phoenix插入语句不是Insert into,而是Upsert into,无法与DI工具匹配。 2.5、Spark 在命令行中,运行pyspark,以及spark shell,进行spark命令行操作,提交spark示例任务,进行试运行。 切换Spark运行模式,进行命令行尝试体验。 通过java demo连接Spark,进行任务的分发计算运行。 三、平台高级 针对上述组件,进行熟练使用,熟能生巧,举一反三,能够根据场景编写MapReduce代码,Spark代码等,针对Hive,HBase深入理解支持的SQL类型,存储过程,触发器等如何进行操作,能够根据需求设计最优的解决方案。 四、平台深度 深读组件源码,理解平台部署中各个配置的意义及影响,以及如何通过源码以及配置对组件进行优化,修改源码提高Hadoop平台的容错性,扩展性,稳定性等。

优秀的个人博客,低调大师

Python 学习(六)

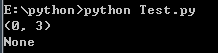
1. 正则表达式 re 模块使 Python 语言拥有全部的正则表达式功能。 1). re.match函数 re.match 尝试从字符串的起始位置匹配一个模式,如果不是起始位置匹配成功的话,match()就返回none。 函数语法: re.match(pattern, string, flags=0) 函数参数说明: pattern : 匹配的正则表达式 string : 要匹配的字符串 flags : 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等。 # 正则表达式 import re # 在起始位置开始匹配 print(re.match("www","www.baidu.com").span()) # 不在起始位置开始匹配 print(re.match("com","www.baidu.com")) 图1.png 2). 使用group(num) 或 groups() 匹配对象函数来获取匹配表达式。 group(num=0):匹配的整个表达式的字符串,group() 可以一次输入多个组号,在这种情况下它将返回一个包含那些组所对应值的元组 groups():返回一个包含所有小组字符串的元组,从 1 到 所含的小组号 # group import re # 字符串 line = "Cats are smarter than dogs" # 正则匹配 matchObj = re.match(r'(.*) are (.*?) .*', line, re.M|re.I) # 判断是否匹配成功 if matchObj: print("matchObj.group(): ", matchObj.group()) print("matchObj.group(1): ", matchObj.group(1)) print("matchObj.group(2): ", matchObj.group(2)) pass else: print("No match!") 打印结果: 图2.png 3). re.search方法 re.search 扫描整个字符串并返回第一个成功的匹配。 函数语法: re.search(pattern, string, flags=0) 函数参数说明: pattern : 匹配的正则表达式 string : 要匹配的字符串 flags : 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等 import re # 在起始位置匹配 print(re.search("www","www.baidu.com").span()) # 不在起始位置匹配 print(re.search("com","www.baidu.com").span()) 打印结果: 图3.png 我们可以使用group(num) 或 groups() 匹配对象函数来获取匹配表达式。 group(num=0):匹配的整个表达式的字符串,group() 可以一次输入多个组号,在这种情况下它将返回一个包含那些组所对应值的元组。 groups():返回一个包含所有小组字符串的元组,从 1 到 所含的小组号。 import re line = "Cats are smarter than dogs" searchObj = re.search(r"(.*) are (.*?) .*", line, re.M|re.I) if searchObj: print("searchObj.group(): ", searchObj.group()) print("searchObj.group(1): ", searchObj.group(1)) print("searchObj.group(2): ", searchObj.group(2)) pass else: print("Nothing found!") pass 打印结果: 图4.png 4). re.match与re.search的区别 re.match只匹配字符串的开始,如果字符串开始不符合正则表达式,则匹配失败,函数返回None;而re.search匹配整个字符串,直到找到一个匹配。 5). 检索和替换 Python 的re模块提供了re.sub用于替换字符串中的匹配项。 语法: re.sub(pattern, repl, string, count=0) 参数: pattern : 正则中的模式字符串。 repl : 替换的字符串,也可为一个函数。 string : 要被查找替换的原始字符串。 count : 模式匹配后替换的最大次数,默认 0 表示替换所有的匹配。 repl为字符串示例: import re phone = "2004-959-559 # 这个一个电话号码" # 删除注释 num = re.sub(r'#.*$', "", phone) print("电话号码:", num) # 移除非数字内容 num = re.sub(r'\D', "", phone) print("电话号码:", num) 打印结果: 图5.png repl为函数示例: # 将匹配的数字乘于2 def double(matched): value = int(matched.group('value')) return str(value*2) pass s = "A23G4HF56" print(re.sub("(?P<value>\d+)", double, s)) 打印结果: 图6.png 6). compile 函数 compile 函数用于编译正则表达式,生成一个正则表达式( Pattern )对象,供 match() 和 search() 这两个函数使用。 语法格式为: re.compile(pattern[, flags]) 参数: pattern : 一个字符串形式的正则表达式 flags 可选,表示匹配模式,比如忽略大小写,多行模式等,具体参数为: 1> re.I 忽略大小写 2> re.L 表示特殊字符集 \w, \W, \b, \B, \s, \S 依赖于当前环境 3> re.M 多行模式 4> re.S 即为' . '并且包括换行符在内的任意字符(' . '不包括换行符) 5> re.U 表示特殊字符集 \w, \W, \b, \B, \d, \D, \s, \S 依赖于 Unicode 字符属性数据库 6> re.X 为了增加可读性,忽略空格和' # '后面的注释 示例: import re # 用于匹配至少一个数字 pattern = re.compile(r'\d+') # 查找头部,没有匹配 m = pattern.match('one12twothree34four') # 打印 print(m) # 从‘e’的位置开始匹配,没有匹配 m = pattern.match('one12twothree34four', 2, 10) print(m) # 从‘1’的位置开始匹配,正好匹配 m = pattern.match('one12twothree34four', 3, 10) print(m) # group([group1, …]) 方法用于获得一个或多个分组匹配的字符串,当要获得整个匹配的子串时,可直接使用 group() 或 group(0); print(m.group(0)) # start([group]) 方法用于获取分组匹配的子串在整个字符串中的起始位置(子串第一个字符的索引),参数默认值为 0; print(m.start(0)) # end([group]) 方法用于获取分组匹配的子串在整个字符串中的结束位置(子串最后一个字符的索引+1),参数默认值为 0; print(m.end(0)) # span([group]) 方法返回 (start(group), end(group))。 print(m.span(0)) 打印结果: 图7.png 7). findall 在字符串中找到正则表达式所匹配的所有子串,并返回一个列表,如果没有找到匹配的,则返回空列表。注意: match 和 search 是匹配一次 findall 匹配所有。 语法格式为: findall(string[, pos[, endpos]]) 参数: string 待匹配的字符串。 pos 可选参数,指定字符串的起始位置,默认为 0。 endpos 可选参数,指定字符串的结束位置,默认为字符串的长度。 import re # 查找数字 pattern = re.compile(r'\d+') result1 = pattern.findall('runoob 123 google 456') result2 = pattern.findall('runoob123google456', 0, 10) print(result1) print(result2) 打印结果: 图8.png 8). finditer 和 findall 类似,在字符串中找到正则表达式所匹配的所有子串,并把它们作为一个迭代器返回。 re.finditer(pattern, string, flags=0) 参数: pattern : 匹配的正则表达式 string : 要匹配的字符串 flags : 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等 import re it = re.finditer(r"\d+","12a32bc43jf3") for match in it: print(match.group()) pass 打印结果: 图9.png 2. CGI(Common Gateway Interface) CGI(Common Gateway Interface),通用网关接口,它是一段程序,运行在服务器上如:HTTP服务器,提供同客户端HTML页面的接口。 1). 网页浏览 为了更好的了解CGI是如何工作的,我们可以从在网页上点击一个链接或URL的流程: 1、使用你的浏览器访问URL并连接到HTTP web 服务器。 2、Web服务器接收到请求信息后会解析URL,并查找访问的文件在服务器上是否存在,如果存在返回文件的内容,否则返回错误信息。 3、浏览器从服务器上接收信息,并显示接收的文件或者错误信息。 CGI程序可以是Python脚本,PERL脚本,SHELL脚本,C或者C++程序等。 2). CGI架构图 图10-CGI架构图 3). 程序 #!D:\java\python\python.exe import cgi form=cgi.FieldStorage() name=form.getvalue('name','world') print """Content-type:text/html <html> <head> <title>Greeting Page</title> </head> <body> <h1>Hello.%s!</h1> <form action='simple3.cgi'> Change name <input type='text' name='name'/> <input type='submit' /> </form> </body> </html> """%name

优秀的个人博客,低调大师

Python 学习(五)

1. 错误与异常 1). try语句按照如下方式工作; 首先,执行try子句(在关键字try和关键字except之间的语句);如果没有异常发生,忽略except子句,try子句执行后结束; 如果在执行try子句的过程中发生了异常,那么try子句余下的部分将被忽略。如果异常的类型和 except 之后的名称相符,那么对应的except子句将被执行。最后执行 try 语句之后的代码; 如果一个异常没有与任何的except匹配,那么这个异常将会传递给上层的try中;一个 try 语句可能包含多个except子句,分别来处理不同的特定的异常。最多只有一个分支会被执行; 处理程序将只针对对应的try子句中的异常进行处理,而不是其他的 try 的处理程序中的异常; 一个except子句可以同时处理多个异常,这些异常将被放在一个括号里成为一个元组,例如: except (RuntimeError, TypeError, NameError): pass 最后一个except子句可以忽略异常的名称,它将被当作通配符使用。你可以使用这种方法打印一个错误信息,然后再次把异常抛出。 示例: import sys try: f = open('myfile.txt') s = f.readline() i = int(s.strip()) pass except OSError as err: print("OS error: {0}".format(err)) except ValueError: print("Could not convert data to an integer") except: print("Unexpected error:", sys.exc_info()[0]) pass 打印结果: 图1.png 2). try except 语句还有一个可选的else子句,如果使用这个子句,那么必须放在所有的except子句之后。这个子句将在try子句没有发生任何异常的时候执行。 for arg in sys.argv[1:]: try: f = open(arg, 'r') except IOError: print('cannot open', arg) else: print(arg, 'has', len(f.readlines()), 'lines') f.close() 3). 抛出异常 raise 唯一的一个参数指定了要被抛出的异常。它必须是一个异常的实例或者是异常的类(也就是 Exception 的子类).如果你只想知道这是否抛出了一个异常,并不想去处理它,那么一个简单的 raise 语句就可以再次把它抛出。 try: raise NameError('HiThere') except NameError: print('An exception flew by!') raise 4). 用户自定义异常 通过创建一个新的exception类来拥有自己的异常。异常应该继承自 Exception 类,或者直接继承,或者间接继承 class MyError(Exception): def __init__(self, value): self.value = value def __str__(self): return repr(self.value) 5). 定义清理行为 try 语句还有另外一个可选的子句,它定义了无论在任何情况下都会执行的清理行为。 try: raise KeyboardInterrupt finally: print('Goodbye, world!') 6). 预定义的清理行为 一些对象定义了标准的清理行为,无论系统是否成功的使用了它,一旦不需要它了,那么这个标准的清理行为就会执行。 with open("myfile.txt") as f: for line in f: print(line, end="") 2. 面向对象技术简介 类(Class): 用来描述具有相同的属性和方法的对象的集合。它定义了该集合中每个对象所共有的属性和方法。对象是类的实例。 类变量:类变量在整个实例化的对象中是公用的。类变量定义在类中且在函数体之外。类变量通常不作为实例变量使用。 数据成员:类变量或者实例变量用于处理类及其实例对象的相关的数据。 方法重写:如果从父类继承的方法不能满足子类的需求,可以对其进行改写,这个过程叫方法的覆盖(override),也称为方法的重写。 实例变量:定义在方法中的变量,只作用于当前实例的类。 继承:即一个派生类(derived class)继承基类(base class)的字段和方法。继承也允许把一个派生类的对象作为一个基类对象对待。例如,有这样一个设计:一个Dog类型的对象派生自Animal类,这是模拟"是一个(is-a)"关系(例图,Dog是一个Animal)。 实例化:创建一个类的实例,类的具体对象。 方法:类中定义的函数。 对象:通过类定义的数据结构实例。对象包括两个数据成员(类变量和实例变量)和方法。 3. 类定义 语法格式如下: class ClassName: <statement-1> . . . <statement-N> 类实例化后,可以使用其属性,实际上,创建一个类之后,可以通过类名访问其属性。 4. 类对象 类对象支持两种操作:属性引用和实例化。属性引用使用和 Python 中所有的属性引用一样的标准语法:obj.name。类对象创建后,类命名空间中所有的命名都是有效属性名。 # 定义类 class MyClass(object): """一个简单的类实例""" i = 123 def f(self): return "Hello World!" pass # 实例化类 x = MyClass() # 访问类的属性和方法 print("MyClass 类的属性 i 为:", x.i) print("MyClass 类的方法 f 输出:", x.f()) 打印结果: 图2.png 5. 构造函数__init__() self代表类的实例,而非类,类的方法与普通的函数只有一个特别的区别——它们必须有一个额外的第一个参数名称, 按照惯例它的名称是 self。self 代表的是类的实例,代表当前对象的地址,而 self.class 则指向类。self 不是 python 关键字,我们把他换成 runoob 也是可以正常执行的: # 定义类 class Complex(object): """docstring for Comples""" def __init__(self, realpart, imagpart): super(Complex, self).__init__() self.r = realpart self.i = imagpart # 创建类 x = Complex(3.0, -2.4) print(x.r, x.i) 打印结果: 图3.png 6. 类的方法 在类地内部,使用 def 关键字来定义一个方法,与一般函数定义不同,类方法必须包含参数 self, 且为第一个参数,self 代表的是类的实例。 # 类定义 class people(object): """docstring for people""" # 定义基本属性 name = "" age = 0 # 定义私有属性, 私有属性在类外部无法直接访问 __weight = 0 # 定义构造方法 def __init__(self, name, age, weight): super(people, self).__init__() self.name = name self.age = age self.__weight = weight def speak(self): print("%s 说:我 %d 岁。" %(self.name, self.age)) pass # 实例化类 p = people("mazaiting", 24, 60) p.speak() 打印结果: 图4.png 7. 继承 Python 同样支持类的继承,如果一种语言不支持继承,类就没有什么意义。派生类的定义如下所示: class DerivedClassName(BaseClassName1): <statement-1> . . . <statement-N> 需要注意圆括号中基类的顺序,若是基类中有相同的方法名,而在子类使用时未指定,python从左至右搜索 即方法在子类中未找到时,从左到右查找基类中是否包含方法。 BaseClassName(示例中的基类名)必须与派生类定义在一个作用域内。除了类,还可以用表达式,基类定义在另一个模块中时这一点非常有用: class DerivedClassName(modname.BaseClassName): 示例: # 类定义 class people(object): """docstring for people""" # 定义基本属性 name = "" age = 0 # 定义私有属性, 私有属性在类外部无法直接访问 __weight = 0 # 定义构造方法 def __init__(self, name, age, weight): super(people, self).__init__() self.name = name self.age = age self.__weight = weight def speak(self): print("%s 说:我 %d 岁。" %(self.name, self.age)) pass # 单继承 class student(people): """docstring for student""" grade = "" def __init__(self, name, age, weight, grade): super(student, self).__init__(name, age, weight) self.grade = grade # 复写父类方法 def speak(self): print("%s 说:我 %d 岁了,我在读 %d年级" %(self.name, self.age, self.grade)) pass s = student("John", 12, 40, 6) s.speak() 打印结果: 图5.png 8. 多继承 Python同样有限的支持多继承形式。多继承的类定义形如下例: class DerivedClassName(Base1, Base2, Base3): <statement-1> . . . <statement-N> 需要注意圆括号中父类的顺序,若是父类中有相同的方法名,而在子类使用时未指定,python从左至右搜索 即方法在子类中未找到时,从左到右查找父类中是否包含方法。 # 类定义 class people(object): """docstring for people""" # 定义基本属性 name = "" age = 0 # 定义私有属性, 私有属性在类外部无法直接访问 __weight = 0 # 定义构造方法 def __init__(self, name, age, weight): super(people, self).__init__() self.name = name self.age = age self.__weight = weight def speak(self): print("%s 说:我 %d 岁。" %(self.name, self.age)) pass # 单继承 class student(people): """docstring for student""" grade = "" def __init__(self, name, age, weight, grade): super(student, self).__init__(name, age, weight) self.grade = grade # 复写父类方法 def speak(self): print("%s 说:我 %d 岁了,我在读 %d年级" %(self.name, self.age, self.grade)) pass # 演讲者类 class speaker(object): """docstring for speaker""" topic = "" name = "" def __init__(self, name, topic): # super(speaker, self).__init__() self.name = name self.topic = topic def speak(self): print("我叫%s, 我是一个演说家,我演讲的主题是%s"%(self.name, self.topic)) pass # 多重继承 class sample(speaker, student): """docstring for sample""" def __init__(self, name, age, weight, grade, topic): student.__init__(self, name, age, weight, grade) speaker.__init__(self, name, topic) test = sample("mazaiting", 24, 60, 6, "Python") # 方法名同, 调用的是在括号中排前的父类的方法 test.speak() 打印结果: 图6.png 9. 方法重写 如果你的父类方法的功能不能满足你的需求,你可以在子类重写你父类的方法 # 方法重写 # 定义父类 class Parent(object): """docstring for Parent""" def myMethod(self): print("调用父类方法") pass # 定义子类 class Child(object): """docstring for Child""" def myMethod(self): print("调用子类方法") pass # 子类实例 c = Child() # 子类调用重写方法 c.myMethod() 打印结果: 图7.png 10. 类属性与方法 类的私有属性 __private_attrs:两个下划线开头,声明该属性为私有,不能在类地外部被使用或直接访问。在类内部的方法中使用时 self.__private_attrs。 类的方法 在类地内部,使用 def 关键字来定义一个方法,与一般函数定义不同,类方法必须包含参数 self,且为第一个参数,self 代表的是类的实例。 self 的名字并不是规定死的,也可以使用 this,但是最好还是按照约定是用 self。 类的私有方法 __private_method:两个下划线开头,声明该方法为私有方法,只能在类的内部调用 ,不能在类地外部调用。self.__private_methods。 私有属性示例: # 定义类 class JustCounter(object): """docstring for JustCounter""" # 私有变量 __secretCount = 0 # 公开变量 publicCount = 0 def count(self): self.__secretCount += 1 self.publicCount += 1 print(self.__secretCount) pass counter = JustCounter() counter.count() counter.count() print(counter.publicCount) # 报错,实例不能访问私有变量 print(counter.__secretCount) 打印结果: 图8.png 私有方法示例: class Site(object): """docstring for Site""" def __init__(self, name, url): super(Site, self).__init__() # public self.name = name # private self.__url = url def who(self): print("name: ", self.name) print("url: ", self.__url) pass # 私有方法 def __foo(): print("这是私有方法") pass # 公共方法 def foo(self): print("这是公共方法") self.__foo() pass x = Site("百度", "www.baidu.com") x.who() x.foo() # 报错 x.__foo() 打印结果: 图9.png 11. 类的专有方法: init : 构造函数,在生成对象时调用 del : 析构函数,释放对象时使用 repr : 打印,转换 setitem : 按照索引赋值 getitem: 按照索引获取值 len: 获得长度 cmp: 比较运算 call: 函数调用 add: 加运算 sub: 减运算 mul: 乘运算 div: 除运算 mod: 求余运算 pow: 乘方 12. 运算符重载 Python同样支持运算符重载,我们可以对类的专有方法进行重载 # 运算符重载 class Vector(object): """docstring for Vector""" def __init__(self, a, b): super(Vector, self).__init__() self.a = a self.b = b def __str__(self): return "Vector (%d, %d)" % (self.a, self.b) pass def __add__(self, other): return Vector(self.a + other.a, self.b + other.b) pass v1 = Vector(2, 10) v2 = Vector(5, -2) print(v1 + v2) 打印结果: 图10.png

优秀的个人博客,低调大师

Python 学习(二)

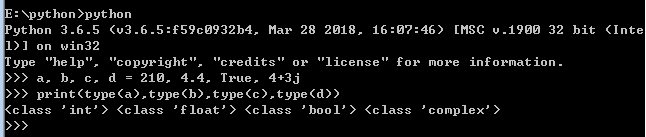
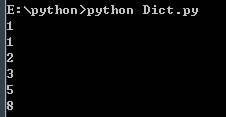
1. 数据类型 Python 中的变量不需要声明。每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建。在 Python 中,变量就是变量,它没有类型,我们所说的"类型"是变量所指的内存中对象的类型。等号(=)用来给变量赋值。等号(=)运算符左边是一个变量名,等号(=)运算符右边是存储在变量中的值。多变量赋值:a = b = c = 1 或者 a, b, c = 1, 2, "mazaiting" Python中六个标准数据类型:Number(数字)、String(字符串)、List(列表)、Tuple(元组)、Sets(集合)、Dictionary(字典) Number(数字) 1). 数字类型有四种 int、float、bool、complex(复数)。 示例1: >>> a, b, c, d = 210, 4.4, True, 4+3j >>> print(type(a),type(b),type(c),type(d)) 打印结果1: 图1.png 示例2: >>> a = 11 >>> isinstance(a,int) 图2.png 区别: type()不会认为子类是一种父类类型。 isinstance()会认为子类是一种父类类型。 2). 删除对象引用del var 注意: 1、Python可以同时为多个变量赋值,如a, b = 1, 2。 2、一个变量可以通过赋值指向不同类型的对象。 3、数值的除法(/)总是返回一个浮点数,要获取整数使用//操作符。 4、在混合计算时,Python会把整型转换成为浮点数。 String(字符串) Python中的字符串用单引号'或双引号"括起来,同时使用反斜杠\转义特殊字符。 str = 'Mazaiting' print (str) # 输出字符串 print (str[0:-1]) # 输出第一个到倒数第二个的所有字符 print (str[0]) # 输出字符串第一个字符 print (str[2:5]) # 输出从第三个开始到第五个的字符 print (str[2:]) # 输出从第三个开始的后的所有字符 print (str * 2) # 输出字符串两次 print (str + "TEST") # 连接字符串 注意 1、反斜杠可以用来转义,使用r可以让反斜杠不发生转义。 2、字符串可以用+运算符连接在一起,用*运算符重复。 3、Python中的字符串有两种索引方式,从左往右以0开始,从右往左以-1开始。 4、Python中的字符串不能改变。 List(列表) 列表可以完成大多数集合类的数据结构实现。列表中元素的类型可以不相同,它支持数字,字符串甚至可以包含列表(所谓嵌套)。列表是写在方括号([])之间、用逗号分隔开的元素列表。和字符串一样,列表同样可以被索引和截取,列表被截取后返回一个包含所需元素的新列表。 示例1: # 列表数据 list = ['abcd', 784, 2.234, 'mazaiting', 20.2] # 短列表 tinylist = [234, 'zaitingma'] # 输出完整列表 print(list) # 输出列表第一个元素 print(list[0]) # 从第二个开始输出到第三个元素 print(list[1:3]) # 输出从第三个元素开始的所有元素 print(list[2:]) # 连续输出两次列表 print(tinylist * 2) # 连接列表 print(list + tinylist) 打印结果1: 图3.png 示例2: 修改列表数据: >>> a = [1, 2, 3, 4, 5] # 定义列表 >>> a[0] = 9 # 为第一个元素赋值 >>> a # 打印列表 [9, 2, 3, 4, 5] >>> a[2:5] = [14,13,14] # 修改第3-5个列表数据 >>> a # 打印 [9, 2, 14, 13, 14] >>> a[2:5] = [] # 将第3-5个数据置为空 >>> a # 打印 [9, 2] Tuple(元组) 元组(tuple)与列表类似,不同之处在于元组的元素不能修改。元组写在小括号(())里,元素之间用逗号隔开。 示例1: # 定义元组 tuple = ('abcd', 432, 3.32, 'mazaiting', 240.2) tinytuple = (123, 'zaitingma') # 输出完整元组 print(tuple) # 输出元组的第一个元素 print(tuple[0]) # 输出从第二个元素到第三个元素 print(tuple[1:3]) # 输出从第三个元素开始的所有元素 print(tuple[2:]) # 输出两次元组 print(tinytuple) # 连接元组 print(tuple+tinytuple) 打印结果1: 图4.png 示例2: >>> tup = (1, 2, 3, 4, 5, 6) >>> print(tup[0]) 1 >>> print(tup[1:5]) (2, 3, 4, 5) >>> tup[0] = 11 # 修改元组数据是非法的 Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: 'tuple' object does not support item assignment >>> string、list和tuple都属于sequence(序列)。 注意: 1、与字符串一样,元组的元素不能修改。 2、元组也可以被索引和切片,方法一样。 3、注意构造包含0或1个元素的元组的特殊语法规则。 4、元组也可以使用+操作符进行拼接。 Sets(集合) 1). 集合(set)是一个无序不重复元素的序列。 2). 基本功能是进行成员关系测试和删除重复元素。 3). 可以使用大括号 { } 或者 set() 函数创建集合,注意:创建一个空集合必须用 set() 而不是 { },因为 { } 是用来创建一个空字典。 示例: # 定义集合 student = {'Tom', 'Jim', 'Mary', 'Tom', 'Jack', 'Rose'} # 输出集合,重复的元素被自动去掉 print(student) # 成员测试 if('Rose' in student) : print('Rose 在集合中') else : print('Rose 不在集合中') # set 可以进行集合运算 a = set('abracdabra') b = set('alacazam') print(a) # a和b的差集 print(a - b) # a和b的并集 print(a | b) # a和b的交集 print(a & b) # a和b不同时存在的元素 print(a ^ b) 打印结果: 图5.png Dictionary(字典) 字典(dictionary)是Python中另一个非常有用的内置数据类型。列表是有序的对象集合,字典是无序的对象集合。两者之间的区别在于:字典当中的元素是通过键来存取的,而不是通过偏移存取。字典是一种映射类型,字典用"{ }"标识,它是一个无序的键(key) : 值(value)对集合。键(key)必须使用不可变类型。在同一个字典中,键(key)必须是唯一的。 示例: # 创建字典 dict = {} dict['one'] = "123" dict[2] = "23434" tinydict = {'name':'mazaiting','code':1,'site':'xibeixing'} # 输出键为'one'的值 print(dict['one']) # 输出键为2的值 print(dict[2]) # 输出完整的字典 print(tinydict) # 输出所有键 print(tinydict.keys()) # 输出所有值 print(tinydict.values()) 打印结果: 图6.png 注意: 1、字典是一种映射类型,它的元素是键值对。 2、字典的关键字必须为不可变类型,且不能重复。 3、创建空字典使用 { }。 2. 运算符 1). 逻辑运算符 and(和)、or(或)、not(非) 2). 成员运算符--用于判断某个元素是否在某个序列中存在 in:如果在指定的序列中找到值返回 True,否则返回 False。 not in:如果在指定的序列中没有找到值返回 True,否则返回 False。 3). 身份运算符--用于判断两个对象是否引用自同一对象 is:is 是判断两个标识符是不是引用自一个对象 x is y is not:is not 是判断两个标识符是不是引用自不同对象 3. 字符串 1). 字符串格式化 # 字符串格式化 print("我叫 %s 今年 %d 岁!" % ('mazaiting', 24)) 打印结果: 图7.png 2). 三引号 python三引号允许一个字符串跨多行,字符串中可以包含换行符、制表符以及其他特殊字符。 para_str = """ 这个一个多行字符串 多行字符串可以使用制表符 \t制表符 \n也可以使用换行符 """ print(para_str) 打印结果: 图8.png 4. 列表 # 创建列表 list1 = ['Google', 'mazaiting', 1204, 10.3] # 获取值 print('list1[0]:', list1[0]) # 追加元素 list1.append('1425941077') # 打印全部数据 print(list1) # 删除第一条数据 del list1[1] # 打印全部数据 print(list1) # 迭代 for x in [1,2,3]: print(x, end=" ") 打印结果: 图9.png 5. 元组 # 访问元组 tup1 = ('Google', 'Runoob', 1992, 2000) print ("tup1[0]: ", tup1[0]) # 修改元组.元素是不允许被修改的,但可以对元组进行拼接 tup2 = ('abc', 'xyz') tup3 = tup1 + tup2 print (tup3) # 删除元组.元组中的元素是不允许被删除的,但我们可以删除整个元组 del tup3 打印结果: 图10.png 6. 字典 字典是另一种可变容器模型,且可存储任意类型对象。 字典的每个键值(key=>value)对用冒号(:)分割,每个对之间用逗号(,)分割,整个字典包括在花括号({})中 ,格式如下所示: d = {key1 : value1, key2 : value2 } 键必须是唯一的,但值则不必。 示例: # 访问字典里的值 dict = {'Name':"mazaiting", 'Age':24, 'Type':'Android'} print("dict['Name']:", dict['Name']) # 修改字典内容 dict['Type'] = 'JavaEE' print("dict['Type']", dict['Type']) # 删除字典元素 del dict['Name'] # 删除键'Name' print(dict) dict.clear() # 清空字典 print(dict) del dict # 删除字典 打印结果: 图11.png 字典键的特性: 1). 不允许同一个键出现两次。创建时如果同一个键被赋值两次,后一个值会被记住. 2). 键必须不可变,所以可以用数字,字符串或元组充当,而用列表就不行.

优秀的个人博客,低调大师

Python 学习(三)

1. 斐波纳契数列 # 两个元素的总和确定了下一个数 a, b = 0, 1 while b < 10: print(b) a, b = b, a + b pass 打印结果: 图1.png 2. end 关键字 关键字end可以用于将结果输出到同一行,或者在输出的末尾添加不同的字符 # 两个元素的总和确定了下一个数 a, b = 0, 1 while b < 10: print(b, end=",") # 将文本输入在同一行 a, b = b, a + b pass 打印结果: 图2.png 3. 数字猜谜游戏 # 数字猜谜游戏 number = 7 guess = -1 print("数字猜谜游戏") while guess != number: guess = int(input("请输入你猜的数字: ")) if guess == number: print("恭喜你猜对了") elif guess < number: print("猜的数字小了") elif guess > number: print("猜的数字大了") pass 打印结果: 图3.png 4. 循环 while 循环 1). Python中while语句的一般形式: while 判断条件: 语句 同样需要注意冒号和缩进。另外,在Python中没有do..while循环 2). while 循环使用 else 语句 在 while … else 在条件语句为 false 时执行 else 的语句块: count = 0 while count < 5: print (count, " 小于 5") count = count + 1 else: print (count, " 大于或等于 5") for 语句 Python for循环可以遍历任何序列的项目,如一个列表或者一个字符串。 for循环的一般格式如下: for <variable> in <sequence>: <statements> else: <statements> 3). break和continue语句及循环中的else子句 break 语句可以跳出 for 和 while 的循环体。如果你从 for 或 while 循环中终止,任何对应的循环 else 块将不执行。 4). pass 语句 Python pass是空语句,是为了保持程序结构的完整性。 5. range()函数 如果你需要遍历数字序列,可以使用内置range()函数。它会生成数列 for i in range(5): print(i) 6. 迭代器 迭代器有两个基本的方法:iter() 和 next() 1). iter()函数 list=[1,2,3,4] it = iter(list) # 创建迭代器对象 for x in it: print (x, end=" ") 2). next()函数 import sys # 引入 sys 模块 list=[1,2,3,4] it = iter(list) # 创建迭代器对象 while True: try: print (next(it)) except StopIteration: sys.exit() 7. 生成器 在 Python 中,使用了 yield 的函数被称为生成器(generator)。普通函数不同的是,生成器是一个返回迭代器的函数,只能用于迭代操作,更简单点理解生成器就是一个迭代器。在调用生成器运行的过程中,每次遇到 yield 时函数会暂停并保存当前所有的运行信息,返回 yield 的值, 并在下一次执行 next() 方法时从当前位置继续运行。 import sys def fibonacci(n): # 生成器函数 - 斐波那契 a, b, counter = 0, 1, 0 while True: if (counter > n): return yield a a, b = b, a + b counter += 1 f = fibonacci(10) # f 是一个迭代器,由生成器返回生成 while True: try: print (next(f), end=" ") except StopIteration: sys.exit()

优秀的个人博客,低调大师

Python 学习(四)

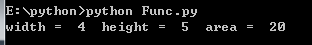
1. 函数 函数是组织好的,可重复使用的,用来实现单一,或相关联功能的代码段。 函数能提高应用的模块性,和代码的重复利用率。 定义函数的规则: 1). 函数代码块以 def 关键词开头,后接函数标识符名称和圆括号 ()。 2). 任何传入参数和自变量必须放在圆括号中间,圆括号之间可以用于定义参数。 3). 函数的第一行语句可以选择性地使用文档字符串—用于存放函数说明。 4). 函数内容以冒号起始,并且缩进。 5). return [表达式] 结束函数,选择性地返回一个值给调用方。不带表达式的return相当于返回 None。 语法: Python 定义函数使用 def 关键字,一般格式如下: def 函数名(参数列表): 函数体 默认情况下,参数值和参数名称是按函数声明中定义的的顺序匹配起来的。 示例: # 计算面积函数 def area(width, height): return width * height pass w = 4 h = 5 print ("width = ", w, " height = ", h, " area = ", area(w,h)) 打印结果: 图1.png 2. 可更改(mutable)与不可更改(immutable)对象 在 python 中,strings, tuples, 和 numbers 是不可更改的对象,而 list,dict 等则是可以修改的对象。 不可变类型:变量赋值 a=5 后再赋值 a=10,这里实际是新生成一个 int 值对象 10,再让 a 指向它,而 5 被丢弃,不是改变a的值,相当于新生成了a。 可变类型:变量赋值 la=[1,2,3,4] 后再赋值 la[2]=5 则是将 list la 的第三个元素值更改,本身la没有动,只是其内部的一部分值被修改了。 3. 参数 必需参数 必需参数须以正确的顺序传入函数。调用时的数量必须和声明时的一样 关键字参数 关键字参数和函数调用关系紧密,函数调用使用关键字参数来确定传入的参数值。 默认参数 调用函数时,如果没有传递参数,则会使用默认参数。 不定长参数 基本语法如下: def functionname([formal_args,] *var_args_tuple ): "函数_文档字符串" function_suite return [expression] 加了星号(*)的变量名会存放所有未命名的变量参数。如果在函数调用时没有指定参数,它就是一个空元组。 示例: # 必需参数 def printStr(str): print(str) pass print("mazaiting") # 关键字参数 def printMe(str): print(str) pass printMe(str = "zaitingma") # 默认参数 def printInfo(name, age = 24): print("名字:", name) print("年龄:", age) pass printInfo(name = "mazaiting") # 不定长参数 def printInfo(arg, *vartuple): print("输出:") print(arg) for var in vartuple: print(var) pass pass printInfo(70, 60, 50) 打印结果: 图2.png 4. 匿名函数 所谓匿名,意即不再使用 def 语句这样标准的形式定义一个函数。 1). lambda 只是一个表达式,函数体比 def 简单很多。 2). lambda的主体是一个表达式,而不是一个代码块。仅仅能在lambda表达式中封装有限的逻辑进去。 3). lambda 函数拥有自己的命名空间,且不能访问自己参数列表之外或全局命名空间里的参数。 4). 虽然lambda函数看起来只能写一行,却不等同于C或C++的内联函数,后者的目的是调用小函数时不占用栈内存从而增加运行效率。 语法 lambda 函数的语法只包含一个语句,如下: lambda [arg1 [,arg2,.....argn]]:expression 示例: # lambda表达式 # 可写函数说明 sum = lambda arg1, arg2: arg1 + arg2 # 调用sum函数 print("相加后的值为:", sum(10, 20)) print("相加后的值为:", sum(20, 20)) 打印结果: 图3.png 5. return语句 return [表达式] 语句用于退出函数,选择性地向调用方返回一个表达式。不带参数值的return语句返回None 示例: # return 语句 def sum(arg1, arg2): total = arg1 + arg2 return total pass # 调用sum函数 total = sum(10, 20) print("函数:",total) 打印结果: 图4.png 6. 变量作用域 Python的作用域一共有4种,分别是: L (Local) 局部作用域 E (Enclosing) 闭包函数外的函数中 G (Global) 全局作用域 B (Built-in) 内建作用域 示例: # 内建作用域 x = int(2.9) # 全局作用域 g_count = 0 def outer(): # 闭包函数外的函数中 o_count = 1 def inner(): # 局部作用域 i_count = 2 pass pass Python 中只有模块(module),类(class)以及函数(def、lambda)才会引入新的作用域,其它的代码块(如 if/elif/else/、try/except、for/while等)是不会引入新的作用域的,也就是说这些语句内定义的变量,外部也可以访问. 当内部作用域想修改外部作用域的变量时,就要用到global和nonlocal关键字: global num = 1 def fun1(): global num # 需要使用 global 关键字声明 print(num) num = 123 print(num) fun1() nonlocal关键字 def outer(): num = 10 def inner(): nonlocal num # nonlocal关键字声明 num = 100 print(num) inner() print(num) outer() 7. 模块 Python 提供了一个办法,把这些定义存放在文件中,为一些脚本或者交互式的解释器实例使用,这个文件被称为模块。 模块是一个包含所有你定义的函数和变量的文件,其后缀名是.py。模块可以被别的程序引入,以使用该模块中的函数等功能。 1). 引用标准库 示例: import sys print("命令行参数如下:") for i in sys.argv: print(i) pass print("\n\nPython 路径为:", sys.path, '\n') 打印结果: 图5.png 2). import 语句 想使用 Python 源文件,只需在另一个源文件里执行 import 语句,语法如下: import module1[, module2[,... moduleN] 当解释器遇到 import 语句,如果模块在当前的搜索路径就会被导入。 示例: Support.py文件: def print_func(str): print("Hello: ", str) return Module.py文件 # 引入Support.py文件 # 导入模块 import Support # 调用Support中的函数 Support.print_func("Mazaiting") 图6.png 打印结果: 图7.png 3). From…import* 语句 把一个模块的所有内容全都导入到当前的命名空间也是可行的,只需使用如下声明: from modname import * 这提供了一个简单的方法来导入一个模块中的所有项目。然而这种声明不该被过多地使用。 4). name属性 一个模块被另一个程序第一次引入时,其主程序将运行。如果我们想在模块被引入时,模块中的某一程序块不执行,我们可以用name属性来使该程序块仅在该模块自身运行时执行。 # Module.py if __name__ == '__main__': print("程序自身在运行") else: print("我来自另一模块") pass 打印结果: 图8.png 5). dir() 函数 内置的函数 dir() 可以找到模块内定义的所有名称。以一个字符串列表的形式返回: 打印结果: 图9.png 8. 包 包是一种管理 Python 模块命名空间的形式,采用"点模块名称"。 比如一个模块的名称是 A.B, 那么他表示一个包 A中的子模块 B 。 就好像使用模块的时候,你不用担心不同模块之间的全局变量相互影响一样,采用点模块名称这种形式也不用担心不同库之间的模块重名的情况。 这样不同的作者都可以提供 NumPy 模块,或者是 Python 图形库。 不妨假设你想设计一套统一处理声音文件和数据的模块(或者称之为一个"包")。 现存很多种不同的音频文件格式(基本上都是通过后缀名区分的,例如: .wav,:file:.aiff,:file:.au,),所以你需要有一组不断增加的模块,用来在不同的格式之间转换。 并且针对这些音频数据,还有很多不同的操作(比如混音,添加回声,增加均衡器功能,创建人造立体声效果),所以你还需要一组怎么也写不完的模块来处理这些操作。 这里给出了一种可能的包结构(在分层的文件系统中): sound/ 顶层包 __init__.py 初始化 sound 包 formats/ 文件格式转换子包 __init__.py wavread.py wavwrite.py aiffread.py aiffwrite.py auread.py auwrite.py ... effects/ 声音效果子包 __init__.py echo.py surround.py reverse.py ... filters/ filters 子包 __init__.py equalizer.py vocoder.py karaoke.py ... 9. 输入输出 1). 输出 Python两种输出值的方式: 表达式语句和 print() 函数。 第三种方式是使用文件对象的 write() 方法,标准输出文件可以用 sys.stdout 引用。 如果你希望输出的形式更加多样,可以使用 str.format() 函数来格式化输出值。 如果你希望将输出的值转成字符串,可以使用 repr() 或 str() 函数来实现。 str(): 函数返回一个用户易读的表达形式 repr(): 产生一个解释器易读的表达形式 示例: # 返回一个用户易读的表达形式 x = str(1/7) print(x) # 产生一个解析器易读的表达形式 y = 100 * 100 print(repr(y)) # 格式话 print("{}网址:'{other}!'".format("百度",other="www.baidu.com")) 打印结果: 图10.png 2). 读键盘输入 # 从键盘输入 str = input("请输入:") print("你输入的内容是:", str) 打印结果: 图11.png 3). 读写文件 读文件:open() 将会返回一个 file 对象,基本语法格式如下: open(filename, mode) filename:filename 变量是一个包含了你要访问的文件名称的字符串值。 mode:mode决定了打开文件的模式:只读,写入,追加等。所有可取值见如下的完全列表。这个参数是非强制的,默认文件访问模式为只读(r)。只读(r), 二进制读(rb),读写(r+),二进制读写(rb+),写(w),二进制写(wb),读写(w+),二进制读写(wb+),追加(a),二进制追加(ab),读写追加(a+),二进制读写追加(ab+). 图12.png 写入文件示例: # 打开文件 file = open("test.txt","w") # 定义数据 str = "Python 是一个非常好的语言。" # 写入文件 file.write(str) # 关闭打开的文件 file.close 打印结果: 图13.png 读取文件示例: # 读取文件 file = open("test.txt", "r") # 读取数据 str = file.read() # 打印 print(str) # 关闭打开文件 file.close() 打印结果: 图14.png readline(): 会从文件中读取单独的一行。换行符为 '\n'。f.readline() 如果返回一个空字符串, 说明已经已经读取到最后一行。 readlines(): 将返回该文件中包含的所有行。如果设置可选参数 sizehint, 则读取指定长度的字节, 并且将这些字节按行分割。 write(string):将 string 写入到文件中, 然后返回写入的字符数。 tell():返回文件对象当前所处的位置, 它是从文件开头开始算起的字节数。 seek():如果要改变文件当前的位置, 可以使用 f.seek(offset, from_what) 函数。 from_what 的值, 如果是 0 表示开头, 如果是 1 表示当前位置, 2 表示文件的结尾,例如: seek(x,0) : 从起始位置即文件首行首字符开始移动 x 个字符 seek(x,1) : 表示从当前位置往后移动x个字符 seek(-x,2):表示从文件的结尾往前移动x个字符 from_what 值为默认为0,即文件开头。 close(): 在文本文件中 (那些打开文件的模式下没有 b 的), 只会相对于文件起始位置进行定位。你处理完一个文件后, 调用 f.close() 来关闭文件并释放系统的资源,如果尝试再调用该文件,则会抛出异常。 4). pickle 模块 python的pickle模块实现了基本的数据序列和反序列化。通过pickle模块的序列化操作我们能够将程序中运行的对象信息保存到文件中去,永久存储。通过pickle模块的反序列化操作,我们能够从文件中创建上一次程序保存的对象。 基本接口: pickle.dump(obj, file, [,protocol]) 有了 pickle 这个对象, 就能对 file 以读取的形式打开: x = pickle.load(file) 注:从 file 中读取一个字符串,并将它重构为原来的python对象。存入数据示例: # 导入pickle import pickle # 使用pickle模块将数据对象保存到文件 data = { 'a':[1,2.3,4,5+6j], 'b':('string', u'Unicode string'), 'c':None } # 打开文件 output = open('data.pkl', 'wb') # 写入数据 pickle.dump(data, output) # 关闭文件 output.close() 写入数据示例: # 导入pickle import pprint,pickle # 使用pickle模块从文件中重构python对象 file = open('data.pkl','rb') # 重构对象 data = pickle.load(file) # 打印数据 pprint.pprint(data) # 关闭文件 file.close() 执行结果: 图15.png 10. 遍历文件夹 import os import os.path # 获取指定目录及其子目录下的py文件 l = [] def get_py(path, list): # 获取path目录下的所有文件 fileList = os.listdir(path) for fileName in fileList: # 获取path与fileName组合后的路径 pathTmp = os.path.join(path, fileName) # 如果是目录 if os.path.isdir(pathTmp): # 递归查找 get_py(pathTmp, list) pass # 不是目录,则比较后缀名 elif fileName[-3:].upper()=='.PY': list.append(pathTmp) pass pass pass path = input("请输入路径: ").strip() get_py(path, l) print("在%s目录及其子目录下找到%d个py文件\n分别为:"%(path,len(l))) for filePath in l: print(filePath+'\n') pass 打印结果: 图16.png

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册