首页 文章 精选 留言 我的

精选列表

搜索[流量结构],共10011篇文章
优秀的个人博客,低调大师

python 数据结构 set

创建set tuple算是list和str的杂合,那么set则可以堪称是list和dict的杂合. set拥有类似dict的特点:可以用{}花括号来定义;其中的元素没有序列,也就是是非序列类型的数据;而且,set中的元素不可重复,这就类似dict的键. set也有继承了一点list的特点:如可以原处修改(事实上是一种类别的set可以原处修改,另外一种不可以). 实验: >>> s1 = set("hiekaye") #把str中的字符拆解开,形成set.特别注意观察:hiekay3中有两个e >>> s1 #但是在s1中,只有一个i,也就是不能重复 set(['h', 'i', '3', 'k', 'a','y']) >>> s2 = set([123,"google","face","book","facebook","book"]) #通过list创建set.不能有重复,元素可以是int/str >>> s2 set(['facebook', 123, 'google', 'book', 'face']) #元素顺序排列不是按照指定顺序 >>> s3 = {"facebook",123} #通过{}直接创建 >>> s3 set([123, 'facebook']) 探究: >>> s3 = {"facebook",[1,2,'a'],{"name":"python","lang":"english"},123} Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: unhashable type: 'dict' >>> s3 = {"facebook",[1,2],123} Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: unhashable type: 'list' 从上述实验中,可以看出,通过{}无法创建含有list/dict元素的set. 继续探索: >>> s1 set(['q', 'i', 's', 'r', 'w']) >>> s1[1] = "I" Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: 'set' object does not support item assignment >>> s1 set(['q', 'i', 's', 'r', 'w']) >>> lst = list(s1) >>> lst ['q', 'i', 's', 'r', 'w'] >>> lst[1] = "I" >>> lst ['q', 'I', 's', 'r', 'w'] 上面的探索中,将set和list做了一个对比,虽然说两者都能够做原处修改,但是,通过索引编号(偏移量)的方式,直接修改,list允许,但是set报错. 那么,set如何修改呢? 更改set 把set的有关内置函数找出来. >>> dir(set) ['__and__', '__class__', '__cmp__', '__contains__', '__delattr__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__iand__', '__init__', '__ior__', '__isub__', '__iter__', '__ixor__', '__le__', '__len__', '__lt__', '__ne__', '__new__', '__or__', '__rand__', '__reduce__', '__reduce_ex__', '__repr__', '__ror__', '__rsub__', '__rxor__', '__setattr__', '__sizeof__', '__str__', '__sub__', '__subclasshook__', '__xor__', 'add', 'clear', 'copy', 'difference', 'difference_update', 'discard', 'intersection', 'intersection_update', 'isdisjoint', 'issubset', 'issuperset', 'pop', 'remove', 'symmetric_difference', 'symmetric_difference_update', 'union', 'update'] 先看这些: 'add', 'clear', 'copy', 'difference', 'difference_update', 'discard', 'intersection', 'intersection_update', 'isdisjoint', 'issubset', 'issuperset', 'pop', 'remove', 'symmetric_difference', 'symmetric_difference_update', 'union', 'update' 然后用help()可以找到每个函数的具体使用方法,下面列几个例子: 增加元素 >>> help(set.add) Help on method_descriptor: add(...) Add an element to a set. This has no effect if the element is already present. 实验: >>> a_set = {} #我想当然地认为这样也可以建立一个set >>> a_set.add("hiekay") #报错.看看错误信息,居然告诉我dict没有add.我分明建立的是set呀. Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'dict' object has no attribute 'add' >>> type(a_set) #type之后发现,计算机认为我建立的是一个dict <type 'dict'> 特别说明一下,{}这个东西,在dict和set中都用.但是,如上面的方法建立的是dict,不是set.这是python规定的.要建立set,只能用前面介绍的方法了. >>> a_set = {'a','i'} #这回就是set了吧 >>> type(a_set) <type 'set'> #果然 >>> a_set.add("hiekay") #增加一个元素 >>> a_set #原处修改,即原来的a_set引用对象已经改变 set(['i', 'a', 'hiekay']) >>> b_set = set("python") >>> type(b_set) <type 'set'> >>> b_set set(['h', 'o', 'n', 'p', 't', 'y']) >>> b_set.add("hiekay") >>> b_set set(['h', 'o', 'n', 'p', 't', 'hiekay', 'y']) >>> b_set.add([1,2,3]) #这样做是不行滴,跟前面一样,报错. Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: unhashable type: 'list' >>> b_set.add('[1,2,3]') #可以这样! >>> b_set set(['[1,2,3]', 'h', 'o', 'n', 'p', 't', 'hiekay', 'y']) 从另外一个set中合并过来元素,方法是set.update(s2) >>> help(set.update) update(...) Update a set with the union of itself and others. >>> s1 set(['a', 'b']) >>> s2 set(['github', 'hiekay']) >>> s1.update(s2) #把s2的元素并入到s1中. >>> s1 #s1的引用对象修改 set(['a', 'hiekay', 'b', 'github']) >>> s2 #s2的未变 set(['github', 'hiekay']) 删除 >>> help(set.pop) pop(...) Remove and return an arbitrary set element. Raises KeyError if the set is empty. >>> b_set set(['[1,2,3]', 'h', 'o', 'n', 'p', 't', 'hiekay', 'y']) >>> b_set.pop() #从set中任意选一个删除,并返回该值 '[1,2,3]' >>> b_set.pop() 'h' >>> b_set.pop() 'o' >>> b_set set(['n', 'p', 't', 'hiekay', 'y']) >>> b_set.pop("n") #如果要指定删除某个元素,报错了. Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: pop() takes no arguments (1 given) set.pop()是从set中任意选一个元素,删除并将这个值返回.但是,不能指定删除某个元素.报错信息中就告诉我们了,pop()不能有参数.此外,如果set是空的了,也报错.这条是帮助信息告诉我们的. 要删除指定的元素,怎么办? >>> help(set.remove) remove(...) Remove an element from a set; it must be a member. If the element is not a member, raise a KeyError. set.remove(obj)中的obj,必须是set中的元素,否则就报错.试一试: >>> a_set set(['i', 'a', 'hiekay']) >>> a_set.remove("i") >>> a_set set(['a', 'hiekay']) >>> a_set.remove("w") Traceback (most recent call last): File "<stdin>", line 1, in <module> KeyError: 'w' discard(obj): >>> help(set.discard) discard(...) Remove an element from a set if it is a member. If the element is not a member, do nothing. 与help(set.remove)的信息对比,看看有什么不同.discard(obj)中的obj如果是set中的元素,就删除,如果不是,就什么也不做,do nothing. >>> a_set.discard('a') >>> a_set set(['hiekay']) >>> a_set.discard('b') >>> set.clear(),它的功能是:Remove all elements from this set. >>> a_set set(['hiekay']) >>> a_set.clear() >>> a_set set([]) >>> bool(a_set) #空了,bool一下返回False. False

优秀的个人博客,低调大师

python 数据结构 字典

字典,名称就叫做dictionary,翻译过来是字典,类似于前面的int/str/list,这种类型数据名称是:dict 实验: >>>help(dict) 使用dir,也能得到相同的结果。 >>> dir(dict) ['__class__', '__cmp__', '__contains__', '__delattr__', '__delitem__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__getitem__', '__gt__', '__hash__', '__init__', '__iter__', '__le__', '__len__', '__lt__', '__ne__', '__new__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__setitem__', '__sizeof__', '__str__', '__subclasshook__', 'clear', 'copy', 'fromkeys', 'get', 'has_key', 'items', 'iteritems', 'iterkeys', 'itervalues', 'keys', 'pop', 'popitem', 'setdefault', 'update', 'values', 'viewitems', 'viewkeys', 'viewvalues'] values这个内置函数的使用方法 >>> help(dict.values) Help on method_descriptor: values(...) D.values() -> list of D's values (END) q键退回。 概述 python中的dict具有如下特点: dict是可变的 dict可以存储任意数量的Python对象 dict可以存储任何python数据类型 dict以:key:value,即“键:值”对的形式存储数据,每个键是唯一的。 dict也被称为关联数组或哈希表。 以上诸条,如果还不是很理解,也没有关系,通过下面的学习,特别是通过各种实验,就能理解了。 创建dict 方法1: 创建一个空的dict,这个空dict,可以在以后向里面加东西用。 >>> mydict = {} >>> mydict {} 创建有内容的dict。 >>> person = {"name":"hiekay","site":"hiekay.github.io","language":"python"} >>> person {'name': 'hiekay', 'language': 'python', 'site': 'hiekay.github.io'} "name":"hiekay"就是一个键值对,前面的name叫做键(key),后面的hiekay是前面的键所对应的值(value)。在一个dict中,键是唯一的,不能重复;值则是对应于键,值可以重复。键值之间用(:)英文的分号,每一对键值之间用英文的逗号(,)隔开。 >>> person['name2']="hiekay" #这是一种向dict中增加键值对的方法 >>> person {'name2': 'hiekay', 'name': 'hiekay', 'language': 'python', 'site': 'hiekay.github.io'} 如下,演示了从一个空的dict开始增加内容的过程: >>> mydict = {} >>> mydict {} >>> mydict["site"] = "hiekay.github.io" >>> mydict[1] = 80 >>> mydict[2] = "python" >>> mydict["name"] = ["zhangsan","lisi","wangwu"] >>> mydict {1: 80, 2: 'python', 'site': 'hiekay.github.io', 'name': ['zhangsan', 'lisi', 'wangwu']} >>> mydict[1] = 90 #如果这样,则是修改这个键的值 >>> mydict {1: 90, 2: 'python', 'site': 'hiekay.github.io', 'name': ['zhangsan', 'lisi', 'wangwu']} 方法2: 元组 >>> name = (["first","Google"],["second","Yahoo"]) #这是另外一种数据类型,称之为元组,后面会讲到 >>> website = dict(name) >>> website {'second': 'Yahoo', 'first': 'Google'} 方法3: Python 字典 fromkeys() 函数用于创建一个新字典,以序列 seq 中元素做字典的键,value 为字典所有键对应的初始值。 >>> website = {}.fromkeys(("third","forth"),"facebook") >>> website {'forth': 'facebook', 'third': 'facebook'} 需要提醒的是,这种方法是从新建立一个dict。 访问dict的值 因为dict是以键值对的形式存储数据的,所以,只要知道键,就能得到值。这本质上就是一种映射关系。 >>> person {'name2': 'hiekay', 'name': 'hiekay', 'language': 'python', 'site': 'hiekay.github.io'} >>> person['name'] 'hiekay' >>> person['language'] 'python' >>> site = person['site'] >>> print site hiekay.github.io 遍历: 可以用for语句 >>> person {'name2': 'hiekay', 'name': 'hiekay', 'language': 'python', 'site': 'hiekay.github.io'} >>> for key in person: ... print person[key] ... hiekay hiekay python hiekay.github.io

优秀的个人博客,低调大师

HPC集群系统结构

1.1、HPC集群系统HPC机群系统建设的目的是为了得到更高的计算性能,更快的解决科研中过程中遇到的大量的密集型计算问题;同时希望HPC系统在CPU数量增加时能带来系统性能的线性提升。 1.2、HPC机群系统的组成HPC机群系统采用主流的Cluster架构组成,TOP500排名中85%以上的HPC计算机系统采用的是Cluster架构,其主要的特点有:² 系统觃模可扩展,伸缩性强。² 性能效率高。² 可靠性高,部分节点故障对于整体系统无影响。² 可用性好,采用通用操作系统。² 易用性,便于学习及使用。² 技术支持,广泛的技术支持及开源软件。 1.3、HPC机群系统的特点² 应用于高性能计算领域,单一映像系统,对于用户就是使用一台计算机。² 整合多个计算单元的并行计算性能。² 注重整体性能的収挥,所有的机器协同工作。² 目前成为高性能计算机的主体架构,可以包含类linux系统、winodws系统等多种异构平台。 1.4、HPC机群系统的功能² 为用户提供高性能计算资源,一般HPC机群的浮点计算能力是普通PC机的几千上万倍。² HPC机群可以大大提升分析、解决问题的能力,缩短产品的研发时间及周期。 特别在CAE领域,对于产品的定型以及性能挃标的测试分析都是其他计算机系统无法比拟的。 1.5、HPC机群系统的原理² 硬件平台部署Redhat 5.7 Linux操作系统² 系统局面完成相应的配置² 使用MPI或PVM并行编程技术,把要解决的问题运行分解,可以让多个核心同时计算,在系统中具体表现为多进程的计算方式;在计算完成后可以把结果输出到指定的文件或是设备中进行保存,以方便读取分析。

优秀的个人博客,低调大师

HBase体系结构剖析

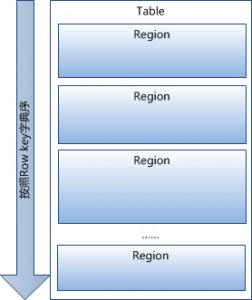
region按大小分割的,每个表一开始只有一个region,随着数据不断插入表,region不断增大,当增大到一个阀值的时候,Hregion就会等分会两个新的Hregion。当table中的行不断增多,就会有越来越多的Hregion。 HRegion是Hbase中分布式存储和负载均衡的最小单元。最小单元就表示不同的Hregion可以分布在不同的HRegion server上。但一个Hregion是不会拆分到多个server上的。 HRegion虽然是分布式存储的最小单元,但并不是存储的最小单元。事实上,HRegion由一个或者多个Store组成,每个store保存一 个columns family。每个Strore又由一个memStore和0至多个StoreFile组成。StoreFile以HFile格式保存在HDFS上。如 图: HFile的格式为: HFile分为六个部分: Data Block 段–保存表中的数据,这部分可以被压缩 Meta Block 段 (可选的)–保存用户自定义的kv对,可以被压缩。 File Info 段–Hfile的元信息,不被压缩,用户也可以在这一部分添加自己的元信息。 Data Block Index 段–Data Block的索引。每条索引的key是被索引的block的第一条记录的key。 Meta Block Index段 (可选的)–Meta Block的索引。 Trailer– 这一段是定长的。保存了每一段的偏移量,读取一个HFile时,会首先读取Trailer,Trailer保存了每个段的起始位置(段的Magic Number用来做安全check),然后,DataBlock Index会被读取到内存中,这样,当检索某个key时,不需要扫描整个HFile,而只需从内存中找到key所在的block,通过一次磁盘io将整个 block读取到内存中,再找到需要的key。DataBlock Index采用LRU机制淘汰。 HFile的Data Block,Meta Block通常采用压缩方式存储,压缩之后可以大大减少网络IO和磁盘IO,随之而来的开销当然是需要花费cpu进行压缩和解压缩。 目标Hfile的压缩支持两种方式:Gzip,Lzo。 系统架构 Client 1. 包含访问hbase的接口,client维护着一些cache来加快对hbase的访问,比如regione的位置信息。 Zookeeper 1. 保证任何时候,集群中只有一个master 2. 存贮所有Region的寻址入口。 3. 实时监控Region Server的状态,将Region server的上线和下线信息实时通知给Master 4. 存储Hbase的schema,包括有哪些table,每个table有哪些column family Master 1. 为Region server分配region 2. 负责region server的负载均衡 3. 发现失效的region server并重新分配其上的region 4. GFS上的垃圾文件回收 5. 处理schema更新请求 Region Server 1.Region server维护Master分配给它的region,处理对这些region的IO请求 2.Region server负责切分在运行过程中变得过大的region 可以看到,client访问hbase上数据的过程并不需要master参与(寻址访问zookeeper和region server,数据读写访问regione server),master仅仅维护者table和region的元数据信息,负载很低。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册