首页 文章 精选 留言 我的

精选列表

搜索[手游加固],共7842篇文章
优秀的个人博客,低调大师

CentOS7手动安装OpenStack Pike版--(neutron)

OpenStack安装指南_Mitakahttp://down.51cto.com/data/2331199 Openstack管理手册-Newton版-CentOS7.2http://down.51cto.com/data/2331201 #Configure neutron mysql -uroot -ppasswd123 -e "CREATE DATABASE neutron" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON neutron.TO 'neutron'@'localhost' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON neutron.TO 'neutron'@'%' IDENTIFIED BY 'passwd123'" openstack user create --domain default --password passwd123 neutron openstack role add --project service --user neutron admin openstack service create --name neutron --description "OpenStack Networking" network openstack endpoint create --region RegionOne network publichttp://controller:9696 openstack endpoint create --region RegionOne network internalhttp://controller:9696 openstack endpoint create --region RegionOne network adminhttp://controller:9696 Networking Option 2: Self-service networks Edit the /etc/neutron/neutron.conf openstack-config --set /etc/neutron/neutron.conf database connection mysql+pymysql://neutron:passwd123@controller/neutron openstack-config --set /etc/neutron/neutron.conf DEFAULT core_plugin ml2 openstack-config --set /etc/neutron/neutron.conf DEFAULT service_plugins router openstack-config --set /etc/neutron/neutron.conf DEFAULT allow_overlapping_ips true openstack-config --set /etc/neutron/neutron.conf DEFAULT transport_url rabbit://openstack:passwd123@controller openstack-config --set /etc/neutron/neutron.conf DEFAULT auth_strategy keystone openstack-config --set /etc/neutron/neutron.conf keystone_authtoken auth_urihttp://controller:5000 openstack-config --set /etc/neutron/neutron.conf keystone_authtoken auth_urlhttp://controller:35357 openstack-config --set /etc/neutron/neutron.conf keystone_authtoken memcached_servers controller:11211 openstack-config --set /etc/neutron/neutron.conf keystone_authtoken auth_type password openstack-config --set /etc/neutron/neutron.conf keystone_authtoken project_domain_name default openstack-config --set /etc/neutron/neutron.conf keystone_authtoken user_domain_name default openstack-config --set /etc/neutron/neutron.conf keystone_authtoken project_name service openstack-config --set /etc/neutron/neutron.conf keystone_authtoken username neutron openstack-config --set /etc/neutron/neutron.conf keystone_authtoken password passwd123 openstack-config --set /etc/neutron/neutron.conf DEFAULT notify_nova_on_port_status_changes true openstack-config --set /etc/neutron/neutron.conf DEFAULT notify_nova_on_port_data_changes true openstack-config --set /etc/neutron/neutron.conf nova auth_urlhttp://controller:35357 openstack-config --set /etc/neutron/neutron.conf nova auth_type password openstack-config --set /etc/neutron/neutron.conf nova project_domain_name default openstack-config --set /etc/neutron/neutron.conf nova user_domain_name default openstack-config --set /etc/neutron/neutron.conf nova region_name RegionOne openstack-config --set /etc/neutron/neutron.conf nova project_name service openstack-config --set /etc/neutron/neutron.conf nova username nova openstack-config --set /etc/neutron/neutron.conf nova password passwd123 openstack-config --set /etc/neutron/neutron.conf oslo_concurrency lock_path /var/lib/neutron/tmp Edit the /etc/neutron/plugins/ml2/ml2_conf.ini openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini ml2 type_drivers flat,vlan,vxlan openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini ml2 tenant_network_types vxlan openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini ml2 mechanism_drivers linuxbridge,l2population openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini ml2 extension_drivers port_security openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini ml2_type_flat flat_networks provider openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini ml2_type_vxlan vni_ranges 1:1000 openstack-config --set /etc/neutron/plugins/ml2/ml2_conf.ini securitygroup enable_ipset true Edit the /etc/neutron/plugins/ml2/linuxbridge_agent.ini openstack-config --set /etc/neutron/plugins/ml2/linuxbridge_agent.ini linux_bridge physical_interface_mappings provider:ens34 openstack-config --set /etc/neutron/plugins/ml2/linuxbridge_agent.ini vxlan enable_vxlan true openstack-config --set /etc/neutron/plugins/ml2/linuxbridge_agent.ini vxlan local_ip 192.168.137.145 openstack-config --set /etc/neutron/plugins/ml2/linuxbridge_agent.ini vxlan l2_population true openstack-config --set /etc/neutron/plugins/ml2/linuxbridge_agent.ini securitygroup enable_security_group true openstack-config --set /etc/neutron/plugins/ml2/linuxbridge_agent.ini securitygroup firewall_driver neutron.agent.linux.iptables_firewall.IptablesFirewallDriver Edit the /etc/neutron/l3_agent.ini openstack-config --set /etc/neutron/l3_agent.ini DEFAULT interface_driver linuxbridge Edit the /etc/neutron/dhcp_agent.ini openstack-config --set /etc/neutron/dhcp_agent.ini DEFAULT interface_driver linuxbridge openstack-config --set /etc/neutron/dhcp_agent.ini DEFAULT dhcp_driver neutron.agent.linux.dhcp.Dnsmasq openstack-config --set /etc/neutron/dhcp_agent.ini DEFAULT enable_isolated_metadata true Edit the /etc/neutron/metadata_agent.ini openstack-config --set /etc/neutron/metadata_agent.ini DEFAULT nova_metadata_host controller openstack-config --set /etc/neutron/metadata_agent.ini DEFAULT metadata_proxy_shared_secret openstack Edit the /etc/nova/nova.conf openstack-config --set /etc/nova/nova.conf neutron urlhttp://controller:9696 openstack-config --set /etc/nova/nova.conf neutron auth_urlhttp://controller:35357 openstack-config --set /etc/nova/nova.conf neutron auth_type password openstack-config --set /etc/nova/nova.conf neutron project_domain_name default openstack-config --set /etc/nova/nova.conf neutron user_domain_name default openstack-config --set /etc/nova/nova.conf neutron region_name RegionOne openstack-config --set /etc/nova/nova.conf neutron project_name service openstack-config --set /etc/nova/nova.conf neutron username neutron openstack-config --set /etc/nova/nova.conf neutron password passwd123 openstack-config --set /etc/nova/nova.conf neutron service_metadata_proxy true openstack-config --set /etc/nova/nova.conf neutron metadata_proxy_shared_secret = openstack ln -s /etc/neutron/plugins/ml2/ml2_conf.ini /etc/neutron/plugin.ini su -s /bin/sh -c "neutron-db-manage --config-file /etc/neutron/neutron.conf \ --config-file /etc/neutron/plugins/ml2/ml2_conf.ini upgrade head" neutron systemctl restart openstack-nova-api.service systemctl enable neutron-server.service \ neutron-linuxbridge-agent.service neutron-dhcp-agent.service \ neutron-metadata-agent.service systemctl start neutron-server.service \ neutron-linuxbridge-agent.service neutron-dhcp-agent.service \ neutron-metadata-agent.service systemctl status neutron-server.service \ neutron-linuxbridge-agent.service neutron-dhcp-agent.service \ neutron-metadata-agent.service systemctl enable neutron-l3-agent.service systemctl start neutron-l3-agent.service systemctl status neutron-l3-agent.service 本文转自 OpenStack2015 博客,原文链接: http://blog.51cto.com/andyliu/2069166 如需转载请自行联系原作者

优秀的个人博客,低调大师

CentOS7手动安装OpenStack Pike版--(horizon)

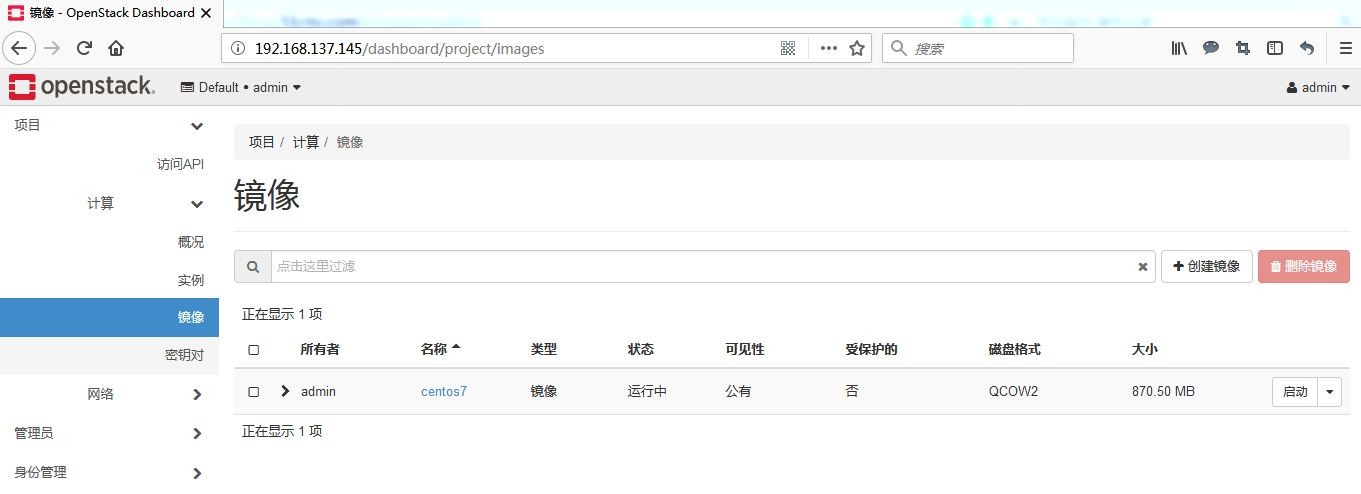
OpenStack安装指南_Mitakahttp://down.51cto.com/data/2331199 Openstack管理手册-Newton版-CentOS7.2http://down.51cto.com/data/2331201 #Configure horizon Edit the /etc/openstack-dashboard/local_settings OPENSTACK_HOST = "controller" ALLOWED_HOSTS = ['*', ] SESSION_ENGINE = 'django.contrib.sessions.backends.cache' CACHES = { 'default': { 'BACKEND': 'django.core.cache.backends.memcached.MemcachedCache', 'LOCATION': 'controller:11211', }, } OPENSTACK_KEYSTONE_URL = "http://%s:5000/v2.0" % OPENSTACK_HOST OPENSTACK_KEYSTONE_MULTIDOMAIN_SUPPORT = True OPENSTACK_API_VERSIONS = { "data-processing": 1.1, "identity": 3, "image": 2, "volume": 2, "compute": 2, } OPENSTACK_KEYSTONE_DEFAULT_DOMAIN = 'Default' OPENSTACK_KEYSTONE_DEFAULT_ROLE = "user" TIME_ZONE = "Asia/Shanghai" systemctl restart httpd.service memcached.service controller节点安装完成,访问Dashboardhttp://192.168.137.145/dashboard/ 本文转自 OpenStack2015 博客,原文链接: http://blog.51cto.com/andyliu/2069169 如需转载请自行联系原作者

优秀的个人博客,低调大师

手撸了一个starter,同事直夸我666~

Spring Boot starter原理 Spring Boot 将常见的开发功能,分成了一个个的starter,这样我们开发功能的时候只需要引入对应的starter,而不需要去引入一堆依赖了!starter可以理解为一个依赖组,其主要功能就是完成引入依赖和初始化配置。Spring 官方提供的starter 命名规范为 spring-boot-starter-xxx ,第三方提供的starter命名规范为 xxx-spring-boot-starter 。 这里我们以 RocketMQ 的依赖 rocketmq-spring-boot-starter 来学习 starter的原理。 在项目中引入 rocketmq-spring-boot-starter 之后,实际上就引入了 rocketmq 的一些相关依赖。 在 rocketmq-spring-boot 中有一个自动装配的类RocketMQAutoConfiguration ,我截取了其中的一小段代码,一起来看看。 @Configuration @EnableConfigurationProperties(RocketMQProperties.class) @ConditionalOnClass({MQAdmin.class}) @ConditionalOnProperty(prefix = "rocketmq", value = "name-server", matchIfMissing = true) @Import({MessageConverterConfiguration.class, ListenerContainerConfiguration.class, ExtProducerResetConfiguration.class, RocketMQTransactionConfiguration.class}) @AutoConfigureAfter({MessageConverterConfiguration.class}) @AutoConfigureBefore({RocketMQTransactionConfiguration.class}) public class RocketMQAutoConfiguration { private static final Logger log = LoggerFactory.getLogger(RocketMQAutoConfiguration.class); public static final String ROCKETMQ_TEMPLATE_DEFAULT_GLOBAL_NAME = "rocketMQTemplate"; @Autowired private Environment environment; @Bean(destroyMethod = "destroy") @ConditionalOnBean(DefaultMQProducer.class) @ConditionalOnMissingBean(name = ROCKETMQ_TEMPLATE_DEFAULT_GLOBAL_NAME) public RocketMQTemplate rocketMQTemplate(DefaultMQProducer mqProducer, RocketMQMessageConverter rocketMQMessageConverter) { RocketMQTemplate rocketMQTemplate = new RocketMQTemplate(); rocketMQTemplate.setProducer(mqProducer); rocketMQTemplate.setMessageConverter(rocketMQMessageConverter.getMessageConverter()); return rocketMQTemplate; } } @Configuration 说明这是一个配置类,类中被@Bean注解了的方法,就是spring的一个bean,例如rocketMQTemplate。 @EnableConfigurationProperties,启用被@ConfigurationProperties的bean,这里引入了 RocketMQProperties 。 RocketMQProperties 就是需要在yml文件中写入的属性。 @ConfigurationProperties(prefix = "rocketmq") public class RocketMQProperties { private String nameServer; private String accessChannel; private Producer producer; private Consumer consumer = new Consumer(); } 在Spring Boot项目启动的时候默认只会扫描下级目录下带 @Configuration 注解的类,那么像本文中提到的 RocketMQAutoConfiguration 是如何扫描的呢?其实项目启动的时候会去加载项目中所有的 spring.factories 文件,然后加载对应的配置类,因此我们就需要在 spring.factories 中只指定需要扫描的类。 原理搞明白了,接下来我们就简单实现一个自己的starter!这个starter的主要作用就是给一个对象尾部拼接一个字符串! 一、新建项目 新建一个名为 javatip-spring-boot-starter 的项目,并且引入下面的依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter</artifactId> </dependency> 二、新增配置类 配置类对应的properties文件中的属性为javatip.name; @ConfigurationProperties(prefix = "javatip") public class JavatipPorperties { private String name; public String getName() { return name; } public void setName(String name) { this.name = name; } } 三、新增拼接字符串的方法 此方法主要就是为对象拼接一个固定的字符串 public class StrUt { private String name; public String strTo(Object object){ return object +"---"+ getName(); } public String getName() { return name; } public void setName(String name) { this.name = name; } } 四、新增自动配置类 使用注解 @EnableConfigurationProperties 启用 JavatipProperties 配置类 使用注解 @Configuration 配合 @Bean 注册一个拼接字符串的bean对象。 @Configuration @EnableConfigurationProperties(JavatipPorperties.class) public class JavatipAutoConfiguration { @Autowired private JavatipPorperties javatipPorperties; @Bean public StrUt strut(){ StrUt strut = new StrUt(); strut.setName(javatipPorperties.getName()); return strut; } } 五、新增配置发现文件 在resources文件夹中新建 META-INF 文件夹,在 META-INF 文件夹中新建配置发现文件 spring.factories,并且将自动配置类写到文件里。 org.springframework.boot.autoconfigure.EnableAutoConfiguration=com.javatip.str.configuration.JavatipAutoConfiguration 六、打包测试 使用 mvn install 命令将项目打包推送到本地maven仓库,然后新建一个测试项目,引入打包好的依赖。 <dependency> <groupId>com.javatip</groupId> <artifactId>javatip-spring-boot-starter</artifactId> <version>0.0.1-SNAPSHOT</version> </dependency> 在 application.yml 文件中写入自动拼接的字符串对应的属性 javatip.name 。 javatip: name: Java旅途 然后手写一个测试类: @RestController public class Test { @Autowired private StrUt strUt; @GetMapping("test") public String test(){ String str = strUt.strTo("who are you?"); return str; } } 运行测试类后,页面返回了 who are you?---Java旅途 这样,一个简单的starter就写好了,只要理解了starter的原理,实现起来就很简单,第一点就是starter相当于一个依赖组,另一点就是starter可以完成初始化配置。 点关注、不迷路 如果觉得文章不错,欢迎关注、点赞、收藏,你们的支持是我创作的动力,感谢大家。 如果文章写的有问题,请不要吝惜文笔,欢迎留言指出,我会及时核查修改。 如果你还想看到更多别的东西,可以微信搜索「Java旅途」进行关注。回复“手册”领取Java面试手册!

优秀的个人博客,低调大师

后端项目开发中写一手好SQL很有必要

最近和很多朋友交流关于数据分析中的SQL技能需求,昨天看了这篇文章,写的很好,给大家推荐一下。其中关于数据表设计、SQL优化部分需要重点阅读,第一部分「MySQL性能」了解即可。 全文共5758字,阅读大概需要20分钟,建议收藏,以下是作者zi'shu: 博主负责的项目主要采用阿里云数据库MySQL,最近频繁出现慢SQL告警,执行时间最长的竟然高达5分钟。导出日志后分析,主要原因竟然是没有命中索引和没有分页处理。其实这是非常低级的错误,我不禁后背一凉,团队成员的技术水平亟待提高啊。改造这些SQL的过程中,总结了一些经验分享给大家,如果有错误欢迎批评指正。 01 MySQL性能 1. 最大数据量 抛开数据量和并发数,谈性能都是耍流氓。MySQL没有限制单表最大记录数,它取决于操作系统对文件大小的限制。 文件系统 单文件大小限制 FAT32 最大4G NTFS 最大64GB NTFS5.0 最大2TB EXT2 块大小为1024字节,文件最大容量16GB;块大小为4096字节,文件最大容量2TB EXT3 块大小为4KB,文件最大容量为4TB EXT4 理论可以大于16TB 《阿里巴巴Java开发手册》提出单表行数超过500万行或者单表容量超过2GB,才推荐分库分表。性能由综合因素决定,抛开业务复杂度,影响程度依次是硬件配置、MySQL配置、数据表设计、索引优化。500万这个值仅供参考,并非铁律。 博主曾经操作过超过4亿行数据的单表,分页查询最新的20条记录耗时0.6秒,SQL语句大致是 select field_1,field_2 from table where id < #{prePageMinId} order by id desc limit 20 prePageMinId 是上一页数据记录的最小ID。虽然当时查询速度还凑合,随着数据不断增长,有朝一日必定不堪重负。分库分表是个周期长而风险高的大活儿,应该尽可能在当前结构上优化,比如升级硬件、迁移历史数据等等,实在没辙了再分。 对分库分表感兴趣的同学可以阅读分库分表的基本思想: https://www.cnblogs.com/jshen/p/7682502.html 2. 最大并发数 并发数是指同一时刻数据库能处理多少个请求,由max_connections和max_user_connections决定。 max_connections是指MySQL实例的最大连接数,上限值是16384,max_user_connections是指每个数据库用户的最大连接数。 MySQL会为每个连接提供缓冲区,意味着消耗更多的内存。如果连接数设置太高硬件吃不消,太低又不能充分利用硬件。一般要求两者比值超过10%,计算方法如下: max_used_connections / max_connections * 100% = 3/100 *100% ≈ 3% 查看最大连接数与响应最大连接数: show variables like '%max_connections%';show variables like '%max_user_connections%';在配置文件 my.cnf 中修改最大连接数 [mysqld]max_connections = 100max_used_connections = 20 3. 查询耗时0.5秒 建议将单次查询耗时控制在0.5秒以内,0.5秒是个经验值,源于用户体验的3秒原则。如果用户的操作3秒内没有响应,将会厌烦甚至退出。响应时间=客户端UI渲染耗时+网络请求耗时+应用程序处理耗时+查询数据库耗时,0.5秒就是留给数据库1/6的处理时间。 4. 实施原则 相比NoSQL数据库,MySQL是个娇气脆弱的家伙。它就像体育课上的女同学,一点纠纷就和同学闹别扭(扩容难),跑两步就气喘吁吁(容量小并发低),常常身体不适要请假(SQL约束太多)。 如今大家都会搞点分布式,应用程序扩容比数据库要容易得多,所以实施原则是数据库少干活,应用程序多干活。 充分利用但不滥用索引,须知索引也消耗磁盘和CPU。 不推荐使用数据库函数格式化数据,交给应用程序处理。 不推荐使用外键约束,用应用程序保证数据准确性。 写多读少的场景,不推荐使用唯一索引,用应用程序保证唯一性。 适当冗余字段,尝试创建中间表,用应用程序计算中间结果,用空间换时间。 不允许执行极度耗时的事务,配合应用程序拆分成更小的事务。 预估重要数据表(比如订单表)的负载和数据增长态势,提前优化。 02 数据表设计 1. 数据类型 数据类型的选择原则:更简单或者占用空间更小。 如果长度能够满足,整型尽量使用tinyint、smallint、medium_int而非int。 如果字符串长度确定,采用char类型。 如果varchar能够满足,不采用text类型。 精度要求较高的使用decimal类型,也可以使用BIGINT,比如精确两位小数就乘以100后保存。 尽量采用timestamp而非datetime。 类型 占据字节 描述 datetime 8字节 '1000-01-01 00:00:00.000000' to '9999-12-31 23:59:59.999999 timestamp 4字节 '1970-01-01 00:00:01.000000' to '2038-01-19 03:14:07.999999' 相比datetime,timestamp占用更少的空间,以UTC的格式储存自动转换时区。 2. 避免空值 MySQL中字段为NULL时依然占用空间,会使索引、索引统计更加复杂。从NULL值更新到非NULL无法做到原地更新,容易发生索引分裂影响性能。尽可能将NULL值用有意义的值代替,也能避免SQL语句里面包含is not null的判断。 3. text 类型优化 由于text字段储存大量数据,表容量会很早涨上去,影响其他字段的查询性能。建议抽取出来放在子表里,用业务主键关联。 4. 索引优化 1) 索引分类 普通索引:最基本的索引。 组合索引:多个字段上建立的索引,能够加速复合查询条件的检索。 唯一索引:与普通索引类似,但索引列的值必须唯一,允许有空值。 组合唯一索引:列值的组合必须唯一。 主键索引:特殊的唯一索引,用于唯一标识数据表中的某一条记录,不允许有空值,一般用primary key约束。 全文索引:用于海量文本的查询,MySQL5.6之后的InnoDB和MyISAM均支持全文索引。由于查询精度以及扩展性不佳,更多的企业选择Elasticsearch。 2)索引优化 分页查询很重要,如果查询数据量超过30%,MYSQL不会使用索引。 单表索引数不超过5个、单个索引字段数不超过5个。 字符串可使用前缀索引,前缀长度控制在5-8个字符。 字段唯一性太低,增加索引没有意义,如:是否删除、性别。 合理使用覆盖索引,如下所示: select login_name, nick_name from member where login_name = ?login_name, nick_name两个字段建立组合索引,比login_name简单索引要更快 5. SQL 优化 1)分批处理 博主小时候看到鱼塘挖开小口子放水,水面有各种漂浮物。浮萍和树叶总能顺利通过出水口,而树枝会挡住其他物体通过,有时还会卡住,需要人工清理。 MySQL就是鱼塘,最大并发数和网络带宽就是出水口,用户SQL就是漂浮物。不带分页参数的查询或者影响大量数据的update和delete操作,都是树枝,我们要把它打散分批处理,举例说明: 业务描述:更新用户所有已过期的优惠券为不可用状态。 SQL语句: update status=0 FROM `coupon` WHERE expire_date <= #{currentDate} and status=1; 如果大量优惠券需要更新为不可用状态,执行这条SQL可能会堵死其他SQL,分批处理伪代码如下: int pageNo = 1;int PAGE_SIZE = 100;while(true) { List<Integer> batchIdList = queryList('select id FROM `coupon` WHERE expire_date <= #{currentDate} and status = 1 limit #{(pageNo-1) * PAGE_SIZE},#{PAGE_SIZE}'); if (CollectionUtils.isEmpty(batchIdList)) { return; } update('update status = 0 FROM `coupon` where status = 1 and id in #{batchIdList}') pageNo ++;} 2)操作符<>优化 通常<>操作符无法使用索引,举例如下,查询金额不为100元的订单: select id from orders where amount != 100; 如果金额为100的订单极少,这种数据分布严重不均的情况下,有可能使用索引。鉴于这种不确定性,采用union聚合搜索结果,改写方法如下: (select id from orders where amount > 100) union all(select id from orders where amount < 100 and amount > 0) 3)OR 优化 在Innodb引擎下or无法使用组合索引,比如: select id,product_name from orders where mobile_no = '13421800407' or user_id = 100; OR无法命中mobile_no + user_id的组合索引,可采用union,如下所示: (select id,product_name from orders where mobile_no = '13421800407') union(select id,product_name from orders where user_id = 100);此时id和product_name字段都有索引,查询才最高效。 4)IN 优化 IN适合主表大子表小,EXIST适合主表小子表大。由于查询优化器的不断升级,很多场景这两者性能差不多一样了。 尝试改为join查询,举例如下: select id from orders where user_id in (select id from user where level = 'VIP'); 采用JOIN如下所示: select o.id from orders o left join user u on o.user_id = u.id where u.level = 'VIP'; 5)不做列运算 通询条件列运算会导致索引失效,如下所示: 查询当日订单 select id from order where date_format(create_time,'%Y-%m-%d') = '2019-07-01'; date_format函数会导致这个查询无法使用索引,改写后: select id from order where create_time between '2019-07-01 00:00:00' and '2019-07-01 23:59:59'; 6) 避免 select all 如果不查询表中所有的列,避免使用SELECT *,它会进行全表扫描,不能有效利用索引。 7)Like 优化 like 用于模糊查询,举个例子(field已建立索引): SELECT column FROM table WHERE field like '%keyword%'; 这个查询未命中索引,换成下面的写法: SELECT column FROM table WHERE field like 'keyword%'; 去除了前面的%查询将会命中索引,但是产品经理一定要前后模糊匹配呢?全文索引fulltext可以尝试一下,但Elasticsearch才是终极武器。 8)Join 优化 join的实现是采用Nested Loop Join算法,就是通过驱动表的结果集作为基础数据,通过该结数据作为过滤条件到下一个表中循环查询数据,然后合并结果。如果有多个join,则将前面的结果集作为循环数据,再次到后一个表中查询数据。 驱动表和被驱动表尽可能增加查询条件,满足ON的条件而少用Where,用小结果集驱动大结果集。 被驱动表的join字段上加上索引,无法建立索引的时候,设置足够的Join Buffer Size。 禁止join连接三个以上的表,尝试增加冗余字段。 9) Limit 优化 limit用于分页查询时越往后翻性能越差,解决的原则:缩小扫描范围,如下所示: select * from orders order by id desc limit 100000,10 耗时0.4秒select * from orders order by id desc limit 1000000,10耗时5.2秒 先筛选出ID缩小查询范围,写法如下: select * from orders where id > (select id from orders order by id desc limit 1000000, 1) order by id desc limit 0,10耗时0.5秒 如果查询条件仅有主键ID,写法如下: select id from orders where id between 1000000 and 1000010 order by id desc耗时0.3秒 如果以上方案依然很慢呢?只好用游标了,感兴趣的朋友阅读JDBC使用游标实现分页查询的方法 https://www.cnblogs.com/firstdream/p/7732656.html 03 其他数据库 作为一名后端开发人员,务必精通作为存储核心的MySQL或SQL Server,也要积极关注NoSQL数据库,他们已经足够成熟并被广泛采用,能解决特定场景下的性能瓶颈。 分类 数据库 特性 键值型 Memcache 用于内容缓存,大量数据的高访问负载 键值型 Redis 用于内容缓存,比Memcache支持更多的数据类型,并能持久化数据 列式存储 HBase Hadoop体系的核心数据库,海量结构化数据存储,大数据必备。 文档型 MongoDb 知名文档型数据库,也可以用于缓存 文档型 CouchDB Apache的开源项目,专注于易用性,支持REST API 文档型 SequoiaDB 国内知名文档型数据库 图形 Neo4J 用于社交网络构建关系图谱,推荐系统等 文章来源:https://www.cnblogs.com/xiaoyangjia/p/11267191.html

优秀的个人博客,低调大师

创始人培训班|阿里巴巴西溪园区一日游游学记

2017年6月7日,上海市中小企业发展服务中心联合阿里巴巴创新中心,经过精心策划准备、组织本市重点培育创业企业创始人培训班学员,赴杭州阿里巴巴西溪园区游学考察。帮助学员们学习阿里创业文化,进一步提升创业创新意识和能力,激发创业激情与智慧。 上午,110多名学员抵达阿里巴巴西溪园区。在“光明顶”的报告厅,阿里巴巴资深总监李树翀对各位学员的到来致以热烈的欢迎并分享了阿里巴巴的创业文化与理念。从“遇见未来”到内部团队创业,不断探索,不断创新。通过在全国各地建立创新中心,发挥阿里的平台优势,向创业者提供资源和服务,降低创业成本,降低创业门槛,提高创业成功率。与更多的创业者和团队合作共赢,为共同推动国家创新驱动发展战略的深入实施而努力。 随后,阿里巴巴战略发展部总监郭小龙向大家展示了阿里云可视化数据大屏,用交互的实时数据,深入介绍了天猫国际、菜

优秀的个人博客,低调大师

Apache DolphinScheduler 8 月报:权限安全加固,调度补火上线,性能与稳定性持续提升

Apache DolphinScheduler 8 月月报来啦!过去一个月,社区持续推进项目迭代,在功能优化、性能提升和生态建设等方面不断取得新进展。让我们一起看看 8 月 DolphinScheduler 又有哪些值得关注的更新,也感谢每一位参与贡献、积极反馈和支持社区的小伙伴,正是大家的共同努力,让 DolphinScheduler 持续成长!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册