首页 文章 精选 留言 我的

精选列表

搜索[共享带宽包],共10000篇文章
优秀的个人博客,低调大师

DC学院爬虫学习笔记(六):浏览器抓包及headers设置

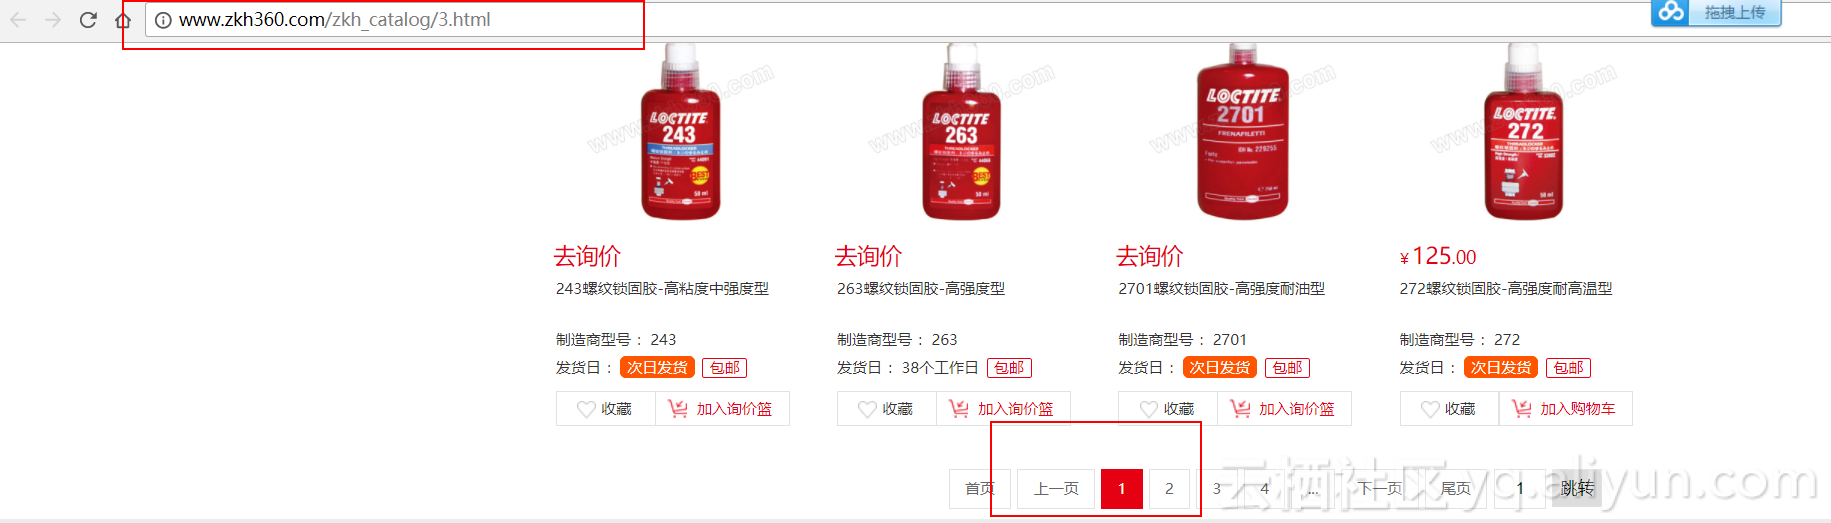
爬虫的一般思路: 抓取网页、分析请求 解析网页、寻找数据 储存数据、多页处理 - 分析具体网页请求: 1. 观察以下网址翻页后的URL: http://www.zkh360.com/zkh_catalog/3.html 可以看到,有些网址翻页后URL是不变的,那该怎么爬取,请看下文。 2. 使用谷歌浏览器分析网页的真实请求 谷歌浏览器——检查——Network 首先清空请求列表,点击下一页(第2页) 在请求列表里查找真实的请求,可发现包含商品信息的真实请求为: http://www.zkh360.com/Product/SearchProduct?catalogueId=3&pageIndex=2&pageSize=20 箭头所指的地方就是真实请求 以下是第2、3、4页的请求,通过对比可以发现网站是通过pageIndex参数控制翻页的,并且pageSize参数删去之后并不会对请求产生影响 第2页:http://www.zkh360.com/Product/SearchProduct?catalogueId=3&pageIndex=2&pageSize=20 第3页:http://www.zkh360.com/Product/SearchProduct?catalogueId=3&pageIndex=3&pageSize=20 第4页:http://www.zkh360.com/Product/SearchProduct?catalogueId=3&pageIndex=4&pageSize=20 有关参数的信息可以在Hearders的Query String Parameters里查找到 翻页后URL不发生变化的网站的数据一般都是通过Ajax或者JavaScript加载的,可以在过滤器的XHR或者JS中找到真实请求 3. 寻找真实请求的三个步骤 分析:使用谷歌浏览器开发者工具分析网页的请求 测试:测试URL请求中每个参数的作用,找出控制翻页等功能的参数 重复:多次重复寻找符合爬虫需要的真实请求 实战:爬取知乎 通过爬取知乎“轮子哥”——vczh关注的人分析Ajax或者JavaScript加载的数据的真实请求并展示这种爬取方法的具体过程。 1. 寻找真实请求的测试 首先,进入“轮子哥——vczh”关注的人的页面(注意:需要先登录个人知乎账号) 通过禁止JavaScript加载的方法发现页面不能正常加载,确认该页面的翻页是通过JavaScript加载数据实现的 使用谷歌浏览器开发者工具寻找包含关注人信息的真实请求,可以发现真实请求是以“followees”开头的请求,其返回一个JSON格式的数据,该数据对应下一页的“他关注的人”: 双击这个请求,返回一个JSON格式的数据,可以通过安装JSONView插件在浏览器中更好地显示该数据 接下来便可以尝试爬取该请求的数据 2. 尝试爬取真实请求的数据 首先使用requests.get()尝试爬取数据 # -*- coding:utf-8 -*- import requests url = 'https://www.zhihu.com/api/v4/members/excited-vczh/followees?include=data%5B*%5D.answer_count%2Carticles_count%2Cgender%2Cfollower_count%2Cis_followed%2Cis_following%2Cbadge%5B%3F(type%3Dbest_answerer)%5D.topics&offset=20&limit=20' response = requests.get(url).text print(response) <html><body><h1>500 Server Error</h1> An internal server error occured. </body></html> 可以发现返回了“500 Server Error”,即由于网站反爬虫的原因,服务器返回了“500服务错误” 该问题可以通过添加hearders请求头信息解决 3. 添加hearders请求头信息模拟浏览器访问 请求头信息承载了关于客户端浏览器、请求页面、服务器等相关的信息,用来告知服务器发起请求的客户端的具体信息 知乎的反爬虫机制是通过核对请求头信息实现的,所以需要在使用requests请求数据的时候加上所需的请求头 对比知乎的请求头信息和常见的请求头信息,发现知乎请求头多了authorization和X-UDID的信息 在爬虫程序中添加请求头信息,即添加headers # -*- coding:utf-8 -*- import requests headers = { 'authorization':'Bearer 2|1:0|10:1519311205|4:z_c0|92:Mi4xeVFXVEF3QUFBQUFBVUd2WmJrTXJEU2NBQUFDRUFsVk5aV2EyV2dBdzY2cTlRY0JHTkc0TkpMalZwOXBkRkowby13|d5a54e1ffbdf3097b4c79eb2dbf297e9c6b55971566d830ce33f8852601375ee ', #括号中填上你的authorization 'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.119 Safari/537.36',#括号中填上你的User-Agent } url = 'https://www.zhihu.com/api/v4/members/excited-vczh/followees?include=data%5B*%5D.answer_count%2Carticles_count%2Cgender%2Cfollower_count%2Cis_followed%2Cis_following%2Cbadge%5B%3F(type%3Dbest_answerer)%5D.topics&offset=20&limit=20' response= requests.get(url, headers = headers).json() ##print(response) 注:刚才写的时候出问题了,说是User-Agent问题,查了半天,发现是在最前面多了个空格。。 运行程序,成功返回数据 4. 使用pandas把数据保存入库 pandas DataFrame的from_dict()方法可以很方便地把爬取到的数据保存为DataFrame格式的结构化数据 import pandas as pd response= requests.get(url, headers = headers).json()['data'] #添加上['data']是因为关注人的信息是保存在data下面的,只需要这一部分的数据 df = pd.DataFrame.from_dict(response) df.to_csv('user.csv') 5. 定义函数实现翻页爬取 定义一个get_user_data()函数,实现翻页爬取功能,并添加上爬取时间间隔以免由于爬取太频繁给服务器造成负担 import time user_data = [] def get_user_data(page): for i in range(page): url = 'https://www.zhihu.com/api/v4/members/excited-vczh/followees?include=data%5B*%5D.answer_count%2Carticles_count%2Cgender%2Cfollower_count%2Cis_followed%2Cis_following%2Cbadge%5B%3F(type%3Dbest_answerer)%5D.topics&offset={}&limit=20'.format(i*20) response = requests.get(url, headers=headers).json()['data'] user_data.extend(response) #把response数据添加进user_data print('正在爬取第%s页' % str(i+1)) time.sleep(1) #设置爬取网页的时间间隔为1秒 if __name__ == '__main__': get_user_data(10) df = pd.DataFrame.from_dict(user_data) df.to_csv('users2.csv') 正在爬取第1页 正在爬取第2页 正在爬取第3页 正在爬取第4页 正在爬取第5页 正在爬取第6页 正在爬取第7页 正在爬取第8页 正在爬取第9页 正在爬取第10页 ok,成功解决

优秀的个人博客,低调大师

GAN发展历程综述:送你最易入手的几个架构 | 附资料包

本文来自AI新媒体量子位(QbitAI) 怎样教机器画一张从未见过的人脸呢?我们知道计算机可以存储大量照片,但它并不知道像素与外观是如何关联起来的。 多年来,各种各样的生成模型都试图解决这个问题。它们使用不同的假设模拟底层数据分布,但那些假设通常并不实用。 目前的实现方法都不是最优解:隐马尔可夫模型生成的文本非常枯燥,由上一句就能预测下一句;变分自编码器(Variational Autoencoders)生成的图像是模糊的,图像之间尽管名称不同,但实际上变化很小,缺乏多样性。 要解决这些问题就要采用一种全新的方法,生成式对抗网络(GAN)应运而生。 在这篇文章中,我们会全面介绍GAN的基础概念,展示其主要架构,并提供大量能显著优化结果的技巧。 GAN的发明 生成模型主要是用来收集训练样本并表示样本的概率分布,解决方案通常是直接推断其概率密度函数

优秀的个人博客,低调大师

AT&T与思科Avent签署IoT开发工具包协议

日前,AT&T宣布已经与思科和Avent为开始物联网项目的开发人员推出物联网入门套件。 该AT&T物联网入门套件提供了物联网创新所需的所有工具,包括4G连接、LTE硬件、应用服务、云存储等。 物联网开发企业Sensamo首席执行官Mike Reich表示:“着手物联网最大的障碍之一是从瞬息万变的硬件和软件中选择最合适的。” AT&T表示开发人员将有权使用AT&T控制中心和思科的物联网服务平台管理他们的连接设备。 AT&T将提供与其他第三方物联网解决方案协同的各种物联网入门套件不同版本。其中包括通过IBM Watson物联网平台为开发者专门设计的版本以及集成了思科物联网服务平台的微软物联网套件Azure IoT Suite。 思科云计算物联网市场部负责人Martyn Etherington表示:“物联网开发者在通过连接设备提供全新有价值服务的应用发展中发挥着关键作用。” ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

一台电脑为什么能替整个内网访问 Internet,彻底理解 Internet 连接共享与 NAT

在 Windows 11 里打开 Mobile hotspot,一台原本只是普通终端的笔记本电脑,很快就能变成其他设备访问 Internet 的入口。Microsoft 当前的文档明确支持把已有的 Wi-Fi、Ethernet 或蜂窝网络连接通过 Wi-Fi 或 Bluetooth 分享给其他设备。Windows 体系里与这个能力密切相关的,就是 Internet Connection Sharing,也就是常说的 ICS。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册