首页 文章 精选 留言 我的

精选列表

搜索[k],共10000篇文章
优秀的个人博客,低调大师

我参与了两个接近100k+star的开源项目!聊聊开源项目贡献指南

给 SkyWalking 以及 JavaGuide 项目贡献后的总结 JavaGuide: https://github.com/Snailclimb/JavaGuide SkyWalking: https://github.com/apache/skywalking 1. 本地开发 以 SkyWalking 举例。在本地编译源码前,先查看相关的文档:https://github.com/apache/skywalking/blob/v8.0.1/docs/en/guides/How-to-build.md 。大致了解后,我们就可以开始操作了。 在 Github 上 fork 你想要贡献的项目 接着在本地拉取自己的项目: git clone --recurse-submodules https://github.com/$Name/skywalking.git 这是因为 SkyWalking 它包含了子仓库,因此加入了 --recurse-submodules 参数,它可以把主仓库和子仓库源码都同时拉取。 代码拉到本地后,接着我们使用 idea 打开该项目。但是可能我们网络不够给力或有“奇怪的力量”干扰,我们则需要改动一些配置以方便快速编译。对 maven 来说一般都是设置 maven 加速器,如果你拉的是 docker 相关,还需要配置 docker 容器阿里云地址加速。而我们这里主要是设置 maven 阿里云镜像以及 npm 设置淘宝镜像。 1.1 设置 maven 加速 当你执行 ./mvnw clean package -DskipTests 会发现以下很慢: 说明从 apache.snapshots 仓库拉的很慢,因此我们对它使用镜像仓库代理,其中 mirrorOf 指定对某个仓库镜像做镜像代理加速,建议 mirrorOf 做明确指定代码的镜像仓库,避免直接使用 * 代理所有镜像,导致你公司的私仓或其它仓库出现拉不到包的情况: <?xmlversion="1.0"encoding="UTF-8"?><settingsxmlns="http://maven.apache.org/SETTINGS/1.0.0"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://maven.apache.org/SETTINGS/1.0.0http://maven.apache.org/xsd/settings-1.0.0.xsd"><mirrors><mirror><id>aliyun-apache.snapshots</id><mirrorOf>apache.snapshots</mirrorOf><name>aliyun-for-apahce.snapshots</name><url>https://maven.aliyun.com/repository/apache-snapshots</url></mirror></mirrors></settings> 接着再执行 ./mvnw clean package -DskipTests,就发现开始使用我们代理仓库下载了: 同理对 center 仓库也做代理: <mirror><id>aliyun-center</id><mirrorOf>center</mirrorOf><name>aliyun-for-center</name><url>https://maven.aliyun.com/repository/public</url></mirror> 1.2 设置 npm 加速 因为有些项目里面包含前端项目(例如 Skywalking-ui),并且前端使用了 node 技术,则建议用淘宝镜像加速,在这个案例中,如下 skywalking/apm-webapp 模块中代码如下:它使用了插件来执行 npm 命令用于生成前端代码,但是 npm 拉依赖包会比较慢,因此这里修改为淘宝镜像地址:将 registry.npmjs.org 修改为:registry.npm.taobao.org。 1.3 编译 还有其它的设置,例如在 SkyWalking 中需要设置 gRPC 为源码包等,因为在官方的文档有详细步骤,就不做说明了。而 JavaGuide 项目不用编译,打开即可,都是 md 类型的文档。 2. 提 Issue 本地代码编译后,接着你可能会有两个操作: 你发现仓库中有个地方的代码写的不好,而且你正好对这块代码所涉及的技术深有研究,那么你先不用直接写代码,而是先去对应的仓库提 Issue,因为很多的仓库,不会莫名其妙的接收用户的 PR,需要先有对应的 Issue,便于作者了解需要改进的地方或知道你即将发起 PR 的缘由。 Issue 一般会有模板并用 markdown 语法,只需要清楚的表达自己的问题描述就可以了。 你发现仓库已有了某个 Issue,而且你知道怎么解决该问题,以 JavaGuide 举例,里面有时候会有些文字描述不当或文章有错别字等这些错误,这对大家来说改进比较容易,因此你可以直接在本地新建分支做对应的改动。 2.1 Issue 艺术 Issue 本质也类似于提问,因此需要清楚的表达你的疑惑并能让别人看得懂。假如你是作者,你看到你的仓库有如下两个 Issue,你更加中意哪个? 但是很多项目都是要求英语交流,我都是先通过谷歌翻译,接着看下翻译之后的地方哪里表述有问题,再自己手动调整,其实表述大家都看得懂,还能顺便学英语,例如我之前的 Issue: 2.2 Issue 的交流 一般 Issue 提出后,都会有相关的人做讨论和交流。以 JavaGuide 举例,里面有些 Issue 讨论也可以学到很多的东西的,如下: 上图可以看出作者对这类文章标记了 discuss 标签,这样你可以更加方便的搜索该标签查找有价值的 Issue 了。 2.3 本地基本操作 这时候我们可以撸起袖子敲代码了。定位你想要修改的代码块,你可以动手本地新建分支,修改,测试代码。注意:秉承一个分支改动一个功能点的理念。你改动代码时,建议只改动 Issue 提及的相关的代码,如果你想这个分支做多个改动,记得同步到 Issue 中。但是如果你发现了另一个改进点,但是这两个改进点无任何联系,建议再新建个 Issue,并再建个分支,在两个分支分别做改动。这样主要是如下理由: 假如你在改动点 1 的代码有问题,而在改动点 2 的代码没问题。但是由于它们是两个独立的分支,因此就不会互相影响,作者可以先 merge 你的分支 2(在公司也建议如下操作,一个分支一个改动点,方便出问题回滚)。 如果你本地做了多个提交,建议使用 git rebase 命令将多个提交合并为一个提交(仅建议)。 涉及到的基本命令: 本地新建分支: git checkout -b feature/word_typo 本地所有改动加入暂存区: git add . 将暂存区提交: git commit -m "commit message" 增加原仓库上游地址: git remote add upstream https://github.com/apache/skywalking.git 与远程 master 分支合并: git merge upstream/master 提交到自己的远程仓库: git push --set-upstream origin feature/word_typo 对第 4 步的解释:因为你本地仓库的远程地址默认为你自己的远程仓库,但是你需要实时和源仓库做同步更新,因此你额外需要保存源仓库的地址,用于与源 master 合并,同步来自源仓库的最新代码。 3. 准备 PR 3.1 PR 通过 当你 push 当你的远程仓库后,此时你打开源仓库,你会发现多了如下提示:我们点击 Compare & pull request 按钮,就会到 PR 界面了,如果作者配置了 PR 模板,我们跟着提示输入即可,PR 界面主要做两个事: 查看你本次提交代码与源仓库主干的改动点。 与作者讨论此时 PR 的代码,以及你此时 PR 的理由(在这里你可以使用 #111 来与你之前的 Issue 做关联)。 做对应的持续集成。 如果跟作者进行友好的交流讨论后,没什么问题,你的 PR 就会被合并接着在源仓库中就会显示当前的 PR 标题,以及你 PR 对应的 Issue。 3.2 PR 不通过 但是更多时候 PR 会不通过,一般大概有两种: 代码审核不通过:你提交的 PR 代码有问题,审核你代码的作者会在 PR 讨论跟你说哪里有问题,哪个地方需要改进,我们只需要跟着改动即可。 CI(持续集成) 有问题。这表明你的代码没问题,但是单元测试或持续集成验证没通过:在大型项目中,都会集成持续集成方案,如果你公司已经在使用了 CI,那就比较熟练了,跟着 Docker 报错日志仔细看看哪个地方有问题就行了。以 SkyWalking 举例,它有个持续集成的测试步骤是这样的:启动 Docker 模拟项目启动,模拟对应的请求,并与预期结果文件做对比,如果发现响应与预期结果文本对比异常,就会报错不通过。这种情况我们可以通过 Github 的 Action 日志做排查。 这里建议了解如下: Github Action:持续集成方案。公司一般会用 GitLab/ Jenkins 多点。大概是监听你的代码某个分支的提交/合并来做一系列的事,比如触发某个脚本等。 Codecov:测试覆盖率方案。公司一般会用 Sonar 比较多。 Checkstyle:如果你代码没问题,但是规则检查没通过,也会不允许合并。具体是注释不规范还是代码格式不规范查看具体的报错即可。 4. 跟踪项目进度 我们想实时跟进项目的进度或讨论的话,可以有以下方式(国外的讨论方式就不做列举了)分别以 JavaGuide 和 SkyWalking 举例: RSS 订阅 Issue 相关信息,例如: https://rsshub.app/github/issue/Snailclimb/JavaGuide 。最后两个为变量,可以自由修改,规则为:UserName/RepositoryName 加入群/关注 B 站,探(mo)讨(yu)技术 邮件订阅,具体参考 dubbo: http://dubbo.apache.org/zh-cn/docs/developers/contributor-guide/mailing-list-subscription-guide_dev.html。适用于任何 apahce 项目,记得把 dubbo 改为具体项目即可(这里改为 skywalking)。 参加线下活动:例如和某个社区伙伴面基、在活动行 APP 里面中关注项目线下宣传什么的(而且阿里云相关的线下活动都有抽奖和零食)。 5. 额外 实际上,我们需要额外的插件来提高我们的效率。 Github 插件推荐两个: Octotree用于可视化 Github 项目文件层级,你不用一个一个点进去就能看到全貌了。 GitZip 用于单独下载某个文件/文件夹,不用为了下载某个文件,要把整个项目下载下来。 idea 插件推荐一个:Maven Help:分析某个 maven 项目的依赖关系,以及查找某个包被哪几个依赖给同时依赖的,在复杂项目中,分析项目的依赖关系很方便。 其实关注 JavaGuide 微信公众号的都会了解 JavaGuide 项目,但是项目贡献的人很少,也有很多人很久没有再继续贡献和讨论了。这篇文章只是做抛砖引玉,希望大家能能了解 JavaGuide 原项目,当然能参与进来贡献那肯定是最好的。毕竟 JavaGuide 是我贡献的开源项目里坚持最久的~希望它能一直活力四射~ 最后 我整理的4本PDF文档,本公众号后台回复“面试突击”即可免费获取。 文章有帮助可以点个「在看」或「分享」,都是支持,我都喜欢! 我是Guide哥,Java后端开发,会一点前端知识,喜欢烹饪,自由的少年。一个三观比主角还正的技术人。我们下期再见! 往期推荐 大白话带你认识 ZooKeeper !重要概念一网打尽! 简单聊聊为什么有些大公司技术弱爆了? 入职外包3个月,我离职了... 为什么我要从 Windows 切换到 Linux? 以 B 站为例,聊聊站内消息系统的设计 来吧!手写一个 RPC 框架。毕设/项目经验稳了! 本文分享自微信公众号 - JavaGuide(JavaGuide)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

一道价值25k的腾讯递归组件面试题(Vue3 + TS 实现)

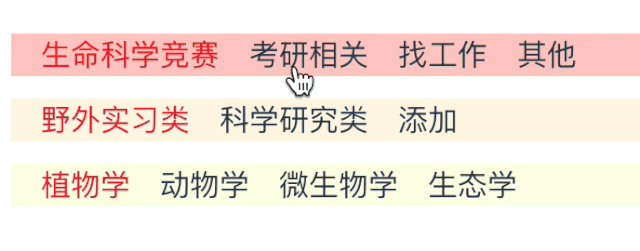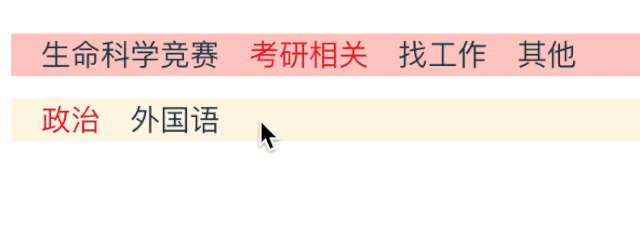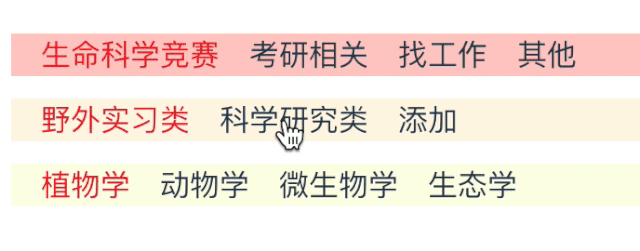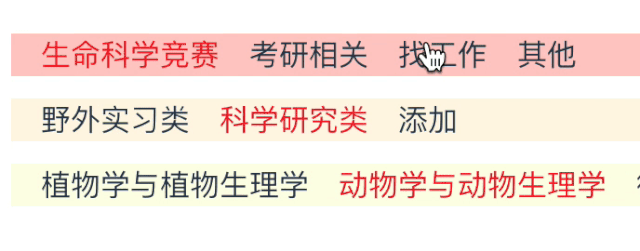
前言 小伙伴们好久不见,最近刚入职新公司,需求排的很满,平常是实在没时间写文章了,更新频率会变得比较慢。 周末在家闲着无聊,突然小弟过来紧急求助,说是面试腾讯的时候,对方给了个 Vue 的递归菜单要求实现,回来找我复盘。 正好这周是小周,没想着出去玩,就在家写写代码吧,我看了一下需求,确实是比较复杂,需要利用好递归组件,正好趁着这个机会总结一篇 Vue3 + TS 实现递归组件的文章。 需求 可以先在 Github Pages[1] 中预览一下效果。 需求是这样的,后端会返回一串可能有无限层级的菜单,格式如下: [{id:1,father_id:0,status:1,name:'生命科学竞赛',_child:[{id:2,father_id:1,status:1,name:'野外实习类',_child:[{id:3,father_id:2,status:1,name:'植物学'}],},{id:7,father_id:1,status:1,name:'科学研究类',_child:[{id:8,father_id:7,status:1,name:'植物学与植物生理学'},{id:9,father_id:7,status:1,name:'动物学与动物生理学'},{id:10,father_id:7,status:1,name:'微生物学'},{id:11,father_id:7,status:1,name:'生态学'},],},{id:71,father_id:1,status:1,name:'添加'},],},{id:56,father_id:0,status:1,name:'考研相关',_child:[{id:57,father_id:56,status:1,name:'政治'},{id:58,father_id:56,status:1,name:'外国语'},],},] 每一层的菜单元素如果有 _child 属性, 这一项菜单被选中以后就要继续展示这一项的所有子菜单,预览一下动图: 并且点击其中的任意一个层级,都需要把菜单的 完整的 id 链路 传递到最外层,给父组件请求数据用。比如点击了 科学研究类。那么向外 emit 的时候还需要带上它的第一个子菜单 植物学与植物生理学 的 id,以及它的父级菜单 生命科学竞赛 的 id,也就是 [1, 7, 8]。 每一层的样式还可以自己定制。 实现 这很显然是一个递归组件的需求,在设计递归组件的时候,我们要先想清楚数据到视图的映射。 在后端返回的数据中,数组的每一层可以分别对应一个菜单项,那么数组的层则就对应视图中的一行,当前这层的菜单中,被点击选中 的那一项菜单的 child 就会被作为子菜单数据,交给递归的 NestMenu 组件,直到某一层的高亮菜单不再有 child,则递归终止。 由于需求要求每一层的样式可能是不同的,所以再每次调用递归组件的时候,我们都需要从父组件的 props 中拿到一个 depth 代表层级,并且把这个 depth + 1 继续传递给递归的 NestMenu 组件。 重点主要就是这些,接下来编码实现。 先看 NestMenu 组件的 template 部分的大致结构: <template><divclass="wrap"><divclass="menu-wrap"><divclass="menu-item"v-for="menuItemindata">{{menuItem.name}}</div></div><nest-menu:key="activeId":data="subMenu":depth="depth+1"></nest-menu></div></template> 和我们预想设计中的一样, menu-wrap 代表当前菜单层, nest-menu 则就是组件本身,它负责递归的渲染子组件。 首次渲染 在第一次获取到整个菜单的数据的时候,我们需要先把每层菜单的选中项默认设置为第一个子菜单,由于它很可能是异步获取的,所以我们最好是 watch 这个数据来做这个操作。 //菜单数据源发生变化的时候默认选中当前层级的第一项constactiveId=ref<number|null>(null)watch(()=>props.data,(newData)=>{if(!activeId.value){if(newData&&newData.length){activeId.value=newData[0].id}}},{immediate:true,}) 现在我们从最上层开始讲起,第一层的 activeId 被设置成了 生命科学竞赛 的 id,注意我们传递给递归子组件的 data ,也就是 生命科学竞赛 的 child,是通过 subMenu 获取到的,它是一个计算属性: constgetActiveSubMenu=()=>{returndata.find(({id})=>id===activeId.value)._child}constsubMenu=computed(getActiveSubMenu) 这样,就拿到了 生命科学竞赛 的 child,作为子组件的数据传递下去了。 点击菜单项 回到之前的需求设计,在点击了菜单项后,无论点击的是哪层,都需要把完整的 id 链路通过 emit 传递到最外层去,所以这里我们需要多做一些处理: /***递归收集子菜单第一项的id*/constgetSubIds=(child)=>{constsubIds=[]consttraverse=(data)=>{if(data&&data.length){constfirst=data[0]subIds.push(first.id)traverse(first._child)}}traverse(child)returnsubIds}constonMenuItemClick=(menuItem)=>{constnewActiveId=menuItem.idif(newActiveId!==activeId.value){activeId.value=newActiveIdconstchild=getActiveSubMenu()constsubIds=getSubIds(child)//把子菜单的默认第一项ids也拼接起来向父组件emitcontext.emit('change',[newActiveId,...subIds])}} 由于我们之前定的规则是,点击了新的菜单以后默认选中子菜单的第一项,所以这里我们也递归去找子菜单数据里的第一项,放到 subIds 中,直到最底层。 注意这里的 context.emit("change", [newId, ...subIds]);,这里是把事件向上 emit,如果这个菜单是中间层级的菜单,那么它的父组件也是 NestMenu,我们需要在父层级递归调用 NestMenu 组件的时候监听这个 change 事件。 <nest-menu:key="activeId"v-if="activeId!==null":data="getActiveSubMenu()":depth="depth+1"@change="onSubActiveIdChange"></nest-menu> 在父层级的菜单接受到了子层级的菜单的 change 事件后,需要怎么做呢?没错,需要进一步的再向上传递: constonSubActiveIdChange=(ids)=>{context.emit('change',[activeId.value].concat(ids))} 这里就只需要简单的把自己当前的 activeId 拼接到数组的最前面,再继续向上传递即可。 这样,任意一层的组件点击了菜单后,都会先用自己的 activeId 拼接好所有子层级的默认 activeId,再一层层向上 emit。并且向上的每一层父菜单都会把自己的 activeId 拼在前面,就像接力一样。 最后,我们在应用层级的组件里,就可以轻松的拿到完整的 id 链路: <template><nest-menu:data="menu"@change="activeIdsChange"/></template>exportdefault{methods:{activeIdsChange(ids){this.ids=ids;console.log("当前选中的id路径",ids);},}, 样式区分 由于我们每次调用递归组件的时候,都会把 depth + 1,那么就可以通过把这个数字拼接到类名后面来实现样式区分了。 <template><divclass="wrap"><divclass="menu-wrap":class="`menu-wrap-${depth}`"><divclass="menu-item">{{menuItem.name}}</div></div><nest-menu/></div></template><style>.menu-wrap-0{background:#ffccc7;}.menu-wrap-1{background:#fff7e6;}.menu-wrap-2{background:#fcffe6;}</style> 默认高亮 上面的代码写完后,应对没有默认值时的需求已经足够了,这时候面试官说,产品要求这个组件能通过传入任意一个层级的 id 来默认展示高亮。 其实这也难不倒我们,稍微改造一下代码,在父组件里假设我们通过 url 参数或者任意方式拿到了一个 activeId,先通过深度优先遍历的方式查找到这个 id 的所有父级。 constactiveId=7constfindPath=(menus,targetId)=>{letidsconsttraverse=(subMenus,prev)=>{if(ids){return}if(!subMenus){return}subMenus.forEach((subMenu)=>{if(subMenu.id===activeId){ids=[...prev,activeId]return}traverse(subMenu._child,[...prev,subMenu.id])})}traverse(menus,[])returnids}constids=findPath(data,activeId) 这里我选择在递归的时候带上上一层的 id,在找到了目标 id 以后就能轻松的拼接处完整的父子 id 数组。 然后我们把构造好的 ids 作为 activeIds 传递给 NestMenu,此时这时候 NestMenu 就要改变一下设计,成为一个「受控组件」,它的渲染状态是受我们外层传递的数据控制的。 所以我们需要在初始化参数的时候改变一下取值逻辑,优先取 activeIds[depth] ,并且在点击菜单项的时候,要在最外层的页面组件中,接收到 change 事件时,把 activeIds 的数据同步改变。这样继续传递下去才不会导致 NestMenu 接收到的数据混乱。 <template><nest-menu:data="data":defaultActiveIds="ids"@change="activeIdsChange"/></template> NestMenu 初始化的时候,对有默认值的情况做一下处理,优先使用数组中取到的 id 值。 setup(props:IProps,context){const{depth=0,activeIds}=props;/***这里activeIds也可能是异步获取到的所以用watch保证初始化*/constactiveId=ref<number|null|undefined>(null);watch(()=>activeIds,(newActiveIds)=>{if(newActiveIds){constnewActiveId=newActiveIds[depth];if(newActiveId){activeId.value=newActiveId;}}},{immediate:true,});} 这样,如果 activeIds 数组中取不到的话,默认还是 null,在 watch 到菜单数据变化的逻辑中,如果 activeId 是 null 的话,会被初始化为第一个子菜单的 id。 watch(()=>props.data,(newData)=>{if(!activeId.value){if(newData&&newData.length){activeId.value=newData[0].id}}},{immediate:true,}) 在最外层页面容器监听到 change 事件的时候,要把数据源同步一下: <template><nest-menu:data="data":activeIds="ids"@change="activeIdsChange"/></template><script>import{ref}from"vue";exportdefault{name:"App",setup(){constactiveIdsChange=(newIds)=>{ids.value=newIds;};return{ids,activeIdsChange,};},};</script> 如此一来,外部传入 activeIds 的时候,就可以控制整个 NestMenu 的高亮选中逻辑了。 数据源变动引发的 bug。 这时候,面试官对着你的 App 文件稍作改动,然后演示了这样一个 bug: App.vue 的 setup 函数中加了这样的一段逻辑: onMounted(()=>{setTimeout(()=>{menu.value=[data[0]].slice()},1000)}) 也就是说,组件渲染完成后过了一秒,菜单的最外层只剩下一项了,这时候面试官在一秒之内点击了最外层的第二项,这个组件在数据源改变之后,会报错: 这是因为数据源已经改变了,但是组件内部的 activeId 状态依然停留在了一个已经不存在了的 id 上。 这会导致 subMenu 这个 computed 属性在计算时出错。 我们对 watch data 观测数据源的这段逻辑稍加改动: watch(()=>props.data,(newData)=>{if(!activeId.value){if(newData&&newData.length){activeId.value=newData[0].id}}//如果当前层级的data中遍历无法找到`activeId`的值说明这个值失效了//把它调整成数据源中第一个子菜单项的idif(!props.data.find(({id})=>id===activeId.value)){activeId.value=props.data?.[0].id}},{immediate:true,//在观测到数据变动之后同步执行这样会防止渲染发生错乱flush:'sync',}) 注意这里的 flush: "sync" 很关键,Vue3 对于 watch 到数据源变动之后触发 callback 这一行为,默认是以 post 也就是渲染之后再执行的,但是在当前的需求下,如果我们用错误的 activeId 去渲染,就会直接导致报错了,所以我们需要手动把这个 watch 变成一个同步行为。 这下再也不用担心数据源变动导致渲染错乱了。 完整代码 App.vue <template><nest-menu:data="data":activeIds="ids"@change="activeIdsChange"/></template><script>import{ref}from"vue";importNestMenufrom"./components/NestMenu.vue";importdatafrom"./menu.js";import{getSubIds}from"./util";exportdefault{name:"App",setup(){//假设默认选中id为7constactiveId=7;constfindPath=(menus,targetId)=>{letids;consttraverse=(subMenus,prev)=>{if(ids){return;}if(!subMenus){return;}subMenus.forEach((subMenu)=>{if(subMenu.id===activeId){ids=[...prev,activeId];return;}traverse(subMenu._child,[...prev,subMenu.id]);});};traverse(menus,[]);returnids;};constids=ref(findPath(data,activeId));constactiveIdsChange=(newIds)=>{ids.value=newIds;console.log("当前选中的id路径",newIds);};return{ids,activeIdsChange,data,};},components:{NestMenu,},};</script> NestMenu.vue <template><divclass="wrap"><divclass="menu-wrap":class="`menu-wrap-${depth}`"><divclass="menu-item"v-for="menuItemindata":class="getActiveClass(menuItem.id)"@click="onMenuItemClick(menuItem)":key="menuItem.id">{{menuItem.name}}</div></div><nest-menu:key="activeId"v-if="subMenu&&subMenu.length":data="subMenu":depth="depth+1":activeIds="activeIds"@change="onSubActiveIdChange"></nest-menu></div></template><scriptlang="ts">import{watch,ref,onMounted,computed}from"vue";importdatafrom"../menu";interfaceIProps{data:typeofdata;depth:number;activeIds?:number[];}exportdefault{name:"NestMenu",props:["data","depth","activeIds"],setup(props:IProps,context){const{depth=0,activeIds,data}=props;/***这里activeIds也可能是异步获取到的所以用watch保证初始化*/constactiveId=ref<number|null|undefined>(null);watch(()=>activeIds,(newActiveIds)=>{if(newActiveIds){constnewActiveId=newActiveIds[depth];if(newActiveId){activeId.value=newActiveId;}}},{immediate:true,flush:'sync'});/***菜单数据源发生变化的时候默认选中当前层级的第一项*/watch(()=>props.data,(newData)=>{if(!activeId.value){if(newData&&newData.length){activeId.value=newData[0].id;}}//如果当前层级的data中遍历无法找到`activeId`的值说明这个值失效了//把它调整成数据源中第一个子菜单项的idif(!props.data.find(({id})=>id===activeId.value)){activeId.value=props.data?.[0].id;}},{immediate:true,//在观测到数据变动之后同步执行这样会防止渲染发生错乱flush:"sync",});constonMenuItemClick=(menuItem)=>{constnewActiveId=menuItem.id;if(newActiveId!==activeId.value){activeId.value=newActiveId;constchild=getActiveSubMenu();constsubIds=getSubIds(child);//把子菜单的默认第一项ids也拼接起来向父组件emitcontext.emit("change",[newActiveId,...subIds]);}};/***接受到子组件更新activeId的同时*需要作为一个中介告知父组件activeId更新了*/constonSubActiveIdChange=(ids)=>{context.emit("change",[activeId.value].concat(ids));};constgetActiveSubMenu=()=>{returnprops.data?.find(({id})=>id===activeId.value)._child;};constsubMenu=computed(getActiveSubMenu);/***样式相关*/constgetActiveClass=(id)=>{if(id===activeId.value){return"menu-active";}return"";};/***递归收集子菜单第一项的id*/constgetSubIds=(child)=>{constsubIds=[];consttraverse=(data)=>{if(data&&data.length){constfirst=data[0];subIds.push(first.id);traverse(first._child);}};traverse(child);returnsubIds;};return{depth,activeId,subMenu,onMenuItemClick,onSubActiveIdChange,getActiveClass,};},};</script><style>.wrap{padding:12px0;}.menu-wrap{display:flex;flex-wrap:wrap;}.menu-wrap-0{background:#ffccc7;}.menu-wrap-1{background:#fff7e6;}.menu-wrap-2{background:#fcffe6;}.menu-item{margin-left:16px;cursor:pointer;white-space:nowrap;}.menu-active{color:#f5222d;}</style> 源码地址 https://github.com/sl1673495/vue-nested-menu 总结 一个递归的菜单组件,说简单也简单,说难也有它的难点。如果我们不理解 Vue 的异步渲染和观察策略,可能中间的 bug 就会困扰我们许久。所以适当学习原理还是挺有必要的。 在开发通用组件的时候,一定要注意数据源的传入时机(同步、异步),对于异步传入的数据,要利用好 watch 这个 API 去观测变动,做相应的操作。并且要考虑数据源的变化是否会和组件内原来保存的状态冲突,在适当的时机要做好清理操作。 另外留下一个小问题,我在 NestMenu 组件 watch 数据源的时候,选择这样去做: watch((()=>props.data); 而不是解构后再去观测: const{data}=props;watch(()=>data); 这两者之间有区别吗?这又是一道考察深度的面试题。 开发优秀组件的路还是很漫长的,欢迎各位也在评论区留下你的看法~ 招聘 字节跳动内推啦,Client Infrastructure是字节跳动终端基础架构团队,面向字节跳动全业务线的移动端、Web、Desktop等终端业务的基础架构部门,为公司业务的高效迭代、质量保证、研发效率和体验提供平台、工具、框架和专项技术能力支撑。研发领域包括但不限于APP框架和基础组件、研发体系、自动化测试、APM、跨平台框架、端智能解决方案、Web开发引擎、Node.js基建以及下一代移动开发技术的预研等,目前在北上广深杭五地均设有研发中心。 上海的同学点这里一键投递,来我们部门和我做同事吧~ https://job.toutiao.com/s/JhRtmQv 其他地区(北上广深杭)也可以自己搜索你想要的业务线和工作地点,通过我的下方内推链接直接投递即可。 https://job.toutiao.com/s/JhRDWep 校招的同学看这里: 投递链接: https://job.toutiao.com/s/JhRV7nC ❤️ 感谢大家 1.如果本文对你有帮助,就点个赞支持下吧,你的「赞」是我创作的动力。 2.关注公众号「前端从进阶到入院」即可加我好友,我拉你进「前端进阶交流群」,大家一起共同交流和进步。 参考资料 [1]Github Pages: https://sl1673495.github.io/vue-nested-menu/ 本文分享自微信公众号 - 前端从进阶到入院(code_with_love)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

TeamCity 2020.1 发布:构建步骤的条件、对 K8s 的支持、新的集成与 UI

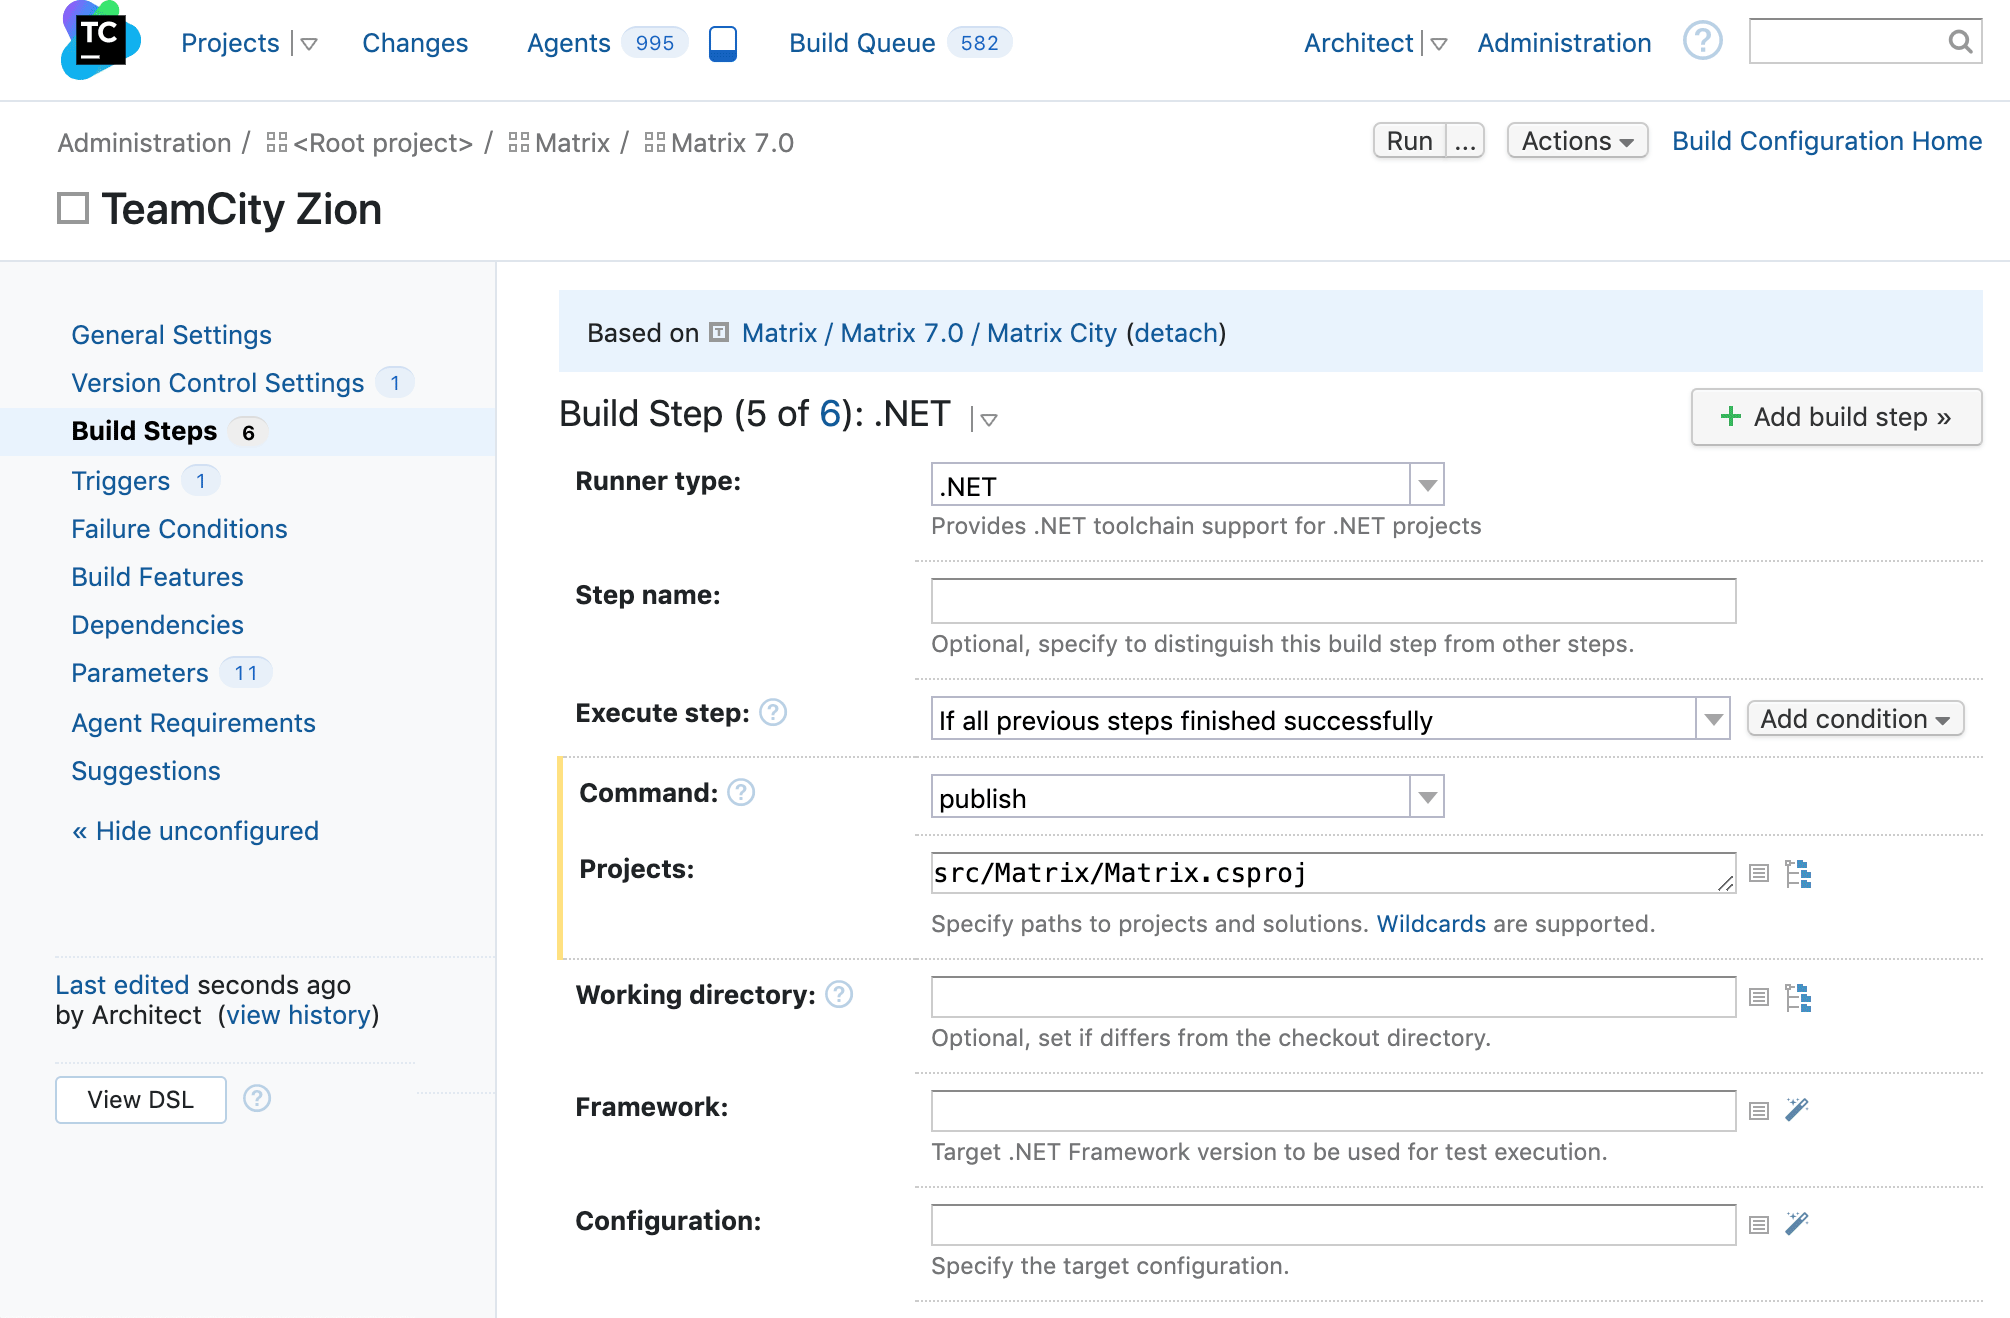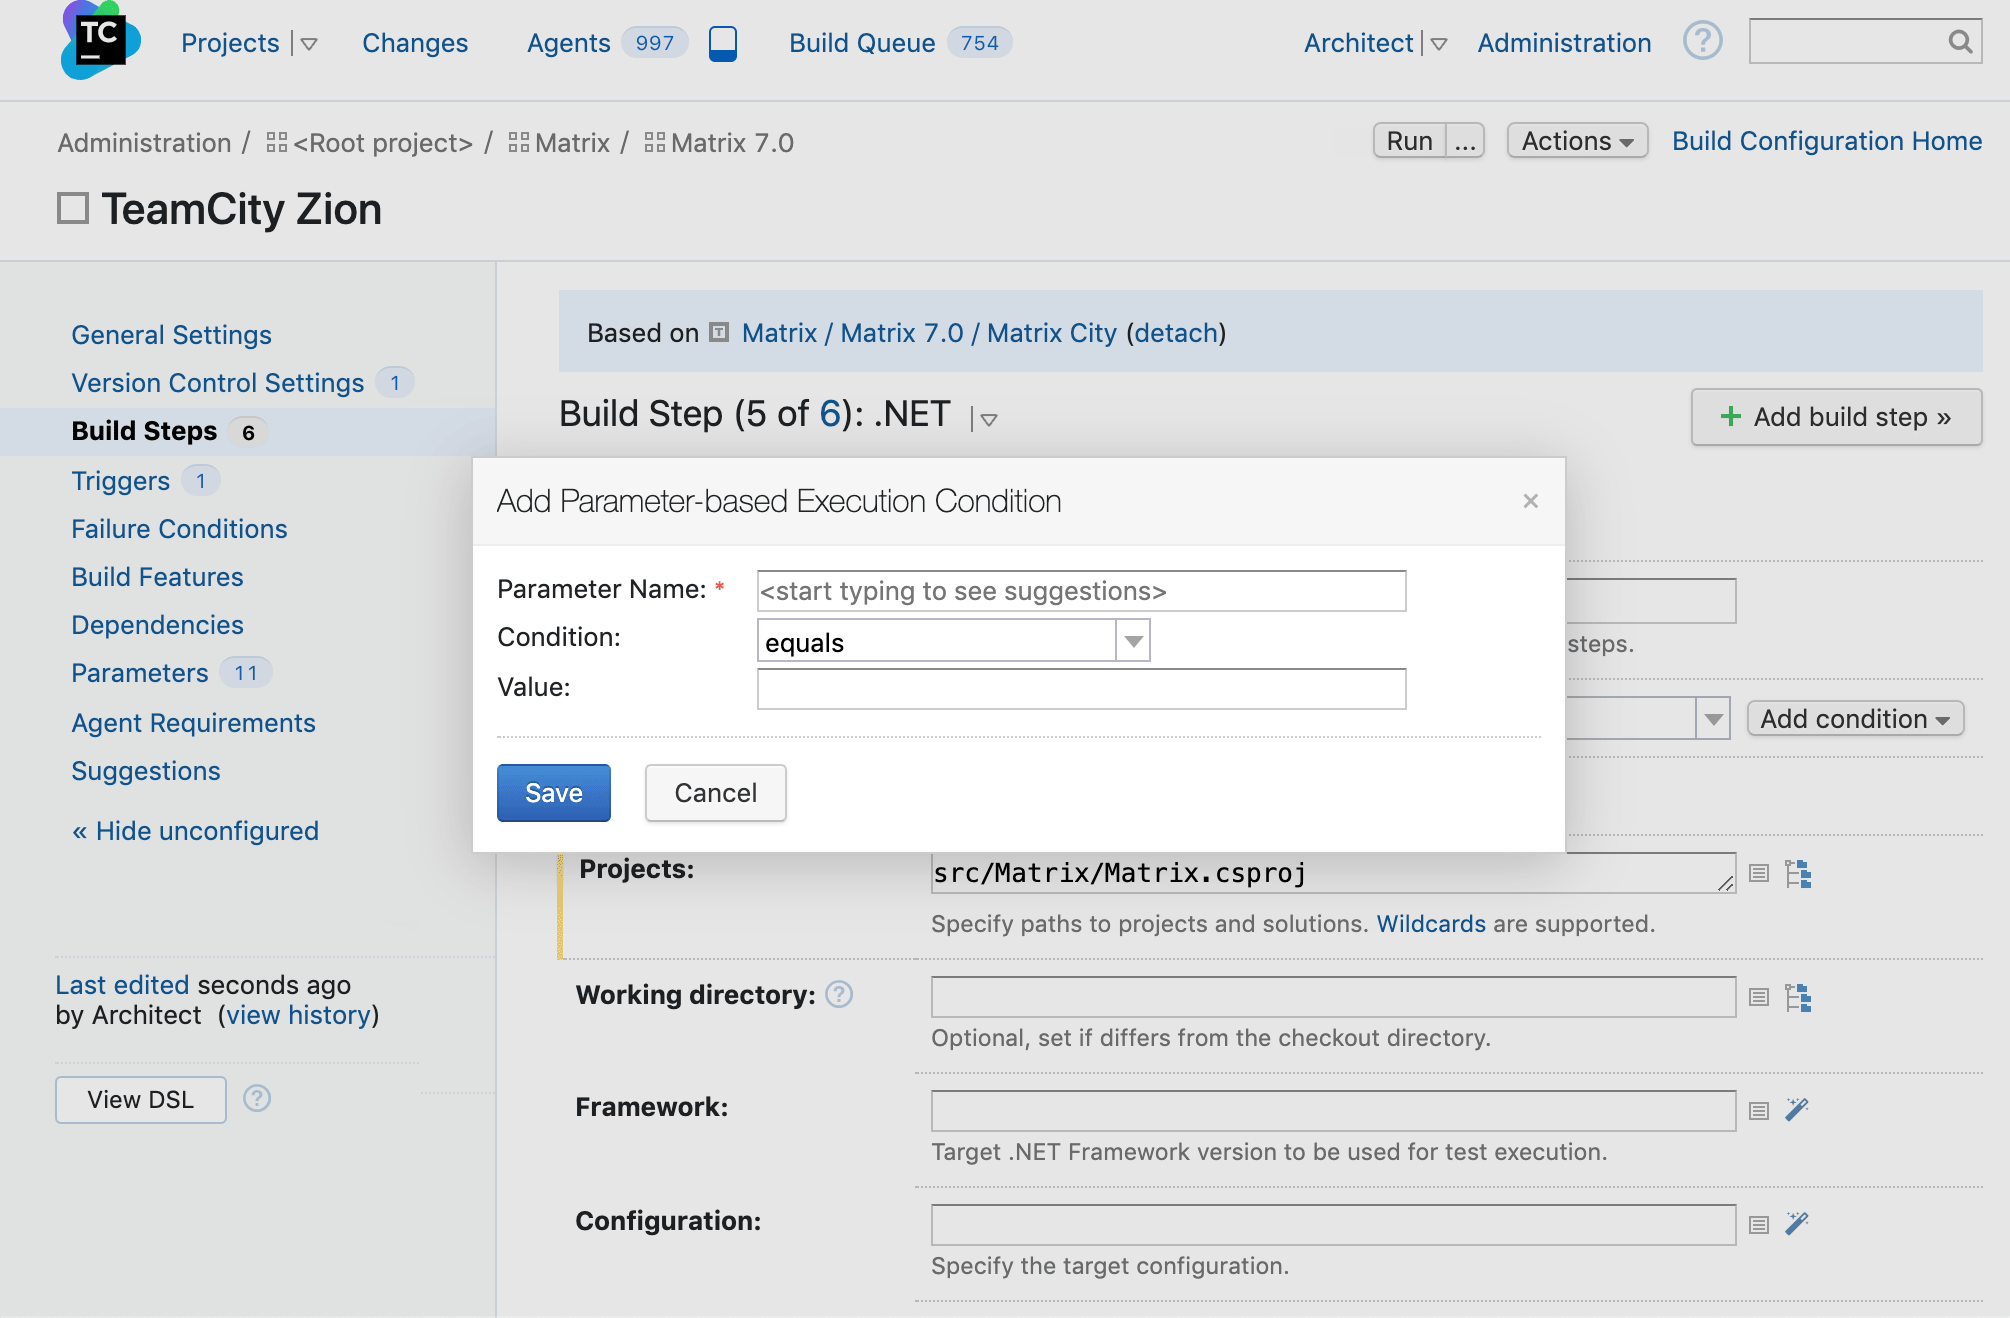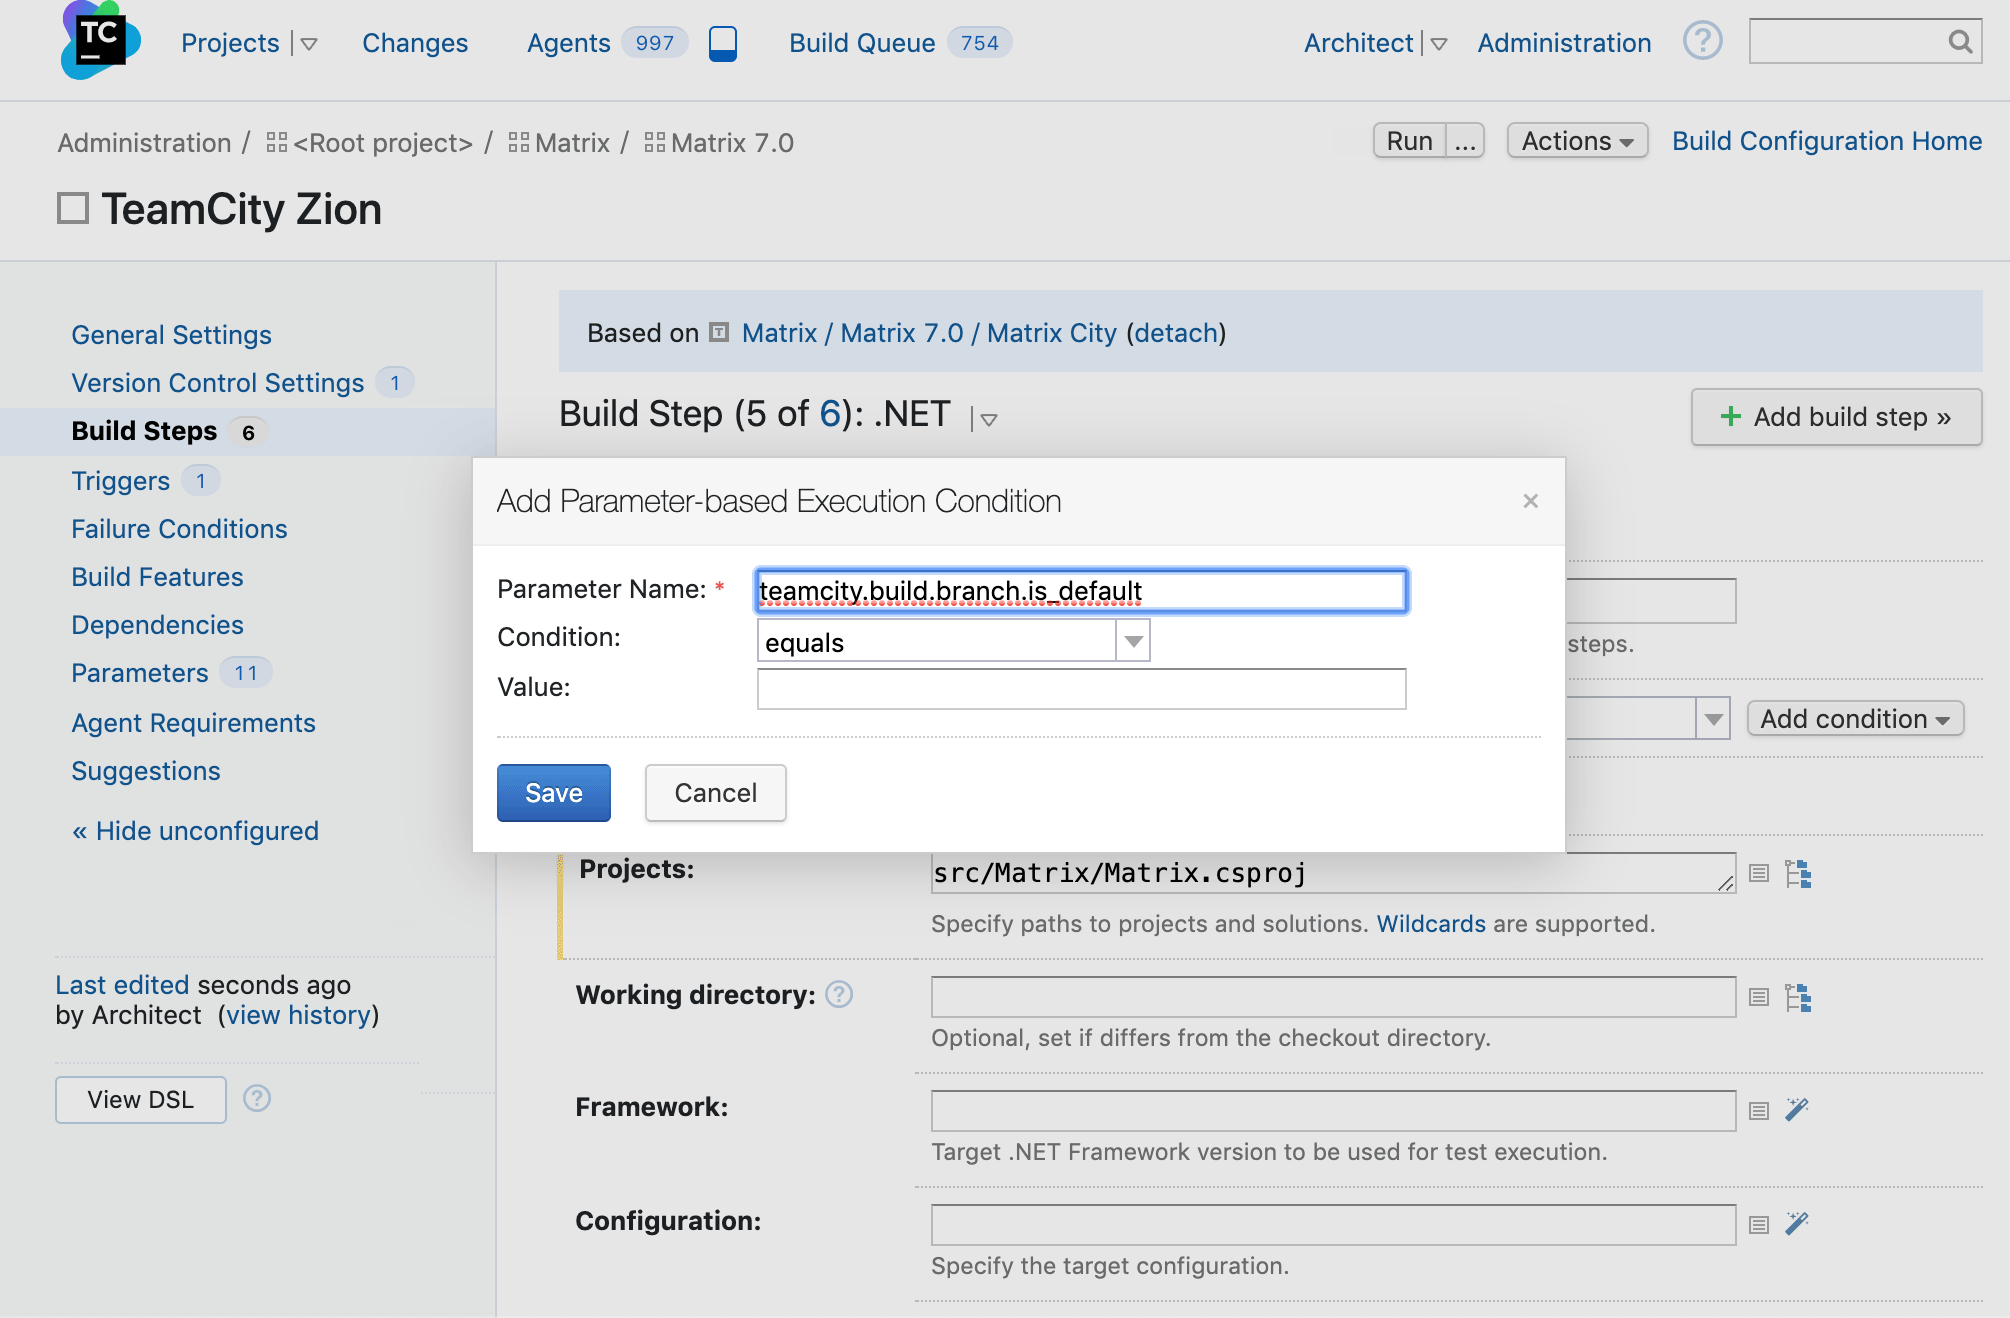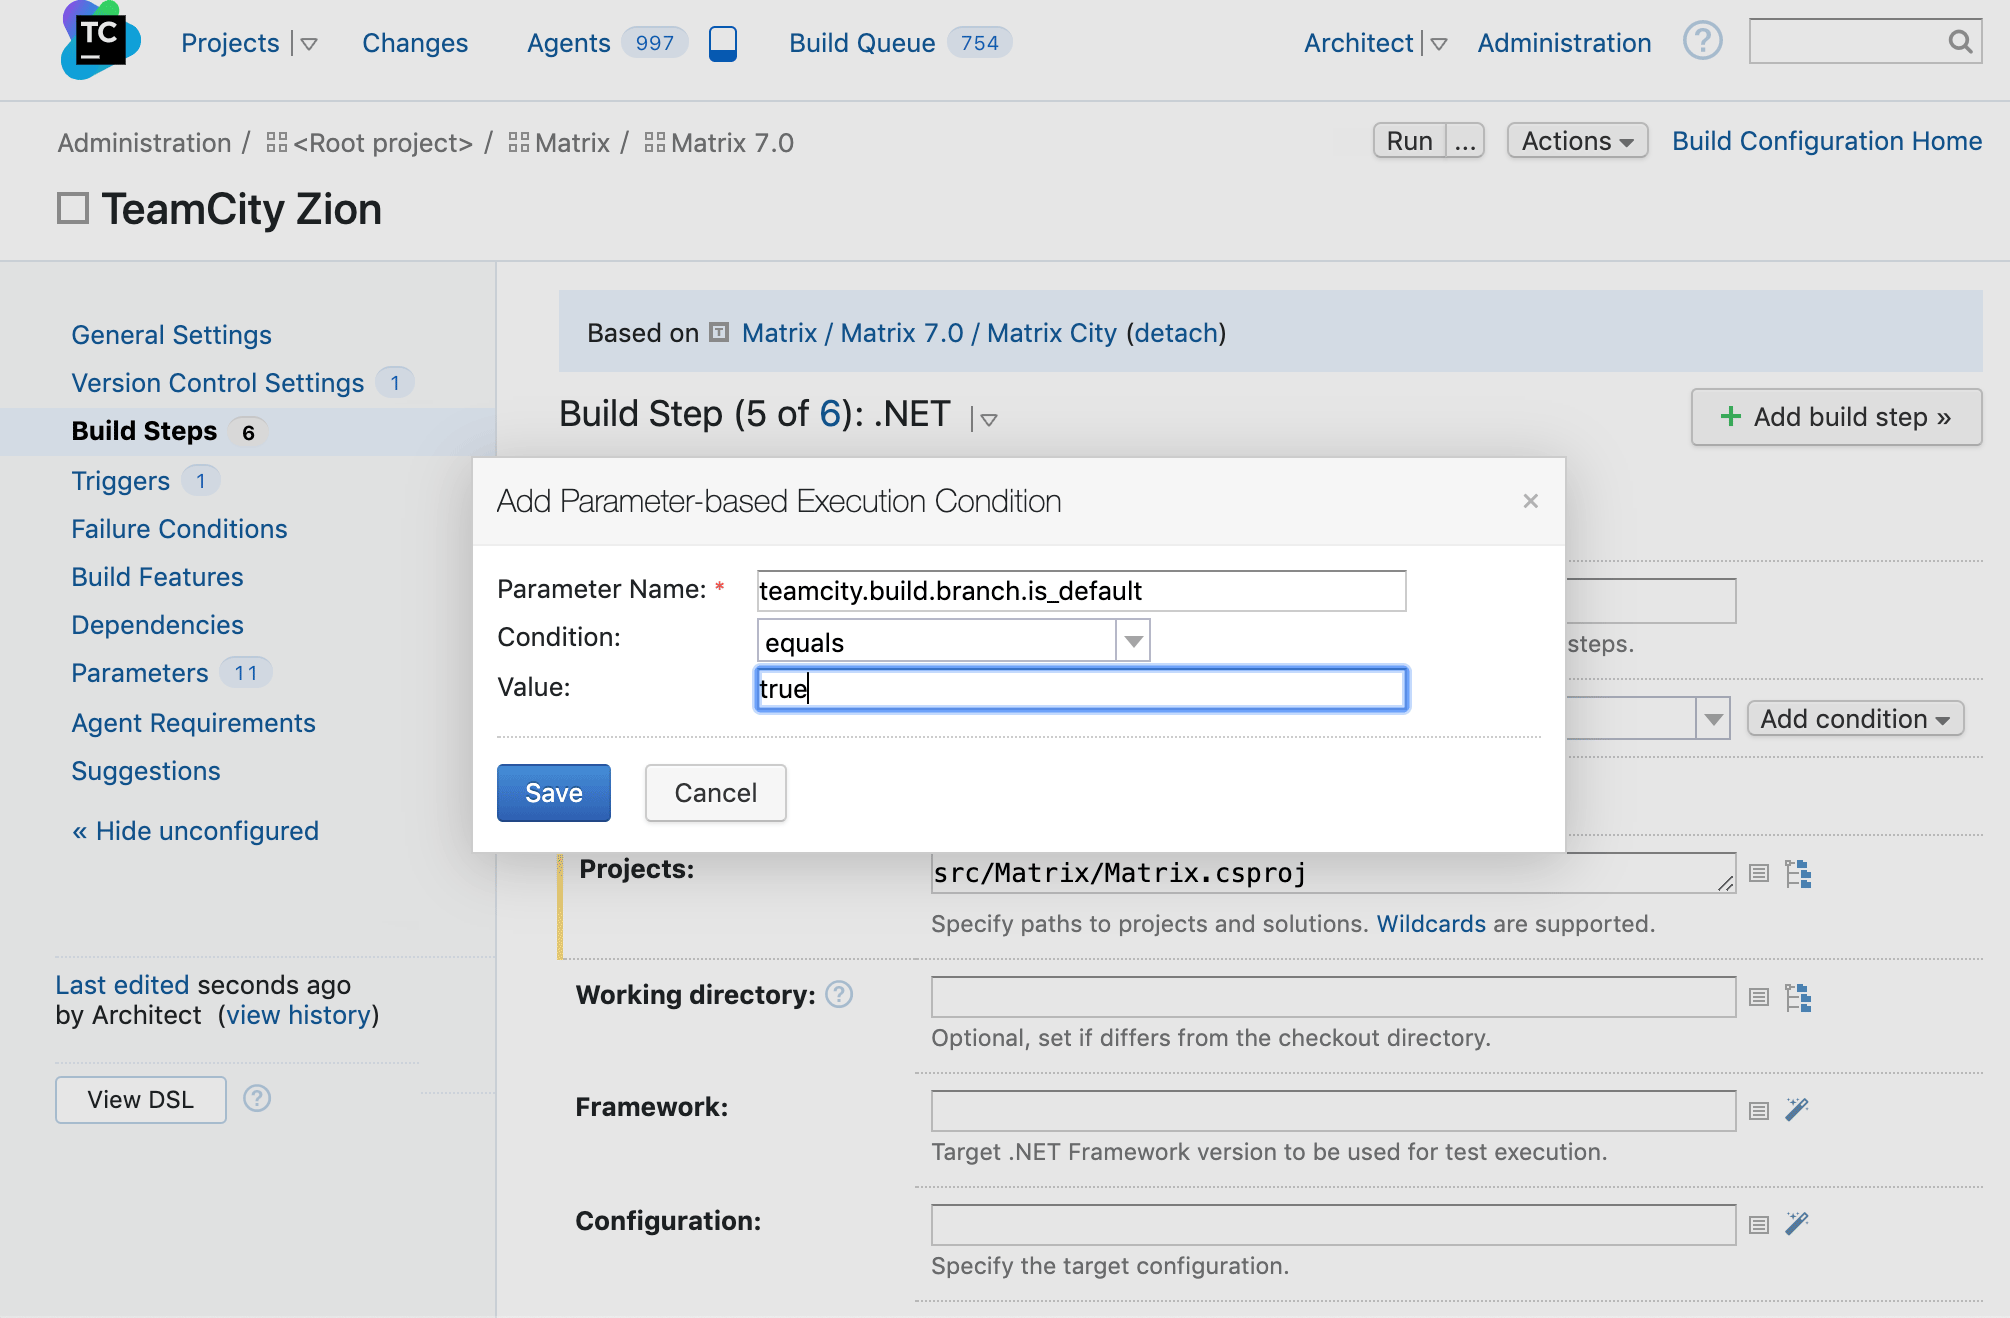
TeamCity 2020.1 发布了。此版本能够指定构建步骤的条件,可在 Kubernetes 群集中启动构建代理,并与 Azure DevOps 和 Jira Software Cloud 集成。它在多节点设置中为辅助服务器增加了更多功能,带有新的 Slack 通知程序,还对实验性的 UI 进行了许多重大改进。 指定构建步骤的条件 你是否曾经想过在不同的平台上执行不同的命令行脚本,或者将更改在不同的分支中部署到不同的登台服务器?现在,TeamCity 2020.1 允许用户指定构建步骤的条件,并仅在满足条件时执行它们。 集群部署 现在即可直接使用简单且可重复的集群部署。TeamCity 2020.1 允许在 Kubernetes 之上实现可扩展的 CI/CD 架构:可以在需要时自动启动构建代理,执行其工作,然后在构建完成后将其删除。 多服务器 运行多个 TeamCity 服务器并使它们协同工作,有助于提升 CI/CD 的性能和可靠性。通过使用触发器处理扩展辅助服务器的功能并支持 UI 中的用户级操作,新版本改善了 TeamCity 在集群环境中的工作方式。 触发处理 从事大型安装工作的专业人员会触发数百(甚至数千)个触发器,这些触发器会触发 VCS、软件包更新和新工件的更改。为了帮助他们获得最高的性能,TeamCity 现在允许辅助服务器参与此过程,并减轻主服务器的负担。 用户级操作 改进了辅助服务器的 UI,从而可以修改用户配置文件、更改项目和配置的视图、管理构建代理等。 更轻松地部署云构建代理 TeamCity 2020.1 带有一个新选项,可以从 TeamCity 服务器下载预打包的代理分发版。预打包的构建代理不需要在连接到 TeamCity 服务器时进行自我更新,因此可以更快、更直接地创建和更新云镜像。 升级通知 新版本实施了一项新的构建功能,该功能使项目管理员可以为整个团队设置自动警报。可以在构建配置级别上配置新的通知,这样就能够使用 Kotlin DSL 进行编辑、重复使用和共享。 全新的 Slack 通知程序可让你的团队直接在 Slack 中获取有关构建状态的通知。 新的Sakura UI 为了支持经典 TeamCity 的更多用例,版本 2020.1 的实验性 UI 附带了更新的“代理和项目”页面,并允许配置项目侧边栏。 更新说明:https://blog.jetbrains.com/teamcity/2020/05/teamcity-2020-1-conditional-build-steps-support-for-kubernetes-slack-notifier-integration-with-azure-devops-and-jira-software-cloud-and-more/

优秀的个人博客,低调大师

Kubernetes 实战教学,手把手教您如何在 K8s 平台上使用 Compose(一)

出品丨Docker公司(ID:docker-cn)编译丨小东每周一、三、五,与您不见不散! 用过 Kubernetes 的用户都知道 Kubernetes API 真的非常庞大。在最新的版本中,从 Pods 和 Deployments 到 Validating Webhook Configuration 和 ResourceQuota,超过 50 个一级对象。如果您是开发人员,我确信这会很容易导致群集配置时出现紊乱。因此,需要一种简化的方法(如 Swarm CLI / API)来部署和管理在 Kubernetes 集群上运行的应用程序。 在 Dockercon 的第二天,Docker 在 Kubernetes 项目上开源了 Compose。这个工具无疑可以简化 Kubernetes。如果您不知道,Docker 企业版已经在 Compose File 3.3 版本中启用了这个功能,它可以让您使用相同的 docker-compose.yml 文件进行 Swarm 部署,也可以在部署应用栈时指定 Kubernetes 工作负载。 让我来解释一下这究竟意味着什么?想象一下,您正在使用 Macbook 上运行的 Docker Desktop。 Docker Desktop 提供了为您的开发环境运行单个节点 Swarm 以及 Kubernetes 集群的功能。您可以选择从本地群集切换到云平台上运行的远程 Swarm 或 Kubernetes 群集,如 GKE / AKS。在本地单节点群集(可能是 Minikube 或 Docker Desktop for Mac)中开发代码后,您可能希望在远程云平台上对其进行测试。之前,所有这一切都需要“点击”将环境从本地群集切换到 GKE 或 AKS。现在,您可以使用相同的 Swarm CLI 命令在相同的 Docker Compose 文件中将应用程序部署到云平台。 在我们演示如何实现之前,让我们花一些时间来了解从 Swarm 到 Kubernetes 的映射是如何实现的?从根本上说,Swarm 到 Kubernetes 的1:1映射并不简单。由于应用栈本质上只是 Swarm 服务的列表,因此映射是基于每个服务完成的。根据官方文档,映射 Swarm 服务基本上需要两类 Kubernetes 对象:一类用于部署和扩展容器,另一类用于处理栈内和栈外网络。在 Kubernetes 中,不是操纵单个容器,而是操作一组称为 pod 的容器。Pods 可以根据需要使用不同的控制器来进行部署和扩展。如果声明服务是全局的,则 Kubernetes 上的 Compose 使用 DaemonSet 来部署 pod。 注意:此类服务不能使用持久化卷。如果服务使用卷,则需要使用 StatefulSet。谈到栈内网络,基本上 Kubernetes 没有像 Swarm 那样的网络概念。相反,命名空间中存在的所有 pod 都可以相互联网。为了使 pod 之间的 DNS 名称解析起作用,需要使用 HeadlessService。浏览 https://github.com/docker/compose-on-kubernetes/blob/master/docs/mapping.md 进一步详细了解从 Swarm 到 Kubernetes 的映射。 架 构 Kubernetes 上 Compose 是由服务器端和客户端组件组成。选择此架构是为了能够管理应用栈的整个生命周期。下图是该架构的结构图: REST API 使用 API 服务器聚合向 Kubernetes 客户端公开自定义 API 服务器。 客户端使用声明性 REST API 与服务器通信。它通过将序列化应用栈结构(v1beta2)或 Compose 文件(v1beta1) POST 到 API 服务器来创建应用栈。此 API 服务器将应用栈存储在 etcd 键值存储中。 服务器端架构 在 Kubernetes 上的 Compose 中有两个服务器端组件: Compose API 服务器; Compose 控制器; Compose API 服务器通过添加用于创建和操作应用栈的路径来扩展 Kubernetes API。它负责将应用栈存储在 etcd 键值存储中。 它还包含将 v1beta1 代表转换为 v1beta2 的逻辑,因此 Compose 控制器只需要处理应用栈的一个代表。 Compose 控制器负责将堆栈结构(v1beta2 模式)转换为 Kubernetes 对象,然后将当前的集群状态与所需的集群状态进行协调。它通过与 Kubernetes API 交互来实现这一点,它是一个 Kubernetes 客户端,可以监视有趣的事件并操纵较低级别的 Kubernetes 对象。 在下一篇文章中,我将展示如何在 Kubernetes 上运用 Compose 的实战演示。

优秀的个人博客,低调大师

去腾讯面试,让做了几道JAVA笔试题,做对就给30K,邀你来战!

前几天去腾讯面试,让做一道JAVA笔试题,今天给大家整理了下。不知道我总结得对不,欢迎有不同的声音。 1、说几种常见的攻击方式及预防手段。 XSS/CSRF/DDOS,后面啥来着? 2、http1.x和http2.x的区别。 http2.0增加多路复用、二进制分帧、首部压缩、服务器推送。 3、mysql查询语句怎么做性能分析。 使用explain或者profile命令。 4、你知道哪几种排序算法? 冒泡、选择、插入、希尔、快速、堆、归并、桶排序。 5、HashMap和HashTable的区别,并说明其底层实现数据结构。 HashMap非线程安全,HashTable线程安全。 6、HashMap满了之后怎么扩容? loadfactor为扩容因子,当数据容量超过最大容量*loadfactor时容量自动扩大2倍,并将当前的数据重新放入新的hashmap中,所以初始的定义大小为2^n的大小最佳。 7、Linux中远程传输文件有什么方式? SCP、FTP等。 8、说说Java中异常的分类。 Throwable子类Exception、Error。 9、TCP和UDP的区别,TCP为什么是三次握手,不是两次。 1)基于连接与无连接 2)TCP要求系统资源较多,UDP较少。 3)UDP程序结构较简单。 4)流模式(TCP)与数据报模式(UDP)。 5)TCP保证数据正确性,UDP可能丢包。 6)TCP保证数据顺序,UDP不保证。 为了防止已失效的连接请求报文段突然又传送到了服务端,因而产生错误,即重要的事情说三遍 10、说说数据库设计的三范式,可以违反三范式吗? 第一范式,又称1NF,它指的是在一个应用中的数据都可以组织成由行和列的表格形式,且表格的任意一个行列交叉点即单元格,都不可再划分为行和列的形式,实际上任意一张表格都满足1NF; 第二范式,又称2NF,它指的是在满足1NF的基础上,一张数据表中的任何非主键字段都全部依赖于主键字段,没有任何非主键字段只依赖于主键字段的一部分。即,可以由主键字段来唯一的确定一条记录。比如学号+课程号的联合主键,可以唯一的确定某个成绩是哪个学员的哪门课的成绩,缺少学号或者缺少课程号,都不能确定成绩的意义。 第三范式,又称3NF,它是指在满足2NF的基础上,数据表的任何非主键字段之间都不产生函数依赖,即非主键字段之间没有依赖关系,全部只依赖于主键字段。例如将学员姓名和所属班级名称放在同一张表中是不科学的,因为学员依赖于班级,可将学员信息和班级信息单独存放,以满足3NF。 某些业务设计可以违反三范式。 以上10道腾讯的面试题,我给了我的答案,不知道正确否,欢迎点评~

优秀的个人博客,低调大师

库、教程、论文实现,这是一份超全的PyTorch资源列表(Github 2.2K星)

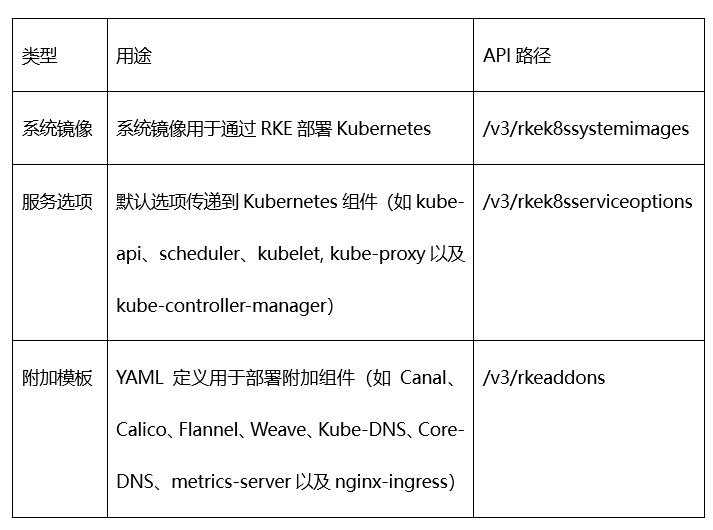
机器之心发现了一份极棒的 PyTorch 资源列表,该列表包含了与 PyTorch 相关的众多库、教程与示例、论文实现以及其他资源。在本文中,机器之心对各部分资源进行了介绍,感兴趣的同学可收藏、查用。 项目地址:https://github.com/bharathgs/Awesome-pytorch-list 列表结构: NLP 与语音处理 计算机视觉 概率/生成库 其他库 教程与示例 论文实现 PyTorch 其他项目 自然语言处理和语音处理 该部分项目涉及语音识别、多说话人语音处理、机器翻译、共指消解、情感分类、词嵌入/表征、语音生成、文本语音转换、视觉问答等任务,其中有一些是具体论文的 PyTorch 复现,此外还包括一些任务更广泛的库、工具集、框架。 这些项目有很多是官方的实现,其中 FAIR 居多,一般会有系统的使用说明,包含安装、加载、训练、测试、演示等多方面的详细解释。例如哈佛大学的 OpenNMT 项目,它是非常流行的神经机器翻译工具包。从导入自定义数据集、加载词嵌入向量到完成神经机器翻译模型的训练,OpenNMT 能支持整个流程,并且官方也一直在更新。 1.pytorch text:Torch 文本相关的内容。 项目地址:https://github.com/pytorch/text 2.pytorch-seq2seq:在 PyTorch 中实现序列到序列(seq2seq)模型的框架。 项目地址:https://github.com/IBM/pytorch-seq2seq 3.anuvada:PyTorch 中实现的 NLP 的可解释模型。 项目地址:https://github.com/Sandeep42/anuvada 4.audio:PyTorch 的简单音频 I/O。 项目地址:https://github.com/pytorch/audio 5.loop:用于生成多个说话人语音的方法。 项目地址:https://github.com/facebookresearch/loop 6.fairseq-py:用 Python 写的 Facebook AI 研究院提出的序列到序列工具集。 项目地址:https://github.com/facebookresearch/fairseq-py 7.speech:PyTorch ASR 实现。 项目地址:https://github.com/awni/speech 8.OpenNMT-py:开源 PyTorch 神经机器翻译。 项目地址:https://github.com/OpenNMT/OpenNMT-py 9.neuralcoref:基于神经网络和 spaCy 的当前最佳共指消解。 项目地址:https://github.com/huggingface/neuralcoref 10.sentiment-discovery:用于鲁棒情感分类的大规模无监督语言建模。 项目地址:https://github.com/NVIDIA/sentiment-discovery 11.MUSE:用于多语言无监督/监督词向量的库。 项目地址:https://github.com/facebookresearch/MUSE 12.nmtpytorch:PyTorch 神经机器翻译框架。 项目地址:https://github.com/lium-lst/nmtpytorch 13.pytorch-wavenet:快速语音生成 WaveNet 的实现。 项目地址:https://github.com/vincentherrmann/pytorch-wavenet 14.Tacotron-pytorch:端到端语音合成的 PyTorch 实现。 项目地址:https://github.com/soobinseo/Tacotron-pytorch 15.AllenNLP:开源 NLP 研究库,基于 PyTorch。 项目地址:https://github.com/allenai/allennlp 16.PyTorch_NLP:用于 PyTorch pytorchnlp.readthedocs.io 的文本实用程序和数据集。 项目地址:https://github.com/PetrochukM/PyTorch-NLP 17.quick_nlp:基于 FastAI 的 PyTorch NLP 库。 项目地址:https://github.com/outcastofmusic/quick-nlp 18.TTS:Text2Speech 的深度学习实现。 项目地址:https://github.com/mozilla/TTS 19.LASER:语言无关的句子表征的 PyTorch 实现。 项目地址:https://github.com/facebookresearch/LASER 20.pyannote-audio:说话人追踪的神经构建块:语音激活检测、说话人变化检测、说话人嵌入。 项目地址:https://github.com/pyannote/pyannote-audio 计算机视觉 该部分项目涉及神经风格迁移、图像分类、人脸对齐、语义分割、RoI 计算、图像增强等任务,还有一些特殊的 CNN 架构,例如第 5、6 和 13 个项目,以及一些预训练模型的集合。其中第 4 个项目可以用于将你的定制图像分类模型和当前最佳模型进行对比,快速知道你的项目到底有没有希望,作者戏称该项目为「Project Killer」。 1.pytorch vision:计算机视觉领域的数据集、转换和模型。 项目地址:https://github.com/pytorch/vision 2.pt-styletransfer:PyTorch 实现的神经分割迁移,作为一个类。 项目地址:https://github.com/tymokvo/pt-styletransfer 3.OpenFacePyTorch:使用 OpenFace's nn4.small2.v1.t7 模型的 PyTorch 模块。 项目地址:https://github.com/thnkim/OpenFacePytorch 4.img_classification_pk_pytorch:快速对比你的图像分类模型和当前最佳模型(例如 DenseNet、ResNet,等)。 项目地址:https://github.com/felixgwu/img_classification_pk_pytorch 5.SparseConvNet:子流形稀疏卷积网络。 项目地址:https://github.com/facebookresearch/SparseConvNet 6.Convolution_LSTM_pytorch:多层卷积 LSTM 模块。 项目地址:https://github.com/automan000/Convolution_LSTM_pytorch 7.face-alignment:基于 PyTorch 的 2D 和 3D 人脸对齐库。 项目地址:https://github.com/1adrianb/face-alignment 8.pytorch-semantic-segmentation:语义分割的 PyTorch 实现。 项目地址:https://github.com/ZijunDeng/pytorch-semantic-segmentation 9.RoIAlign.pytorch:这是一个 PyTorch 版本的 RoIAlign。这个实现基于 crop_and_resize,并支持 CPU 和 GPU 上的前向传播、反向传播。 项目地址:https://github.com/longcw/RoIAlign.pytorch 10.pytorch-cnn-finetune:PyTorch 实现的微调预训练卷积神经网络。 项目地址:https://github.com/creafz/pytorch-cnn-finetune 11.detectorch:PyTorch 实现的 detectron 图像分割模型。 项目地址:https://github.com/ignacio-rocco/detectorch 12.Augmentor:Python 图像增强库。 项目地址:https://github.com/mdbloice/Augmentor 13.s2cnn:这个库包含一个用于球面信号(例如,全向摄像机、地球信号等)的 SO(3) 等变 CNN 的 PyTorch 实现。 项目地址:https://github.com/jonas-koehler/s2cnn 概率/生成库 该部分项目主要涉及概率编程、统计推理和生成模型。 1.ptstat:PyTorch 上的概率编程和统计推理。 项目地址:https://github.com/stepelu/ptstat 2.pyro:基于 PyTorch 和 Python 的深度全局概率编程。 项目地址:https://github.com/uber/pyro 3.probtorch:Probabilistic Torch 是深度生成模型的 PyTorch 扩展库。 项目地址:https://github.com/probtorch/probtorch 4.paysage:Python/PyTorch 中的无监督学习和生成模型。 项目地址:https://github.com/drckf/paysage 5.pyvarinf:Python 包,方便在 PyTorch 中利用变分推理执行贝叶斯深度学习方法。 项目地址:https://github.com/ctallec/pyvarinf 6.pyprob:一个基于 PyTorch 的概率编程和推理编译库。 项目地址:https://github.com/probprog/pyprob 7.mia:对机器学习模型运行成员推理攻击的库。 项目地址:https://github.com/spring-epfl/mia 教程和示例 这一部分包含了很多 PyTorch 教程,它不仅有官方教程与示例,同时还包含很多开发者在学习过程的经验与理解。从难易程度上看,它们首先介绍了如何入门 PyTorch 这一个框架,并使用 MNIST 等简单数据集展示了一般搭建模型的方法,这些都非常适合初学者入门机器学习。其次会有一些练习题及示例脚本,这些资源可以帮助更好地理解机器学习与 PyTorch 框架。最后就是一些具体任务与模型架构的实现,例如基于 ImageNet 实现 Inception_v3 或 ResNet_50 等。 这里值得注意的是 PyTorch 官方教程,基本上初学者只要跟着官方教程走就行了,它们非常丰富与具体。PyTorch 的教程确实很完美,它不仅从入门基础、计算机视觉、文本处理、生成模型和产品部署等方面全面覆盖了 DL 的使用范围,同时每一个教程不仅解释了模型原理,还注释了大多数的代码。小编感觉相对于 TensorFlow 的教程解释(需要大量查找文档),PyTorch 更加具体。如下展示了 PyTorch 的入门主题: 1.Practical Pytorch:解释不同 RNN 模型的教程。 地址:https://github.com/spro/practical-pytorch 2.DeepLearningForNLPInPytorch:基于 IPython Notebook 的深度学习教程,关注于自然语言处理。 地址:https://github.com/rguthrie3/DeepLearningForNLPInPytorch 3.pytorch-tutorial:为研究者准备的 PyTorch 深度学习教程。 地址:https://github.com/yunjey/pytorch-tutorial 4.pytorch-exercises:PyTorch 练习题集。 地址:https://github.com/keon/pytorch-exercises 5.pytorch tutorials:各种官方 PyTorch 教程。 地址:https://github.com/pytorch/tutorials 6.pytorch examples:通过示例展示如何使用 PyTorch 的项目。 地址:https://github.com/pytorch/examples 7.pytorch practice:一些 PyTorch 脚本示例。 地址:https://github.com/napsternxg/pytorch-practice 8.pytorch mini tutorials:根据 Alec Radford's Theano 教程改编的极简教程。 地址:https://github.com/vinhkhuc/PyTorch-Mini-Tutorials 9.pytorch text classification:基于文本分类任务的简单 CNN 实现。 地址:https://github.com/xiayandi/Pytorch_text_classification 10.cats vs dogs:用于 kaggle 竞赛 Dogs vs. Cats Redux 的模型,该解决方案目前总排名第 27。 地址:https://github.com/desimone/pytorch-cat-vs-dogs 11.convnet:在各种数据集上(ImageNet、Cifar10、 Cifar100 和 MNIST)使用深度卷积神经网络的完整示例。 地址:https://github.com/eladhoffer/convNet.pytorch 12.pytorch-generative-adversarial-networks:简单的生成对抗网络实现。 地址:https://github.com/mailmahee/pytorch-generative-adversarial-networks 13.T-SNE in pytorch:基于 PyTorch 的 t 分布随机近邻嵌入(t-SNE)实现。 地址:https://github.com/cemoody/topicsne 14.AAE_pytorch:对抗自编码器。 地址:https://github.com/fducau/AAE_pytorch 15.Kind_PyTorch_Tutorial:很容易的 PyTorch 入门教程。 地址:https://github.com/GunhoChoi/Kind_PyTorch_Tutorial 16.pytorch-poetry-gen:实现字符级的 RNN 模型。 地址:https://github.com/justdark/pytorch-poetry-gen 17.pytorch-REINFORCE:REINFORCE 的 PyTorch 实现,该项目支持 OpenAI gym 中的连续型和离散型环境。 地址:https://github.com/JamesChuanggg/pytorch-REINFORCE 18.PyTorch-Tutorial:快速上手搭建神经网络。 地址:https://github.com/MorvanZhou/PyTorch-Tutorial 19.pytorch-intro:展示如何执行卷积神经网络和循环神经网络的一些脚本。 地址:https://github.com/joansj/pytorch-intro 论文实现 最近 Frankensteinian 等开发者爬取并统计了 ICLR 2019 提交论文提及不同框架的论文数量,其中 TensorFlow 的论文数量从 2018 年的 228 篇略微提升到了 266 篇,Keras 从 42 升到 56,但 Pytorch 的数量从 87 篇提升到了 252 篇。从这里可以看出来 PyTorch 在研究中有非常广泛的应用,很多研究论文都采用 PyTorch 作为首选框架。 因为动态计算图的便利,很多原本使用 TensorFlow 实现的论文都有 PyTorch 复现版,例如下面的高速公路网络和多人实时姿态估计(CVPR'17)等。而更多的是本来就由 PyTorch 实现的论文,包括 DiscoGAN、AnimeGAN 和 TCN 等。这一部分收录了 273 篇论文实现,但是限于长度,我们只展示了前 20 个项目,读者可查阅原项目了解更多。 1.google_evolution :该项目实现了 Esteban Real 等人完成的图像分类器大规模演化结果。 地址:https://github.com/neuralix/google_evolution 2.pyscatwave:通过 CuPy/PyTorch 实现的 Fast Scattering Transform。 地址:https://github.com/edouardoyallon/pyscatwave 3.scalingscattering:论文《Scaling The Scattering Transform : Deep Hybrid Networks》的实现 地址:https://github.com/edouardoyallon/scalingscattering 4.deep-auto-punctuation:PyTorch 实现字符级的自动标点符号模型。 地址:https://github.com/episodeyang/deep-auto-punctuation 5.Realtime_Multi-Person_Pose_Estimation :GitHub 项目 Realtime_Multi-Person_Pose_Estimation 的 PyTorch 版。 地址:https://github.com/tensorboy/pytorch_Realtime_Multi-Person_Pose_Estimation 6.PyTorch-value-iteration-networks:价值迭代网络(NIPS'16 论文)的 PyTorch 实现。 地址:https://github.com/onlytailei/PyTorch-value-iteration-networks 7.pytorch_Highway:基于 PyTorch 实现的高速公路网络。 地址:https://github.com/analvikingur/pytorch_Highway 8.pytorch_NEG_loss : 实现 NEG 损失函数。 地址:https://github.com/analvikingur/pytorch_NEG_loss 9.pytorch_RVAE:实现生成序列数据的循环变分自编码器(Recurrent Variational Autoencoder)。 地址:https://github.com/analvikingur/pytorch_RVAE 10.pytorch_TDNN :时延神经网络(Time Delayed NN)的实现。 地址:https://github.com/analvikingur/pytorch_TDNN 11.eve.pytorch:Eve Optimizer 的实现,该最优化器在论文《proposed in Imploving Stochastic Gradient Descent with Feedback》中提出。 地址:https://github.com/moskomule/eve.pytorch 12.e2e-model-learning:基于任务的端到端模型学习。 地址:https://github.com/locuslab/e2e-model-learning 13.pix2pix-pytorch:使用条件对抗网络实现图像到图像的转换。 地址:https://github.com/mrzhu-cool/pix2pix-pytorch 14.Single Shot MultiBox Detector :单次多框检测器的 PyTorch 实现。 地址:https://github.com/amdegroot/ssd.pytorch 15.DiscoGAN:论文《Learning to Discover Cross-Domain Relations with Generative Adversarial Networks》的 PyTorch 实现 地址:https://github.com/carpedm20/DiscoGAN-pytorch 16.official DiscoGAN implementation:论文《Learning to Discover Cross-Domain Relations with Generative Adversarial Networks》的官方实现。 地址:https://github.com/SKTBrain/DiscoGAN 17.pytorch-es:进化策略的 PyTorch 实现。 地址:https://github.com/atgambardella/pytorch-es 18.piwise : 基于 VOC2012 数据集实现逐像素的分割。 地址:https://github.com/bodokaiser/piwise 19.pytorch-dqn:实现深度 Q 学习。 地址:https://github.com/transedward/pytorch-dqn 20.neuraltalk2-pytorch:实现图像描述模型,其中 CNN 根据任务可微调。 地址:https://github.com/ruotianluo/neuraltalk2.pytorch PyTorch 其它项目 这一部分主要介绍了 PyTorch 其它各种资源,包括教程论文列表、个人的学习经验与实践、好用的 PyTorch 插件等。这一部分相对于其它部分比较散,但是有一些项目还是非常有意思的,例如在 PyTorch 项目模板中,其介绍了构建 PyTorch 项目一般所采用的结构,包括文件夹及文件结构、各文件的编写规范和示例等。这个项目一直在更新,下图展示了构建 PyTorch 项目的一般文件结构: 1.the-incredible-pytorch:包含 PyTorch 各种教程、论文、项目和社区的项目。 地址:https://github.com/ritchieng/the-incredible-pytorch 2.generative models:收集 TensorFlow、Keras 和 PyTorch 的生成模型,即 GAN 和 VAE。 地址:https://github.com/wiseodd/generative-models) 3.pytorch vs tensorflow:reddit 上 PyTorch 与 TensorFlow 对比。 地址:https://github.com/wiseodd/generative-models 4.Pytorch discussion forum:PyTorch 论坛。 地址:https://discuss.pytorch.org/ 5.pytorch notebook: docker-stack :类似于 Jupyter Notebook 的项目。 地址:https://hub.docker.com/r/escong/pytorch-notebook/ 6.drawlikebobross:使用神经网络做图象风格迁移。 地址:https://github.com/kendricktan/drawlikebobross 7.pytorch-tvmisc:PyTorch 个人实现项目。 地址:https://github.com/t-vi/pytorch-tvmisc 8.pytorch-a3c-mujoco:在 Mujoco gym 环境下实现 A3C 项目。 地址:https://github.com/andrewliao11/pytorch-a3c-mujoco 9.pytorch_chatbot:使用 PyTorch 实现 ChatBot。 地址:https://github.com/jinfagang/pytorch_chatbot 10.sketchnet:输入图像并生成处理源码,其可以再生成改图像。 地址:https://github.com/jtoy/sketchnet 11.Deep-Learning-Boot-Camp:非赢利公司,5 天的深度学习训练营。 地址:https://github.com/QuantScientist/Deep-Learning-Boot-Camp 12.Amazon_Forest_Computer_Vision:使用 PyTorch 或 Keras 的卫星图像标注代码,它有非常多 PyTorch 技巧。 地址:https://github.com/mratsim/Amazon_Forest_Computer_Vision 13.AlphaZero_Gomoku:用于五子棋的 AlphaZero 算法实现。 地址:https://github.com/junxiaosong/AlphaZero_Gomoku 14.pytorch-cv:目标检测、语义分割和姿态识别的实现项目。 地址:https://github.com/youansheng/pytorch-cv 15.deep-person-reid:深度人脸再识别 PyTorch 实现项目。 地址:https://github.com/KaiyangZhou/deep-person-reid 16.pytorch-template:PyTorch 项目模板。 地址:https://github.com/victoresque/pytorch-template 17.Deep Learning With Pytorch TextBook:使用 PyTorch 构建基于文本或视觉方面的神经网络指南。 地址:https://www.packtpub.com/big-data-and-business-intelligence/deep-learning-pytorch 18.compare-tensorflow-pytorch:对比使用 TensorFlow 写的模型和用 PyTorch 写的模型。 地址:https://github.com/jalola/compare-tensorflow-pytorch 原文发布时间为:2018-11-04 本文作者:深度学习自然语言处理 本文来自云栖社区合作伙伴“深度学习自然语言处理”,了解相关信息可以关注“深度学习自然语言处理”。

优秀的个人博客,低调大师

容器平台选型的十大模式:Docker、DC/OS、K8S 谁与当先?【转】

网易企业服务2017-10-13 无论是在社区,还是在同客户交流的过程中,总会被问到到底什么时候该用 Docker?什么时候用虚拟机?如果使用容器,应该使用哪个容器平台? 显而易见,我不会直接给大家一个答案,而是希望从技术角度进行分析具体的场景。例如客户是大公司还是小公司,将部署小集群还是大集群,倾向于私有云还是公有云,已经采购了 IaaS 还是没有 IaaS,IT 运维能力强还是弱,是否需要物理机、虚拟机、容器的混合部署,是一般的并发系统还是高并发,这里面所应该做的技术选型都不一样。举个例子,如果你是一个初创型的主营业务非 IT 的小公司,自然不应该花大力气在数据中心里面自己搭建一套大规模、高并发、高性能的容器平台。 接下来,首先,我们来谈下什么情况下应该使用 Docker 的问题。 如上图所示,左面是我们经常挂在嘴边的所谓容器的优势,但是虚拟机都能一一怼回去。 如果部署的是一个传统的应用,这个应用启动速度慢,进程数量少,基本不更新,那么虚拟机完全能够满足需求。 应用启动慢:应用启动 15 分钟,容器本身秒级,虚拟机很多平台能优化到十几秒,两者几乎看不出差别; 内存占用大:动不动 32G,64G 内存,一台机器跑不了几个; 基本不更新:半年更新一次,虚拟机镜像照样能够升级和回滚; 应用有状态:停机会丢数据,如果不知道丢了什么,就算秒级启动也没有用,照样恢复不了,而且还有可能因为丢数据,在没有修复的情况下,盲目重启带来数据混乱; 进程数量少:两三个进程相互配置一下,不用服务发现,配置不麻烦 如果是一个传统应用,根本没有必要花费精力去容器化,因为白花了力气,享受不到好处。 那么什么情况下,才应该考虑做一些改变呢: 传统业务突然被互联网业务冲击了,应用老是变,三天两头要更新,而且流量增大了,原来支付系统是取钱刷卡的,现在要互联网支付了,流量扩大了 N 倍。 这种情况下就只能:拆。 拆开了,每个子模块独自变化,相互影响变少。 拆开了,原来一个进程扛流量,现在多个进程一起扛。 这被称为微服务。 微服务场景下,进程多,更新快,于是出现 100 个进程,每天一个镜像。 容器乐了,每个容器镜像小,没什么问题,虚拟机哭了,因为虚拟机每个镜像太大了。 所以微服务场景下,可以开始考虑用容器了。 这时虚拟机又怒了,我不用容器了,微服务拆分之后,用 Ansible 自动部署是一样的。 这从技术角度来讲没有任何问题,问题是从组织角度出现的。一般的公司,开发会比运维多得多,开发写完代码就不用管了,环境的部署完全是运维负责,运维为了自动化,写 Ansible 脚本来解决问题。 然而这么多进程,又拆又合并的,更新这么快,配置总是变,Ansible 脚本也要常改,每天都上线,不得累死运维。 所以在如此大的工作量情况下,运维很容易出错,哪怕通过自动化脚本。这时,容器就可以作为一个非常好的工具运用起来。 除了容器从技术角度,能够使得大部分的内部配置可以放在镜像里面之外,更重要的是从流程角度,将环境配置这件事情,往前推了,推到了开发这里,要求开发完毕之后,就需要考虑环境部署的问题,而不能当甩手掌柜。 这样做的好处就是,虽然进程多,配置变化多,更新频繁,但是对于某个模块的开发团队来讲,这个量是很小的,因为 5-10 个人专门维护这个模块的配置和更新,不容易出错。 如果这些工作量全交给少数的运维团队,不但信息传递会使得环境配置不一致,部署量也会大非常多。 容器是一个非常好的工具,就是让每个开发仅仅多做 5% 的工作,就能够节约运维 200% 的工作量,并且不容易出错。 然而原来运维该做的事情开发做了,开发的老大愿意么?开发的老大会投诉运维的老大么? 这就不是技术问题了,其实这就是 DevOps,DevOps 不是不区分开发和运维,而是公司从组织到流程能够打通,看如何合作,边界如何划分,对系统的稳定性更有好处。 所以微服务、DevOps、容器是相辅相成,不可分割的。不是微服务,根本不需要容器,虚拟机就能搞定,不需要 DevOps,一年部署一次,开发和运维沟通再慢都能搞定。 所以,容器的本质是基于镜像的跨环境迁移。 镜像是容器的根本性发明,是封装和运行的标准,其它什么 namespace,cgroup,早就有了,这是技术方面。 在流程方面,镜像是 DevOps 的良好工具。 容器是为了跨环境迁移的,第一种迁移的场景是开发、测试、生产环境之间的迁移。如果不需要迁移,或者迁移不频繁,虚拟机镜像也行,但总是要迁移,带着几百 G 的虚拟机镜像,太大了。 第二种迁移的场景是跨云迁移,跨公有云,跨 Region,跨两个 OpenStack 的虚拟机迁移都是非常麻烦,甚至不可能的,因为公有云不提供虚拟机镜像的下载和上传功能,而且虚拟机镜像太大了,一传传一天。 所以跨云场景下,混合云场景下,容器也是很好的使用场景。这也同时解决了仅仅私有云资源不足,扛不住流量的问题。 所以这是我认为的容器的本质,是最终应该使用容器的正确姿势,当然一开始你不一定完全按照这个来。 模式一:公有云虚拟机 适合场景:初创公司,无信息安全担忧 如果您是一家初创公司,人员少,IT 运维能力不足,要部署的系统很少,能够花在 IT 系统上的资金有限,当然应该选择公有云的虚拟机部署,它能够解决您的如下问题: 基层 IT 资源的管理交给公有云平台,公司自身运维人员仅需要基本的 Linux 能力; 少量的部署系统,例如 10 台以下的虚拟机,往往替换一个 war,重启 Tomcat 就能解决,如果稍微虚拟机多一点 10 到 20 台,Ansible 脚本可以很好地解决这个问题; 公有云按量按时收费,可以在花费很少的情况下启动,并且在业务飞速扩展的时候,迅速申请大量虚拟机; 这里所说的信息安全担忧,真的仅仅是心理的担忧,公有云往往有大量的安全机制来保证每个租户的安全隔离,只要用好了这些机制,公有云的安全性绝对大于一般公司自己搭建的数据中心,当客户在说要安全的时候,客户在想什么? 这篇文章讲到了绝对的端到端解决方案。 这里贴张图说明公有云的安全性: (点击图片放大查看) 公有云为支撑自身高并发业务积累了更强的安全防护能力和更多的安全防护经验: 多线 BGP,外网线路冗余 高吞吐量的 DDoS 外网防护 更完善的防火墙,入侵检测,WAF 更完善的流量清洗规则 公有云为支撑自身高并发业务推出了更安全、更高可靠、更高可用的 PaaS 服务: 数据库: 高可用:主备切换数据零丢失 高可靠:同城双活,异地备份 安全性:访问控制,IP 白名单 对象存储: 高可靠:超大容量,三份备份,异地同步 安全性:访问控制,防盗链 公有云为支撑自身高并发业务推出更完善的监控运维的系统,流程,经验: 完善的监控系统,保障大促期间系统故障的快速定位和排障 保障大促能够极大的提升和训练一支有经验的运维团队 大促的业务层面的数据对运维也是机密的,需要流程保障 道高一尺魔高一丈,公有云为保证自身业务的安全性对云平台不断升级: 越来越强的 DDoS 防护 越来越完善的防火墙规则 最新的云平台安全功能和机制 不断更新的虚拟机和容器镜像建设漏洞 不断更新的病毒库 模式二:无 IaaS,裸用容器 适用场景:初创公司无 IaaS,有信息安全担忧 但是即便如此,还是有初创公司或者初创项目,也许因为心理方面,也许因为合规方面,非常担心信息安全问题,还是希望采取部署在自己机房的方式。 但由于是初创公司,在机房里面一般是不能部署 IaaS,因为 IaaS 平台的运维难度,优化难度更大,没有一个 50 人的团队根本玩不起来,所以一般在使用容器之前,采用的是物理机部署的方式,当物理机数目非常小,比如部署 5 到 10 个应用的时候手动部署或者简单脚本部署就可以,但是一旦到了 20 个应用,手动部署和简单脚本就非常麻烦了: 运维人员比例低,而应用相对较多 部署在同一个物理机上的应用多,配置冲突,端口冲突,互相连接,运维需要一个 excel 去管理,还容易出错 物理机容器被脚本和 Ansible 改的乱七八糟,难以保证环境一致性,重装物理机更加麻烦 不同的应用依赖不同的操作系统和底层包,千差万别 这个时候,可以试一下裸用容器,即在原来的脚本,或者 Ansible 里面,将启动进程,改为使用 Docker run,可以有以下的作用: 配置,端口隔离,冲突减少 基于容器部署,使得环境一致性,安装和删除干干净净 不同的操作系统和底层包,都可以用容器镜像搞定 在这个阶段,最简单的方式就是把容器当做虚拟机来使用,也即先启动容器,然后在里面下载 war 包等,当然也可以更进一步,将 war 包和配置直接打在容器镜像里面,这样需要一个持续集成的流程了,不仅仅是运维的事情,开发也要参与其中。 在这个阶段,网络的模式可以使用桥接打平的方式。 这种方式好处是访问 Docker 和访问物理机一样,可很方便地实现 Docker 里面和物理机里面的互通,兼容原来部署在物理机上的应用。 当然 Bridge 的性能一般,如果性能要求比较高,可使用 SR-IOV 网卡嵌入容器内。 模式三:有 IaaS,裸用容器 适用场景:创新项目,引入 DevOps 流程 有一些公司规模大一些,已经采购了 IaaS,只不过有一些创新的项目需要部署,这种状态下,基本虚拟机已经能够满足需求,而且由于能够运维 IaaS,IT 能力比较强,一般也采用了 Ansible 等部署工具。 这种情况下,使用容器的动力相对比较少,然而容器也是能够带来一定好处的,就是 DevOps。 创新项目迭代速度比较快,如果有比较多的创新项目,对运维的压力也是非常大的,这里的裸用容器和模式二的裸用容器不同的是,不是拿容器当做虚拟机来用,而是将容器当做交付物来用。 虽然容器化对于运维的整个过程来讲改进有限,但是关键就是要开发写一个 Dockerfile,这一点非常重要,意味着运行环境的配置提前到开发,而非直接交到运维,也即上面说的,开发 5% 的工作量增加减少大量运维工作,容器环境原子性升级回滚使得停服时间变短,可以保持开发、测试、运维环境的一致性。 模式四:使用 Docker Swarm Mode 适用场景:发展中公司,中等规模集群 当集群规模超过 50 台时,裸用容器已经非常难受了,因为网络、存储、编排、服务发现等全部要靠自己的脚本或 Ansible 来搞定,是时候引入容器平台了。 当容器平台规模不是很大时,Docker Swarm Mode 还是比较好用的: 集群的维护不需要 Zookeeper,不需要 Etcd,自己内置 命令行和 Docker 是一样的,用起来顺手 服务发现和 DNS 是内置的 Docker Overlay 网络是内置的 总之 docker 帮你料理好了一切,你不用太关心细节,很容易就能够将集群运行起来。 而且可以通过 docker 命令,像在一台机器上使用容器一样使用集群上的容器,可以随时将容器当虚拟机来使用,这样对于中等规模集群,以及运维人员还是比较友好的。 当然内置的太多了也有缺点,就是不好定制化,不好 Debug,不好干预。当你发现有一部分性能不行时,你需要改整个代码,全部重新编译,当社区更新了,合并分支是很头疼的事情。当出现问题时,由于 Manager 大包大揽干了很多活,不知道哪一步出错了,反正就是没有返回,停在那里,如果重启整个 Manager,影响面又很大。 模式五:使用 Marathon 和 Mesos 使用场景:万节点集群,多定制 当集群规模大一些,几百个节点时,很多人就不愿意使用 Docker Swarm Mode 了,很多的选择是既没有用 DC/OS,也没有用 Kubernetes,而是仅仅用了 Marathon 和 Mesos。 因为 Mesos 是一个非常优秀的调度器,它的双层调度机制可以使得集群规模大很多。 Mesos 的调度过程如图所示: Mesos 有 Framework、Master、Agent、Executor、Task 几部分组成。这里面有两层的 Scheduler,一层在 Master 里面,allocator 会将资源公平的分给每一个 Framework,二层在 Framework 里面,Framework 的 scheduler 将资源按规则分配给 Task。 其它框架的调度器是直接面对整个集群,Mesos 的优势在于,第一层调度先将整个 Node 分配给一个 Framework,然后 Framework 的调度器面对的集群规模小很多,然后在里面进行二次调度,而且如果有多个 Framework,例如有多个 Marathon,则可以并行调度不冲突。 详细的调度机制非常复杂,可以看 号称了解 mesos 双层调度的你,先来回答下面这五个问题!这篇文章。 而且 Mesos 的架构相对松耦合,有很多可以定制化的地方,从而运维人员可以根据自己的需要开发自己的模块。详细的定制方式看文章 定制化 Mesos 任务运行的几种方法。 这也是很多优秀的公司使用 Marathon 和 Mesos 的原因。 例如爱奇艺、去哪儿、携程、当当等都选择了使用 Mesos,需要提一下的是,大家如果参加社区,能发现裸用 Marathon 和 Mesos 的很多,但是整个 DC/OS 都用得比较少,而用 Marathon 和 Mesos 往往不能解决一些问题,因而这些 IT 能力非常强的互联网公司做了大量的自己的定制化,增加了 Marathon 和 Mesos 的外围模块。 模式六:使用开源 Kubernetes 使用场景:千节点集群,少定制 Kubernetes 模块划分得更细,模块比较多,比起裸 Marathon 和 Mesos 来讲功能丰富,而且模块之间完全的松耦合,可以非常方便地进行定制化。 而且 Kubernetes 的数据结构的设计层次比较细,非常符合微服务的设计思想。例如从容器->Pods->Deployment->Service,本来简单运行一个容器,被封装为这么多的层次,每个层次有自己的作用,每一层都可以拆分和组合,这样带来一个很大的缺点,就是学习门槛高,为了简单运行一个容器,需要先学习一大堆的概念和编排规则。 但是当需要部署的业务越来越复杂时,场景越来越多时,你会发现 Kubernetes 这种细粒度设计的优雅,使得你能够根据自己的需要灵活的组合,而不会因为某个组件被封装好了,从而导致很难定制。例如对于 Service 来讲,除了提供内部服务之间的发现和相互访问外,还灵活设计了 headless service,这使得很多游戏需要有状态的保持长连接有了很好的方式,另外访问外部服务时,例如数据库、缓存、headless service 相当于一个 DNS,使得配置外部服务简单很多。很多配置复杂的大型应用,更复杂的不在于服务之间的相互配置,可以有 Spring Cloud 或者 Dubbo 去解决,复杂的反而是外部服务的配置,不同的环境依赖不同的外部应用,External Name 这个提供了很好的机制。 包括统一的监控 cadvisor,统一的配置 confgMap,都是构建一个微服务所必须的。 然而 Kubernetes 当前也有一个瓶颈——集群规模还不是多么大,官方说法是几千个节点,所以超大规模的集群,还是需要有很强的 IT 能力进行定制化,这个在模式七中会说一下我们在网易云上做的事情。但是对于中等规模的集群也足够了。 而且 Kubernetes 社区的热度,可以使得使用开源 Kubernetes 的公司能够很快地找到帮助,等待到新功能的开发和 Bug 的解决。 模式七:深入掌握使用 Kubernetes 使用场景:万节点集群,IT 能力强 随着 Kubernetes 使用规模的越来越大,大型的公司可以对 Kubernetes 进行一定的定制化,从而可以实现万节点甚至更大规模的支撑,当然需要 IT 能力比较强,网易在这方面有很多的实践。 从 APIServer 看集群的规模问题 随着集群规模的扩大,apiserver 的压力越来越大。 因为所有的其他组件,例如 Controller、Scheduler、客户端、Kubelet 等都需要监听apiserver,来查看 etcd 里面的变化,从而执行一定的操作。 很多人都将容器和微服务联系起来,从 Kubernetes 的设计可以看出,Kubernetes 的模块设计时非常的微服务化,每个进程都仅仅干自己的事情,而通过 apiserver 的松耦合关联起来。 而 apiserver 则很像微服务中的 api 网关,是一个无状态的服务,可以很好地弹性伸缩。 为了应对 listwatch,apiserver 用了 watchcache 来缓解压力,然而最终的瓶颈还是在 etcd 上。 最初用的是 etcd2,这时候 listwatch 每次只能接受一个事件,所以压力很大。为了继续使用 etcd2,则需要使用多个 etcd2 的集群来解决这个问题,通过不同的租户分配到不同的 etcd2 集群来分担压力。 将来会迁移到 etcd3 有了事件的批量推送,但是从 etcd2 到 etcd3 需要一定的迁移工作。 通过优化 Scheduler 解决并行调度的问题 大的资源池的调度也是一个很大的问题,因为同样一个资源只能被一个任务使用,如果并行调度,则存在两个并行的调度器同时认为某个资源空闲,于是同时将两个任务调度到同一台机器,结果出现竞争的情况。 为了租户隔离,不同的租户是不共享虚拟机的,这样不同的租户是可以参考 Mesos 机制进行并行调度的。因为不同的租户即便进行并行调度,也不会出现冲突的现象,每个租户不是在几万个节点中进行调度,而仅仅在属于这个租户的有限的节点中进行调度,大大提高了调度策略。 并且通过预过滤无空闲资源的 Node,调整 predicate 算法进行预过滤,进一步减少调度规模。 通过优化 Controller 加快新任务的调度速度 Kubernetes 采用的是微服务常使用的基于事件的编程模型。 当有增量事件产生时,则 controller 根据事件进行添加、删除、更新等操作。 但基于事件模型的一个缺点是,总是通过 delta 进行事件触发,过了一段时间,就不知道是否同步了,因而需要周期性地 Resync 一下,保证全量的同步之后,然后再进行增量的事件处理。 然而问题来了,当 Resync 时,正好遇到一个新容器的创建,则所有的事件在一个队列里面,拖慢了新创建容器的速度。 通过保持多个队列,并且队列的优先级 ADD 优于 Update 优于 Delete 优于 Sync,保证相应的实时性。 模式八:深入掌握使用 DC/OS 使用场景:万节点集群,IT 能力强 前面说过 Mesos 由于本身独特的调度机制,从而支撑的集群规模比较大,但是大多数使用 Mesos 的公司都没有使用 DC/OS,而是裸使用 Marathon 和 Mesos 外加自己定制开发的一些组件。 Mesos 可以支持当集群规模非常大,单个 Marathon 的性能不足以支撑时,可以使用自己的 Framework 机制,使得不同的租户使用单独的 Marathon 来解决问题。 后来 DC/OS 在最基础的 Marathon 和 Mesos 之上添加了很多的组件,如图所示,现在已经非常丰富,例如 DCOS 的客户端 (kubectl)、API 网关 admin router (类似 apiserver)、服务发现 minuteman(类似 kube-proxy)、Pod 的支持、CNI 插件的支持、存储插件的支持等,和 Kubernetes 已经非常像了。 很多公司裸用 Marathon 和 Mesos 而没有进一步使用 DC/OS,可能是因为和核心组件 Mesos 已经经过大规模生产性支撑不同,这些外围的组件也是新的,对其稳定性也是有一定的顾虑,所以需要比较长的学习曲线,并且对于这些新的组件有非常好的把控,才敢上生产。 所以从这个角度来讲,虽然 Mesos 的稳定性和大规模无容置疑,但就整个 DC/OS 来讲,和 Kubernetes 从功能和稳定性来讲,在伯仲之间,都需要使用者有强大的 IT 能力,对于开源软件的各个模块非常熟悉,甚至能够做一定的代码修改和 Bug fix,才敢在大规模集群中使用。 模式九:部署大数据,Kubernetes vs. Mesos Mesos 还有一个优势,就是 Mesos 可以通过开发 Framework,构建大数据平台,例如 Spark 就有基于 Mesos 的部署方式。 基于 Mesos 的 Spark 有两种方式,粗粒度和细粒度。 粗粒度模式(Coarse-grained Mode):应用程序的各个任务正式运行之前,需要将运行环境中的资源全部申请好,且运行过程中要一直占用这些资源,即使不用,最后程序运行结束后,回收这些资源。组粒度的方式浪费资源。 细粒度模式(Fine-grained Mode):按需分配,应用程序启动时,先会启动 executor,但每个 executor 占用资源仅仅是自己运行所需的资源,不需要考虑将来要运行的任务,之后,mesos 会为每个 executor 动态分配资源,每分配一些,便可以运行一个新任务,单个 Task 运行完之后可以马上释放对应的资源。细粒度的缺点是性能有问题。 其实细粒度模式才是真正能够发挥 Mesos 动态资源调度最有效的方式,但是考虑到有大幅度的性能降低,https://issues.apache.org/jira/browse/SPARK-11857,很可惜这种方式在 Spark 2.0.0 被 deprecated 掉了。 如果使用 kubernetes 部署大数据,其实和部署一个普通的应用思路差不多,和 Mesos 不同,kubernetes 不会干预到大数据运行的上下文中,Kubernetes 启动的容器仅仅作为资源预留方式存在,容器内的资源分配则大数据平台自己解决。这样的利用率就降低了,相当于粗粒度模式。 基于容器部署大数据平台,也是建议部署计算部分,例如 Map-Reduce,或者 Spark,对于数据部分 HDFS,应当另行部署。 模式十:容器和虚拟化混合部署 使用场景:大型公司,逐步容器化 对于很多大公司但是非互联网公司,使用容器还是需要小心对待的,因而需要逐步容器化,所以存在有 IaaS 平台,并且虚拟机和容器混合使用的状态,这种状态可能会持续相当长的时间。 在这种情况下,建议容器套在虚拟机里面使用。 使用 Flannel 和 Calico 都仅仅适用于裸机容器,而且仅仅用于容器之间的互通。 一旦有 IaaS 层,就会存在网络二次虚拟化的问题。 虚拟机之间的互联是需要通过一个虚拟网络的,例如 vxlan 的实现,而使用 Flannel 或者 Calico 相当于在虚拟机网络虚拟化的上面再做一次虚拟化,使得网络性能大幅度降低。 而且如果使用 Flannel 或者 Calico,那容器内的应用和虚拟机上的应用相互通信时,则需要出容器平台,多使用 node port,通过 NAT 的方式访问,或者通过外部负载均衡器的方式进行访问。在现实应用中,不可能一下子将所有的应用全部容器化,只是部分应用容器化,部分应用部署在虚拟机里面是常有的现象。然而通过 NAT 或者外部负载均衡器的方式,对应用的相互调用有侵入,使得应用不能像原来一样相互调用,尤其是当应用之间使用 Dubbo 或者 SpringCloud 这种服务发现机制时,尤其如此。 网易云开发了自己的 NeteaseController,在监听到有新的 Pod 创建时,调用 IaaS 的 API 创建 IaaS 层的虚拟网卡,然后在虚拟机内部,通过调用 Netease CNI 插件将虚拟网卡添加到容器里面。添加技术用的就是上一节提到的 setns 命令。 通过这个图我们可以看出,容器的网卡是直接连接到虚拟私有网络的 OVS 上的,和虚拟机是一个平的二层网络,在 OVS 来看,容器和虚拟机是在同一个网络里面的。 这样一方面没有了二次虚拟化,只有 OVS 一层虚拟化。另外容器和虚拟机网络打平的好处是,当部分应用部署容器、虚拟机时,对应用没有侵入,应用原来如何相互访问,现在还是如何访问,有利于应用逐步容器化。 OpenStack 里面有一个项目 Kuryr 可以很好地去做这件事情,完全使用开源的 OpenStack 和 Kubernetes 可以尝试集成一下。 !完 ! 谋胆并重

优秀的个人博客,低调大师

用 k8s 管理机密信息 - 每天5分钟玩转 Docker 容器技术(155)

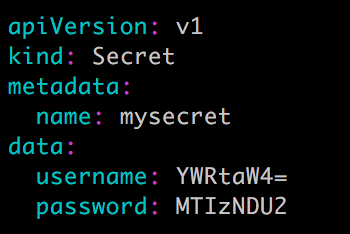
应用启动过程中可能需要一些敏感信息,比如访问数据库的用户名密码或者秘钥。将这些信息直接保存在容器镜像中显然不妥,Kubernetes 提供的解决方案是 Secret。 Secret 会以密文的方式存储数据,避免了直接在配置文件中保存敏感信息。Secret 会以 Volume 的形式被 mount 到 Pod,容器可通过文件的方式使用 Secret 中的敏感数据;此外,容器也可以环境变量的方式使用这些数据。 Secret 可通过命令行或 YAML 创建。比如希望 Secret 中包含如下信息: 用户名admin 密码123456 创建 Secret 有四种方法创建 Secret: 1. 通过--from-literal: kubectl create secret generic mysecret --from-literal=username=admin --from-literal=password=123456 每个--from-literal对应一个信息条目。 2. 通过--from-file: echo -n admin > ./username echo -n 123456 > ./password kubectl create secret generic mysecret --from-file=./username --from-file=./password 每个文件内容对应一个信息条目。 3. 通过--from-env-file: cat << EOF > env.txt username=admin password=123456 EOF kubectl create secret generic mysecret --from-env-file=env.txt 文件env.txt中每行 Key=Value 对应一个信息条目。 4. 通过 YAML 配置文件: 文件中的敏感数据必须是通过 base64 编码后的结果。 执行kubectl apply创建 Secret: 下一节我们学习如何使用这些创建好的 Secret。 书籍: 1.《每天5分钟玩转Kubernetes》https://item.jd.com/26225745440.html 2.《每天5分钟玩转Docker容器技术》https://item.jd.com/16936307278.html 3.《每天5分钟玩转OpenStack》https://item.jd.com/12086376.html

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码