首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

Apache Spark机器学习3.4 模型估计

3.4 模型估计 在上一节完成了特征集选择,接下来需要评估模型参数。我们可以使用MLlib或者R语言进行评估,并准备分布式的计算。 为了简化操作,我们使用Databricks的作业特性。具体来讲,在Databricks环境中,前往“Job”菜单,创建作业,如下图所示: 接着,用户可以选择notebook来运行,指定集群并且调度作业。一旦作业被调度,用户可以监视作业的执行,并收集结果。 在3.2节,我们为选择的3个模型准备了一些代码。现在,需要修改这些代码和上一节讨论的最终特征集,以创建最终的notebook。 换句话说,我们有1个因变量和通过PCA和特征选择得到的17个特征。因此,我们需要将这些变量插入到我们第2节开发的代码中,以建立我们的notebook。然后,我们将使用Spark作业特征以分布式的方式执行这些notebook。 3.4.

优秀的个人博客,低调大师

Apache Spark机器学习3.5 模型评估

3.5 模型评估 在上一节,我们完成了模型估计任务。现在,对我们来讲是时候评估模型是否满足模型质量标准,以决定我们进行下一步的结果解释还是回到前面的阶段改善模型。 本节,我们将使用均方根误差(Root-Mean-Square Error,RMSE)和受试者工作特征(Receiver Operating Characteristic,ROC)曲线来评估我们模型的质量。计算RMSE和ROC曲线,我们需要使用测试数据而不是训练数据来评估模型。 3.5.1 快速评价 很多软件包为用户提供一些算法来快速评估模型。例如,在MLlib和R语言中,逻辑回归模型都提供混淆矩阵和误报数计算。 具体来讲,MLlib为我们提供confusionMatrix 和numFalseNegatives()这两个函数和一些算法来快速计算MES,如下所示: 此外,R语言为我们

优秀的个人博客,低调大师

Android Activity和Intent机制学习笔记

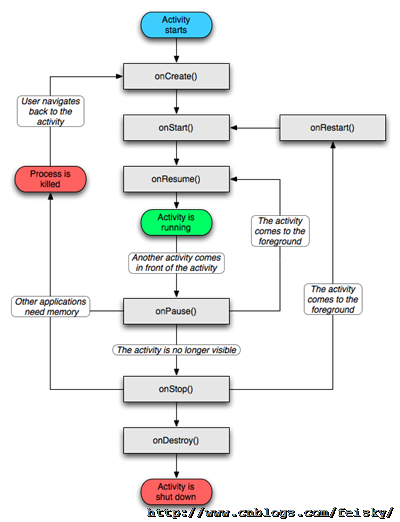
Activity Android中,Activity是所有程序的根本,所有程序的流程都运行在Activity之中,Activity具有自己的生命周期(见http://www.cnblogs.com/feisky/archive/2010/01/01/1637427.html,由系统控制生命周期,程序无法改变,但可以用onSaveInstanceState保存其状态)。 对于Activity,关键是其生命周期的把握(如下图),其次就是状态的保存和恢复(onSaveInstanceState onRestoreInstanceState),以及Activity之间的跳转和数据传输(intent)。 Activity中常用的函数有SetContentView() findViewById() finish() startActivity(),其生命周期涉及的函数有: void onCreate(BundlesavedInstanceState)void onStart()void onRestart()void onResume()void onPause()void onStop()void onDestroy() 注意的是,Activity的使用需要在Manifest文件中添加相应的<Activity>,并设置其属性和intent-filter。 Intent Android中提供了Intent机制来协助应用间的交互与通讯,Intent负责对应用中一次操作的动作、动作涉及数据、附加数据进行描述,Android则根据此Intent的描述,负责找到对应的组件,将 Intent传递给调用的组件,并完成组件的调用。Intent不仅可用于应用程序之间,也可用于应用程序内部的Activity/Service之间的交互。因此,Intent在这里起着一个媒体中介的作用,专门提供组件互相调用的相关信息,实现调用者与被调用者之间的解耦。在SDK中给出了Intent作用的表现形式为: 通过Context.startActivity()orActivity.startActivityForResult()启动一个Activity; 通过Context.startService()启动一个服务,或者通过Context.bindService()和后台服务交互; 通过广播方法(比如Context.sendBroadcast(),Context.sendOrderedBroadcast(),Context.sendStickyBroadcast()) 发给broadcast receivers。 Intent属性的设置,包括以下几点:(以下为XML中定义,当然也可以通过Intent类的方法来获取和设置) (1)Action,也就是要执行的动作 SDk中定义了一些标准的动作,包括 onstant Target component Action ACTION_CALL activity Initiate a phone call. ACTION_EDIT activity Display data for the user to edit. ACTION_MAIN activity Start up as the initial activity of a task, with no data input and no returned output. ACTION_SYNC activity Synchronize data on a server with data on the mobile device. ACTION_BATTERY_LOW broadcast receiver A warning that the battery is low. ACTION_HEADSET_PLUG broadcast receiver A headset has been plugged into the device, or unplugged from it. ACTION_SCREEN_ON broadcast receiver The screen has been turned on. ACTION_TIMEZONE_CHANGED broadcast receiver The setting for the time zone has changed. 当然,也可以自定义动作(自定义的动作在使用时,需要加上包名作为前缀,如"com.example.project.SHOW_COLOR”),并可定义相应的Activity来处理我们的自定义动作。 (2)Data,也就是执行动作要操作的数据 Android中采用指向数据的一个URI来表示,如在联系人应用中,一个指向某联系人的URI可能为:content://contacts/1。对于不同的动作,其URI数据的类型是不同的(可以设置type属性指定特定类型数据),如ACTION_EDIT指定Data为文件URI,打电话为tel:URI,访问网络为http:URI,而由content provider提供的数据则为content:URIs。 (3)type(数据类型),显式指定Intent的数据类型(MIME)。一般Intent的数据类型能够根据数据本身进行判定,但是通过设置这个属性,可以强制采用显式指定的类型而不再进行推导。 (4)category(类别),被执行动作的附加信息。例如 LAUNCHER_CATEGORY 表示Intent 的接受者应该在Launcher中作为顶级应用出现;而ALTERNATIVE_CATEGORY表示当前的Intent是一系列的可选动作中的一个,这些动作可以在同一块数据上执行。还有其他的为 Constant Meaning CATEGORY_BROWSABLE The target activity can be safely invoked by the browser to display data referenced by a link — for example, an image or an e-mail message. CATEGORY_GADGET The activity can be embedded inside of another activity that hosts gadgets. CATEGORY_HOME The activity displays the home screen, the first screen the user sees when the device is turned on or when the HOME key is pressed. CATEGORY_LAUNCHER The activity can be the initial activity of a task and is listed in the top-level application launcher. CATEGORY_PREFERENCE The target activity is a preference panel. (5)component(组件),指定Intent的的目标组件的类名称。通常 Android会根据Intent 中包含的其它属性的信息,比如action、data/type、category进行查找,最终找到一个与之匹配的目标组件。但是,如果 component这个属性有指定的话,将直接使用它指定的组件,而不再执行上述查找过程。指定了这个属性以后,Intent的其它所有属性都是可选的。 (6)extras(附加信息),是其它所有附加信息的集合。使用extras可以为组件提供扩展信息,比如,如果要执行“发送电子邮件”这个动作,可以将电子邮件的标题、正文等保存在extras里,传给电子邮件发送组件。 理解Intent的关键之一是理解清楚Intent的两种基本用法:一种是显式的Intent,即在构造Intent对象时就指定接收者;另一种是隐式的Intent,即Intent的发送者在构造Intent对象时,并不知道也不关心接收者是谁,有利于降低发送者和接收者之间的耦合。 对于显式Intent,Android不需要去做解析,因为目标组件已经很明确,Android需要解析的是那些隐式Intent,通过解析,将 Intent映射给可以处理此Intent的Activity、IntentReceiver或Service。 Intent解析机制主要是通过查找已注册在AndroidManifest.xml中的所有IntentFilter及其中定义的Intent,最终找到匹配的Intent。在这个解析过程中,Android是通过Intent的action、type、category这三个属性来进行判断的,判断方法如下: 如果Intent指明定了action,则目标组件的IntentFilter的action列表中就必须包含有这个action,否则不能匹配; 如果Intent没有提供type,系统将从data中得到数据类型。和action一样,目标组件的数据类型列表中必须包含Intent的数据类型,否则不能匹配。 如果Intent中的数据不是content: 类型的URI,而且Intent也没有明确指定它的type,将根据Intent中数据的scheme (比如 http: 或者mailto:) 进行匹配。同上,Intent 的scheme必须出现在目标组件的scheme列表中。 如果Intent指定了一个或多个category,这些类别必须全部出现在组建的类别列表中。比如Intent中包含了两个类别:LAUNCHER_CATEGORY 和 ALTERNATIVE_CATEGORY,解析得到的目标组件必须至少包含这两个类别。 Intent-Filter的定义 一些属性设置的例子: <action android:name="com.example.project.SHOW_CURRENT" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="video/mpeg" android:scheme="http" . . . /> <data android:mimeType="image/*" /> <data android:scheme="http" android:type="video/*" /> 完整的实例 <activity android:name="NotesList" android:label="@string/title_notes_list"> <intent-filter> <action android:name="android.intent.action.MAIN" /> <category android:name="android.intent.category.LAUNCHER" /> </intent-filter> <intent-filter> <action android:name="android.intent.action.VIEW" /> <action android:name="android.intent.action.EDIT" /> <action android:name="android.intent.action.PICK" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.dir/vnd.google.note" /> </intent-filter> <intent-filter> <action android:name="android.intent.action.GET_CONTENT" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.item/vnd.google.note" /> </intent-filter> </activity> Intent用法实例 1.无参数Activity跳转 Intent it = new Intent(Activity.Main.this, Activity2.class); startActivity(it); 2.向下一个Activity传递数据(使用Bundle和Intent.putExtras) Intent it = new Intent(Activity.Main.this, Activity2.class); Bundle bundle=new Bundle(); bundle.putString("name", "This is from MainActivity!"); it.putExtras(bundle); // it.putExtra(“test”, "shuju”); startActivity(it); // startActivityForResult(it,REQUEST_CODE); 对于数据的获取可以采用: Bundle bundle=getIntent().getExtras(); String name=bundle.getString("name"); 3.向上一个Activity返回结果(使用setResult,针对startActivityForResult(it,REQUEST_CODE)启动的Activity) Intent intent=getIntent(); Bundle bundle2=new Bundle(); bundle2.putString("name", "This is from ShowMsg!"); intent.putExtras(bundle2); setResult(RESULT_OK, intent); 4.回调上一个Activity的结果处理函数(onActivityResult) @Override protected void onActivityResult(int requestCode, int resultCode, Intent data) { // TODO Auto-generated method stub super.onActivityResult(requestCode, resultCode, data); if (requestCode==REQUEST_CODE){ if(resultCode==RESULT_CANCELED) setTitle("cancle"); else if (resultCode==RESULT_OK) { String temp=null; Bundle bundle=data.getExtras(); if(bundle!=null) temp=bundle.getString("name"); setTitle(temp); } } } 下面是转载来的其他的一些Intent用法实例(转自javaeye) 显示网页 1. Uri uri = Uri.parse("http://google.com"); 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. startActivity(it); 显示地图 1. Uri uri = Uri.parse("geo:38.899533,-77.036476"); 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. startActivity(it); 4. //其他 geo URI 範例 5. //geo:latitude,longitude 6. //geo:latitude,longitude?z=zoom 7. //geo:0,0?q=my+street+address 8. //geo:0,0?q=business+near+city 9. //google.streetview:cbll=lat,lng&cbp=1,yaw,,pitch,zoom&mz=mapZoom 路径规划 1. Uri uri = Uri.parse("http://maps.google.com/maps?f=d&saddr=startLat%20startLng&daddr=endLat%20endLng&hl=en"); 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. startActivity(it); 4. //where startLat, startLng, endLat, endLng are a long with 6 decimals like: 50.123456 打电话 1. //叫出拨号程序 2. Uri uri = Uri.parse("tel:0800000123"); 3. Intent it = new Intent(Intent.ACTION_DIAL, uri); 4. startActivity(it); 1.//直接打电话出去 2. Uri uri = Uri.parse("tel:0800000123"); 3. Intent it = new Intent(Intent.ACTION_CALL, uri); 4. startActivity(it); 5. //用這個,要在 AndroidManifest.xml 中,加上 6. //<uses-permission id="android.permission.CALL_PHONE" /> 传送SMS/MMS 1.//调用短信程序 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. it.putExtra("sms_body", "The SMS text"); 4. it.setType("vnd.android-dir/mms-sms"); 5. startActivity(it); 1.//传送消息 2. Uri uri = Uri.parse("smsto://0800000123"); 3. Intent it = new Intent(Intent.ACTION_SENDTO, uri); 4. it.putExtra("sms_body", "The SMS text"); 5. startActivity(it); 1.//传送 MMS 2. Uri uri = Uri.parse("content://media/external/images/media/23"); 3. Intent it = new Intent(Intent.ACTION_SEND); 4. it.putExtra("sms_body", "some text"); 5. it.putExtra(Intent.EXTRA_STREAM, uri); 6. it.setType("image/png"); 7. startActivity(it); 传送 Email 1. Uri uri = Uri.parse("mailto:xxx@abc.com"); 2. Intent it = new Intent(Intent.ACTION_SENDTO, uri); 3. startActivity(it); 1. Intent it = new Intent(Intent.ACTION_SEND); 2. it.putExtra(Intent.EXTRA_EMAIL, "me@abc.com"); 3. it.putExtra(Intent.EXTRA_TEXT, "The email body text"); 4. it.setType("text/plain"); 5. startActivity(Intent.createChooser(it, "Choose Email Client")); 1. Intent it=new Intent(Intent.ACTION_SEND); 2. String[] tos={"me@abc.com"}; 3. String[] ccs={"you@abc.com"}; 4. it.putExtra(Intent.EXTRA_EMAIL, tos); 5. it.putExtra(Intent.EXTRA_CC, ccs); 6. it.putExtra(Intent.EXTRA_TEXT, "The email body text"); 7. it.putExtra(Intent.EXTRA_SUBJECT, "The email subject text"); 8. it.setType("message/rfc822"); 9. startActivity(Intent.createChooser(it, "Choose Email Client")); 1. //传送附件 2. Intent it = new Intent(Intent.ACTION_SEND); 3. it.putExtra(Intent.EXTRA_SUBJECT, "The email subject text"); 4. it.putExtra(Intent.EXTRA_STREAM, "file:///sdcard/mysong.mp3"); 5. sendIntent.setType("audio/mp3"); 6. startActivity(Intent.createChooser(it, "Choose Email Client")); 播放多媒体 Uri uri = Uri.parse("file:///sdcard/song.mp3"); Intent it = new Intent(Intent.ACTION_VIEW, uri); it.setType("audio/mp3"); startActivity(it); Uri uri = Uri.withAppendedPath(MediaStore.Audio.Media.INTERNAL_CONTENT_URI, "1"); Intent it = new Intent(Intent.ACTION_VIEW, uri); startActivity(it); Market 相关1. //寻找某个应用 2. Uri uri = Uri.parse("market://search?q=pname:pkg_name"); 3. Intent it = new Intent(Intent.ACTION_VIEW, uri); 4. startActivity(it); 5. //where pkg_name is the full package path for an application 1. //显示某个应用的相关信息 2. Uri uri = Uri.parse("market://details?id=app_id"); 3. Intent it = new Intent(Intent.ACTION_VIEW, uri); 4. startActivity(it); 5. //where app_id is the application ID, find the ID 6. //by clicking on your application on Market home 7. //page, and notice the ID from the address bar Uninstall 应用程序1. Uri uri = Uri.fromParts("package", strPackageName, null);2. Intent it = new Intent(Intent.ACTION_DELETE, uri); 3. startActivity(it); 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/16/1649081.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

学习笔记-Redis设计与实现-事件

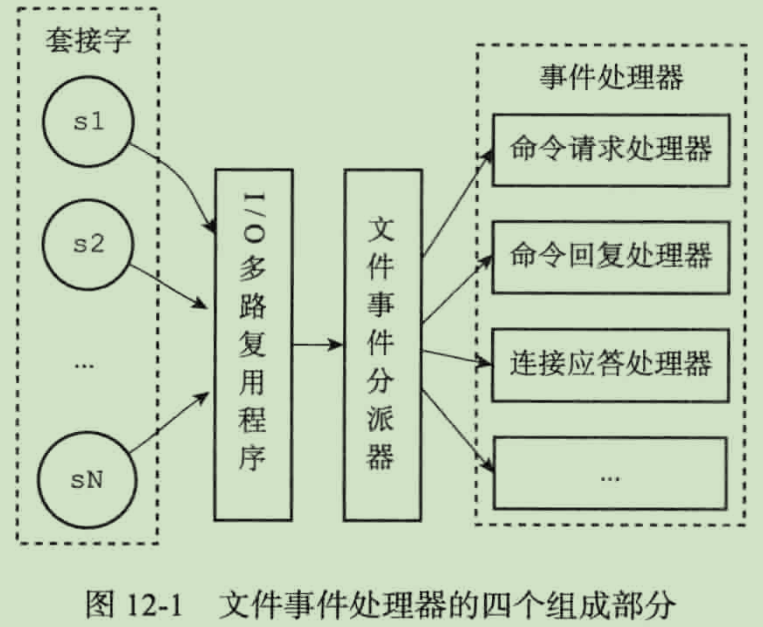
Redis服务器是一个事件驱动程序,服务器需要处理以下两类事件: 文件事件(file event):Redis服务器通过套接字与客户端(或者其他Redis服务器)进行连接,而文件事件就是服务器对套接字操作的抽象。 时间事件(time event):Redis服务器中的一些操作(比如serverCron函数)需要在给定的时间点执行,而时间事件就是服务器对这类定时操作的抽象。 12.1 文件事件 Redis基于Reactor模式开发了自己的网络事件处理器,被称为文件事件处理器(file event handler): 文件事件处理器使用I/O多路复用(multiplexing)程序来同时监听多个套接字,并根据套接字目前执行的任务来为套接字关联不同的事件处理器。 当被监听的套接字准备好执行连接应答(accept)、读取(read)、写入(write)、关闭(close)等操作时,与操作相对应的文件事件就会产生,这时文件事件处理器就会调用套接字之前关联好的事件处理器来处理这些事件。 虽然文件事件处理器以单线程方式运行,但通过使用I/O多路复用程序来监听多个套接字,文件事件处理器既实现了高性能的网络通信模型,又可以很好地与Redis服务器中其他同样以单线程方式运行地模块进行对接,这保持了Redis内部单线程设计地简单性。 12.1.1 文件事件处理器地构成 文件事件处理器的四个组成部分,分别时套接字、I/O多路复用程序、文件事件分派器(dispatcher),以及事件处理器。 文件事件是对套接字操作的抽象,每当一个套接字准备好执行连接应答(accept)、写入、读取、关闭等操作时,就会产生一个文件事件。因为一个服务器通常会连接多个套接字,所以多个文件事件有可能会并发地出现。 I/O多路复用程序负责监听多个套接字,并向文件事件分派器传送产生了事件地套接字。 尽管多个文件事件可能会并发地出现,但I/O多路复用程序总是会将所有产生事件地套接字都放到一个队列里面,然后通过这个队列,以有序(sequentially)、同步(synchronously)、每次一个套接字的方式向文件事件分派器传送套接字。 文件事件分派器接收I/O多路复用程序传来地套接字,并根据套接字产生地事件地类型,调用响应地事件处理器。 12.1.2I/O多路复用程序的实现 12.1.3 事件的类型 I/O多路复用程序可以监听多个套接字的ae.h/AE_READABLE事件和ae.h/AE_WRITEABLE事件,这两类事件和套接字操作之间的对应关系如下: 当套接字变得可读时(客户端对套接字执行write操作,或者执行close操作),或者有新的可应答(acceptable)套接字出现时(客户端对服务器的监听套接字执行connect操作),套接字产生AE_READABLE事件。 当套接字变得可写时(客户端对套接字执行read操作),套接字产生AE_WRITEABLE事件。 如果一个套接字又可读又可写,那么服务器优先读套接字,后写套接字。 12.1.4 API 12.1.5 文件事件的处理器 1、连接应答处理器 2、命令请求处理器 3、命令回复处理器 12.2 时间事件 Redis的时间事件分为定时事件和周期性事件。 一个时间事件主要由以下三个属性组成: id:服务器为时间事件创建的全局唯一ID。 when:毫秒精度的UNIX时间戳,记录了时间事件的到达时间。 timeProc:时间事件处理器。 一个时间事件是定时事件还是周期性事件取决于时间事件处理器的返回值: 如果事件处理器返回ae.h/AE_NOMORE,事件为定时事件:该事件在达到一次之后就会被删除。 如果事件处理器返回一个非AE_NOMORE的整数值,那么这个事件为周期性事件。 12.2.1 实现 服务器将所有时间事件都放在一个无序链表中,每当时间事件执行器运行时,它就遍历整个链表,查找所有已到达的时间事件,并调用相应的事件处理器。 12.2.2 API 12.2.3 时间事件应用实例:serverCron函数 持续进行的Redis服务器需要定期对自身的资源和状态进行检查和调整,从而确保服务器可以长期、稳定地运行,这些定期操作由redis.c/serverCron函数负责执行,它的主要工作包括: 更新服务器的各类统计信息,比如时间、内存占用、数据库占用情况等。 清理数据库中的过期键值对。 关闭和清理连接失效的客户端。 尝试进行AOF或RDB持久化操作。 如果服务器是主服务器,那么对从服务器进行定期同步。 如果处于集群模式,对集群进行定期同步和连接测试。 12.3 事件的调度与执行 事件的调度和执行规则: aeApiPoll函数的最大阻塞时间由到达时间最接近当前时间的时间事件决定,这个方法既可以避免服务器对时间事件进行频繁的轮询,也可以确保aeApiPoll函数不会阻塞过长时间。 因为文件事件是随机出现的,如果等待并处理完一次文件事件之后,仍未有任何时间事件到达,服务器将再次等待并处理文件事件。 对文件事件和时间事件的处理都是同步、有序、原子地执行地,服务器不会中途中断事件处理,也不会进行抢占,因此,不管是文件事件地处理器,还是时间事件地处理器,它们都会尽可能地减少程序地阻塞时间,并在有需要时主动让出执行权,从而降低造成事件饥饿地可能性。 因为时间事件在文件事件之后执行,并且事件之间不会出现抢占,所以时间事件地实际处理时间,通常会比时间事件设定的到达时间稍晚一些。 12.4 重点回顾 Redis服务器时一个事件驱动程序,服务器处理的事件分为时间事件和文件事件两类。 文件事件处理器是基于Reactor模式出现的网络通信程序。 文件事件是对套接字操作的抽象:每次套接字变为可应答(acceptable)、可写(writable)或者可读(readable)时,相应的文件事件就会产生。 文件事件分为AE_READABLE事件和AE_WRITEABLE事件两类。 时间事件分为定时事件和周期性事件。 服务器在一般情况下只执行serverCron函数一个时间函数,并且这个事件是周期性事件。 文本事件和时间事件之间是合作关系,服务器会轮流处理这种事件,并且处理事件的过程中也不会产生抢占。 时间事件的实际处理时间通常会比设定的到达时间晚一些。

优秀的个人博客,低调大师

机器学习实现海量新闻自动分类

通过最佳实践帮助您实现上述案例效果 Step1:数据导入MaxCompute 1.1 创建需要上传的本地数据 新闻文本表: 字段名 含义 类型 描述 category 新闻类型 string 体育、女性、社会、军事、科技等 title 标题 string 新闻标题 content 内容 string 新闻内容 源数据:nlp_use stop_words表: 字段名 含义 类型 描述 point 用户名 string 人 stop_words 标点符号 string " " ,等 源数据:stop_words 1.2 创建MaxCompute表 1.2.1 开通MaxCompute 阿

优秀的个人博客,低调大师

【MaxCompute学习】隐式转化的问题

有一次计算一个数据的百分比,想把小数结果取2位,并拼接一个百分号展示在结果报表中。用到的sql如下 selectconcat(round(10230/1497409,4)*100,'%')fromdual; 很奇怪局部数据并没有保留2位小数,比如上面的数据返回的是67.99999999999999 我计算了下上面的结果大概得到的数据为0.0068 selectconcat(round(0.0066,4)*100,'%')fromdual;--0.66% selectconcat(round(0.0067,4)*100,'%')fromdual;--0.67% selectconcat(round(0.0068,4)*100,'%')fromdual;--0.6799999999999999% sele

优秀的个人博客,低调大师

hbase 学习(十三)集群间备份原理

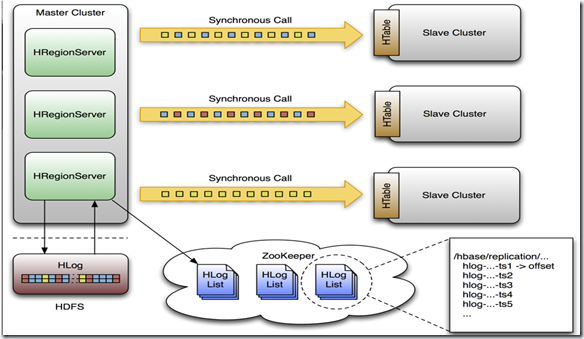
集群建备份,它是master/slaves结构式的备份,由master推送,这样更容易跟踪现在备份到哪里了,况且region server是都有自己的WAL 和HLog日志,它就像mysql的主从备份结构一样,只有一个日志来跟踪。一个master集群可以向多个slave集群推送,收到推送的集群会覆盖它本地的edits日志。 这个备份操作是异步的,这意味着,有时候他们的连接可能是断开的,master的变化不会马上反应到slave当中。备份个格式在设计上是和mysql的statement-based replication是一样的,全部的WALEdits(多种来自Delete和Put的Cell单元)为了保持原子性,会一次性提交。 HLogs是region server备份的基础,当他们要进行备份时必须保存在hdfs上,每个region server从它需要的最老的日志开始进行备份,并且把当前的指针保存在zookeeper当中来简化错误恢复,这个位置对于每一个slave 集群是不同的,但是对于同一个队列的HLogs是相同的。 下面这个是设计的结构图: 下面我们了解一下master和一个slave节点的整个过程。 1)当客户端通过api发送Put、Delete或者ICV到region server,这些KeyValue被转换成WALEdit,这个过程会被replication检测到,每一个设置了replication的列族,会把scope添加到edit的日志,然后追加到WAL中,并被应用到MemStore中。 2)在另一个线程当中,edit被从log当中读取来,并且只有可以备份的KeyValues(列族为scoped为GLOBAL的,并且不是catalog,catalog指的是.META. 和 -ROOT-) 3-1)这个edit然后被打上master群集的UUID,当buffer写满的时候或者读完文件,buffer会发到slave集群的随机的一个region server同步的,收到他们的region server把edit分开,一个表一个buffer,当所有的edits被读完之后,每一个buffer会通过HTable来flush,edits里面的master集群的UUID被应用到了备份节点,以此可以进行循环备份。 4-1)回到master的region server上,当前WAL的位移offset已经被注册到了zookeeper上面。 3-2)这里面,如果slave的region server没有响应,master的region server会停止等待,并且重试,如果目标的region server还是不可用,它会重新选择别的slave的region server去发送那些buffer。 同时WALs会被回滚,并且保存一个队列在zookeeper当中,那些被region server存档的Logs会更新他们在复制线程中的内存中的queue的地址。 4-2)当目标集群可用了,master的region server会复制积压的日志。 下面是一些具体的操作: 假设zookeeper当中的节点是/hbase/replication ,它会有三个子节点。 /hbase/replication/state /hbase/replication/peers /hbase/replication/rs The State znode state节点是记录是否可以进行备份的,它里面记录这个一个boolean值,true或者false,它是由hbase.replication决定的,同事它会在ReplicationZookeeper当中缓存,它还会因为在shell中执行了stop_replication而改变。 /hbase/replication/state [VALUE: true] The Peers znode 这个节点下面记录着所有需要备份的集群和他们当前的备份状态,如下: /hbase/replication/peers /1 [Value: zk1.host.com,zk2.host.com,zk3.host.com:2181:/hbase] /2 [Value: zk5.host.com,zk6.host.com,zk7.host.com:2181:/hbase]peer的id是自己在add_peer时候,自己提供的,后面的value是slave集群所使用的zookeeper集群,最后是所在的znode的父节点。 在每一个peer节点的下面还有一个表示状态的节点: /hbase/replication/peers /1/peer-state [Value: ENABLED] /2/peer-state [Value: DISABLED] The RS znode rs的节点下面包括了复制的region server以及需求复制的HLog的队列,看图就知道啦! 第一层节点记录着region server的机器名,端口号以及start code。 /hbase/replication/rs /hostname.example.org,6020,1234 /hostname2.example.org,6020,2856 下一层是需求复制的HLog的队列: /hbase/replication/rs /hostname.example.org,6020,1234 /1 /2 队列里面需要复制的HLog,值是已经被复制的最新的位置position。 /hbase/replication/rs /hostname.example.org,6020,1234 /1 23522342.23422 [VALUE: 254] 12340993.22342 [VALUE: 0]过程是上述的过程,下面展开讲一下具体的细节。 1)选择哪个region server去复制 当master节点准备好备份之后,它首先要通过slave集群的zookeeper,然后查看他们的rs的节点下面有多少可用的rs,然后随机选择他们中的一部分,默认是10%,如果有150个机器的话,会选择15个机器去发送。这个时候是有一个watcher在监视着slave集群的rs下面的变化,如果节点发生了变化,它会通知master节点的region server重发。 2)错误恢复,直接来个实际的例子 一个有3个region server集群正在和一个peer id为2的集群进行备份,每个region server下面都有一个队列 队列中的每个znode都是hdfs上的真实的文件名,“地址,端口.时间戳”。 /hbase/replication/rs/ 1.1.1.1,60020,123456780/ 2/ 1.1.1.1,60020.1234 (Contains a position) 1.1.1.1,60020.1265 1.1.1.2,60020,123456790/ 2/ 1.1.1.2,60020.1214 (Contains a position) 1.1.1.2,60020.1248 1.1.1.2,60020.1312 1.1.1.3,60020, 123456630/ 2/ 1.1.1.3,60020.1280 (Contains a position) 现在让1.1.1.2的zookeeper丢失session,观察者会创建一个lock,这个时候1.1.1.3完成了,它会把1.1.1.2的给接手过来,在自己的znode下面创建一个新的znode,并且加上dead的server的名称,就像下面这样子,原来的1.1.1.2的下面多了一层lock,1.1.1.3下面多了一个,和它原始的状态也不一样,前面多了个2。 /hbase/replication/rs/ 1.1.1.1,60020,123456780/ 2/ 1.1.1.1,60020.1234 (Contains a position) 1.1.1.1,60020.1265 1.1.1.2,60020,123456790/ lock 2/ 1.1.1.2,60020.1214 (Contains a position) 1.1.1.2,60020.1248 1.1.1.2,60020.1312 1.1.1.3,60020,123456630/ 2/ 1.1.1.3,60020.1280 (Contains a position) 2-1.1.1.2,60020,123456790/ 1.1.1.2,60020.1214 (Contains a position) 1.1.1.2,60020.1248 1.1.1.2,60020.1312然后1.1.1.3又自己倒腾了一会儿,假设它也挂了,最后的形态会是这样 1.1.1.1把1.1.1.3的未完成事业给接过了过来,所以我们看到1.1.1.1下面有个三手货和几个二手货。。。 /hbase/replication/rs/ 1.1.1.1,60020,123456780/ 2/ 1.1.1.1,60020.1378 (Contains a position) 2-1.1.1.3,60020,123456630/ 1.1.1.3,60020.1325 (Contains a position) 1.1.1.3,60020.1401 2-1.1.1.2,60020,123456790-1.1.1.3,60020,123456630/ 1.1.1.2,60020.1312 (Contains a position) 1.1.1.3,60020,123456630/ lock 2/ 1.1.1.3,60020.1325 (Contains a position) 1.1.1.3,60020.1401 2-1.1.1.2,60020,123456790/ 1.1.1.2,60020.1312 (Contains a position)原理说完了,从下面说说进行这个备份操作是哪些要求吧 (1)hbase的大的版本要一致 0.90.1 可以向0.90.0推送但是0.90.1不可以向0.89.20100725推送 (2)独立部署的zookeeper集群 (3)集群间的备份的表名和列族都要一致 (4)多个slave集群的话,要0.92以上版本 (5)集群间可以互相访问 (6)集群间的zookeeper.znode.parent不能相同 要使用这个集群建备份的功能需要先进行以下的设置: 1、修改hbase-site.xml文件 <property> <name>hbase.replication</name> <value>true</value> </property> 2、add_peer 输入这个命令,查看它的具体用法,然后添加 3、修改表的REPLICATION_SCOPE disable 'your_table' alter 'your_table', {NAME => 'family_name', REPLICATION_SCOPE => '1'} enable 'your_table' 4、list_peers 查看一下状态 5、备份完成之后如何进行数据校验,VerifyReplication就是专门来处理这个校验的。我们需要提供peer的id还有表名,verifyrep是它的简称,要用hadoop jar来运行。 集群之间备份的网址,说明他们是怎么工作的: http://hbase.apache.org/replication.html

优秀的个人博客,低调大师

hbase 学习(十六)系统架构图

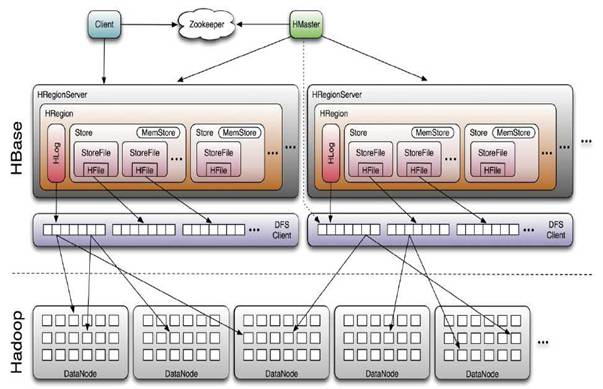
HBase 系统架构图 组成部件说明 Client: 使用HBase RPC机制与HMaster和HRegionServer进行通信 Client与HMaster进行通信进行管理类操作 Client与HRegionServer进行数据读写类操作 Zookeeper: Zookeeper Quorum存储-ROOT-表地址、HMaster地址 HRegionServer把自己以Ephedral方式注册到Zookeeper中,HMaster随时感知各个HRegionServer的健康状况 Zookeeper避免HMaster单点问题 HMaster: HMaster没有单点问题,HBase中可以启动多个HMaster,通过Zookeeper的Master Election机制保证总有一个Master在运行 主要负责Table和Region的管理工作: 1 管理用户对表的增删改查操作 2 管理HRegionServer的负载均衡,调整Region分布 3 Region Split后,负责新Region的分布 4 在HRegionServer停机后,负责失效HRegionServer上Region迁移 HRegionServer: HBase中最核心的模块,主要负责响应用户I/O请求,向HDFS文件系统中读写数据 HRegionServer管理一些列HRegion对象; 每个HRegion对应Table中一个Region,HRegion由多个HStore组成; 每个HStore对应Table中一个Column Family的存储; Column Family就是一个集中的存储单元,故将具有相同IO特性的Column放在一个Column Family会更高效 HStore: HBase存储的核心。由MemStore和StoreFile组成。 MemStore是Sorted Memory Buffer。用户写入数据的流程: Client写入 -> 存入MemStore,一直到MemStore满 -> Flush成一个StoreFile,直至增长到一定阈值 -> 触发Compact合并操作 -> 多个StoreFile合并成一个StoreFile,同时进行版本合并和数据删除 -> 当StoreFiles Compact后,逐步形成越来越大的StoreFile -> 单个StoreFile大小超过一定阈值后,触发Split操作,把当前Region Split成2个Region,Region会下线,新Split出的2个孩子Region会被HMaster分配到相应的HRegionServer上,使得原先1个Region的压力得以分流到2个Region上。 由此过程可知,HBase只是增加数据,有所得更新和删除操作,都是在Compact阶段做的,所以,用户写操作只需要进入到内存即可立即返回,从而保证I/O高性能。 HLog 引入HLog原因: 在分布式系统环境中,无法避免系统出错或者宕机,一旦HRegionServer意外退出,MemStore中的内存数据就会丢失,引入HLog就是防止这种情况 工作机制: 每个HRegionServer中都会有一个HLog对象,HLog是一个实现Write Ahead Log的类,每次用户操作写入Memstore的同时,也会写一份数据到HLog文件,HLog文件定期会滚动出新,并删除旧的文件(已持久化到StoreFile中的数据)。当HRegionServer意外终止后,HMaster会通过Zookeeper感知,HMaster首先处理遗留的HLog文件,将不同region的log数据拆分,分别放到相应region目录下,然后再将失效的region重新分配,领取到这些region的HRegionServer在Load Region的过程中,会发现有历史HLog需要处理,因此会Replay HLog中的数据到MemStore中,然后flush到StoreFiles,完成数据恢复。 HBase存储格式 HBase中的所有数据文件都存储在Hadoop HDFS文件系统上,格式主要有两种: 1 HFile HBase中KeyValue数据的存储格式,HFile是Hadoop的二进制格式文件,实际上StoreFile就是对HFile做了轻量级包装,即StoreFile底层就是HFile 2 HLog File,HBase中WAL(Write Ahead Log) 的存储格式,物理上是Hadoop的Sequence File HFile 图片解释: HFile文件不定长,长度固定的块只有两个:Trailer和FileInfo Trailer中指针指向其他数据块的起始点 File Info中记录了文件的一些Meta信息,例如:AVG_KEY_LEN, AVG_VALUE_LEN, LAST_KEY, COMPARATOR, MAX_SEQ_ID_KEY等 Data Index和Meta Index块记录了每个Data块和Meta块的起始点 Data Block是HBase I/O的基本单元,为了提高效率,HRegionServer中有基于LRU的Block Cache机制 每个Data块的大小可以在创建一个Table的时候通过参数指定,大号的Block有利于顺序Scan,小号Block利于随机查询 每个Data块除了开头的Magic以外就是一个个KeyValue对拼接而成, Magic内容就是一些随机数字,目的是防止数据损坏 HFile里面的每个KeyValue对就是一个简单的byte数组。这个byte数组里面包含了很多项,并且有固定的结构。 KeyLength和ValueLength:两个固定的长度,分别代表Key和Value的长度 Key部分:Row Length是固定长度的数值,表示RowKey的长度,Row 就是RowKey Column Family Length是固定长度的数值,表示Family的长度 接着就是Column Family,再接着是Qualifier,然后是两个固定长度的数值,表示Time Stamp和Key Type(Put/Delete) Value部分没有这么复杂的结构,就是纯粹的二进制数据 HLog File HLog文件就是一个普通的Hadoop Sequence File,Sequence File 的Key是HLogKey对象,HLogKey中记录了写入数据的归属信息,除了table和region名字外,同时还包括 sequence number和timestamp,timestamp是“写入时间”,sequence number的起始值为0,或者是最近一次存入文件系统中sequence number。 HLog Sequece File的Value是HBase的KeyValue对象,即对应HFile中的KeyValue 结束语:这篇文章是我专门在网上弄下来的,算是hbase部分的终极篇吧,我的服务端的源码系列也要基于这个顺序来开展。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册