首页 文章 精选 留言 我的

精选列表

搜索[API选型],共10007篇文章
优秀的个人博客,低调大师

分布式链路追踪选型-skywalking

为什么需要分布式链路追踪? 服务从单体应用升级到微服务的时候,整个请求的链路会变多,当发生异常、或遇到接口性能瓶颈时。很难将具体的异常日志和具体的请求关联起来,也很难直接定位是哪个调用环节存在性能瓶颈。这个时候就需要一个分布式链路追踪系统来串联调用链,快速定位问题。 更多详情及应用场景,参见 Google 分布式链路追踪论文 :《Dapper,大规模分布式系统的跟踪系统》 相关方案对比 方案 Jaeger zipkin ApacheskyWalking CAT Pinpoint ElasticAPM 开发语言 Go Java Java Java Java Go Github Star 12.7k+ 13.9K+ 15.9k+ 14.9k+ 11.1k+ 800+ Github contributors 191 146 313 77 99 53 Github open lssue/close Issue/PR 340 / 948 / 1399 132 / 1600 / 2101 61 / 3069 / 3122 107 / 974 / 1008 147 / 2891 / 4523 111 / 874 / 3647 背后公司或组织 CNCF、Uber Apache、Twitter Apache 美团 NAVER Elastic 侵入性 中 高 低 高 低 很低 OpenTracing兼容 是 是 是 否 否 不完善 客户端支持语言 Java、 Go、 Python. Node.js、 C++和C# Java, PHP, Go, Python, .NET, Ruby, Java, PHP, Go, C++, Node.js, Python, .NET, Lua, Java, Go, C/C++, Node.js, Python, Java, PHP, Python Java, PHP, Go, Node.js, Python, .Net, Ruby, UI丰富度 中 中 较高 高 高 中 监控报警 无,需结合其它工具实现 无,需结合其它工具实现 支持 支持 支持 支持 二次开发难度 低 中 中 高 高 高 存储类型 Memory, Cassandra, Elasticsearch, Kafka Memory, Cassandra, ElasticSearch and MysQL Memory( H2 )、 ElasticSearch, MySQL、 TiDB、 infulxdb HDFS HBase Elasticsearch github 数据截止 2021-1-25 日 分布式链路追踪:skywalking skywalking 是一个完整实现了 Google 分布式链路追踪论文所述功能的开源项目,最新的 skywalking 版本实现了作者发表的《STAM(流拓扑分析方法)》论文中的设计,该论文指出了Jaeger、zipkin 在分析服务拓扑方法的局限性,以及如何使用流拓扑分析的方法显著降低负载和内存成本。skywalking 的目标,是针对微服务、Cloud Native、容器化架构,提供应用性能监控和分布式调用链追踪能力。而且做到了在开启100%采样下,非常低的性能消耗,基于这些特点,以及下面这些特性,决定先采用 skywalking 作为链路追踪系统,如果有更好的替代方案欢迎在下方讨论 skywalking架构 如下图,skywalking 整个架构可分为五个模块: agent :各种语言、和框架适配的无缝接入探针,以及部分语言本身没有探针特性,也会提供集成的SDK支持手动集成 recelver:数据收集器,agent探针获取的调用链上下文数据会通过 grpc 或者 kafka 投递到数据收集器,支持各种协议的 trace 数据(包括 trace 规范协议、以及主流 trace 系统客户端sdk数据),metrics 数据收集,以及针对 service mesh 场景有单独实现收集器 aggregator:多个跨进程系统来源数据聚合、分析、关联 storage:最终落地持久化,落地数据库可选 es、tidb、influxdb、mysql、h2、shardingsphere web ui:采用 vue 实现的 前后端分离的 ui,界面美观 功能特性 1、trace 数据协议支持丰富 在 trace 数据收集方面,skywalking 支持了如下的 Trace 协议数据格式上报分析 opentracing Jaeger zipkin skywalking 协议 文档地址:backend-receivers.md 2、开发语言支持丰富 虽然 skywalking 是 java 语言实现的链路追踪项目,但是在客户端 sdk 集成方面,几乎覆盖了主流开发语言。java 等部分支持动态织入的应用可以通过 agent 探针技术无感集成,其他语言也均有完善的 sdk 支持 java:Java agent php :SkyAPM PHP SDK C++: cpp2sky go:SkyAPM GO2Sky lua:LUA agent node.js:Node.js agent .net:SkyAPM .NET Core agent python:Python Agent service mesh(服务网格实现):SkyWalking on Istio、Envoy Proxy 3、探针性能优异 从测验结果看,增加链路追踪,几乎不影响业务服务的吞吐,只会增加一点资源消耗 测验项目地址:https://github.com/SkyAPMTest/Agent-Benchmarks 4、ui 完善美观 服务拓扑 服务链路 响应排名,热点图等 参考线上体验 demo:http://demo.skywalking.apache.org/ 用户名:skywalking 密码:skywalking 5、架构灵活、不侵入业务 skywalking 在架构设计上,oapServer 是无状态的支持横向扩展,超大规模流量下,只要后端存储模块(elasticsearch)能够 hold 住,支撑 100% 的 trace 采样率没啥问题。而且,大部分语言的集成实现,支持无缝集成,不侵入业务,探针的可定制化程度高,trace 追踪力度可配置追踪每个内部 service 方法级别。支持 opentracing 协议以及自定义埋点的数据收集。经初步测验,oapServer 在处理能力不足、或者直接宕机的情况下,均不影响业务服务 6、社区活跃,企业用户多,对这个项目足够了解 skywalking 自开源以来,博主一直在关注这个项目,曾写过源码级的原理分析博文。作者吴晟早期在华为从事 apm 相关的工作,skywalking 最早是他个人主导的开源项目,随后捐献给 Apache 开源组织,并从 Apache 成功孵化毕业,最后成为 Apache 基金会顶级项目,。对 skywalking 内部的代码架构设计比较了解。曾经也给 skywalking 社区贡献过代码,截至目前已有三百多个代码贡献者,迭代到了8.x的版本。国内有很多公司采用 skywalking 搭建性能分析 、链路追踪系统 更多企业用户:https://github.com/apache/skywalking-website/blob/master/data/homepage.yml 部分公司落地分享资料: 【刘嘉鹏】devcon2020-爱番番skywalking实践经验.pdf 【宋振东】Apache SkyWalking在小米中的应用.pdf 【王院生】SkyWalking 与 Nginx 的优化实践 20201113.pdf 【赵禹光】SkyWalking Dev Con 分享贝壳全链路跟踪.pdf 【高洪涛】Observability Solutions in Cloud Native-高洪涛.pdf 【张鑫】2020-11-14-Connection-Pool.pdf 【吴晟】2020-SkyWalking DevCon Open Talk.pdf 分享视频:https://skywalking.apache.org/zh/2020-11-23-devcon/ 结语 Apache 的项目,虽然功能迭代和发版会经过严格的测试流程、发版表决流程,但是之前一直采用的 skywalking5.x 的版本,最新的版本到了8.x,功能增强了很多,ui 也更加美观了,整体变化比较大,所以先准备在小范围业务、部分流量尝试使用。 skywalking 相关资源 github:https://github.com/apache/skywalking 官网:https://skywalking.apache.org/ slack:https://the-asf.slack.com/join/shared_invite/zt-kcq6ba3p-Zjf1BvfpYzQu_kFQ99jefQ#/ QQ群:392443393
优秀的个人博客,低调大师

云产品的选型:8/2选择原则

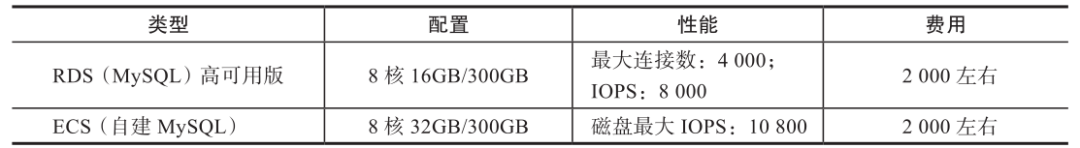
本文摘自于阿里云MVP、“乔帮主”乔锐杰所撰写的《阿里云运维架构实践秘籍》一书,选好云平台后,接下来要考虑的是在这个云平台上选择什么样的云产品进行业务部署及规划。可是在面对云平台上的两三百款产品时,难免会眼花缭乱。如何选择对应的产品?选择的重点是什么?我们又要注意哪些事项呢? 云产品的8/2选择原则 在云端应用场景下,80%的企业(默认情况)会选择云产品,只有20%的企业会考虑自行搭建对应服务。比如,有SLB,企业肯定不会自己去搭建Nginx做负载均衡;再如,有RDS,企业也定不会自己去搭建MySQL。 对于云产品的选择,有件事情让我印象深刻。一次去北京出差,与同事一起拜访了一家公司。这家公司在云领域有十几台服务器,由一位运维人员负责维护。该公司的数据库都是在ECS上搭建MySQL来运行的,于是我问那位运维人员,“为什么不选择RDS?”那位运维人员不假思索地说,“在ECS上搭建也挺方便的,为什么要用RDS?”听到这个回答,我有点不高兴了,比较严肃且强势地说,“使用RDS就不用你考虑安装配置、调优、备份、扩展等问题,拿来就用,为什么还要自己去折腾搭建!”所以选择合适的云产品,相比自行搭建,有以下技术方面及非技术方面的优势。 五个技术优势 安装配置方面 一些软件的编译安装,比如PHP,经常会有依赖包、版本兼容等问题,其安装配置没有想象中那么简单。而对于云产品,我们不用再去官网找安装包,也不用自己手动安装、配置,这一切云产品都默默地替你做了。 调优方面 对于云产品,我们也不用关心一些性能参数要如何去优化,这一切云产品也会默认替你实现。比如,MySQL的配置优化对细节、技术、经验都有较大的挑战,如果你对其性能要求较高,只需要在管理界面选择更高规格的配置型号,或者选择集群版本即可。 备份方面 在传统运维过程中,我们需要搭建主从、编写备份脚本以及操作Binlog来进行对应的备份及恢复,这方面对运维人员来说都是较大的挑战。但使用云产品时,我们也不用关心冷备、热备方面的问题了,因为这一切云产品都默认帮你实现了,你只需要“傻瓜式”地操作即可,哪里不会点哪里。 高可用方面 使用云产品,我们不用担心出现高可用方面的问题,也担心什么时候挂了没办法提供服务。在ECS、SLB、RDS、OSS等阿里云产品中,都是采用集群的方式部署对应的云产品,保证我们使用对应云产品的高可用性。比如,ECS和OSS都是三副本的数据冗余,而RDS,则是采用DNS+双Master架构来保障高可用性。除了开放给用户的一个RDS库以外,还有一个隐藏的从库未开放给客户(举例:进入RDS MySQL,通过“show slave statusG”可以看到隐藏的从库)。 安全性方面 对于安全性方面,使用云产品,不用关心软件版本的安全性问题,也不用关心这个版本的软件有哪些补丁、漏洞要去修复,更不用关心这个软件会被攻击的问题,这都是云产品默认会做到的。 两个非技术优势 责任方面 在非技术方面,云产品有一个很大的优势,即如果是自己搭建维护的平台出了问题,那么对客户、对领导都要负责,对应的损失也得自己承担;相反,如果使用云产品出现了对应问题(当然主要是云产品稳定性、性能、安全性、高可用等本身问题,不包括因用户不会使用及对应误操作等导致的问题),那么对应的损失甚至可以找云厂商进行索赔。 部分企业在面向客户服务的时候,想要自己招聘运维人员,而不想找第三方服务公司,觉得不安全,怕数据被第三方公司窃取,或者出现安全性问题。众所周知,企业招聘员工,本身在成本和管理上就有很大的困难,这里先不谈这方面的挑战。换个角度,企业招聘员工本身就是安全风险非常高的事情,比如,怎么保障这个员工不泄密?其实很多企业的数据泄露,不是因为被黑客窃取,而往往是因为公司内部人员泄密。有时候,我们也会看到一些有意思的故事,比如“从删库到跑路”。虽然大家把这些故事都当成笑话,但殊不知这都是真实的案例。比如,一个运维人员因加班而失恋,之后格式化了所在公司的所有服务器并离职。因此员工造成的问题,结果只能是企业自己扛。若面对的是第三方专业团队,那么这些问题就可由第三方专业团队解决,甚至向其索赔。 费用方面 当然,云产品责任方面的优势只是从特定的某个方面来说,具体情况还得看业务需求和业务场景。在实际应用中,很多用户会觉得使用云产品成本较高,不如自建平台。单纯使用高规格的云产品的费用的确不低,但是深入了解后你会发现,想自行在ECS上搭建出和云产品具备相同性能的环境,所采用的ECS台数和ECS配置的费用加起来也不比使用云产品的费用低多少,如下表所示。 这里有一个需要注意的地方,RDS的8核16GB配置只是一个规格配置参考,并不代表我们自己ECS上部署的MySQL也要采用8核16GB配置,这是个细节误区。RDS最主要的规格性能参数是:“最大连接数:4000; IOPS:8000”。所以在实际部署中,要让数据库达到如此性能。我们一般采用CPU和内存配比为1∶4的ECS配置(数据库偏向内存型应用,具体实践参考第5章),如4核16GB、8核32GB、16核64GB。在上述ECS的配置清单中,默认推荐选择8核32GB是为了保障自建数据库的性能和稳定性。而且RDS的高可用版是双机高可用版,我们在ECS上自建的MySQL是单机版,这里还需要再开一台做主从,以保障数据库数据的安全性和高可用。这样一来,成本就进一步增加了。 选择自建环境的条件 那么,具体在什么场景下我们才需要自己搭建对应的服务呢?对此主要从功能性和灵活性等方面来考虑,这也是自行搭建服务平台的相对优势。阿里云的很多云产品,如SLB、RDS、CDN等,其核心都是基于开源技术进行了封装并做了相应优化,然后形成对应的云产品。相应的封装给我们带来了相应的优势,但同时也给我们带来了相应的缺陷,比如,做了封装,必然会使很多原生态的功能和特性存在一定的使用限制,下面我们具体来看。 七层SLB的功能限制 何为七层负载均衡?更多地称之为反向代理,大家最为熟悉的就是Nginx。何为七层反向代理/负载均衡?是因为它不只是能做七层转发,而更多的是能在七层上做很多Rewrite的七层控制等。而早期的SLB产品,连虚拟主机功能都不支持,只是可以简单地七层转发。当然,当前SLB产品已经支持虚拟主机,具有七层代表性的核心功能。如果想用Rewrite等更多七层功能,我们只能自行在ECS上搭建Nginx。 连接Redis,有密码鉴权有些客户问这个密码鉴权能不能去掉,代码中采用了一个老的Ruby框架,不支持这个鉴权,也没办法改代码。所以这时候我们只能无奈地在ECS上自己搭建主从Redis,然后结合Console+DNS做高可用。 RDS MySQL对Myisam存储引擎的支持在用户的业务中,需要MySQL支持Myisam存储引擎。而RDS MySQL版默认只支持Innodb的存储引擎,所以我们只能在ECS上搭建MySQL来满足业务需求。 云数据库MongoDB对跨地域多副本冗余的支持若客户对数据的安全性要求较高,并且云端和他们线下IDC做了专线打通,他们需要将云端的MongoDB数据在线下IDC中做个副本,当前云数据库MongoDB结合DTS还不支持此功能。所以我们在云端搭建了两个副本,在IDC上同步一个副本,组成MongoDB的副本集。综上可见,有些功能是云产品没办法支持的,且当前企业没办法调整自己的业务架构及代码。这个时候基于灵活性和功能性方面的考虑,只能选择在ECS上搭建相应的服务。

优秀的个人博客,低调大师

用户画像的技术选型与架构实现

这里讲解下用户画像的技术架构和整体实现,那么就从数据整理、数据平台、面向应用三个方面来讨论一个架构的实现(个人见解)。 数据整理: 1、数据指标的的梳理来源于各个系统日常积累的日志记录系统,通过sqoop导入hdfs,也可以用代码来实现,比如spark的jdbc连接传统数据库进行数据的cache。还有一种方式,可以通过将数据写入本地文件,然后通过sparksql的load或者hive的export等方式导入HDFS。 2、通过hive编写UDF 或者hiveql 根据业务逻辑拼接ETL,使用户对应上不同的用户标签数据(这里的指标可以理解为为每个用户打上了相应的标签),生成相应的源表数据,以便于后续用户画像系统,通过不同的规则进行标签宽表的生成。 数据平台 1、数据平台应用的分布式文件系统为Hadoop的HDFS,因为Hadoop2.0以后,任何的大数据应用都可以通过ResoureManager申请资源,注册服务。比如(sparksubmit、hive)等等。而基于内存的计算框架的出现,就并不选用hadoop的MapReduce了。当然很多离线处理的业务,很多人还是倾向于使用Hadoop,但是hadoop的封装的函数只有map和Reduce太过单一,而不像spark一类的计算框架有更多封装的函数(可参考博客spark专栏)。可以大大提升开发效率。 2、计算的框架选用Spark以及RHadoop,这里Spark的主要用途有两种,一种是对于数据处理与上层应用所指定的规则的数据筛选过滤,(通过Scala编写spark代码提交至sparksubmit)。一种是服务于上层应用的SparkSQL(通过启动spark thriftserver与前台应用进行连接)。 RHadoop的应用主要在于对于标签数据的打分,比如利用协同过滤算法等各种推荐算法对数据进行各方面评分。 3、MongoDB内存数据的应用主要在于对于单个用户的实时的查询,也是通过对spark数据梳理后的标签宽表进行数据格式转换(json格式)导入mongodb,前台应用可通过连接mongodb进行数据转换,从而进行单个标签的展现。(当然也可将数据转换为Redis中的key value形式,导入Redis集群) 4、mysql的作用在于针对上层应用标签规则的存储,以及页面信息的展现。后台的数据宽表是与spark相关联,通过连接mysql随后cache元数据进行filter,select,map,reduce等对元数据信息的整理,再与真实存在于Hdfs的数据进行处理。 面向应用 1、从刚才的数据整理、数据平台的计算,都已经将服务于上层应用的标签大宽表生成。(用户所对应的各类标签信息)。那么前台根据业务逻辑,勾选不同的标签进行求和、剔除等操作,比如本月流量大于200M用户(标签)+本月消费超过100元用户(标签)进行和的操作,通过前台代码实现sql的拼接,进行客户数目的探索。这里就是通过jdbc的方式连接spark的thriftserver,通过集群进行HDFS上的大宽表的运算求count。(这里要注意一点,很多sql聚合函数以及多表关联join 相当于hadoop的mapreduce的shuffle,很容易造成内存溢出,相关参数调整可参考本博客spark栏目中的配置信息) 这样便可以定位相应的客户数量,从而进行客户群、标签的分析,产品的策略匹配从而精准营销。

优秀的个人博客,低调大师

LocalDateTime API 整理

对象介绍 Object desc format LocalDateTime 日期时间 yyyy-MM-dd'T'HH:mm:ss LocalDate 日期 yyyy-MM-dd LocalTime 时间 HH:mm:ss 获取对象实例 Function Desc now 获取当前时间 of 获取指定时间 判断 Prefix is Suffix desc after 是否在传入对象, 之后 before 是否在传入对象, 之前 equal 相等 supported 检查是否受支持( 字段支持, 单位支持 ) Demo LocalDateTime maxTime = LocalDateTime.now().plusSeconds(SendMessageConfig.getDelayTime()); if (messageDTO.getSendTime().isAfter(maxTime)) { return ViewUtils.build(ViewCodeEnum.ERROR.getCode(), "验证码超时", null); } 运算 Operation Prefix plus 加 Prefix minus 减 prefix get 获取 时间单位 Suffix Desc nanos 纳 seconds 秒 hours 小时 minutes 分钟 days 天 weeks 周 months 月 years 年 获取时间戳 Instant.now().toEpochMilli() System.currentTimeMillis()

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册