首页 文章 精选 留言 我的

精选列表

搜索[空间理解],共10007篇文章
优秀的个人博客,低调大师

python unittest框架理解

整个平台的搭建使用的是python的unittest测试框架,这里简单介绍下unittest模块的简单应用。 unittest是python的标准测试库,相比于其他测试框架是python目前使用最广的测试框架。 Unittest framework 正常调用unittest的流程是: 1、TestLoader 自动将测试用例TestCase中加载到TestSuite里 2、在执行TestCase过程中,先进行SetUp()环境准备,执行测试代码。 3、TextTestRunner调用TestSuite的run方法,顺序执行里面的TestCase中以test开头的方法,其中TestLoader在加载过程中,进行添加的TestCase是没有顺序的。一个TestCase里如果存在多个验证方法的话,会按照方法中test后方首字母的排序进行执行。可以通过手动调用TestSuite的addTest、addTests方法来动态添加TestCase,这样既可以确定添加用例的执行顺序,也可避免TestCase中的验证方法一定要用test开头。 4、最后tearDown()进行测试的还原。 5、得到测试结果TestResult。 KeywordsTestCase: The individual unit of testing.TestSuite: A collection of test cases, test suites, or both. It is used to aggregate tests that should be executed together.TestLoader: Load the test cases to the test suite.TestRunner: A component which orchestrates the execution of tests and provides the outcome to the user.TestFixture: Represents the preparation needed to perform one or more tests, and any associate cleanup actions. setUp(), tearDown(), setUpClass(), tearDownClass()Decorator: skip, skipIf, skipUnless, expectedFailure unittest有四个比较重要的概念是test fixture, test case, test suite, test runner, 。 test fixture:The test fixture is everything we need to have in place to exercise the sut。简单来说就是做一些测试过程中需要准备的东西,比如创建临时的数据库,文件和目录等,其中 setUp() 和 setDown() 是最常用的方法 test case:用户自定义的测试case的基类,调用run()方法,会依次调用setUP方法、执行用例的方法、tearDown()方法。 test suite:测试用例集合,可以通过addTest()方法手动增加Test Case,也可通过TestLoader自动添加Test Case,TestLoader在添加用例时,会没有顺序。 test runner:运行测试用例的驱动类,可以执行TestCase,也可执行TestSuite。执行后TestCase和Testsuite会自动管理TestResult。 Command linepython -m unittest xxxpython -m unittest -hpython -m unittest discover # discovery the test cases(test*.py) and execute automatically

优秀的个人博客,低调大师

深入理解springMVC

什么是spring MVC Spring MVC属于SpringFrameWork的后续产品,已经融合在Spring Web Flow里面。Spring 框架提供了构建 Web 应用程序的全功能 MVC 模块。使用 Spring 可插入的 MVC 架构,从而在使用Spring进行WEB开发时,可以选择使用Spring的SpringMVC框架或集成其他MVC开发框架,如Struts1(现在一般不用),Struts2(一般老项目使用)等。 spring mvc简介 springmvc是spring的一个模块,提供web层解决方案(基于mvc设计架构) 采用springmvc的好处 Spring MVC中提供一个DispatcherServlet, 无需额外开发。 springMVC中使用基于xml的配置文件,可以编辑,无需重新编译应用程序。 springMVC实例化控制器,并根据用户输入来构造bean。 springMVC可以自动绑定用户输入,并正确的转换数据类型。例如,springMVC能自动解析字 符串,并设置float或decimal类型的属性。 springMVC可以检验用户输入,若校验不通过,则重定向回输入表单。输入校验是可选的, 支持编码方式以及声明。关于这一点,springMVC内置了常见的校验器。 springMVC是spring框架的一部分。可以利用spring提供的其它能力。 springMVC支持国际化和本地化,支持根据用户区域显示多国语言。 springMVC支持多种视图技术,最常见的JSP技术以及其它技术包括Velocity和FreeMarker。 使用springMVC的优势 1、清晰的角色分配: 前段控制器(dispatcherServlet) , 请求到处理器映射(handlerMapping), 处理器适配器(HandlerAdapter), 视图解析器(ViewResolver), 处理器和页面控制器(Controller),验证器(Validator),命令对象(Command), 表单对象(FromObject) 2、分工明细 3、和Spring框架无缝结合 spring mvc框架流程图 SpringMvc整个的执行流程: 1、发起请求到前端控制器(DispatcherServlet) 2、前端控制器请求HandlerMapping查找Handler(可以根据xml、注解进行查找) 3、处理器映射器HandlerMapping向前端控制器DispatcherServlet返回Handler 4、前端控制器DispatcherServlet 调用处理器适配器HandlerAdapter 执行Handler 5、处理器适配器HandlerAdapter 执行Handler 6、Handler执行完给处理器适配器返回ModelAndView 7、处理器适配器向前端控制器返回ModelAndView (ModelAndView 是SpringMvc的底层对象 包括model和view) 8、前端控制器请求视图解析器去解析视图 根据逻辑视图名解析成真正的视图(jsp) 9、视图解析器向前端控制器返回view 10、前端控制器进行视图渲染 视图渲染将模型数据(模型数据在ModelAndView对象中)填充到request域 11、前端控制器向用户响应结果 组件: 1、前端控制器DispatcherServlet(不需要程序员开发) 作用接收请求,响应结果,相当于转发器,中央处理器。 有了DispatcherServlet减少了其它组件之间的耦合度。 2、处理器映射器HandlerMapping(不需要程序员开发) 作用:根据请求的url查找Handler 3、处理器适配器HandlerAdapter 作用:按照特定规则(HandlerAdapter要求的规则)去执行Handler 4、处理器Handler(需要程序员开发) 注意:编写Handler时按照HandlerAdapter的要求去做,这样适配器才可以去正确执行Handler 5、视图解析器View resolver(不需要程序员开发) 作用:进行视图解析,根据逻辑视图名解析成真正的视图(view) 6、视图View(需要程序员开发jsp) View是一个接口,实现类支持不同的View类型(jsp、freemarker、pdf...) springMVC常用注解 1. 在 struts-config.xml 文件中加入 2.在 applicationContext.xml 文件中加入 3.cn.base.GetPersonListAction 实现请求响应代码 可以看出一次请求需求如此多的步骤,在加上一个项目下来有很多这样的请求响应,将给配置文件管理带来很大的麻烦。 经过对 Spring 的深入应用, Spring 本身提供的 URL 请求控制,对其天然支持可以让我们不需要 applicationContext.xml 再次声明一次 URL 请求 Bean ,即减少了 Struts 的声明 URL ,达到减少些繁琐的配置。但只是少了一些而已,同样也会面临着配置文件的管理问题。 Spring 注解将给我们的工作带来些轻松,利用反射机制原理出现的注解就是为了解决配置大量的配置问题。请看下处理一次简单的请求响应代码 @Controller --声明控制器 @RequestMapping("/person") –声明URL public class PersonControl extends BaseController { @Autowired –业务接口注入 private personServices personServices;/*** 获得人员列表*@param request* @param response* @throws Exception*/ @RequestMapping(params = "method=geList") --即处理/person.do? method=geList方法 public void getnodeList(HttpServletRequest request,HttpServletResponse response) throws Exception { //处理请求//处理响应}} 可以看出,在代码上加入注解可以省去我们上面说的多个配置文件的工作,达到简便的 MVC 处理请求响应。 再配上简单的配置文件声明,即可轻松处理项目的全部请求控制工作。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Python socket 编程理解

HTTP 、Socket 、 TCP 七层OSI网络模型,这里只介绍五层常用网络模型,想知道全部七层详细内容自行查询。 应用层 :HTTP FTP SMTP DNS Telnet 传输层 :TCP UDP 网络层 :IP ICMP 数据链路层 :ARP等 物理层 :1000BASE-SX等 socket是用来连接传输层和应用层,使得应用层可以直接和传输层做交互。 socket本身不属于网络协议,socket可以直接操控tcp,这样可以实现自己的应用层协议,例如聊天室就是,socket可以直接和tcp打交道,实现与http同级别的网络协议。 image.png image.png 上图左侧是server端,右侧是client端

优秀的个人博客,低调大师

面向设计原则理解

面向对象设计(OOD)核心原则让我的程序模块达到“高内聚低耦合”,这是来自于30年前兴起的结构化设计(structured Design),但是同样适用于我们的OOD。 1.高内聚: 高内聚是指某个特定模块(程序,类型)都应完成一系列相关功能,描述了不同程序,类型中方法,方法中不同操作描述的逻辑之间的距离相近。高内聚意味可维护性,可重新性,因为模块对外部的依赖少(功能的完备性)。如果两个模块之间的修改,互不影响这说明模块之间是高内聚的。模块的内聚和其担当的职责成反比,即,模块的职责越多,模块的内聚性越低,这也是模块的单一原则(SRP),SRP提倡每个类型都最好只承担单一的职责,只有单一的改变因素。 2.低耦合: 耦合是描述模块之间的依赖程度,如果一个模块的修改,都有影响另一个模块则,两模块之间是相互依赖耦合的。(依赖具有传递性,耦合的两个模块可能间接依赖),低耦合是我们的设计目的,但不是不存在耦合不存依赖,依赖是必须的,因为模块之间必须通信交互,不过我的设计依赖应该依赖于不变或者不易变的接口,无需了解模块的具实现(OO封装性)。 在面向对象:我们可以简述为功能完备(高内聚)的对象之间的交互是依赖于不变或不易变的接口契约(低耦合)。 实现高内聚低耦合:行之有效的方式是分了关注点(SOC),将系统拆分成功能不同没有重叠功能集。每个功能只关注一个方面(Aspect)保证模块之间功能没有或者尽量少的重复。模块化内部实现细节隐藏,只暴露必须的接口,使得模块之间依赖于抽象,达到稳定。分离关注点的思想存在于我们软件设计的各个领域。如在.net的世界里SOA(面向服务架构)服务就是关注点,只暴露出必要的契约。分层架构从逻辑上利用接口抽象信息隐藏,减少依赖。MVC,MVP也是遵循分了关注点原则,达到表现层和逻辑的分离。 面向对象设计原则: 1.降低耦合度:对象直接需要交互,这就存在依赖,为了实现低耦合就必须减少依赖,依赖于稳定或不易变抽象。考虑如下订单日志记录场景:我们需要在订单每部操作记录更改日志。 public class OrderManager { public void Create(Order order) { //订单处理. Logger log = new Logger(); var history=GetHistory(); log.log(history); } } 在这里我们的OrderManager和Logger存在高耦合,Logger类的修改可能导致OrderManager的修改,而且不能随意切换我们的日志记录方式,比如文件,控制台,数据库等日志方式。 面向抽象编程提出抽象(接口,abstract类)是不易变的稳定抽象;对于OrderManager来说我不需要了解日志记录组件内部,只需要明白提供那些接口可用,怎么用。 public interface ILogger { void Log(History history); } public class Logger { public void Log(History history) { //内部实现 }; } 那么我们可以从设计模式工厂模式(工厂模式是负责一些列相似对象的创建)Create 日志组件ILogger。 我们的OrderManager 就可以实现为: ILogger log =LoggerFactory.Create(); log.Log(history); 这样我们的OrderManager就依赖于ILogger,而隔离Logger具体实现,将依赖于抽象,把变化缩小到Factory内部(同样也可以用抽象工厂),如果日志实现变化我们可以重新实现ILogger ,修改Factory逻辑,如果内部利用配置我的需求变更转移到配置。这就是面向对象第一原则,依赖于抽象而隐藏实现。(利用IOC是一种更好的方式) 2.代码的重用性:尽量保证相同功能代码只出现一次(Code once run anywhere)。代码的重用在面对对象设计中有继承和组合两种方式,一般推荐组合优先。组合依赖于接口,组合更安全,易于维护,测试。继承存在父类访问权限,父类的修改导致子类的变化,太多的继承也有导致派生类的膨胀,维护管理也是件头痛的事。 3.开闭原则(OCP):表述拥抱需求变化,尽量做到对模块的扩展开发,修改关闭。对于新增需求我们完美的做法是新增类型而不是修改逻辑,这就意味着我们必须使用组合或者是继承体系(为了避免上一条重用性,我的继承应该是干净的继承体系,派生类应该只是新增功能而不是修改来自父类上下文), 4.里氏替换(LSP):表述派生类应该可以在任何地方替代父类使用。并不是所有的子类都可以完全替换子类,比如设计父类私有上下文信息的访问,导致子类无法访问。 5.依赖倒置(DIP):描述组件之间高层组件不应该依赖于底层组件。依赖倒置是指实现和接口倒置,采用自顶向下的方式关注所需的底层组件接口,而不是其实现。DI框架实现IOC(控制反转)就是DIP很好的插入底层组件构造框架(分构造注入,函数注入,属性注入)。微软Unity,Castle windsor,Ninject等框架支持。 最后分离关注点,衍生出声明式编程,面向方面编程(AOP)实现纵切关注点,把具体业务逻辑和日志安全等框架集公用逻辑分离。 关于IOC/AOP参见博客我的IOC/AOP随笔目录不在累赘。 本文转自 破狼 51CTO博客,原文链接:http://blog.51cto.com/whitewolfblog/856563,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark-理解RDD

问题 spark的计算模型是如何做到并行的呢?如果你有一箱香蕉,让三个人拿回家吃完,如果不拆箱子就会很麻烦对吧,哈哈,一个箱子嘛,当然只有一个人才能抱走了。这时候智商正常的人都知道要把箱子打开,倒出来香蕉,分别拿三个小箱子重新装起来,然后,各自抱回家去啃吧。 Spark和很多其他分布式计算系统都借用了这种思想来实现并行:把一个超大的数据集,切分成N个小堆,找M个执行器(M < N),各自拿一块或多块数据慢慢玩,玩出结果了再收集在一起,这就算执行完啦。那么Spark做了一项工作就是:凡是能够被我算的,都是要符合我的要求的,所以spark无论处理什么数据先整成一个拥有多个分块的数据集再说,这个数据集就叫RDD。 RDD RDD(Resilient Distributed Datasets,弹性分布式数据集)是一个分区的只读记录的集合。RDD只能通过在稳定的存储器或其他RDD的数据上的确定性操作来创建。我们把这些操作称作变换以区别其他类型的操作。例如 map,filter和join。 RDD在任何时候都不需要被”物化”(进行实际的变换并最终写入稳定的存储器上)。实际上,一个RDD有足够的信息描述着其如何从其他稳定的存储器上的数据生成。它有一个强大的特性:从本质上说,若RDD失效且不能重建,程序将不能引用该RDD。而用户可以控制RDD的其他两个方面:持久化和分区。用户可以选择重用哪个RDD,并为其制定存储策略(比如,内存存储)。也可以让RDD中的数据根据记录的key分布到集群的多个机器。 这对位置优化来说是有用的,比如可用来保证两个要jion的数据集都使用了相同的哈希分区方式。 spark 编程接口 ,对编程人员通过对稳定存储上的数据进行变换操作(如map和filter).而得到一个或多个RDD。然后可以调用这些RDD的actions(动作)类的操作。这类操作的目是返回一个值或是将数据导入到存储系统中。动作类的操作如count(返回数据集的元素数),collect(返回元素本身的集合)和save(输出数据集到存储系统)。spark直到RDD第一次调用一个动作时才真正计算RDD。 还可以调用RDD的persist(持久化)方法来表明该RDD在后续操作中还会用到。默认情况下,spark会将调用过persist的RDD存在内存中。但若内存不足,也可以将其写入到硬盘上。通过指定persist函数中的参数,用户也可以请求其他持久化策略(如Tachyon)并通过标记来进行persist,比如仅存储到硬盘上或是在各机器之间复制一份。最后,用户可以在每个RDD上设定一个持久化的优先级来指定内存中的哪些数据应该被优先写入到磁盘。 缓存有个缓存管理器,spark里被称作blockmanager。注意,这里还有一个误区是,很多人认为调用了cache或者persist的那一刻就是在缓存了,这是完全不对的,真正的缓存执行指挥在action被触发。 现在数据存储在hdfs上,而数据格式以“;”作为每行数据的分割: "age";"job";"marital";"education";"default";"balance";"housing";"loan" 30;"unemployed";"married";"primary";"no";1787;"no";"no" 33;"services";"married";"secondary";"no";4789;"yes";"yes" /1.定义了以一个HDFS文件(由数行文本组成)为基础的RDD val lines = sc.textFile("/data/spark/bank/bank.csv") //2.因为首行是文件的标题,我们想把首行去掉,返回新RDD是withoutTitleLines val withoutTitleLines = lines.filter(!_.

优秀的个人博客,低调大师

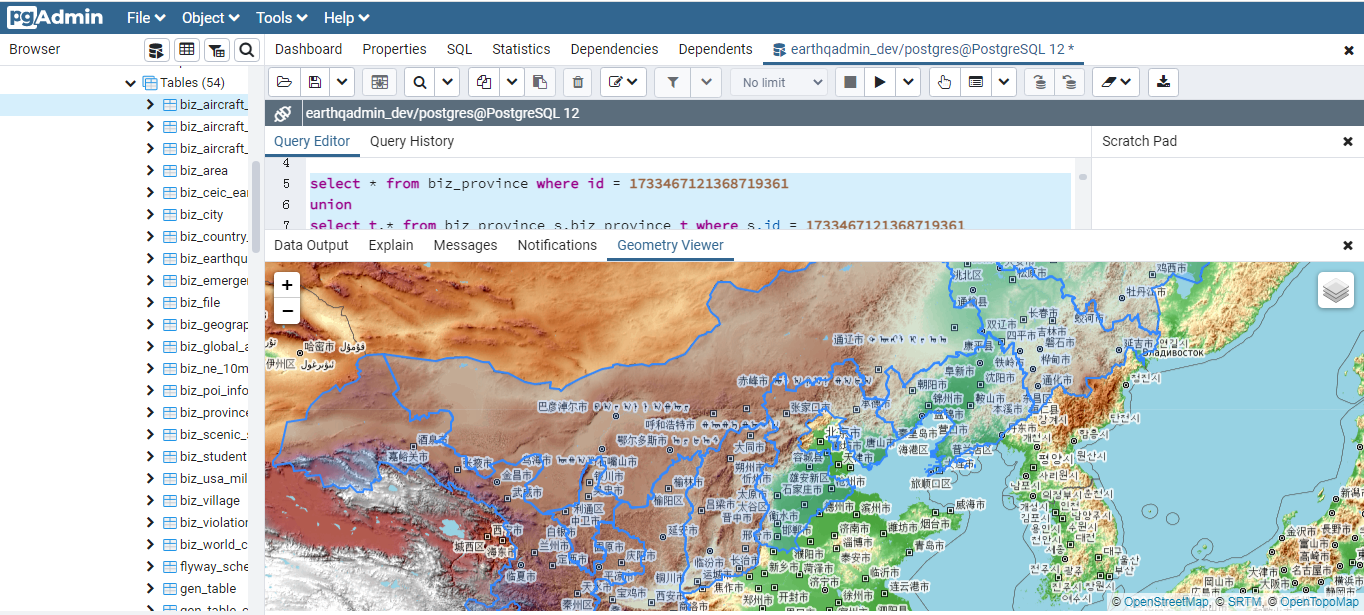
HTAP数据库 PostgreSQL 场景与性能测试之 29 - (OLTP) 高并发空间位置更新(含空间索引)

标签 PostgreSQL , HTAP , OLTP , OLAP , 场景与性能测试 背景 PostgreSQL是一个历史悠久的数据库,历史可以追溯到1973年,最早由2014计算机图灵奖得主,关系数据库的鼻祖Michael_Stonebraker操刀设计,PostgreSQL具备与Oracle类似的功能、性能、架构以及稳定性。 PostgreSQL社区的贡献者众多,来自全球各个行业,历经数年,PostgreSQL 每年发布一个大版本,以持久的生命力和稳定性著称。 2017年10月,PostgreSQL 推出10 版本,携带诸多惊天特性,目标是胜任OLAP和OLTP的HTAP混合场景的需求: 《最受开发者欢迎的HTAP数据库PostgreSQL 10特性》 1、多核并行增强 2、fdw 聚合下推 3、逻辑订阅 4、分区 5、金融级多副本 6、jso

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册