首页 文章 精选 留言 我的

精选列表

搜索[数据库知识开放麦],共10027篇文章
优秀的个人博客,低调大师

Kubernetes知识小普及

大部分概念Kubernetes官网都有详细介绍,Kubernetes中文官网 https://kubernetes.io/zh/docs/tutorials/kubernetes-basics/ 官网还提供一个比较好的功能是能在线互动,见互动教程,类似实操命令初步感受。 Kubernetes主要功能 基于容器的应用部署、维护和滚动升级 负载均衡和服务发现 跨机器和跨地区的集群调度 自动伸缩 无状态服务和有状态服务 广泛的 Volume 支持 插件机制保证扩展性 Kubernetes是谷歌开源的容器集群管理系统 Kubernetes 提供了很多的功能,它可以简化应用程序的工作流,加快开发速度。使用Kubernetes只需一个部署文件,使用一条命令就可以部署多层容器(前端,后台等)的完整集群。 核心概念 Kubernetes 主要由以下几个核心组件组成: etcd 保存了整个集群的状态; apiserver 提供了资源操作的唯一入口,并提供认证、授权、访问控制、API 注册和发现等机制; controller manager 负责维护集群的状态,比如故障检测、自动扩展、滚动更新等; scheduler 负责资源的调度,按照预定的调度策略将 Pod 调度到相应的机器上; kubelet 负责维护容器的生命周期,同时也负责 Volume(CVI)和网络(CNI)的管理; Container runtime 负责镜像管理以及 Pod 和容器的真正运行(CRI); kube-proxy 负责为 Service 提供 cluster 内部的服务发现和负载均衡 典型的Kubernetes架构图 上图可以看到如下组件,使用特别的图标表示Service和Label: Pod Container(容器) Label()(标签) Replication Controller(复制控制器) Service()(服务) Node(节点) Kubernetes Master(Kubernetes主节点) Pod Pod在节点上,包含一组容器和卷。同一个Pod里的容器共享同一个网络命名空间,可以使用localhost互相通信。Pod是短暂的,不是持续性实体。如果Pod是短暂的,那么我怎么才能持久化容器数据使其能够跨重启而存在呢? Kubernetes支持卷的概念,因此可以使用持久化的卷类型。如果Pod是短暂的,那么重启时IP地址可能会改变,那么怎么才能从前端容器正确可靠地指向后台容器呢?这时可以使用Service。 Lable 一些Pod有Label。一个Label是attach到Pod的一对键/值对,用来传递用户定义的属性。比如,你可能创建了一个"tier"和“app”标签,通过Label(tier=frontend, app=myapp)来标记前端Pod容器,使用Label(tier=backend, app=myapp)标记后台Pod。然后可以使用Selectors选择带有特定Label的Pod,并且将Service或者Replication Controller应用到上面。 Replication Controller Replication Controller确保任意时间都有指定数量的Pod“副本”在运行。如果为某个Pod创建了Replication Controller并且指定3个副本,它会创建3个Pod,并且持续监控它们。如果某个Pod不响应,那么Replication Controller会替换它,保持总数为3.如下面的动画所示: 如果之前不响应的Pod恢复了,现在就有4个Pod了,那么Replication Controller会将其中一个终止保持总数为3。如果在运行中将副本总数改为5,Replication Controller会立刻启动2个新Pod,保证总数为5。还可以按照这样的方式缩小Pod,这个特性在执行滚动升级时很有用。 当创建Replication Controller时,需要指定两个东西: Pod模板:用来创建Pod副本的模板 Label:Replication Controller需要监控的Pod的标签。 现在已经创建了Pod的一些副本,那么在这些副本上如何均衡负载呢?我们需要的是Service。 Service Service是定义一系列Pod以及访问这些Pod的策略的一层抽象。Service通过Label找到Pod组。因为Service是抽象的,所以在图表里通常看不到它们的存在,这也就让这一概念更难以理解。 假定有2个后台Pod,并且定义后台Service的名称为‘backend-service’,lable选择器为(tier=backend, app=myapp)。backend-service的Service会完成如下两件重要的事情: 会为Service创建一个本地集群的DNS入口,因此前端Pod只需要DNS查找主机名为 ‘backend-service’,就能够解析出前端应用程序可用的IP地址。 现在前端已经得到了后台服务的IP地址,但是它应该访问2个后台Pod的哪一个呢?Service在这2个后台Pod之间提供透明的负载均衡,会将请求分发给其中的任意一个(如下面的动画所示)。通过每个Node上运行的代理(kube-proxy)完成。这里有更多技术细节。 如果不进入网络配置,那么达到透明的负载均衡目标所涉及的底层网络和路由相对先进。 有一个特别类型的Kubernetes Service,称为'LoadBalancer',作为外部负载均衡器使用,在一定数量的Pod之间均衡流量。比如,对于负载均衡Web流量很有用。 Pod与Service 每个Pod都提供了一个独立的Endpoint(Pod IP+ContainerPort)以被客户端访问,多个Pod副本组成了一个集群来提供服务,一般的做法是部署一个负载均衡器来访问它们,为这组Pod开启一个对外的服务端口如8000,并且将这些Pod的Endpoint列表加入8000端口的转发列表中,客户端可以通过负载均衡器的对外IP地址+服务端口来访问此服务。运行在Node上的kube-proxy其实就是一个智能的软件负载均衡器,它负责把对Service的请求转发到后端的某个Pod实例上,并且在内部实现服务的负载均衡与会话保持机制。Service不是共用一个负载均衡器的IP地址,而是每个Servcie分配一个全局唯一的虚拟IP地址,这个虚拟IP被称为Cluster IP。 Node IP Node节点的IP地址,是Kubernetes集群中每个节点的物理网卡的IP地址,是真是存在的物理网络,所有属于这个网络的服务器之间都能通过这个网络直接通信; Pod IP Pod的IP地址,是Docker Engine根据docker0网桥的IP地址段进行分配的,通常是一个虚拟的二层网络,位于不同Node上的Pod能够彼此通信,需要通过Pod IP所在的虚拟二层网络进行通信,而真实的TCP流量则是通过Node IP所在的物理网卡流出的; Cluster IP Service的IP地址。特性如下: 仅仅作用于Kubernetes Servcie这个对象,并由Kubernetes管理和分配IP地址; 无法被Ping,因为没有一个“实体网络对象”来响应; 只能结合Service Port组成一个具体的通信端口; Node IP网、Pod IP网域Cluster IP网之间的通信,采用的是Kubernetes自己设计的一种编程方式的特殊的路由规则,与IP路由有很大的不同; Node 节点(上图橘色方框)是物理或者虚拟机器,作为Kubernetes worker,通常称为Minion。每个节点都运行如下Kubernetes关键组件: Kubelet:是主节点代理。 Kube-proxy:Service使用其将链接路由到Pod,如上文所述。 Docker或Rocket:Kubernetes使用的容器技术来创建容器。 Kubernetes Master 集群拥有一个Kubernetes Master。Kubernetes Master提供集群的独特视角,并且拥有一系列组件,比如Kubernetes API Server。API Server提供可以用来和集群交互的REST端点。master节点包括用来创建和复制Pod的Replication Controller。 应用 Kubernetes进行蓝绿部署 应用程序更新到一个新版本时,部署功能能够帮您对容器进行滚动更新,若有异常可自动回滚。 Kubernetes在腾讯游戏的应用 接入容器数超过两万,接入的业务也有两百多款,包括手游、端游、页游。 基于Kubernetes的Spark集群部署 相比于在物理机上部署,在Kubernetes集群上部署Spark集群,具有以下优势: 快速部署:安装1000台级别的Spark集群,在Kubernetes集群上只需设定worker副本数目replicas=1000,即可一键部署。 快速升级:升级Spark版本,只需替换Spark镜像,一键升级。 弹性伸缩:需要扩容、缩容时,自动修改worker副本数目replicas即可。 高一致性:各个Kubernetes节点上运行的Spark环境一致、版本一致 高可用性:如果Spark所在的某些node或pod死掉,Kubernetes会自动将计算任务,转移到其他node或创建新pod。 强隔离性:通过设定资源配额等方式,可与WebService应用部署在同一集群,提升机器资源使用效率,从而降低服务器成本。 Kubernetes、Docker Swarm、 Mesos 网易云容器如何解决Kubernetes在公有云上的问题 微服务持续集成 Spring Cloud + GitLab + Docker + K8S 微服务组成:Gateway api网关>消费端>服务端 和 一个注册中心,共4个Spring Boot项目 Kubernetes实际要用起来问题还有很多,需要躺很多坑,搭建起一套Kubernetes环境就可能会让你从入门到放弃,再接再励。 资料来源: http://www.dockone.io/article/932

优秀的个人博客,低调大师

多线程知识回顾

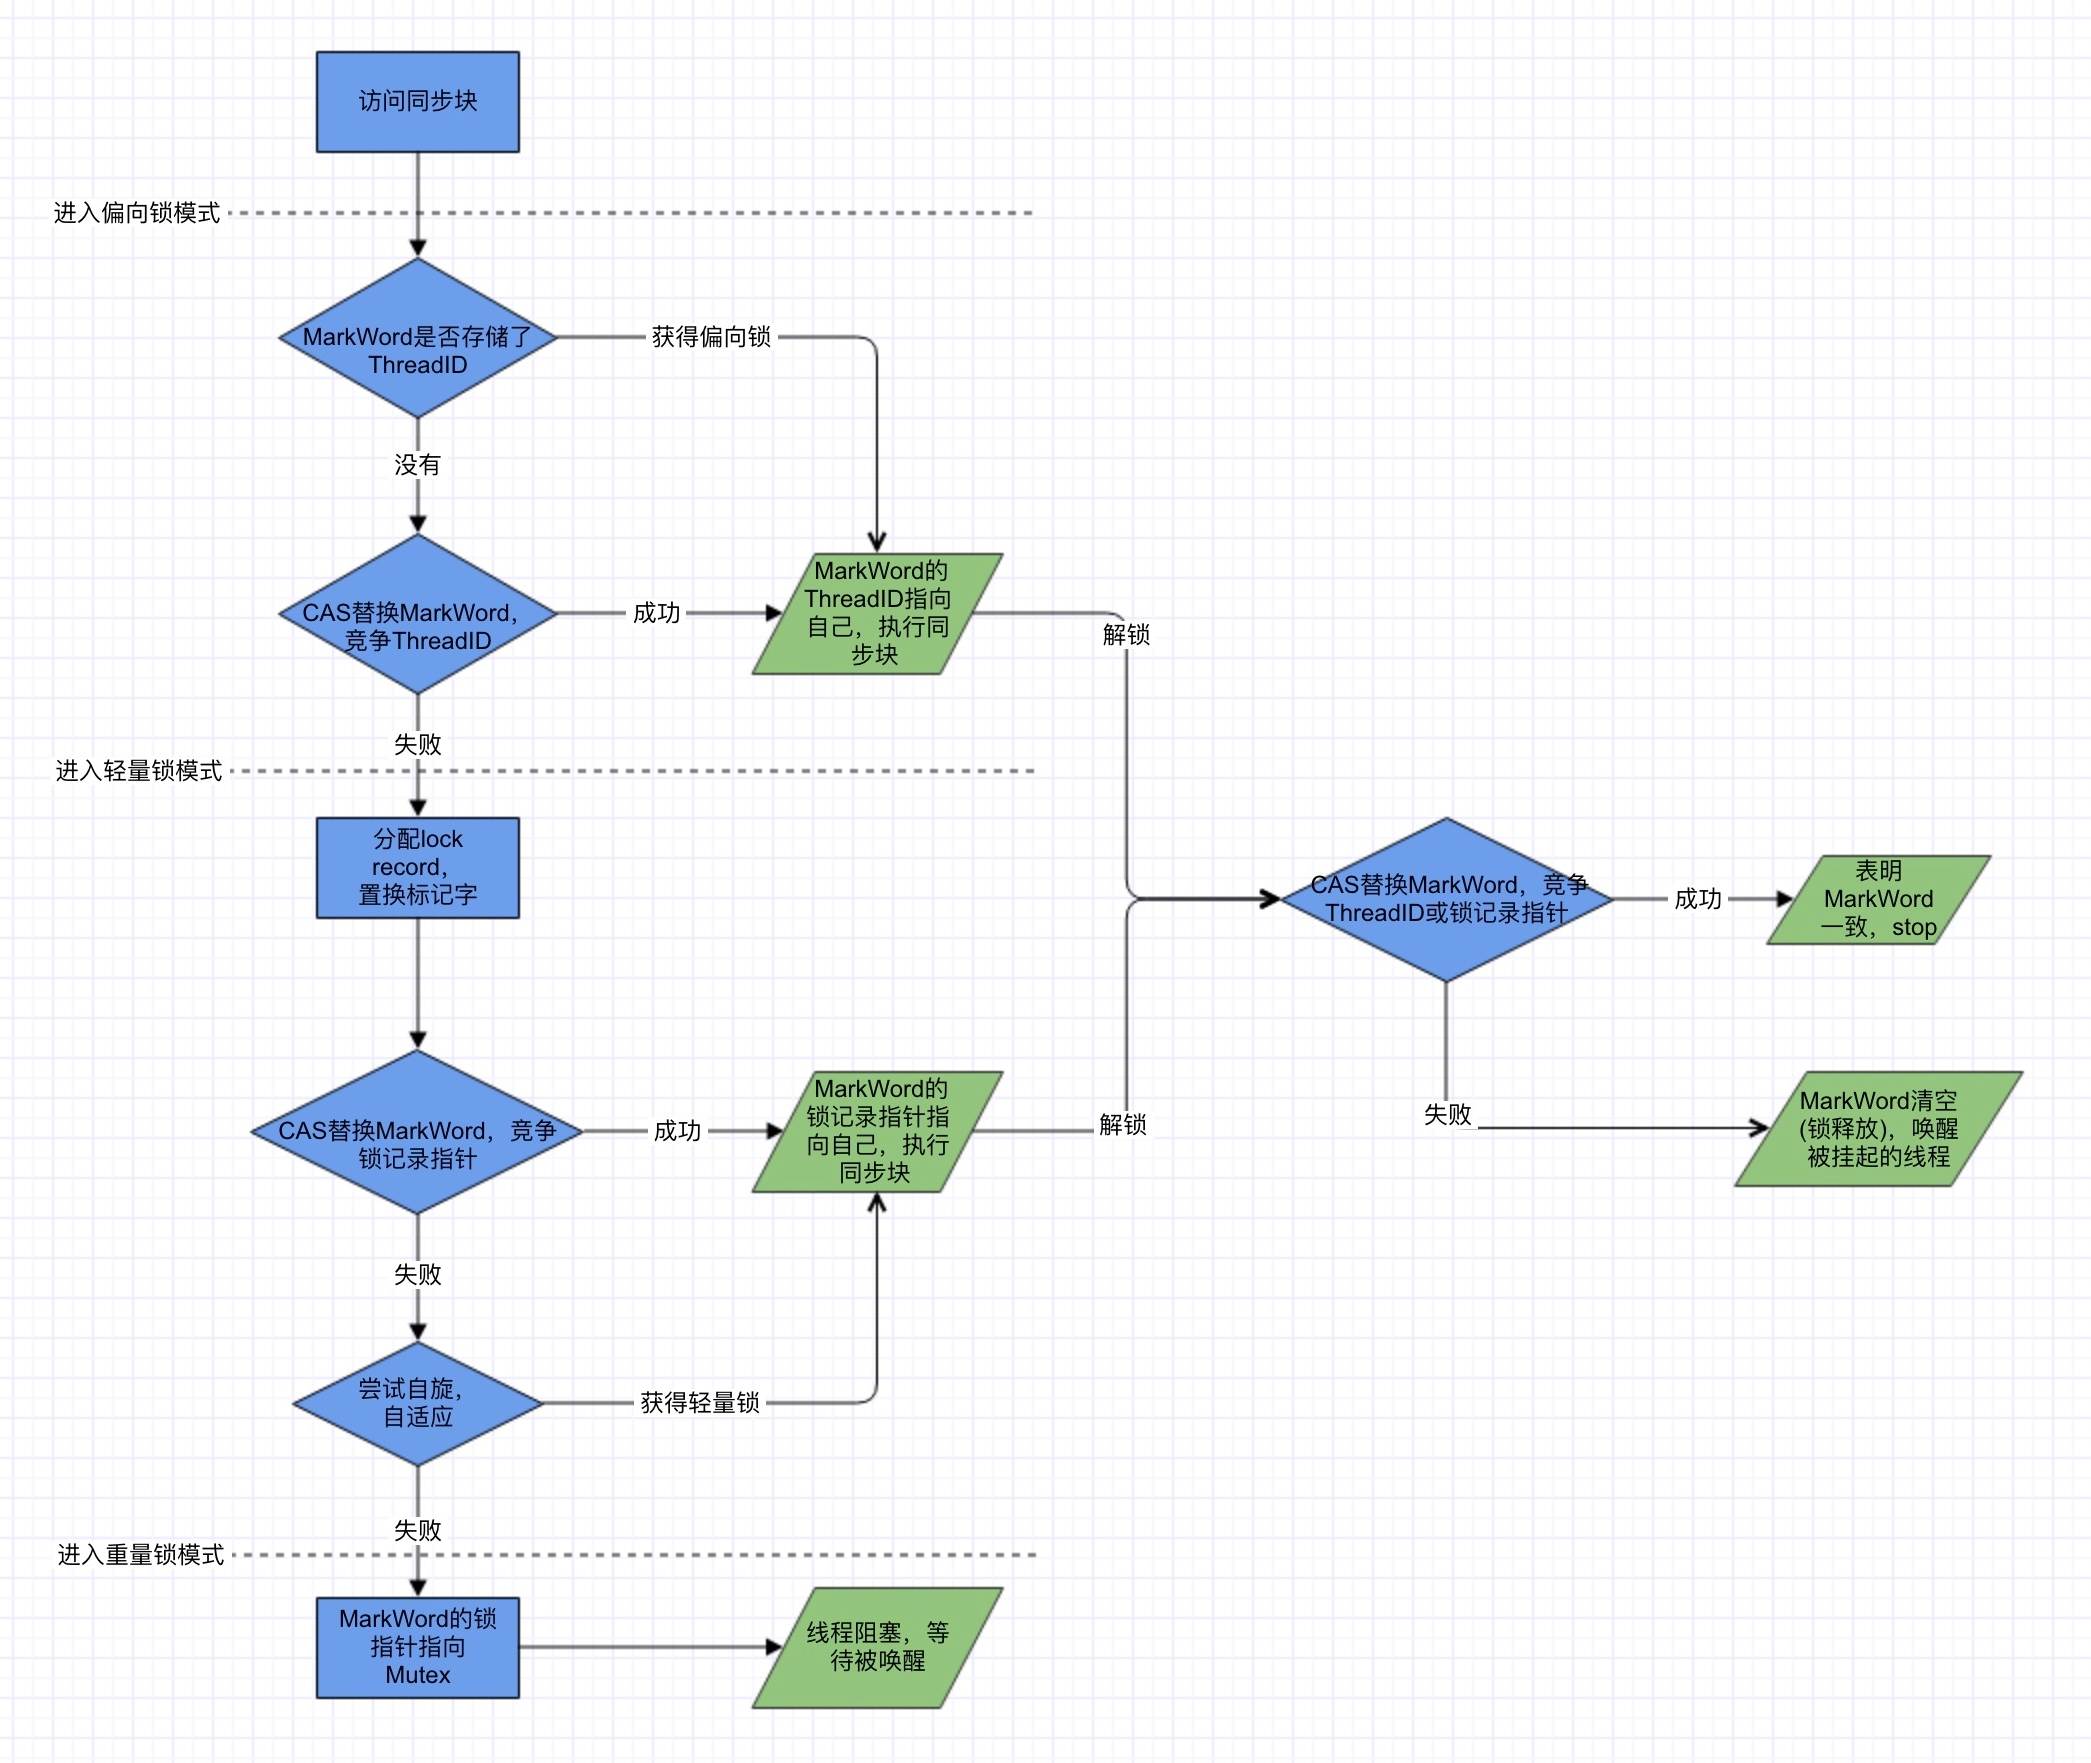
以前看过不少JDK源码,最近回顾了一下笔记,所以在这里对几个很常见到的线程类做个记录。 一、ThreadLocal ThreadLocal是一个线程级的局部变量,“本地线程”只是俗称但并不准确。 假设是拿Map去做线程的局部变量,一般就两种思路:以Thread为key的共享区域,使用上不会有什么问题,但因为是共享区域访问,我们要做并发控制比如synchronized这样的悲观策略来保证线程安全,可同步会限制吞吐。第二种就是线程封闭,ThreadLocal正是使用了这种方式,线程本地维护一个区域ThreadLocalMap,以ThreadLocal实例为key,线程间数据隔离,自然就不存在线程安全的问题了。即ThreadLocal作为句柄、一个入口,来连接ThreadLocalMap和Thread。 内存泄漏问题:ThreadLocalMap的key使用了弱引用,指向某个ThreadLocal实例。当把ThreadLocal实例置为null后,那么它将会被GC回收。但ThreadLocalMap中的value不会被回收,因为存在一条current thread的强引用。因为ThreadLocalMap出现了大量key为null的Entry(key被回收了),且没办法访问Entry的value,只有当前thread结束、强引用断开,当前Thread、ThreadLocalMap,ThreadLocalMap中的value才会被GC回收。 为什么key要使用弱引用?如果key使用强引用,ThreadLocal不会被回收,因为存在一条ThreadLocalMap的key对它的强引用;如果使用弱引用,能保证ThreadLocal能被GC掉。但不管是强引用还是弱引用,都不影响存在无法访问Entry的事实,都需要事后去手动删除无用的Entry,否则都存在内存泄漏的隐患(Thread不死,无用的Entry就一直在增长)。 这也就是为什么会有内存泄漏的问题了:存在一条强引用链 Current Thread -> ThreaLocalMap -> Entry -> value。比如我们使用业务线程池中的线程作为ThreadLocalMap的引用的时候,或者使用单例、static的ThreadLocal时(因为延长了ThreadLocal的生命周期),又或者使用ThreadLocal作为每次调用上下文而又不清理的时候,经管ThreadLocal在get、set、remove方法都会去清除线程ThreadLocalMap里所有key为null的value,但这需要我们主动的显示调用才起作用。 带来的思考: 避免使用同步的方法之一就是不共享数据,比如线程封闭,通过比如转换为单线程,即便对象本身不是线程安全的也不会有什么问题; 给每一个访问共享变量的线程一个独立的副本,可以解决变量并发访问的冲突问题,一种空间换时间的做法; 二、synchronized对象锁 为了保证synchronized的可重入性,JDK为每一个对象的内置锁都关联了一个计数器和所有者线程,为0就是未被持有,为1就是有一个线程,为2就是这个线程再次请求了这个锁,退出则递减。这背后的原理,是synchronized关键字经过编译后,在同步代码块的前后分别形成MonitorEnter和MonitorExit两个字节码指令。执行MonitorEnter指令时获取对象的内置锁,如果没有被锁定,则锁的计数器加1;执行MonitorExit指令时锁的计数器减1,计数器为0时锁就释放了。如果获取锁失败则线程阻塞等待,直到被唤醒。 而关于synchronized锁的状态:无锁,偏向锁,轻量级锁,重量级锁,这存在于Java对象头MarkWord,根据锁标志位复用空间。无锁状态为空,偏向锁时的ThreadID,轻量锁时锁记录的指针,重量锁时指向系统的互斥量Mutex(0|1)。 偏向锁,适用于单线程访问同步块的场景,同步但无竞争的情况,但只要存在不同线程申请锁时即升级为轻量锁。无锁模式下和偏向锁模式下的性能消耗:CAS替换和退出偏向锁时的撤销。 轻量锁是适用于线程交替执行同步块的场景,有竞争但无阻塞的情况,追求响应时间,但只要存在有锁竞争时即升级为重量锁。 三、Lock 1.ReentrantLock ReentrantLock的内部实现,简单来说,就是在获取锁时先判断state是不是0,如果是就先cas一把获取锁对象,如果不是0,则链到CLH等待队列(双端队列)队尾,标记为独占。如果放入失败,则自旋+CAS,然后进入wait状态,等待unpark()。唤醒后尝试能否cas锁资源成功,成功则指向head队头,然后返回中断标识。 Reentrant的可重入性,其实是依靠AQS的内部机制的。 AQS(AbstractQueuedSychronizer)也叫“队列同步器”,是整个Java并发包的核心,多种锁的抽象父类。其内部维护了一个volatile的int类型成员变量state和CLH,并且具有两个Node节点的引用:head和tail: 如果申请锁资源时,当前线程与独占的Owner线程一致,则state值CAS加1,退出则CAS减1,获取多少次就要释放多么次,直到state回到零态,然后unpark。 CLH具体实现上,是由内部类Node构成的FIFO双向同步队列。当竞争锁资源失败后,AQS会将当前线程的引用以及等待状态构造成一个Node并加入到CLH中并阻塞当前线程;每次入CLH队列都要通过CAS操作,使tail指向新节点、新节点prev字段指向原来的尾节点;当首节点锁资源释放后,将后继节点的线程唤醒,而后继节点的线程在尝试获取锁资源成功后将自身设置为首节点。 对于公平锁和非公平锁:它们的差异就是在获取锁资源时,非公平是抢占式的,先cas一把不排队直接插队,失败才走acquire(1);然后第二个差别是在acquire时,公平锁会先判断CLH队列中是否空闲,而非公平是没有的。 对于共享锁和独占锁:共享锁,在竞争到锁资源后成为Head头时,如果CLH队列不为空则还会唤醒下一个线程;在释放锁时,独占锁是state=0才去唤醒其它线程,而共享锁则不管state是否为0都会去尝试唤醒。 2.StampedLock StampedLock是Java8新增的读写锁,除读写分离外,它的亮点在于乐观读模式,就是在读多写少的情况下,先乐观的读(不阻塞写),而后通过冲突检测来决定是做后续操作,还是重新做悲观的读锁定(即ReadWriteLock的读读不互斥、读写互斥)。 虽然没有像其它锁一样定义了内部类来实现AQS,但StampedLock的内部实现还是基于CLH(维护一个等待队列,所有没有成功申请锁的线程都放在这个FIFO队列中,然后通过一个标记位locked判断当前线程是否已释放锁)的,通过状态位来表示锁的状态和类型。而且除乐观读之外,其余锁操作都是典型的CAS操作,先自旋尝试、加入CLH等待队列、再次自旋尝试、直至最终Unsafe.park()挂起线程,成功获取锁资源则CAS操作更新标志位。 StampedLock与ReadWriteLock的区别: StampedLock可以做乐观读,而ReadWriteLock使用的都是悲观策略; StampedLock关注的是读写比例,而ReadWriteLock关注的是读写; StampedLock读写锁可以互相转换,而ReadWriteLock只有锁降级; ReentrantReadWriteLock是可重入的,而StampedLock三种锁模式都是不可重入的,它并没有直接实现AQS; StampedLock对多核CPU做了优化(通过Runtime#availableProcessors()获取CPU核数作为自旋次数); 在性能上,正常情况下,StampedLock比ReadWritLock快4倍的读,快1倍的写 3.Volatile volatile的作用其实就两个:保证线程可见性,禁止指令重排序。 通常情况下,为了保证cache一致性,工作内存发生变化之后需要回写到主内存,不管你通过什么方式。而volatile修饰的变量则要求工作内存与主内存保持同步,发生更新立即回写、读的时候读主内存。其实是,JVM在volatile变量前后会插入一个内存屏障指令Store-Load。一个CPU内存访问的一个同步点,屏障之前的写操作都要写入内存、屏障之后的读操作都可以读到屏障之前的写操作结果。这其实是必须要保证的,CPU硬件级别也是有缓存的,就是寄存器。当一个变量被修改时是在其寄存器上操作,如果没有及时回写到物理内存上,线程可见性也难以保证。 CPU有它自己的指令排序,随机写的性能肯定比不上批处理方式的刷新,而且还可以合并对同一个内存地址的多次写,以减少内存总线的占用。所以,为了保证内存可见性,对于编译器,JVM会禁止volatile变量的编译器重排序;对于处理器,JVM会要求Java编译器在生成指令序列时,插入内存屏障指令,通过内存屏障指定来禁止特定类型的处理器重排序。可想而知这降低了效率,无法被编译器优化。 volatile与sychronized的区别: sychronized也保证了线程可见性,也在锁即将释放之前将工作内存回写到主内存,但它范围更大,它锁定了一块内存区域做同步,而volatile只是锁定一个变量,所以后者无法替代前者。 实际上也没法替代,volatile只保证可见性不保证原子性,而synchronized是保证的。 4.CAS CAS是“Compare And Set”的简称,一种系统原语,JDK通过Unsafe对象来实现CAS,利用native方法的原子性来保证线程安全。 简单来说,就是一个CAS操作包含三个操作数——内存值(V)、预期值(A)和新值(B)。当且仅当预期值A和内存值V相同时,才会将V改为B并返回true,否则什么都不做并返回false。而底层实现,在比如常见的Linux的X86上,是通过调用Atomic:comxchg()指令(这个方法的实现在HotSpot下的os_cpu包中,该方法的实现和操作系统相关)来直接操作内存的,而这个指令在多处理器情况下会通过使用lock-xadd来加锁。 synchronized在JDK1.6之后,通过偏向锁 -> 轻量级锁 -> 重量级锁这样的锁优化,大幅的提高了获取锁和释放锁的效率。但在Java8之后,CAS得到了增强,AtomicI包的性能比synchronized更好了。具体原因是,CAS失败自旋用到了JDK1.8中Unsafe新增的getAndAddXXX方法,如果系统底层支持fetch-and-add,则使用fetch-and-add这样的原子指令(get和cas都是native,自然更快);如果不支持,则使用原来的compare-and-swap原子指令。 CAS使用中要注意的问题主要是ABA和CPU资源浪费: ABA问题:比如内存值变化了之后恢复成原值,但不代表内存值就没有发生变化。一个解决的思路是:通过添加修改计数器或是版本号,来标记是否发生过变更。实际上,JAVA中提供的Atomic原子类型变量就是这么做的,其内部实现是在对象中额外增加了一个标记位来标识对象是否有过变更。 CPU问题:如果自旋时间长,则可能浪费CPU这样的宝贵资源,即使没有任何争用也会做一些无用功。所以要明确适用场景,比如简单的非阻塞操作可以考虑使用CAS操作。而且建议与volatile变量“打配合”,来保证每次拿到的变量是主内存中的最新值,否则旧的预期值对某个线程来说,永远是一个不会变的值,只要某次CAS操作失败,则永远不会成功。 Java8之后,这样的并发处理成为主流:通过双层for循环+CAS自旋这样的无锁算法来处理并发,即外层死循环、里层自旋尝试,成功的话直接return或者goto关键字跳出外层循环并结束CAS操作,而不是通过锁竞争、阻塞的方式。 四、 线程池 拿ThreadPoolExecutor来说,工作队列workQueue和工作线程池works是分开的。它的工作机制是这样的: 关于排队策略,针对workQueue,通常有三种排队策略:直接提交,无界队列,有界队列。 直接提交:使用同步阻塞队列,将任务直接提交给线程,如果当前没有空闲线程则创建一个新的。它是无界的; 无界队列:使用链表阻塞队列,如果没有空闲线程则将任务提交给队列。它也是无界的,而且活跃线程数只会是corePoolSize值; 有界队列:使用列表阻塞队列,这时maxPoolSize有效,队列未满则放入队列阻塞,队列已满则跑拒绝策略; 具体使用哪种排队策略,还是看业务场景和任务量,比如说任务量不大、瞬发情况多,那可以用无界队列;如果任务量大,则要考虑用有界队列去调整。实际情况较常用的是有界队列,以避免耗尽资源导致OOM(同步队列会创建大量线程阻塞,无界队列会堆积大量任务),常见的使用策略是大型队列+小型池(吞吐高、响应慢)或者小型队列+大型池(吞吐低、响应快)。 使用Executors获取线程池的弊端: - newFixedThreadPool()和newSingleThreadPool()方法:允许工作队列⻓度为Integer.MAX_VALUE,这可能会堆积大量请求,从而导致OOM; - newCachedThreadPoolnew和newScheduledThreadPool()方法:允许创建的线程数为Integer.MAX_VALUE,可能会创建大量的线程,从而导致OOM; 关于线程池的饱和(拒绝)策略,主要有四种: 抛异常、丢任务,ThreadPoolExecutor的默认策略; 不抛异常、丢任务; 在pool没有关闭的前提下,丢弃列表头任务,尝试执行新任务; 尝试用调用者线程即主线程去执行任务(由于池中已无任何资源,这其实是风险最高的); 关于线程池大小设置,其实常见的参数就那么几个:corePoolSize核心线程数、maxPoolSize最大线程数、queueCapacity队列容量、keepAliveSeconds空闲时间,前两个比较重要。总结来说,主要是这三种: CPU密集型:CPU使用率高,为减少线程上下文切换开销,将池设置大小为CPU核数+1; I/O密集型:因为IO操作不占CPU,为了充分利用CPU,将池设置大小为CPU核数*2+1; 混合型:预估I/O密集型和CPU密集型的执行时间,执行时间差不多就拆分开,差很多就选其一; CPU密集型会考虑上下文切换的开销,儿I/O密集型会考虑I/O等待耗时。具体到实践中,主要也是看业务场景、什么样的任务。一般规律是:线程等待时间占比越高,需要越多线程数;CPU时间占比越高,需要越少线程数。当然,实际上还要考虑容量占比,不要超过阈值,保持应用的健康状态。

优秀的个人博客,低调大师

Vue重要知识小结

vue sync修饰 (1)双向数据绑定,父子组件之间信息的交互 1⃣️在自组件中使用this.emmit('toFather'),子组件产生一个tofather事件,然后在父组件中通过@进行监听,那么可以实现通信过程 2⃣️使用简单的方式传递,如上图中emmit(update:title),然后在v-bind:title.sync='title',从而实现双向数据绑定 (2)双向数据绑定,使用v-model 通过在自组件中使用model 定义 prop event ,从而可以实现父子组件之间通过v-model实现通信,或者不定义model ,使用默认的的prop:value,enent:input keep-alive <keep-alive><My-component /> <keep-alive> 可以实现缓存 作用域插槽 这个其实就是可以使用自组件中的数据,使用slot-scope接受自组件中的数据 自组件访问父级组件 1⃣️ let father = this.$parent 2⃣️通过依赖注入 计算属性 刚开始在学习计算属性的时候,一直默认的认为是一个函数,但是在调用的时候,是不用加()的,这样的话,在认为是一个函数就不对了,其实就是类似于 data中的数据,只不过会有缓存和更新。例如使用的时候直接{{computed}},通俗的说,可以单纯的将它作为一个data值 method方法 调用方法的时候,如果不传递值的话,那么可以不用加入() 混入 minxins 自定义指令 通过Vue.directive(name,{}) Vuex 三部分构成 state actions mutations state 此部分存放数据,可以通过mapStated获取到数据。 actions 可以使用异步,通过this.$store.dispathc()触发 mutatios mutatios 必须是同步,通过this.emmit()触发 步骤: Vue.use(Vuex) const store = new Vuex.Store({ state: { //前端全栈交流学习圈:886109386 count: //针对一到五年前端开发人员 }, //帮助突破技术瓶颈,提升思维能力。 mutations: { increment (state) { state.count++ } }, actions: { increment (context) { context.commit('increment') } } })

优秀的个人博客,低调大师

JAVA基础知识

快速浏览 Sun公司在1991成立了一个名为Green的小组,这个小组开发了Oak,这正是java的前身,最初的开发目的是为了做家电的嵌入式应用,不过因为缺乏硬件市场的支持并没有受到大的关注。1995的时候,互联网开始崛起,这给了java机会。Sun公司首先推出了可以嵌入网页并且可以随同网页在网络上传输的Applet,并将Oak更名为Java。1996年1月,Sun公司发布了Java的第一个开发工具包,这个工具包被命名为JDK1.0,这标志着Java正式成为了一种独立的开发工具。1998年12月8日,第二代Java平台的企业版J2EE发布。1999年6月,Sun公司发布了第二代Java平台的第3个版本:J2ME。1999年4月27日,HotSpot虚拟机发布。HotSpot虚拟机发布时是作为JDK 1.2的附加程序提供的,后来它成为了JDK 1.3及之后所有版本的Sun JDK的默认虚拟机 。2000年5月,JDK1.3、JDK1.4和J2SE1.3相继发布,几周后其获得了Apple公司Mac OS X的工业标准的支持。2002年2月26日,J2SE1.4发布。自此Java的计算能力有了大幅提升,与J2SE1.3相比,其多了近62%的类和接口,其中比较重要的更新有XML、Socket、正则表达式改进的I/O等。2004年9月30日,J2SE1.5发布。为了表示该版本的重要性,J2SE 1.5更名为Java SE 5.0。更新中包含了从1996年发布1.0版本以来的最重大的更新,其中包括泛型、基本类型的自动装箱、改进的循环、枚举类型及可变参数。2006年11月13日,Java技术的发明者Sun公司宣布,将Java技术作为免费软件对外发布。从2007年3月起,全世界所有的开发人员均可对Java源代码进行修改。2009年,甲骨文公司宣布收购Sun。 Applet是一种将小程序嵌入到网页中进行执行的技术。 在申请注册商标时,Sun发现Oak已经被人使用了,再想了一系列名字之后,最终,使用了提议者在喝一杯Java咖啡时无意提到的Java词语。 技术架构 JAVASE:全称 Java Platform Standard Edition,Java 2平台的标准版,应用于桌面应用程序;JAVAEE:Java Platform Enterprise Edition,企业版,应用于WEB开发;JAVAME:Java Platform Micro Edition,微型版,应用于移动环境和嵌入式设备,例如安卓手机中的应用程序; 跨平台的秘密 java的底层依靠虚拟机,不同的操作系统对应不同的java虚拟机。所以只需要在不同的操作系统中安装对应虚拟机就可以实现不修改java源代码就可以运行。 JRE和JDK JDK:Java Development Kit,JDK中包含了JRE,JDK是java的开发工具。JRE:Java Runtime Environment,java程序的运行环境,包含Java运行的所需的类库和JVM。JVM:Java Virtual Machine,Java虚拟机,是一种用于计算设备的规范,它是一个虚构出来的计算机,是通过在实际的计算机上仿真模拟各种计算机功能来实现的。 环境搭建 配置环境变量:就是将在jdkbin目录下指令告知当前系统,在需要使用对应指令的时候由系统根据指定目录寻找指令。 经常被使用的两个指令是javac和java指令,它们分别负责编译和运行java程序。javac:当执行javac的时候会启动java的编译器对.java文件进行编译,也就是生成.class文件,这是jvm可以识别的字节码文件。java:会启动jvm,加载运行需要的类库,然后执行.class文件 永久配置方式:JAVA_HOME=%安装路径%Javajdkpath=%JAVA_HOME%binCLASSPATH=;%JAVA_HOME%lib 临时配置方式:path:C:ProgramJavajdkbin 在定义classpath环境变量时,如果没有定义环境变量classpath,java启动jvm后,会在当前目录下查找要运行的类文件;如果指定了classpath,那么会在指定的目录下查找要运行的类文件;如果classpath值中结尾处有分号那么在指定目录下没有找到类文件的时候,会默认在当前目录下找一次;如果classpath值中结尾处没有分号在指定目录下没有找到类文件的时候会报错。 一般写分号,如果在指定目录下没有找到的话就让它报错,这样方便调试程序。 注释 单行注释(single-line):// 一次只能注释一行,一般是简单注释,用来简短描述某个变量或属性,程序块。块注释(block):/ 为了进行多行简单注释,一般不使用。/ 文档注释:/* 可以使用多行,一般用来对类、接口、成员方法、成员变量、静态字段、静态方法、常量进行说明。Javadoc可以用它来产生代码的文档。为了可读性,可以有缩进和格式控制。 / 语法规则 约定俗成的书写规则 包名:package 的名字应该采用完整的英文描述符,由一个小写单词组成,并且包名的前缀是一个顶级域名,如com、net、org等类名:class 名应该是个一名词,采用大小写混合的方式,每个单词的首字母大写。一般保证类名简洁而富于描述。常量:全部采用大写字母,单词之间尽量使用下划线分割。变量:不可以使用数字和下划线开头;不可以使用关键字。 变量有分成员变量和局部变量。成员变量直接定义在类中,作用于当前类,存在于堆内存中;局部变量可以定义在参数列表和方法内部,作用于当前方法,存在于栈内存中。 所有对象在创建的时候都需要初始化才能使用,做这个工作的是构造函数,其实就是一个与类名称相同的方法,可以重载,不需要返回值。构造函数和一般函数之间的区别除了定义格式上之外还有就是构造函数只被执行一次。 数据类型 基本数据类型:byte、short、int、long、float、double、char、boolean引用数据类型: 字符串、数组、枚举、接口、对象。 运算符 算术运算符:+、-、*、/、%、+(连接符)、++、--赋值运算符:=、+=、-=、*=、/=、%=比较运算符(运算的结果要么是true,要么是false):>、<、==、>=、<=逻辑运算符(用于连接两个boolean表达式,除!之外):&、|、^、! (二元运算符)、&&(短路与) 、||(短路或)位运算符(用于操作二进制位的运算符):<<、>>、>>>(无符号右移) &: 只有两边都为true结果是true。否则就是false。 & 和 &&区别: & :无论左边结果是什么,右边都参与运算。 &&:短路与,如果左边为false,那么右边不参数与运算。 | : 只要两边都为false的时候结果才是false,否则就是true | 和|| 区别:|:两边都参加运算。||:短路或,如果左边为true,那么右边不参与运算。 流程控制语句 用于决定某个代码块是否可以被执行ifswitch 当判断固定个数的值的时候建议使用switch,效率相对较高。 需要循环执行某个代码块的时候do whilewhileforforeach while和for可以相互转换,如果需要定义变量控制循环次数,建议使用for,for循环完毕的时候变量会在内存中释放。 java还提供了两个关键字来帮助细粒化控制流程。break:作用于switch和循环语句,用于跳出当前循环。 在break关键字下面的代码不会被执行,当有嵌套的时候break只会跳出当前循环,如果需要跳出外部循环,可以给循环打个标记。 continue:作用于循环结构,含义是结束本次循环,开始下次循环。 数组 存储同一类型并且固定长度数据的容器,通过对容器元素编号的方式来访问元素,这样的容器就是数组。 dataType[] arrayRefVar = {value0, value1, ..., valuek}; 方法 为了提高代码的复用,可以将一个代码块抽取出一个方法,用于实现某一个或多个功能。 访问修饰符 返回值类型 方法名称(参数类型 形式参数0,参数类型 形式参数1,......){ 执行语句; return 返回值;} return的作用是结束方法。 如果方法的返回值是void,系统会自动帮你补上。 当方法没有具体的返回值时,返回值类型用void关键字表示。 形式参数对应着实际参数,前者的作用是占位,后者是当调用方法的时候传入的参数,这个参数是某个具体的值,因此称为实参。 参数的类型用于区分方法重载,方法重载指的是方法名相同参数列表不同,和返回值类型无关。 this this是java中的关键字,你可以用它来 调用本类中的属性,也就是类中的成员变量 调用本类中的其他方法 调用本类中的其他构造方法 在使用this关键字调用构造方法的时候需要放在构造方法的第一行,否则就会报错,因为构造方法用于初始化,初始化的动作需要一定被执行。 super super 用于限定本类调用从父类继承得到的实例变量或方法。 子类覆盖父类属性的时候可以使用super调用父类属性 子类覆盖父类方法的时候可以使用super调用父类方法 调用父类的构造方法,必须在首行调用 final final用于修饰类、方法和变量,被final修饰有如下特点 被final修饰的类不可以被继承,其中类中的成员变量都会隐式设置为final,String就是这样一个类。 被final修饰的方法不可以被覆盖,被private修饰的方法会隐式地被指定为final方法。 被final修饰的变量是一个常量,只能被赋值一次。 匿名内部类中使用的外部局部变量只能是final变量。 static static是一个用于修饰成员变量和方法的修饰符,被static修饰之后有如下特点 对象数据共享 成员变量可以被类名直接调用 静态优先于对象加载 static作用于成员变量时表示只保存一份副本,而final的作用是用来保证变量不可变。 使用static需要注意的地方 主函数是被静态修饰 静态优先对象加载,所以静态方法只能访问静态成员变量,不能访问非静态成员变量 this和super关键字也不能在静态中使用,理由同上 被静态修饰成员变量和方法会存储到单独的静态区也就是方法区,否则会当作对象的一部分存储在对象区也就是堆区 成员变量只能被对象调用而静态变量可以被对象和类名调用 这是面试中常常遇到的问题,如果静态代码块、构造函数、构造代码块同时存在,那么它们先后执行的顺序是: 静态代码块-->构造代码块-->构造函数 abstract abstract类用于标注一个类是抽象类,目的是不让类实例化,抽象类有如下特点 抽象方法只能定义在抽象类中,并且只能修饰方法和类不能修饰变量。 抽象方法不负责具体的实现 抽象类不可以被实例化 当子类通过继承的方式实现了抽象类中的所有抽象方法时,子类才可以实例化,否则该子类也是一个抽象类 抽象类有构造方法,是用来给子类对象初始化的 abstract不可以和final、private和static共存 抽象类的最佳实践是模板设计模式 interface interface用于修饰一个类为接口,接口用于设计上的好处是 功能扩展 降低耦合 规则约束 多继承 接口和抽象的区别 抽象类单继承,接口多实现 抽象类可以定义非抽象方法,子类继承使用;接口全是抽象方法需要子类实现 抽象类可以使用任意修饰符修饰,接口的成员都是public instanceof instanceof用于判断一个对象是否是指定的类型 内部类 为了方便访问,直接将B类定义在A类中,那么B类就是A类的内部类。A类可以通过创建B类对象访问B类属性,B类可以直接访问A类属性。如果内部类只需要被使用一次,那么可以定义为匿名类,就是没有命名的内部类,定义匿名内部类的前提是必须继承一个类或者实现一个接口。 异常 java中的异常可以分为运行时异常和编译时异常。在程序运行的时候产生的异常就是运行时异常。 异常被定义在java.lang.Throwable中。处理异常有两种方式,抛出和捕获。 抛出,使用throws关键字抛出异常,子类抛出的异常由父类处理,如果父类无法处理则可以继续往上抛 捕获,当一段代码可能会发生异常的时候或已经发生异常的时候可以使用try/catch处理。try {需要被检测的代码;}catch(异常类 变量名){异常处理代码;}fianlly{ 一定会执行的代码;}java提供了很丰富的异常子类,另外开发者还可以自定义异常类丰富异常。 I/O I/O就是Input/Output,在编程语言中就是输入输出流,编写一个好的输入输出流系统不是一个很好实现的工作。 File file是java中用于管理文件的类,使用它可以生成文件目录,修改文件名,删除文件,判断文件所在路径等,是I/O非流式的组成部分。 InputStream inputStream二进制字节输入流,是所有输入流抽象父类。定义输入流所具备的所有特征 OutputStream outputStream是inputStream的对位抽象类,是所有输出流的父类 Reader reader是基于字符输入流的抽象类 Writer writer是基于字符输出流的抽象类 所谓的”流“就是代表任何有能力产出数据的数据源对象或者是有能力接受数据的接收端对象,流的本质是数据传输,设计者将不同的数据类型传输抽象成各种不同的类进行数据操作,因此某某类被定义为流的含义就是为数据之间提供传输通道。 泛型 泛型是JDK1.5引入的新特性,这是java的提供的编译时安全检测机制,本质是参数化类型,将要操作的数据类型被指定为参数,也就是为集合存储的元素指定数据类型,在存储的时候必须存入指定的数据类型的数据。 泛型一般应用于集合,也可以使用在方法和类上,如果你不知道具体的数据类型的话也可以使用通配符"?"来表示未知数据类型。 集合

优秀的个人博客,低调大师

HTML DOM详细知识

1:节点 HTML DOM中,所有的事物都是节点。 整个文档是一个文档节点; 每个HTML元素是一个元素节点; 每个元素内的文本是一个文本节点; 每个属性是一个属性节点; 每个注释是一个注释节点; 2:方法 首先理解“编程接口”的概念:我们可以通过编程语言(如javaScript)对HTML DOM进行访问,这里把HTML元素视为对象,编程接口就是对象的方法和属性。通过方法和属性来对对象进行操作。 HTML DOM方法是可以在节点上执行的动作。 常用的HTML DOM方法: getElementById(id):获取带有指定id的节点(元素); getElementsByTagName(tagName):获取包含指定标签名称的所有元素的节点列表(集合、数组); getElementsByClassName(className):获取包含指定类名的所有元素的节点列表(集合、数组); appendChild(node):插入新的子节点; removeChild(node):删除子节点; 点击查看更多 3:属性 HTML DOM属性是节点上能够获取或设置的值。 innerHTML属性:获取元素内容,对于获取或替换HTML元素的内容很有用。 nodeName属性:规定节点的名称。它是只读的。元素节点的nodeName与标签名相同,属性节点的nodeName与属性名相同,文本节点的nodeName为#text,文档节点的nodeName为#document。 nodeValue属性:规定节点的值。元素节点的nodeValue为undefined或者null,文本节点的nodeValue为文本内容,属性节点的nodeValue为属性值。 nodeType属性:返回节点的类型,是只读的。元素节点的nodeType为1,属性节点的nodeType为2,文本节点的nodeType为3,注释节点的nodeType为8,文档节点的nodeType为9。 4:访问 访问节点也就是查找HTML的元素。 对HTML DOM节点的访问主要通过上文所说的方法来进行。 5:修改 修改HTML DOM意味着很多方面的内容,如: 该表HTML内容、改变CSS样式、改变HTML属性、创建新的HTML元素等等。 创建HTML内容:最简单的方式是使用innerHTML属性。如: document.getEmlemntById("p1").innerHTML="新文本"; 改变HMTL样式:如: document.getElementById("p1").style.color="red"; document.getElementById("p1").style.fontSize="larger"; 创建新的HTML元素:需要先创建新节点,然后把它追加到已有的元素节点上。如: var para = document.creatElement("p"); var node = document.creatTextNode("这是一个新段落"); para.appendChild(node); document.getElementById("div1").appendChild(para); 6:事件 HTML DOM允许JavaScript对HTML事件做出反应。当事件发生时,可以执行JavaScript。比如用户点击某个元素时执行代码。 事件属性:使用事件属性来向元素分配事件。如: <button onclick="displayDate()">点我</button>//向botton属性分配了onclick事件。 使用HTML DOM来分配事件:如: document.getElementById("p1").onclick=function(){displayDate()}; onload和onunload事件:当用户进入和离开页面时,会触发onload和onunload事件。它们可用于检查浏览器类型、处理cookies。 onchange时间:常用于输入字段的验证。当焦点离开时会触发。如: <input type="text" id="fname" onchange="upperCase()"> onmouseover和onmouseout事件:当鼠标指针移动到或离开元素时会触发。 onmousedowm、onmouseup及onclick事件:他们是一次鼠标点击的全部过程。当鼠标按钮被点击时,出发onmousedown,鼠标按钮松开时,触发nomouseup,最后鼠标点击完成,触发onclick。也就意味着,需要定义一次点击事件时,可以直接使用onclick。当需要点击和松开事件时,需要另外两个。 7:导航 在HTML DOM中通过节点关系来进行导航。 节点列表:节点列表是一个节点数组,通过下标可以访问相应的节点。与数组相似,通过length属性可以返回数组长度(节点个数)。 节点关系:可以使用三个节点属性,分别是:parentNode、firstChild及lastChild。 根属性:document.documentElement:全部文档; document.body:文档的主体。 childNodes和nodeValue:除了使用innerHTML,还可以使用childNodes和nodeValue属性来获取元素内容。如: txt = document.getElementById("intro").childNodes[0].nodeValue;//获取id为intro的元素的第一个子元素的值 原文发布时间:2018-6-19 原文作者:WARGON 本文来源 CSDN博客如需转载请紧急联系作者

优秀的个人博客,低调大师

python基础知识

1、print()函数print函数用于向控制台、python解释器、cmd命令行输出你想要输出的内容。print函数有输入参数,可以是字符串、数字、变量等等,也可以是它们的混合,不同对象之间可以使用,来分隔,print函数遇到,的时候会输出一个空格来作为分隔输出的效果。注意:在print函数中,如果输入的内容是可以继续计算或者合并的,那么python会先计算或者合并之后再输出。如:print(100+200)print('a'+'b')会输出数字300以及字符串'ab'2、input()函数用于从命令行、python解释器获取用户的输入,从subline text中无法输入。用户的所有输入都会被当做是str类型,即字符串类型,用户可以将input的输入内容放入变量中,即:name=input()用于保存输入的内容用作后续代码的指代。同时,为了更友好的界面,可以给input函数输入参数值,参数值可以是一个字符串,也可以是一个变量的指代,用于在提示用户输入的时候给出详细的说明,即:name=input('inpurt your name:')或者i='please input here:' , name=input(变量i)。3、组织方式python的组织方式是通过统一缩进,主旨是简洁优雅。4、数据类型和变量====整数和浮点数:整数分为正整数、负整数、0浮点数有精度问题,很大的浮点数可以用科学计数法标记,其中的10使用e来表示,即:12300000 = 1.23e7 ,或者类似2.35e-5等等====字符串:字符串,顾名思义,是一串字符序列,使用单引号或者双引号包括起来,外围的单引号或者双引号不算字符串的内容。如果字符串内容有单引号,那么外围要使用双引号包围,反之亦然,如果字符串内容中既有单引号又有双引号,则要使用\来转义其中一个引号如:' i\'am a "good" man ' ,使用\'来表示转义单引号====字符串+转义字符:在print函数中无法通过回车来体现最终打印字符串的换行,必须使用\n来表示换行,使用\t表示制表符,\单引号或者双引号,\\表示\符号注意:默认情况下,一个字符串中的\转义字符是会转义的,转义规则根据上述说明。但是如果在字符串前面加上r,则表示不对字符串内容做转义如:默认转义,print('line1\'line2')---->line1'line2强制不转义,print(r'line1\'line2')----->line1\'line2(可用于re的过滤规则中)这种情况下,不会转义:print('line1\\'+'nline2')------>line1\nline2====字符串+''''''实现简化换行:如果要输出一个段落,涉及字符串内部的多处换行,可以使用\n来实现,也可以使用print(''' ''')来实现,里面的字符串根据实际内容直接回车如:print('''这里是根据传入的页数,形成了所有的链接这里是server端这是一张新图片,准备下载''')====布尔值:True和False,用于各种判断,意味着一件事件为真或者为假,如3>2为真,2==0为假逻辑运算and,or,not,逻辑运算会与布尔值结合计算,如True and True 的结果为True注意:在python中,1可以被认为是True,0被认为是False(可以计算),其他值即不是True也不是False注意is是表示两边是同一个对象====空值:python中的空值使用None表示,注意,None不是0,对于0而言是有意义的,而None是一种特殊的属性,意味着空====变量:python支持多种数据类型,有内置原生数据类型,也有自定义扩展数据类型,任何类型的数据都可以看成一个对象,通过变量来指向它,对变量进行赋值就是让某一个变量指向某一个对象,建立他们两之间的关系。变量类似一个指针,指向某一个内存对象,python是动态语言,所以可以指向不同类型的对象,如str,int,float,list等等,java是静态语言一旦int a,那么a只能指向ini类型对象a='hello' , b=a ,意味着把a指向的对象的地址赋给b,或者说,让b指向a所指向的对象,这时候'hello'对象有两个指向自己的指针。如果此时a='world',那么print(b)还是等于'hello'====常量:约定俗成的使用全部大写变量名来表示常量,如PI对于除法/,python3中是不会取整的,python2是取整的对于地板除//,python3和2都是取整的使用%获取余数5、字符串编码问题====历史:在计算机历史上,计算机被设计成拥有处理数字的功能,计算机底层1个字节定义成8个位,1个字节可以表示的数字最大是255,如果需要表示更大的数字,就需要更多的字节,2个字节可以表示最大65535,4个字节可以表示42亿左右。根据计算机的原本设计是只能处理数字,如果要处理文本,即处理字符串,则需要把字符串与数字进行映射,即通过编码的方式记录每一个字符对应的数字。计算机是美国人发明的,所以当时只需要处理英文字符串,所有英文字符,包括字母大小写、数字、符号等等加在一起一共形成了127个字符,这127个字符通过1个字节就可以完全表示。通过1个字节对应的1个整数,映射到不同的字符,这种编码方式就是ASCII编码方式。随着计算机的发展,不同国家都在使用,都想通过计算机输入本国的语言,如中文,对于中文而言,中文的字符至少需要2个字节即至少需要65535个数字才能表示,所以中国为中文定制了GB2312编码方式,用于将中文编码到计算机的底层整数。同样的,不同国家有不同的编码方式,这就导致:同样的1个编码整数可能会在不同国家有不同的表示,而且,如果多个国家的程序放在一起,计算机就无法识别某一个字符串是属于英文还是中文还是其他国家的字符。为了解决不同国家定制不同的编码标准,出现了unicode统一字符编码标准,unicode标准常常使用2个字节表示1个字符,将世界上所有的语言都包含到这个编码标准中,这样不论计算机在哪里使用,不论计算机使用的是哪种语言,都不会出现混乱和冲突的问题。对于一些生僻的字符,unicode可能需要使用4-6个字符来表示。而如果单纯只使用unicode编码的时候,会出现空间浪费的问题,如果程序全部使用英文编写,所有英文字符默认2个unicode字节对应1个英文字符。所以使用unicode虽然可以很好的解决不同语言之间互通的问题,但是会带来空间浪费和效率不高的问题。这时候就需要使用UTF-8可变长编码方式,使用UTF-8的时候,如果是中文就是2个字节对应1个中文字符,如果是英文就是1个字节对应1个英文字符,即UTF-8的字节使用数量是根据实际使用的语言来灵活变化的,这种好处尤其体现在数据的保存、压缩、传输上。所以现在的计算机保存的数据都是UTF-8编码方式,一旦被程序调用的时候,文件中的数据则转换成unicode编码方式在内存中被处理,在处理完毕再次保存之前又被转换成高效的UTF-8编码方式。我们从网站上获取网页的时候,网页html是以源代码的形式传回给我们的浏览器,源代码中经常有:<meta charset="utf-8" /> 表示该网页使用UTF-8编码的方式来传输数据。====python字符串的编码:python3版本中,所有的字符串str类型对象都是使用unicode编码方式,即python中的所有字符串,都有对应的unicode整数,如:unicode是针对每一个字符做编码的,可以通过ord()函数对任意一个字符求出对应的unicode整数,也可以通过chr()输入unicode整数来得到对应的unicode字符当然,也可以这样写:'\uxxxx'其中要放入unicode整数的十六进制数,如,25991的十六进制数是0x6587:====编码转换:python在内存中的数据都是unicode编码,都是str类型的对象。而数据在保存或者网络传输的时候,必须转换成byte类型的字节流的形式,把unicode转换成byte类型需要依据不同的内容做不同的编码,所有byte类型的对象都是b开头,如:'abc'是str类型的对象,是unicode编码,是英文,所以转换成可传输的字节流就是'abc'.encode('ascii')---->b'abc',此时ascii编码中,1个字节对应1个英文字符'中文'是str类型的对象,是unicode编码,是中文,所以转换成可传输的字节流就是'中文'.encode('utf-8')---->b'\xe4\xb8\xad\xe6\x96\x87',此时utf-8编码中,使用3个字节表示1个中文字符------------------------------------------------------------------------------------------------------'中文'.encode('gb2312')---->b'\xd6\xd0\xce\xc4' ,此时gb2312编码中,使用2个字符表示1个中文字符总结:在计算机内存中,在python3中,所有str对象都是unicode编码,这是为了使不同国家语言可以互通,unicode编码一般是2个字节编码1个字符。而在传输、保存数据的时候,需要把unicode编码的字符转换成其他的编码方式,英文可以转换成ascii或者utf-8,中文可以转换成gb2312或者utf-8,变成可传输的字节流。使用不同的编码方式,1个字符使用的字节数量不同。一般情况下,我们都使用unicode和utf-8这两种,因为中文和英文都可以使用utf-8方式编码。即:str对象.encode('utf-8')可以变成字节流byte类型对象以b开头, byte对象.decode('utf-8')可以变成unicode字符的str类型对象用于计算机和程序的处理,所以在hello.py文件的开头都有:#coding:utf-8就是告诉python解释器:使用utf-8编码方式来decode到unicode来处理,然后将unicode的数据encode到utf-8来保存和传输====python的格式化字符串:last=72today=85rate=(today-last)/lastprint('小明的成绩从去年的%d分提升到了今年的%d分,增长百分比是:%.1f%%' %(last,today,rate))6、list和tuple====list的性质:list是python的内置数据类型,翻译成列表或者数组。list是一组数据或者一组对象或者一组元素的序列,同样的元素不同的排列是不同的列表。列表的元素数量可以通过len(a)来获得,list是可变长数组,可以随时通过append在末尾增加元素,通过pop(i)弹出位置i的元素默认是末尾,通过insert(i,xx)在位置i插入xx元素。除此之外,list还是混合类型数组,即数组内部可以允许不同类型的元素,如:a=[1,True,'abc',2.2],此时的a是一个指向一个list地址的变量(性质上是指针)。list通过下标0~len-1的范围来获取每一个元素。list可以通过-1,-2来从尾部开始获取元素,-1表示倒数第1个元素,-2表示倒数第2个元素,以此类推。list中可以放任何类型的对象,除了python内置的整数、浮点数、布尔值、字符串等,还可以是list,tuple,dict,其他自定义数据类型等等。如果list中还有一个list,则意味着内部的list是一个二维数组,如果内部list的一个对象还是一个list,则最内部list是三维数组,以此类推,通过a[1][2]来获取二维数组的元素。====tuple的性质:tuple的性质和list很相似,最大的不同在于tuple更严格、更安全、数据只能取不能增删改,即tuple一旦初始化后则无法改变内容,而list可以随时增删改元素。====注意:二义性的tuple符号:list在创建的时候使用[],tuple在创建的时候使用(),如果是创建一个空list则是a=[],如果是创建空tuple则是a=(),如果创建一个只含有1个元素的tuple,不应该写成a=(1)这会被python解释成a=1,a是一个int类型的对象因为python遇到()的时候有二义性,到底是tuple还是普通的小括号,python规定当做小括号使用,所以声明一个只有1个元素的tuple应该是:a=(1,)注意不要缺少这个逗号。====注意:“可变的”tupletuple的不可修改指的是每一个tuple中的元素所指向的对象都不发生地址变化,但是所指向的对象的内容却可以改变,如:a=('a','b',['A','B'])a[2][0]='X'a[2][1]='Y'print(a) -- > ('a','b',['X','Y'])这种修改是合法的,因为对于tuple a而言,a[2]这个元素地址并没有发生改变,即并没有指向其他的list,而这个未改变地址的list的内容发生改变并不影响tuple的规定。7、条件判断if,elif,else判断语句,用于分支判断,if可以理解成判断后面的语句是否为真,如果是真则执行if语句块,如果不为真就一定为假,则执行else语句块,使用elif可以增加多个判断条件。连用多个if和elif的判断逻辑类似于ACL访问控制列表,判断顺序也是自上而下,一条没有满足即顺延到下一条判断条件,一旦某一条判断条件是真,则不再进行后续判断,如果所有if和elif都判断为假,则用最后的else作为permit any含义。注意条件判断后面不要遗漏:冒号,条件判断还可以简写成if x: 这个x只要是非零整数、非空列表、非空tuple、非空字符串等等,都认为是True,否则认为是False。input()函数用于获取用户输入,无论用户输入的是数字、字符、还是字符串等等,都被input函数以str的类型返回。可以通过eval()函数获取一个字符串的值,如:'2'就是2,'a'会得到变量a8、循环python中的循环有两类====for循环:for循环用于遍历一个序列,将序列中的每一个元素赋值给自定义的变量以便操作序列中的所有元素值,如:注意:一般会使用list(range(10))来构造一个10个元素的列表,因为从0开始所以是0~9的10个元素。for循环的循环执行依赖于明确的范围遍历(无法依赖条件判断)====while循环:while循环的执行依赖于while关键字后面的条件判断,当为真的时候执行循环体,执行完毕后再次条件判断,为假的时候跳出循环,所以循环体内部需要有一定的限制条件或者手段来保证有限次的循环后可以跳出,即while循环的执行依赖于条件判断+循环体内部限制条件注意:跳出while循环的时候,一定是第一次不满足循环条件判断的时候====break:在循环体内部使用break可以跳出当前一层循环,用于特殊、有需要的程序执行分支流程====continue:在循环体内部使用continue可以省略剩余的循环体语句并立即开始下一次循环,如果是for就中断并提前遍历下一个元素,如果是while就中断并提前执行下一次条件判断注意:大量的、不加规划的使用break和continue的确会导致程序的逻辑、执行流程混乱,加重代码的复杂度以及后期debug的工作量。另外,就像无限迭代会导致机器崩溃一样,无限循环也会导致机器崩溃,所以编写循环首要注意的就是是否可以在必要的时候跳出循环体,尤其是while循环体中是否有足够的限制条件和手段。9、dict和set就像list和tuple非常的类似,并且都是python的内置数据类型一样。dict和set也是python的内置数据类型,也一样非常类似。====dict:dict在python中称为字典,是一种key-value对,其实类似于哈希表,即一个输入(key),有着唯一的输出(value),中间通过hash算法来完成唯一的映射。dict使用{}来表示,里面填写每一个key-value对使用逗号分隔。dict中的key就是哈希表中的输入或者关键字,dict使用哈希算法将key映射成唯一的内存地址,该内存地址上可以保存其他对象即value,所以key被要求不可变(即一旦初始化即不可再改变),如整数、字符串、元祖tuple等等,而value的值却是可变的,但若value变化多次则会以最后一次的值为准。在dict中,key是没有排序的,即无法使用dict[0]这种类似list和tuple的方式来获取第1个元素,dict只能使用d[key名称]的形式来获取这个key所对应的value。dict使用d[key名称]=value的方式来为一个dict新增键值对,也可以使用del d[key]的方式删除一个键值对,或者是d.pop(key)的方式弹出一个键值对,dict使用d[key名称]的方式来访问这个key对应的value,如果没有该key则会报错,所以访问方式还可以是:key in d 使用布尔判断是否含有此key,或者是d.get(key,-1)获取d的key的value,如果没有key则返回-1,默认返回None无法在python解释器中显示结果。遇到任何有联系的两个对象,都可以使其一成为key,另一个成为value放入dict中,在dict中的查找速度是非常快的基本等于O(1)。====set:set在python中称为集合,更确切的说,就是一些不重复的对象的集合,之所以不说是序列,是因为set是无序的,即无法使用s[0]这种序列访问方式来访问,就像dict一样,也是无序的。同时,set的构造使用{}来表示,和dict一样,但是set的对象并不是dict那样的键值对,事实上,set的对象只有key而没有value。可以使用s=set(某个序列)函数来构造一个集合,输入需要是一个序列,可以是list、tuple、range(10)等。set最重要的特性是:1、set中对象无重复2、set作为集合,可用于数学上的集合运算,如交集&,并集|交集:取s1和s2中共有的部分作为结果,即交集是s1的子集,也是s2的子集并集:将s1和s2所有元素整合并消除重复,即s1是并集的子集,s2页是并集的子集3、set可以增加或者减少对象,s.add(100), s.remove(2)如果新增多个重复的对象,set会自动过滤====注意:关于不可变对象:首先,对象不可变指的是某个对象一旦被构造并被初始化值之后,就不能再改变这个对象的地址以及这个对象的值,如:整数、字符串、tuple、dict的key等等。其次,不可变对象的一些函数如果涉及到需要改变对象的值,则一般会复制一份同值的对象并返回,而原来的不可变对象还是没有改变值,以此来保证对象的不可变性。对于可变对象,对象的函数如果涉及改变对象的值,则直接在原有对象上进行改变。如:因为str1不可变,所以replace涉及修改值的时候返回了另一个对象因为list1可变,所以直接在list1对象上直接修改值,并不返回另一个对象

优秀的个人博客,低调大师

日期型数据知识

日期型数据,在 C# 中的参与运算的时候,应该也是转换为长整型数据来运算的。它 的长整型值是自 0001 年 1 月 1 日午夜 12:00 以来所经过时间以 100 毫微秒为间隔表示时 的数字。这个数在 C# 的 DateTime 中被称为 Ticks(刻度)。DateTime 类型有一个名为 Ticks 的长整型只读属性,就保存着这个值。如此,要从一个 DataTime 型数据得到 long 型值就非常简单了,只需要读出 DataTime 对象的 Ticks 值即可,如: long longDate = DateTime.Now.Ticks; DateTime 的构造函数中也提供了相应的,从长整型数据构造 DateTime 型数据的函 数:DateTime(long)。如: DateTime theDate = new DateTime(longDate); 格式化日期型数据 编程的过程中,通常需要将日期型数据按照一定的格式输出,当然,输出结果肯定是 字符串。为此,我们需要使用 System.DateTime 类的 ToString() 方法,并为其指定格式字 符串。 MSDN 中,System.Globalization.DateTimeFormatInfo 类的概述里对模式字符串有非 常详细的说明,因此,这里我只对常用的一些格式进行说明,首先请看下表: d 月中的某一天一位数的日期没有前导零 dd 月中的某一天一位数的日期有一个前导零 ddd 周中某天的缩写名称在 AbbreviatedDayNames 中定义 dddd 周中某天的完整名称在 DayNames 中定义 M 月份数字一位数的月份没有前导零 MM 月份数字一位数的月份有一个前导零 MMM 月份的缩写名称在 AbbreviatedMonthNames 中定义 MMMM 月份的完整名称在 MonthNames 中定义 y 不包含纪元的年份如果不包含纪元的年份小于 10,则显示不具有前导零的年份 yy 不包含纪元的年份如果不包含纪元的年份小于 10,则显示具有前导零的年份 yyyy 包括纪元的四位数的年份 h 12 小时制的小时一位数的小时数没有前导零 hh 12 小时制的小时一位数的小时数有前导零 H 24 小时制的小时一位数的小时数没有前导零 HH 24 小时制的小时一位数的小时数有前导零 m 分钟一位数的分钟数没有前导零 mm 分钟一位数的分钟数有一个前导零 s 秒一位数的秒数没有前导零 ss 秒一位数的秒数有一个前导零 为了便于大家的理解,不妨试试下面的程序: private void TestDateTimeToString() { DateTime now = DateTime.Now; string format; this.textBox1.Text = ""; format = "yyyy-MM-dd HH:mm:ss"; this.textBox1.AppendText(format + ": " +now.ToString(format) + "\n"); format = "yy 年M 日d 日"; this.textBox1.AppendText(format + ": " + now.ToString(format) +"\n"); } 这段程序将输出结果: yyyy-MM-dd HH:mm:ss: 2002-08-26 17:03:04 yy 年M 日d 日: 02 年8 日26 日 这时候,又出现一个问题,如果要输出的文本信息中包含格式字符怎么办?如 format = "year: yyyy, month: MM, day: dd"; this.textBox1.AppendText(now.ToString(format) + "\n"); 将输出: 2ear: 2002, 4on 下5: 08, 26a2: 26 这并不是我想要的结果,怎么办呢?有办法—— format = "\"year\": yyyy, \'month\': MM, \'day\': dd"; this.textBox1.AppendText(now.ToString(format) + "\n"); 看,这次运行结果对了: year: 2002, month: 08, day: 26 可以看出,只需要使用单引号或者双引号将文本信息括起来就好。 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/archive/2010/06/21/1761695.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android基础:SlidingDrawer知识

SlidingDrawer抽屉,主要有handler和content组成,handler一般是图片,cotent随意,基本的方法主要有 open()、animateOpen()、close()、animateClose()、SlidingDrawer.setOnDrawerOpenListener()、SlidingDrawer.setOnDrawerCloseListener() lock()、unlock(), 系统自带的抽屉可以从下往上、或者从右往左拉开,通过orientation来设置,如果要使SlidingDrawer按指定高度拉开,应该放到Relativelayout中,同时设置alignParentBotom为true. <?xml version= "1.0" encoding= "utf-8" ?> <RelativeLayout xmlns:android= "http://schemas.android.com/apk/res/android" android:layout_width= "match_parent" android:layout_height= "match_parent" android:orientation= "vertical" > <SlidingDrawer android:id= "@+id/slidingdrawer" android:layout_width= "fill_parent" android:layout_height= "400px" android:content= "@+id/content" android:handle= "@+id/handler" android:orientation= "horizontal" android:layout_alignParentBottom= "true" > <ImageView android:id= "@id/handler" android:layout_width= "wrap_content" android:layout_height= "wrap_content" android:src= "@drawable/handler" /> <TextView android:id= "@+id/content" android:layout_width= "fill_parent" android:layout_height= "fill_parent" android:text= "测试。。。。。。。。" android:textSize= "18px" android:gravity= "center_vertical" android:background= "#ff00ff00" /> </SlidingDrawer> </RelativeLayout> handler = (ImageView) findViewById(R.id.handler); content = (TextView) findViewById(R.id.content); slidingdrawer = (SlidingDrawer) findViewById(R.id.slidingdrawer); slidingdrawer.open(); slidingdrawer.setOnDrawerOpenListener( new OnDrawerOpenListener() { @Override public void onDrawerOpened() { handler.setImageDrawable(MainActivity. this .getResources().getDrawable(R.drawable.p)); ScaleAnimation anim = new ScaleAnimation( 0 .0f, 1 .0f, 0 .0f, 1 .0f); anim.setDuration( 1000 ); // slidingdrawer.setAnimation(anim); // slidingdrawer.startAnimation(anim); } }); slidingdrawer.setOnDrawerCloseListener( new OnDrawerCloseListener() { @Override public void onDrawerClosed() { handler.setImageDrawable(MainActivity. this .getResources().getDrawable(R.drawable.handler)); /**锁定slidingdrawer.lock();**/ // slidingdrawer.lock(); } }); 本文转自demoblog博客园博客,原文链接http://www.cnblogs.com/0616--ataozhijia/archive/2012/11/01/2750165.html如需转载请自行联系原作者 demoblog

优秀的个人博客,低调大师

Android系统小知识

1.添加振动 http://blog.csdn.net/caesardadi/article/details/8251933 2.excel操作 jxl.jar jxcell.jar Appache的poi库 3.保证屏幕黑屏之后CPU继续运作 http://blog.csdn.net/jhope/article/details/53737402 4.文件新建之后,在电脑上看不见。 http://blog.csdn.net/lmw21848/article/details/52297346 5.java文件加解密 http://zhangzhaoaaa.iteye.com/blog/2124700 6.AlarmManager定点提醒 http://blog.csdn.net/fxdaniel/article/details/41150129 几个设置参数的意义 http://blog.csdn.net/wangjia55/article/details/21518931 7. 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/2048586,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android JNI知识简介

Java Native Interface (JNI)标准是java平台的一部分,它允许Java代码和其他语言写的代码进行交互。JNI 是本地编程接口,它使得在 Java 虚拟机 (VM) 内部运行的 Java 代码能够与用其它编程语言(如 C、C++ 和汇编语言)编写的应用程序和库进行交互操作。 1.从如何载入.so档案谈起 由于Android的应用层的类都是以Java写的,这些Java类编译为Dex型式的Bytecode之后,必须靠Dalvik虚拟机(VM: Virtual Machine)来执行。VM在Android平台里,扮演很重要的角色。 此外,在执行Java类的过程中,如果Java类需要与C组件沟通时,VM就会去载入C组件,然后让Java的函数顺利地调用到C组件的函数。此时,VM扮演着桥梁的角色,让Java与C组件能通过标准的JNI介面而相互沟通。 应用层的Java类是在虚拟机(VM: Vitual Machine)上执行的,而C件不是在VM上执行,那么Java程式又如何要求VM去载入(Load)所指定的C组件呢? 可使用下述指令: System.loadLibrary(*.so的档案名); 例如,Android框架里所提供的MediaPlayer.java类,含指令: public classMediaPlayer {static{System.loadLibrary("media_jni");}} 这要求VM去载入Android的/system/lib/libmedia_jni.so档案。载入*.so之后,Java类与*.so档案就汇合起来,一起执行了。 2.如何撰写*.so的入口函数 ---- JNI_OnLoad()与JNI_OnUnload()函数的用途 当Android的VM(Virtual Machine)执行到System.loadLibrary()函数时,首先会去执行C组件里的JNI_OnLoad()函数。它的用途有二: (1)告诉VM此C组件使用那一个JNI版本。如果你的*.so档没有提供JNI_OnLoad()函数,VM会默认该*.so档是使用最老的JNI 1.1版本。由于新版的JNI做了许多扩充,如果需要使用JNI的新版功能,例如JNI 1.4的java.nio.ByteBuffer,就必须藉由JNI_OnLoad()函数来告知VM。 (2)由于VM执行到System.loadLibrary()函数时,就会立即先呼叫JNI_OnLoad(),所以C组件的开发者可以藉由JNI_OnLoad()来进行C组件内的初期值之设定(Initialization) 。 例如,在Android的/system/lib/libmedia_jni.so档案里,就提供了JNI_OnLoad()函数,其程式码片段为: // #defineLOG_NDEBUG0 #defineLOG_TAG"MediaPlayer-JNI" jintJNI_OnLoad(JavaVM*vm, void*reserved) {JNIEnv*env=NULL;jintresult=-1;if(vm->GetEnv((void**)&env,JNI_VERSION_1_4)!=JNI_OK){LOGE("ERROR:GetEnvfailed/n");gotobail;}assert(env!=NULL);if(register_android_media_MediaPlayer(env)<0){LOGE("ERROR:MediaPlayernativeregistrationfailed/n");gotobail;}if(register_android_media_MediaRecorder(env)<0){LOGE("ERROR:MediaRecordernativeregistrationfailed/n");gotobail;}if(register_android_media_MediaScanner(env)<0){LOGE("ERROR:MediaScannernativeregistrationfailed/n");gotobail;}if(register_android_media_MediaMetadataRetriever(env)<0){LOGE("ERROR:MediaMetadataRetrievernativeregistrationfailed/n");gotobail;}/*success--returnvalidversionnumber*/result=JNI_VERSION_1_4;bail:returnresult;} 此函数回传JNI_VERSION_1_4值给VM,于是VM知道了其所使用的JNI版本了。此外,它也做了一些初期的动作(可呼叫任何本地函数),例如指令: if(register_android_media_MediaPlayer(env)<0) {LOGE("ERROR:MediaPlayernativeregistrationfailed/n");gotobail;} 就将此组件提供的各个本地函数(Native Function)登记到VM里,以便能加快后续呼叫本地函数的效率。 JNI_OnUnload()函数与JNI_OnLoad()相对应的。在载入C组件时会立即呼叫JNI_OnLoad()来进行组件内的初期动作;而当VM释放该C组件时,则会呼叫JNI_OnUnload()函数来进行善后清除动作。当VM呼叫JNI_OnLoad()或JNI_Unload()函数时,都会将VM的指针(Pointer)传递给它们,其参数如下: jintJNI_OnLoad(JavaVM*vm, void*reserved) {} jintJNI_OnUnload(JavaVM*vm, void*reserved) {} 在JNI_OnLoad()函数里,就透过VM之指标而取得JNIEnv之指标值,并存入env指标变数里,如下述指令: jintJNI_OnLoad(JavaVM*vm, void*reserved) {JNIEnv*env=NULL;jintresult=-1;if(vm->GetEnv((void**)&env,JNI_VERSION_1_4)!=JNI_OK){LOGE("ERROR:GetEnvfailed/n");gotobail;}} 由于VM通常是多执行绪(Multi-threading)的执行环境。每一个执行绪在呼叫JNI_OnLoad()时,所传递进来的JNIEnv指标值都是不同的。为了配合这种多执行绪的环境,C组件开发者在撰写本地函数时,可藉由JNIEnv指标值之不同而避免执行绪的资料冲突问题,才能确保所写的本地函数能安全地在Android的多执行绪VM里安全地执行。基于这个理由,当在呼叫C组件的函数时,都会将JNIEnv指标值传递给它,如下: 这JNI_OnLoad()呼叫register_android_media_MediaPlayer(env)函数时,就将env指标值传递过去。如此,在register_android_media_MediaPlayer()函数就能藉由该指标值而区别不同的执行绪,以便化解资料冲突的问题。 例如,在register_android_media_MediaPlayer()函数里,可撰写下述指令: if((*env)->MonitorEnter(env,obj)!=JNI_OK) {} 查看是否已经有其他执行绪进入此物件,如果没有,此执行绪就进入该物件里执行了。还有,也可撰写下述指令: if((*env)->MonitorExit(env,obj)!=JNI_OK) {} 查看是否此执行绪正在此物件内执行,如果是,此执行绪就会立即离开。 3.registerNativeMethods()函数的用途 应用层级的Java类别透过VM而呼叫到本地函数。一般是仰赖VM去寻找*.so里的本地函数。如果需要连续呼叫很多次,每次都需要寻找一遍,会多花许多时间。此时,组件开发者可以自行将本地函数向VM进行登记。例如,在Android的/system/lib/libmedia_jni.so档案里的代码段如下: // #defineLOG_NDEBUG0 #defineLOG_TAG"MediaPlayer-JNI" staticJNINativeMethodgMethods[]= {{"setDataSource","(Ljava/lang/String;)V",(void*)android_media_MediaPlayer_setDataSource},{"setDataSource","(Ljava/io/FileDescriptor;JJ)V",(void*)android_media_MediaPlayer_setDataSourceFD},{"prepare","()V",(void*)android_media_MediaPlayer_prepare},{"prepareAsync","()V",(void*)android_media_MediaPlayer_prepareAsync},{"_start","()V",(void*)android_media_MediaPlayer_start},{"_stop","()V",(void*)android_media_MediaPlayer_stop},{"getVideoWidth","()I",(void*)android_media_MediaPlayer_getVideoWidth},{"getVideoHeight","()I",(void*)android_media_MediaPlayer_getVideoHeight},{"seekTo","(I)V",(void*)android_media_MediaPlayer_seekTo},{"_pause","()V",(void*)android_media_MediaPlayer_pause},{"isPlaying","()Z",(void*)android_media_MediaPlayer_isPlaying},{"getCurrentPosition","()I",(void*)android_media_MediaPlayer_getCurrentPosition},{"getDuration","()I",(void*)android_media_MediaPlayer_getDuration},{"_release","()V",(void*)android_media_MediaPlayer_release},{"_reset","()V",(void*)android_media_MediaPlayer_reset},{"setAudioStreamType","(I)V",(void*)android_media_MediaPlayer_setAudioStreamType},{"setLooping","(Z)V",(void*)android_media_MediaPlayer_setLooping},{"setVolume","(FF)V",(void*)android_media_MediaPlayer_setVolume},{"getFrameAt","(I)Landroid/graphics/Bitmap;",(void*)android_media_MediaPlayer_getFrameAt},{"native_setup","(Ljava/lang/Object;)V",(void*)android_media_MediaPlayer_native_setup},{"native_finalize","()V",(void*)android_media_MediaPlayer_native_finalize},}; static intregister_android_media_MediaPlayer(JNIEnv*env) {returnAndroidRuntime::registerNativeMethods(env,"android/media/MediaPlayer",gMethods,NELEM(gMethods));} jintJNI_OnLoad(JavaVM*vm, void*reserved) {if(register_android_media_MediaPlayer(env)<0){LOGE("ERROR:MediaPlayernativeregistrationfailed/n");gotobail;}} 当VM载入libmedia_jni.so档案时,就呼叫JNI_OnLoad()函数。接着,JNI_OnLoad()呼叫register_android_media_MediaPlayer()函数。此时,就呼叫到AndroidRuntime::registerNativeMethods()函数,向VM(即AndroidRuntime)登记gMethods[]表格所含的本地函数了。简而言之,registerNativeMethods()函数的用途有二: (1)更有效率去找到函数。 (2)可在执行期间进行抽换。由于gMethods[]是一个<名称,函数指针>对照表,在程序执行时,可多次呼叫registerNativeMethods()函数来更换本地函数之指针,而达到弹性抽换本地函数之目的。 4.Andoird 中使用了一种不同传统Java JNI的方式来定义其native的函数。其中很重要的区别是Andorid使用了一种Java 和 C 函数的映射表数组,并在其中描述了函数的参数和返回值。这个数组的类型是JNINativeMethod,定义如下: typedefstruct {constchar*name;/*Java中函数的名字*/constchar*signature;/*描述了函数的参数和返回值*/void*fnPtr;/*函数指针,指向C函数*/}JNINativeMethod; 其中比较难以理解的是第二个参数,例如 "()V" "(II)V" "(Ljava/lang/String;Ljava/lang/String;)V" 实际上这些字符是与函数的参数类型一一对应的。 "()" 中的字符表示参数,后面的则代表返回值。例如"()V" 就表示void Func(); "(II)V" 表示 void Func(int, int); 具体的每一个字符的对应关系如下 字符 Java类型 C类型 V void void Z jboolean boolean I jint int J jlong long D jdouble double F jfloat float B jbyte byte C jchar char S jshort short 数组则以"["开始,用两个字符表示 [I jintArray int[] [F jfloatArray float[] [B jbyteArray byte[] [C jcharArray char[] [S jshortArray short[] [D jdoubleArray double[] [J jlongArray long[] [Z jbooleanArray boolean[] 上面的都是基本类型。如果Java函数的参数是class,则以"L"开头,以";"结尾,中间是用"/" 隔开的包及类名。而其对应的C函数名的参数则为jobject. 一个例外是String类,其对应的类为jstring Ljava/lang/String; String jstring Ljava/net/Socket; Socket jobject 如果JAVA函数位于一个嵌入类,则用$作为类名间的分隔符。 例如 "(Ljava/lang/String;Landroid/os/FileUtils$FileStatus;)Z" Android JNI编程实践 一、直接使用java本身jni接口(windows/ubuntu) 1.在Eclipsh中新建一个android应用程序。两个类:一个继承于Activity,UI显示用。另一个包含native方法。编译生成所有类。 jnitest.java文件: packagecom.hello.jnitest; importandroid.app.Activity; importandroid.os.Bundle; public classjnitest extendsActivity {/**Calledwhentheactivityisfirstcreated.*/@OverridepublicvoidonCreate(BundlesavedInstanceState){super.onCreate(savedInstanceState);setContentView(R.layout.main);Naddcal=newNadd();setTitle("TheNativeAddResultis"+String.valueOf(cal.nadd(10,19)));}} Nadd.java文件: packagecom.hello.jnitest; public classNadd {static{System.loadLibrary("Nadd");}publicnativeintnadd(inta,intb);} 以上在windows中完成。 2.使用javah命令生成C/C++的.h文件。注意类要包含包名,路径文件夹下要包含所有包中的类,否则会报找不到类的错误。classpath参数指定到包名前一级文件夹,文件夹层次结构要符合java类的组织层次结构。 javah -classpath ../jnitest/bin com.hello.jnitest.Nadd com_hello_jnitest_Nadd .h文件: /*DONOTEDITTHISFILE-itismachinegenerated*/ #include<jni.h> /*Headerforclasscom_hello_jnitest_Nadd*/ #ifndef_Included_com_hello_jnitest_Nadd #define_Included_com_hello_jnitest_Nadd #ifdef__cplusplus extern"C" {#endif/**Class:com_hello_jnitest_Nadd*Method:nadd*Signature:(II)I*/JNIEXPORTjintJNICALLJava_com_hello_jnitest_Nadd_nadd(JNIEnv*,jobject,jint,jint);#ifdef__cplusplus} #endif #endif 3.编辑.c文件实现native方法。 com_hello_jnitest_Nadd.c文件: #include<stdlib.h> #include"com_hello_jnitest_Nadd.h" JNIEXPORTjintJNICALLJava_com_hello_jnitest_Nadd_nadd(JNIEnv*env,jobjectc,jinta,jintb) {return(a+b);} 4.编译.c文件生存动态库。 arm-none-linux-gnueabi-gcc -I/home/a/work/android/jdk1.6.0_17/include -I/home/a/work/android/jdk1.6.0_17/include/linux -fpic -c com_hello_jnitest_Nadd.c arm-none-linux-gnueabi-ld -T/home/a/CodeSourcery/Sourcery_G++_Lite/arm-none-linux-gnueabi/lib/ldscripts/armelf_linux_eabi.xsc -share -o libNadd.so com_hello_jnitest_Nadd.o 得到libNadd.so文件。 以上在ubuntu中完成。 5.将相应的动态库文件push到avd的system/lib中:adb push libNadd.so /system/lib。若提示Read-only file system错误,运行adb remount命令,即可。 Adb push libNadd.so /system/lib 6.在eclipsh中运行原应用程序即可。 以上在windows中完成。 对于一中生成的so文件也可采用二中的方法编译进apk包中。只需在工程文件夹中建libs/armeabi文件夹(其他文件夹名无效,只建立libs文件夹也无效),然后将so文件拷入,编译工程即可。 二.使用NDK生成本地方法(ubuntu and windows) 1.安装NDK:解压,然后进入NDK解压后的目录,运行build/host-setup.sh(需要Make 3.81和awk)。若有错,修改host-setup.sh文件:将#!/bin/sh修改为#!/bin/bash,再次运行即可。 2.在apps文件夹下建立自己的工程文件夹,然后在该文件夹下建一文件Application.mk和项project文件夹。 Application.mk文件: APP_PROJECT_PATH:=$(callmy-dir)/project APP_MODULES:=myjni 3.在project文件夹下建一jni文件夹,然后新建Android.mk和myjni.c。这里不需要用javah生成相应的.h文件,但函数名要包含相应的完整的包、类名。 4.编辑相应文件内容。 Android.mk文件: #Copyright(C)2009TheAndroidOpenSourceProject # #LicensedundertheApacheLicense,Version2.0(the"License"); #youmaynotuse thisfileexcept incompliancewiththeLicense. #YoumayobtainacopyoftheLicenseat # #http: // www.apache.org/licenses/LICENSE-2.0 # #Unlessrequiredbyapplicablelaworagreedto inwriting,software #distributedundertheLicense isdistributedonan"ASIS"BASIS, #WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. #SeetheLicense forthespecificlanguagegoverningpermissionsand #limitationsundertheLicense. # LOCAL_PATH:=$(callmy-dir) include$(CLEAR_VARS) LOCAL_MODULE:=myjni LOCAL_SRC_FILES:=myjni.c include$(BUILD_SHARED_LIBRARY) myjni.c文件: #include< string.h> #include<jni.h> jstring Java_com_hello_NdkTest_NdkTest_stringFromJNI(JNIEnv*env, jobjectthiz) {return(*env)->NewStringUTF(env,"HellofromMy-JNI!");} myjni文件组织: a@ubuntu:~/work/android/ndk-1.6_r1/apps$ tree myjni myjni |-- Application.mk `-- project |-- jni | |-- Android.mk | `-- myjni.c `-- libs `-- armeabi `-- libmyjni.so 4 directories, 4 files 5.编译:make APP=myjni. 以上内容在ubuntu完成。以下内容在windows中完成。当然也可以在ubuntu中完成。 6.在eclipsh中创建android application。将myjni中自动生成的libs文件夹拷贝到当前工程文件夹中,编译运行即可。 NdkTest.java文件: packagecom.hello.NdkTest; importandroid.app.Activity; importandroid.os.Bundle; importandroid.widget.TextView; public classNdkTest extendsActivity {/**Calledwhentheactivityisfirstcreated.*/@OverridepublicvoidonCreate(BundlesavedInstanceState){super.onCreate(savedInstanceState);TextViewtv=newTextView(this);tv.setText(stringFromJNI());setContentView(tv);}publicnativeStringstringFromJNI();static{System.loadLibrary("myjni");}} 对于二中生成的so文件也可采用一中的方法push到avd中运行。

优秀的个人博客,低调大师

Appium知识技巧收集

1、真机调试打开USB调试模式 2、启动脚本提示apk包Could not make a string,是释放string.json出错,由于apk损坏导致,验证是安装到真机上开启APP 3、Activity要写对,否则提示不存在Activity,建议写完整名称,完整包名类似com.xxx.xxx.Activity;启动Activity要写对,否则提示XXX never XXX。包名参数与Activity参数可以在AndroidManifest.xml(获取方法http://code.google.com/p/android-apktool/)中查看,包名: android:name="com.xxx.xxx.SplashActivity" android:launchMode="singleTop" android:screenOrientation="portrait" ,本例中是com.xxx.xxx.SplashActivity 4、Appium支持一个Webdriver元素定位方法的子集 find by "tag name" (i.e., 通过UI的控件类型) find by "name" (i.e., 通过元素的文本, 标签, 或者开发同学添加的id标示, 比如accessibilityIdentifier) find by "xpath" (i.e., 具有一定约束的路径抽象标示, 基于XPath方式) 5、Appium 在 Mac OS X 上安装使用文档,参考:http://testerhome.com/topics/166,Windows平台,参考:http://testerhome.com/topics/155,Linux平台,参考:http://testerhome.com/topics/160,Android平台,参考:http://testerhome.com/topics/153 6、iOS模拟器—>硬件—>设备—>iPhone 7、【坑】Appium在MacOS10.9以及iOS7上面的问题:启动appium脚本没有问题。安装好应用之后log中会报出500,同时instruments会显示simulator session timeout。 8、生成build/Test.appa的方法,进入到目录下面编译 xcodebuild -sdk iphonesimulator6.0 9、安装路径问题 全局路径,也就是带上参数 -g 的安装模式。这个命令会把模块安装在 $PREFIX/lib/node_modules 下,可通过命令 npm root -g 查看全局模块的安装目录。 package.json 里定义的bin会安装到 $PREFIX/bin 目录下,如果模块带有 man page 会安装到 $PREFIX/share/man 目录下。 本地路径,不带 -g 参数的。从当前目录一直查找到根目录/下有没有 node_modules 目录,有模块安装到这个目录下的 node_modules 目录里,如果没有找到则把模块安装到当前目录 node_modules 目录下。package.josn 定义的 bin 会安装到 node_modules/.bin 目录下,man page 则不会安装。 最新内容请见作者的GitHub页:http://qaseven.github.io/

优秀的个人博客,低调大师

Android基础知识

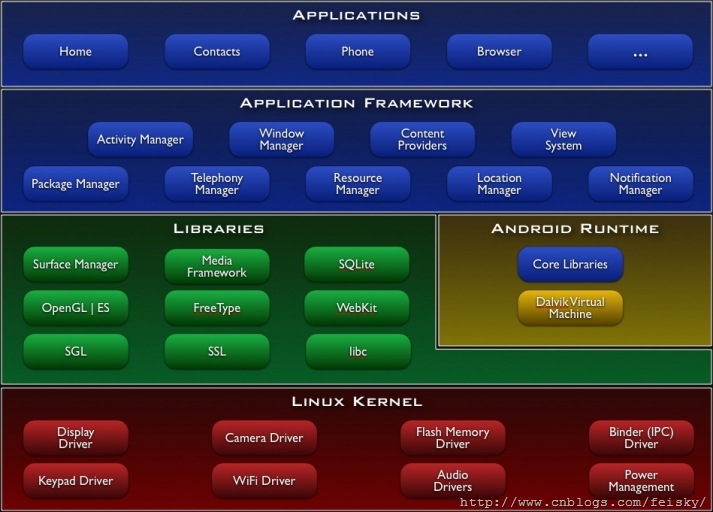
Android特性: Application frameworkenabling reuse and replacement of components Dalvik virtual machineoptimized for mobile devices Integrated browserbased on the open sourceWebKitengine Optimized graphicspowered by a custom 2D graphics library; 3D graphics based on the OpenGL ES 1.0 specification (hardware acceleration optional) SQLitefor structured data storage Media supportfor common audio, video, and still image formats (MPEG4, H.264, MP3, AAC, AMR, JPG, PNG, GIF) GSM Telephony(hardware dependent) Bluetooth, EDGE, 3G, and WiFi(hardware dependent) Camera, GPS, compass, and accelerometer(hardware dependent) Rich development environmentincluding a device emulator, tools for debugging, memory and performance profiling, and a plugin for the Eclipse IDE 框架: 应用程序部件: Activity Services Content Providers Broadcast receiver Manifest 文件 整个程序的功能清单,包括包的定义、版本声明,应用程序Activity、ICON、service、intent filter等的声明。 在Eclipse中可以通过Manifest Editor方便编辑(右键打开)。 <?xml version="1.0" encoding="utf-8"?> <manifest . . . > <application . . . > <activity android:name="com.example.project.FreneticActivity" android:icon="@drawable/small_pic.png" android:label="@string/freneticLabel" . . . > </activity> . . . </application> </manifest> Activities and Tasks 一个task就是用户感觉上的"应用程序",task 是一组相互关联的activity集合组成的栈(这些activity可能属于多个应用程序). 栈底就是应用程序启动时显示的第一个activity。栈顶activity就是用户在屏幕上看到的activity。当一个activity启动一个新的activity时,新的activity就会被压入栈中。当用户点击"back " 按钮时,位于栈顶的activity将会被弹出栈。我们举个例子,假设task中有两个activity,分别是 A 和 B,其中A是位于栈顶的activity,用户点击"back"后, A就被弹出栈, B 就成为了新的栈顶activity,然后 activity B 会显示在屏幕上。 通常来讲,task栈中的activity不会被改变排列顺序,只有出栈和入栈操作。 A task is a stack of activities, not a class or an element in the manifest file. So there's no way to set values for a task independently of its activities. Values for the task as a whole are set in the root activity. For example, the next section will talk about the "affinity of a task"; that value is read from the affinity set for the task's root activity. 一个task中的所有activity是作为一个整体来移动的--移到前台后者后台。就个例子,假设当前 task 栈中有ABCD4个activity,A是栈顶activity,也就是在屏幕上显示的activity,用户点击了"home"键,启动了一个新的应用程序,则 ABCD 4个activity都会被移动到后台。过了一会,用户又点击了"home"键,并重新选择了先前的程序,则 ABCD 都被移动到前台,A 仍然作为栈顶activity 被显示在屏幕上,然后用户点击了"back",A被弹出栈,B作为新的栈顶activity被显示在屏幕上。 前面所讲的都是task的默认行为,我们可以通过某些方法改变task 的默认行为。 不同的task里的activity是由affinity来区别的.默认情况下每个task里面的activities都有相同的affinity。但是可以通过<activity> 标签里taskAffinity属性来修改某个activity的affinity,此时需要设置FLAG_ACTIVITY_NEW_TASK标志,并且allowTaskReparenting 属性设置为true。关于这点的文档解释是:As described earlier, a new activity is, by default, launched into the task of the activity that calledstartActivity(). It's pushed onto the same stack as the caller. However, if the Intent object passed tostartActivity()contains theFLAG_ACTIVITY_NEW_TASKflag, the system looks for a different task to house the new activity. Often, as the name of the flag implies, it's a new task. However, it doesn't have to be. If there's already an existing task with the same affinity as the new activity, the activity is launched into that task. If not, it begins a new task. 注意:在使用FLAG_ACTIVITY_NEW_TASK属性(singleTask和singleInstance类似)时,无法回退到调用者。 activity在task中加载方式主要有四种: 1.standard(the default mode):一个intent发过来之后,都会产生一个新的activity来响应这个intent; 2.singleTop:保持stack顶端的那个activity.也就是说,如果一个intent是由stack顶端的activity处理的话,将不会新建一个新的activity来处理,而是由原来的那个activity处理; 3.singleTask:对于这个activity则会新建一个task.也就是说,对于这个activity,会分配一个新的affinity; 4.singleInstance:identical to "singleTask",并保证这个activity唯一. 既然对初始加载的过程有所规定,那么也就很自然地会有结束过程的一些方式: acitivity在退出的时候,必然会影响到task的stack,因此,android对acitivity的行为方式也做了规定. 1.alwaysRetainTaskState属性.保证stack不变.默认状态下,一个task长期不活动的话,会退化到root activity,也就是弹出stack,只保留底部的一个acitivity. 2.clearTaskOnLaunch属性.这个会在acitivity加载的时候清空task的stack. 3.finishOnTaskLaunch属性.某种程度上说这个属性保证了某项task是唯一的.因为当一个同类的task加载的时候,如果此属性为true,那么就会先退出之前的task,然后再加载这个task. 如果FLAG_ACTIVITY_CLEAR_TOP属性为真,则结束activity时,所有处于该activity堆栈之上的activity都会同时清除,FLAG_ACTIVITY_CLEAR_TOP is most often used in conjunction with FLAG_ACTIVITY_NEW_TASK. When used together, these flags are a way of locating an existing activity in another task and putting it in a position where it can respond to the intent. 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2009/12/30/1636377.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Seedance 2.0 全面开放 API 服务

火山引擎宣布正式上线 Seedance 2.0系列 API 服务,企业和个人用户现在可以调用其视频生成能力,重塑工作流、探索全新的产品形态和应用场景。 Seedance 2.0支持文字、图片、音频、视频四种模态输入。在复杂交互和运动场景下的可用率更高,物理准确度、逼真度、可控性显著增强,更加贴合工业级创作场景的需求。 火山引擎方面表示,其还为 Seedance 2.0 建立了肖像与版权安全标准,覆盖视频生成涉及的各种模态和创作前后的全部流程。 并围绕安全创作,为企业和个人用户提供一系列配套能力。例如:用户可通过火山方舟控制台便捷地完成人脸验证与肖像授权,授权后即可将该形象用于创作,兼顾效率与合规;火山方舟预置超过1万个高质量虚拟人像,涵盖不同年龄、职业等虚拟人物特征,用户可直接用于视频创作,进一步丰富创作选择。 更多详情可查看API 调用官方文档。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册