首页 文章 精选 留言 我的

精选列表

搜索[工具集],共10013篇文章
优秀的个人博客,低调大师

Hadoop 2.6.0集群搭建

yum install gcc yum install gcc-c++ yum install make yum install autoconfautomake libtool cmake yum install ncurses-devel yum install openssl-devel groupadd hadoop 添加一个组 useradd hadoop -g hadoop 添加用户 安装protoc(需用root用户) 1 tar -xvf protobuf-2.5.0.tar.bz2 2 cd protobuf-2.5.0 3 ./configure --prefix=/opt/protoc/ 4 make && make install 编译hadoop mvn clean package -Pdist,native -DskipTests -Dtar 编译完的hadoop在 /home/hadoop/ocdc/hadoop-2.6.0-src/hadoop-dist/target 路径下 配置hosts文件 10.1.245.244 master 10.1.245.243 slave1 命令行输入 hostname master 免密码登录: 执行命令生成密钥: ssh-keygen -t rsa -P "" 进入文件夹cd .ssh (进入文件夹后可以执行ls -a 查看文件) 将生成的公钥id_rsa.pub 内容追加到authorized_keys(执行命令:cat id_rsa.pub >> authorized_keys) ---------------------------(core-site.xml)------------------------------ <configuration> <!--指定hdfs的nameservice为ns1--> <property> <name>fs.defaultFS</name> <value>hdfs://master</value> </property> <property> <name>io.file.buffer.size</name> <value>131072</value> </property> <!--指定hadoop数据存放目录--> <property> <name>hadoop.tmp.dir</name> <value>/home/hadoop/ocdc/hadoop-2.6.0/tmp</value> <description>Abasefor other temporary directories.</description> </property> <property> <name>hadoop.proxyuser.spark.hosts</name> <value>*</value> </property> <property> <name>hadoop.proxyuser.spark.groups</name> <value>*</value> </property> </configuration> <!--指定zookeeper地址--> <property> <name>ha.zookeeper.quorum</name> <value>h4:2181,h5:2181,h6:2181</value> </property> </configuration> -------------------------------(hdfs-site.xml )----------------------------------- <configuration> <property> <name>dfs.namenode.secondary.http-address</name> <value>master:9001</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>/home/hadoop/ocdc/hadoop-2.6.0/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>/home/hadoop/ocdc/hadoop-2.6.0/data</value> </property> <property> <name>dfs.replication</name> <value>3</value> </property> <property> <name>dfs.webhdfs.enabled</name> <value>true</value> </property> <property> <name>dfs.nameservices</name> <value>ns1</value> </property> <!-- ns1下面有两个NameNode,分别是nn1,nn2 --> <property> <name>dfs.ha.namenodes.ns1</name> <value>nn1,nn2</value> </property> </configuration> ----------------------------------------(yarn-site.xml)-------------------------- <configuration> <!-- Site specific YARN configuration properties --> <!--指定nodemanager启动时加载server的方式为shuffle server --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name> <value>org.apache.hadoop.mapred.ShuffleHandler</value> </property> <property> <name>yarn.resourcemanager.address</name> <value>master:8032</value> </property> <property> <name>yarn.resourcemanager.scheduler.address</name> <value>master:8030</value> </property> <property> <name>yarn.resourcemanager.resource-tracker.address</name> <value>master:8035</value> </property> <property> <name>yarn.resourcemanager.admin.address</name> <value>master:8033</value> </property> <property> <name>yarn.resourcemanager.webapp.address</name> <value>master:8088</value> </property> <property> <name>yarn.nodemanager.resource.memory-mb</name> <value>16384</value> </property> </configuration> <!--指定resourcemanager地址--> <property> <name>yarn.resourcemanager.hostname</name> <value>h3</value> </property> -----------------------------(mapred-site.xml)------------------------------- <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapreduce.jobhistory.address</name> <value>master:10020</value> </property> <property> <name>mapreduce.jobhistory.webapp.address</name> <value>master:19888</value> </property> <property> <name>yarn.scheduler.maximum-allocation-mb</name> <value>16384</value> </property> </configuration>

优秀的个人博客,低调大师

大数据“云”集,河北如何掘金

阿里张北云数据中心项目施工现场。 河北大数据交易中心、廊坊市大数据应用服务中心……近日,我省多个大数据类项目签约。在京畿之地,大数据产业正在加速聚集。河北,似乎已经站在了大数据产业发展的“风口”。 不过,业内人士认为,唯有突破产业布局、数据应用及数据资产化等关键问题,“风口”之上的河北大数据产业,才能实现顺利起飞。 大数据存储——产业布局应科学规划 除了摇滚音乐节,张家口市张北县今后又多了一个新名片——云计算产业基地。目前,多家互联网企业正把他们的数据中心建到张北云计算基地。这些企业中,有阿里巴巴、赛尔,将来还可能有微软、惠普。如果成功,这里将建成规模为50万台服务器的跨国云端数据中心,而这也将成为全球最大的云端数据中心。 不只是张北,目前大数据产业已在我省多地竞相开花。不久前,京东集团和廊坊市签约,计划投资395亿元,共建北方大数据中心项目。浪潮集团也与廊坊市签约,计划投资15亿元,就数据存储、云服务等展开合作。此前,中国电子信息产业集团、戴尔、浪潮等20多家企业已与承德签约,一批项目相继运营。 在顶层设计上,北京市提出的“京津冀大数据走廊”构想正成为推动京津冀产业转型升级的新引擎。根据规划,三地将重点支持中关村企业在北京布局研发中心,在天津建设大数据、云计算、物联网等设备生产基地,在河北廊坊、承德、张家口等地建设大体量数据中心和电子商务等产业大数据规模化应用服务项目。 京津冀地区拥有庞大的数据体量,是中国大数据资源和产业最集中区域之一,集中了全国70%至80%的数据流量。因土地、存储空间、电力、水资源等限制,国家部委、央企总部等机构的数据中心外溢需求增大,为我省张家口、承德、廊坊等地带来承接契机。 但省工信厅相关负责人表示,目前我省的大数据产业还存在着一哄而上、同质化严重等问题。“北京周围的几个设区市,比如廊坊、承德、张家口、秦皇岛等地都提出要大力发展大数据存储中心。但事实上,市场真正需要多少存储中心,许多地方政府和企业并没有一个清晰的概念。”这位负责人表示。 相关专家认为,我省应从省级层面加强大数据中心规划,在规模控制、产业布局上形成科学合理的大数据存储中心网络。 大数据应用——数据应用和产业化水平需提升 大数据里有商机,这正是大数据的魅力所在。对此,近日来我省洽谈项目的安徽容知日新信息技术公司高级工程师高军深有感触。 通过物联网技术获取海量装备运行数据,容知日新公司能够运用云平台技术对数据进行实时筛选和分析,利用远程诊断技术甄别设备故障,预测部件寿命,实现工业装备安全检测和预测维修服务。 “河北是工业大省,钢铁、水泥、发电等产业发达,这正是我们所服务的领域。据预测,光是依托大数据的设备信息化产业,河北省每年就能产生上百亿元的产值。”高军告诉记者,公司正在河北与河钢邯钢、河钢石钢等洽谈相关项目。 不过高军也坦言,在这个领域,河北省的企业还在缺席。 “形象地说,好多行业是‘守着金山讨饭吃’。”河北省北方电子商务研究院院长宋雷表示,我省对数据资源整合能力和获取能力普遍不足,目前产业界积累了大量的数据资产,但是由于我省数据观念不强、应用产业不发达,使得大量的数据“闲置沉睡”,不能创造出社会和商业价值。 业内人士表示,发展大数据产业,硬件只是躯壳,软件服务才是灵魂。只有提升数据应用和产业化水平,河北的大数据产业链才能实现真正腾飞。 相关专家建议,贵州打造“云上贵州”,浙江建设“政务超市”的做法具有借鉴意义,河北应发挥自身在食品药品监管、交通等方面的优势,集中资金、人才打造一个明星项目,从而以点带面,使河北相关产业取得更大的突破。 大数据交易——京津冀三地资源待盘活 2015年12月3日,河北大数据交易中心在北京中关村宣布启动。承德市政府与北京数海集团共同投资2亿元,将该中心打造成全国第一家数据资产证券化服务机构、华北地区首家数据资产交易平台。 据估算,随着河北京津冀大数据交易中心启动,京津冀区域五年内能建成全国最大的大数据交易市场,总交易规模超过千亿元。 长久以来,市场上存在着不同程度的数据交易活动,但受到交易要素不健全的制约和供需信息不对称等因素的影响,大量的数据交易活动范围仍很有限,包括交易量和交易范围等。这些都影响着我省的大数据产业发展。 数海集团创始人、河北大数据交易中心董事长秦翯认为,唯有京津冀三地打通数据交易的信息平台、披露平台,才有可能进一步加速河北大数据资源变资产的过程。 据悉,河北大数据交易中心主要从事数据资产登记、数据资产托管管理、数据商品交易等业务。它的成立,将打破行业间数据共享的壁垒,盘活京津冀地区的数据资源,实现数据资产的有效利用,并与全国第一家数据交易平台“中关村数海大数据交易平台”实现对接,打通京津冀大数据走廊。 尽管如此,互联网领域分析师许强仍认为,京津冀三地围绕大数据的产业效应还须强化。例如,三地间大数据不仅要实现自由流动、资产赋值确权,更要让数据资产在区域内实现均等的可评估、可抵押,以此解决大数据企业的融资难题。 链接 各地“掘金”未来大数据 承德:打造“大数据谷” 根据规划,承德将以承德高新区大数据产业城为核心,建设面向全国、服务京津冀的“大数据谷”,力争到2020年,实现大数据产业总产值500亿元。 廊坊:发展大数据交易中心 按照目标,到2017年廊坊力争引进100家机构,吸纳5万人就业,创造100亿-500亿元产值,发展成为国内领先的大数据交易中心。 张家口:产业规模将破1000亿元 根据规划,张家口将在张北建设云计算产业基地,总体目标是到2020年数据中心规模达到150万台服务器,支撑“9+N”云应用服务平台建设,基地入驻企业200家以上,相关产业规模突破1000亿元。 本文转自d1net(转载)

优秀的个人博客,低调大师

storm0.9.5集群安装

安装前的准备工作 关闭防火墙 chkconfig iptables off && setenforce 0 创建用户 groupadd realtime && useradd realtime && usermod -a -G realtime realtime 创建工作目录并赋权 mkdir /export mkdir /export/servers chmod 755 -R /export 切换到realtime用户下 su realtime 1、安装一个zookeeper集群,并启动zookeeper集群。 2、上传storm的安装包,解压 3、修改storm配置文件storm.yaml 必填配置 #所使用的zookeeper集群主机的ip地址 storm.zookeeper.servers: - "weekend01" - "weekend02" - "weekend03" #storm中nimbus所在的主机名 nimbus.host: "weekend04" 可选配置 #指定一个supervisor上可以启动几个work进程,每个进程占用一个端口,如果不配置默认是4个work进程。 supervisor.slots.ports -6701 -6702 -6703 -6704 -6705 #指定nimbus启动JVM最大可用内存大小 nimbus.childopts:"-Xmx1024m" #指定supervisor启动JVM最大可用内存大小 supervisor.childopts:"-Xmx1024m" #指定supervisor节点上,每一个worker启动JVM最大可用内存大小 worker.childopts:"-Xmx1024m" #指定ui启动JVM最大可用内存大小,ui服务一般与nimbus同在一个节点上 ui.childopts:"-Xmx1024m" 等等.... 新浪微博:intsmaze刘洋洋哥 启动storm 在storm/bin目录下 先在nimbus主机上启动nimbus ./storm nimbus ./storm ui 这样启动如果关闭会话窗口nimbus服务就会关闭。 输入下面命令,让nimbus在后台进程;运行。 nohup ./storm nimbus 1>/dev/null 2>&1 & 可以通过打印台看到其实就是执行该命令,启动一个java类:Running: /export/servers/jdk/bin/java -server backtype.storm.daemon.nimbus nohup ./storm ui 1>/dev/null 2>&1 & 在supervisor主机上 nohup ./storm supervisor 1>/dev/null 2>&1 & Running: /export/servers/jdk/bin/java -server backtype.storm.daemon.supervisor 启动./storm ui后,就可以访问图形界面了。 访问nimbus.host:/8080,即可看到storm的ui界面。 4、Storm常用操作命令 有许多简单且有用的命令可以用来管理拓扑,它们可以提交、杀死、禁用、再平衡拓扑。 提交任务命令格式:storm jar 【jar路径】 【拓扑包名.拓扑类名】 【拓扑名称】 bin/storm jar examples/storm-starter/storm-starter-topologies-0.10.0.jar storm.starter.WordCountTopology wordcount 杀死任务命令格式:storm kill 【拓扑名称】 -w 10(执行kill命令时可以通过-w [等待秒数]指定拓扑停用以后的等待时间) storm kill topology-name -w 10 停用任务命令格式:storm deactivte 【拓扑名称】 storm deactivte topology-name 我们能够挂起或停用运行中的拓扑。当停用拓扑时,所有已分发的元组都会得到处理,但是spouts的nextTuple方法不会被调用。销毁一个拓扑,可以使用kill命令。它会以一种安全的方式销毁一个拓扑,首先停用拓扑,在等待拓扑消息的时间段内允许拓扑完成当前的数据流。 启用任务命令格式:storm activate【拓扑名称】 storm activate topology-name 重新部署任务命令格式:storm rebalance 【拓扑名称】 storm rebalance topology-name再平衡使你重分配集群任务。这是个很强大的命令。比如,你向一个运行中的集群增加了节点。再平衡命令将会停用拓扑,然后在相应超时时间之后重分配工人,并重启拓扑。 5、Storm集群的进程及日志熟悉 5.1、查看nimbus的日志信息 在nimbus的服务器上cd /export/servers/storm/logstail -100f /export/servers/storm/logs/nimbus.log 5.2、查看ui运行日志信息 在ui的服务器上,一般和nimbus一个服务器cd /export/servers/storm/logstail -100f /export/servers/storm/logs/ui.log 5.3、查看supervisor运行日志信息 在supervisor服务上cd /export/servers/storm/logstail -100f /export/servers/storm/logs/supervisor.log 5.4、查看supervisor上worker运行日志信息 在supervisor服务上cd /export/servers/storm/logstail -100f /export/servers/storm/logs/worker-6702.log 作者: intsmaze(刘洋) 出处: http://www.cnblogs.com/intsmaze/ 老铁,你的--->推荐,--->关注,--->评论--->是我继续写作的动力。 微信公众号号:Apache技术研究院 由于博主能力有限,文中可能存在描述不正确,欢迎指正、补充! 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

搭建hadoop1.2集群

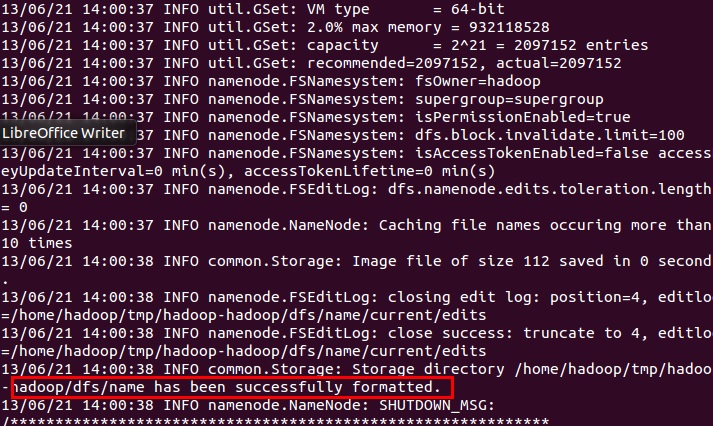
环境准备 我使用的是vmware workstation,首先安装ubuntu 12.04,安装完成后通过vmware的clone,clone出两个虚机,设置的IP分别是: 192.168.74.130 master 192.168.74.132 node1 192.168.74.133 node2 然后修改各个主机的/etc/hosts中的内容。 使用vi或者gedit,将上边的内容编缉进去。 创建用户 先创建hadoop用户组: sudo addgroup hadoop 然后创建用户hadoop: sudo adduser -ingroup hadoop hadoop 注:在centos 和 redhat下直接创建用户就行,会自动生成相关的用户组和相关文件,而ubuntu下直接创建用户,创建的用户没有根目录。 给hadoop用户添加权限,打开/etc/sudoers文件; sudo gedit /etc/sudoers 按回车键后就会打开/etc/sudoers文件了,给hadoop用户赋予root用户同样的权限。 在root ALL=(ALL:ALL) ALL下添加hadoop ALL=(ALL:ALL) ALL, hadoop ALL=(ALL:ALL) ALL 为本机(master)和子节点(node..)安装JDK环境。 其实网上挺多的,参考http://blog.csdn.net/klov001/article/details/8075237,这里不详细描述了。 修改本机(master)和子节点(node..)机器名 打开/etc/hostname文件; sudo gedit /etc/hostname 分别改为master、node1和node2。 本机(master)和子节点(son..)安装ssh服务 主要为ubuntu安装,cents和redhat系统自带。 ubuntu下: sudo apt-get install ssh openssh-server 建立ssh无密码登录环境 做这一步之前首先建议所有的机子全部转换为hadoop用户,以防出现权限问题的干扰。 ssh生成密钥有rsa和dsa两种生成方式,默认情况下采用rsa方式。 创建ssh-key,这里我们采用rsa方式; ssh-keygen -t rsa -P "" (注:回车后会在~/.ssh/下生成两个文件:id_rsa和id_rsa.pub这两个文件是成对出现的) 进入~/.ssh/目录下,将id_rsa.pub追加到authorized_keys授权文件中,开始是没有authorized_keys文件的; cd ~/.ssh cat id_rsa.pub >> authorized_keys 可以使用ssh 主机名测试一下是否成功。 为mater安装hadoop 在hadoop用户下建立hadoop文件夹,然后将hadoop-1.2.0.tar.gz上传到这个目录下。 tar -zxvf hadoop-1.2.0.tar.gz 解压缩。然后到hadoop目录下conf下找到hadoop-env.sh 配置JAVA_HOME为你上面配置的JAVA_HOME。 找到core-site.xml,配置信息如下: <configuration> <property> <name>hadoop.tmp.dir</name> <value>/home/hadoop/tmp/hadoop-${user.name}</value> <description>A base for other temporarydirectories.</description> </property> <property> <name>fs.default.name</name> <value>hdfs://master:9000</value> <description>The name of the default file system. A URI whose scheme and authority determine the FileSystem implementation. The uri's scheme determines the config property (fs.SCHEME.impl) naming the FileSystem implementation class. The uri's authority is used to determine the host, port, etc. for a filesystem. </description> </property> </configuration> 修改hdfs-site.xml: <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>dfs.replication</name> <value>2</value> <description>Default block replication. The actual number of replications can be specified when the file iscreated. The default is used if replication is not specified in create time. </description> </property> </configuration> 修改mapred-site.xml: <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>mapred.job.tracker</name> <value>master:9001</value> <description>The host and port that the MapReduce job trackerruns at. If "local", then jobs are run in-process as a singlemap and reduce task. </description> </property> </configuration> 修改masters: master 修改slaves: node1 node2 启动hadoop 在master主机上的hadoop安装目录下的bin目录下,执行格式化 ./hadoop namenode -format 正常情况下会出现如下提示: 说明格式化成功。 启动所有结点: ./start-all.sh 会按先后顺序启动,启动完成后,分别到主机和两个node上使用jps查看。 master上显示如下: node1和node2上显示: 在操作的过程中遇到了DataNode不能启动的问题,经过查看node1的hadoop的日志,发现提示错误信息: org.apache.hadoop.hdfs.server.datanode.DataNode: All directories in dfs.data.dir are invalid. 经过查找是因为权限的问题,于是 sudo chmod 755 “你配置的data目录” 问题解决。 运行示例 在根目录下新建文件a,并且向a中随意添加字符串信息。 然后在hdfs上创建目录: ./hadoop dfs -mkdir test1 把刚才创建的文件a上传到test1下: ./hadoop dfs -put ~/a test1 然后查看文件中的内容: ./hadoop dfs -cat test1/a 显示结果如下:

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册