首页 文章 精选 留言 我的

精选列表

搜索[古德哈特定律],共4304篇文章
优秀的个人博客,低调大师

ELK收集nginx日志并用高德地图展示出IP

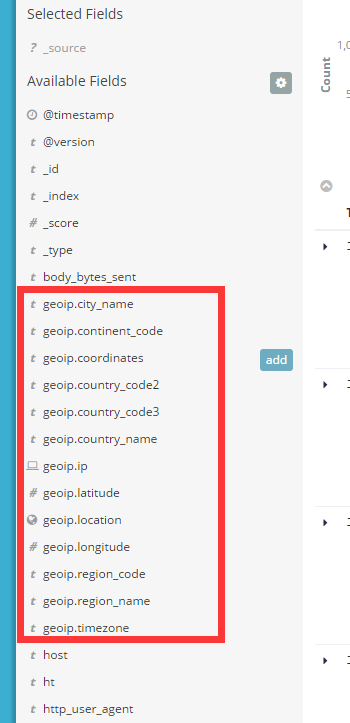
(一)测试的环境 agentd:192.168.180.22 ES:192.168.180.23 kibana:192.168.180.23 采用的拓扑:logstash -->ES-->kibana (二)实施步骤: (1)logstsh具体配置: 1,配置nginx日志格式,采用log_format格式: 1 2 3 log_formatmain '$remote_addr-$remote_user[$time_local]"$request"' '$status$body_bytes_sent"$http_referer"' '"$http_user_agent""$http_x_forwarded_for"' ; 2,在logstash服务器下载IP地址归类查询库 1 2 3 [root@localhostconfig] #cd/usr/local/logstash/config/ [root@localhostconfig] #wgethttp://geolite.maxmind.com/download/geoip/database/GeoLite2-City.mmdb. gz 3,配置logstash客户端 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 [root@localhostconfig] #vim/usr/local/logstash/config/nginx-access.conf input{ file { path=> "/opt/access.log" type => "nginx" start_position=> "beginning" } } filter{ grok{ match=>{ "message" =>"%{IPORHOST:remote_addr}--\[%{HTTPDATE:time_local}\]\"%{WO RD:method}%{URIPATHPARAM:request}HTTP/%{NUMBER:httpversion}\"%{INT:status}%{INT:body_bytes_sent}% {QS:http_referer}%{QS:http_user_agent}" } } geoip{ source => "remote_addr" target=> "geoip" database=> "/usr/local/logstash/config/GeoLite2-City.mmdb" add_field=>[ "[geoip][coordinates]" , "%{[geoip][longitude]}" ] add_field=>[ "[geoip][coordinates]" , "%{[geoip][latitude]}" ] } } output{ elasticsearch{ hosts=>[ "192.168.180.23:9200" ] manage_template=> true index=> "logstash-map-%{+YYYY-MM}" } } 备注: geoip: IP查询插件 source: 需要通过geoip插件处理的field,一般为ip,这里因为通过控制台手动输入的是ip所以直接填message,生成环境中如果查询nginx访问用户,需先将客户端ip过滤出来,然后这里填remote_addr即可 target: 解析后的Geoip地址数据,应该存放在哪一个字段中,默认是geoip这个字段 database: 指定下载的数据库文件 add_field: 这里两行是添加经纬度,地图中地区显示是根据经纬度来识 。如果启动正常的话,可以在kibana看到geoip相关的字段,如下图: 3,启动logstash客户端并加载刚才的配置文件。 1 2 3 4 5 6 7 8 9 10 11 12 [root@localhostconfig] #/usr/local/logstash/bin/logstash-fnginx-access.conf SendingLogstash'slogsto /usr/local/logstash/logs which isnowconfiguredvialog4j2.properties [2017-06-20T22:55:23,801][INFO][logstash.outputs.elasticsearch]ElasticsearchpoolURLsupdated{:changes=>{:removed=>[],:added=>[http: //192 .168.180.23:9200/]}} [2017-06-20T22:55:23,805][INFO][logstash.outputs.elasticsearch]Runninghealthchecktosee if anElasticsearchconnectionisworking{:healthcheck_url=>http: //192 .168.180.23:9200/,:path=> "/" } [2017-06-20T22:55:23,901][WARN][logstash.outputs.elasticsearch]RestoredconnectiontoESinstance{:url=> #<URI::HTTP:0x4e54594dURL:http://192.168.180.23:9200/>} [2017-06-20T22:55:23,909][INFO][logstash.outputs.elasticsearch]Usingmappingtemplatefrom{:path=>nil} [2017-06-20T22:55:23,947][INFO][logstash.outputs.elasticsearch]Attemptingto install template{:manage_template=>{ "template" => "logstash-*" , "version" =>50001, "settings" =>{ "index.refresh_interval" => "5s" }, "mappings" =>{ "_default_" =>{ "_all" =>{ "enabled" => true , "norms" => false }, "dynamic_templates" =>[{ "message_field" =>{ "path_match" => "message" , "match_mapping_type" => "string" , "mapping" =>{ "type" => "text" , "norms" => false }}},{ "string_fields" =>{ "match" => "*" , "match_mapping_type" => "string" , "mapping" =>{ "type" => "text" , "norms" => false , "fields" =>{ "keyword" =>{ "type" => "keyword" }}}}}], "properties" =>{ "@timestamp" =>{ "type" => "date" , "include_in_all" => false }, "@version" =>{ "type" => "keyword" , "include_in_all" => false }, "geoip" =>{ "dynamic" => true , "properties" =>{ "ip" =>{ "type" => "ip" }, "location" =>{ "type" => "geo_point" }, "latitude" =>{ "type" => "half_float" }, "longitude" =>{ "type" => "half_float" }}}}}}}} [2017-06-20T22:55:23,955][INFO][logstash.outputs.elasticsearch]NewElasticsearchoutput{:class=> "LogStash::Outputs::ElasticSearch" ,:hosts=>[ #<URI::Generic:0x1e098115URL://192.168.180.23:9200>]} [2017-06-20T22:55:24,065][INFO][logstash.filters.geoip]Usinggeoipdatabase{:path=> "/usr/local/logstash/config/GeoLite2-City.mmdb" } [2017-06-20T22:55:24,094][INFO][logstash.pipeline]Startingpipeline{ "id" => "main" , "pipeline.workers" =>4, "pipeline.batch.size" =>125, "pipeline.batch.delay" =>5, "pipeline.max_inflight" =>500} [2017-06-20T22:55:24,275][INFO][logstash.pipeline]Pipelinemainstarted [2017-06-20T22:55:24,369][INFO][logstash.agent]SuccessfullystartedLogstashAPIendpoint{:port=>9600} (2)Kibana配置. 1,编辑修改kibana的配置文件kibana.yml在最后添加如下: 1 2 3 4 5 6 #Thedefaultlocale.Thislocalecanbeusedincertaincircumstancestosubstituteanymissing #translations. #i18n.defaultLocale:"en" tilemap.url:'http: //webrd02 .is.autonavi.com /appmaptile ?lang=zh_cn&size=1&scale=1&style=7&x={x}&y={y}& z={z}' 2,重启kibana服务。 1 2 3 4 5 6 7 8 9 10 11 12 13 [root@localhostbin] #/usr/local/kibana/bin/kibana& [1]10631 [root@localhostbin] #ps-ef|grepkibana root1063177952110:52pts /0 00:00:02 /usr/local/kibana/bin/ .. /node/bin/node --no-warnings /usr/local/kibana/bin/ .. /src/cli root106437795010:52pts /0 00:00:00 grep --color=autokibana [root@localhostbin] #log[02:52:59.297][info][status][plugin:kibana@5.4.0]Statuschangedfromuninitializedtogreen-Ready log[02:52:59.445][info][status][plugin:elasticsearch@5.4.0]Statuschangedfromuninitializedtoyellow-Waiting for Elasticsearch log[02:52:59.482][info][status][plugin:console@5.4.0]Statuschangedfromuninitializedtogreen-Ready log[02:52:59.512][info][status][plugin:elasticsearch@5.4.0]Statuschangedfromyellowtogreen-Kibanaindexready log[02:52:59.513][info][status][plugin:metrics@5.4.0]Statuschangedfromuninitializedtogreen-Ready log[02:53:00.075][info][status][plugin:timelion@5.4.0]Statuschangedfromuninitializedtogreen-Ready log[02:53:00.080][info][listening]Serverrunningathttp: //192 .168.180.23:5601 log[02:53:00.081][info][status][uisettings]Statuschangedfromuninitializedtogreen-Ready 3,创建nginx的访问索引lostash-map*。具体步骤如下:ip:5601--->Management--Index Patterns--->+--->在Index name or pattern中添加logstash-map*--->create。具体如下图: 4,创建Visualize。具体步骤如下:Visalize--->+--->Maps(Tile Maps) 本文转自 lqbyz 51CTO博客,原文链接:http://blog.51cto.com/liqingbiao/1940469

优秀的个人博客,低调大师

不讲码德?

随着互联网的发展,业务越来越庞大,客户群体也越来越多,所要存储的数据也越来越多,慢慢的就出现了分库分表的中间件。 比如cobar,TDDL,atlas,sharding-jdbc,mycat等,都是非常优秀的产品,解决了各种问题,但是引入了中间件肯定就会增加各方面的维护成本等 这篇带大家了解一款替代分库分表的解决方案:分布式数据库:TIDB 前言 如今硬件的性价比越来越高,网络传输速度越来越快,数据库分层的趋势逐渐显现,人们已经不再强求用一个解决方案来解决所有的存储问题,而是通过分层,让缓存与数据库负责各自擅长的业务场景。 当前数据库领域面临各种问题,如在缩放、一致性、大数据分析、与云基础架构集成等方面均存在诸多问题,现有的数据库解决方案和大数据分析引擎解决方案基本处于割裂的状态,由于 Oracle、MySQL 数据库并不是面向分布式环境而设计,因此即使勉强通过分库、分表或中间件的方式,在数据库层面做了分片,从本质上看也只是复制了相同的堆栈,而非针对分布式系统进行存储和计算优化,这正是进行跨业务查询或跨物理机查询和写入十分繁琐的本质原因。NoSQL 虽然解决了数据库弹性扩展的难题,但是却放弃了数据的强一致性以及对 ACID 事务的支持,带来了新的问题。 为了解决这一问题,TiDB 在架构上将计算和存储层进行高度的抽象和分离,对混合负载的场景通过 IO 优先级队列,智能副本调度,行列混合存储等技术使其变为可能。 大家可能都没有听过TIDB这款分布式数据库,但是它已经出现很久了,随着不断完善,也受到越来越多的企业喜爱,接下来让我们开始了解TIDB吧! TIDB简介 TIDB是什么? TiDB 是一个分布式 NewSQL 数据库。它支持水平弹性扩展、ACID 事务、标准 SQL、MySQL 语法和 MySQL 协议,具有数据强一致的高可用特性,是一个不仅适合 OLTP 场景还适合OLAP 场景的混合数据库。 TIDB怎么来的? 开源分布式缓存服务 Codis 的作者,PingCAP联合创始人& CTO ,资深 infrastructure 工程师的黄东旭,擅长分布式存储系统的设计与实现,开源狂热分子的技术大神级别人物。即使在互联网如此繁荣的今天,在数据库这片边界模糊且不确定地带,他还在努力寻找确定性的实践方向。 2012 年底,他看到 Google 发布的两篇论文,得到了很大的触动,这两篇论文描述了 Google 内部使用的一个海量关系型数据库 F1/Spanner ,解决了关系型数据库、弹性扩展以及全球分布的问题,并在生产中大规模使用。“如果这个能实现,对数据存储领域来说将是颠覆性的”,黄东旭为完美方案的出现而兴奋, PingCAP 的 TiDB 在此基础上诞生了。 TIDB的架构 TiDB在整体架构基本是参考 Google Spanner 和 F1 的设计,上分两层为TiDB和TiKV。TiDB 对应的是 Google F1, 是一层无状态的 SQL Layer ,兼容绝大多数 MySQL 语法,对外暴露 MySQL 网络协议,负责解析用户的 SQL 语句,生成分布式的 Query Plan,翻译成底层 Key Value 操作发送给 TiKV , TiKV 是真正的存储数据的地方,对应的是 Google Spanner ,是一个分布式 Key Value 数据库,支持弹性水平扩展,自动的灾难恢复和故障转移(高可用),以及 ACID 跨行事务。值得一提的是 TiKV 并不像 HBase 或者 BigTable 那样依赖底层的分布式文件系统,在性能和灵活性上能更好,这个对于在线业务来说是非常重要。 所以一套这样的架构是由这样的3类角色共同组建而成。每个部分的解释如下: 1.TiDB Server TiDB Server 负责接收 SQL 请求,处理 SQL 相关的逻辑,并通过 PD 找到存储计算所需数据的 TiKV 地址,与 TiKV 交互获取数据,最终返回结果。TiDB Server 是无状态的,其本身并不存储数据,只负责计算,可以无限水平扩展,可以通过负载均衡组件(如LVS、HAProxy 或 F5)对外提供统一的接入地址。 2.PD Server Placement Driver (简称 PD) 是整个集群的管理模块,其主要工作有三个:一是存储集群的元信息(某个 Key 存储在哪个 TiKV 节点);二是对 TiKV 集群进行调度和负载均衡(如数据的迁移、Raft group leader 的迁移等);三是分配全局唯一且递增的事务 ID。PD 是一个集群,需要部署奇数个节点,一般线上推荐至少部署 3 个节点。 3.TiKV Server TiKV Server 负责存储数据,从外部看 TiKV 是一个分布式的提供事务的 Key-Value 存储引擎。存储数据的基本单位是 Region,每个 Region 负责存储一个 Key Range (从 StartKey 到 EndKey 的左闭右开区间)的数据,每个 TiKV 节点会负责多个 Region 。TiKV 使用 Raft 协议做复制,保持数据的一致性和容灾。副本以 Region 为单位进行管理,不同节点上的多个 Region 构成一个 Raft Group,互为副本。数据在多个 TiKV 之间的负载均衡由 PD 调度,这里也是以 Region 为单位进行调度。 TIDB五大核心特性 一键水平扩缩容 得益于 TiDB 存储计算分离的架构的设计,可按需对计算、存储分别进行在线扩容或者缩容,扩容或者缩容过程中对应用运维人员透明。 金融级高可用 数据采用多副本存储,数据副本通过 Multi-Raft 协议同步事务日志,多数派写入成功事务才能提交,确保数据强一致性且少数副本发生故障时不影响数据的可用性。可按需配置副本地理位置、副本数量等策略满足不同容灾级别的要求。 实时HTAP 提供行存储引擎 TiKV、列存储引擎 TiFlash 两款存储引擎,TiFlash 通过 Multi-Raft Learner 协议实时从 TiKV 复制数据,确保行存储引擎 TiKV 和列存储引擎 TiFlash 之间的数据强一致。TiKV、TiFlash 可按需部署在不同的机器,解决 HTAP 资源隔离的问题。 云原生的分布式数据库 专为云而设计的分布式数据库,通过TiDB Operator可在公有云、私有云、混合云中实现部署工具化、自动化。 兼容MYSQL5.7 专为云而设计的分布式数据库,通过TiDB Operator可在公有云、私有云、混合云中实现部署工具化、自动化。 TIDB四大核心应用场景 HTAP 给开发者提供了一个实时数据分析方面的新思路,不需要再去维护另一个离线的数据仓库,既减轻了 ETL 的工作,又能节省很大一部分建立数据仓库所用到的存储和计算成本,HTAP 将是未来的重要趋势。 黄东旭介绍了 TiDB 的四个主要应用场景,一是 MySQL 分片与合并;二是直接替换 MySQL;三是用做数据仓库;四是作为其他系统的一个模块。 MySQL分片与合并 Syncer: TiDB 应用的第一类场景是 MySQL 的分片与合并。对于已经在用 MySQL 的业务,分库、分表、分片、中间件是常用手段,随着分片的增多,跨分片查询是一大难题。TiDB 在业务层兼容 MySQL 的访问协议,PingCAP 做了一个数据同步的工具——Syncer,它可以把 TiDB 作为一个 MySQL Slave,将 TiDB 作为现有数据库的从库接在主 MySQL 库的后方,在这一层将数据打通,可以直接进行复杂的跨库、跨表、跨业务的实时 SQL 查询。黄东旭提到,过去的数据库都是一主多从,有了 TiDB 以后,可以反过来做到多主一从。 替换MySQL 第二类场景是用 TiDB 直接去替换 MySQL。如果你的IT架构在搭建之初并未考虑分库分表的问题,全部用了 MySQL,随着业务的快速增长,海量高并发的 OLTP 场景越来越多,如何解决架构上的弊端呢? 在一个 TiDB 的数据库上,所有业务场景不需要做分库分表,所有的分布式工作都由数据库层完成。TiDB 兼容 MySQL 协议,所以可以直接替换 MySQL,而且基本做到了开箱即用,完全不用担心传统分库分表方案带来繁重的工作负担和复杂的维护成本,友好的用户界面让常规的技术人员可以高效地进行维护和管理。另外,TiDB 具有 NoSQL 类似的扩容能力,在数据量和访问流量持续增长的情况下能够通过水平扩容提高系统的业务支撑能力,并且响应延迟稳定。 黄东旭在演讲中提到了摩拜单车的案例,摩拜早期的数据库全部用 MySQL,随着业务的快速增长,MySQL 的弊端逐渐显现,摩拜单车于 2017 年初开始使用 TiDB 替换 MySQL。如今,摩拜的 IT 系统中已部署了数套 TiDB 集群,近百个节点,承载着数十 TB 的各类数据。 数据仓库 TiDB 本身是一个分布式系统,第三种使用场景是将 TiDB 当作数据仓库使用。TPC-H 是数据分析领域的一个测试集,TiDB 2.0 在 OLAP 场景下的性能有了大幅提升,原来只能在数据仓库里面跑的一些复杂的 Query,在 TiDB 2.0 里面跑,时间基本都能控制在 10 秒以内。当然,因为 OLAP 的范畴非常大,TiDB 的 SQL 也有搞不定的情况,为此 PingCAP 开源了 TiSpark,TiSpark 是一个 Spark 插件,用户可以直接用 Spark SQL 实时地在 TiKV 上做大数据分析。 作为其他系统的模块 TiDB 是一个传统的存储跟计算分离的项目,其底层的 Key-Value 层,可以单独作为一个 HBase 的 Replacement 来用,它同时支持跨行事务。TiDB 对外提供两个 API 接口,一个是 ACID Transaction 的 API,用于支持跨行事务;另一个是 Raw API,它可以做单行的事务,换来的是整个性能的提升,但不提供跨行事务的 ACID 支持。用户可以根据自身的需求在两个 API 之间自行选择。例如有一些用户直接在 TiKV 之上实现了 Redis 协议,将 TiKV 替换一些大容量,对延迟要求不高的 Redis 场景。 与MySQL兼容性对比 TiDB 支持包括跨行事务,JOIN 及子查询在内的绝大多数 MySQL 的语法,用户可以直接使用现有的 MySQL 客户端连接。如果现有的业务已经基于 MySQL 开发,大多数情况不需要修改代码即可直接替换单机的 MySQL。 包括现有的大多数 MySQL 运维工具(如 PHPMyAdmin, Navicat, MySQL Workbench 等),以及备份恢复工具(如 mysqldump, mydumper/myloader)等都可以直接使用。 不过一些特性由于在分布式环境下没法很好的实现,目前暂时不支持或者是表现与 MySQL 有差异。 一些 MySQL 语法在 TiDB 中可以解析通过,但是不会做任何后续的处理,例如 Create Table 语句中 Engine 以及 Partition 选项,都是解析并忽略。 不支持的特性有以下这些: 存储过程,视图,触发器,自定义函数,外键约束,全文索引,空间索引,非 UTF8 字符集等 总结 本文带你了解了TIDB这款分布式数据库,它的特性,应用场景以及与MySQl的兼容性对比,下篇将会介绍TIDB的部署搭建,计算,存储,调度方面的知识! 假如面试中你被问到这些,我相信你看了这篇一定能拨动面试官的心! 本文分享自微信公众号 - 悟空聊架构(PassJava666)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

码德需求?这不就是产品给我留的数学作业!

作者:小傅哥 博客:https://bugstack.cn ❝ 沉淀、分享、成长,让自己和他人都能有所收获!😜 ❞ 目录 一、前言 二、代码就是对数学逻辑的具体实现 三、得物(毒) 8位随机抽奖码设计 1. 需求描述 2. 实现方案 四、总结 五、系列推荐 一、前言 图 15-1 写好代码的核心 为什么你的代码一坨坨?其实来自你有那么多为什么你要这样写代码! 为什么你的代码那么多for循环?因为没有合理的数据结构和算法逻辑。 为什么你的代码那么多ifelse?因为缺少设计模式对业务场景的运用。 为什么你的程序应用复杂对接困难?因为没有良好的系统架构拆分和规划。 为什么你的程序逻辑开发交付慢返工多?因为不具备某些业务场景的开发经验。 为什么你的程序展现都是看上去不说人话?因为没有产品思维都是程序员逻辑的体现。 「最终」,所有的这些不合理交织在一起,就是你能看到的一坨坨的代码!「所以」,要想把代码写好、写美,写到自己愿意反复欣赏,那么基本需要你有一定的:基础能力(数据结构、算法逻辑、设计模式)、应用能力(系统架构、开发经验)、拓展能力(产品思维),这三方面综合起来才能更好的开发程序。 但可能杠精会喊,我就写个CRUD要什么逻辑、什么数据结构,还算法? 但写CRUD并不一定业务需求是CRUD,只是你的知识面和技术深度只能把它设计成CRUD,用ifelse和for循环在一个类里反复粘贴复制罢了。 可能同样的需求交给别人手里,就会想的更多搭建的更加完善。就像:树上10只鸟开一枪还剩下几只,你会想到什么?比如: 手抢是无声的吗? 枪声大吗? 这个城市打鸟犯不犯法? 确定那只鸟被打死了? 树上的鸟有没有聋子? 有没有被关在笼子里或者绑在树上的鸟? 旁边还有其他树吗? 有残疾或者飞不动的鸟吗? 有怀孕肚子里的鸟吗? 打鸟的人眼睛花没花? 保证是10只吗? 有没有那种不怕死的鸟? 会不会一枪打死两只或者更多? 所有的鸟都可以自由活动飞离树以外吗? 打死以后挂在树上还是掉下来了? 所以,你还相信写程序只是简简单单的搞CRUD吗?接下来小傅哥再带着你搞几个例子看一看! 二、代码就是对数学逻辑的具体实现 数据结构:数组、链表、红黑树 算法逻辑:哈希、扰动函数、负载因子、拉链寻址、 其实我们所开发的业务程序,哪怕是CRUD也都是对数学逻辑的具体实现过程。只不过简单的业务有简单的数学逻辑、复杂的业务有复杂的数学逻辑。数学逻辑是对数据结构的使用,(例如:把大象装进冰箱分几步)合理的数据的结构有利于数据逻辑的实现和复杂程度。 在我们常用的API中,HashMap 就是一个非常好的例子,既有非常好的数据结构的使用,也有强大的数学逻辑的实现。为此也让 HashMap 成为开发过程中非常常用的API,当然也成为面试过程中最常问的技术点。 图 15-2 HashMap中的数据结构和数学逻辑 「重点」,HashMap 中涉及的知识点非常多,包括数据结构的使用、数组、链表、红黑树,也包括算法逻辑的实现:哈希、扰动函数、负载因子、拉链寻址等等。而这些知识如果可以深入的搞清楚,是完全不需要死记硬背的,也不需要为了面试造火箭。就像如下问题: HashMap 怎么来的?因为有非常多业务开发中需要key、value的形式存放获取数据。 为什么要用哈希计算下标呢?因为哈希值求计算出的 key 具有低碰撞性。 为什么还要加扰动函数呀?因为扰动函数可以让数据散列的均匀,如果HashMap中的数据都碰撞成短链表,就会大大降低HashMap的索引性能。 为什么会有链表呢?因为无论如何都有会有节点碰撞的可能,碰撞后HashMap选择拉链寻址的方式存放数据。当然在 ThreadLocal 中采用的是斐波那契(Fibonacci)散列+开放寻址,感兴趣也可以看看。 为什么链表会转换树呢?因为时间复杂度问题,链表的时间复杂度是O(n),越长越慢。 为什么树是红黑树呢?红黑树具有平衡性,也就是黑色节点是平衡的,平衡带来的效果就是控制整体树高,让时间复杂度最终保持在O(logn),否则都是一丿的树就没意义了。 为什么有个负载因子呢?负载因子决定HashMap的高矮胖瘦,负载你可以理解成一辆卡车能装多少货,装的越多这一趟赚的也阅读风险也越高,装的越少跑的越快赚的也少。所以选择了适当大小0.75。 为什么JDK8优化了数据扩容时迁移?那不就是因为计算哈希值求下标耗费时间吗,已经找到了数学规律,直接迁移就可以了,提高性能。 「看到了吗?」 HashMap完全就是对数据结构的综合使用,以及对数学逻辑的完美结合,才让我们有了非常好用的HashMap。这些知识的学习就可以技术迁移到我们自己业务开发中,把有些业务开发优化到非常不错的性能体现上。同时你的代码也值得加薪! 「哈希下标」 图 15-2 中涉及到的下标位置存放的数据,不是胡乱写的。是按照 HashMap 中的计算逻辑找到的固定位置值。代码如下: for(inti=1;i<1000;i++){ Stringkey=String.valueOf(i); inthash=key.hashCode()^(key.hashCode()>>>16); intidx=(64-1)&hash; if(idx==2){ // System.out.println(i +" Idx:"+ idx); } if(idx==62){ System.out.println(i+" Idx:"+idx); } } 如果你需要英文的,那么可以跑10万单词的字典表。关于HashMap的内容小傅哥已经整理到面经手册中,链接:面经手册 • 拿大厂Offer 三、得物(毒) 8位随机抽奖码设计 1. 需求描述 图 15-3 模仿得物(毒) APP抽奖码需求 图 15-3 是我们模拟得物APP中关于抽奖码需求的样式图,核心技术点包括: 需要一个8位的随机码,全局唯一。 每个人可以获得多个这样的随机码,随机码阅读中奖概率越大。 随机码我们这里的设计与毒App的展现形式略有不同,组成包括:大写字母、小写字母和数字。 在你没有看实现方案前,你可以先考虑下这样的唯一的随机码该怎样去生成。 2. 实现方案 2.1 基于Redis生成 intcodeId=RedisUtil.incr("codeUUID"); StringUUID=String.format("%08d",codeId); System.out.println(UUID); //测试结果 00000001 00000002 00000003 评分:⭐ 方案:基于 Redis 的 incr 方法,全局自增从0开始,以上是伪代码。 点评:以上方案不可用,除了并不一定能保证全局自增和可靠性外,有一个很大的问题是你的顺序自增,把APP有多少人参加活动的数据暴露了。 2.2 随机数生成 Randomrandom=newRandom(); StringBuffercode=newStringBuffer(); for(inti=0;i<8;i++){ intnumber=random.nextInt(3); switch(number){ case0: code.append((char)(random.nextInt(26)+65));//65~90 break; case1: code.append((char)(random.nextInt(26)+97));//97~122 break; case2: code.append((char)(random.nextInt(9)+48));//48~97 break; } } System.out.println(code.toString()); //测试结果 qvY0Fqrk 8uyehK3H U7z2v4qK 评分:⭐⭐ 方案:基于随机数生成8位随机码,相当于62^8次幂,有将近百万亿的随机数。 点评:此方案在很多业务场景中都有使用,但这里的实现还有一个问题,就是随性后的不唯一性,虽然我们知道这么大体量很难出现两个相同的。但如果随着业务运营日积月累的使用,终究会有两个一样的随机数,只要出现就会是客诉。所以还需要保证唯一性,可以在随机数中加入年或者月的标记,按照这个体量落库用防重方式保证唯一。 当然你还可以有其他的方式来保证唯一 2.3 基于雪花算法 finalstaticchar[]digits={'0','1','3','2','4','7','6','5','8', 'z','A','B','C','D','E','F','G','H','I','J','K','L', '9','a','b','c','d','e','f','g','h','i','j','k','l', 'm','n','o','p','q','r','s','t','u','v','w','x','y', 'M','N','O','P','Q','R','S','T','U','V','W','X','Y', 'Z','0','1',}; publicstaticvoidmain(String[]args){ SnowflakeIdWorkeridWorker=newSnowflakeIdWorker(0,0); System.out.println(idWorker.nextId()); longcode=idWorker.nextId(); char[]buf=newchar[64]; intcharPos=64; intradix=1<<6; longmask=radix-1; do{ buf[--charPos]=digits[(int)(code&mask)]; code>>>=6; }while(code!=0); System.out.println(newString(buf,charPos,(64-charPos))); } //测试结果 uxdDQOG001 uxd8Uoj001 uxdERuG000 评分:⭐⭐⭐ 方案:基于雪花算法的核心目的是,生成随机串的本身就是唯一值,那么就不需要考虑重复性。只需要将唯一值转换为对应64进制的字符串组合就可以了。 点评:这里的思路很好,但有几个问题需要解决。首先是雪花算法的长度是18位,在转换为64位时会会有10位长的随机字符串组合,不满足要求。另外大写字母、小写字母和数字组合是62个,还缺少2个不满足64个,所以需要后面补充两位,但这两位生成的组合数需要废弃。 「那么」,如果按照这个生成随机串且保证唯一的思路,就需要完善雪花算法,降低位数,在满足业务自身的情况下,控制生成长度。 「实现方案」,终究不会一次就完美,还需要不断的优化完善。除此之外也会有很多其他的思路,例如电商生成订单号的方案也可以考虑设计,另外你以为这就完事了?当你已经工作多年,那么你每一天其实都在解决技术问题也是数学问题,产品的需求也更像是数学作业!加油数学老师! 四、总结 好的程序实现离不开数据结构的设计、逻辑算法的完善、设计模式的考量,再配合符合业务发展和程序设计的架构才能搭建出更加合理的程序。 在学习的过程中不要刻意去背答案、背套路,那不是理科内容的学习方式。只有你更多的去实践、去验证,让懂了就是真的懂,才更加舒心! 本篇又扯到了这,想问一句你是害怕35岁,还是害怕自己能力不及年龄增长? 想学就把知识学透,你骗不了面试官,只能骗自己! 五、系列推荐 握草,你竟然在代码里下毒! 一次代码评审,差点过不了试用期! 数据结构,HashCode为什么使用31作为乘数? HashMap核心知识,扰动函数、负载因子、扩容链表拆分,深度学习 HashMap数据插入、查找、删除、遍历,源码分析 bugstack虫洞栈 沉淀、分享、成长,让自己和他人都能有所收获! 作者小傅哥多年从事一线互联网Java开发,从19年开始编写工作和学习历程的技术汇总,旨在为大家提供一个较清晰详细的核心技能学习文档。如果本文能为您提供帮助,请给予支持(关注、点赞、分享)! 本文分享自微信公众号 - bugstack虫洞栈(bugstack)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册