首页 文章 精选 留言 我的

精选列表

搜索[产业分析],共10000篇文章
优秀的个人博客,低调大师

Knative 健康检查机制分析

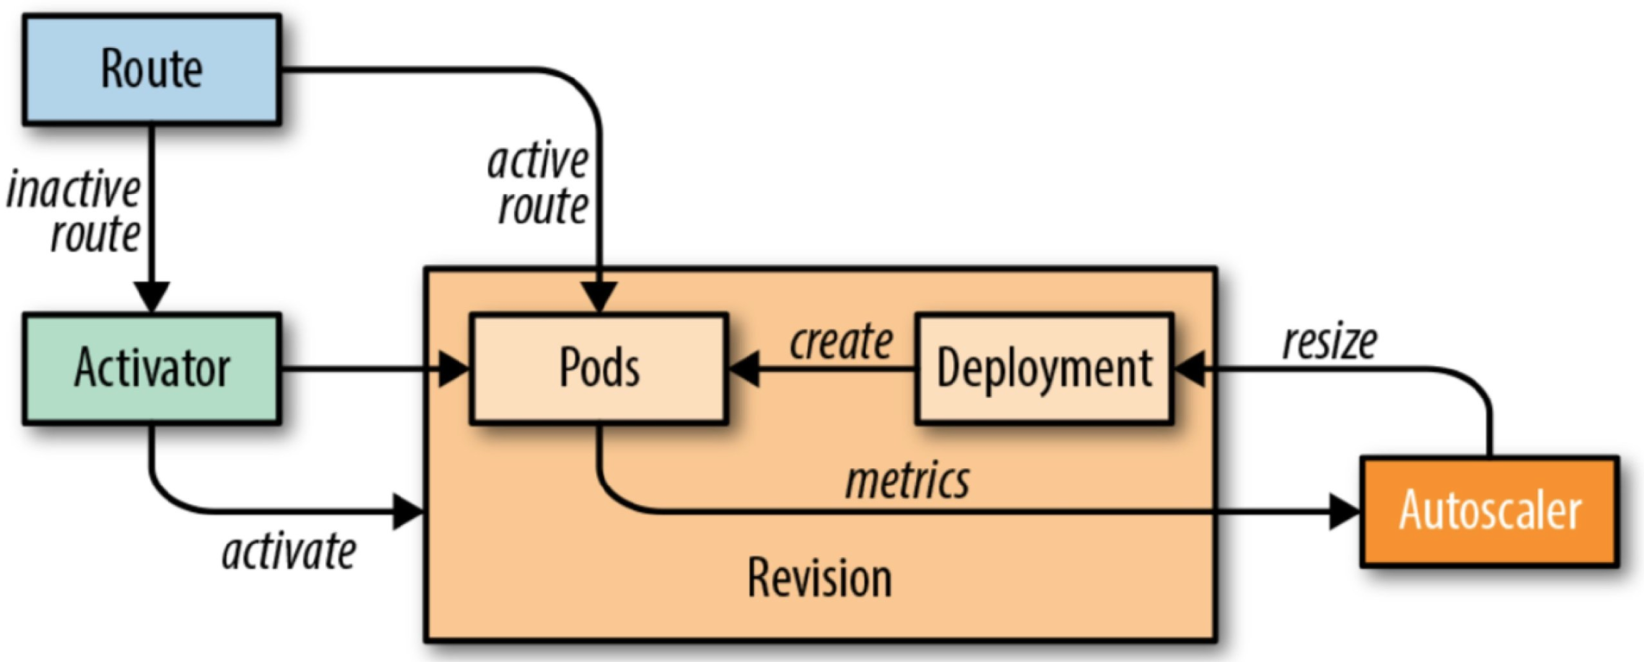
从头开发一个 Serverless 引擎并不是一件容易的事情,今天咱们就从 Knative 的健康检查说起。通过健康检查这一个点来看看 Serverless 模式和传统的模式都有哪些不同以及 Knative 针对 Serverless 场景都做了什么思考。Knative Serving 模块的核心原理如下图所示。下图中的 Route 可以理解成是 Istio Gateway 的角色。 当缩容到零时进来的流量就会指到 Activator 上面 当 Pod 数不为零时流量就会指到对应的 Pod 上面,此时流量不经过 Activator 其中 Autoscaler 模块根据请求的 Metrics 信息实时动态的扩缩容 关于这部分的详细介绍可以参见 https://yq.aliyun.com/articles/702969 这篇文章。 Knativ

优秀的个人博客,低调大师

({} + {}).length的答案结果分析详解

JavaScript的({} + {}).length结果是什么?码笔记告诉你答案是30,那么,为什么是30呢?详解如下: ({} + {}).length答案详解 ({} + {}).length等价于({}.toString() + {}.toString()).length ({}).length结果为undefined,这是因为对象{}没有length属性,所以是undefined 由于javascript是弱类型语言,加法运算间接调用了对象的toString()方法,其结果是字符串的相加,于是{}.toString()的值为[object Object] 码笔记来数一下[object Object],为15,如下所示: [ o b j e c t O b j e c t ] 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 所以,最终15+15=30 懂了吗?码笔记梳理一下: ({} + {}).length ->> ({}.toString() + {}.toString()).length {}.toString() ->> [object Object]所以,({} + {}).length = ({}.toString() + {}.toString()).length = [object Object]+[object Object] = 15+15 = 30 阿里云大学推出《JavaScript入门与实战》免费视频课程,大家可以关注下。

优秀的个人博客,低调大师

深入分析java I/O

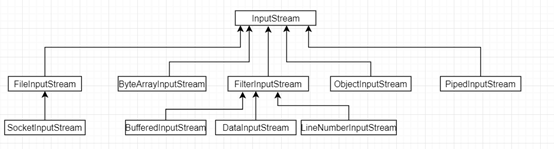
I/O 是最为基础重要的一门工程,它是数据信息交换的渠道方式。在爆炸性海量数据的互联网时代,I/O问题尤其重要,往往影响我们系统的性能祸首之一。常常有网络I/O网络数据上传与下载能力, 磁盘I/O即是我们硬盘的读写能力。而I/O类主要在JDK包java.io下,类比较繁多,我们只需要挑一两个来study。根据数据流的格式和方式如下分类:1)基于字节(抽象类):InputStream 和 OutputStream2)基于字符(抽象类):Writer 和 Reader3)基于磁盘文件(类):File4)基于网络传输(类):Socket 基于字节的I/O操作InputStream类的相关层级关系 代码1 private static void inputStreamForFile(File file) throws IOException { InputStream fis = null; try { fis = new FileInputStream(file); /* int result; while ((result = fis.read()) != -1) { System.out.print((char)result); }*/ byte[] buffer = new byte[(fis.available())]; // 缓存大小跟文件字节数一致 fis.read(buffer); System.out.println(new String(buffer)); } finally { fis.close(); } } 与InputStream输入字节流相对应的是OutputStream输出字节流 代码2 public static void outputStreamToFile(File file) { String bufferStr = new String("\n hello from outStream!"); byte buffer[] = bufferStr.getBytes(); OutputStream out = null; try { // 以追加的方式写入文件 out = new FileOutputStream(file, true); out.write(buffer); } catch (Exception ex) { ex.printStackTrace(); } finally { try { out.close(); } catch (IOException ioEx) { System.out.println(ioEx.toString()); } } } 其中,FileOutputStream(File file, boolean append)以追加的方式,添加入文件的末尾。通过类层次可以知道,FileOutputStream 的子类有SocketOutputStream, 即网络输出字节流其实也是以文件流形式进行传输。 基于字符的I/O操作最小的存储单元是字节而不是字符,所以I/O操作都是针对字节进行存储。那为啥需要引入字符呢?那是因为在我们的程序中,通常操作的数据都是以字符形式,为了操作方便需要提供一个直接写字符的 I/O 接口。 Reader 字符流,它的类层次结构如下 代码3 private static void readForFile(File file) throws IOException { StringBuffer sb; FileReader fileReader = null; try { sb = new StringBuffer(); char[] buf = new char[1024]; fileReader = new FileReader(file); while (fileReader.read(buf) > 0) { sb.append(buf); } } finally { fileReader.close(); } System.out.println("readForFile, " + sb.toString()); } Writer的类层次结构 代码4 private static void writeForFile(File file) throws IOException { FileWriter fw = null; try { fw = new FileWriter(file, true); fw.write("this is from write"); } finally { fw.close(); } } 刚才说了,底层是以最小单元为字节进行存储,而程序中经常以字符来进行操作,所以存在字节与字符的转化,拿InputStream 输入字节流举例,类结构如下 如果转换时,没有指定编码,会以默认的字符编码进行转义,默认的是“UTF-8” public static Charset defaultCharset() { if (defaultCharset == null) { synchronized (Charset.class) { String csn = AccessController.doPrivileged( new GetPropertyAction("file.encoding")); Charset cs = lookup(csn); if (cs != null) defaultCharset = cs; else defaultCharset = forName("UTF-8"); } } return defaultCharset; } java 访问磁盘文件在 java 中通常的 File 并不代表一个真实存在的文件对象,当你指定一个路径描述符时,他就会返回代表这个路径的虚拟对象,它可能是一个真实存在的文件或者一个包含多个文件的文件夹。多数情况下,我们并不关心这是文件是否存在,只关心这个文件到底如何操作。那么什么时候会检查这个文件是否真实存在呢?只有在真正需要读取文件的时候,才会去检查这个文件是否存在前文已经提到,文件存盘的最小单位是字节,所以直接和硬盘打交道的是字节流,针对于输入文件字节流FileInputStream,在它实例化时会创建一个 FileDescritor 对象,其实FileDescritor就是代表一个存在的文件对象的描述。当我们在操作一个FileInputStream文件对象时,可以通过其 getFD() 方法来获取FileDescriptor对象。而FileDescriptor是与底层操作系统相关联文件的行为描述。 具体的行为包括如下: /** * Force all system buffers to synchronize with the underlying * device. This method returns after all modified data and * attributes of this FileDescriptor have been written to the * relevant device(s)… **/ FileDescriptor.sync() 方法将操作系统缓存中的数据强制刷新到物理磁盘中。 /** * Tests if this file descriptor object is valid. */ FileDescriptor.valid() 方法将检测描述对象是否有效。 当传入一个文件路径时,将会根据这个路径创建一个 File 对象,然后创建StreamDecoder进行编码解码,最后将会真正创建一个关联真实存在的磁盘文件的文件描述符 FileDescriptor,这个对象可以用来操作磁盘文件。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册