首页 文章 精选 留言 我的

精选列表

搜索[AI运维],共10000篇文章
优秀的个人博客,低调大师

三分钟带你了解一站式大数据平台运维管家ChengYing产品包制作

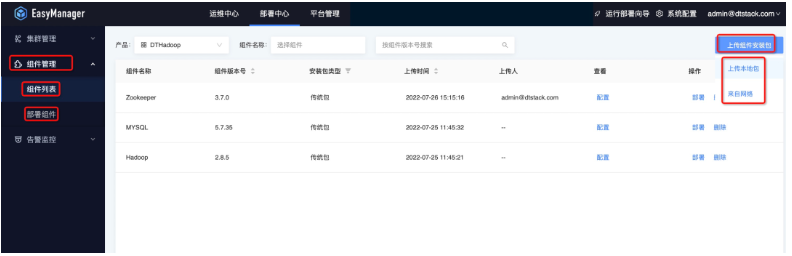
课件获取:关注公众号 “数栈研习社”,后台私信 “ChengYing” 获得直播课件 视频回放:点击这里 ChengYing 开源项目地址:github 丨 gitee 喜欢我们的项目给我们点个__ STAR!STAR!!STAR!!!(重要的事情说三遍)__ 技术交流钉钉 qun:30537511 产品包的构成 01 产品包制作前置条件 在制作产品包之前,我们首先要完成以下3个步骤: ChengYing已部署完成,ChengYing的部署内容可以参考【ChengYing安装原理】。 组件原料准备完成(组件原料主要是指已经编译完成的二进制包)。 当以上两个步骤完成之后,我们就可以开始产品包的制作。 02 产品包构成 产品包主要由schema.yml及各服务目录组成。Schema主要主要描述产品的组成,是一个编排文件,服务目录类似于工作目录,也有可能是静态组件,我们以下面两个产品包介绍为例: ● 基础服务包 上层应用所依赖的服务、例如mysql、zookeeper等服务,其目录结构如下: ● Java应用包 Java应用层产品包、包含的组件,前端,后端,sql组件、其目录结构如下: Schema解析&产品包制作 接下来我们来重点了解下Schema相关的内容。 01 Schema解析 Schema.yml是整个产品包的核心文件,其内容主要描述了产品包里所有组件信息以及配置变量。 产品所属父级名称(parent_product_name) 产品名称(product_name) 产品版本(product_version) 服务名(service) 配置文件(application.properties) schem语法参考: https://dtstack.github.io/chengying-web/docs/chengyingDocs/introduction/schema 02 部署流程 部署流程在上述的Schema解析中都有体现,主要是以下流程: ● 安装(install) 从ChengYing服务端下载组件,并执行post_deploy.sh脚本,成功则进行下一步。 ● 启动(running) 执行Schema文件中所定义的启动脚本,执行失败,脚本返回“1”则表示run failed ,反之则表示启动成功。 ● 健康检查(healthy-check) 定时执行健康检查脚本(health.sh)。 案例分享 接下来为大家分享两个ChengYing产品包制作的案例 01 Base包制作 以Base产品包为例,其中主要包含zookeeper,mysql,mysql_slaves等组件。 1.官网下载二进制安装包 2.脚本编写(启动脚本,监控脚本,部署脚本) 3.提取参数,编写Schema 4.使用Mero工具制作产品包 产品包地址: curl http://172.0.0.1:8864/api/v2/product/upload -F 'package=@DTBase_2.1.19.tar' 注意:IP为ChengYying所在服务的节点ip,产品包则是执行mero命令后所生成的文件 02 Taier产品包制作 Taier属于Java应用,前后端分离部署的架构模式。 1.下载前端代码,进行编译获取编译后的js文件 2.下载后端代码,进行编译后获取编译后jar包 3.按模块划分目录 4.提取参数,编写schema 5.使用mero工具制作产品包 产品包地址: curl http://172.0.0.1:8864/api/v2/product/upload -F 'package=@Taier_4.2.1_rel.tar' 注意:IP为ChengYying所在服务的节点ip,产品包则是执行mero命令后所生成的文件 03 附录 ● 关于Base产品包 Mysql二进制包: https://downloads.mysql.com/archives/community/ Zookeeper二进制包下载: https://dlcdn.apache.org/zookeeper/zookeeper-3.8.0/ ● 关于Taier产品包 Taier源码下载:https://github.com/DTStack/Taier 前端编译命令:npm run build 后端编译命令:mvn clean package -DskipTests -T 1C -pl taier-data-develop,taier-common,taier-worker/taier plugins -am –amd ● Mero下载地址 https://dtstack-opensource.oss-cn-hangzhou.aliyuncs.com/chengying/mero 袋鼠云开源框架钉钉技术交流群(30537511),欢迎对大数据开源项目有兴趣的同学加入交流最新技术信息,开源项目库地址:https://github.com/DTStack/Taier

优秀的个人博客,低调大师

【阿里云新品发布·周刊】第9期:实时大数据开发难、运维难、应用难?来,一站解决!

点击订阅新品发布会! 新产品、新版本、新技术、新功能、价格调整,评论在下方,下期更新!关注更多内容,了解更多 最新发布 DataWorks Stream Studio重磅发布 2019年5月15日15时,阿里云DataWorks Stream Studio: 一站式流任务开发平台重磅发布,介绍实时计算任务开发的困难、问题和背景,引出使用Stream Studio可以大大加快实时任务的开发速度,降低开发和维护门槛,同时结合DataWorks的整体能力,能够实现实时数仓、实时监控、实时分析、实时大屏等实时大数据场景的一站式开发。 查看产品产品文档 应用实时监控 ARMS 升级发布 2019年5月9日,阿里云应用实时监控 ARMS 再升级,支持 Prometheus 开源生态。全新升级的阿里云应用监控ARMS从3个端到端的视角帮助企业监控管理应

优秀的个人博客,低调大师

宜信-运维-数据库|SQL优化:一篇文章说清楚Oracle Hint的正确使用姿势

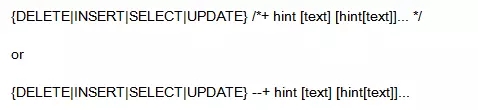
一、提示(Hint)概述 1、为什么引入Hint? Hint是Oracle数据库中很有特色的一个功能,是很多DBA优化中经常采用的一个手段。那为什么Oracle会考虑引入优化器呢?基于代价的优化器是很聪明的,在绝大多数情况下它会选择正确的优化器,减轻DBA的负担。 但有时它也聪明反被聪明误,选择了很差的执行计划,使某个语句的执行变得奇慢无比。此时就需要DBA进行人为的干预,告诉优化器使用指定的存取路径或连接类型生成执行计划,从而使语句高效地运行。Hint就是Oracle提供的一种机制,用来告诉优化器按照告诉它的方式生成执行计划。 2、不要过分依赖Hint 当遇到SQL执行计划不好的情况,应优先考虑统计信息等问题,而不是直接加Hint了事。如果统计信息无误,应该考虑物理结构是否合理,即没有合适的索引。只有在最后仍然不能SQL按优化的执行计划执行时,才考虑Hint。 毕竟使用Hint,需要应用系统修改代码,Hint只能解决一条SQL的问题,并且由于数据分布的变化或其他原因(如索引更名)等,会导致SQL再次出现性能问题。 3、Hint的弊端 Hint是比较"暴力"的一种解决方式,不是很优雅。需要开发人员手工修改代码。 Hint不会去适应新的变化。比如数据结构、数据规模发生了重大变化,但使用Hint的语句是感知变化并产生更优的执行计划。 Hint随着数据库版本的变化,可能会有一些差异、甚至废弃的情况。此时,语句本身是无感知的,必须人工测试并修正。 4、Hint与注释关系 提示是Oracle为了不破坏和其他数据库引擎之间对SQL语句的兼容性而提供的一种扩展功能。Oracle决定把提示作为一种特殊的注释来添加。它的特殊性表现在提示必须紧跟着DELETE、INSERT、UPDATE或MERGE关键字。 换句话说,提示不能像普通注释那样在SQL语句中随处添加。且在注释分隔符之后的第一个字符必须是加号。在后面的用法部分,会详细说明。 5、Hint功能 Hint提供的功能非常丰富,可以很灵活地调整语句的执行过程。通过Hint,我们可以调整: 优化器类型 优化器优化目标 数据读取方式(访问路径) 查询转换类型 表间关联的顺序 表间关联的类型 并行特性 其他特性 二、Hint用法 1、语法 1)关键字说明 DELETE、INSERT、SELECT和UPDATE是标识一个语句块开始的关键字,包含提示的注释只能出现在这些关键字的后面,否则提示无效。 "+"号表示该注释是一个提示,该加号必须立即跟在"/*"的后面,中间不能有空格。 hint是下面介绍的具体提示之一,如果包含多个提示,则每个提示之间需要用一个或多个空格隔开。 text是其它说明hint的注释性文本 2)提示中的错误 提示中的语法错误不会报错,如果解析器不能解析它,就会把它看做一个普通注释处理。这也是容易造成困惑的一点,使用的Hint到底是否起效?可以采用一些手段,检查提示的有效性。需要注意的是,那些语法正确但引用对象错误的提示是不会被报告的。 explain plan + dbms_xplan 使用dbms_xplan输出中的note选项。 10132事件 在10g中,这个事件产生的输出文档的末尾有一部分内容专门讲提示。通过它可以检查两个方面:一是每个用到的提示都会被列出来。如果漏掉了哪个,就说明这个提示没有被识别;二是检查是否有一些信息指明了出现提示错误(如果出错,err值将大于0)。 3)提示中的对象 SELECT /*+ INDEX(table_name index_name) */ ... table_name是必须要写的,且如果在查询中使用了表的别名,在hint也要用表的别名来代替表名。 index_name可以不必写,Oracle会根据统计值选一个索引。 如果索引名或表名写错了,那这个hint就会被忽略。 如果指定对象是视图,需要按此方法指定。/*+hint view.table ...*/,其中table是view中的表。 一个很常见的错误时,在使用提示的时候最易犯的错误是与表的别名有关。正确的规则是,当在提示中使用表时,只要表有别名就应该使用别名而不是表名。 2、提示的作用域 查询块 初始化参数提示对整个SQL语句起作用,其他的提示仅仅对查询块起作用。仅仅对单个查询块起作用的提示,必须在它控制的查询块内指定。 例外 - 全局提示 可以使用点号引用包含在其他查询块(假设这些块已命名)中的对象。全局提示的语法可以支持两层以上的引用,对象间必须用点号分隔。 命名查询块 既然where子句中的子查询是没有命名的,它们的对象就不能被全局提示引用。为了解决这个问题,10g中使用了另一种方法来解决-命名查询块。查询优化器可以给每个查询生成一个查询块名,而且还可以使用提示qb_name手工为每个查询块命名。大多数提示都可以通过参数来指定在那个查询块中有效。 *在提示中通过@来引用一个查询块。 3、提示数据字典 Oracle在11g的版本中提供了一个数据字典—V$SQL_HINT。通过这个数据字典可以看到提示的出现版本、概要数据版本、SQL特性以及相反提示等。 INVERSE 这个hint相反操作的hint。 VERSION 代表着这个hint正式公布引入的版本。 三、Hint分类 1、和优化器相关的 当对优化器为某个语句所制定的基本执行计划不满意时,最好的办法就是通过提示来转换优化器的模式,并观察其转换后的结果,看是否已经达到期望程度。如果只通过转换优化器的模式就可以获得非常好的执行计划,则就没有必要额外使用更为复杂的提示了。 OPT_PARAM 这个提示的作用就是使我们在某条语句中指定某个系统参数值。 ALL_ROWS 为实现查询语句整体最优化而引导优化器制定最少成本的执行计划。这个提示会使优化器选择一条可最快检索所有查询行的路径,而代价就是在检索一行数据时,速度很慢。 FIRST_ROWS 为获得最佳响应时间而引导优化器制定最少成本的执行计划。这个提示会使优化器选择可最快检索出查询的第一行(或指定行)数据的路径,而代价就是检索很多行时速度就会很慢。利用FIRST_ROWS来优化的行数,默认值为1,这个值介于10到1000之间,这个使用FIRST_ROWS(n)的新方法是完全基于代价的方法。它对n很敏感,如果n值很小,CBO就会生成包含嵌套循环以及索引查找的计划;如果n很大,CBO会生成由哈希连接和全表扫描组成的计划(类似ALL_ROWS)。 CHOOSE 依据SQL中所使用到的表的统计信息存在与否,来决定使用RBO还是CBO。在CHOOSE模式下,如果能够参考表的统计信息,则将按照ALL_ROWS方式执行。除非在查询中的所有表都没有经过分析,否则choose提示会对整个查询使用基于代价的优化。如果在多表连接中有一个表经过分析过,那么就会对整个查询进行基于代价的优化。 RULE 使用基于规则的优化器来实现最优化执行,即引导优化器根据优先顺序规则来决定查询条件中所使用到的索引或运算符的执行顺序来制定执行计划。这个提示强制oracle优先使用预定义的一组规则,而不是对数据进行统计;同时该提示还会使这个语句避免使用其他提示,除了DRIVING_SITE和ORDERED(不管是否进行基于规则的优化,这两个提示都可使用)。 2、和访问路径相关的 FULL 告诉优化器通过全表扫描方式访问数据。这个提示只对所指定的表进行全表扫描,而不是查询中的所有表。FULL提示可以改善性能。这主要是因为它改变了查询中的驱动表,而不是因为全表扫描。在使用其他某些提示时,也必须使用FULL提示。只有访问整个表时,才可利用CACHE提示将表进行缓存。并行组中的某些提示也必须使用全表扫描。 CLUSTER 引导优化器通过扫描聚簇索引来从索引表中读取数据。 HASH 引导优化器按照哈希扫描的方式从表中读取数据。 INDEX 告诉优化器对指定表通过索引的方式访问数据。当访问数据会导致结果集不完整时,优化器将忽略这个Hint。 NO_INDEX 告诉优化器对指定表不允许使用索引。这个提示会禁止优化器使用指定索引。可以在删除不必要的索引之前在许多查询中禁止索引。如果使用了NO_INDEX,但是没有指定任何索引,则会执行全表扫描。如果对某个索引同时使用了NO_INDEX和会之产生冲突的提示(如INDEX),这时两个提示都会被忽略掉。 INDEX_ASC 利用索引从表中读取数据时,引导优化器对提示中所指定索引的索引列值按照升序使用范围扫描。 INDEX_COMBINE 告诉优化器强制选择位图索引。这个提示会使优化器合并表上的多个位图索引,而不是选择其中最好的索引(这是INDEX提示的用途)。还可以使用index_combine指定单个索引(对于指定位图索引,该提示优先于INDEX提示)。对于B树索引,可以使用AND_EQUAL提示而不是这个提示。 INDEX_JOIN 索引关联,当谓词中引用的列上都有索引的时候,可以通过索引关联的方式来访问数据。这个提示可以将同一个表的各个不同索引进行合并,这样就只需要访问这些索引就可以了,节省了回表查询的时间。但只能在基于代价的优化器中使用该提示。这个提示不仅允许只访问表上的索引,这样可以扫描更少的代码块,并且它比使用索引并通过rowid扫描整个表快5倍。 INDEX_DESC 利用索引从表中读取数据时,引导优化器对提示中所指定索引的索引列值按照降序使用范围扫描。 INDEX_FFS 告诉优化器以INDEX FFS(index fast full scan)的方式访问数据。INDEX_FFS提示会执行一次索引的快速全局扫描。这个提示只访问索引,而不是对应的表。只有查询需要检索的信息都在索引上时,才使用这个提示。特别在表有很多列时,使用该提示可以极大地改善性能。 INDEX_SS 强制使用index skip scan的方式访问索引。当在一个联合索引中,某些谓词条件并不在联合索引的第一列时(或者谓词并不在联合索引的第一列时),可以通过index skip scan来访问索引获得数据。当联合索引第一列的唯一值很少时,使用这种方式比全表扫描的方式效率要高。 3、和查询转换相关的 USE_CONCAT 将含有多个OR或者IN运算符所连接起来的查询语句分解为多个单一查询语句,并为每个单一查询语句选择最优化查询路径,然后再将这些最优化查询路径结合在一起,以实现整体查询语句的最优化目的。只有在驱动查询条件中包含OR的时候,才可以使用该提示。 NO_EXPAND 引导优化器不要为使用OR运算符号(或IN运算符)的条件制定相互结合的执行计划。正好和USE_CONCAT相反。 REWRITE 当表连接的对象是数据量比较大的表或者需要获得使用统计函数处理过的结果时,为了提高执行速度可预先创建物化视图。当用户要求查询某个查询语句时,优化器会在从表中和从物化视图中读取数据的两种方法中选择一个更有效的方法来读取数据。该执行方法称之为查询重写。使用REWRITE提示引导优化器按照该方式执行。 MERGE 为了能以最优方式从视图或者嵌套视图中读取数据,通过变换查询语句来直接读取视图使用的基表数据,该过程被称之为视图合并。不同的情况其具体使用类型也有所不同。该提示主要在视图未发生合并时被使用。尤其是对比较复杂的视图或者嵌套视图(比如使用了GROUP BY或DISTINC的视图)使用该提示,有时会取得非常好的效果。 UNNEST 提示优化器将子查询转换为连接的方式。也就是引导优化器合并子查询和主查询并且将其向连接类型转换。 NO_UNNEST 引导优化器让子查询能够独立地执行完毕之后再跟外围的查询做FILTER。 PUSH_PRED 使用该提示可以将视图或嵌套视图以外的查询条件推入到视图之内。 NO_PUSH_PRED 使用该提示确保视图或嵌套视图以外的查询条件不被推入到视图内部。 PUSH_SUBQ 使用该提示引导优化器为不能合并的子查询制定执行计划。不能合并的子查询被优先执行之后,该子查询的执行结果将扮演缩减主查询数据查询范围的提供者角色。通常在无法执行子查询合并的情况下,子查询扮演的都是检验者角色,所以子查询一般被放在最后执行。在无法被合并的子查询拥有较少的结果行,或者该子查询可以缩减主查询查询范围的情况下,可以使用该提示引导优化器最大程度地将该子查询放在前面执行,以提高执行速度。但如果子查询执行的是远程表或者排序合并连接的一部分连接结果,则该提示将不起任何作用。 NO_PUSH_SUBQ 使用该提示将引导优化器将不能实现合并的子查询放在最后执行。在子查询无法缩减主查询的查询范围,或者执行子查询开销较大的情况下,将这样的子查询放在最后执行可以在某种程度上提高整体的执行效率。也就是说,尽可能地使用其他查询条件最大程度地缩减查询范围之后,再执行子查询。 4、和表连接顺序相关的 这些提示可以调整表连接的顺序。调整表连接的顺序并不是只能使用这些提示,在嵌套循环连接方式中也可以让提示来引导优化器使用由驱动查询条件所创建的索引。然而,该方法只有在使用的索引和表连接顺序同时被调整的情况下才比较有效。一般而言,这些提示主要在执行多表连接和表之间的连接顺序比较混乱的情况下才使用,也在排序合并连接或哈希连接方式下,为引导优化器优先执行数据量比较少得表时使用。 LEADING 在一个多表关联的查询中,这个Hint指定由哪个表作为驱动表,即告诉优化器首先要访问那个表上的数据。引导优化器使用LEADING指定的表作为表连接顺序中的第一个表。该提示既与FROM中所描述的表的顺序无关,也与作为调整表连接顺序的ORDERED提示不同,并且在使用该提示时并不需要调整FROM中所描述的表的顺序。当该提示与ORDERED提示同时使用时,该提示被忽略。 这个提示类似ORDERED提示,它允许指定驱动查询的表,然后由优化器来判断下一个要访问的表。如果使用这个提示指定多张表,那么就可以忽略这个提示。 ORDERED 引导优化器按照FROM中所描述的表的顺序执行连接。如果和LEADING提示被一起使用,则LEADING提示将被忽略。由于ORDERED只能调整表连接的顺序并不能改变表连接的方式,所以为了改变表的连接方式,经常将USE_NL、USE_MERGE提示与ORDERED提示放在一起使用。 5、和表连接操作相关的 USE_NL 使用该提示引导优化器按照嵌套循环连接方式执行表连接。它只是指出表连接的方式,对于表连接顺序不会有任何影响。 USE_MERGE 引导优化器按照排序合并连接方式执行连接。在有必要的情况下,推荐将该提示与ORDERED提示一起使用。提示通常用于获得查询的最佳吞吐量。假设将两个表连接在一起,从每个表返回的行集将被排序,然后再被合并(也就是合并排序),从而组成最终的结果集。由于每个行先被排序之后才进行合并,所以在给定查询中检索所有行时,速度将会最快。如果需要以最快速度返回第一行,就应该使用USE_NL提示。 USE_HASH 该提示引导优化器按照哈希连接方式执行连接。在执行哈希连接时,如果由于某一边的表比较小,从而可以在内存中实现哈希连接,那么就能够获得非常好的执行速度。由于在大部分情况下优化器会通过对统计信息的分析来决定Build Input和Prove Input,所以建议不要使用ORDERED提示随意改变表的连接顺序。但是当优化器没能做出正确判断时,或者像从嵌套视图中所获得的结果集合那样不具备统计信息时,可以使用该提示。 6、和并行相关的 PARALLEL 指定SQL执行的并行度,这个值将会覆盖表自身设定的并行度。如果这个值为default,CBO使用系统参数。从表中读取大量数据和执行DML操作时使用该提示来指定SQL的并行操作。 一般情况下需要在该提示中指定将要使用的并行线程个数。如果在该提示中没有指定并行度的个数,则优化器将使用PARALLEL_THREADS_PER_CPU参数所指定的值进行自动计算。如果在定义表时指定了PARALLEL,那么在能够使用并行操作的情况下,即使没有使用该提示,优化器也会按照指定的并行级别选择并行操作。 但是如果想在DELETE、INSERT、UPDATE、MERGE等DML操作中使用并行操作,则必须要在会话中设置ALTER SESSION ENABLE PARALLEL DML。在某个会话中所设置的并行级别也可以被引用在内部的GROUP BY或者排序操作中。在并行操作中如果出现了某个限制要素,则该提示将被忽略。 NOPARALLEL/NO_PARALLEL 在SQL语句禁止使用并行。在有些版本中用NO_PARALLEL提示来代替NOPARALLEL提示。 PQ_DISTRIBUTE 为了提高并行连接的执行速度,使用该提示来定义使用何种方法在主从进程之间(例如生产者进程和消费者进程)分配各连接表的数据行。 PARALLEL_INDEX 为了按照并行操作的方式对分区索引进行索引范围扫描而使用该提示,并且可以指定进程的个数。 7、其他相关的 APPEND 让数据库以直接加载的方式(direct load)将数据加载入库。这个提示不会检查当前是否有插入所需要的块空间,相反它会直接将数据添加到新块中。这样会浪费空间,但可以提高插入的性能。需要注意的是,数据将被存储在HWM之上的位置。 APPEND_VALUES 在11.2中,Oracle新增了APPEND_VALUES提示,使得INSERT INTO VALUES语句也可以使用直接路径插入。 CACHE 在全表扫描之后,数据块将留在LRU列表的最活跃端。如果设置表的CACHE属性,它的作用和HINT一样。这个提示会将全表扫描全部缓存到内存中。如果表很大,会占用大量内存。因此适用于用户经常访问的较小的表。 NOCACHE 引导优化器将通过全表扫描方式获取的数据块缓存在LRU列表的最后位置,这样可以让数据库实例缓存中的这些数据块被优先清除。这是优化器在Buffer Cache中管理数据块的默认方法(仅针对全表扫描)。 QB_NAME 使用该提示为查询语句块命名,在其他查询语句块可以直接使用该查询语句块的名称。 DRIVING_SITE 这个提示在分布式数据库操作中有用。指定表是处理连接所在的位置。可以限制通过网络处理的信息量。此外,还可以建立远程表的本地视图来限制从远程站点检索的行。本地视图应该有where子句,从而视图可以在将行发送回本地数据库之前限制从远程数据库返回的行。 DYNAMIC_SAMPLING 提示SQL执行时动态采样的级别。这个级别为0~10,它将覆盖系统默认的动态采样级别。等级越高,所获得统计信息的准确率越高。该提示的功能就是为了确保将动态采样原理应用在单个SQL中。 AND_EQUAL 这个提示会使优化器合并表上的多个索引,而不是选择其中最好的索引(这是INDEX提示的用途)。这个提示与前面的INDEX_JOIN提示有区别,以此指定的合并索引随后需访问表,而INDEX_JOIN提示则只需访问索引。如果发现需经常用到这个提示,可能需要删除这些单个索引而改用一个组合索引。需要查询条件里面包括所有索引列,然后取得每个索引中得到的rowid列表。然后对这些对象做merge join,过滤出相同的rowid后再去表中获取数据或者直接从索引中获得数据。在10g中,and_equal已经废弃了,只能通过hint才能生效。 CARDINALITY 向优化器提供对某个查询语句的整体或部分的预测基数值,并通过参考该基数值来为查询语句制定执行计划。如果在该提示中没有指定表的名称,则该基数值将被视为从该查询语句所获得的最终结果行数。 四、Hint使用示例 下面通过一个例子说明一下提示的使用及在什么情况下提示会被忽略。 1、构建表 2、使用INDEX提示 *在某些情况下,如果CBO认为Hint会导致错误结果,那么Hint则会忽略。该例子中因为ID字段可能为空,而索引是保存空值的,因此count(*)使用索引将导致错误的结果,故而使用了全表扫描,忽略了Hint。 3、使用INDEX提示(非空字段) *ID字段不可为空,因此COUNT可用索引扫描的方式处理,Hint生效了。 作者:韩锋 来源:宜信技术学院 (http://college.creditease.cn/)

优秀的个人博客,低调大师

L09-10老男孩Linux运维实战培训-Nginx服务生产实战应用指南05(架构解决方案)

nginx的多实例设置 首先说一下nginx后面加的参数的说明 -s 后面加reload 就是重新加载的意思和apache的graceful同样的效果 -v 小写的v显示版本号后退出 -V大写的V显示nginx的版本号和配置环境 -t 就是test的意思,检查配置文件是否正确 -c 后面配置文件的地址,可以开启多个实例 我们实际就是用-c这个参数来启动多个实例 使用include 后接配置文件地址来让实例参数内嵌在主配置文件nginx.conf中 本文转自wangchangshu2 51CTO博客,原文链接:http://blog.51cto.com/398528/2062563,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册