首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

NLTK基础教程学习笔记(十二)

构建第一个NLP应用:信息摘要:对所提供的文章短文故事生成需要针对其内容自动生成摘要。信息摘要需要理解的不只是句子的结构,而是整个文本结构,还要了解文本的体裁和主体主题内容。下面了一个介绍创建个人版的Google News通常用于较多实体和名词的句子的重要性往往会比较高,现在的任务是要用某种可能被标准化的统一逻辑来计算重要性成分(importance score),即如果想要获取前n个句子的信息情况,要去选择一个重要性评分阈值。由于找不到原文的新闻材料所以用wiki上的一段介绍吾王Saber材料代替; f=open('new.txt','r') new_content=f.read() print(new_content) 结果: Saber's full name is Altria Pendragon, a character inspired by the legends of King Arthur. At her nativity, Uther decides to not publicly announce Altria's birth or gender, fearing his subjects will never accept a woman as a legitimate ruler. She is entrusted by Merlin to a loyal knight, Sir Ector, who raises her as a surrogate son. When Altria is fifteen, King Uther dies leaving no known eligible heir to the throne. Britain enters a period of turmoil following the growing threat of invasion by the Saxons. Merlin soon approaches Altria, explaining that the British people will recognize her as a destined ruler if she withdraws Caliburn, a ceremonial sword embedded in a large slab of stone. However, pulling this sword is symbolic of accepting the hardships of a monarch, and Altria will be responsible for preserving the welfare of her people. Without hesitation and despite her gender, she draws Caliburn and shoulders Britain's mantle of leadership. Altria rules Britain from her stronghold in Camelot and earns the reputation of a just, yet distant king. Under the guidance of Merlin and with the aid of her Knights of the Round Table, she guides Britain into an era of prosperity and tranquillity. Caliburn is destroyed, but Altria soon acquires her holy sword, Excalibur, and Avalon, Excalibur's blessed sheath, from Vivian, the Lady of the Lake. While Avalon is in her possession, Altria never ages and is immortal in battle. Despite her immense strength and fighting abilities, Altria is plagued by feelings of guilt and inferiority throughout her reign; she sacrifices her emotions for the good of Britain, yet many of her subjects and knights become critical of her lack of humanity and cold calculation. Excalibur's scabbard is stolen while she repels an assault along her country's borders; when Altria returns inland, she discovers Britain is being torn asunder by civil unrest. Despite her valiant efforts to placate the dissent, Altria is mortally wounded by a traitorous knight, a homunculus born of her blood named Mordred, during the Battle of Camlann. Her dying body is escorted to a holy isle by Morgan le Fay and Sir Bedivere. Altria orders a grieving Bedivere to dispose of Excalibur by throwing it back to Vivian; in her absence, she reflects on her personal failures, regretting her life as king. Before her last breath, she appeals to the world; in exchange for services as a Heroic Spirit, she asks to be given an opportunity to relive her life, where someone more suitable and effective would lead Britain in her stead. 要对文字进行分析,先要将文章转换成一个句子列表。用句子标识器将内容分成若干个句子,这里提供一些句型的编号,便于识别这些句子并对其进行排名。一旦得到了这些段子,会让其在单词标识器中过一遍,最后再来过NER标注器和POS标注器。 import nltk f=open('new.txt','r') new_content=f.read() results=[] for sent_no,sentence in enumerate(nltk.sent_tokenize(new_content)): no_of_tokens=len(nltk.word_tokenize(sentence)) #print(no_of_tokens) tagged=nltk.pos_tag(nltk.word_tokenize(sentence)) no_of_nouns=len([word for word ,pos in tagged if pos in ["NN","NNP"]]) ners=nltk.ne_chunk(nltk.pos_tag(nltk.word_tokenize(sentence))) no_of_ners=len([chunk for chunk in ners if hasattr(chunk,'label')]) score=(no_of_ners+no_of_nouns)/float(no_of_tokens) results.append((sent_no,no_of_tokens,no_of_ners,no_of_nouns,score,sentence)) for sent in sorted(results,key=lambda x:x[4],reverse=True): print(sent[5]) 上面代码中我们对句子列表进行了迭代,并根据公式计算出了这些句子的评分,该公式只是个以被标识实体为分子,以普通标识词为分母的分子式,将这些结果创建成一个元组。降序排列后打印的结果: Caliburn is destroyed, but Altria soon acquires her holy sword, Excalibur, and Avalon, Excalibur's blessed sheath, from Vivian, the Lady of the Lake. Her dying body is escorted to a holy isle by Morgan le Fay and Sir Bedivere. Saber's full name is Altria Pendragon, a character inspired by the legends of King Arthur. Britain enters a period of turmoil following the growing threat of invasion by the Saxons. Altria rules Britain from her stronghold in Camelot and earns the reputation of a just, yet distant king. Without hesitation and despite her gender, she draws Caliburn and shoulders Britain's mantle of leadership. Under the guidance of Merlin and with the aid of her Knights of the Round Table, she guides Britain into an era of prosperity and tranquillity. While Avalon is in her possession, Altria never ages and is immortal in battle. Excalibur's scabbard is stolen while she repels an assault along her country's borders; when Altria returns inland, she discovers Britain is being torn asunder by civil unrest. Despite her valiant efforts to placate the dissent, Altria is mortally wounded by a traitorous knight, a homunculus born of her blood named Mordred, during the Battle of Camlann. When Altria is fifteen, King Uther dies leaving no known eligible heir to the throne. She is entrusted by Merlin to a loyal knight, Sir Ector, who raises her as a surrogate son. Merlin soon approaches Altria, explaining that the British people will recognize her as a destined ruler if she withdraws Caliburn, a ceremonial sword embedded in a large slab of stone. Altria orders a grieving Bedivere to dispose of Excalibur by throwing it back to Vivian; in her absence, she reflects on her personal failures, regretting her life as king. At her nativity, Uther decides to not publicly announce Altria's birth or gender, fearing his subjects will never accept a woman as a legitimate ruler. Before her last breath, she appeals to the world; in exchange for services as a Heroic Spirit, she asks to be given an opportunity to relive her life, where someone more suitable and effective would lead Britain in her stead. Despite her immense strength and fighting abilities, Altria is plagued by feelings of guilt and inferiority throughout her reign; she sacrifices her emotions for the good of Britain, yet many of her subjects and knights become critical of her lack of humanity and cold calculation. However, pulling this sword is symbolic of accepting the hardships of a monarch, and Altria will be responsible for preserving the welfare of her people. 完成了句子的排序,一旦有no_of_nouns和no_of_ners的评分列表,就可以围绕他们建议一些更加复杂的规则。

优秀的个人博客,低调大师

NLTK基础教程学习笔记(十一)

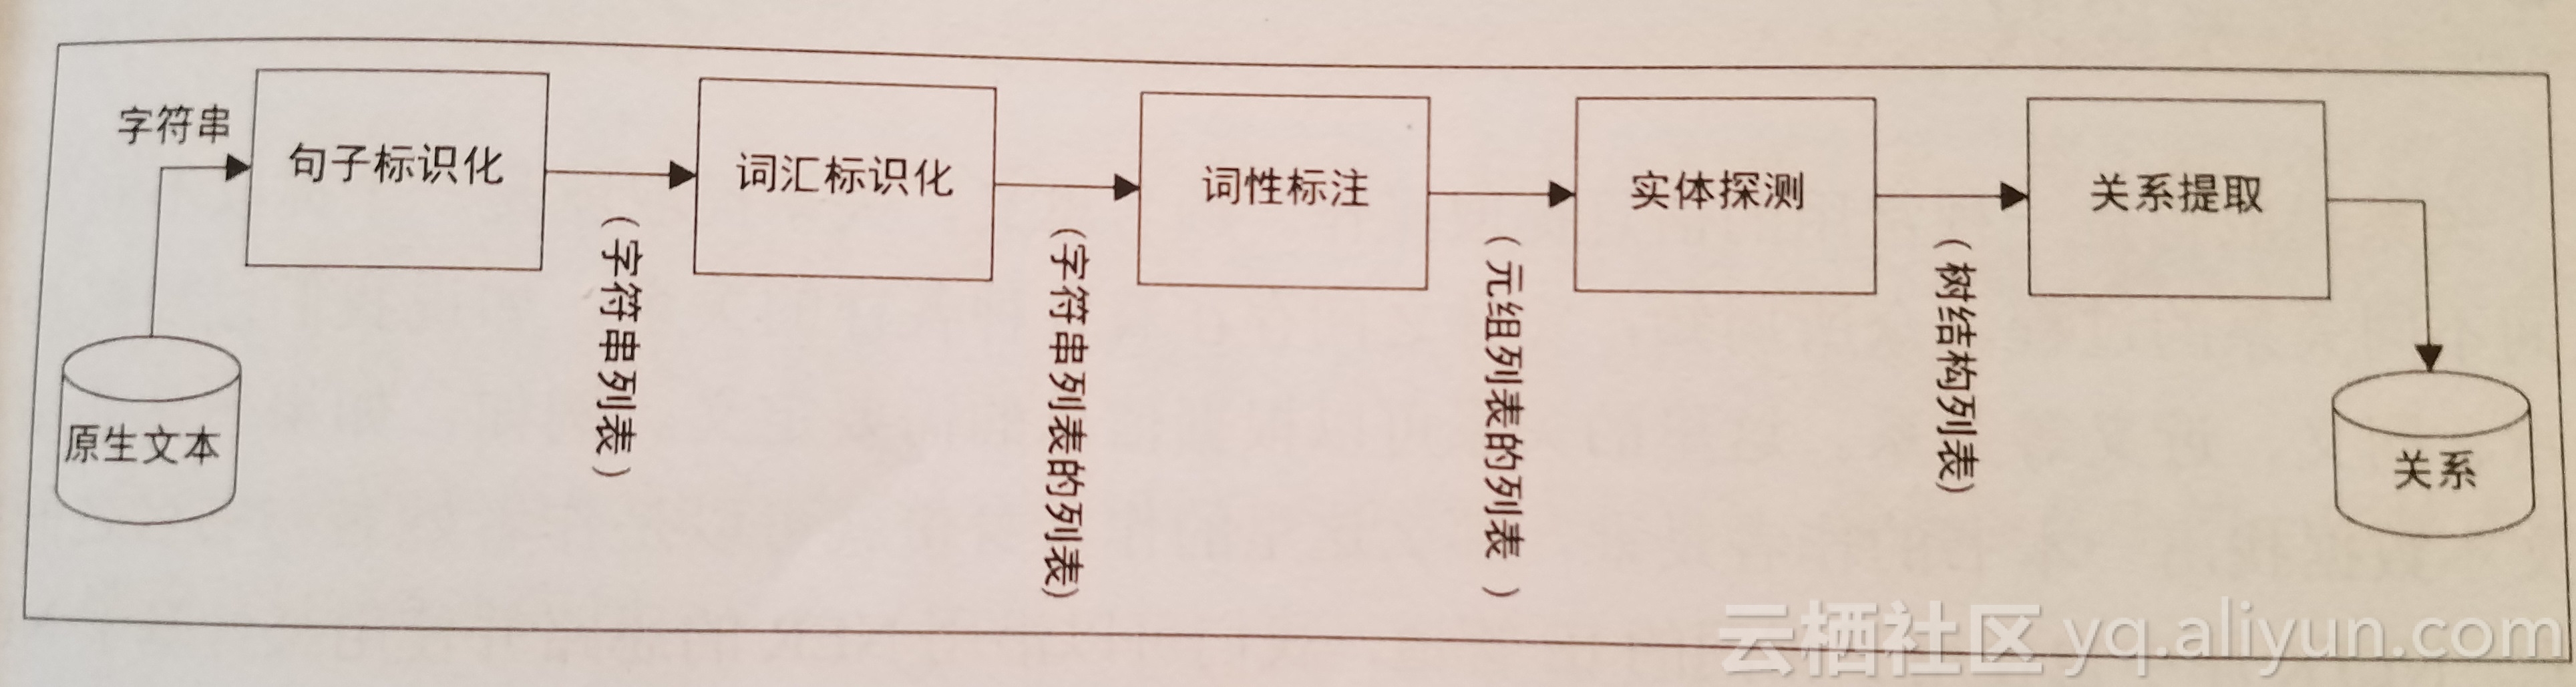
语块分解例子: from nltk.chunk.regexp import * import nltk test_sent="The prime minister announced he had asked the chief government whip, Philip Ruddock, to call a special party room meeting for 9am on Monday to consider the spill motion." test_sent_pos=nltk.pos_tag(nltk.word_tokenize(test_sent)) rule_vp=ChunkRule(r'(<VB.*>)?(<VB.*>)+(PRP)?','Chunk VPs') parser_vp=RegexpChunkParser([rule_vp],chunk_label='VP') print(parser_vp.parse(test_sent_pos)) rule_np=ChunkRule(r'(<DT>?<RB>?)?<JJ|CD>*(<JJ|CD><,>)*(<NN.*>)+','Chunk NPs') parser_np=RegexpChunkParser([rule_np],chunk_label="NP") print(parser_np.parse(test_sent_pos)) 结果: (S The/DT prime/JJ minister/NN (VP announced/VBD) he/PRP (VP had/VBD asked/VBN) the/DT chief/JJ government/NN whip/NN ,/, Philip/NNP Ruddock/NNP ,/, to/TO (VP call/VB) a/DT special/JJ party/NN room/NN meeting/NN for/IN 9am/CD on/IN Monday/NNP to/TO (VP consider/VB) the/DT spill/NN motion/NN ./.) (S (NP The/DT prime/JJ minister/NN) announced/VBD he/PRP had/VBD asked/VBN (NP the/DT chief/JJ government/NN whip/NN) ,/, (NP Philip/NNP Ruddock/NNP) ,/, to/TO call/VB (NP a/DT special/JJ party/NN room/NN meeting/NN) for/IN 9am/CD on/IN (NP Monday/NNP) to/TO consider/VB (NP the/DT spill/NN motion/NN) ./.) 上述代码是用来对动词,和名词进行划分操作,语块分解过程中会有一条管道,作用his标记POS标签,并为相关的语块分解器提供输入字符串,这里使用的是普通的语块分解器,其中的NP、VP规则定义了各种不同的可被称为动词与名词短语的POS模式。例如,NP规则定义的是所有以限定词开头,后接一个副词、形容词或纯数字的可被分解成一个名词短语的组合,这种基于一个表达式的语块分解器得依靠手动涉及分块字符串来定义分块规则。但普适式的规则很难找到。另一种方法是用机器学习的方法来进行语块的分解。信息提取:介绍了如何用NLTK库来开发一个信息提取(IE)引擎。一个典型的信息抽取管道在结构上都是非常类似的具体如下图:命名实体识别(NER)从本质上讲NER是一种提取信息的方式,它提取的是一些最常见的实体信息,如实体名词,所属的组织,以及所在的位置等。某些NER也可用于提取一般实体,如产品名词,生物医学项目、作者姓名、品牌名等。下面是一个例子: import nltk f=open('nerdemo.txt') text=f.read() sentences=nltk.sent_tokenize(text) tokenized_sentences = [nltk.word_tokenize(sentence) for sentence in sentences] tagged_sentences = [nltk.pos_tag(sentence) for sentence in tokenized_sentences] for sent in tagged_sentences: print(nltk.ne_chunk(sent)) 结果: (S I/PRP want/VBP the/DT (GPE Cherry/NNP) keyboard/NN) 上面代码按照之前的相同管道流程走了一遍,执行了所有的预处理步骤,包括句子的标识化,词汇标识化、词性标注以及NLTK的NER(预训练模型)等用来提取所有NER的步骤。关系提取:关系提取是常用的信息提取操作。是提取不同实体之间不同的关系的过程,这里的关系可以根据信息的需要定义。下面的代码中,使用了ieer的内置语料库,会对句子进行NER标注,这里唯一需要做的是指定所需的关系模式,以及该关系所定义NER种类,下面代码中组织与位置之间的关系已经被定义好了,要要提取的是这些模式的所有组合。 import re import nltk IN = re.compile(r'.*\bin\b(?!\b.+ing)') for doc in nltk.corpus.ieer.parsed_docs('NYT_19980315'): for rel in nltk.sem.extract_rels('ORG', 'LOC', doc, corpus='ieer', pattern=IN): print(nltk.sem.rtuple(rel)) 结果: [ORG: 'WHYY'] 'in' [LOC: 'Philadelphia'] [ORG: 'McGlashan &AMP; Sarrail'] 'firm in' [LOC: 'San Mateo'] [ORG: 'Freedom Forum'] 'in' [LOC: 'Arlington'] [ORG: 'Brookings Institution'] ', the research group in' [LOC: 'Washington'] [ORG: 'Idealab'] ', a self-described business incubator based in' [LOC: 'Los Angeles'] [ORG: 'Open Text'] ', based in' [LOC: 'Waterloo'] [ORG: 'WGBH'] 'in' [LOC: 'Boston'] [ORG: 'Bastille Opera'] 'in' [LOC: 'Paris'] [ORG: 'Omnicom'] 'in' [LOC: 'New York'] [ORG: 'DDB Needham'] 'in' [LOC: 'New York'] [ORG: 'Kaplan Thaler Group'] 'in' [LOC: 'New York'] [ORG: 'BBDO South'] 'in' [LOC: 'Atlanta'] [ORG: 'Georgia-Pacific'] 'in' [LOC: 'Atlanta']

优秀的个人博客,低调大师

NLTK基础教程学习笔记(十)

依赖性文本解析:依赖性文本解析(dependency parsing 简称DP)是一种现代化的文本解析机制。DP的主要概念是将各个语法单元(单词)用丁香链路串联起来。这种链路称为依赖关系(dependencies)。在目前的文本解析社区中,有大量工作在进行。尽管短语结构式文本解析(phrase structure parsing)在异乡词序自由的语言(如捷克语和土耳其语)中被广泛使用,但依赖性文本解析别被证明是一种更为有效地方法。短语结构式文本解析与依赖性文本解析之间存在着一个明显的区别,从他们所产生的解析树上可以看出来。解析书上短语结构树试图捕捉的首先是单词与短语之间的关系,然后是短语与短语之间的关系,依存关系树只关心单词与单词之间的关系如big完全依赖于dog。NLTK库也提供了一些可用于执行依存性文本解析的方法。其中一个是使用基于概率的投射依存性解析器(probabilistic,projective dependency parser),但解析器得经由某个有限训练数据集来进行训练。依存性解析器的另一种形态就是Stanford解析器。下面是一个Stanford解析器的例子:语块分解:语块分解属于浅解析,目的是将句子分解成有意义的语块,将语块定义为文本解析中的最小单元,例如将“the President speaks about the health care reforms “句子分成两个语块。第一个语块“the President”该语块由名词主导,称为名词短语(NP),另一部分由动词主导称为动词短语。将句子划分成各个部分的过程就是语块分解。从形式上看语块分解操作也可以被看作是一种处理接口,作用是识别出文本中互相不重叠的部分。对于一些文本问题想只想提取其中的关键短语,命名实体或者先关项目的特定模式,在这种情况下要做浅解析非深解析,深解析回去处理所有违法语法规则的句子,也会产生不同的语法树,直到解析器在反复回溯的过程中找到最佳的解析树,整个过程非常耗时和繁琐,并且完成了所有的这些过程也未必会得到正确的解析树。而浅解析则可以用语块来保证其浅解析的结构,这种处理相对而言要较快一些。

优秀的个人博客,低调大师

NLTK基础教程学习笔记(七)

正则表达式标注器:定义了一个这则表达式的同时定义出给定表达式所对应的标签。下面会看到一些常见的正则表达式是如何获取不同词性的。其中有一些模式都有各自关联的POS类别。 from nltk.tag.sequential import RegexpTagger from nltk.corpus import brown brown_tagged_sents=brown.tagged_sents(categories='news') train_data=brown_tagged_sents[:int(len(brown_tagged_sents)*0.9)] test_data=brown_tagged_sents[int(len(brown_tagged_sents)*0.9):] regexp_tagger = RegexpTagger( [( r'^-?[0-9]+(.[0-9]+)?$', 'CD'), # cardinal numbers ( r'(The|the|A|a|An|an)$', 'AT'), # articles ( r'.*able$', 'JJ'), # adjectives ( r'.*ness$', 'NN'), # nouns formed from adj ( r'.*ly$', 'RB'), # adverbs ( r'.*s$', 'NNS'), # plural nouns ( r'.*ing$', 'VBG'), # gerunds (r'.*ed$', 'VBD'), # past tense verbs (r'.*', 'NN') # nouns (default) ]) print(regexp_tagger.evaluate(test_data)) 结果: 0.31306687929831556 这里应用一些基于POS的显模式能到到30%的正确率。通过BackoffTagger就有可能提高性能。尝试着通过UnigramTagger from nltk.tag.sequential import RegexpTagger from nltk.corpus import brown import nltk from nltk.tag import UnigramTagger brown_tagged_sents=brown.tagged_sents(categories='news') train_data=brown_tagged_sents[:int(len(brown_tagged_sents)*0.9)] test_data=brown_tagged_sents[int(len(brown_tagged_sents)*0.9):] regexp_tagger = RegexpTagger( [( r'^-?[0-9]+(.[0-9]+)?$', 'CD'), # cardinal numbers ( r'(The|the|A|a|An|an)$', 'AT'), # articles ( r'.*able$', 'JJ'), # adjectives ( r'.*ness$', 'NN'), # nouns formed from adj ( r'.*ly$', 'RB'), # adverbs ( r'.*s$', 'NNS'), # plural nouns ( r'.*ing$', 'VBG'), # gerunds (r'.*ed$', 'VBD'), # past tense verbs (r'.*', 'NN') # nouns (default) ]) Unigram_tagger=UnigramTagger(train_data,backoff=regexp_tagger) print(Unigram_tagger.evaluate(test_data)) 结果为: 0.8656433768563739 相较于之前的确有略微地提升Brill标注器:Bril标注器是一种基于转换操作的标注器,其思路是先对标签做一个猜想,然后在下一轮迭代中基于标注器接下来所学到的规则设置返回到原先的错误上并修复它。是一种半监督的标注方式,与N-gram不同的是后者会在训练过程中对N-gram模式来进行计数,这里我们要查找的是转换规则。基于机器学习的标注器:一些标注器内部都是黑盒子,如pos——tag内部使用的是最大熵分类器(MEC),StanfordTagger所采用的也是最大熵标注器但属于不同的模型。其中有很多是基于隐马尔科夫随机场(HMM)和条件随机场(CRF)的标注器都是生成模型。命名实体识别(NER):除了POS之外在文本中找出命名实体项也是最常见的标签化问题,通常情况下NER主要由实体、位置和组织构成。这也可以视为一个顺序化标签的问题,可以利用上下文语境和其他相关特性来标签化这些命名体。NLTK库中NER标注的方式有两种:1是基于事先标注好的NER模型2是建立一个机器学习的模型。NER标注器:NLTK提供的命名实体提取方式是ne_chunk().用一个例子来显示如何对任意的语句进行标注。这种方法需要先进性文本的预处理,即先对语句进行标识化处理,然后再进行语块分解和词性标注的处理顺序,之后才能进行命名实体的标注: import nltk from nltk import word_tokenize from nltk import ne_chunk Sent="Mark is studying at Standford University in California." print(ne_chunk(nltk.pos_tag(word_tokenize(Sent)),binary=False)) 结果: (S (PERSON Mark/NNP) is/VBZ studying/VBG at/IN (ORGANIZATION Standford/NNP University/NNP) in/IN (GPE California/NNP) ./.) 可以看到ne_chunking方法主要用于姓名,地点,如果binary设置True,给出句子树结构和标签。

优秀的个人博客,低调大师

NLTK基础教程学习笔记(八)

浅解析与深解析:通常情况下,在深入解析或者全面解析的过程中,像CFG(Context-Free Grammer,上下文无关语法),PCFG(即probabilistic context-free grammar,概率性上下文无关语法)以及搜索策略这样的语法概念的作用都是要将一套完整的语法结构运用的某个句子上。其中浅解析(shallow parsing)是一种面向给定文本的,对其语法信息部分控模型的有限解析任务。而深解析(deep parsing)则是一种更为复杂的应用。一般来说,深解析比较适合于对话系统和文本综述这样的应用场景,而浅解析更适合于信息提取和文本挖掘这一类的应用。两种解析方法:文本解析方法主要有两种,其具体情况如下所示:基于规则的方法:该方法基于规则和语法,在该方法中我们将会基于CFG等语法概念来撰写语法规则手册,是一种自上而下的方法,该方法中包含了CFG和基于表达式的解析器。基于概率的方法:在该方法中通过概率模型来学习规则和语法,该方法使用的是所观测到的相关语言特征的出现概率,是一个自下而上的方法,方法中包含了PCFG和stanford解析器。为什么要进行解析?编写解析器时,能提出一组可被当作某种模板的规则,这些规则就能按照某种适当的顺序写出句子。另外也需要将单词分门别类即进行词性的标注。下面是一个用CFG的例子: import nltk toy_grammar=nltk.CFG.fromstring( """ S -> NP VP VP -> V NP V -> "eats" | "drinks" NP -> Det N Det -> "a" | "an" | "the" N -> "president" |"Obama" |"apple"| "coke" """) print(toy_grammar.productions()) 结果: [S -> NP VP, VP -> V NP, V -> 'eats', V -> 'drinks', NP -> Det N, Det -> 'a', Det -> 'an', Det -> 'the', N -> 'president', N -> 'Obama', N -> 'apple', N -> 'coke'] 目前这一语法概念所能产生的句子数量有限。如果出现知道如何一个名词和一个动词搭配使用,并且这些动词和名词只能来自于上述代码所列出的单词,那么大概可以搭配出这样的列句。President eats appleObama drinks coke显然我们运用所学的英语语法规则造出句子,理解也是相同的规则,但在这些规则显然不适用于莎士比亚时期所用的文体。而且同一套语法也可能会构造出一些毫无意义的句子如:Apple eats coke.President drinks Obama.当涉及到某个语法解析器时(syntactic parser)时,事实上本身就有一定的几率在语法上形成一些毫无意义的句子。如果想要获取其中的语义的话,就需要对句子有一个更深入的理解。

优秀的个人博客,低调大师

NLTK基础教程学习笔记(六)

用NLYK库实现标注任务的方式有两种:1:使用NLTK库或其他库中的预置标注器,并将其运用到测试数据上。这两种标注器应该足以应对英语文本环境,以及非特殊领域语料库中的所有词性标注任务。2:基于测试数据来创建或训练出适合的标注器。深入了解标注器:一个典型的标注器通常要用到大量的训练数据,它主要被用于标注出句子中的各种单词,并为其贴上POS标签。标注是一个纯手工的工作,具体如下: Well/UH what/WP do/VBP you/PRP think/VB about/IN the/DT idea/NN of/IN... 以上是来自Penn Treebank的语义库。其中还有一个语言数据联盟(LDC)专门用来研究不同语言的标注,不同文本种类以及不同标注操作,如词性标注,句法分析标注,以及对话标注等。通常情况下,像词性标注这样的标注问题往往会被视为顺序标签化的问题或者某种分类问题,后者特指人们为特定token所生成的正确标签,并用先关判别模型对其进行判别的一类问题。下面是分析Brown语料库中各POS标签的分布频率: from nltk.corpus import brown import nltk tags=[tag for (word,tag)in brown.tagged_words(categories='news')] print(nltk.FreqDist(tags)) out=nltk.FreqDist(tags) 结果: <FreqDist with 218 samples and 100554 outcomes> 由于个数太多无法打印,可以通过debug进去看各个词的的频率。Debug进去看可以看到NN在这里出现频率最高,可以用来创建一个POS标注器,用来给所有的测试文本分配NN标签。DefaultTagger函数是顺序性标注器,标注器会去调用evaluate()函数,该函数主要用来评估相关单词POS的准确度,是对Brown语料库的标注器所用的基准: from nltk.corpus import brown import nltk brown_tagged_sents=brown.tagged_sents(categories='news') default_tagger=nltk.DefaultTagger('NN') print(default_tagger.evaluate(brown_tagged_sents)) 结果: 0.13089484257215028 准确率大概13%左右DefaultTagger的表现并不是很好,DefaultTagger本质上只是基类SequentialBackoffTagger的一部分,后者是一个顺序性标注服务。标注器会试着基于其所处的上下文环境来模型化先关的标签。而且如果它不能进行正确的标签预测,就会去咨询BackoffTagger。通常情况下,DefaultTagger参数都可以被当作一个BackoffTagger实体来使用。N-gram标注器 from nltk.tag import UnigramTagger from nltk.tag import DefaultTagger from nltk.tag import BigramTagger from nltk.tag import TrigramTagger from nltk.corpus import brown import nltk brown_tagged_sents=brown.tagged_sents(categories='news') default_tagger=nltk.DefaultTagger('NN') train_data=brown_tagged_sents[:int(len(brown_tagged_sents)*0.9)] test_data=brown_tagged_sents[int(len(brown_tagged_sents)*0.9):] unigram_tagger=UnigramTagger(train_data,backoff=default_tagger) print(unigram_tagger.evaluate(test_data)) bigram_tagger=BigramTagger(train_data,backoff=unigram_tagger) print(bigram_tagger.evaluate(test_data)) trigram_tagger=TrigramTagger(train_data,backoff=bigram_tagger) print(trigram_tagger.evaluate(test_data)) 结果: 0.8368384331705372 0.8460081730290043 0.8439150802352238 其中,基于元模型的标注只考虑相关标签的条件概率,以及针对每个给定token所能预测到的、频率最高的标签。而bigram-tagger参数将会考虑给定的单词和该单词的前一个单词,其标签将以元组的形式来关联被测试单词所得到的标签。类似的,TrigramTagger参数将让其查找过程兼顾到给定单词的前两个单词。TrigramTagger参数的覆盖范围比较小,而实例精度则高一些。从另一方面来说,UnigramTagger的覆盖范围则会大一些。为了让准确率和反馈率之间保持平衡,上述代码结合了这三种标注器。

优秀的个人博客,低调大师

NLTK基础教程学习笔记(四)

标识化处理:机器所要理解的最小处理单位是单词(分词)。标识化处理,是将原生字符创分割成一系列有意义的分词。标识化就是将原生字符串分割成一系列有意义的分词。标识化处理的复杂性因具体NLP应用而异,目标语言本身的复杂性本身也会带来相关的变化。在英语中,可以通过正则表达式简单的单词来选取纯单词和数字,但在中文中会成为一个复杂的任务 from nltk.tokenize import word_tokenize from nltk.tokenize import regexp_tokenize,wordpunct_tokenize,blankline_tokenize s="Hi Everyone! hola gr8" print(s.split()) print(word_tokenize(s)) print(regexp_tokenize(s,pattern='\w+')) print(regexp_tokenize(s,pattern='\d+')) print(wordpunct_tokenize(s)) print(blankline_tokenize(s)) 结果: ['Hi', 'Everyone!', 'hola', 'gr8'] ['Hi', 'Everyone', '!', 'hola', 'gr8'] ['Hi', 'Everyone', 'hola', 'gr8'] ['8'] ['Hi', 'Everyone', '!', 'hola', 'gr8'] ['Hi Everyone! hola gr8'] 上面用到了各种标识器(tokenizer)Python字符串类型方法split():是一个最基本的标识器,使用空白符来执行单词的分割,split()本身也可以被配置成为一些较为复杂的标识化处理。word_tokensize()方法是一个通用的,强大的,面向对象的可面向对象所有类型预料库的标识化处理方法。regex_tokensize()是一个位用户需求设计的,自定义程度更高的表示器,如用可以基于正则表达式的标识器分割出相同的字符串,用/w分割出单词和数字用/d对数字进行提取词干提取:词干提取(stemming)是一个修枝剪叶的过程,通过一些基本的规则,可以得到所有的分词。词干提取是一种较为粗糙的过程,希望用它来取得相关的分词的各种变化,如eat这个词会有像eating,eaten,eats等变化。在某些情况下不需要区别这些,通常会用词干提取的方法将这些变化归结为相同的词根。对于简单的方法我们可以用词干提取,对于较为复杂的NLP问题,我们必须改用词形还原(lemmatization):下面是一个词干提取的例子: from nltk.stem import PorterStemmer from nltk.stem.lancaster import LancasterStemmer from nltk.stem.snowball import SnowballStemmer pst=PorterStemmer() lst=LancasterStemmer() print(lst.stem("eating")) print(pst.stem("shopping")) 结果: eat shop 一个拥有基本规则的词干提取器,在像移除-s/es、-ing或-ed这里事情上都可以达到70%的精确度。Poster1和lancaStemmer有更多的规则,精确度会更加高。当多种词干提取算法介入时,精确度和性能上会有差异。Snowball能处理荷兰语,英语,法语,德语,意大利语,葡萄牙语,罗马尼亚语和俄语等语言。词形还原:词形还原(lemmatization)涵盖了词根所有的文法和变化形式,还会利用上下文语境和词性来确定相关单词的变化,并运用不同的标准化规则,根据词性来获取相关的词根。 from nltk.stem import WordNetLemmatizer wlem=WordNetLemmatizer() print(wlem.lemmatize("ate")) 结果 ate WordNetLemmatizer使用了wordnet,会针对某个单词去搜索wordnet这个语义字典,还用到了变形分析,以便直切词根并搜索到特殊词形。停用词移除:停用词移除(Stop word removal)简单的移除预料库中在所有文档中可能出现的单词,通常是冠词和代词。 from nltk.corpus import stopwords stoplist=stopwords.words('english') #print(stoplist) text="This is just a test" out=cleanwordlist=[word for word in text.split() if word not in stoplist] print(out) 结果: ['This', 'test']

优秀的个人博客,低调大师

NLTK基础教程学习笔记(五)

词性标注:词性(POS)常用的POS标记库Penn Treebank,PennTreeBank原本是一个NLP项目的名称,该项目主要是对相关语料进行标注,标注内容包括词性标注以及语法分析,其语料来自1989年的华尔街日报,包含2499篇文章。下面是Penn Treebank库编号 缩写 英文 中文1 CC Coordinating conjunction 并列连接词2 CD Cardinal number 基数3 DT Determiner 限定词4 EX Existential there 存在型there5 FW Foreign word 外文单词6 IN Preposition/subord, conjunction 介词/从属,连接词7 JJ Adjective 形容词8 JJR Adjective, comparative 形容词,比较级9 JJS Adjective, superlative 形容词,最高级10 LS List item marker 列表项标记11 MD Modal 情态动词12 NN Noun ,singular or mass 名词,可数或不可数13 NNS Noun, plural 名词,复数14 NNP Proper noun, singular 专有名词,单数15 NNPS Proper noun, plural 专有名词,复数16 PDT Predeterminer 前位限定词17 POS Possessive ending 所有格结束词18 PRP Personal pronoun 人称代名词19 PP$ Possessive pronoun 物主代词,所有格代名词20 RB Adverb 副词21 RBR Adverb, comparative 副词,比较级22 RBS Adverb, superlative 副词,最高级23 RP Particle 小品词24 SYM Symbol(mathematical or scientific) 符号(数学或科学)25 TO to To26 UH Interjection 感叹词27 VB Verb, base form 动词,基本形态28 VBD Verb, past tense 动词,过去式29 VBG Verb, gerund/present participle 动词,动名词/现在分词30 VBN Verb, past participle 动词,过去分词31 VBP Verb, non-3rd ps. sing. Present 动词,非第三人称单数现在式32 VBZ Verb, 3rd ps. sing. Present 动词,第三人称单数现在式33 WDT wh-determiner wh-限定词34 WP wh-pronoun wh-代词35 WP$ Possessive wh-pronoun 所有格wh-代词36 WRB wh-adverb wh-副词37 # Pound sign #符号38 $ Dollar sign 美元符号39 . Sentence-final punctuation 句点40 , Comma 逗号41 : Colon, semi-colon 冒号,分号42 ( Left bracket character 左括号43 ) Right bracket character 右括号44 “ Straight double quote 双引号45 ‘ Left open single quote 左单引号46 “ Left open double quote 左双引号47 ’ Right close single quote 右单引号48 ” Right close double quote 右双引号和中学时学的英语差不多。下面是一个简单的用POS语料库的例子: import nltk from nltk import word_tokenize s="I was watching TV" print(nltk.pos_tag(word_tokenize(s))) 结果: [('I', 'PRP'), ('was', 'VBD'), ('watching', 'VBG'), ('TV', 'NN')] 代码中先将文本进行表示化处理,再调用NLTK库中的pos_tag方法得到一组(词形,词性标签),可以看到很好地将一句话进行了标注。用POS语料库可以进行很多灵活的操作,如找出文本中所有的名词等: import nltk from nltk import word_tokenize s="I was watching TV" #print(nltk.pos_tag(word_tokenize(s))) tagged=nltk.pos_tag(word_tokenize(s)) allnoun=[word for word ,pos in tagged if pos in ['NN','NNP']] print (allnoun) 结果: ['TV'] 如果要找动词只需要改变pos的词性为 allnoun=[word for word ,pos in tagged if pos in ['VB','VBD','VBG ','VBN']]

优秀的个人博客,低调大师

java nio的基础--缓冲区

有一本小书,叫<java nio>, 2002年的中文版PDF。 可以看看,尽管是一本历史感很强的书, 讲解还是很细致的。 由此进深入nio2的话, 那java io的秘密, 就全部清晰了。 package com.ronsoft.books.nio.buffers; import java.nio.CharBuffer; import java.nio.Buffer; import java.nio.ByteBuffer; import java.nio.ByteOrder; public class BufferFillDrain { public static void main(String[] args) throws Exception { // TODO Auto-generated method stub CharBuffer buffer = CharBuffer.allocate(100); while (fillBuffer(buffer)) { buffer.flip(); drainBuffer(buffer); buffer.clear(); } ByteBuffer byteBuffer = ByteBuffer.allocate(7).order(ByteOrder.BIG_ENDIAN); CharBuffer charBuffer = byteBuffer.asCharBuffer(); byteBuffer.put(0, (byte)0); byteBuffer.put(1, (byte)'H'); byteBuffer.put(2, (byte)0); byteBuffer.put(3, (byte)'i'); byteBuffer.put(4, (byte)0); byteBuffer.put(5, (byte)'!'); byteBuffer.put(6, (byte)0); println(byteBuffer); println(charBuffer); } private static void drainBuffer(CharBuffer buffer) { while (buffer.hasRemaining()) { System.out.print(buffer.get()); } System.out.println(""); } private static boolean fillBuffer(CharBuffer buffer) { if (index >= strings.length) { return (false); } String string = strings[index++]; for (int i = 0; i < string.length(); i++) { buffer.put(string.charAt(i)); } return (true); } private static int index = 0; private static String []strings = { "A random string value", "The product of an infinite number of monkeys", "Hey hey we're the Monkees", "Opening act for the Monkees: Jimi Hendrix", "'Scuse me while I kill this fly", "Help Me! Help Me!", }; private static void println(Buffer buffer) { System.out.println("post=" + buffer.position() + ", limit=" + buffer.limit() + ", capacity=" + buffer.capacity() + ": '" + buffer.toString() + "'"); } } 输出如下: A random string value The product of an infinite number of monkeys Hey hey we're the Monkees Opening act for the Monkees: Jimi Hendrix 'Scuse me while I kill this fly Help Me! Help Me! post=0, limit=7, capacity=7: 'java.nio.HeapByteBuffer[pos=0 lim=7 cap=7]' post=0, limit=3, capacity=3: 'Hi!'

优秀的个人博客,低调大师

PowerShell中的基础数据类型

PowerShell是一个面向对象的语言,在申明变量的时候不强制要求申明数据类型,使用$开头来申明变量即可。 基本数据类型 PowerShell本身是基于.Net开发出来的,所以在.Net中的基本数据类型,在PowerShell中也可以使用,只是在PowerShell中用”[]”来标识具体的数据类型。比如[int],[long],[string],[bool],[double]等。 使用-is来判断某个变量是否指定的数据类型,和C#中的is关键字是一样的。比如: $a=10; $a -is[int] $a -is[double] 第二行返回True,第三行返回False。 我们也可以在定义变量时指定数据类型。比如我们要定义decimal类型的10,那么可以写为: [decimal] $c=10 $c.GetType() 可以看到我们的类型为Decimal。 数据类型转换 关于默认数据类型转换,PowerShell和C#的行为有所不同。PowerShell会根据第一个变量的类型作为目标类型,然后将运算后面的联系转换为第一个类型。比如我们申明两个变量: $a=10; $b= " 10 "; 如果我们使用加法运算: $a+ $b 该运算会返回20,因为第一个变量是int类型的,所以后面的变量都会转换为int类型。如果我们调整变量的顺序: $b+ $a 该运算返回的结果为1010,因为第一个变量是string类型。习惯了C#的默认类型转换,那么我们可以强制进行类型转换后再进行运算。强制类型转换的方法也是与C#相同。 比如我们要按int类型来计算,那么我们第二个加法可以改为: [int] $b+ $a 我们也可以使用-as命令,那么第二个加法改为: ( $b -as[int])+ $a List/Array类型 我们平时使用的各种Get-XXX命令,很多都是返回对应类型的Array,比如Get-Process. 如果我们要定义一个集合,那么可以使用”@(对象1,对象2,对象3…)”的格式申明集合。比如我们定义一个字符串集合: $a=@('a','bb','ccc') 其实不使用@和括号也是可以的,只需要用逗号分割各个Item即可。 $a='aaa','bb','c' 如果是申明一个空的集合,就必须写为: $a=@() 与C#不同的是,在PowerShell中,往集合中添加元素,可以使用+=符号。 $a=@() $a+= " abc " $a+= " dddd " Write-Host $a 如果要移除某个元素,那么就不简单了,需要使用Where查询(简写为?),找出要保留的元素,然后将保留的元素集合再重新赋值会变量。比如对于字符串集合,我们要移除字符c,那么操作如下: $a=@('aaa','bb','c') $a= $a|?{ $_ -ne'c'} Write-Host $a 访问某个元素使用[idx]即可和C#相同。至于对集合的各种操作,可以参见我上一篇博文。 Hashtable/Dictionary类型 哈希表就是一个Key-Value对的集合。哈希表的创建格式如下: @{Key1=Value1;Key2=Value2;…} 这里Key一般是字符串,但是并不需要用引号引起来(当然,使用了引号更好),Value可以是任意类型。比如我们创建一个员工和部门的Hashtable,命令如下: $a=@{Devin= " IT ";Edward= " Finance ";Jeneen= " Sale "} 使用keys属性可以获得哈希表的Key列表,使用values属性可以获得Value列表。 如果要往哈希表中添加元素,可以使用.Add(Key,Value)方法。比如添加一个员工: $a.Add( " Julia ", " Logisitcs ") 这里需要注意的是Key必须要带引号。而且哈希表的Key是不允许重复的,如果已经存在相同的值,添加会报错。可以先判断Key是否存在,然后再添加: if( -not $a.ContainsKey( " Julia ")) { $a.Add( " Julia ", " Logisitcs ") } 如果要移除某个Key对应的元素,那么可以调用.Remove(Key)函数即可。 $a.Remove( " Julia ") 如果要访问某个Key对应的值,有两种方法: $a[ " Devin "] $a.Devin 需要注意的是,直接对哈希表进行Sort-Object是没有效的,我们必须先调用GetEnumerator方法,把哈希表转换后在执行Sort。 $a.GetEnumerator()|Sort-ObjectName 本文转自深蓝居博客园博客,原文链接:http://www.cnblogs.com/studyzy/p/4521367.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

c语言基础学习02_helloworld

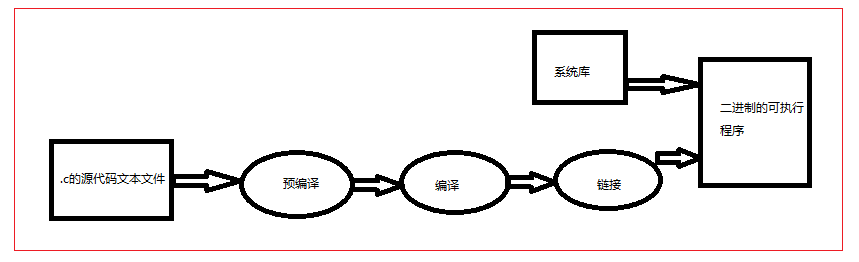
=============================================================================涉及到的知识点有:include有两种用法、{}大括号用法解释、C语言自定义名字的要求、c语言库函数printf的解释、编译错误有两种、调用system函数、c语言编译过程、操作系统结构、指令集中的cpu架构 、QT常用快捷键、vs常用快捷键 =============================================================================将windows的可执行文件上传到linux,看能够执行吗?sftp> put a.exe 出现下面错误:没有权限;拒绝访问-bash: ./a.exe: Permission denied那我们提升下a.exe的权限试试chmod u+x a.exe 则出现下面错误:不能执行二进制文件:执行格式错误-bash: ./a.exe: cannot execute binary file: Exec format error说明windows的可执行文件不能再linux系统下执行 fatal error 致命错误 =============================================================================#include的意思是头文件包含,使用c语言库函数需要提前包含所用到的库函数对应的头文件c语言中如果要用到printf函数,在使用前必须 #include <stdio.h>-----------------------------------------------------------------------------include有两种用法:1、#include <文件名> 说明需要包含的文件在系统目录下2、#include “文件名” 说明需要包含的文件在当前目录下-----------------------------------------------------------------------------可执行代码必须放在{}大括号里面; 在c语言中一行只写一个分号是可以的,表示是空语句。c语言中一组大括号里也可以再有多组大括号。-----------------------------------------------------------------------------int a; //定义一个变量。extern int b; //声明一个变量。-----------------------------------------------------------------------------C语言自定义名字的要求:可以使用大小写字母、下划线、数字,但第一个字母必须是字母或者下划线。且字母区分大小写。(注意:BASIC语言不区分大小写)----------------------------------------------------------------------------- printf 是c语言库函数,功能是:向标准输出设备输出一个字符串(注意:标准输出设备不仅仅指的是控制台、屏幕,还有打印机等等什么的。)printf 函数只能用在控制台程序里面(就是字符界面下的),不能用在图形界面下,即不能把一个字符串输出到窗口里面。可以通过命令 man 3 printf 来查看。 -----------------------------------------------------------------------------编译错误有两种warning 不影响编译,只是警告。error 编译器彻底罢工了,不干活了。----------------------------------------------------------------------------- 第一种写法: int main(){ return 0;} 第二种写法: void main(){ return ; //或者可以这句话不用写} 对c语言,两种写法都对,但对于C++来讲,只支持第一种写法。-----------------------------------------------------------------------------在main函数中return 0; 代表程序执行成功,return -1; 代表程序执行失败。-----------------------------------------------------------------------------c语言文件的扩展名是.c,C++文件的扩展名就是cpp linux系统并不用后缀名来区分文件;Linux不像Windows一样区分文件后缀的,所以是可以改的,而且不影响使用的。 1,mv可以移动文件,也可以用作更改文件名。 2,修改命名:mv fileName.type fileName.newType就可以更改文件后缀了。 3,但是一些特定的文件不要随意更改,例如配置文件。=============================================================================在使用system之前需要包含stdlib.h这个头文件,调用system函数,可以在c语言的代码中执行另外一个程序-----------------------------------------------------------------------------如果在命令行执行一个程序,那么这个程序的调用者就是操作系统; 如果在代码中通过system,执行一个程序,那么这个程序的调用者就是自己写的代码本身。 c语言所有的库函数调用,只能保证语法是一致的,但不能保证执行结果是一致的,同样的,库函数在不同的操作系统下执行结果可能是一样的,也可能是不一样的。 不同平台下的c语言的库函数只能保证调用语法一样,但不能保证执行结果也是一样的。(因为c语言对硬件的要求、对操作系统的要求太多啦!)所以用C语言在不同的平台写代码的时候,可能会有一些移植的工作量。-----------------------------------------------------------------------------POSIX是一个标准,只要符合这个标准的函数,在不同的系统下执行的结果就可以一致。如果有符合posix标准的函数,尽量使用。 Unix和Linux很多库函数都是支持POSIX的,但windows支持的比较差。(曾经微软说过要表示大力支持,但说得多做得少!)所以说,如果将Unix代码移植到Linux一般代价很小,如果把windows代码移植到Unix或者linux就比较麻烦。-----------------------------------------------------------------------------system 返回的是一个整数。即system的返回值就是所被调用程序中main函数的return的值。 =============================================================================c语言编译过程1、预编译 --> 2、编译 --> 3、链接-----------------------------------------------------------------------------预编译命令:gcc -o cc1.c c1.c -E 或者 gcc -o cc1.c -E c1.c 或者 gcc -E c1.c -o cc1.c(注意:-o 作用是指定输出文件的名字,如果不加-o的话,则生成的文件名字总叫a.out)预编译c1.c,预编译之后得到的文件的名字叫cc1.c。(注意:编译后的名字可以随意起,但是呢我们知道预编译后的文件还是文本的.c文件,所以为了好区分起名字为 xxx.c)在c语言中#开头的语句又叫预编译指令。#include <stdio.h>预编译的功能之一:会把include包含的头文件内容做一个简单的替换,即替换到.c文件里面去。......//此处省略1万行......预编译的功能之二:会把代码中的注释去掉。-----------------------------------------------------------------------------编译的命令:gcc -o cc1.o cc1.c -c 或者 gcc -o cc1.o -c cc1.c 或者gcc -c cc1.c -o cc1.o编译cc1.c,编译之后得到的文件名字叫cc1.o.编译的功能是:把文本的c语言编译为二进制指令。-----------------------------------------------------------------------------链接的命令:gcc -o c1 cc1.o 或者 gcc cc1.o -o c1(注意:gcc没有单独的链接参数) 将系统库函数与cc1.o进行链接(简言之合并),得到可执行的程序,该程序的名字叫c1。 我们想知道在linux系统下到底链接来了什么库来呢?(即可执行程序需要用到什么库呢?)使用命令 ldd c1 查看。 (注意;用c语言写的代码依赖的库最少,如果使用其他语言依赖的库更多哦!!需要装好多包包。)那么在windows系统下的可执行程序需要用到什么库呢?使用一个小软件Depends.exe可以查看的到。 =============================================================================操作系统结构 1、用户模式 我们目前写的程序都是在用户模式下运行的。2、内核模式 操作系统本身、设备驱动等这些软件是在内核模式下运行的。-----------------------------------------------------------------------------一个CPU的一个寄存器可以放8个二进制位。例如:0000 00001111 1111则这个CPU就是8位的CPU。-----------------------------------------------------------------------------一个CPU的一个寄存器可以放16个二进制位。0000 0000 0000 00001111 1111 1111 1111则这个CPU就是16位CPU。-----------------------------------------------------------------------------总线有三种:数据总线、地址总线、控制总线。总线在大多数时候和CPU的寄存器位数是相同的。 8位CPU的总线是8位。1111 1111f f256BYTE(255字节) 16位CPU的总线是16位。1111 1111 1111 1111f f f f65536BYTE(64k字节) 32位CPU的总线是32位。1111 1111 1111 1111 1111 1111 1111 1111f f f f f f f f32位CPU管理内存有一个最大值,4G字节 = 4 x 1024M = 4 x 1024 x 1024 x 1024Byte(字节)。 64位CPU的总线是64位。1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111f f f f f f f f f f f f f f f f理论上64位CPU管理内存是:2^64个字节,但同时又取决于综合的指标:比如主板、操作系统的支持等等。但至少是远远大于4G的。 如果寄存器是64位,但总线是32位,这种cpu叫准64位CPU。(即里面可以做到很宽,但是外面的工艺却达不到) 若在64位的CPU架构上运行了64位的软件操作系统,那么这个系统是64位的;若在64位的CPU架构上运行了32位的软件操作系统,那么这个系统是32位的。-----------------------------------------------------------------------------指令集中的cpu架构 精简指令集RISC(服务器端用的)比如:SPARC、ARM属于精简指令集。 复杂指令集CISC(比如Inter的CPU)比如:X86属于典型的复杂指令集。-----------------------------------------------------------------------------cpu内部里面所有的计算都得在寄存器里面来完成。 cpu内部的寄存器还有名字哦:8位cpu(x86构架) 16位CPU 32位CPU 64位CPU a ax,al,ah eax rax b bx,bl,bh ebx rbx c cx ecx rcx d dx edx rdx-----------------------------------------------------------------------------使用Qt时,再用到system函数时,会出现一个控制台的窗口。为什么呢?答:因为system函数在windows系统下就是一个基于控制台的函数(就是字符界面的函数),所以即使在图形界面下调用system也会出现一个控制台窗口。那么如何在图形界面下调用该函数又不显示控制台呢?答:可以换另外一个函数啊!该函数是 WinExec("notepad",SW_NORMAL); 但是该函数需要包含一个头文件是 #include <windows.h>。 QT常用快捷键Ctrl + I 自动格式化代码Ctrl + / 注释代码/取消注释代码Ctrl + r 不调试运行代码Ctrl + b 编译代码但不运行代码Alt + enter 自动完成类函数定义F9 设置断点F5 调试运行F10 next调试F11 step调试-----------------------------------------------------------------------------vs常用快捷键Ctrl + F5 不调试运行代码Ctrl + k,Ctrl + f 自动格式化代码Ctrl + k,Ctrl + c 注释代码Ctrl + k,Ctrl + u 取消注释代码Ctrl + Shift + b 编译,不运行代码F5 调试运行F9 设置断点 注意:C语言以分号结尾的,而不是以行结尾的。=============================================================================我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

smart_Activity互相跳转——基础编

让我们看一下原代码: packagecom.smart.activity; importandroid.app.Activity; importandroid.content.ComponentName; importandroid.content.Intent; importandroid.os.Bundle; importandroid.view.View; importandroid.widget.Button; publicclassMainextendsActivity{ //ANDROID系统,组件与组件之间是通过,INTENT进行通信的。 @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.main); Buttonbutton=(Button)this.findViewById(R.id.button); button.setOnClickListener(newView.OnClickListener(){ @Override publicvoidonClick(Viewv){ //打开新的Activity //第一种方法调用 Intentintent=newIntent(Main.this,SmartActivity.class); //打开应用的组件 Main.this.startActivity(intent); //第二种方法调用 //Intentintent=newIntent(); //intent.setClass(Main.this,SmartActivity.class); //第三种方法调用 //Intentintent=newIntent(); //intent.setComponent(newComponentName(Main.this,SmartActivity.class)); //意思是讲三种方法调查用,意是一样的, //一般来讲用第一种 } }); } } packagecom.smart.activity; importandroid.app.Activity; importandroid.content.Intent; importandroid.os.Bundle; importandroid.view.View; importandroid.widget.Button; publicclassSmartActivityextendsActivity{ @Override protectedvoidonCreate(BundlesavedInstanceState){ //关于这行代码,是完成界面的代码 super.onCreate(savedInstanceState); setContentView(R.layout.smart); Buttonbutton2=(Button)this.findViewById(R.id.button2); button2.setOnClickListener(newView.OnClickListener(){ @Override publicvoidonClick(Viewv){ //打开新的Activity //第一种方法调用 Intentintent=newIntent(SmartActivity.this,Main.class); //打开应用的组件 SmartActivity.this.startActivity(intent); //第二种方法调用 //Intentintent=newIntent(); //intent.setClass(Main.this,SmartActivity.class); //第三种方法调用 //Intentintent=newIntent(); //intent.setComponent(newComponentName(Main.this,SmartActivity.class)); //意思是讲三种方法调查用,意是一样的, //一般来讲用第一种 } }); } } 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/490078,如需转载请自行联系原作者

优秀的个人博客,低调大师

确定取消经典之作——基础编

让我们看一下效果图 packagecom.smart; importandroid.app.Activity; importandroid.app.AlertDialog; importandroid.content.DialogInterface; importandroid.os.Bundle; importandroid.view.View; importandroid.view.View.OnClickListener; importandroid.widget.Button; /** *不知道看的朋友,认识,如何,我觉得挺经典的按钮之作 *如有问题,请发自llb988@126.com **/ publicclassMainextendsActivityimplementsOnClickListener{ /**Calledwhentheactivityisfirstcreated.*/ @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.main); //得到按钮ID Buttonbutton=(Button)findViewById(R.id.button); //进行监听 button.setOnClickListener(this); } @Override//断送确定与取消方法 publicvoidonClick(Viewv){ newAlertDialog.Builder(this).setIcon(R.drawable.question).setTitle("是否删除文件").setPositiveButton("确定",newDialogInterface.OnClickListener(){ @Override publicvoidonClick(DialogInterfacedialog,intwhich){ newAlertDialog.Builder(Main.this).setMessage("文件已删除").create().show(); } }).setNegativeButton("取消",newDialogInterface.OnClickListener(){ @Override publicvoidonClick(DialogInterfacedialog,intwhich){ newAlertDialog.Builder(Main.this).setMessage("您选择取消按钮,文件未被删除").create().show(); } }).show(); } } 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/489541,如需转载请自行联系原作者

优秀的个人博客,低调大师

Toast使用方法——简单基础编

Toast内容显示图 packagecom.smart; importandroid.app.Activity; importandroid.content.DialogInterface; importandroid.os.Bundle; importandroid.view.View; importandroid.view.View.OnClickListener; importandroid.widget.Button; importandroid.widget.TextView; importandroid.widget.Toast; publicclassMainextendsActivityimplementsOnClickListener{ @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.main);//得到参数 ButtonbtnTextToast=(Button)findViewById(R.id.btnTextToast); ButtonbtnImageToast=(Button)findViewById(R.id.btnImageToast); btnTextToast.setOnClickListener(this);//绑定器 btnImageToast.setOnClickListener(this); } //点击方法事件 @Override publicvoidonClick(Viewv){ switch(v.getId()){ caseR.id.btnTextToast: //使用TOAST方法显示结果内容 ToasttextToast=Toast.makeText(this,"新年好,我的朋友们,\n哈,哈,哈!",Toast.LENGTH_LONG); textToast.show(); break; caseR.id.btnImageToast: Viewview=getLayoutInflater().inflate(R.layout.toast,null); TextViewtextView=(TextView)view.findViewById(R.id.smart); //使用TOAST方法显示结果内容 textView.setText("新年好,我的朋友们,\n哈,哈,哈!"); Toasttoast=newToast(this); toast.setDuration(Toast.LENGTH_LONG); toast.setView(view); toast.show(); break; } } } 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/489546,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册