首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

Java 基础 之 关系运算符

http://www.verejava.com/?id=16992594990214 public class Operation3 { public static void main(String[] args) { //关系运算符 只有两种结果:真 true, 假 false /* 包括: 大于 >, 大于等于 >= 小于 <, 小于等于 <= 等于==, 不等于 != */ System.out.println(1>2); System.out.println(1>=1); System.out.println(1<2); System.out.println(1<=2); System.out.println(1==1); System.out.println(1!=2); System.out.println(1==1.0); System.out.println('A'==65); //true 不能等于1 ,false 不能等于 0; //System.out.println(true==1); } } http://www.verejava.com/?id=16992594990214

优秀的个人博客,低调大师

Java 基础 之 算数运算符

http://www.verejava.com/?id=16992579787012 /* 1. 算数运算 */ public class Operation { public static void main(String[] args) { //1. 算数运算 加+,减-,乘*,整除/,取模%,自减--,自增++ int a=1; int b=2; int c=3; int d=4; System.out.println(a+b); System.out.println(a-b); System.out.println(a*b); System.out.println(b/a); System.out.println(a/b); //取模就是整除后余下的数 System.out.println(c%b); System.out.println(d%b); System.out.println(4%-3); System.out.println(-4%-3); System.out.println(-4%3); System.out.println(d++); System.out.println(++d); System.out.println(d--); System.out.println(--d); /* 注意: 1. 整除的时候会自动切除小数部分 2. 取模的时候结果值的正负取决于分子的符号 3. 对于自增++在变量后面时是先输出,再加1, 如果++放在变量前面则是先加+再输出计算。 4. 对于自减在变量后面时是先输出再减1,如果放在变量后面是先减1再输出计算 */ } } http://www.verejava.com/?id=16992579787012

优秀的个人博客,低调大师

JavaScript 基础 --- (数据类型/循环/条件)

一、js 输出1.window.alert() 警告框 2.document.write() 写到 HTML 文档中 3.innerHTML 写到 HTML 元素 4.console.log() 写到浏览器的控制台 二、js 语句与注释 1. ; (var a = 1;) ;表示语句的结尾 2. 语句标识符:var / if / for 等 3.注释:单行 // 多行 /* */三、数据类型 1.未定义 (undefined) var x; //x 为 undefined(表示变量不含有值) 2.数字 (Number) var y = 5; //y 为数字 3.字符串 (String) var z = "John" // z为字符串 4.布尔 (Boolean) var a = true; //a 为 布尔类型 5.对象 (Object) var person ={firstname:"John",lastname:"Doe",id:5566}; 取值:console.log(person.firstname) console.log(person["firstname"]) 6.数组 (Array) 6-1. var cars = new Array(); //此时 cars 数组的长度为 0 cars[0] = "Saab"; //此时 cars 数组的长度为 1 ,js 数组是动态变化的,即第一个数赋值为 Saab car[1] = "Volvo"; //即第二个数赋值为 Volvo car[1] = "BMW"; //即第三个数赋值为 BMW 6-2. var cars = new Array("Saab","Volvo","bmw") ; 6-3. var cars = ["Saab"."Volvo","BMW"]; 7.空 (Null) var b = null //b为 null(可以用来清空变量) 四、js 变量 1.变量必须以字母开头,(不推荐 $ 和 _)区分大小写 五、js 函数 函数:是由事件驱动的或者当它被调用时执行的可重复使用的代码块 定义方法:1.function a(参数){ } 声明会前置 输出: hello world 输出: hello world 2. var a = function(参数){} 匿名函数 输出:这是一个匿名函数 输出: 1 2 3 (传递参数) return 输出: 六、js 比较与逻辑运算符 1. < 小于 > 大于 2.== 等于(5=="5") === 绝对等于(值和类型均相等 5===5) != 不等于 3.&& 与 || 或 !非 七、js 条件语句 if else if 输出: switch 输出:1 八、js 循环语句 for 输出: for in(循环遍历对象) 输出: while(指定条件为 true 时循环指定的代码块) 输出: break (跳出整个循环) 输出: continue(跳出本次循环) 输出:

优秀的个人博客,低调大师

Java基础之HashTable与ConcurrentHashMap解析

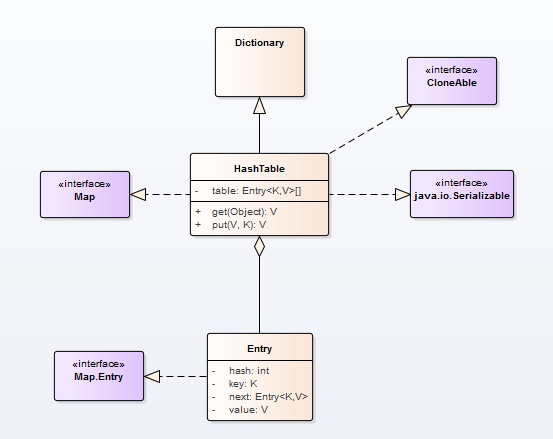
HashTable和HashMap的区别 在面试的过程中,经常会被问到HashTable和HashMap的区别,下面就这些区别做一个简单的总结。 1、继承的父类不同 Hashtable继承自Dictionary类,而HashMap继承自AbstractMap类,但二者都实现了Map接口。 2、线程安全性不同 Hashtable 中的方法是Synchronized的,而HashMap中的方法在缺省情况下是非Synchronized的。在多线程并发的环境下,可以直接使用Hashtable,不需要自己为它的方法实现同步,但使用HashMap时就必须要自己增加同步处理。 总结一句话:Hashtable(1.0版本)不建议在新代码中使用,不需要线程安全的场合可以用HashMap替换,需要线程安全的场合可以用ConcurrentHashMap替换。 3、是否提供contains方法 HashMap把Hashtable的contains方法去掉了,改成containsValue和containsKey,因为contains方法容易让人引起误解。Hashtable则保留了contains,containsValue和containsKey三个方法,其中contains和containsValue功能相同。 4、key和value是否允许null值 Hashtable中,key和value都不允许出现null值。但是如果在Hashtable中有类似put(null,null)的操作,编译同样可以通过,因为key和value都是Object类型,但运行时会抛出NullPointerException异常。 HashMap中,null可以作为键,这样的键只有一个;可以有一个或多个键所对应的值为null。当get()方法返回null值时,可能是 HashMap中没有该键,也可能使该键所对应的值为null。因此,在HashMap中不能由get()方法来判断HashMap中是否存在某个键, 而应该用containsKey()方法来判断。 5、遍历的内部实现方式不同 Hashtable、HashMap都使用了 Iterator。但由于历史原因,Hashtable还使用了Enumeration的方式 。 6,数组初始化和扩容方式不同 HashTable在不指定容量的情况下的默认容量为11,而HashMap为16,Hashtable不要求底层数组的容量一定要为2的整数次幂,而HashMap则要求一定为2的整数次幂。具体扩容时,Hashtable将容量变为原来的2倍加1,而HashMap扩容时,将容量变为原来的2倍。 HashTable 由于HashTable的性能问题,在实际编程中HashTable并不是很常见,更多的是使用HashMap或ConcurrentHashMap。 简单来说,HashTable是一个线程安全的哈希表,它通过使用synchronized关键字来对方法进行加锁,从而保证了线程安全。但这也导致了在单线程环境中效率低下等问题。 HashTable存储模型 HashTable保存数据是和HashMap是相同的,使用的也是Entry对象。HashTable类继承自Dictionary类,实现了Map,Cloneable和java.io.Serializable三个接口,其UML图如下图所示。 HashTable的功能与与HashMap中的功能相同,主要有:put,get,remove和rehash等。 HashTable的主要方法的源码实现逻辑与HashMap中非常相似,有一点重大区别就是所有的操作都是通过synchronized锁保护的。也就是说,只有获得了对应的锁,才能进行后续的读写等操作。 下面就HashTable常见的方法给大家做一个简单的解析。 构造方法 HashTable的构造方法源码如下: public Hashtable(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal Load: "+loadFactor); if (initialCapacity==0) initialCapacity = 1; this.loadFactor = loadFactor; table = new Entry<?,?>[initialCapacity]; threshold = (int)Math.min(initialCapacity * loadFactor, MAX_ARRAY_SIZE + 1); } public Hashtable(int initialCapacity) { this(initialCapacity, 0.75f); } public Hashtable() { this(11, 0.75f); } 从构造函数中可以得到如下的信息:HashTable默认的初始化容量为11(与HashMap不同,HashMap是16),负载因子默认为0.75(与HashMap相同)。而正因为默认初始化容量的不同,同时也没有对容量做调整的策略,所以可以先推断出,HashTable使用的哈希函数跟HashMap是不一样的。 put put方法的主要逻辑如下: 先获取synchronized锁; put方法不允许null值,如果发现是null,则直接抛出异常; 计算key的哈希值和index; 遍历对应位置的链表,如果发现已经存在相同的hash和key,则更新value,并返回旧值; 如果不存在相同的key的Entry节点,则调用addEntry方法增加节点; addEntry方法中,如果需要则进行扩容,之后添加新节点到链表头部。 Put方法的源码如下: public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) { throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode(); //计算桶的位置 int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; //遍历桶中的元素,判断是否存在相同的key for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } //不存在相同的key,则把该key插入到桶中 addEntry(hash, key, value, index); return null; } 涉及的Entry对象的源码如下: private void addEntry(int hash, K key, V value, int index) { modCount++; Entry<?,?> tab[] = table; //哈希表的键值对个数达到了阈值,则进行扩容 if (count >= threshold) { // Rehash the table if the threshold is exceeded rehash(); tab = table; hash = key.hashCode(); index = (hash & 0x7FFFFFFF) % tab.length; } // Creates the new entry. @SuppressWarnings("unchecked") Entry<K,V> e = (Entry<K,V>) tab[index]; //把新节点插入桶中(头插法) tab[index] = new Entry<>(hash, key, value, e); count++; } 从上面的源码可以看到,put方法一开始就会进行值的null值检测,同时,HashTable的put方法也是使用synchronized来修饰。你可以发现,在HashTable中,几乎所有的方法都使用了synchronized来保证线程安全。 get get方法的主要逻辑如下: 先获取synchronized锁; 计算key的哈希值和index; 在对应位置的链表中寻找具有相同hash和key的节点,返回节点的value; 如果遍历结束都没有找到节点,则返回null。 get函数的源码如下: public synchronized V get(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); //通过哈希函数,计算出key对应的桶的位置 int index = (hash & 0x7FFFFFFF) % tab.length; //遍历该桶的所有元素,寻找该key for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return (V)e.value; } } return null; } 从上面的代码可以发现,get方法使用了synchronized来修饰,以保证线程的安全,并且它是通过链表的方式来处理冲突的。另外,我们还可以看见HashTable并没有像HashMap那样封装一个哈希函数,而是直接把哈希函数写在了方法中。 rehash扩容 rehash扩容方法主要逻辑如下:数组长度增加一倍(如果超过上限,则设置成上限值);更新哈希表的扩容门限值;遍历旧表中的节点,计算在新表中的index,插入到对应位置链表的头部。 rehash方法的源码如下: protected void rehash() { int oldCapacity = table.length; Entry<?,?>[] oldMap = table; //扩容扩为原来的两倍+1 int newCapacity = (oldCapacity << 1) + 1; //判断是否超过最大容量 if (newCapacity - MAX_ARRAY_SIZE > 0) { if (oldCapacity == MAX_ARRAY_SIZE) // Keep running with MAX_ARRAY_SIZE buckets return; newCapacity = MAX_ARRAY_SIZE; } Entry<?,?>[] newMap = new Entry<?,?>[newCapacity]; modCount++; //计算下一次rehash的阈值 threshold = (int)Math.min(newCapacity * loadFactor, MAX_ARRAY_SIZE + 1); table = newMap; //把旧哈希表的键值对重新哈希到新哈希表中去 for (int i = oldCapacity ; i-- > 0 ;) { for (Entry<K,V> old = (Entry<K,V>)oldMap[i] ; old != null ; ) { Entry<K,V> e = old; old = old.next; int index = (e.hash & 0x7FFFFFFF) % newCapacity; e.next = (Entry<K,V>)newMap[index]; newMap[index] = e; } } } HashTable的rehash方法相当于HashMap的resize方法。跟HashMap那种巧妙的rehash方式相比,HashTable的rehash过程需要对每个键值对都重新计算哈希值,而比起异或和与操作,取模是一个非常耗时的操作。这也是HashTable比HashMap低效的原因之一。 remove remove方法主要逻辑如下: 先获取synchronized锁; 计算key的哈希值和index; 遍历对应位置的链表,寻找待删除节点,如果存在,用e表示待删除节点,pre表示前驱节点。如果不存在,返回null; 更新前驱节点的next,指向e的next。返回待删除节点的value值。 remove函数的源码如下: public synchronized V remove(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> e = (Entry<K,V>)tab[index]; for(Entry<K,V> prev = null ; e != null ; prev = e, e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { modCount++; if (prev != null) { prev.next = e.next; } else { tab[index] = e.next; } count--; V oldValue = e.value; e.value = null; return oldValue; } } return null; } ConcurrentHashMap HashMap是我们平时开发过程中使用的比较多的集合,但它是非线程安全的,在涉及到多线程并发的情况,进行get操作有可能会引起死循环,导致CPU利用率接近100%。例如: final HashMap<String, String> map = new HashMap<String, String>(2); for (int i = 0; i < 10000; i++) { new Thread(new Runnable() { @Override public void run() { map.put(UUID.randomUUID().toString(), ""); } }).start(); } 但是解决方法也有很多,如Hashtable和Collections.synchronizedMap(hashMap),不过这两个方案基本上是对读写进行加锁操作,一个线程在读写元素,其余线程必须等待,性能可想而知。此时,可以使用ConcurrentHashMap来解决。 JDK 1.7 ConcurrentHashMap实现 和HashMap不同,ConcurrentHashMap采用分段锁的机制,实现并发的更新操作,底层采用数组+链表的存储结构。ConcurrentHashMap最核心的两个核心静态内部类包括:Segment和HashEntry。 理解ConcurrentHashMap需要注意如下几个概念: Segment继承ReentrantLock用来充当锁的角色,每个 Segment 对象守护每个散列映射表的若干个桶; HashEntry 用来封装映射表的键 / 值对; 每个桶是由若干个 HashEntry 对象链接起来的链表。 一个 ConcurrentHashMap 实例中包含由若干个 Segment 对象组成的数组,其数据结构如下: JDK1.8 ConcurrentHashMap实现 1.8的实现已经抛弃了Segment分段锁机制,而是采用CAS+Synchronized来保证并发更新的安全,底层采用数组+链表+红黑树的存储结构。而HashMap在1.8版本中也对存储结构进行了优化,采用数组+链表+红黑树的方式进行数据存储,红黑树可以有效的平衡二叉树,带来插入、查找性能上的提升。 ConcurrentHashMap在1.8版本的数据存储结构如下图: 初始化 只有在第一次执行put方法时才会调用initTable()初始化Node数组,该方法的源码如下: private final Node<K,V>[] initTable() { Node<K,V>[] tab; int sc; while ((tab = table) == null || tab.length == 0) { if ((sc = sizeCtl) < 0) Thread.yield(); // lost initialization race; just spin else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) { try { if ((tab = table) == null || tab.length == 0) { int n = (sc > 0) ? sc : DEFAULT_CAPACITY; @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n]; table = tab = nt; sc = n - (n >>> 2); } } finally { sizeCtl = sc; } break; } } return tab; } sizeCtl默认为0,如果ConcurrentHashMap实例化时有传参数,sizeCtl会是一个2的幂次方的值。所以执行第一次put操作的线程会执行Unsafe.compareAndSwapInt方法修改sizeCtl为-1,有且只有一个线程能够修改成功,其它线程通过Thread.yield()让出CPU时间片等待table初始化完成。 关于具体的的一些put、get、table扩容等操作,大家可以自行搜索相关的资料。

优秀的个人博客,低调大师

Java并发编程基础-线程间通信

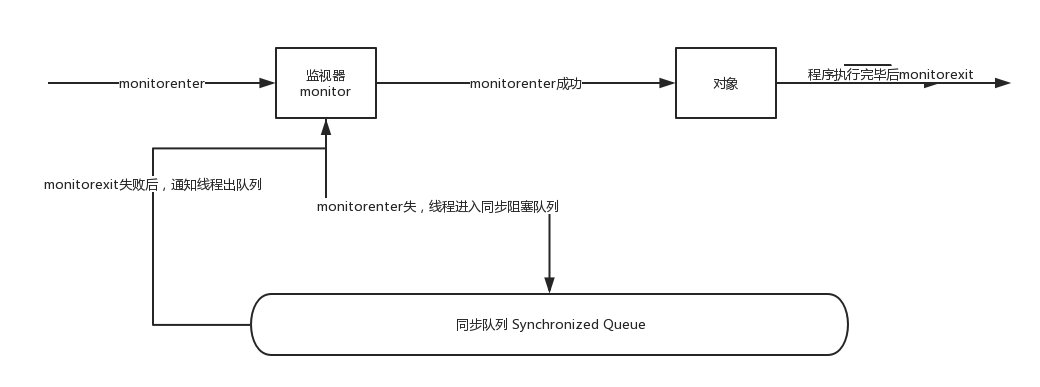
章节目录 volatile 与 synchronized 关键字 等待/通知机制 等待/通知经典范式 管道输入/输出流 Thread.join() 的 使用 1. volatile 与 synchronized 关键字 线程开始运行,拥有自己的栈空间,就如同一个脚本一样,按照既定的代码一行一行的执行,直到终止。如果每个运行中的线程,仅仅是孤立的运行,那么没有价值,或者说价值很少,如果多个线程能够 相互配合 完成工作,这将带来巨大的价值。 1.1 Java 线程操作的共享变量是对共享内存变量的一份拷贝 Java支持多个线程同时访问一个对象或者对象的成员变量,由于每个线程可以拥有这个共享变量的一份拷贝 (虽然对象以及成员变量分配的内存是在共享内存中,但是每个执行的线程还是可以拥有一份拷贝,这样做的目的是 加速程序的执行)。这是现代多核处理器的一个显著特性, 所以在程序执行过程中,(未同步的程序代码块),一个线程看到的变量并不一定是最新的。 1.2 volatile 关键字-线程间通信 关键字volatile可以用来修饰字段(成员变量),就是告知任何对该变量的访问均 需要从共享内存中获取,而对它的改变必须同步刷新到共享内存, 它能保证虽有线程对共享变量的可见性。 举个例子,定义一个程序是否运行的成员变量,boolean on = true; 那么另一个 线程可能对它执行关闭动作(on = false),这涉及多个线程对变量的访问,因此 需要将其定义为 volatile boolean on = true,这样其他线程对他进行改变时,可 以让所有线程感知到变化,因为所有对共享变量的访问(load)和修改(store)都需 要以共享内存为准。但是过多的使用volatile是不必要的,因为它会降低程序执行的效率。 1.3 synchronized 关键字-线程间通信 关键字 synchronized 可以修饰方法 或者以同步块的形来进行使用,它主要确 保多个线程在同一时刻,只能有一个线程执行同步方法或同步块,它保证了线 程对变量访问的可见性、排他性。 如下所示,类中使用了同步块和同步方法,通过使用javap 工具查看生成的class文件信息来分析synchronized关键字实现细节,示例如下: package org.seckill.Thread; public class Synchronized { public static void ls(String[] args) { synchronized (Synchronized.class) { }//静态同步方法,对Synchronized Class对象进行加锁 m(); } public static synchronized void m(){ } } 执行 javap -v Synchronized.class 输出如下所示: public static void main(java.lang.String[]); descriptor: ([Ljava/lang/String;)V flags: ACC_PUBLIC, ACC_STATIC Code: stack=2, locals=3, args_size=1 0: ldc #2 // class org/seckill/Thread/Synchronized 2: dup 3: astore_1 4: monitorenter 5: aload_1 6: monitorexit 7: goto 15 10: astore_2 11: aload_1 12: monitorexit 13: aload_2 14: athrow 15: invokestatic #3 // Method m:()V 18: return public static synchronized void m(); descriptor: ()V flags: ACC_PUBLIC, ACC_STATIC, ACC_SYNCHRONIZED Code: stack=0, locals=0, args_size=0 0: return 对上述汇编指令进行解读 对于同步代码块(临界区)的实现使用了monitorenter 和 monitorexit 指令。 同步方法则是依靠方法修饰符上的ACC_SYNCHRONIZED。 另种同步方式的原理是 对一个充当锁的对象的monitor 进行获取,而这个获取过程是排他的,也就是同一时刻只能有一个线程获取到由syntronized 所保护的对象的监视器。 任何一个对象都拥有自己的监视器,当这个对象由同步块或者这个对象的同步方法调用时,执行方法的线程必须先获取到对象的监视器才能进入到同步块或者同步方法中,那么没有获取到监视器(执行改方法)的线程将会被阻塞在同步块和同步方法的入口处,进入blocked 状态。 如下是对上述解读过程的图示: 对象、监视器、同步队列、执行线程之间的关系 2.等待/通知机制 等待通知相关方法 方法名称 描述 wait() 调用lock.wait()(lock是充当锁的对象)的线程将进入waiting状态,只有等待另外线程的通知或者线程对象.interrupted()才能返回,wait()调用后,会释放对象的锁 wait(long) 超时一段时间,这里的参数是毫秒,也就是等待n毫秒,如果没有通知就超时返回 wait(long,int) 对于超时间的更细粒度控制,可以达到纳秒级别 notify() 通知一个在锁对象上等待的线程,使其从wait()方法返回,而返回的前提是该线程获取到了对象的锁(其实是线程获取到了该对象的monitor对象的控制权) notifyAll() 通知所有等待在充当锁的对象上的线程 对等待通知机制的解释 等待通知机制,是指一个线程A调用了充当锁的对象的wait()方法进入等 waiting 状态 另一个线程B调用了对象的O的 notify() 或者 notifyAll() 方法,线程A接收到通知后从充当锁的对象上的wait()方法返回,进而执行后续操作,最近一次操作是线程从等待队列进入到同步阻塞队列。 上述两个线程通过充当锁的对象 lock 来完成交互,而lock对象上的wait()/notify/notifyAll()的关系就如同开关信号一样,用来完成等待方和通知方的交互工作 如下代码清单所示,创建两个线程 WaitThread & NotifyThread,前者检查flag是否为false,如果符合要求,进行后续操作,否则在lock上wait,后者在睡眠一段时间后对lock进行通知。 package org.seckill.Thread; public class WaitNotify { static boolean flag = true; static Object lock = new Object();//充当锁的对象 public static void main(String[] args) { //新建wait线程 Thread waitThread = new Thread(new WaitThread(),"waitThread"); Thread notifyThread = new Thread(new NotifyThread(),"notifyThread"); waitThread.start();//等待线程开始运行 Interrupted.SleepUnit.second(5);//主线程sleep 5s notifyThread.start(); } //wait线程 static class WaitThread implements Runnable { public void run() { synchronized (lock) { //判定flag while (flag) { try { System.out.println(Thread.currentThread().getName() + "获取flag 信息" + flag); //判定为true 直接wait lock.wait(); } catch (InterruptedException e) { e.printStackTrace(); } } System.out.println(Thread.currentThread().getName() + "获取flag 信息 为" + flag); } } } static class NotifyThread implements Runnable { public void run() { synchronized (lock) { while (flag) { System.out.println(Thread.currentThread().getName() + "获取flag 信息 为" + flag+"可以运行"); lock.notify();//唤醒wait在lock上的线程,此时wait线程只能能从waiting队列进入阻塞队列,但还没有开始重新进行monitorenter的动作 // 因为锁没有释放 flag = false; Interrupted.SleepUnit.second(5); } } synchronized (lock){//有可能获取到lock对象monitor,获取到锁 System.out.println(Thread.currentThread().getName()+" hold lock again"); Interrupted.SleepUnit.second(5); } } } } 运行结果如下所示: 运行结果 对如上程序运行流程的解释如下所示: 上图中"hold lock again 与 最后一行输出"的位置可能互换,上述例子说明调用wait()、notify()、notifyAll需要注意的细节 使用wait()、notify() 和 notifyAll() 时需要在同步代码块或同步方法中使用,且需要先对调用的锁对象进行加锁(获取充当锁的对象的monitor对象) 调用wait() 方法后,线程状态由running 变为 waiting,并将当前线程放置到等待队列中 notify()、notifyAll() 方法调用后,等待线程依旧不会从wait()方法返回,需要调用notify()、notifyAll()的线程释放锁之后,等待线程才有机会从wait()方法返回 notify() 方法将waiting队列中的一个等待线程从waiting队列 移动到同步队列中,而notifyAll() 则是将等待队列中所有的线程全部移动到同步队列,被移动的线程状态由waiting status change to blocked状态 从wait() 方法返回的前提是获得了调用对象的锁等待/通知机制依托于同步机制,其目的就是确保等待线程从wait()方法返回时能够感知到通知线程对变量做出的修改 3.等待/通知经典范式 等待/通知经典范式 该范式分为两部分,分别针对等待方(消费方)、和通知方(生产方)等待方遵循如下原则: 获取对象的锁 如果条件不满足,则调用对象的wait() 方法,被通知后仍要检查条件 条件满足则执行对应的逻辑 对应伪代码 syntronized (lock) { while( !条件满足 ){ lock.wait(); } //对应的处理逻辑 } 通知方遵循如下原则: 获取对象锁 改变条件 通知所有等待在锁对象的线程 syntronized(lock) { //1.执行逻辑 //2.更新条件 lock.notify(); } 4.管道输入输出流 管道输入 / 输出流和普通的文件输入/输出流 或者网络输入/输出流的不同之处在于它主要用于线程之间的数据传输,而传输的媒介为内存。 管道输入 / 输出流主要包括如下4种具体实现:PipedOutputStream、PipedInputStream、PipedReader 、PipedWriter 前两种面向字节,后两种面向字符 对于Piped类型的流,必须先进行绑定,也就是调用connect()方法,如果没有输入/输出流绑定起来,对于该流的访问将抛出异常。 5.Thread.join() 的 使用 如果使用了一个线程A执行了thread.join ,其含义是线程A等待thread线程终止之后才从thread.join()返回。 如下笔试题: 有A、B、C、D四个线程,在main线程中运行,要求 执行顺序是A->B->C->D->mian 变种->main等待A、B、C、D四个线程顺序执行,且进行sum,之后main线程打印sum解法1-join() 其实就是插队 package org.seckill.Thread; public class InOrderThread { static int num = 0; public static void main(String[] args) throws InterruptedException { Thread previous = null; for (int i = 0; i < 4; i++) { char threadName = (char) (i + 65); Thread thread = new Thread(new RunnerThread(previous), String.valueOf(threadName)); previous = thread; thread.start(); } previous.join(); System.out.println("total num=" + num); System.out.println(Thread.currentThread().getName() + "terminal"); } static class RunnerThread implements Runnable { Thread previous;//持有前一个线程引用 public RunnerThread(Thread previous) { this.previous = previous; } public void run() { if (this.previous == null) { // num += 25; System.out.println(Thread.currentThread().getName() + " terminate "); } else { try { previous.join(); } catch (InterruptedException e) { e.printStackTrace(); } // num += 25; System.out.println(Thread.currentThread().getName() + " terminate "); } } } } 解法2-wait/notify package org.seckill.Thread; //wait/notify public class InOrderThread2 { // static int state = 0;//运行标志 // static Object lock = new Object(); public static void main(String[] args) { // RunnerThread runnerThreadA = new RunnerThread(); // RunnerThread runnerThreadB = new RunnerThread(); // RunnerThread runnerThreadC = new RunnerThread(); // RunnerThread runnerThreadD = new RunnerThread(); // Thread threadA = new Thread(runnerThreadA, "A"); // Thread threadB = new Thread(runnerThreadB, "B"); // Thread threadC = new Thread(runnerThreadC, "C"); // Thread threadD = new Thread(runnerThreadD, "D"); RunnerThread runnerThread = new RunnerThread(); Thread threadA = new Thread(runnerThread, "A"); Thread threadB = new Thread(runnerThread, "B"); Thread threadC = new Thread(runnerThread, "C"); Thread threadD = new Thread(runnerThread, "D"); threadD.start(); threadA.start(); threadB.start(); threadC.start(); } static class RunnerThread implements Runnable { // private boolean flag = true; static int state = 0;//运行标志 static Object lock = new Object(); public void run() { String threadName = Thread.currentThread().getName(); // while (flag) { // synchronized (lock) { // if (state % 4 == threadName.charAt(0) - 65) { // state++; // flag = false; // System.out.println(threadName + " run over"); // } // } // } synchronized (lock) { while (state % 4 != threadName.charAt(0) - 65) { try { lock.wait(); }catch (InterruptedException e){ e.printStackTrace(); } } state++; System.out.println(threadName+" run over "); lock.notifyAll(); } } } } 等待/通知范式做线程同步 是非常方便的。 解法3-循环获取锁 package org.seckill.Thread; //wait/notify public class InOrderThread2 { static int state = 0;//运行标志 static Object lock = new Object(); public static void main(String[] args) { RunnerThread runnerThreadA = new RunnerThread(); RunnerThread runnerThreadB = new RunnerThread(); RunnerThread runnerThreadC = new RunnerThread(); RunnerThread runnerThreadD = new RunnerThread(); Thread threadA = new Thread(runnerThreadA, "A"); Thread threadB = new Thread(runnerThreadB, "B"); Thread threadC = new Thread(runnerThreadC, "C"); Thread threadD = new Thread(runnerThreadD, "D"); // RunnerThread runnerThread = new RunnerThread(); // Thread threadA = new Thread(runnerThread, "A"); // Thread threadB = new Thread(runnerThread, "B"); // Thread threadC = new Thread(runnerThread, "C"); // Thread threadD = new Thread(runnerThread, "D"); threadD.start(); threadA.start(); threadB.start(); threadC.start(); } static class RunnerThread implements Runnable { private boolean flag = true;//每个线程的私有变量 // static int state = 0;//运行标志 // static Object lock = new Object(); public void run() { String threadName = Thread.currentThread().getName(); while (flag) {//主动循环加锁 synchronized (lock) { if (state % 4 == threadName.charAt(0) - 65) { state++; flag = false; System.out.println(threadName + " run over"); } } } // // synchronized (lock) { // while (state % 4 != threadName.charAt(0) - 65) { // try { // lock.wait(); // }catch (InterruptedException e){ // e.printStackTrace(); // } // } // state++; // System.out.println(threadName+" run over "); // lock.notifyAll(); // } } } } 开销是极大的、难以确保及时性 解法4-CountDownLatch package org.seckill.Thread; import java.util.concurrent.CountDownLatch; public class InOrderThread3 { // static int state = 0;//运行标志 // static Object lock = new Object(); public static void main(String[] args) throws InterruptedException{ CountDownLatch countDownLatchA = new CountDownLatch(1); CountDownLatch countDownLatchB = new CountDownLatch(1); CountDownLatch countDownLatchC = new CountDownLatch(1); CountDownLatch countDownLatchD = new CountDownLatch(1); RunnerThread runnerThreadA = new RunnerThread(countDownLatchA); RunnerThread runnerThreadB = new RunnerThread(countDownLatchB); RunnerThread runnerThreadC = new RunnerThread(countDownLatchC); RunnerThread runnerThreadD = new RunnerThread(countDownLatchD); Thread threadA = new Thread(runnerThreadA, "A"); Thread threadB = new Thread(runnerThreadB, "B"); Thread threadC = new Thread(runnerThreadC, "C"); Thread threadD = new Thread(runnerThreadD, "D"); // RunnerThread runnerThread = new RunnerThread(); // Thread threadA = new Thread(runnerThread, "A"); // Thread threadB = new Thread(runnerThread, "B"); // Thread threadC = new Thread(runnerThread, "C"); // Thread threadD = new Thread(runnerThread, "D"); threadA.start(); countDownLatchA.await();//主线程阻塞,待countDownLatch 减为0即可继续向下运行 threadB.start(); countDownLatchB.await(); threadC.start(); countDownLatchC.await(); threadD.start(); countDownLatchD.await(); System.out.println(Thread.currentThread().getName()+" run over "); } static class RunnerThread implements Runnable { // private boolean flag = true; // static int state = 0;//运行标志 // static Object lock = new Object(); CountDownLatch countDownLatch; RunnerThread(CountDownLatch countDownLatch){ this.countDownLatch = countDownLatch; } public void run() { String threadName = Thread.currentThread().getName(); System.out.println(threadName+" run over"); countDownLatch.countDown(); // while (flag) { // synchronized (lock) { // if (state % 4 == threadName.charAt(0) - 65) { // state++; // flag = false; // System.out.println(threadName + " run over"); // } // } // } // // synchronized (lock) { // while (state % 4 != threadName.charAt(0) - 65) { // try { // lock.wait(); // }catch (InterruptedException e){ // e.printStackTrace(); // } // } // state++; // System.out.println(threadName+" run over "); // lock.notifyAll(); // } } } } countDownLatch 的使用场景 :比如系统完全开启需要等待系统软件全部运行之后才能开启。最终的结果一定是发生在子(部分)结果完成之后的。也可作为线程同步的一种方式Thread join() 源码 public final synchronized void join() throws InterruptedException { while (isAlive) { wait(0); } } 当被调用thread.join() 的线程(thread)终止运行时,会调用自身的notifyAll()方法,会通知所有等待该线程对象上完成运行的线程,可以看到join方法的逻辑结构与等待/通知经典范式一致,即加锁、循环、处理逻辑3个步骤。

优秀的个人博客,低调大师

Java并发编程基础-ThreadLocal的使用

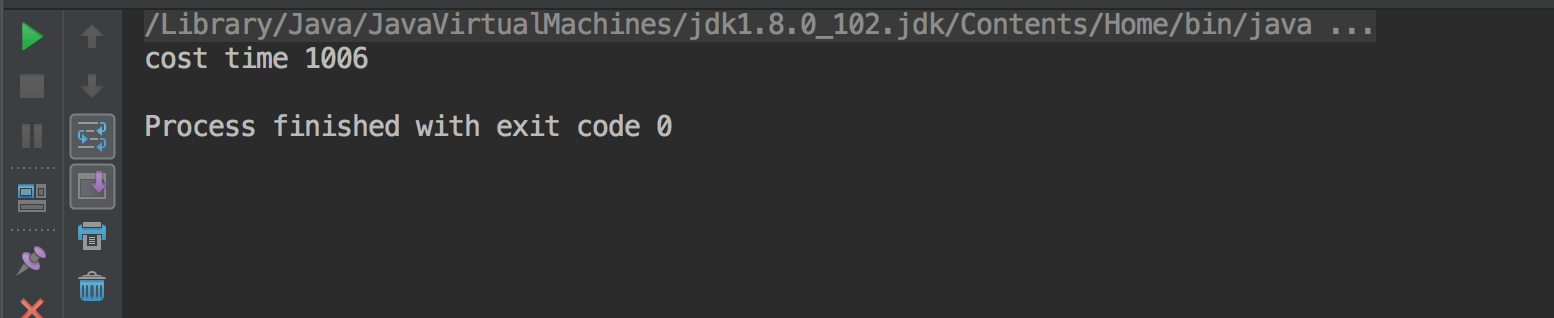
章节目录 ThreadLocal 简介 ThreadLocal 使用 1.ThreadLocal 简介 什么是ThreadLocal ThreadLocal 为线程变量,是一个以ThreadLocal对象为key,任意对象为值的存储 结构,这个结构被附带到线程上。 ThreadLocal的作用 通过set(T)来设置一个值,在当前线程下通过get()方法获取到原先设置的值。 2.ThreadLocal 使用 题目:设计一个方案统计每个接口的响应时间 思路: 采用AOP(面向切面编程),可以在方法调用前的切入点执行begin()方法,在方法调用后的切入点执行end()方法。 每个请求本质上是线程执行的过程,那么问题就变为统计每个线程执行过程的耗时。 采用工具类+实力方式会产生过多工具类对象 采用静态方法方式,如果不同步共享变量会产生并发获取系统时间的问题,统计不准确。 采用同步方式统计接口响应时间,接口性能会下降。 那么有没有一种方式是将不通接口响应时间值绑定到 不同线程上的方式,并且获取方法一致,但是时间值是每个线程特定可见的,答案就是使用ThreadLocal Profiler begin() 获取接口执行时间点、end()获取从begin()方法调用开始到end()方法被调用时的时间差,单位毫秒。 package org.seckill.Thread; public class Profiler { private static final ThreadLocal<Long> TIME_THREADLOCAL = new ThreadLocal<Long>(){ //第一次get()方法调用时会进行初始化,这个是在set()方法没有被调用的情况下发生,每个线程调用一次 protected Long initialValue() { return System.currentTimeMillis(); } }; //设置初始运行时刻 public static final void begin(){ TIME_THREADLOCAL.set(System.currentTimeMillis()); } public static final long end(){ return System.currentTimeMillis()- TIME_THREADLOCAL.get(); } public static void main(String[] args) { Profiler.begin(); Interrupted.SleepUnit.second(1); System.out.println("cost time "+Profiler.end()); } } 运行结果: 运行结果

优秀的个人博客,低调大师

Java基础11:Java泛型详解

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/a724888/article/details/80146648 这位大侠,这是我的公众号:程序员江湖。 分享程序员面试与技术的那些事。 干货满满,关注就送。 本文对java的泛型的概念和使用做了详尽的介绍。 本文参考https://blog.csdn.net/s10461/article/details/53941091 具体代码在我的GitHub中可以找到 https://github.com/h2pl/MyTech 文章首发于我的个人博客: https://h2pl.github.io/2018/04/29/javase11 更多关于Java后端学习的内容请到我的CSDN博客上查看: https://blog.csdn.net/a724888 泛型概述 泛型在java中有很重要的地位,在面向对象编程及各种设计模式中有非常广泛的应用。 什么是泛型?为什么要使用泛型? 泛型,即“参数化类型”。一提到参数,最熟悉的就是定义方法时有形参,然后调用此方法时传递实参。那么参数化类型怎么理解呢?顾名思义,就是将类型由原来的具体的类型参数化,类似于方法中的变量参数,此时类型也定义成参数形式(可以称之为类型形参),然后在使用/调用时传入具体的类型(类型实参)。 泛型的本质是为了参数化类型(在不创建新的类型的情况下,通过泛型指定的不同类型来控制形参具体限制的类型)。也就是说在泛型使用过程中,操作的数据类型被指定为一个参数,这种参数类型可以用在类、接口和方法中,分别被称为泛型类、泛型接口、泛型方法。 一个栗子 一个被举了无数次的例子: List arrayList = new ArrayList(); arrayList.add("aaaa"); arrayList.add(100); for(int i = 0; i< arrayList.size();i++){ String item = (String)arrayList.get(i); Log.d("泛型测试","item = " + item); } 毫无疑问,程序的运行结果会以崩溃结束: java.lang.ClassCastException: java.lang.Integer cannot be cast to java.lang.String ArrayList可以存放任意类型,例子中添加了一个String类型,添加了一个Integer类型,再使用时都以String的方式使用,因此程序崩溃了。为了解决类似这样的问题(在编译阶段就可以解决),泛型应运而生。 我们将第一行声明初始化list的代码更改一下,编译器会在编译阶段就能够帮我们发现类似这样的问题。 List arrayList = new ArrayList(); … //arrayList.add(100); 在编译阶段,编译器就会报错 特性 泛型只在编译阶段有效。看下面的代码: List<String> stringArrayList = new ArrayList<String>(); List<Integer> integerArrayList = new ArrayList<Integer>(); Class classStringArrayList = stringArrayList.getClass(); Class classIntegerArrayList = integerArrayList.getClass(); if(classStringArrayList.equals(classIntegerArrayList)){ Log.d("泛型测试","类型相同"); } 通过上面的例子可以证明,在编译之后程序会采取去泛型化的措施。也就是说Java中的泛型,只在编译阶段有效。在编译过程中,正确检验泛型结果后,会将泛型的相关信息擦出,并且在对象进入和离开方法的边界处添加类型检查和类型转换的方法。也就是说,泛型信息不会进入到运行时阶段。 对此总结成一句话:泛型类型在逻辑上看以看成是多个不同的类型,实际上都是相同的基本类型。 泛型有三种使用方式,分别为:泛型类、泛型接口、泛型方法 泛型类 泛型类型用于类的定义中,被称为泛型类。通过泛型可以完成对一组类的操作对外开放相同的接口。最典型的就是各种容器类,如:List、Set、Map。 泛型类的最基本写法(这么看可能会有点晕,会在下面的例子中详解): class 类名称 <泛型标识:可以随便写任意标识号,标识指定的泛型的类型>{ private 泛型标识 /*(成员变量类型)*/ var; ..... } 一个最普通的泛型类: //此处T可以随便写为任意标识,常见的如T、E、K、V等形式的参数常用于表示泛型 //在实例化泛型类时,必须指定T的具体类型 public class Generic<T>{ //在类中声明的泛型整个类里面都可以用,除了静态部分,因为泛型是实例化时声明的。 //静态区域的代码在编译时就已经确定,只与类相关 class A <E>{ T t; } //类里面的方法或类中再次声明同名泛型是允许的,并且该泛型会覆盖掉父类的同名泛型T class B <T>{ T t; } //静态内部类也可以使用泛型,实例化时赋予泛型实际类型 static class C <T> { T t; } public static void main(String[] args) { //报错,不能使用T泛型,因为泛型T属于实例不属于类 // T t = null; } //key这个成员变量的类型为T,T的类型由外部指定 private T key; public Generic(T key) { //泛型构造方法形参key的类型也为T,T的类型由外部指定 this.key = key; } public T getKey(){ //泛型方法getKey的返回值类型为T,T的类型由外部指定 return key; } } 12-27 09:20:04.432 13063-13063/? D/泛型测试: key is 123456 12-27 09:20:04.432 13063-13063/? D/泛型测试: key is key_vlaue 定义的泛型类,就一定要传入泛型类型实参么?并不是这样,在使用泛型的时候如果传入泛型实参,则会根据传入的泛型实参做相应的限制,此时泛型才会起到本应起到的限制作用。如果不传入泛型类型实参的话,在泛型类中使用泛型的方法或成员变量定义的类型可以为任何的类型。 看一个例子: Generic generic = new Generic("111111"); Generic generic1 = new Generic(4444); Generic generic2 = new Generic(55.55); Generic generic3 = new Generic(false); Log.d("泛型测试","key is " + generic.getKey()); Log.d("泛型测试","key is " + generic1.getKey()); Log.d("泛型测试","key is " + generic2.getKey()); Log.d("泛型测试","key is " + generic3.getKey()); D/泛型测试: key is 111111 D/泛型测试: key is 4444 D/泛型测试: key is 55.55 D/泛型测试: key is false 注意: 泛型的类型参数只能是类类型,不能是简单类型。 不能对确切的泛型类型使用instanceof操作。如下面的操作是非法的,编译时会出错。 if(ex_num instanceof Generic){ } 泛型接口 泛型接口与泛型类的定义及使用基本相同。泛型接口常被用在各种类的生产器中,可以看一个例子: //定义一个泛型接口 public interface Generator<T> { public T next(); } 当实现泛型接口的类,未传入泛型实参时: /** * 未传入泛型实参时,与泛型类的定义相同,在声明类的时候,需将泛型的声明也一起加到类中 * 即:class FruitGenerator<T> implements Generator<T>{ * 如果不声明泛型,如:class FruitGenerator implements Generator<T>,编译器会报错:"Unknown class" */ class FruitGenerator<T> implements Generator<T>{ @Override public T next() { return null; } } 当实现泛型接口的类,传入泛型实参时: /** * 传入泛型实参时: * 定义一个生产器实现这个接口,虽然我们只创建了一个泛型接口Generator<T> * 但是我们可以为T传入无数个实参,形成无数种类型的Generator接口。 * 在实现类实现泛型接口时,如已将泛型类型传入实参类型,则所有使用泛型的地方都要替换成传入的实参类型 * 即:Generator<T>,public T next();中的的T都要替换成传入的String类型。 */ public class FruitGenerator implements Generator<String> { private String[] fruits = new String[]{"Apple", "Banana", "Pear"}; @Override public String next() { Random rand = new Random(); return fruits[rand.nextInt(3)]; } } 泛型通配符 我们知道Ingeter是Number的一个子类,同时在特性章节中我们也验证过Generic与Generic实际上是相同的一种基本类型。那么问题来了,在使用Generic作为形参的方法中,能否使用Generic的实例传入呢?在逻辑上类似于Generic和Generic是否可以看成具有父子关系的泛型类型呢? 为了弄清楚这个问题,我们使用Generic这个泛型类继续看下面的例子: public void showKeyValue1(Generic<Number> obj){ Log.d("泛型测试","key value is " + obj.getKey()); } Generic<Integer> gInteger = new Generic<Integer>(123); Generic<Number> gNumber = new Generic<Number>(456); showKeyValue(gNumber); // showKeyValue这个方法编译器会为我们报错:Generic<java.lang.Integer> // cannot be applied to Generic<java.lang.Number> // showKeyValue(gInteger); 通过提示信息我们可以看到Generic不能被看作为`Generic的子类。由此可以看出:同一种泛型可以对应多个版本(因为参数类型是不确定的),不同版本的泛型类实例是不兼容的。 回到上面的例子,如何解决上面的问题?总不能为了定义一个新的方法来处理Generic类型的类,这显然与java中的多台理念相违背。因此我们需要一个在逻辑上可以表示同时是Generic和Generic父类的引用类型。由此类型通配符应运而生。 我们可以将上面的方法改一下: public void showKeyValue1(Generic<?> obj){ Log.d("泛型测试","key value is " + obj.getKey()); 类型通配符一般是使用?代替具体的类型实参,注意, 此处的?和Number、String、Integer一样都是一种实际的类型,可以把?看成所有类型的父类。是一种真实的类型。 可以解决当具体类型不确定的时候,这个通配符就是 ? ;当操作类型时,不需要使用类型的具体功能时,只使用Object类中的功能。那么可以用 ? 通配符来表未知类型 public void showKeyValue(Generic obj){ System.out.println(obj); } Generic<Integer> gInteger = new Generic<Integer>(123); Generic<Number> gNumber = new Generic<Number>(456); public void test () { // showKeyValue(gInteger);该方法会报错 showKeyValue1(gInteger); } public void showKeyValue1(Generic<?> obj) { System.out.println(obj); } // showKeyValue这个方法编译器会为我们报错:Generic<java.lang.Integer> // cannot be applied to Generic<java.lang.Number> // showKeyValue(gInteger); 。 泛型方法 在java中,泛型类的定义非常简单,但是泛型方法就比较复杂了。 尤其是我们见到的大多数泛型类中的成员方法也都使用了泛型,有的甚至泛型类中也包含着泛型方法,这样在初学者中非常容易将泛型方法理解错了。 泛型类,是在实例化类的时候指明泛型的具体类型;泛型方法,是在调用方法的时候指明泛型的具体类型 。 /** * 泛型方法的基本介绍 * @param tClass 传入的泛型实参 * @return T 返回值为T类型 * 说明: * 1)public 与 返回值中间<T>非常重要,可以理解为声明此方法为泛型方法。 * 2)只有声明了<T>的方法才是泛型方法,泛型类中的使用了泛型的成员方法并不是泛型方法。 * 3)<T>表明该方法将使用泛型类型T,此时才可以在方法中使用泛型类型T。 * 4)与泛型类的定义一样,此处T可以随便写为任意标识,常见的如T、E、K、V等形式的参数常用于表示泛型。 */ public <T> T genericMethod(Class<T> tClass)throws InstantiationException , IllegalAccessException{ T instance = tClass.newInstance(); return instance; } Object obj = genericMethod(Class.forName("com.test.test")); 泛型方法的基本用法 光看上面的例子有的同学可能依然会非常迷糊,我们再通过一个例子,把我泛型方法再总结一下。 /** * 这才是一个真正的泛型方法。 * 首先在public与返回值之间的<T>必不可少,这表明这是一个泛型方法,并且声明了一个泛型T * 这个T可以出现在这个泛型方法的任意位置. * 泛型的数量也可以为任意多个 * 如:public <T,K> K showKeyName(Generic<T> container){ * ... * } */ public class 泛型方法 { @Test public void test() { test1(); test2(new Integer(2)); test3(new int[3],new Object()); //打印结果 // null // 2 // [I@3d8c7aca // java.lang.Object@5ebec15 } //该方法使用泛型T public <T> void test1() { T t = null; System.out.println(t); } //该方法使用泛型T //并且参数和返回值都是T类型 public <T> T test2(T t) { System.out.println(t); return t; } //该方法使用泛型T,E //参数包括T,E public <T, E> void test3(T t, E e) { System.out.println(t); System.out.println(e); } } 类中的泛型方法 当然这并不是泛型方法的全部,泛型方法可以出现杂任何地方和任何场景中使用。但是有一种情况是非常特殊的,当泛型方法出现在泛型类中时,我们再通过一个例子看一下 //注意泛型类先写类名再写泛型,泛型方法先写泛型再写方法名 //类中声明的泛型在成员和方法中可用 class A <T, E>{ { T t1 ; } A (T t){ this.t = t; } T t; public void test1() { System.out.println(this.t); } public void test2(T t,E e) { System.out.println(t); System.out.println(e); } } @Test public void run () { A <Integer,String > a = new A<>(1); a.test1(); a.test2(2,"ds"); // 1 // 2 // ds } static class B <T>{ T t; public void go () { System.out.println(t); } } 泛型方法与可变参数 再看一个泛型方法和可变参数的例子: public class 泛型和可变参数 { @Test public void test () { printMsg("dasd",1,"dasd",2.0,false); print("dasdas","dasdas", "aa"); } //普通可变参数只能适配一种类型 public void print(String ... args) { for(String t : args){ System.out.println(t); } } //泛型的可变参数可以匹配所有类型的参数。。有点无敌 public <T> void printMsg( T... args){ for(T t : args){ System.out.println(t); } } //打印结果: //dasd //1 //dasd //2.0 //false } 静态方法与泛型 静态方法有一种情况需要注意一下,那就是在类中的静态方法使用泛型:静态方法无法访问类上定义的泛型;如果静态方法操作的引用数据类型不确定的时候,必须要将泛型定义在方法上。 即:如果静态方法要使用泛型的话,必须将静态方法也定义成泛型方法 。 public class StaticGenerator<T> { .... .... /** * 如果在类中定义使用泛型的静态方法,需要添加额外的泛型声明(将这个方法定义成泛型方法) * 即使静态方法要使用泛型类中已经声明过的泛型也不可以。 * 如:public static void show(T t){..},此时编译器会提示错误信息: "StaticGenerator cannot be refrenced from static context" */ public static <T> void show(T t){ } } 泛型方法总结 泛型方法能使方法独立于类而产生变化,以下是一个基本的指导原则: 无论何时,如果你能做到,你就该尽量使用泛型方法。也就是说,如果使用泛型方法将整个类泛型化,那么就应该使用泛型方法。另外对于一个static的方法而已,无法访问泛型类型的参数。所以如果static方法要使用泛型能力,就必须使其成为泛型方法。 泛型上下边界 在使用泛型的时候,我们还可以为传入的泛型类型实参进行上下边界的限制,如:类型实参只准传入某种类型的父类或某种类型的子类。 为泛型添加上边界,即传入的类型实参必须是指定类型的子类型 public class 泛型通配符与边界 { public void showKeyValue(Generic<Number> obj){ System.out.println("key value is " + obj.getKey()); } @Test public void main() { Generic<Integer> gInteger = new Generic<Integer>(123); Generic<Number> gNumber = new Generic<Number>(456); showKeyValue(gNumber); //泛型中的子类也无法作为父类引用传入 // showKeyValue(gInteger); } //直接使用?通配符可以接受任何类型作为泛型传入 public void showKeyValueYeah(Generic<?> obj) { System.out.println(obj); } //只能传入number的子类或者number public void showKeyValue1(Generic<? extends Number> obj){ System.out.println(obj); } //只能传入Integer的父类或者Integer public void showKeyValue2(Generic<? super Integer> obj){ System.out.println(obj); } @Test public void testup () { //这一行代码编译器会提示错误,因为String类型并不是Number类型的子类 //showKeyValue1(generic1); Generic<String> generic1 = new Generic<String>("11111"); Generic<Integer> generic2 = new Generic<Integer>(2222); Generic<Float> generic3 = new Generic<Float>(2.4f); Generic<Double> generic4 = new Generic<Double>(2.56); showKeyValue1(generic2); showKeyValue1(generic3); showKeyValue1(generic4); } @Test public void testdown () { Generic<String> generic1 = new Generic<String>("11111"); Generic<Integer> generic2 = new Generic<Integer>(2222); Generic<Number> generic3 = new Generic<Number>(2); // showKeyValue2(generic1);本行报错,因为String并不是Integer的父类 showKeyValue2(generic2); showKeyValue2(generic3); } } == 关于泛型数组要提一下 == 看到了很多文章中都会提起泛型数组,经过查看sun的说明文档,在java中是”不能创建一个确切的泛型类型的数组”的。 也就是说下面的这个例子是不可以的: List<String>[] ls = new ArrayList<String>[10]; 而使用通配符创建泛型数组是可以的,如下面这个例子: List<?>[] ls = new ArrayList<?>[10]; 这样也是可以的: List<String>[] ls = new ArrayList[10]; 下面使用Sun的一篇文档的一个例子来说明这个问题: List<String>[] lsa = new List<String>[10]; // Not really allowed. Object o = lsa; Object[] oa = (Object[]) o; List<Integer> li = new ArrayList<Integer>(); li.add(new Integer(3)); oa[1] = li; // Unsound, but passes run time store check String s = lsa[1].get(0); // Run-time error: ClassCastException. 这种情况下,由于JVM泛型的擦除机制,在运行时JVM是不知道泛型信息的,所以可以给oa[1]赋上一个ArrayList而不会出现异常,但是在取出数据的时候却要做一次类型转换,所以就会出现ClassCastException,如果可以进行泛型数组的声明,上面说的这种情况在编译期将不会出现任何的警告和错误,只有在运行时才会出错。 而对泛型数组的声明进行限制,对于这样的情况,可以在编译期提示代码有类型安全问题,比没有任何提示要强很多。 下面采用通配符的方式是被允许的:数组的类型不可以是类型变量,除非是采用通配符的方式,因为对于通配符的方式,最后取出数据是要做显式的类型转换的。 List<?>[] lsa = new List<?>[10]; // OK, array of unbounded wildcard type. Object o = lsa; Object[] oa = (Object[]) o; List<Integer> li = new ArrayList<Integer>(); li.add(new Integer(3)); oa[1] = li; // Correct. Integer i = (Integer) lsa[1].get(0); // OK 最后 本文中的例子主要是为了阐述泛型中的一些思想而简单举出的,并不一定有着实际的可用性。另外,一提到泛型,相信大家用到最多的就是在集合中,其实,在实际的编程过程中,自己可以使用泛型去简化开发,且能很好的保证代码质量。

优秀的个人博客,低调大师

Java基础10:全面解读Java异常

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/a724888/article/details/80114720 这位大侠,这是我的公众号:程序员江湖。 分享程序员面试与技术的那些事。 干货满满,关注就送。 本文非常详尽地介绍了Java中的异常,几乎360度无死角。 从异常的概念,分类,使用方法,注意事项和设计等方面全面地介绍了Java异常。 具体代码在我的GitHub中可以找到 https://github.com/h2pl/MyTech 喜欢的话麻烦点下星哈 文章首发于我的个人博客: https://h2pl.github.io/2018/04/27/javase10 更多关于Java后端学习的内容请到我的CSDN博客上查看:https://blog.csdn.net/a724888 为什么要使用异常 首先我们可以明确一点就是异常的处理机制可以确保我们程序的健壮性,提高系统可用率。虽然我们不是特别喜欢看到它,但是我们不能不承认它的地位,作用。 在没有异常机制的时候我们是这样处理的:通过函数的返回值来判断是否发生了异常(这个返回值通常是已经约定好了的),调用该函数的程序负责检查并且分析返回值。虽然可以解决异常问题,但是这样做存在几个缺陷: 1、 容易混淆。如果约定返回值为-11111时表示出现异常,那么当程序最后的计算结果真的为-1111呢? 2、 代码可读性差。将异常处理代码和程序代码混淆在一起将会降低代码的可读性。 3、 由调用函数来分析异常,这要求程序员对库函数有很深的了解。 在OO中提供的异常处理机制是提供代码健壮的强有力的方式。使用异常机制它能够降低错误处理代码的复杂度,如果不使用异常,那么就必须检查特定的错误,并在程序中的许多地方去处理它。 而如果使用异常,那就不必在方法调用处进行检查,因为异常机制将保证能够捕获这个错误,并且,只需在一个地方处理错误,即所谓的异常处理程序中。 这种方式不仅节约代码,而且把“概述在正常执行过程中做什么事”的代码和“出了问题怎么办”的代码相分离。总之,与以前的错误处理方法相比,异常机制使代码的阅读、编写和调试工作更加井井有条。(摘自《Think in java 》)。 该部分内容选自http://www.cnblogs.com/chenssy/p/3438130.html 异常基本定义 在《Think in java》中是这样定义异常的:异常情形是指阻止当前方法或者作用域继续执行的问题。在这里一定要明确一点:异常代码某种程度的错误,尽管Java有异常处理机制,但是我们不能以“正常”的眼光来看待异常,异常处理机制的原因就是告诉你:这里可能会或者已经产生了错误,您的程序出现了不正常的情况,可能会导致程序失败! 那么什么时候才会出现异常呢?只有在你当前的环境下程序无法正常运行下去,也就是说程序已经无法来正确解决问题了,这时它所就会从当前环境中跳出,并抛出异常。抛出异常后,它首先会做几件事。 首先,它会使用new创建一个异常对象,然后在产生异常的位置终止程序,并且从当前环境中弹出对异常对象的引用,这时。异常处理机制就会接管程序,并开始寻找一个恰当的地方来继续执行程序,这个恰当的地方就是异常处理程序。 总的来说异常处理机制就是当程序发生异常时,它强制终止程序运行,记录异常信息并将这些信息反馈给我们,由我们来确定是否处理异常。 异常体系 从上面这幅图可以看出,Throwable是java语言中所有错误和异常的超类(万物即可抛)。它有两个子类:Error、Exception。 Java标准库内建了一些通用的异常,这些类以Throwable为顶层父类。 Throwable又派生出Error类和Exception类。 错误:Error类以及他的子类的实例,代表了JVM本身的错误。错误不能被程序员通过代码处理,Error很少出现。因此,程序员应该关注Exception为父类的分支下的各种异常类。 异常:Exception以及他的子类,代表程序运行时发送的各种不期望发生的事件。可以被Java异常处理机制使用,是异常处理的核心。 总体上我们根据Javac对异常的处理要求,将异常类分为2类。 非检查异常(unckecked exception):Error 和 RuntimeException 以及他们的子类。javac在编译时,不会提示和发现这样的异常,不要求在程序处理这些异常。所以如果愿意,我们可以编写代码处理(使用try…catch…finally)这样的异常,也可以不处理。 对于这些异常,我们应该修正代码,而不是去通过异常处理器处理 。这样的异常发生的原因多半是代码写的有问题。如除0错误ArithmeticException,错误的强制类型转换错误ClassCastException,数组索引越界ArrayIndexOutOfBoundsException,使用了空对象NullPointerException等等。 检查异常(checked exception):除了Error 和 RuntimeException的其它异常。javac强制要求程序员为这样的异常做预备处理工作(使用try…catch…finally或者throws)。在方法中要么用try-catch语句捕获它并处理,要么用throws子句声明抛出它,否则编译不会通过。 这样的异常一般是由程序的运行环境导致的。因为程序可能被运行在各种未知的环境下,而程序员无法干预用户如何使用他编写的程序,于是程序员就应该为这样的异常时刻准备着。如SQLException , IOException,ClassNotFoundException 等。 需要明确的是:检查和非检查是对于javac来说的,这样就很好理解和区分了。 这部分内容摘自http://www.importnew.com/26613.html 初识异常 异常是在执行某个函数时引发的,而函数又是层级调用,形成调用栈的,因为,只要一个函数发生了异常,那么他的所有的caller都会被异常影响。当这些被影响的函数以异常信息输出时,就形成的了异常追踪栈。 异常最先发生的地方,叫做异常抛出点。 public class 异常 { public static void main (String [] args ) { System . out. println( "----欢迎使用命令行除法计算器----" ) ; CMDCalculate (); } public static void CMDCalculate () { Scanner scan = new Scanner ( System. in ); int num1 = scan .nextInt () ; int num2 = scan .nextInt () ; int result = devide (num1 , num2 ) ; System . out. println( "result:" + result) ; scan .close () ; } public static int devide (int num1, int num2 ){ return num1 / num2 ; } // ----欢迎使用命令行除法计算器---- // 1 // 0 // Exception in thread "main" java.lang.ArithmeticException: / by zero // at com.javase.异常.异常.devide(异常.java:24) // at com.javase.异常.异常.CMDCalculate(异常.java:19) // at com.javase.异常.异常.main(异常.java:12) // ----欢迎使用命令行除法计算器---- // r // Exception in thread "main" java.util.InputMismatchException // at java.util.Scanner.throwFor(Scanner.java:864) // at java.util.Scanner.next(Scanner.java:1485) // at java.util.Scanner.nextInt(Scanner.java:2117) // at java.util.Scanner.nextInt(Scanner.java:2076) // at com.javase.异常.异常.CMDCalculate(异常.java:17) // at com.javase.异常.异常.main(异常.java:12) 从上面的例子可以看出,当devide函数发生除0异常时,devide函数将抛出ArithmeticException异常,因此调用他的CMDCalculate函数也无法正常完成,因此也发送异常,而CMDCalculate的caller——main 因为CMDCalculate抛出异常,也发生了异常,这样一直向调用栈的栈底回溯。 这种行为叫做异常的冒泡,异常的冒泡是为了在当前发生异常的函数或者这个函数的caller中找到最近的异常处理程序。由于这个例子中没有使用任何异常处理机制,因此异常最终由main函数抛给JRE,导致程序终止。 上面的代码不使用异常处理机制,也可以顺利编译,因为2个异常都是非检查异常。但是下面的例子就必须使用异常处理机制,因为异常是检查异常。 代码中我选择使用throws声明异常,让函数的调用者去处理可能发生的异常。但是为什么只throws了IOException呢?因为FileNotFoundException是IOException的子类,在处理范围内。 异常和错误 下面看一个例子 //错误即error一般指jvm无法处理的错误 //异常是Java定义的用于简化错误处理流程和定位错误的一种工具。 public class 错误和错误 { Error error = new Error(); public static void main(String[] args) { throw new Error(); } //下面这四个异常或者错误有着不同的处理方法 public void error1 (){ //编译期要求必须处理,因为这个异常是最顶层异常,包括了检查异常,必须要处理 try { throw new Throwable(); } catch (Throwable throwable) { throwable.printStackTrace(); } } //Exception也必须处理。否则报错,因为检查异常都继承自exception,所以默认需要捕捉。 public void error2 (){ try { throw new Exception(); } catch (Exception e) { e.printStackTrace(); } } //error可以不处理,编译不报错,原因是虚拟机根本无法处理,所以啥都不用做 public void error3 (){ throw new Error(); } //runtimeexception众所周知编译不会报错 public void error4 (){ throw new RuntimeException(); } // Exception in thread "main" java.lang.Error // at com.javase.异常.错误.main(错误.java:11) } 异常的处理方式 在编写代码处理异常时,对于检查异常,有2种不同的处理方式: 使用try…catch…finally语句块处理它。 或者,在函数签名中使用throws 声明交给函数调用者caller去解决。 下面看几个具体的例子,包括error,exception和throwable 上面的例子是运行时异常,不需要显示捕获。 下面这个例子是可检查异常需,要显示捕获或者抛出。 @Test public void testException() throws IOException { //FileInputStream的构造函数会抛出FileNotFoundException FileInputStream fileIn = new FileInputStream("E:\\a.txt"); int word; //read方法会抛出IOException while((word = fileIn.read())!=-1) { System.out.print((char)word); } //close方法会抛出IOException fileIn.close(); } 一般情况下的处理方式 try catch finally public class 异常处理方式 { @Test public void main() { try{ //try块中放可能发生异常的代码。 InputStream inputStream = new FileInputStream("a.txt"); //如果执行完try且不发生异常,则接着去执行finally块和finally后面的代码(如果有的话)。 int i = 1/0; //如果发生异常,则尝试去匹配catch块。 throw new SQLException(); //使用1.8jdk同时捕获多个异常,runtimeexception也可以捕获。只是捕获后虚拟机也无法处理,所以不建议捕获。 }catch(SQLException | IOException | ArrayIndexOutOfBoundsException exception){ System.out.println(exception.getMessage()); //每一个catch块用于捕获并处理一个特定的异常,或者这异常类型的子类。Java7中可以将多个异常声明在一个catch中。 //catch后面的括号定义了异常类型和异常参数。如果异常与之匹配且是最先匹配到的,则虚拟机将使用这个catch块来处理异常。 //在catch块中可以使用这个块的异常参数来获取异常的相关信息。异常参数是这个catch块中的局部变量,其它块不能访问。 //如果当前try块中发生的异常在后续的所有catch中都没捕获到,则先去执行finally,然后到这个函数的外部caller中去匹配异常处理器。 //如果try中没有发生异常,则所有的catch块将被忽略。 }catch(Exception exception){ System.out.println(exception.getMessage()); //... }finally{ //finally块通常是可选的。 //无论异常是否发生,异常是否匹配被处理,finally都会执行。 //finally主要做一些清理工作,如流的关闭,数据库连接的关闭等。 } 一个try至少要跟一个catch或者finally try { int i = 1; }finally { //一个try至少要有一个catch块,否则, 至少要有1个finally块。但是finally不是用来处理异常的,finally不会捕获异常。 } } 异常出现时该方法后面的代码不会运行,即使异常已经被捕获。这里举出一个奇特的例子,在catch里再次使用try catch finally @Test public void test() { try { throwE(); System.out.println("我前面抛出异常了"); System.out.println("我不会执行了"); } catch (StringIndexOutOfBoundsException e) { System.out.println(e.getCause()); }catch (Exception ex) { //在catch块中仍然可以使用try catch finally try { throw new Exception(); }catch (Exception ee) { }finally { System.out.println("我所在的catch块没有执行,我也不会执行的"); } } } //在方法声明中抛出的异常必须由调用方法处理或者继续往上抛, // 当抛到jre时由于无法处理终止程序 public void throwE (){ // Socket socket = new Socket("127.0.0.1", 80); //手动抛出异常时,不会报错,但是调用该方法的方法需要处理这个异常,否则会出错。 // java.lang.StringIndexOutOfBoundsException // at com.javase.异常.异常处理方式.throwE(异常处理方式.java:75) // at com.javase.异常.异常处理方式.test(异常处理方式.java:62) throw new StringIndexOutOfBoundsException(); } 其实有的语言在遇到异常后仍然可以继续运行 有的编程语言当异常被处理后,控制流会恢复到异常抛出点接着执行,这种策略叫做:resumption model of exception handling(恢复式异常处理模式 ) 而Java则是让执行流恢复到处理了异常的catch块后接着执行,这种策略叫做:termination model of exception handling(终结式异常处理模式) “不负责任”的throws throws是另一种处理异常的方式,它不同于try…catch…finally,throws仅仅是将函数中可能出现的异常向调用者声明,而自己则不具体处理。 采取这种异常处理的原因可能是:方法本身不知道如何处理这样的异常,或者说让调用者处理更好,调用者需要为可能发生的异常负责。 public void foo() throws ExceptionType1 , ExceptionType2 ,ExceptionTypeN { //foo内部可以抛出 ExceptionType1 , ExceptionType2 ,ExceptionTypeN 类的异常,或者他们的子类的异常对象。 } 纠结的finally finally块不管异常是否发生,只要对应的try执行了,则它一定也执行。只有一种方法让finally块不执行:System.exit()。因此finally块通常用来做资源释放操作:关闭文件,关闭数据库连接等等。 良好的编程习惯是:在try块中打开资源,在finally块中清理释放这些资源。 需要注意的地方: 1、finally块没有处理异常的能力。处理异常的只能是catch块。 2、在同一try…catch…finally块中 ,如果try中抛出异常,且有匹配的catch块,则先执行catch块,再执行finally块。如果没有catch块匹配,则先执行finally,然后去外面的调用者中寻找合适的catch块。 3、在同一try…catch…finally块中 ,try发生异常,且匹配的catch块中处理异常时也抛出异常,那么后面的finally也会执行:首先执行finally块,然后去外围调用者中寻找合适的catch块。 public class finally使用 { public static void main(String[] args) { try { throw new IllegalAccessException(); }catch (IllegalAccessException e) { // throw new Throwable(); //此时如果再抛异常,finally无法执行,只能报错。 //finally无论何时都会执行 //除非我显示调用。此时finally才不会执行 System.exit(0); }finally { System.out.println("算你狠"); } } } throw : JRE也使用的关键字 throw exceptionObject 程序员也可以通过throw语句手动显式的抛出一个异常。throw语句的后面必须是一个异常对象。 throw 语句必须写在函数中,执行throw 语句的地方就是一个异常抛出点,==它和由JRE自动形成的异常抛出点没有任何差别。== public void save(User user) { if(user == null) throw new IllegalArgumentException("User对象为空"); //...... } 后面开始的大部分内容都摘自http://www.cnblogs.com/lulipro/p/7504267.html 该文章写的十分细致到位,令人钦佩,是我目前为之看到关于异常最详尽的文章,可以说是站在巨人的肩膀上了。 异常调用链 异常的链化 在一些大型的,模块化的软件开发中,一旦一个地方发生异常,则如骨牌效应一样,将导致一连串的异常。假设B模块完成自己的逻辑需要调用A模块的方法,如果A模块发生异常,则B也将不能完成而发生异常。 ==但是B在抛出异常时,会将A的异常信息掩盖掉,这将使得异常的根源信息丢失。异常的链化可以将多个模块的异常串联起来,使得异常信息不会丢失。== 异常链化:以一个异常对象为参数构造新的异常对象。新的异对象将包含先前异常的信息。这项技术主要是异常类的一个带Throwable参数的函数来实现的。这个当做参数的异常,我们叫他根源异常(cause)。 查看Throwable类源码,可以发现里面有一个Throwable字段cause,就是它保存了构造时传递的根源异常参数。这种设计和链表的结点类设计如出一辙,因此形成链也是自然的了。 public class Throwable implements Serializable { private Throwable cause = this; public Throwable(String message, Throwable cause) { fillInStackTrace(); detailMessage = message; this.cause = cause; } public Throwable(Throwable cause) { fillInStackTrace(); detailMessage = (cause==null ? null : cause.toString()); this.cause = cause; } //........ } 下面看一个比较实在的异常链例子哈 public class 异常链 { @Test public void test() { C(); } public void A () throws Exception { try { int i = 1; i = i / 0; //当我注释掉这行代码并使用B方法抛出一个error时,运行结果如下 // 四月 27, 2018 10:12:30 下午 org.junit.platform.launcher.core.ServiceLoaderTestEngineRegistry loadTestEngines // 信息: Discovered TestEngines with IDs: [junit-jupiter] // java.lang.Error: B也犯了个错误 // at com.javase.异常.异常链.B(异常链.java:33) // at com.javase.异常.异常链.C(异常链.java:38) // at com.javase.异常.异常链.test(异常链.java:13) // at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) // Caused by: java.lang.Error // at com.javase.异常.异常链.B(异常链.java:29) }catch (ArithmeticException e) { //这里通过throwable类的构造方法将最底层的异常重新包装并抛出,此时注入了A方法的信息。最后打印栈信息时可以看到caused by A方法的异常。 //如果直接抛出,栈信息打印结果只能看到上层方法的错误信息,不能看到其实是A发生了错误。 //所以需要包装并抛出 throw new Exception("A方法计算错误", e); } } public void B () throws Exception,Error { try { //接收到A的异常, A(); throw new Error(); }catch (Exception e) { throw e; }catch (Error error) { throw new Error("B也犯了个错误", error); } } public void C () { try { B(); }catch (Exception | Error e) { e.printStackTrace(); } } //最后结果 // java.lang.Exception: A方法计算错误 // at com.javase.异常.异常链.A(异常链.java:18) // at com.javase.异常.异常链.B(异常链.java:24) // at com.javase.异常.异常链.C(异常链.java:31) // at com.javase.异常.异常链.test(异常链.java:11) // 省略 // Caused by: java.lang.ArithmeticException: / by zero // at com.javase.异常.异常链.A(异常链.java:16) // ... 31 more } 自定义异常 如果要自定义异常类,则扩展Exception类即可,因此这样的自定义异常都属于检查异常(checked exception)。如果要自定义非检查异常,则扩展自RuntimeException。 按照国际惯例,自定义的异常应该总是包含如下的构造函数: 一个无参构造函数 一个带有String参数的构造函数,并传递给父类的构造函数。 一个带有String参数和Throwable参数,并都传递给父类构造函数 一个带有Throwable 参数的构造函数,并传递给父类的构造函数。 下面是IOException类的完整源代码,可以借鉴。 public class IOException extends Exception { static final long serialVersionUID = 7818375828146090155L; public IOException() { super(); } public IOException(String message) { super(message); } public IOException(String message, Throwable cause) { super(message, cause); } public IOException(Throwable cause) { super(cause); } } 异常的注意事项 异常的注意事项 当子类重写父类的带有 throws声明的函数时,其throws声明的异常必须在父类异常的可控范围内——用于处理父类的throws方法的异常处理器,必须也适用于子类的这个带throws方法 。这是为了支持多态。 例如,父类方法throws 的是2个异常,子类就不能throws 3个及以上的异常。父类throws IOException,子类就必须throws IOException或者IOException的子类。 至于为什么?我想,也许下面的例子可以说明。 class Father { public void start() throws IOException { throw new IOException(); } } class Son extends Father { public void start() throws Exception { throw new SQLException(); } } /************假设上面的代码是允许的(实质是错误的)*************/ class Test { public static void main(String[] args) { Father[] objs = new Father[2]; objs[0] = new Father(); objs[1] = new Son(); for(Father obj:objs) { //因为Son类抛出的实质是SQLException,而IOException无法处理它。 //那么这里的try。。catch就不能处理Son中的异常。 //多态就不能实现了。 try { obj.start(); }catch(IOException) { //处理IOException } } } } ==Java的异常执行流程是线程独立的,线程之间没有影响== Java程序可以是多线程的。每一个线程都是一个独立的执行流,独立的函数调用栈。如果程序只有一个线程,那么没有被任何代码处理的异常 会导致程序终止。如果是多线程的,那么没有被任何代码处理的异常仅仅会导致异常所在的线程结束。 也就是说,Java中的异常是线程独立的,线程的问题应该由线程自己来解决,而不要委托到外部,也不会直接影响到其它线程的执行。 下面看一个例子 public class 多线程的异常 { @Test public void test() { go(); } public void go () { ExecutorService executorService = Executors.newFixedThreadPool(3); for (int i = 0;i <= 2;i ++) { int finalI = i; try { Thread.sleep(2000); } catch (InterruptedException e) { e.printStackTrace(); } executorService.execute(new Runnable() { @Override //每个线程抛出异常时并不会影响其他线程的继续执行 public void run() { try { System.out.println("start thread" + finalI); throw new Exception(); }catch (Exception e) { System.out.println("thread" + finalI + " go wrong"); } } }); } // 结果: // start thread0 // thread0 go wrong // start thread1 // thread1 go wrong // start thread2 // thread2 go wrong } } 当finally遇上return 首先一个不容易理解的事实: 在 try块中即便有return,break,continue等改变执行流的语句,finally也会执行。 public static void main(String[] args) { int re = bar(); System.out.println(re); } private static int bar() { try{ return 5; } finally{ System.out.println("finally"); } } /*输出: finally */ 很多人面对这个问题时,总是在归纳执行的顺序和规律,不过我觉得还是很难理解。我自己总结了一个方法。用如下GIF图说明。 也就是说:try…catch…finally中的return 只要能执行,就都执行了,他们共同向同一个内存地址(假设地址是0×80)写入返回值,后执行的将覆盖先执行的数据,而真正被调用者取的返回值就是最后一次写入的。那么,按照这个思想,下面的这个例子也就不难理解了。 finally中的return 会覆盖 try 或者catch中的返回值。 public static void main(String[] args) { int result; result = foo(); System.out.println(result); /////////2 result = bar(); System.out.println(result); /////////2 } @SuppressWarnings("finally") public static int foo() { trz{ int a = 5 / 0; } catch (Exception e){ return 1; } finally{ return 2; } } @SuppressWarnings("finally") public static int bar() { try { return 1; }finally { return 2; } } finally中的return会抑制(消灭)前面try或者catch块中的异常 class TestException { public static void main(String[] args) { int result; try{ result = foo(); System.out.println(result); //输出100 } catch (Exception e){ System.out.println(e.getMessage()); //没有捕获到异常 } try{ result = bar(); System.out.println(result); //输出100 } catch (Exception e){ System.out.println(e.getMessage()); //没有捕获到异常 } } //catch中的异常被抑制 @SuppressWarnings("finally") public static int foo() throws Exception { try { int a = 5/0; return 1; }catch(ArithmeticException amExp) { throw new Exception("我将被忽略,因为下面的finally中使用了return"); }finally { return 100; } } //try中的异常被抑制 @SuppressWarnings("finally") public static int bar() throws Exception { try { int a = 5/0; return 1; }finally { return 100; } } } finally中的异常会覆盖(消灭)前面try或者catch中的异常 class TestException { public static void main(String[] args) { int result; try{ result = foo(); } catch (Exception e){ System.out.println(e.getMessage()); //输出:我是finaly中的Exception } try{ result = bar(); } catch (Exception e){ System.out.println(e.getMessage()); //输出:我是finaly中的Exception } } //catch中的异常被抑制 @SuppressWarnings("finally") public static int foo() throws Exception { try { int a = 5/0; return 1; }catch(ArithmeticException amExp) { throw new Exception("我将被忽略,因为下面的finally中抛出了新的异常"); }finally { throw new Exception("我是finaly中的Exception"); } } //try中的异常被抑制 @SuppressWarnings("finally") public static int bar() throws Exception { try { int a = 5/0; return 1; }finally { throw new Exception("我是finaly中的Exception"); } } } 上面的3个例子都异于常人的编码思维,因此我建议: 不要在fianlly中使用return。 不要在finally中抛出异常。 减轻finally的任务,不要在finally中做一些其它的事情,finally块仅仅用来释放资源是最合适的。 将尽量将所有的return写在函数的最后面,而不是try … catch … finally中。

优秀的个人博客,低调大师

Java 发送qq邮件基础和封装

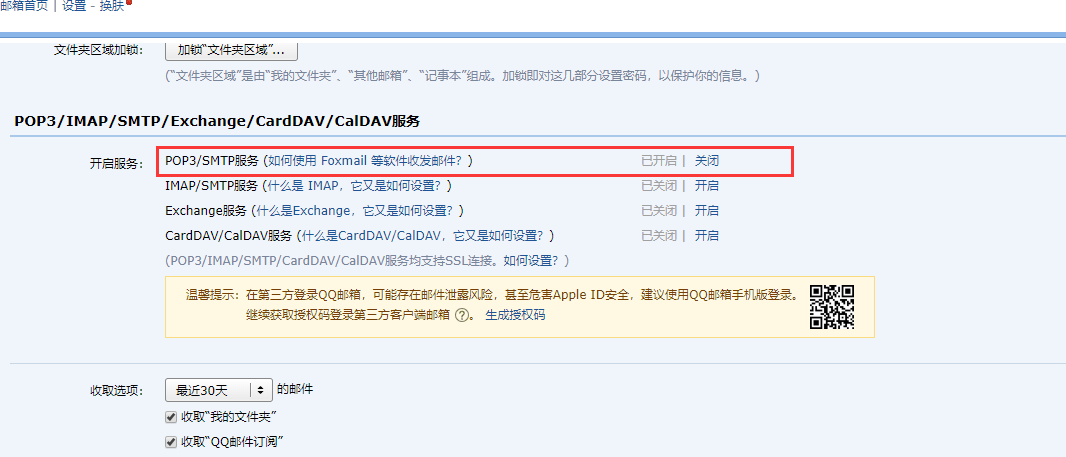
前文摘自 菜鸟教程 :http://www.runoob.com/java/java-sending-email.html 使用Java应用程序发送 E-mail 十分简单,但是首先你应该在你的机器上安装 JavaMail API 和Java Activation Framework (JAF) 。 您可以从 Java 网站下载最新版本的 JavaMail,打开网页右侧有个 Downloads 链接,点击它下载。 您可以从 Java 网站下载最新版本的 JAF(版本 1.1.1)。 你也可以使用本站提供的下载链接: JavaMail mail.jar 1.4.5 JAF(版本 1.1.1) activation.jar 下载并解压缩这些文件,在新创建的顶层目录中,您会发现这两个应用程序的一些 jar 文件。您需要把 mail.jar 和 activation.jar文件添加到您的 CLASSPATH 中。 如果你使用第三方邮件服务器如QQ的SMTP服务器,可查看文章底部用户认证完整的实例。 发送一封简单的 E-mail 下面是一个发送简单E-mail的例子。假设你的localhost已经连接到网络。 如果需要提供用户名和密码给e-mail服务器来达到用户认证的目的,你可以通过如下设置来完成: props.put("mail.smtp.auth", "true"); props.setProperty("mail.user", "myuser"); props.setProperty("mail.password", "mypwd"); 需要用户名密码验证邮件发送实例: 你需要在登录QQ邮箱后台在"设置"=》账号中开启POP3/SMTP服务 ,如下图所示: 我这里已经开启了。需要生成授权码,仔细看说明就行。生成授权码后会给你一串字符,它是密码 SendEmail2.java // 需要用户名密码邮件发送实例 //文件名 SendEmail2.java //本实例以QQ邮箱为例,你需要在qq后台设置 import java.util.Properties; import javax.mail.Authenticator; import javax.mail.Message; import javax.mail.MessagingException; import javax.mail.PasswordAuthentication; import javax.mail.Session; import javax.mail.Transport; import javax.mail.internet.InternetAddress; import javax.mail.internet.MimeMessage; public class SendEmail2 { public static void main(String [] args) { // 收件人电子邮箱 String to = "xxx@qq.com"; // 发件人电子邮箱 String from = "xxx@qq.com"; // 指定发送邮件的主机为 smtp.qq.com String host = "smtp.qq.com"; //QQ 邮件服务器 // 获取系统属性 Properties properties = System.getProperties(); // 设置邮件服务器 properties.setProperty("mail.smtp.host", host); properties.put("mail.smtp.auth", "true"); // 获取默认session对象 Session session = Session.getDefaultInstance(properties,new Authenticator(){ public PasswordAuthentication getPasswordAuthentication() { return new PasswordAuthentication("xxx@qq.com", "qq邮箱密码"); //发件人邮件用户名、密码 } }); try{ // 创建默认的 MimeMessage 对象 MimeMessage message = new MimeMessage(session); // Set From: 头部头字段 message.setFrom(new InternetAddress(from)); // Set To: 头部头字段 message.addRecipient(Message.RecipientType.TO, new InternetAddress(to)); // Set Subject: 头部头字段 message.setSubject("This is the Subject Line!"); // 设置消息体 message.setText("This is actual message"); // 发送消息 Transport.send(message); System.out.println("Sent message successfully....from runoob.com"); }catch (MessagingException mex) { mex.printStackTrace(); } } } 企业级开发封装 实体类 MailEntity .java package com.fantj.myEmail; /** * 邮件实体类 * Created by Fant.J. */ @Data public class MailEntity implements Serializable { //此处填写SMTP服务器 private String smtpService; //设置端口号 private String smtpPort; //设置发送邮箱 private String fromMailAddress; // 设置发送邮箱的STMP口令 private String fromMailStmpPwd; //设置邮件标题 private String title; //设置邮件内容 private String content; //内容格式(默认采用html) private String contentType; //接受邮件地址集合 private List<String> list = new ArrayList<>(); } enum 类 MailContentTypeEnum .java package com.fantj.myEmail.emailEnum; /** * 自定义的枚举类型,枚举类型包含了邮件内容的类型 * Created by Fant.J. */ public enum MailContentTypeEnum { HTML("text/html;charset=UTF-8"), //html格式 TEXT("text") ; private String value; MailContentTypeEnum(String value) { this.value = value; } public String getValue() { return value; } } package com.fantj.myEmail.emailEnum; /** * 自定义的枚举类型,枚举类型包含了邮件内容的类型 * Created by Fant.J. */ public enum MailContentTypeEnum { HTML("text/html;charset=UTF-8"), //html格式 TEXT("text") ; private String value; MailContentTypeEnum(String value) { this.value = value; } public String getValue() { return value; } } 邮件发送类 MailSender .java package com.fantj.myEmail; /** * 邮件发送类 * Created by Fant.J. */ public class MailSender { //邮件实体 private static MailEntity mail = new MailEntity(); /** * 设置邮件标题 * @param title 标题信息 * @return */ public MailSender title(String title){ mail.setTitle(title); return this; } /** * 设置邮件内容 * @param content * @return */ public MailSender content(String content) { mail.setContent(content); return this; } /** * 设置邮件格式 * @param typeEnum * @return */ public MailSender contentType(MailContentTypeEnum typeEnum) { mail.setContentType(typeEnum.getValue()); return this; } /** * 设置请求目标邮件地址 * @param targets * @return */ public MailSender targets(List<String> targets) { mail.setList(targets); return this; } /** * 执行发送邮件 * @throws Exception 如果发送失败会抛出异常信息 */ public void send() throws Exception { //默认使用html内容发送 if(mail.getContentType() == null) { mail.setContentType(MailContentTypeEnum.HTML.getValue()); } if(mail.getTitle() == null || mail.getTitle().trim().length() == 0) { throw new Exception("邮件标题没有设置.调用title方法设置"); } if(mail.getContent() == null || mail.getContent().trim().length() == 0) { throw new Exception("邮件内容没有设置.调用content方法设置"); } if(mail.getList().size() == 0) { throw new Exception("没有接受者邮箱地址.调用targets方法设置"); } //读取/resource/mail_zh_CN.properties文件内容 final PropertiesUtil properties = new PropertiesUtil("mail"); // 创建Properties 类用于记录邮箱的一些属性 final Properties props = new Properties(); // 表示SMTP发送邮件,必须进行身份验证 props.put("mail.smtp.auth", "true"); //此处填写SMTP服务器 props.put("mail.smtp.host", properties.getValue("mail.smtp.service")); //设置端口号,QQ邮箱给出了两个端口465/587 props.put("mail.smtp.port", properties.getValue("mail.smtp.prot")); // 设置发送邮箱 props.put("mail.user", properties.getValue("mail.from.address")); // 设置发送邮箱的16位STMP口令 props.put("mail.password", properties.getValue("mail.from.smtp.pwd")); // 构建授权信息,用于进行SMTP进行身份验证 Authenticator authenticator = new Authenticator() { @Override protected PasswordAuthentication getPasswordAuthentication() { // 用户名、密码 String userName = props.getProperty("mail.user"); String password = props.getProperty("mail.password"); return new PasswordAuthentication(userName, password); } }; // 使用环境属性和授权信息,创建邮件会话 Session mailSession = Session.getInstance(props, authenticator); // 创建邮件消息 MimeMessage message = new MimeMessage(mailSession); // 设置发件人 String nickName = MimeUtility.encodeText(properties.getValue("mail.from.nickname")); InternetAddress form = new InternetAddress(nickName + " <" + props.getProperty("mail.user") + ">"); message.setFrom(form); // 设置邮件标题 message.setSubject(mail.getTitle()); //html发送邮件 if(mail.getContentType().equals(MailContentTypeEnum.HTML.getValue())) { // 设置邮件的内容体 message.setContent(mail.getContent(), mail.getContentType()); } //文本发送邮件 else if(mail.getContentType().equals(MailContentTypeEnum.TEXT.getValue())){ message.setText(mail.getContent()); } //发送邮箱地址 List<String> targets = mail.getList(); for(int i = 0;i < targets.size();i++){ try { // 设置收件人的邮箱 InternetAddress to = new InternetAddress(targets.get(i)); message.setRecipient(Message.RecipientType.TO, to); // 最后当然就是发送邮件啦 Transport.send(message); }catch (Exception e) { continue; } } } } 配置文件的读取工具类 PropertiesUtil .java package com.fantj.myEmail; /** * PropertiesUtil是用于读取*.properties配置文件的工具类 * Created by Fant.J. */ public class PropertiesUtil { private final ResourceBundle resource; private final String fileName; /** * 构造函数实例化部分对象,获取文件资源对象 * * @param fileName */ public PropertiesUtil(String fileName) { this.fileName = fileName; this.resource = ResourceBundle.getBundle(this.fileName, Locale.SIMPLIFIED_CHINESE); } /** * 根据传入的key获取对象的值 getValue * * @param key properties文件对应的key * @return String 解析后的对应key的值 */ public String getValue(String key) { String message = this.resource.getString(key); return message; } /** * 获取properties文件内的所有key值<br> * @return */ public Enumeration<String> getKeys(){ return resource.getKeys(); } } 配置文件 mail.properties mail.smtp.service=smtp.qq.com mail.smtp.prot=587 mail.from.address=844072586@qq.com mail.from.smtp.pwd=这里填写自己的授权码 mail.from.nickname=这里填写 将名字转换成ascii码放在这里 测试类 MailTest .java package com.fantj.myEmail; /** * Created by Fant.J. */ public class MailTest { @Test public void test() throws Exception { for (int i = 0;i<20;i++){ new MailSender() .title("焦哥给你发送的邮件") .content("你就是傻") .contentType(MailContentTypeEnum.TEXT) .targets(new ArrayList<String>(){{ add("xxxxx@qq.com"); }}) .send(); Thread.sleep(1000); System.out.println("第"+i+"次发送成功!"); } } } ok了,自己动手试试吧。

优秀的个人博客,低调大师

NLTK基础教程学习笔记(十三)

在信息摘要应用中还包含着另一种理论逻辑:重要的句子中通常包含着重要的词汇,而跨语料库的差异词(discriminatory word)绝大多数数是重要词汇。因此,句子中包含具有差异很大的词汇,它就很重要。这样就得到一个非常简单的测量方法,就是计算每一个词各种的TF-IDF(term frequency-inverse document )分值,然后根据词汇的重要性找出一种标准化的凭据评分。这个评分就可以用来充当在信息摘要中选取句子的标准。 TF-IDF(term frequency–inverse document frequency)是一种用于资讯检索与资讯探勘的常用加权技术。TF-IDF是一种统计方法,用以评估一字词对于一个文件集或一个语料库中的其中一份文件的重要程度。字词的重要性随着它在文件中出现的次数成正比增加,但同时会随着它在语料库中出现的频率成反比下降。TF-IDF加权的各种形式常被搜寻引擎应用,作为文件与用户查询之间相关程度的度量或评级。除了TF-IDF以外,因特网上的搜寻引擎还会使用基于连结分析的评级方法,以确定文件在搜寻结果中出现的顺序。按照其不拿整段介绍来做,只拿前三句来实践,我拿了前一段: import nltk from sklearn.feature_extraction.text import TfidfVectorizer f=open('news.txt') news_content=f.read() results=[] sentences=nltk.sent_tokenize(news_content) vectorizer=TfidfVectorizer(norm='l2',min_df=0,use_idf=True,smooth_idf=False,sublinear_tf=True) sklearn_binary=vectorizer.fit_transform(sentences) print(vectorizer.get_feature_names()) print(sklearn_binary.toarray()) 结果: ['accept', 'accepting', 'altria', 'and', 'announce', 'approaches', 'arthur', 'as', 'at', 'be', 'birth', 'britain', 'british', 'by', 'caliburn', 'ceremonial', 'character', 'decides', 'despite', 'destined', 'dies', 'draws', 'ector', 'eligible', 'embedded', 'enters', 'entrusted', 'explaining', 'fearing', 'fifteen', 'following', 'for', 'full', 'gender', 'growing', 'hardships', 'heir', 'her', 'hesitation', 'his', 'however', 'if', 'in', 'inspired', 'invasion', 'is', 'king', 'knight', 'known', 'large', 'leadership', 'leaving', 'legends', 'legitimate', 'loyal', 'mantle', 'merlin', 'monarch', 'name', 'nativity', 'never', 'no', 'not', 'of', 'or', 'pendragon', 'people', 'period', 'preserving', 'publicly', 'pulling', 'raises', 'recognize', 'responsible', 'ruler', 'saber', 'saxons', 'she', 'shoulders', 'sir', 'slab', 'son', 'soon', 'stone', 'subjects', 'surrogate', 'sword', 'symbolic', 'that', 'the', 'this', 'threat', 'throne', 'to', 'turmoil', 'uther', 'welfare', 'when', 'who', 'will', 'withdraws', 'without', 'woman'] [[ 0. 0. 0.15095332 0. 0. 0. 0.31622502 0. 0. 0. 0. 0. 0. 0.20340954 0. 0. 0.31622502 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.31622502 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.31622502 0. 0.17386773 0.24504638 0. 0. 0. 0. 0. 0.31622502 0. 0. 0. 0. 0. 0.31622502 0. 0. 0. 0. 0.15095332 0. 0.31622502 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.31622502 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.15095332 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. ] [ 0.23250474 0. 0.11098857 0. 0.23250474 0. 0. 0.14955705 0.23250474 0. 0.23250474 0. 0. 0. 0. 0. 0. 0.23250474 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.23250474 0. 0. 0. 0. 0.18017058 0. 0. 0. 0.11098857 0. 0.23250474 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.23250474 0. 0. 0. 0. 0. 0.23250474 0.23250474 0. 0.23250474 0. 0.23250474 0. 0. 0. 0. 0.23250474 0. 0. 0. 0. 0.18017058 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.23250474 0. 0. 0. 0. 0. 0. 0. 0. 0.14955705 0. 0.18017058 0. 0. 0. 0.14955705 0. 0. 0.23250474] [ 0. 0. 0. 0. 0. 0. 0. 0.18736875 0. 0. 0. 0. 0. 0.18736875 0. 0. 0. 0. 0. 0. 0. 0. 0.29128766 0. 0. 0. 0.29128766 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.13904921 0. 0. 0. 0. 0. 0. 0. 0.1601566 0. 0.29128766 0. 0. 0. 0. 0. 0. 0.29128766 0. 0.22572213 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.29128766 0. 0. 0. 0. 0. 0.18736875 0. 0.29128766 0. 0.29128766 0. 0. 0. 0.29128766 0. 0. 0. 0. 0. 0. 0. 0.18736875 0. 0. 0. 0. 0.29128766 0. 0. 0. 0. ] [ 0. 0. 0.14155101 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.29652856 0. 0. 0.29652856 0. 0. 0. 0. 0. 0.29652856 0. 0. 0. 0. 0. 0. 0.29652856 0. 0. 0. 0. 0. 0. 0. 0. 0.16303816 0.22978336 0. 0.29652856 0. 0. 0.29652856 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.29652856 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.14155101 0. 0. 0.29652856 0.19073992 0. 0.22978336 0. 0.29652856 0. 0. 0. 0. 0. ] [ 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.24121053 0. 0.20022545 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.31127497 0. 0. 0. 0. 0.31127497 0. 0. 0. 0.31127497 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.31127497 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.25158536 0. 0. 0. 0.31127497 0. 0. 0. 0. 0. 0. 0. 0. 0.31127497 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.25158536 0. 0.31127497 0. 0. 0.31127497 0. 0. 0. 0. 0. 0. 0. 0. ] [ 0. 0. 0.10632924 0. 0. 0.22274414 0. 0.14327861 0. 0. 0. 0. 0.22274414 0. 0.17260697 0.22274414 0. 0. 0. 0.22274414 0. 0. 0. 0. 0.22274414 0. 0. 0.22274414 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.10632924 0. 0. 0. 0.22274414 0.22274414 0. 0. 0. 0. 0. 0. 0.22274414 0. 0. 0. 0. 0. 0. 0.17260697 0. 0. 0. 0. 0. 0. 0.10632924 0. 0. 0.17260697 0. 0. 0. 0. 0. 0.22274414 0. 0.17260697 0. 0. 0.14327861 0. 0. 0.22274414 0. 0.22274414 0.22274414 0. 0. 0.17260697 0. 0.22274414 0.10632924 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.14327861 0.22274414 0. 0. ] [ 0. 0.24521796 0.11705736 0.19002219 0. 0. 0. 0. 0. 0.24521796 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.24521796 0. 0. 0. 0.24521796 0. 0.11705736 0. 0. 0.24521796 0. 0. 0. 0. 0.13482643 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.24521796 0. 0. 0. 0. 0. 0.24565801 0. 0. 0.19002219 0. 0.24521796 0. 0.24521796 0. 0. 0.24521796 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.19002219 0.24521796 0. 0.19819534 0.24521796 0. 0. 0. 0. 0. 0.24521796 0. 0. 0.15773474 0. 0. 0. ] [ 0. 0. 0. 0.38872173 0. 0. 0. 0. 0. 0. 0. 0.22958532 0. 0. 0.22958532 0. 0. 0. 0.29627299 0. 0. 0.29627299 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.22958532 0. 0. 0. 0.14142901 0.29627299 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.29627299 0. 0. 0. 0. 0.29627299 0. 0. 0. 0. 0. 0. 0. 0.14142901 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.19057553 0.29627299 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0. 0.29627299 0. ]]

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册