基于SpirngBoot的企业级后台管理框架Guns完整解析
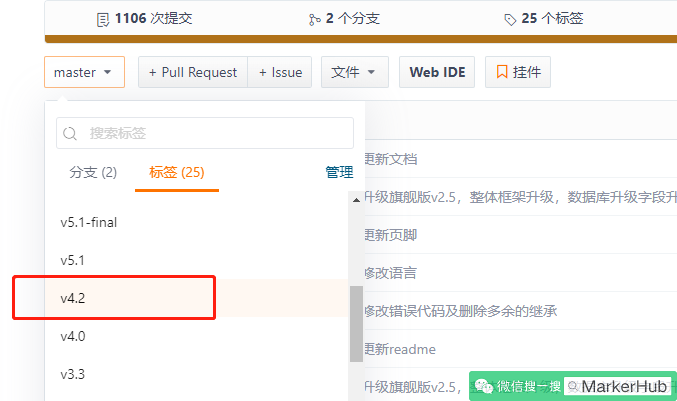
小Hub领读: guns这个项目相信很多人都知道,不知道你们有没完整读过呢,今天一起跟着小Hub来学习下哈。 一共几个主要模块比较重要: map + warpper模式 Api数据传输安全 数据范围限定 视频讲解:https://www.bilibili.com/video/BV1P5411j7yA/ 简介 Guns基于SpringBoot 2,致力于做更简洁的后台管理系统。Guns项目代码简洁,注释丰富,上手容易,同时Guns包含许多基础模块(用户管理,角色管理,部门管理,字典管理等10个模块),可以直接作为一个后台管理系统的脚手架! 官网:https://www.stylefeng.cn 视频讲解:https://www.bilibili.com/video/BV1P5411j7yA/ 本次解读版本:tag-v4.2版本,因为5.0后的项目都是maven单项目,核心类都封装到jar中了,所以学习的话最好使用v4.2的最后一版本maven多模块项目学习。 https://gitee.com/stylefeng/guns/tree/v4.2/ 项目特点 基于SpringBoot,简化了大量项目配置和maven依赖,让您更专注于业务开发,独特的分包方式,代码多而不乱。 完善的日志记录体系,可记录登录日志,业务操作日志(可记录操作前和操作后的数据),异常日志到数据库,通过@BussinessLog注解和LogObjectHolder.me().set()方法,业务操作日志可具体记录哪个用户,执行了哪些业务,修改了哪些数据,并且日志记录为异步执行,详情请见@BussinessLog注解和LogObjectHolder,LogManager,LogAop类。 利用beetl模板引擎对前台页面进行封装和拆分,使臃肿的html代码变得简洁,更加易维护。 对常用js插件进行二次封装,使js代码变得简洁,更加易维护,具体请见webapp/static/js/common文件夹内js代码。 利用ehcache框架对经常调用的查询进行缓存,提升运行速度,具体请见ConstantFactory类中@Cacheable标记的方法。 controller层采用map + warpper方式的返回结果,返回给前端更为灵活的数据,具体参见com.stylefeng.guns.modular.system.warpper包中具体类。 简单可用的代码生成体系,通过SimpleTemplateEngine可生成带有主页跳转和增删改查的通用控制器、html页面以及相关的js,还可以生成Service和Dao,并且这些生成项都为可选的,通过ContextConfig下的一些列xxxSwitch开关,可灵活控制生成模板代码,让您把时间放在真正的业务上。 控制器层统一的异常拦截机制,利用@ControllerAdvice统一对异常拦截,具体见com.stylefeng.guns.core.aop.GlobalExceptionHandler类。 技术选型 springboot mybatis plus shiro beetl ehcache jwt 模块分析 学习一个项目就是学习项目的亮点地方,在分析guns的过程中,有些地方值得我们学习,下面我们一一来分析: map + warpper模式 访问后台的用户列表时候,我们通常需要去查询用户表,但是用户表里面有些外键,比如角色信息、部门信息等。因此有时候我们查询列表时候一般在mapper中关联查询,然后得到记录。 官网介绍: map+warpper方式即为把controller层的返回结果使用BeanKit工具类把原有bean转化为Map的的形式(或者原有bean直接是map的形式),再用单独写的一个包装类再包装一次这个map,使里面的参数更加具体,更加有含义,下面举一个例子,例如,在返回给前台一个性别时,数据库查出来1是男2是女,假如直接返回给前台,那么前台显示的时候还需要增加一次判断,并且前后端分离开发时又增加了一次交流和文档的成本,但是采用warpper包装的形式,可以直接把返回结果包装一下,例如动态增加一个字段sexName直接返回给前台性别的中文名称即可。 guns项目中,作者说独创了一种map+warpper模式。我们来看下是如何实现的。 看看下UserController的代码: /** * 查询管理员列表 */ @RequestMapping("/list") @Permission @ResponseBody public Object list(@RequestParam(required = false) String name , @RequestParam(required = false) String beginTime , @RequestParam(required = false) String endTime , @RequestParam(required = false) Integer deptid) { if (ShiroKit.isAdmin()) { List<Map<String, Object>> users = userService.selectUsers(null, name, beginTime, endTime, deptid); return new UserWarpper(users).warp(); } else { DataScope dataScope = new DataScope(ShiroKit.getDeptDataScope()); List<Map<String, Object>> users = userService.selectUsers(dataScope, name, beginTime, endTime, deptid); return new UserWarpper(users).warp(); } } userService.selectUsers中只是一个单表的查询操作,没有关联其他表,因此查询出来的结果中有些字段需要手动转换,比如sex、roleId等,因此作者定义了一个UserWarpper,用来转换这些特殊字段,比如sex存的0转成男,roleId查库之后转成角色名称等。 /** * 用户管理的包装类 * * @author fengshuonan * @date 2017年2月13日 下午10:47:03 */ public class UserWarpper extends BaseControllerWarpper { public UserWarpper(List<Map<String, Object>> list) { super(list); } @Override public void warpTheMap(Map<String, Object> map) { map.put("sexName", ConstantFactory.me().getSexName((Integer) map.get("sex"))); map.put("roleName", ConstantFactory.me().getRoleName((String) map.get("roleid"))); map.put("deptName", ConstantFactory.me().getDeptName((Integer) map.get("deptid"))); map.put("statusName", ConstantFactory.me().getStatusName((Integer) map.get("status"))); } } 因为mybatis plus支持查询返回map的形式,所以只需要把map传进来,就可以转换成功,如果查询结果是一个实体的bean,那就先转成map,然后再用warpTheMap。其中BaseControllerWarpper也是一个关键抽象类,提供转换结果。 日志模块 日志记录采用aop(LogAop类)方式对所有包含@BussinessLog注解的方法进行aop切入,会记录下当前用户执行了哪些操作(即@BussinessLog value属性的内容)。 如果涉及到数据修改,会取当前http请求的所有requestParameters与LogObjectHolder类中缓存的Object对象的所有字段作比较(所以在编辑之前的获取详情接口中需要缓存被修改对象之前的字段信息),日志内容会异步存入数据库中(通过ScheduledThreadPoolExecutor类)。 日志注解标识:com.stylefeng.guns.core.common.annotion.BussinessLog 日志处理切面:com.stylefeng.guns.core.aop.LogAop 日志记录字段字典:com.stylefeng.guns.core.common.constant.dictmap.base.AbstractDictMap 任务式保存记录:LogManager.me().executeLog(TimerTask task) jwt校验 在之前的课程中,我们已经说过了很多次jwt的形式作为用户的token,在这项目中,jwt讲到了与Api的数据传输安全结合起来一起运用。首先我们看下guns-rest项目,打开com.stylefeng.guns.rest.modular.auth.controller.AuthController,这个类是客户端调用登录生成Jwt的地方。 @RestController public class AuthController { @Autowired private JwtTokenUtil jwtTokenUtil; @Resource(name = "simpleValidator") private IReqValidator reqValidator; /** * 请求生成jwt * * @param authRequest * @return */ @RequestMapping(value = "${jwt.auth-path}") public ResponseEntity<?> createAuthenticationToken(AuthRequest authRequest) { boolean validate = reqValidator.validate(authRequest); if (validate) { final String randomKey = jwtTokenUtil.getRandomKey(); final String token = jwtTokenUtil.generateToken(authRequest.getUserName(), randomKey); return ResponseEntity.ok(new AuthResponse(token, randomKey)); } else { throw new GunsException(BizExceptionEnum.AUTH_REQUEST_ERROR); } } } 来说明一下上面的代码: IReqValidator :账号密码校验器 DbValidator SimpleValidator randomKey :随机生成的key,用于数据安全校验 token:生成保护用户id的jwt 所以app登录调用这接口生成的值如下: { "randomKey": "1jim2v", "token": "eyJhbGciOiJIUzUxMiJ9.eyJyYW5kb21LZXkiOiIxamltMnYiLCJzdWIiOiJhZG1pbiIsImV4cCI6MTU2MjM5NjgwNCwiaWF0IjoxNTYxNzkyMDA0fQ.vr3HwhV_e8MrpNZY0rxbqs1cOzHIBdon4cQT-Gs9wvmv8UZEBbc4QNSMxTh_ulcVpkaw2uwZY4_8zJ7I2G-36Q" } 好了,客户端拿到token之后,每次请求需要在header中把token带上,然后服务过滤器校验 AuthFilter:校验jwt是否过期和是否正确 //验证token是否过期,包含了验证jwt是否正确 boolean flag = jwtTokenUtil.isTokenExpired(authToken); ok,jwt的生成和校验逻辑都很简单,下面我们来说说接口传输安全是怎么做到的。 Api数据传输安全 上面我们说到客户端登录之后拿到了一个token和randomKey,token是用来校验用户身份的,那么这个randomKey是用来干嘛的呢,其实是用来做数据安全加密的。 当开启传输安全模式时候,客户端发送数据给服务器的时候会进行加密传输,具体的加密过程,guns中有一个com.stylefeng.guns.jwt.DecryptTest: public static void main(String[] args) { String salt = "1jim2v"; SimpleObject simpleObject = new SimpleObject(); simpleObject.setUser("stylefeng"); simpleObject.setAge(12); simpleObject.setName("ffff"); simpleObject.setTips("code"); String jsonString = JSON.toJSONString(simpleObject); String encode = new Base64SecurityAction().doAction(jsonString); String md5 = MD5Util.encrypt(encode + salt); BaseTransferEntity baseTransferEntity = new BaseTransferEntity(); baseTransferEntity.setObject(encode); baseTransferEntity.setSign(md5); System.out.println(JSON.toJSONString(baseTransferEntity)); } 上面的过程就是把simpleObject 对象进行new Base64SecurityAction().doAction自定义加密(可自定义,项目只是简单Base64编码),然后加把加密后的值和salt进行Md5计算,得出来的md5就是签名,那么这个salt是哪里来的呢,其实这个salt的值就是randomKey的值。 DataSecurityAction:加密、解密的抽象类 Base64SecurityAction:其中一种实现,简单的Base64编码完成加密解密 如果其他方式的直接实现DataSecurityAction即可 上面的main方法运行之后得到的值如下: {"object":"eyJhZ2UiOjEyLCJuYW1lIjoiZmZmZiIsInRpcHMiOiJjb2RlIiwidXNlciI6InN0eWxlZmVuZyJ9", "sign":"34bdd49a0838b1ef69cca928d71e885d"} 因此,客户端就是把这串数据传送到服务器: 注意要填请求头:Authorization的值是:Bearer+空格+token,这个可以从AuthFilter中知道 好了,上面发送给hello接口,那么我们看下是如何接收和解密的,首先来看下接口: @Controller @RequestMapping("/hello") public class ExampleController { @RequestMapping("") public ResponseEntity hello(@RequestBody SimpleObject simpleObject) { System.out.println(simpleObject.getUser()); return ResponseEntity.ok("请求成功!"); } } 貌似没啥特殊的,参数SimpleObject应该是解析之后得到的值得,我们都知道,我们把参数写到控制器中时候,spring会自动帮我们完成参数注入到实体bean的过程,我们传过来的是一个加密的json,spring是帮不了我们自动解析的,因此,这里我们要做个手动转换json(解密)的过程,再完成注入; 先来分析一下spring的过程:在springboot项目里当我们在控制器类上加上@RestController注解或者其内的方法上加入@ResponseBody注解后,默认会使用jackson插件来返回json数据。 因此我们需要实现手动转成json与bean,只需要继承FastJsonHttpMessageConverter,重写read的过程。 guns项目中有WithSignMessageConverter 这样一个类: /** * 带签名的http信息转化器 * * @author fengshuonan * @date 2017-08-25 15:42 */ public class WithSignMessageConverter extends FastJsonHttpMessageConverter { @Autowired JwtProperties jwtProperties; @Autowired JwtTokenUtil jwtTokenUtil; @Autowired DataSecurityAction dataSecurityAction; @Override public Object read(Type type, Class<?> contextClass , HttpInputMessage inputMessage) throws IOException, HttpMessageNotReadableException { InputStream in = inputMessage.getBody(); Object o = JSON.parseObject(in, super.getFastJsonConfig().getCharset(), BaseTransferEntity.class, super.getFastJsonConfig().getFeatures()); //先转化成原始的对象 BaseTransferEntity baseTransferEntity = (BaseTransferEntity) o; //校验签名 String token = HttpKit.getRequest().getHeader(jwtProperties.getHeader()).substring(7); String md5KeyFromToken = jwtTokenUtil.getMd5KeyFromToken(token); String object = baseTransferEntity.getObject(); String json = dataSecurityAction.unlock(object); String encrypt = MD5Util.encrypt(object + md5KeyFromToken); if (encrypt.equals(baseTransferEntity.getSign())) { System.out.println("签名校验成功!"); } else { System.out.println("签名校验失败,数据被改动过!"); throw new GunsException(BizExceptionEnum.SIGN_ERROR); } //校验签名后再转化成应该的对象 return JSON.parseObject(json, type); } } 分析:首先从body中获取到json数据,然后从header中获取到jwt的token(为了拿到randomKey),然后再Md5计算,比较传过来的sign,一致代表数据是没被串改过的,然后dataSecurityAction.unlock解密得到原始的json数据,最后调用JSON.parseObject(json, type);把json转成SimpleObject,所以整过过程就是这样,perfect。 数据范围限定 关于数据范围限定的概念很多人不知道,我们先来看下效果: 超级用户:admin登录查看用户列表 运营主管(运营部):test登录查看用户列表 从上面的两个登录账号中可以很直观看到,admin作为超级管理员,可以看到所有的数据,而test作为运营部的运营主管角色只能看到自己部门下的用户。 因此数据范围限定的意思就是根据用户的角色决定用户能查看的数据范围。 要完成这个功能有两个关键类: DataScope: public class DataScope { /** * 限制范围的字段名称 */ private String scopeName = "deptid"; /** * 具体的数据范围 */ private List<Integer> deptIds; ... } DataScopeInterceptor @Intercepts({@Signature(type = StatementHandler.class, method = "prepare", args = {Connection.class, Integer.class})}) public class DataScopeInterceptor implements Interceptor { @Override public Object intercept(Invocation invocation) throws Throwable { StatementHandler statementHandler = (StatementHandler) PluginUtils.realTarget(invocation.getTarget()); MetaObject metaStatementHandler = SystemMetaObject.forObject(statementHandler); MappedStatement mappedStatement = (MappedStatement) metaStatementHandler.getValue("delegate.mappedStatement"); if (!SqlCommandType.SELECT.equals(mappedStatement.getSqlCommandType())) { return invocation.proceed(); } BoundSql boundSql = (BoundSql) metaStatementHandler.getValue("delegate.boundSql"); String originalSql = boundSql.getSql(); Object parameterObject = boundSql.getParameterObject(); //查找参数中包含DataScope类型的参数 DataScope dataScope = findDataScopeObject(parameterObject); if (dataScope == null) { return invocation.proceed(); } else { String scopeName = dataScope.getScopeName(); List<Integer> deptIds = dataScope.getDeptIds(); String join = CollectionKit.join(deptIds, ","); originalSql = "select * from (" + originalSql + ") temp_data_scope where temp_data_scope." + scopeName + " in (" + join + ")"; metaStatementHandler.setValue("delegate.boundSql.sql", originalSql); return invocation.proceed(); } } ... } 可以看出,其实就是一个mybatis的拦截器,拦截StatementHandler的prepare方法,然后在需要执行的sql外包装一层select * from(...)别名 where 别名.字段 in (范围)。 看起来逻辑还是挺清晰的。回头看下用户的list代码, DataScope dataScope = new DataScope(ShiroKit.getDeptDataScope()); List<Map<String, Object>> users = userService.selectUsers(dataScope, name, beginTime, endTime, deptid); 因此在需要数据范围限定的地方加上DataScope dataScope参数,拦截器会扫描参数中是否有 DataScope 类型,有的话就在sql外套上一层select * from,然后加上定义的字段限定范围。perfect~ 结束语 好了,这里是MarkerHub,我是小Hub吕一明。就解读到这里,更多开源项目解读可以上 httts://markerhub.com 。 推荐阅读: B站50K播放量,SpringBoot+Vue前后端分离完整入门教程! 分享一套SpringBoot开发博客系统源码,以及完整开发文档!速度保存! Github上最值得学习的100个Java开源项目,涵盖各种技术栈! 2020年最新的常问企业面试题大全以及答案