首页 文章 精选 留言 我的

精选列表

搜索[VPU驱动],共10000篇文章
优秀的个人博客,低调大师

uniTerm v1.1 发布,AI Agent 驱动的全能终端与远程管理工具

uniTerm v1.1 系列(v1.1.0 ~ v1.1.2)正式发布。uniTerm 是一款开源的跨平台终端与远程管理一体化工具,内置 AI Agent 可自主操控终端执行命令、读写文件、分析日志,同时支持 SSH、SFTP、RDP、VNC、SPICE、串口、Telnet、Mosh 等多种协议,并集成数据库管理、服务器监控、工作区分屏等能力。本次更新重点增强了 SFTP 文件管理、新增串口终端与 WSL 支持、引入终端主题系统和自定义快捷键等功能。 v1.1 新功能 SFTP 文件管理增强 SFTP 功能大幅增强,补齐了日常文件管理所需的关键能力: 内置文本编辑器:支持在 SFTP 中直接编辑远程文件,可配置编码格式(UTF-8、GBK 等)与换行符类型(LF/CRLF),无需先下载、本地编辑、再上传。 文件创建与剪贴板操作:新增新建文件/文件夹功能,支持复制、粘贴、剪切操作,与本地文件管理器体验一致。 权限管理优化:chmod 对话框新增八进制权限输入模式(如 755、644),同时保留原有的 rwx 勾选框,兼顾新手与老手的使用习惯。 上传覆盖确认:上传同名文件时弹出覆盖确认提示,避免误操作丢失数据。 串口终端连接 新增串口终端连接支持。可自动扫描系统可用串口,支持配置波特率、数据位、停止位、校验位等参数后连接,方便嵌入式开发、网络设备调试等场景。 WSL 本地终端 本地终端新增 WSL 支持。侧边栏 New Local Terminal 菜单自动扫描并列出已安装的 WSL 发行版(如 WSL - Ubuntu、WSL - Debian),点击即可在 uniTerm 内直接打开对应 Linux shell,无需额外启动 Windows Terminal。 连接凭据提示 对于未保存用户名或密码的连接,连接前会在终端内直接弹出输入提示,无需先打开编辑对话框填写。SSH 密码同样支持在终端内交互式输入,免去来回切换窗口的麻烦。 终端主题系统 新增 22 款终端主题,侧边栏个性化面板支持一键预览与切换。主题涵盖经典配色(Dracula、Solarized、Monokai、Nord 等)与多套原创方案,切换实时生效、无需重启。 自定义键盘快捷键 新增快捷键自定义功能,可为新建连接、切换/关闭标签、聚焦终端/AI、锁定 AI、复制会话、切换侧边栏、打开设置等操作绑定个性化快捷键。 AI 功能增强 API 协议切换:AI 模型配置新增协议类型选择(Anthropic / OpenAI 兼容),支持连接测试按钮验证 API Key 和端点可达性,支持自定义 User-Agent。 Heredoc 兼容:修复 heredoc 语法下 AI 命令注入失败的问题,AI 现在可正确生成和执行多行脚本。 uniTerm v1.1.2 安装包可通过 GitHub Releases 下载,Windows 用户可选择安装包(.exe)或便携版(.zip)。 更多信息请访问 uniTerm 软件首页:https://uniterm.net

优秀的个人博客,低调大师

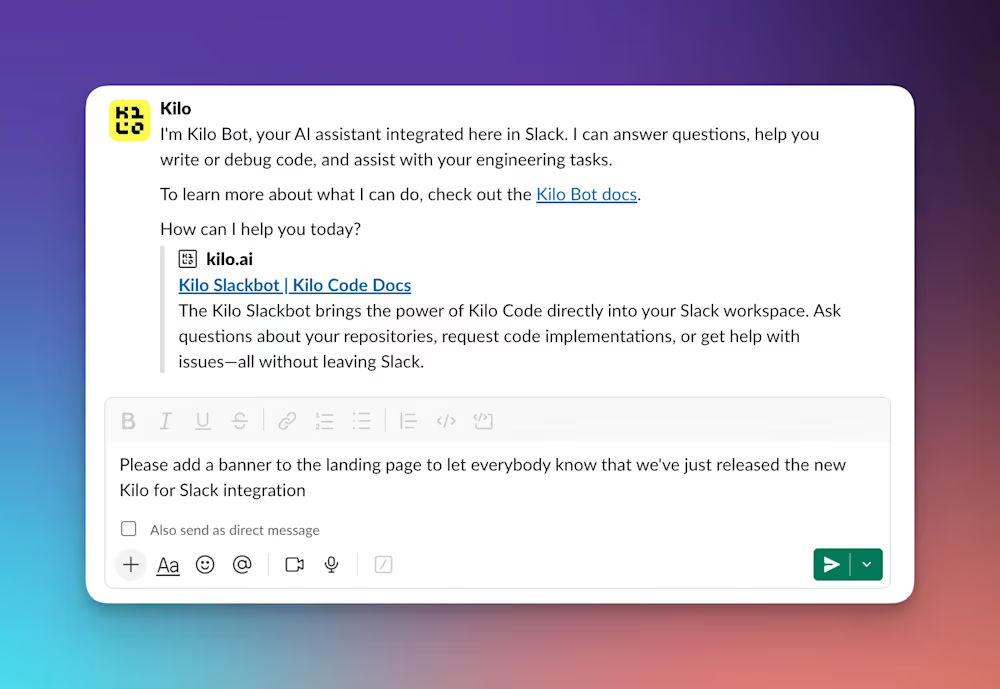
Kilo 推出 AI 驱动的 Slack 机器人,可直接从聊天消息生成并推送代码

AI 编程工具进入全面竞争阶段,知名开源 AI 初创公司 Kilo Code 近日发布了全新的 Slack 集成产品 Kilo for Slack,允许开发团队从团队聊天中直接执行代码更改、修复 Bug 并提交 Pull Request,无需打开传统集成开发环境(IDE)或切换应用。 官网地址:https://kilo.ai/slack Kilo for Slack核心功能亮点 从 Slack 聊天直接生成可执行代码 开发者在 Slack 讨论串中用 @Kilo 提及机器人后,Kilo 会读取上下文、访问连接的 GitHub 仓库,并根据讨论内容自动创建分支和 Pull Request。例如,一条类似下面的请求即可触发整个流程: 产品经理在 Slack 频道中报告了一个 bug。工程师们讨论了可能的原因。开发者无需将对话复制到 IDE 中并向 AI 助手重新解释问题,只需输入: @Kilo based on this thread, can you implement the fix for the null pointer exception in the Authentication service? (@Kilo基于这个讨论串,你能实现身份验证服务中空指针异常的修复程序吗?) 系统将生成修复代码并提交 PR,而整个过程都留在 Slack 中展示。据介绍,整个过程无需在应用程序之间复制信息或在窗口之间跳转——开发人员只需在 Slack 中发送一条消息即可触发复杂的代码更改。 无缝集成团队协作流程 相比某些只能理解单一仓库或单次交互的竞品(如 Cursor 或部分 Claude Code 的 Slack 接入),Kilo 声称支持跨多个仓库保持长期上下文关联,并在 Slack、云代理、IDE 和命令行之间做到状态连续与协作衔接。 数据权限与安全设计 Kilo 强调机器人仅读取触发提及的讨论串内容,且只访问用户授权的特定 GitHub 仓库,不会索引或浏览无关代码。所有代码更改仍需经过现有的审查流程审批,避免自动合并导致安全风险。 AI 模型与生态选择 此 Slack 集成默认使用来自中国 AI 公司 MiniMax 的开源模型 M2.1,这反映了开源模型与传统专有高端模型之间的差距正在缩小。Kilo 也支持用户自选其他模型,并强调不会将代码用于训练。 在开发工具逐渐向“去 IDE 化”(让开发行动发生在协作沟通之地)的趋势下,Kilo 希望通过把编程动作嵌入日常聊天场景来提高团队效率,这或将改变工程师的开发与协作工作方式。

优秀的个人博客,低调大师

如何采用人工智能驱动的安全信息和事件管理提高IT安全性

采用安全信息和事件管理(SIEM)软件可以为企业提供威胁监控、事件关联、事件响应和报告。SIEM通过企业技术(其中包括应用程序、防火墙和其他系统)收集、汇总和分析日志数据,随后会提醒企业的IT安全团队登录失败、恶意软件和其他潜在的恶意活动。 然而,多年来,SIEM几乎没有超出提供更好、更易搜索的基于规则的日志引擎的能力。而人工智能(AI)和机器学习(ML)技术与网络安全工具的结合则预示着美好的未来。 调研机构Gartner公司在2016年创造了另一个新术语,也就是“用于IT运营的人工智能”(AIOps)。人工智能和基于机器学习的算法与预测分析相结合,正在迅速成为SIEM平台的核心部分。这些平台提供对给定IT环境中观察到的所有活动的自动化、持续分析和关联。这种集成为SIEM提供了深度学习功能和无数集成工具,以推动更明智的结果。 以下是这种集成SIEM的好处: 防止隐形攻击 典型的SIEM分析将在相对较短的时间内(通常是数小时和数天)收集的来自不同来源的事件相关联。这与基础设施的基线相比,如果超过预设阈值,将会输出优先警报。AIOps表示将长期(可能长达数年)收集到的事件信息存储在数据库中,然后对该数据应用于分析系统。 这种分析使AIOps能够随着时间的推移来调整基础设施基线和警报阈值,并根据相关事件自动采取一些补救措施。此外,使用大数据使SIEM能够检测到网络上非常缓慢或隐蔽的活动,否则SIEM可能会错过或忽略这些攻击。通过检测这些缓慢或隐蔽的攻击活动,安全团队可以防止重大安全事件。 威胁检测 除了提供标准日志数据之外,人工智能和机器学习技术还可以整合威胁情报源。某些产品还具有高级安全分析功能,可以查看用户和网络行为。机器学习使企业的SIEM能够促进跨大型数据集的威胁检测,从而减轻安全团队的一些威胁搜寻责任。威胁情报可以深入了解全球互联网上各个IP地址、网站、域和其他实体的可能意图,这使他们能够区分正常活动和恶意活动。 为企业的SIEM提供对一个或多个威胁情报源的持续访问,使机器学习技术能够使用威胁情报提供的场景。随着了解的更多信息,它开始理解超出其初始数据输入的恶意行为警告。因此,它可以阻止企业的网络安全从未遇到的威胁。它改进了SIEM的决策,尤其是在准确性方面,从而有助于深化企业的安全层。 不过在此提出一个警告:机器学习应用在较大的数据集上比应用在较小的数据集上更有效,但由于大数据可能有损耗,它可能会使合规性报告复杂化。但由于这是一个已知问题,因此有多种解决方法可供选择。 消除数据中的噪声 典型的SIEM提供了大量的监控数据/日志,但SIEM报告数据不具有可操作性、难以理解且包含太多噪声。集成人工智能的SIEM解决方案可以高效地管理大数据,并可以使用自动化工作流替换重复性而冗余的任务。 尽管大多数人工智能程序有助于数据分类,但人工智能元素无法对无法识别的数据点和事件信息进行分组。另一方面,机器学习可以利用数据聚类功能来识别这些未知值,并根据检测到的相似性将它们分组。 随着企业规模的扩大消除盲点 随着企业规模的扩大,安全系统变得更容易出现盲点。每个盲点可能会持续数月甚至数年都没有受到监控。因此,网络的这些部分可能会长时间未打补丁。这些盲点进一步成为黑客进行威胁的渗透场所。 幸运的是,SIEM中的人工智能可以帮助提高网络的可见性,从而快速、定期地发现网络中的盲点。它还可以从这些最近发现的盲点中提取安全日志,从而扩大SIEM解决方案的范围。 提高IT安全团队的响应能力 任何企业的安全运营中心(SOC)团队都是有限的,任何SIEM产生的日志数据量都相当可观。这使得以响应迅速且有效的方式处理事件的挑战极其艰巨。更重要的是,很多SIEM工具还提供了很多不相关的数据,导致安全运营中心(SOC)团队面临警报疲劳。 当处理太多警报并且不知道应该注意和忽略哪些警报时,就会发生这种情况。机器学习提供的自动化和标准化的工作流程可以减少人为错误的可能性,并更快地完成工作。 SIEM还需要企业的IT安全团队持续监控。人工监控每个系统检查点不仅会让工作人员筋疲力尽,还会导致工作倦怠。支持机器学习功能的SIEM可以提供: 自我学习以自动化重复的非结构化流程 自动化系统警报的能力 数据可视化仪表板 实时分析 顶级企业安全 跨部门共享 不幸的是,由简单的机器学习功能支持的SIEM无法与人类的创造力和网络攻击者的集体协作相匹敌。因此,企业的安全团队需要带头进行威胁追踪和事件响应。 但是,正确实施的人工智能增强SIEM可以通过其预测和自动化功能优化这些流程。此类SIEM可为企业的IT安全团队提供以下功能 : 通过企业的安全关联规则,可以执行自动威胁搜寻。 SIEM中的人工智能元素可以通过对所有警报自动应用情境化来识别误报。 人工智能增强的SIEM可以加快安全工作人员有限的企业的检测和响应时间。 从本质上讲,企业不仅可以将这项技术视为第二双眼睛,还可以将其视为第二双手。但是需要记住的是,人类智慧将永远胜于人工智能。 预测模式 机器学习算法增强了SIEM系统,使它们能够使用以前的模式来预测未来的数据。 例如,考虑在安全漏洞期间提供的数据模式。机器学习功能使系统能够内化这些模式,然后使用它们来检测可能显示后续违规或渗透的可疑活动。 人工智能增强的SIEM可以阻止可能是恶意的进程。这不仅有助于调查和威胁补救,而且甚至在事件响应开始之前就可以减轻损害。 对于规模相对较小的企业或那些拥有简单IT基础设施的企业来说,启用人工智能的SIEM的成本可能会令人望而却步,同时在与良好的安全措施相结合的情况下几乎没有优势。大型且复杂的IT基础设施可能证明企业使用支持人工智能的SIEM的成本是合理的。但是,始终建议对产品进行详细评估。 Gartner公司预测,到2023年,全球约有1755亿美元将用于信息安全和风险管理。而到2023年,数据安全、云安全和基础设施保护是安全支出增长最快的领域。根据Zion Market Research公司的调查,全球基于人工智能的网络安全系统和服务2018年的支出高达71亿美元,预计到2025年将达到309亿美元。 随着在日益数字化的市场中生成越来越多的数据,企业关键信息的安全性至关重要。随着网络攻击的复杂程度和频率不断提高,支持威胁情报的网络安全工具将成为企业最宝贵的资产。

优秀的个人博客,低调大师

开源驱动,协同创新 | CITAHub 两周年生态交流会圆满举办

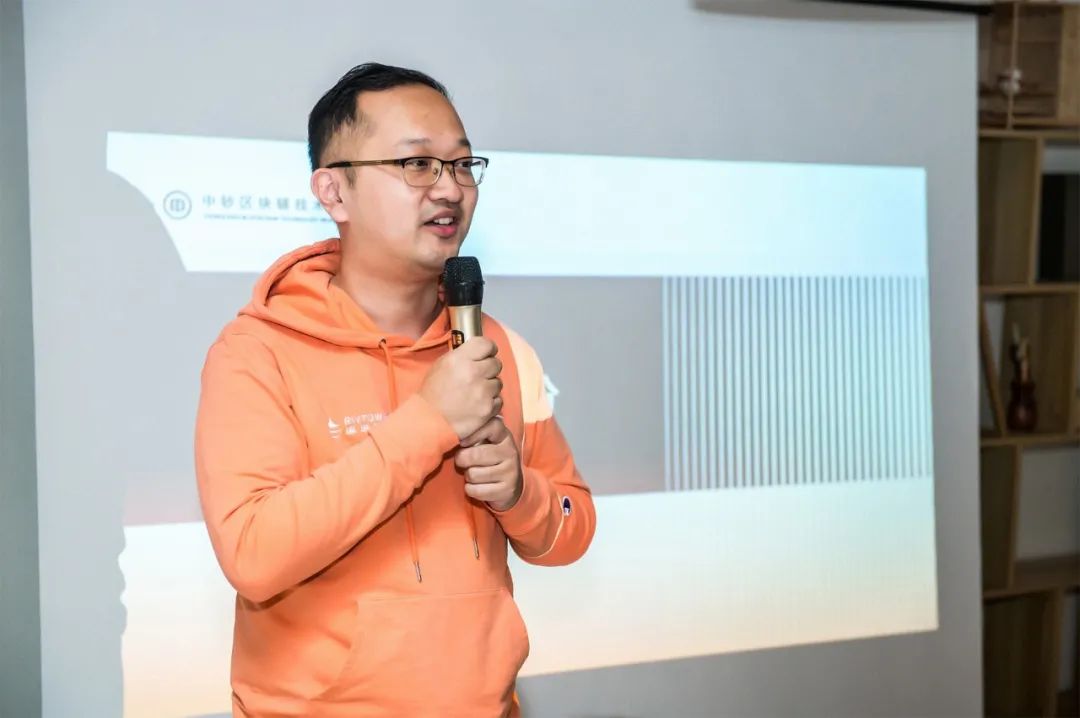
4月17日,CITAHub 两周年生态交流会在春意盎然的杭州西溪湿地正式举办。交流会由杭州溪塔科技有限公司主办,来自中国信息通信研究院、招商银行、中钞区块链技术研究院、北京航天航空大学杭州创新研究院等多家企业机构、院校组织的嘉宾受邀出席。 本次交流会由溪塔科技 CEO 王晓亮致欢迎辞,开源社区主理人潘若辰介绍社区团队,并宣布 CITAHub 新官网正式进入公测期。 溪塔科技 CEO 王晓亮致辞 会上,招商银行开放许可链负责人陈鹏分享了对开放许可链实践与发展的思考,在分析当下开发许可链的建设背景和应用状况的同时,也进一步探讨了相关发展规划,指出未来将与更多的行业链、业务链互联互通,多链并行,组建更大生态,各方优势互补,共同促进区块链开放生态发展。 陈鹏老师分享对开放许可链实践与发展的思考 中钞区块链技术研究院产品专家潘镥镥就分布式数字身份发表了主题演讲,指出数字身份是数字世界的基础和入口,并从 DID 全局认证、可验证凭证技术、分布式验证、P2P 可信通信等几个方面总结了分布式数字身份的特性。 潘镥镥老师关于分布式数字身份的演讲 中国信息通信研究院、工业互联网与物联网研究所工程师杨白雪从依托国家顶级节点部署的区块链实验网络——“星火·链网”出发,着重解析了新型基础设施建设的布局和目标规划,指出以区块链技术作为自主创新的重要突破口,为产业数字化转型提供支撑的同时,推动区块链的应用发展,实现新基建的引擎作用。 杨白雪老师解析“星火·链网” 针对以上主题,现场嘉宾进行了热烈的讨论交流。 讨论过后,溪塔科技首席架构师宁志伟从区块链生态角度,描述云原生和联盟链的特性,向嘉宾们刻画了联盟链2.0 CITA-Cloud的功能蓝图和技术架构。溪塔科技 COO 孔庆阳向大家介绍了 CITA 的产品形态和相关案例,总结了区块链技术的典型应用场景。 宁志伟描绘联盟链2.0 CITA-Cloud 银河系计划 孔庆阳分享区块链技术的应用场景 会议最后,回顾 CITA 五周年, CITAHub 开源社区成立两周年,溪塔科技 CEO 王晓亮分享了对区块链技术的应用路径和现状的思考,并再次感谢了各位生态合作伙伴对 CITAHub 开源社区的关注和支持。 王晓亮对 CITAHub 开源社区两周年的回顾总结 CITAHub 两周年生态交流会合影 当前,新一轮的科技革命和产业革命正在加速发展,区块链技术作为创造信任价值网络的工具,与各行各业产生了密不可分的联系。 基于首个国产自主区块链内核 CITA 所构建的 CITAHub 开源社区,是一个连接开发者和商业场景的合作平台。未来,溪塔科技将携手各位生态合作伙伴,共同促进区块链技术与经济社会的深度融合,更好地发挥区块链在建设数字经济中的应用价值,助力“区块链+5G”技术的发展。 CITAHub 开源社区团队

优秀的个人博客,低调大师

Spring注解驱动开发之六——@Bean指定初始化、销毁方法、BeanPostProcessor后置处理器

本文包含以下内容: 新、旧方法指定初始化和销毁方法 InitializingBean、DisposableBean指定生命周期方法 @PostConstruct、@PreDestroy调用Bean 创建前后的方法 BeanPostProcessor 后置处理器,进行初始化 前后的工作 上述3种的联合调试 1.新、旧方法指定初始化和销毁方法 在之前,指定一个Bean 的初始化方法和销毁方法可以在 bean.xml 文件中<bean> 标签中指定 init-method和 destroy-method 进行初始函数、销毁函数的指定。要求没有任何参数、可以报任何异常 在注解中也可以通过在 @Bean (initMethod= "init" ,destroyMethod= "detory" ) 注解中指定 ,初始化方法和销毁方法。下面开始测试 1.建立实体类 @Componentpublic class Car { public Car(){ System.out.println("car constructor..."); } public void init(){ System.out.println("car ... init..."); } public void detory(){ System.out.println("car ... detory..."); }} 2.通过注解标记需要 创建的类 @Bean(initMethod="init",destroyMethod="detory") public Car car(){ return new Car(); } 3.编写测试方法进行 测试 @Test public void test01(){ //1、创建ioc容器 AnnotationConfigApplicationContext applicationContext = new AnnotationConfigApplicationContext(MainConfigOfLifeCycle.class); System.out.println("容器创建完成..."); //applicationContext.getBean("car"); //关闭容器 applicationContext.close(); } 4.获得结果 5.测试, 非单例的情况加上 @Scope ( "prototype" ) 注解,获得结果,表示,非单例的组件在容器创建后就不在进行管理,不再进行销毁操作了 2.InitializingBean、DisposableBean指定生命周期方法 除了通过指定指定初始化方法、销毁方法外,还可以通过继承 InitializingBean 、 DisposableBean 接口分别实现其afterPropertiesSet 、destroy 方法实现,在Bean创建前后执行函数操作,下面进行测试: 1)建立实体类 @Componentpublic class Cat implements InitializingBean,DisposableBean { public Cat(){ System.out.println("cat constructor..."); } @Override public void destroy() throws Exception { // TODO Auto-generated method stub System.out.println("cat...destroy..."); } @Override public void afterPropertiesSet() throws Exception { // TODO Auto-generated method stub System.out.println("cat...afterPropertiesSet..."); }} 2)运行获得结果 3.@PostConstruct、@PreDestroy调用Bean 创建前后的方法 在springboot中可以通过@PostConstruct、@PreDestroy,分别制定在Bean装配前后执行的函数。下面开始测试: 1)建立实体类 @Componentpublic class Dog implements ApplicationContextAware { //@Autowired private ApplicationContext applicationContext; public Dog(){ System.out.println("dog constructor..."); } //对象创建并赋值之后调用 @PostConstruct public void init(){ System.out.println("Dog....@PostConstruct..."); } //容器移除对象之前 @PreDestroy public void detory(){ System.out.println("Dog....@PreDestroy..."); }} 2)运行测试方法,在Bean创建完成之后、容器创建完成前 调用的 @PostConstruct 在Bean销毁前调用了 @PreDestroy的方法 4.BeanPostProcessor 后置处理器,进行初始化 前后的工作 可以通过建立BeanPostProcessor 实现类,通过其 postProcessBeforeInitialization 、postProcessAfterInitialization方法可以在Bean 完成创建之后、Bean 销毁之前,执行指定方法。下面开始测试: 1.创建自定义 BeanPostProcessor 实现类 /** * 后置处理器:初始化前后进行处理工作 * 将后置处理器加入到容器中 * @author lfy */@Componentpublic class MyBeanPostProcessor implements BeanPostProcessor { @Override public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException { // TODO Auto-generated method stub System.out.println("postProcessBeforeInitialization..."+beanName+"=>"+bean); return bean; } @Override public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException { // TODO Auto-generated method stub System.out.println("postProcessAfterInitialization..."+beanName+"=>"+bean); return bean; }} 2.运行测试,得到结果,在Bean创建完成之后,调用了 postProcessBeforeInitialization方法 ,在创建Bean完成之后调用 postProcessAfterInitialization 。结果如下: 5.上述3种的联合调试 综合上述内容,同时加入(1)InitializingBean、DisposableBean (2)@PostConstruct、@PreDestroy (3)BeanPostProcessor查看执行方法的先后顺序 1.)首先是创建,测试结果如下图所示:执行顺序是,现执行 postProcessBeforeInitialization而后是构造方法 、而后是 postProcessAfterInitialization而后是 InitializingBean的 afterPropertiesSet -END- 可以关注我的公众号,免费获取价值1980元学习资料 点击“在看”,学多少都不会忘~ 本文分享自微信公众号 - 阿聪的全栈之路(gh_ffab7c84fb0c)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Commvault蔡报永:以全新产品组合,驱动企业智能化数据管理

【51CTO.com原创稿件】提到Commvault,很多用户会认为这是一家专注于数据安全保护的厂商。实际上,Commvault并非仅仅专注于数据安全保护,而是一家跨越云端和本地环境的一体化智能数据管理厂商。在今年的Commvault FutureReady大会上,Commvault不但推出了包括CommvaultBackup & Recovery、CommvaultDisaster Recovery、Commvault CompleteTM Data Protection以及Commvault HyperScale X在内的全新智能数据管理产品与服务组合,同时宣布以全新灵活的订阅定价模式,助力于客户提升价值并简化混合云环境下的数据管理。 在近期Commvault举行的一次线上媒体沟通会上,Commvault中国区技术总监蔡报永详细分享了Commvault全新的产品和服务组合。蔡报永表示,Commvault是着重于智能化数据管理的一家企业,对数据有非常好的感知,提供了数据的移动、搬迁、去重、容灾等能力,产品涵盖了数据存储、保护、优化、使用四大方面,帮助企业在任何的场景下实现智能化数据管理,加速企业数字化转型。 集成Hedvig技术,Commvault HyperScaleX一体机全新上市 一年前,Commvault收购了Hedvig,并正式开始提供多协议存储。一年之后,在Commvault FutureReady大会上,Commvault正式发布了基于Hedvig的Commvault HyperScaleX一体机。 据蔡报永介绍,Commvault HyperScaleX是一款直观、易于部署的横向扩展型一体机,与Commvault智能数据管理平台实现了全面集成。HyperScaleX提供的可扩展性、安全性和恢复能力能够有力推动企业向混合云、容器和虚拟化环境过渡,其灵活架构使得用户能够按需快速启动和运行。此外,HyperScaleX能够在并发硬件故障时通过保持可用性来提高恢复能力、提供了更优的SLA并最大程度降低操作影响。通过Hedvig文件系统的横向扩展能力,HyperScale X能够为客户提供高性能的备份和恢复功能,并随着企业扩展而提高性能,加速企业数字化转型进程。 据了解,HyperScale X一体机提供了完整的一体机交付模式,即软件+硬件的组合,上层采用了Commvault最新的软件,底层则采用了超微的环境。蔡报永表示,在HyperScale X一体机上,Commvault同时也可采用参考架构模式,仅对硬件环境进行了认证,交付则是在当地进行,这样的好处是能够与更多的硬件厂商合作,提供更加灵活的交付模式。 蔡报永告诉记者,Commvault之所以收购Hedvig,是希望把一级存储和二级存储两部分进行融合,为用户提供一体化、智能化的数据管理产品。目前, Hedvig不仅提供了一级存储的支持,而且通过与Commvault Backup&Recovery进行组合还提供了二级存储服务,并且通过与竞争对手的备份软件集成,能够充分挖掘用户备份数据、归档数据的价值,应用于生产决策当中,更加有利于发挥全部数据的价值。 另据介绍,HyperScale X一体机采用了订阅模式进行销售。当用户订阅之后,Commvault会提供一整套HyperScale运行环境,时间为三年,其中包含了Commvault软件和物理机。不过,蔡报永表示其中的备份软件用户可以独立订阅,也可以是购买永久许可,灵活性非常高。 合而为一,以更加灵活的方式提供定制化服务 在Commvault的全新产品组合中,记者发现Disaster Recovery和Backup&Recovery这两个独立的数据备份与恢复的产品。其中Commvault Backup & Recovery能够跨云和本地环境确保包括容器、云原生及虚拟在内的全部工作负载的数据可用性,并提供简单、可靠的数据保护。而Commvault Disaster Recovery作为一款功能全面的数据灾备产品,能够助力客户确保业务连续性,跨云和本地环境验证数据的可恢复性,并提供简单且自动化的灾难恢复编排、灵活的复制和可靠的恢复就绪性。 在记者的印象当中,Commvault是一家非常注重提供统一化平台的公司,而今天发布的很多产品,有合也有分,那么这一变动的初衷为何? “Commvault新推出的Disaster Recovery是一个产品,Backup&Recovery是另外一个产品,看起来好像是分开了,但其实是一个合而为一的产品。”蔡报永表示, Disaster Recovery和Backup&Recovery这两个产品采用了统一的管理界面和中枢大脑,把产品拆开之后,两个产品可以用到不同的场景应用当中,更加方便用户的选择,灵活性也更强了。 蔡报永强调,虽然产品组合更加多样化,但由于管理界面和中枢神完全一样,因此并不会给用户带来任何的使用差别,如之前使用Disaster Recovery的用户,之后想增加一套虚拟化备份软件产品,这时候就可以选择Backup&Recovery,在使用起来并不会有两个独立的产品感受。 据蔡报永介绍,Commvault将Disaster Recovery+Backup&Recovery的组合称之为CommvaultCompleteTM Data Protection,能够帮助用户实现自动化加速上云,此外如数据保护、勒索软件保护、自动化恢复就绪、数据验证以及SLA延续性等等,都完全涵盖在完整的CommvaultCompleteTM Data Protection中。 全面支持容器,加速Kubernetes应用开发 众所周知,Kubernetes已迅速发展成为应用程序现代化的标准容器基础设施平台。企业需要确保支持容器化工作负载的存储基础架构具备适用于Kubernetes部署的集成解决方案,且此类基础架构必须能够跨所有类型的Kubernetes部署(云托管或自管理)实现集成,并为整个容器化环境提供无缝迁移、数据保护、可用性保障和灾备能力。 为此,Commvault宣布推出Hedvig分布式存储平台(Hedvig Distributed StoragePlatform)的全新增强功能,用于在混合云和多云环境下运行Kubernetes。 蔡报永表示,Hedvig分布式存储平台全新的Kubernetes原生API 增强功能,支持在任何Kubernetes环境中通过加密和第三方KMIP密钥管理确保数据安全性,从而为客户开发和运行新型现代应用程序提供了灵活性。此外,新的增强功能还可以帮助企业用户无缝地保护、迁移并使用存储在Hedvig中的数据,以加快DevOps流程并消除任何云托管或自管理Kubernetes服务之间的分界。他强调,Hedvig分布式存储平台提供了业界最为广泛的与本地基础设施、云存储和容器平台的紧密结合,无论数据存储在容器、云原生应用还是传统工作负载中,Hedvig分布式存储平台都可以提供全面的数据管理解决方案。 采访最后,蔡报永向记者再次强调了Commvault的愿景。他表示,Commvault是一个纯粹的数据管理软件解决方案提供商,其愿景是帮助企业将生产与存储做到统一融合,包括在二级存储和数据管理层面的统一融合,以智能化的数据管理解决方案,帮助企业加速数字化转型。 【51CTO原创稿件,合作站点转载请注明原文作者和出处为51CTO.com】 【责任编辑: 张诚 TEL:(010)68476606】

优秀的个人博客,低调大师

【Spring注解驱动开发】使用@Autowired@Qualifier@Primary三大注解自动装配组件,你会了吗?

点击上方蓝色“冰河技术”,关注并选择“设为星标” 持之以恒,贵在坚持,每天进步一点点! 作者个人研发的在高并发场景下,提供的简单、稳定、可扩展的延迟消息队列框架,具有精准的定时任务和延迟队列处理功能。自开源半年多以来,已成功为十几家中小型企业提供了精准定时调度方案,经受住了生产环境的考验。为使更多童鞋受益,现给出开源框架地址: https://github.com/sunshinelyz/mykit-delay PS: 欢迎各位Star源码,也可以pr你牛逼哄哄的代码。 写在前面 【Spring专题】停更一个多月,期间在更新其他专题的内容,不少小伙伴纷纷留言说:冰河,你【Spring专题】是不是停更了啊!其实并没有停更,只是中途有很多小伙伴留言说急需学习一些知识技能,以便于跳槽,哈哈,大家都懂得!所以,中途停更了一段时间,写了一些其他专题的文章。现在,继续更新【String专题】。 关注 冰河技术 微信公众号,订阅更多技术干货!如果文章对你有所帮助,请不要吝惜你的点赞、在看、留言和转发,你的支持是我持续创作的最大动力! 项目工程源码已经提交到GitHub:https://github.com/sunshinelyz/spring-annotation 注解说明 @Autowired注解 @Autowired 注解,可以对类成员变量、方法和构造函数进行标注,完成自动装配的工作。@Autowired 注解可以放在类,接口以及方法上。在使用@Autowired之前,我们对一个bean配置属性时,是用如下xml文件的形式进行配置的。 <propertyname="属性名"value="属性值"/> @Autowired 注解的源码如下所示。 packageorg.springframework.beans.factory.annotation;importjava.lang.annotation.Documented;importjava.lang.annotation.ElementType;importjava.lang.annotation.Retention;importjava.lang.annotation.RetentionPolicy;importjava.lang.annotation.Target;@Target({ElementType.CONSTRUCTOR,ElementType.METHOD,ElementType.PARAMETER,ElementType.FIELD,ElementType.ANNOTATION_TYPE})@Retention(RetentionPolicy.RUNTIME)@Documentedpublic@interfaceAutowired{booleanrequired()defaulttrue;} @Autowired 注解说明: (1)默认优先按照类型去容器中找对应的组件,找到就赋值; (2)如果找到多个相同类型的组件,再将属性名称作为组件的id,到 IOC 容器中进行查找。 @Qualifier注解 @Autowired是根据类型进行自动装配的,如果需要按名称进行装配,则需要配合@Qualifier 注解使用。 @Qualifier注解源码如下所示。 packageorg.springframework.beans.factory.annotation;importjava.lang.annotation.Documented;importjava.lang.annotation.ElementType;importjava.lang.annotation.Inherited;importjava.lang.annotation.Retention;importjava.lang.annotation.RetentionPolicy;importjava.lang.annotation.Target;@Target({ElementType.FIELD,ElementType.METHOD,ElementType.PARAMETER,ElementType.TYPE,ElementType.ANNOTATION_TYPE})@Retention(RetentionPolicy.RUNTIME)@Inherited@Documentedpublic@interfaceQualifier{Stringvalue()default"";} @Primary注解 在Spring 中使用注解,常使用@Autowired, 默认是根据类型Type来自动注入的。但有些特殊情况,对同一个接口,可能会有几种不同的实现类,而默认只会采取其中一种实现的情况下, 就可以使用@Primary注解来标注优先使用哪一个实现类。 @Primary注解的源码如下所示。 packageorg.springframework.context.annotation;importjava.lang.annotation.Documented;importjava.lang.annotation.ElementType;importjava.lang.annotation.Retention;importjava.lang.annotation.RetentionPolicy;importjava.lang.annotation.Target;@Target({ElementType.TYPE,ElementType.METHOD})@Retention(RetentionPolicy.RUNTIME)@Documentedpublic@interfacePrimary{} 自动装配 在进行项目实战之前,我们先来说说什么是Spring组件的自动装配。Spring组件的自动装配就是:Spring利用依赖注入,也就是我们通常所说的DI,完成对IOC容器中各个组件的依赖关系赋值。 项目实战 测试@Autowired注解 这里,我们以之前项目中创建的dao、service和controller为例进行说明。dao、service和controller的初始代码分别如下所示。 dao packageio.mykit.spring.plugins.register.dao;importorg.springframework.stereotype.Repository;/***@authorbinghe*@version1.0.0*@description测试的dao*/@RepositorypublicclassPersonDao{} service packageio.mykit.spring.plugins.register.service;importio.mykit.spring.plugins.register.dao.PersonDao;importorg.springframework.beans.factory.annotation.Autowired;importorg.springframework.stereotype.Service;/***@authorbinghe*@version1.0.0*@description测试的Service*/@ServicepublicclassPersonService{@AutowiredprivatePersonDaopersonDao;} controller packageio.mykit.spring.plugins.register.controller;importorg.springframework.stereotype.Controller;/***@authorbinghe*@version1.0.0*@description测试的controller*/@ControllerpublicclassPersonController{@AutowiredprivatePersonServicepersonService;} 可以看到,我们在Service中使用@Autowired注解注入了Dao,在Controller中使用@Autowired注解注入了Service。为了方便测试,我们在PersonService类中生成一个toString()方法,如下所示。 packageio.mykit.spring.plugins.register.service;importio.mykit.spring.plugins.register.dao.PersonDao;importorg.springframework.beans.factory.annotation.Autowired;importorg.springframework.stereotype.Service;/***@authorbinghe*@version1.0.0*@description测试的Service*/@ServicepublicclassPersonService{@AutowiredprivatePersonDaopersonDao;@OverridepublicStringtoString(){returnpersonDao.toString();}} 这里,我们在PersonService类的toString()方法中直接调用personDao的toString()方法并返回。为了更好的演示效果,我们在项目的 io.mykit.spring.plugins.register.config 包下创建AutowiredConfig类,如下所示。 packageio.mykit.spring.plugins.register.config;importorg.springframework.context.annotation.ComponentScan;importorg.springframework.context.annotation.Configuration;/***@authorbinghe*@version1.0.0*@description测试自动装配组件的Config配置类*/@Configuration@ComponentScan(value={"io.mykit.spring.plugins.register.dao","io.mykit.spring.plugins.register.service","io.mykit.spring.plugins.register.controller"})publicclassAutowiredConfig{} 接下来,我们来测试一下上面的程序,我们在项目的src/test/java目录下的 io.mykit.spring.test 包下创建AutowiredTest类,如下所示。 packageio.mykit.spring.test;importio.mykit.spring.plugins.register.config.AutowiredConfig;importio.mykit.spring.plugins.register.service.PersonService;importorg.junit.Test;importorg.springframework.context.annotation.AnnotationConfigApplicationContext;/***@authorbinghe*@version1.0.0*@description测试自动装配*/publicclassAutowiredTest{@TestpublicvoidtestAutowired01(){//创建IOC容器AnnotationConfigApplicationContextcontext=newAnnotationConfigApplicationContext(AutowiredConfig.class);PersonServicepersonService=context.getBean(PersonService.class);System.out.println(personService);context.close();}} 测试方法比较简单,这里,我就不做过多说明了。接下来,我们运行AutowiredTest类的testAutowired01()方法,得出的输出结果信息如下所示。 io.mykit.spring.plugins.register.dao.PersonDao@10e92f8f 可以看到,输出了PersonDao信息。 那么问题来了:我们在PersonService类中输出的PersonDao,和我们直接在Spring IOC容器中获取的PersonDao是不是同一个对象呢? 我们可以在AutowiredTest类的testAutowired01()方法中添加获取PersonDao对象的方法,并输出获取到的PersonDao对象,如下所示。 @TestpublicvoidtestAutowired01(){//创建IOC容器AnnotationConfigApplicationContextcontext=newAnnotationConfigApplicationContext(AutowiredConfig.class);PersonServicepersonService=context.getBean(PersonService.class);System.out.println(personService);PersonDaopersonDao=context.getBean(PersonDao.class);System.out.println(personDao);context.close();} 我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 io.mykit.spring.plugins.register.dao.PersonDao@10e92f8fio.mykit.spring.plugins.register.dao.PersonDao@10e92f8f 可以看到,我们在PersonService类中输出的PersonDao对象和直接从IOC容器中获取的PersonDao对象是同一个对象。 如果在Spring容器中存在对多个PersonDao对象该如何处理呢? 首先,为了更加直观的看到我们使用@Autowired注解装配的是哪个PersonDao对象,我们对PersonDao类进行改造,为其加上一个remark字段,为其赋一个默认值,如下所示。 packageio.mykit.spring.plugins.register.dao;importlombok.AllArgsConstructor;importlombok.Data;importlombok.NoArgsConstructor;importorg.springframework.stereotype.Repository;/***@authorbinghe*@version1.0.0*@description测试的dao*/@Data@NoArgsConstructor@AllArgsConstructor@RepositorypublicclassPersonDao{privateStringremark="1";} 接下来,我们就在AutowiredConfig类中注入一个PersonDao对象,并且显示指定PersonDao对象在IOC容器中的bean的名称为personDao2,并为PersonDao对象的remark字段赋值为2,如下所示。 @Bean("personDao2")publicPersonDaopersonDao(){returnnewPersonDao("2");} 目前,在我们的IOC容器中就会注入两个PersonDao对象。那此时,@Autowired注解装配的是哪个PersonDao对象呢? 接下来,我们运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 PersonDao{remark='1'} 可以看到,结果信息输出了1,说明:@Autowired注解默认优先按照类型去容器中找对应的组件,找到就赋值;如果找到多个相同类型的组件,再将属性名称作为组件的id,到 IOC 容器中进行查找。 那我们如何让@Autowired装配personDao2呢? 这个问题问的好,其实很简单,我们将PersonService类中的personDao全部修改为personDao2,如下所示。 packageio.mykit.spring.plugins.register.service;importio.mykit.spring.plugins.register.dao.PersonDao;importorg.springframework.beans.factory.annotation.Autowired;importorg.springframework.stereotype.Service;/***@authorbinghe*@version1.0.0*@description测试的Service*/@ServicepublicclassPersonService{@AutowiredprivatePersonDaopersonDao2;@OverridepublicStringtoString(){returnpersonDao2.toString();}} 此时,我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 PersonDao{remark='2'} 可以看到,此时命令行输出了personDao2的信息。 测试@Qualifier注解 从测试@Autowired注解的结果来看:@Autowired注解默认优先按照类型去容器中找对应的组件,找到就赋值;如果找到多个相同类型的组件,再将属性名称作为组件的id,到 IOC 容器中进行查找。 如果IOC容器中存在多个相同类型的组件时,我们可不可以显示指定@Autowired注解装配哪个组件呢?有些小伙伴肯定会说:废话!你都这么问了,那肯定可以啊!没错,确实可以啊!此时,@Qualifier注解就派上用场了! 在之前的测试案例中,命令行输出了 PersonDao{remark='2'} 说明@Autowired注解装配了personDao2,那我们如何显示的让@Autowired注解装配personDao呢? 比较简单,我们只需要在PersonService类上personDao2字段上添加@Qualifier注解,显示指定@Autowired注解装配personDao,如下所示。 @Qualifier("personDao")@AutowiredprivatePersonDaopersonDao2; 此时,我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 PersonDao{remark='1'} 可以看到,此时尽管字段的名称为personDao2,但是我们使用了@Qualifier注解显示指定@Autowired注解装配personDao对象,所以,最终的结果输出了personDao对象的信息。 测试容器中无组件的情况 如果IOC容器中无相应的组件,会发生什么情况呢?此时,我们删除PersonDao类上的@Repository注解,并且删除AutowiredConfig类中的personDao()方法上的@Bean注解,如下所示。 packageio.mykit.spring.plugins.register.dao;/***@authorbinghe*@version1.0.0*@description测试的dao*/publicclassPersonDao{privateStringremark="1";publicStringgetRemark(){returnremark;}publicvoidsetRemark(Stringremark){this.remark=remark;}@OverridepublicStringtoString(){return"PersonDao{"+"remark='"+remark+'\''+'}';}} packageio.mykit.spring.plugins.register.config;importio.mykit.spring.plugins.register.dao.PersonDao;importorg.springframework.context.annotation.ComponentScan;importorg.springframework.context.annotation.Configuration;/***@authorbinghe*@version1.0.0*@description测试自动装配组件的Config配置类*/@Configuration@ComponentScan(value={"io.mykit.spring.plugins.register.dao","io.mykit.spring.plugins.register.service","io.mykit.spring.plugins.register.controller"})publicclassAutowiredConfig{publicPersonDaopersonDao(){PersonDaopersonDao=newPersonDao();personDao.setRemark("2");returnpersonDao;}} 此时IOC容器中不再有personDao,我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 Causedby:org.springframework.beans.factory.NoSuchBeanDefinitionException:Noqualifyingbeanoftype'io.mykit.spring.plugins.register.dao.PersonDao'available:expectedatleast1beanwhichqualifiesasautowirecandidate.Dependencyannotations:{@org.springframework.beans.factory.annotation.Qualifier(value=personDao),@org.springframework.beans.factory.annotation.Autowired(required=true)} 可以看到,Spring抛出了异常,未找到相应的bean对象,我们能不能让Spring不报错呢? 那肯定可以啊!Spring的异常信息中都给出了相应的提示。 {@org.springframework.beans.factory.annotation.Qualifier(value=personDao),@org.springframework.beans.factory.annotation.Autowired(required=true)} 解决方案就是在PersonService类的@Autowired添加一个属性required=false,如下所示。 @Qualifier("personDao")@Autowired(required=false)privatePersonDaopersonDao2; 并且我们修改下PersonService的toString()方法,如下所示。 @OverridepublicStringtoString(){return"PersonService{"+"personDao2="+personDao2+'}';} 此时,还需要将AutowiredTest类的testAutowired01()方法中直接从IOC容器中获取personDao的代码删除,如下所示。 @TestpublicvoidtestAutowired01(){//创建IOC容器AnnotationConfigApplicationContextcontext=newAnnotationConfigApplicationContext(AutowiredConfig.class);PersonServicepersonService=context.getBean(PersonService.class);System.out.println(personService);context.close();} 此时,我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 PersonService{personDao2=null} 可以看到,当为@Autowired添加属性required=false后,即使IOC容器中没有对应的对象,Spring也不会抛出异常。此时,装配的对象就为null。 测试完成后,我们再次为PersonDao类添加@Repository注解,并且为AutowiredConfig类中的personDao()方法添加@Bean注解。 测试@Primary注解 在Spring中,对同一个接口,可能会有几种不同的实现类,而默认只会采取其中一种实现的情况下, 就可以使用@Primary注解来标注优先使用哪一个实现类。 首先,我们在AutowiredConfig类的personDao()方法上添加@Primary注解,此时,我们需要删除PersonService类中personDao字段上的@Qualifier注解,这是因为@Qualifier注解为显示指定装配哪个组件,如果使用了@Qualifier注解,无论是否使用了@Primary注解,都会装配@Qualifier注解标注的对象。 设置完成后,我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 PersonService{personDao2=PersonDao{remark='2'}} 可以看到,此时remark的值为2,装配了AutowiredConfig类中注入的personDao。 接下来,我们为PersonService类中personDao字段再次添加@Qualifier注解,如下所示。 @Qualifier("personDao")@Autowired(required=false)privatePersonDaopersonDao; 此时,我们再次运行AutowiredTest类的testAutowired01()方法,输出的结果信息如下所示。 PersonService{personDao=PersonDao{remark='1'}} 可以看到,此时,Spring装配了使用@Qualifier标注的personDao。 重磅福利 关注「 冰河技术 」微信公众号,后台回复 “设计模式” 关键字领取《深入浅出Java 23种设计模式》PDF文档。回复“Java8”关键字领取《Java8新特性教程》PDF文档。回复“限流”关键字获取《亿级流量下的分布式限流解决方案》PDF文档,三本PDF均是由冰河原创并整理的超硬核教程,面试必备!! 好了,今天就聊到这儿吧!别忘了点个赞,给个在看和转发,让更多的人看到,一起学习,一起进步!! 写在最后 如果你觉得冰河写的还不错,请微信搜索并关注「 冰河技术 」微信公众号,跟冰河学习高并发、分布式、微服务、大数据、互联网和云原生技术,「 冰河技术 」微信公众号更新了大量技术专题,每一篇技术文章干货满满!不少读者已经通过阅读「 冰河技术 」微信公众号文章,吊打面试官,成功跳槽到大厂;也有不少读者实现了技术上的飞跃,成为公司的技术骨干!如果你也想像他们一样提升自己的能力,实现技术能力的飞跃,进大厂,升职加薪,那就关注「 冰河技术 」微信公众号吧,每天更新超硬核技术干货,让你对如何提升技术能力不再迷茫! 后记: 记住:你比别人强的地方,不是你做过多少年的CRUD工作,而是你比别人掌握了更多深入的技能。不要总停留在CRUD的表面工作,理解并掌握底层原理并熟悉源码实现,并形成自己的抽象思维能力,做到灵活运用,才是你突破瓶颈,脱颖而出的重要方向! 你在刷抖音,玩游戏的时候,别人都在这里学习,成长,提升,人与人最大的差距其实就是思维。你可能不信,优秀的人,总是在一起。。 扫一扫或长按二维码 关注冰河技术微信公众号 如果你喜欢这篇文章,欢迎点赞和转发。 生活很美好,明天见(。・ω・。)ノ♡ 写留言 本文分享自微信公众号 - 冰河技术(hacker-binghe)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

驱动智慧医疗,从至强开始--英特尔,用人工智能解决大问题

大数据、云计算、人脸识别、自动驾驶……近年来这些耳熟能详的人工智能科技,正在悄然改变着我们的生活。英特尔作为全球领先的科技公司,一直致力于用人工智能解决大问题。 面对乳腺癌这一威胁女性健康的“头号杀手”,英特尔与国家级医学影像人工智能高新技术企业——汇医慧影公司携手,将用于乳腺癌筛查的深度学习模型,应用在英特尔至强可扩展处理器平台上,大幅提升数据的处理和推理效率,让乳腺癌的筛查更精准、高效。 同传统方案相比,采用至强可拓展处理器平台拥有以下五点优势: 高度统一的平台架构:至强服务器提供全CPU统一架构处理,除了单芯片20核心40线程的处理器硬件,还支持优化的Math Kernel Library数学核心计算库和深度学习框架,开发者可以在这一平台上,实现不同深度学习算法的移植、优化和重新部署。 强大的海量数据处理能力:人工智能技术可以进行多模态影像数据融合,多维度,立体化进行数据融合分析,为乳腺癌的诊断及治疗提供全面的个体化的综合信息。针对来自多个医疗中心的海量影像数据,至强服务器提供最高达768GB的超大内存,配合多核心多线程处理能力,对乳腺采集影像进行像素级别的特征识别。 数据识别更加精准:经汇医慧影测试,经过深度学习的人工智能系统,读片准确率可达到90%以上。英特尔至强服务器可将深度网络模型优化并将数据集进一步加强,进一步帮助提高识别准确率。 数据分析的高效快捷:英特尔至强服务器支持完整的数据处理及深度学习工具链。通过采用Multi-Stream多数据流并行处理技术,并对各个数据处理环节进行优化,使得数据处理更加流畅,使人工智能影像分析速度远超传统的数据处理方案。 方案部署更便捷:在方案的推进过程中,技术人员需要在云端和医院部署大量的计算设备。至强服务器的统一架构大大降低了部署和维护成本,对于一项医疗服务的持续部署和优化具有重大意义。 此外,英特尔还将与汇医慧影公司进一步开发“人工智能乳腺全周期健康管理系统”, 以可靠的端到端的人工智能解决方案,着力打造贯穿乳腺癌早期筛查、临床治疗决策及术后复查的服务闭环。 21世纪是属于生命科学的世纪。未来,英特尔的人工智能还将在智慧医疗领域发挥更大的作用,致力解决人类面临的大问题,加速行业转型,更好地帮助医生,造福广大患者。 原文发布时间为:2018-10-23 本文作者:英特尔 本文来自云栖社区合作伙伴“ 大数据地盘”,了解相关信息可以关注“ 大数据地盘”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册